【Qwen-Image-2.1】7Bで透過画像も生成できるAlibabaの最新画像生成AIの使い方・性能を徹底解説
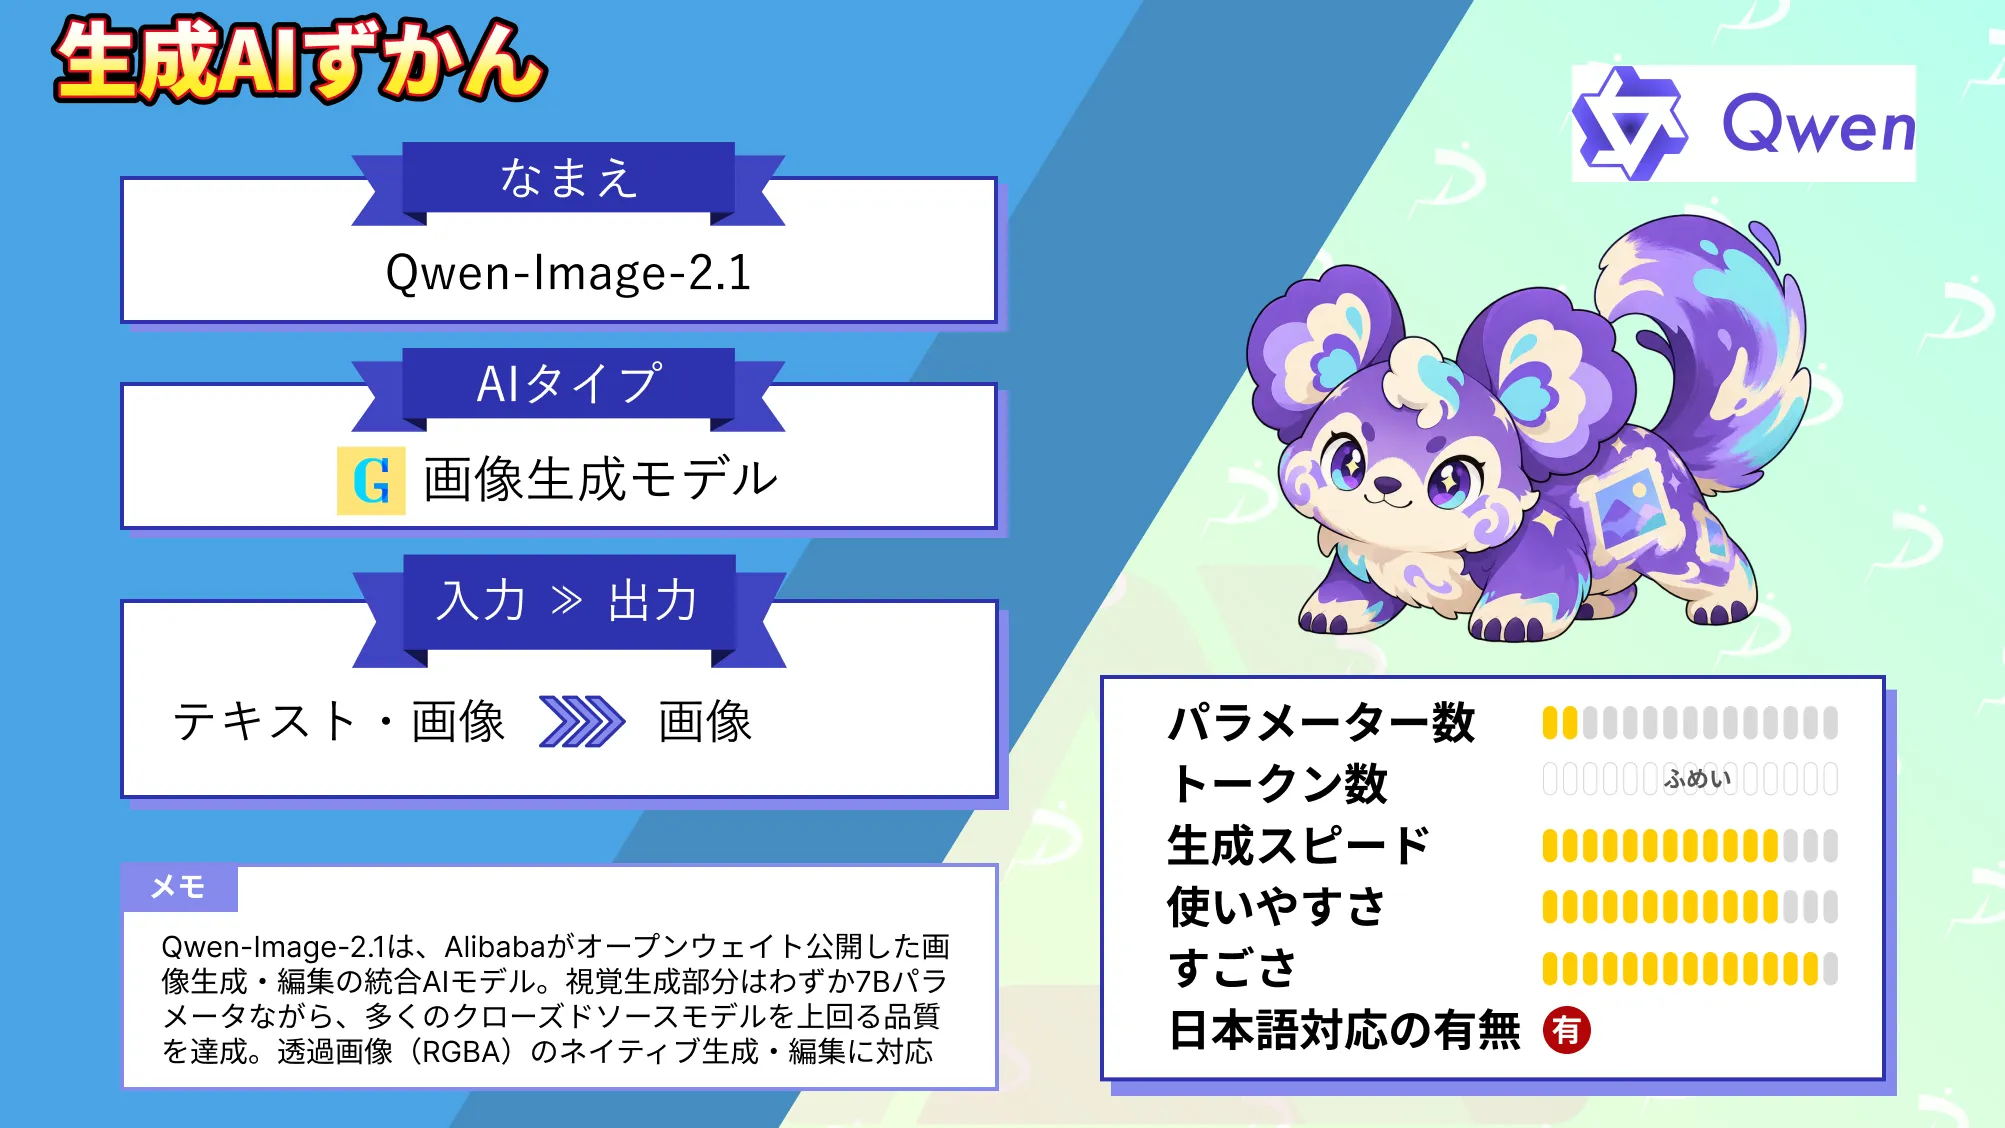
- Qwen-Image-2.1は、Alibabaが2026年9月20日にオープンウェイト公開した画像生成・編集の統合AIモデル
- 視覚生成部分はわずか7Bパラメータながら、多くのクローズドソースモデルを上回る品質を達成
- 透過画像(RGBA)のネイティブ生成・編集に対応し、最大10枚の参照画像を一度に処理できる
2026年9月20日、Alibabaの生成AIチーム「Qwen」が、画像生成AI「Qwen-Image-2.1」をオープンウェイトとして公開しました!
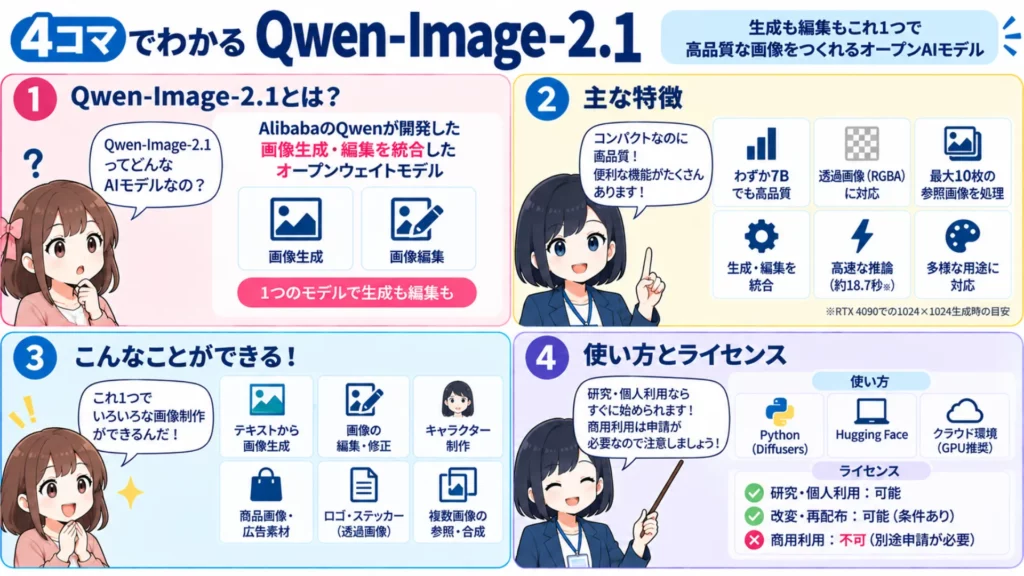
Qwen-Imageシリーズの最新モデルとなるこのモデルは、画像の「生成」と「編集」を1つのアーキテクチャに統合したことが最大の注目ポイントです。視覚生成コンポーネントのパラメータ数はわずか7Bに抑えられているにもかかわらず、多くのクローズドソースモデルを上回る性能を実現しています。
「でも、どうやって使うの?」「ライセンスはどうなっている?」と気になっている方も多いのではないでしょうか。そこでこの記事では、Qwen-Image-2.1の概要から仕組み、性能、料金、使い方、活用シーンまでを徹底解説します。ぜひ最後までご覧ください!
\生成AIを活用して業務プロセスを自動化/
Qwen-Image-2.1とは?
Qwen-Image-2.1は、Alibaba(アリババ)のAI研究チーム「Qwen」が開発した画像生成・画像編集を統合的に行える次世代のオープンウェイトモデルです。
前身モデルであるQwen-Image(2025年8月公開、20Bパラメータ)から大幅にアーキテクチャが刷新されていて、視覚生成コンポーネントのパラメータ数を7Bまで圧縮しつつ品質を向上させた点が特徴的です。テキストエンコーダ部分を含めた総パラメータ数は約16.22B(ModelScope表記)で、ファイルサイズは合計約33GBとなっています。
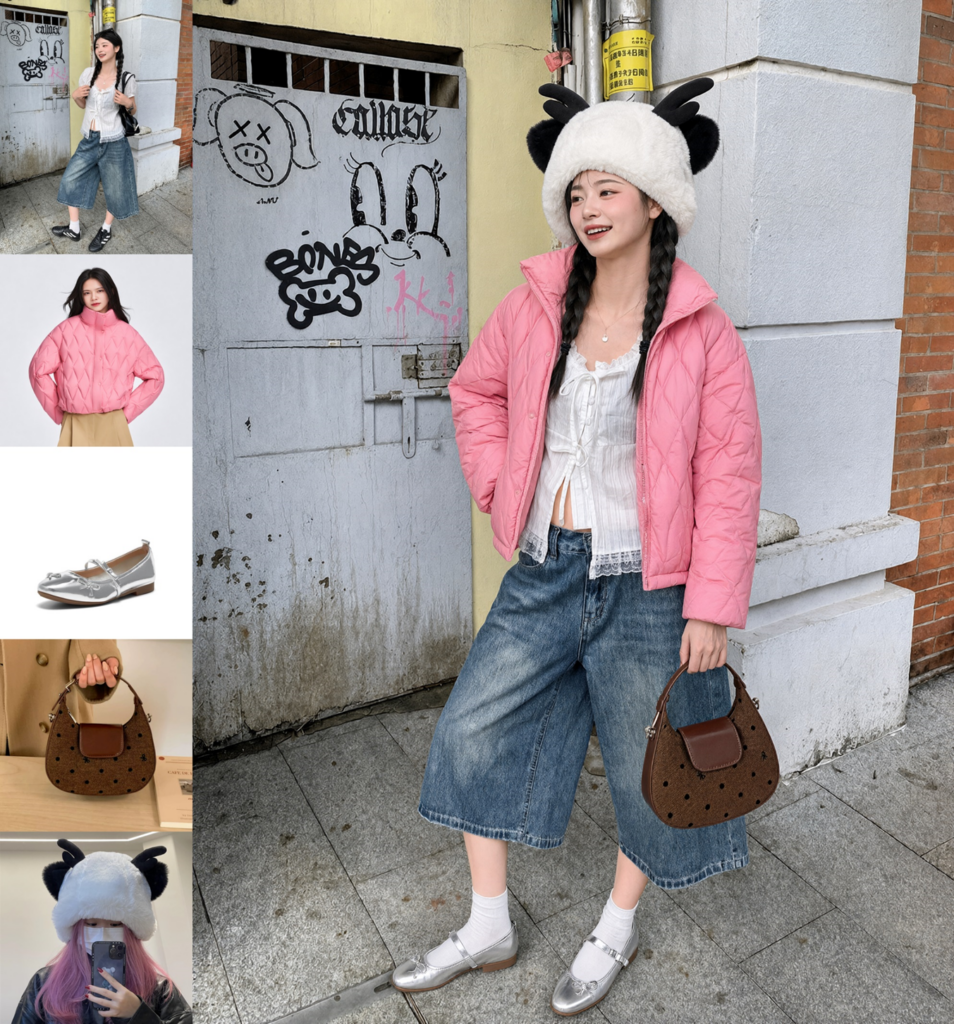
このモデルがユニークなのは、「テキストから画像を生成する」機能と「既存の画像を編集する」機能を1つのチェックポイントで切り替えなしに実行できる点です。従来の画像生成AIでは、生成と編集は別々のモデルとして提供されることが一般的でしたが、Qwen-Image-2.1では統合パイプラインにより、1つのモデルでシームレスに両方のタスクをこなせます。
Qwen-Image-2.1の仕組み
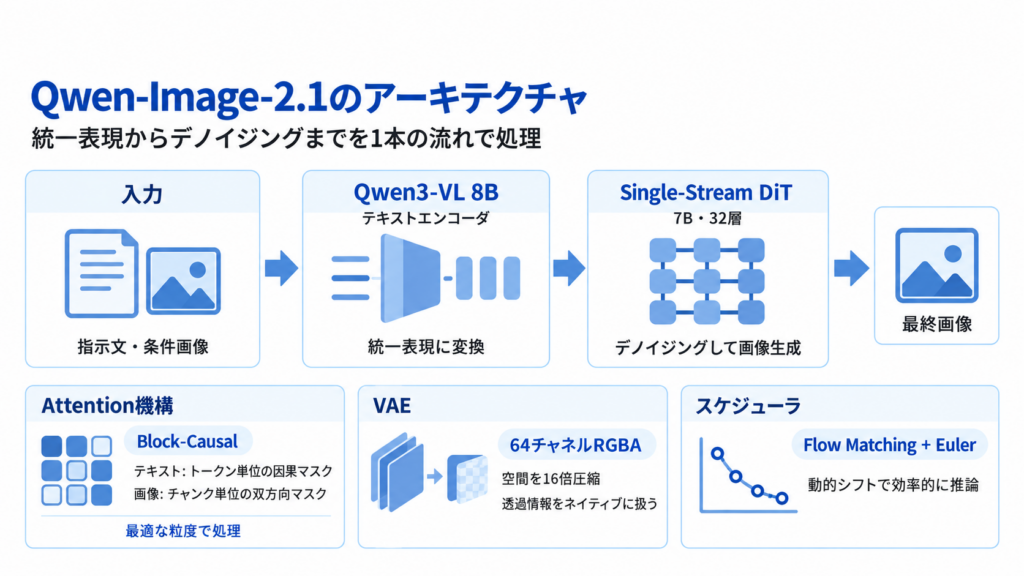
Qwen-Image-2.1は、テキストエンコーダとDiffusion Transformerの2つのコンポーネントを統合したシングルストリーム型アーキテクチャを採用しています。
具体的には、まずテキストエンコーダにQwen3-VL 8B(ビジョン・ランゲージモデル)が搭載されていて、テキストの指示文と条件画像(参照画像)を統一的な表現に変換します。続いて、視覚生成部となる7B・32層のSingle-Stream DiT(Diffusion Transformer)が、そのエンコード結果を受け取って画像のデノイジングを行い、最終的な画像を生成する流れです。
Attention機構にはBlock-Causalアテンションと呼ばれる混合粒度の仕組みが採用されていて、テキストトークンにはトークンレベルの因果的マスクを、画像にはチャンクレベルの双方向マスクを適用します。この設計によって、テキストと画像それぞれに最適な粒度で情報を処理できるようになっています。
Qwen-Image-2.1の特徴
Qwen-Image-2.1の性能面で注目すべきポイントが複数あります。
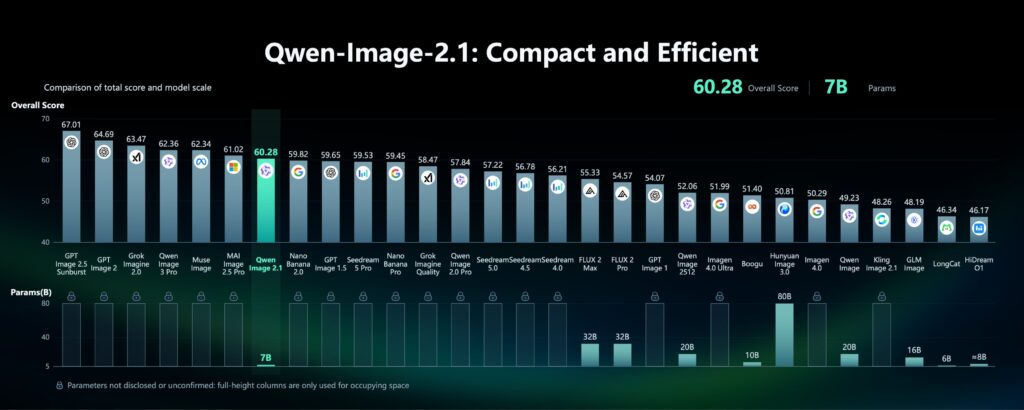
まず性能面では、Qwen-Image-BenchにおいてQwen-Image-2.1はスコア60.28を記録しています。
これは、パラメータ数32BのFLUX 2 Max(55.33)や、GPT Image 1(54.07)を上回る結果です。首位のGPT Image 2.5 Sunburst(67.01)には届かないものの、7Bという軽量なアーキテクチャでこのスコアを達成している点は驚異的といえるでしょう。
次に推論速度について、SGLang-Diffusionのベンチマークでは、RTX 4090 1枚で1024×1024の画像を約18.7秒で生成できることが報告されています。画像編集の場合でも約21.7秒で完了し、ピークGPUメモリ使用量は22.7GiBに収まっています。
Qwen-Image-2.1の安全性・制約
Qwen-Image-2.1の安全性や利用上の制約について確認しておきましょう。
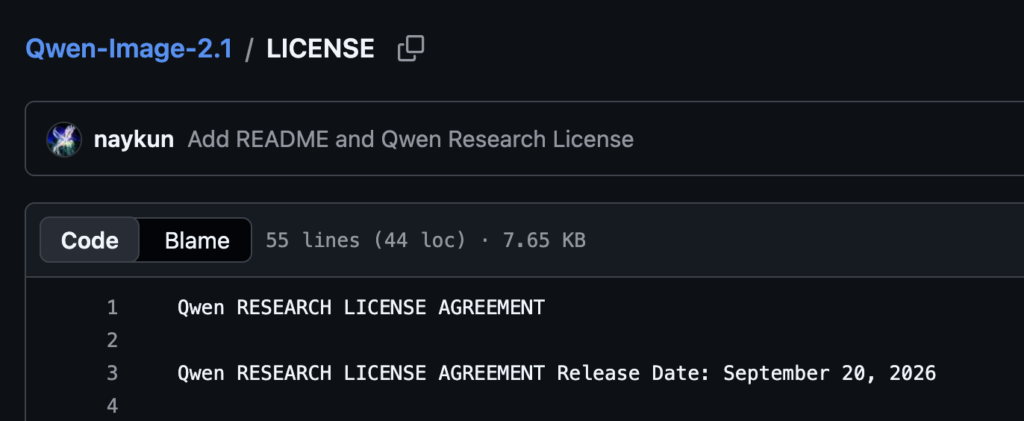
まず、このモデルはQwen Research License Agreementのもとで公開されています。これは「非商用目的のみ」の利用を許可するライセンスであり、商用利用には別途Qwenチームへの申請が必要です。商用利用を検討している方は、事前にライセンスの確認と手続きを行う必要がある点に注意してください。
また、モデルの重みは約33GBと比較的大きなサイズであるため、動作にはNVIDIA RTX 3090以上のGPUが推奨されます。CPUオフロード機能(pipe.enable_model_cpu_offload())も用意されていますが、あくまで限定的なメモリ環境向けの回避策であり、本格的な運用にはGPUリソースの確保が不可欠です。
Qwen-Image-2.1の料金
Qwen-Image-2.1の利用料金について整理します。前提として、このモデルはオープンウェイトとして公開されているため、自前のGPU環境でローカル実行する場合は、APIの従量課金は発生しません。
ただし2026年9月21日時点では、Qwen-Image-2.1専用のホスティングAPIエンドポイントは公式に提供されていません。APIを通じた画像生成サービスとしてはまだ正式に展開されていない状況です。参考として、同シリーズの既存モデルに対するAlibaba Cloud Model Studio(旧DashScope)の料金を記載します。
| モデル名 | 出力解像度 | 出力単価(1枚あたり) | 無料枠 |
|---|---|---|---|
| qwen-image-3.0-pro | 2K | $0.075 | 10枚 |
| qwen-image-3.0 | 2K | $0.03 | 10枚 |
| qwen-image-2.0-pro | – | $0.075 | 100枚 |
| qwen-image-2.0 | – | $0.035 | 100枚 |
Qwen-Image-2.1のライセンス
Qwen-Image-2.1のライセンスについて詳しく確認しておきましょう。このモデルは、Qwen Research License Agreement(2026年9月20日付)のもとで公開されています。
| 利用用途 | 可否 | 備考 |
|---|---|---|
| 商用利用 | ❌ | 別途Qwenチームへのライセンス申請が必要 |
| 改変 | ⭕️ | 研究目的の範囲内で可 |
| 再配布 | ⭕️ | ライセンス条件を維持する必要あり |
| 特許利用 | – | |
| 私的利用 | ⭕️ |
Qwen-Image-2.1の使い方
Qwen-Image-2.1は複数の方法で利用できます。今回は代表的な使い方をステップバイステップで紹介します。
Diffusers(Python)で画像を生成する
もっとも手軽に始められる方法です。HuggingFace Diffusersライブラリを使ってPythonから直接画像を生成できます。
環境をセットアップ
Python 3.9以上の環境に、必要なライブラリをインストールします。
pip install torch>=2.4.0
pip install transformers>=5.17
pip install git+https://github.com/huggingface/diffusers
pip install accelerate
pip install pillow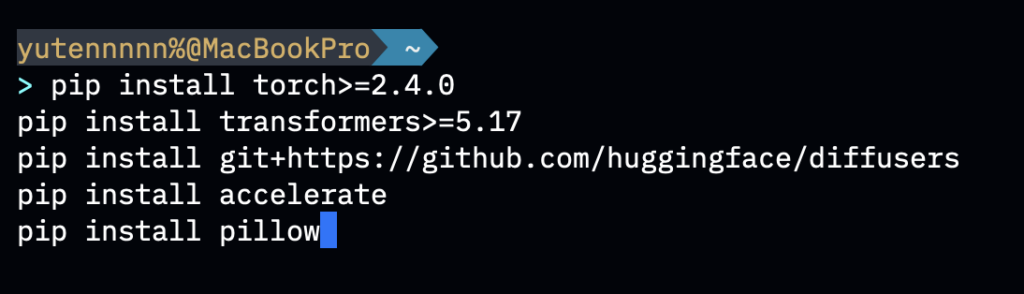
テキストから画像を生成(Text-to-Image)
import torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt="A neon shop sign that reads \"QWEN IMAGE 2.1\", rainy night, reflections on wet pavement",
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

image.save("t2i_example.png")参照画像を使って編集(Image Editing)
from PIL import Image

input_image = Image.open("input.png")

image = pipe(
    prompt="Change the background to a sunset beach",
    image=input_image,
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

image.save("edit_example.png")透過画像(RGBA)を生成する
透過画像を生成するには、プロンプトに透過を指示するフレーズを含めます。
image = pipe(
    prompt="This is an RGBA image with transparency. A cute cartoon dragon sticker. The image has alpha channel and the background is transparent.",
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

image.save("transparent_example.png")GPUメモリが不足する場合は、pipe.enable_model_cpu_offload() を呼び出すことで一部の計算をCPUに退避させることも可能です。
ComfyUIで利用する
ノードベースのワークフローが好みの方には、ComfyUIがDay 0でサポートされています。
ComfyUIアップデート
ComfyUIを最新版にアップデートしましょう。
画像生成を実行
公式が提供しているワークフローテンプレート(テキストから画像生成用 / 画像編集用)を読み込んで実行しましょう。
SGLang-Diffusionで高速推論する
大量の画像を効率的に生成したい場合は、SGLang-Diffusionの利用が適しています。コマンド1行で画像を生成できます。
sglang generate \
  --model-path Qwen/Qwen-Image-2.1 \
  --prompt "A capybara reading a book by candlelight" \
  --height 1024 --width 1024 \
  --num-inference-steps 40 --guidance-scale 1 \
  --seed 42 --save-output
画像編集の場合は --image-path input.png を追加するだけで対応できます。
【業界別】Qwen-Image-2.1の活用シーン
Qwen-Image-2.1の機能を活かせる業界ごとの活用シーンを紹介します。画像生成・編集を1つのモデルで統合的に扱えるメリットは、さまざまな業務領域にインパクトを与える可能性を秘めています。
EC・ファッション業界
Qwen-Image-2.1のマルチリファレンス編集機能は、バーチャル試着やコーディネート画像の自動生成に適しています。モデル写真・衣服・靴・アクセサリーなど最大10枚の参照画像を組み合わせることで、商品の着用イメージを効率的に量産できるでしょう。RGBA透過画像の生成にも対応しているため、商品画像の背景切り抜き作業も不要になります。
小売業における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
デザイン・クリエイティブ業界
ステッカーやロゴの制作では透過画像のネイティブ生成が威力を発揮しますし、パノラマ画像やインフォグラフィックの生成もサポートされています。キャラクターの三面図から一貫性のあるストーリーボードを自動生成する機能は、漫画やアニメーションの制作現場で特に注目されるでしょう。
生成AIでクリエイティブ作成する方法について、詳しく知りたい方は以下の記事も参考にしてみてください。

広告・マーケティング業界
人物写真の忠実度が高い点を活かして、一貫したキャラクターが登場する広告シリーズの制作に活用できます。テキストレンダリング精度も向上しているため、ポスターや看板の文字入り画像を直接生成する用途でも精度の高い結果が期待できるでしょう。
広告業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
【課題別】Qwen-Image-2.1が解決できること
続いて、Qwen-Image-2.1が解決できる具体的な課題を整理します。これまで画像生成AIを使う上で壁となっていた問題の多くに、このモデルはアプローチしています。
透過画像の後処理作業をなくす
従来の画像生成AIでは、生成された画像から背景を除去するために別途ツールを使う必要がありました。Qwen-Image-2.1はRGBA透過画像をネイティブで出力できるため、背景切り抜きの後処理工程を丸ごとスキップできます。
複数素材を組み合わせた画像を一発で作る
これまでは複数の素材を合成するためにPhotoshopなどのツールで手作業が必要でしたが、最大10枚の参照画像を一度に入力してテキストで指示するだけで合成画像を生成できます。集合写真の合成やファッションコーディネートの可視化が大幅に効率化されるはずです。
キャラクターの一貫性を保ったまま複数シーンを生成
キャラクターの三面図(正面・側面・背面)を参照画像として渡すことで、同一キャラクターが異なるシーンに登場するストーリーボードを自動生成できます。手動でキャラクターの整合性を保つ煩わしさから解放されるでしょう。
Qwen-Image-2.1を使ってみた
それでは実際にQwen-Image-2.1を試してみましょう。今回は一般的なPCでも試せるよう、ModelScope CIVISIONのオンライン画像生成ページを使って検証を行いました。ブラウザさえあれば誰でもすぐに体験できます。
検証1:ModelScope CIVISIONでテキスト入り画像を生成してみた
以下の手順で、GPUなしのPCからでもQwen-Image-2.1の画像生成を試すことができます。
デモページへアクセス
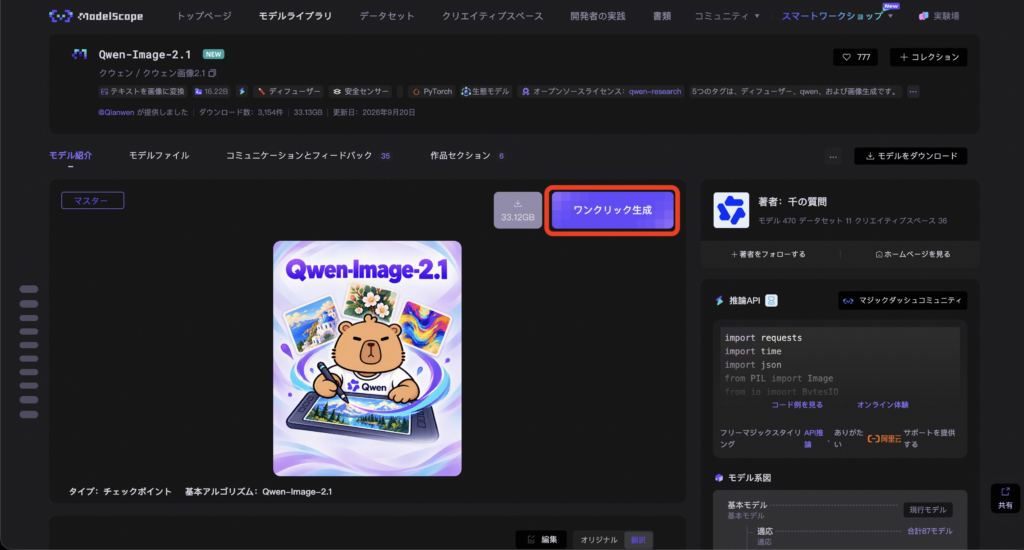
ブラウザでModelScopeのQwen-Image-2.1ページへアクセスし、「ワンクリック生成」ボタンからCIVISIONの画像生成ページに遷移します。アカウント登録(無料)が必要です。
モデル選択
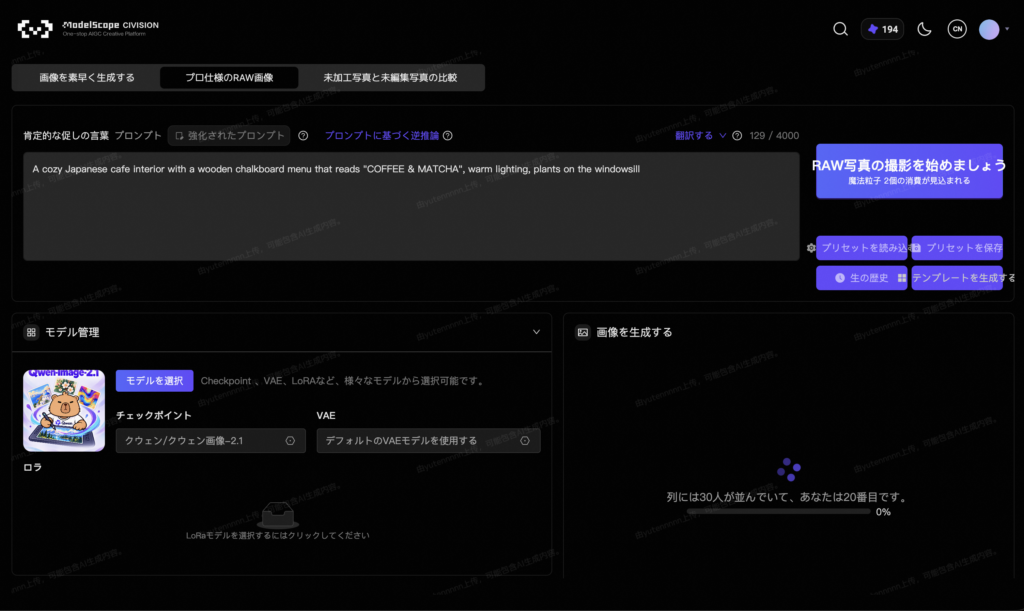
画面左下の「モデル管理」セクションで、チェックポイントが「クウェン/クウェン画像-2.1」(Qwen/Qwen-Image-2.1)になっていることを確認します。
プロンプト送信
画面上部のプロンプト入力欄に、生成したい画像の説明を入力します。今回は、テキストレンダリング性能の確認も兼ねて以下のプロンプトを使用しました。
プロンプトはこちら
A cozy Japanese cafe interior with a wooden chalkboard menu that reads "COFFEE & MATCHA", warm lighting, plants on the windowsill出力結果はこちら
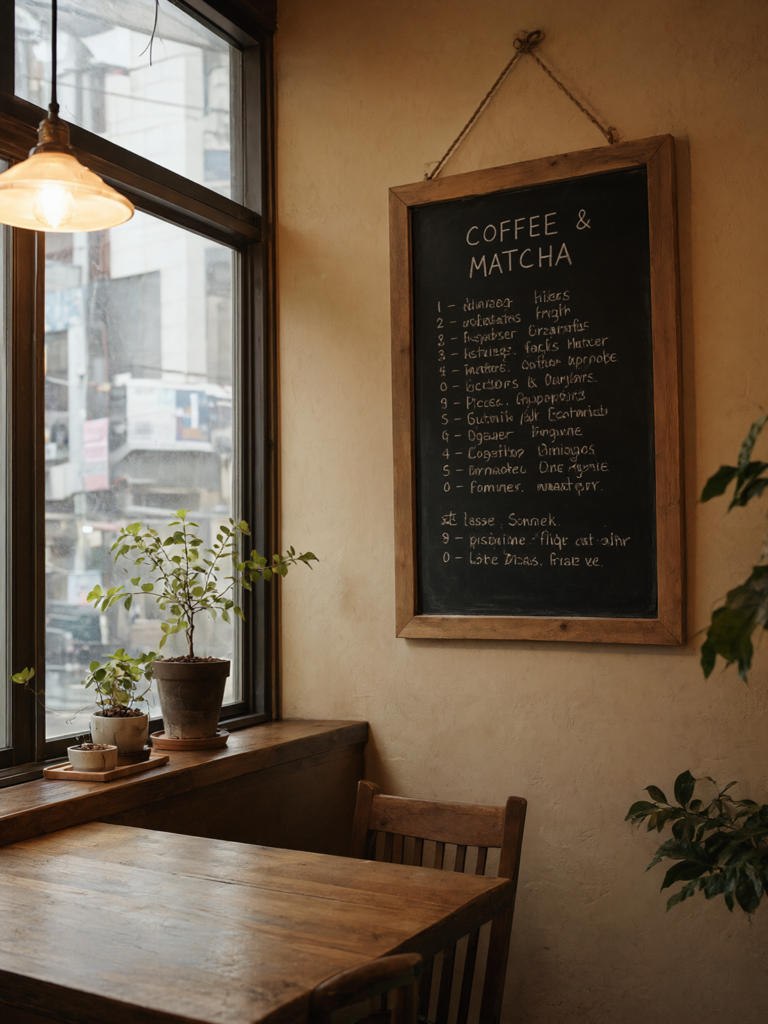
生成結果を見ると、温かみのある照明に照らされた木目調のカフェインテリアが写実的に描かれています。窓辺の観葉植物や木製テーブルの質感も自然です。注目のテキストレンダリングについては、黒板上部の「COFFEE & MATCHA」の見出し部分はくっきりと正確に描画されていました。
一方で、その下に並ぶメニュー項目の細かい文字は判読不能な架空のテキストになっていて、指示していない部分のテキストまでは精度が及ばないようです。とはいえ、メインのタイトルテキストが崩れないのは画像生成AIとしては高い水準といえるでしょう。
検証2:日本語テキスト入りの居酒屋画像を生成
続いて、Qwen-Imageシリーズが強みとしている日本語テキストのレンダリング精度を検証してみます。以下のプロンプトで、赤提灯に「居酒屋」、木製看板に「本日のおすすめ」と書かれた画像の生成を指示しました。
プロンプトはこちら
A stylish Japanese izakaya entrance at night with a red paper lantern that reads "居酒屋" and a wooden sign that reads "本日のおすすめ", warm golden light spilling onto the narrow alley, photorealistic出力結果はこちら
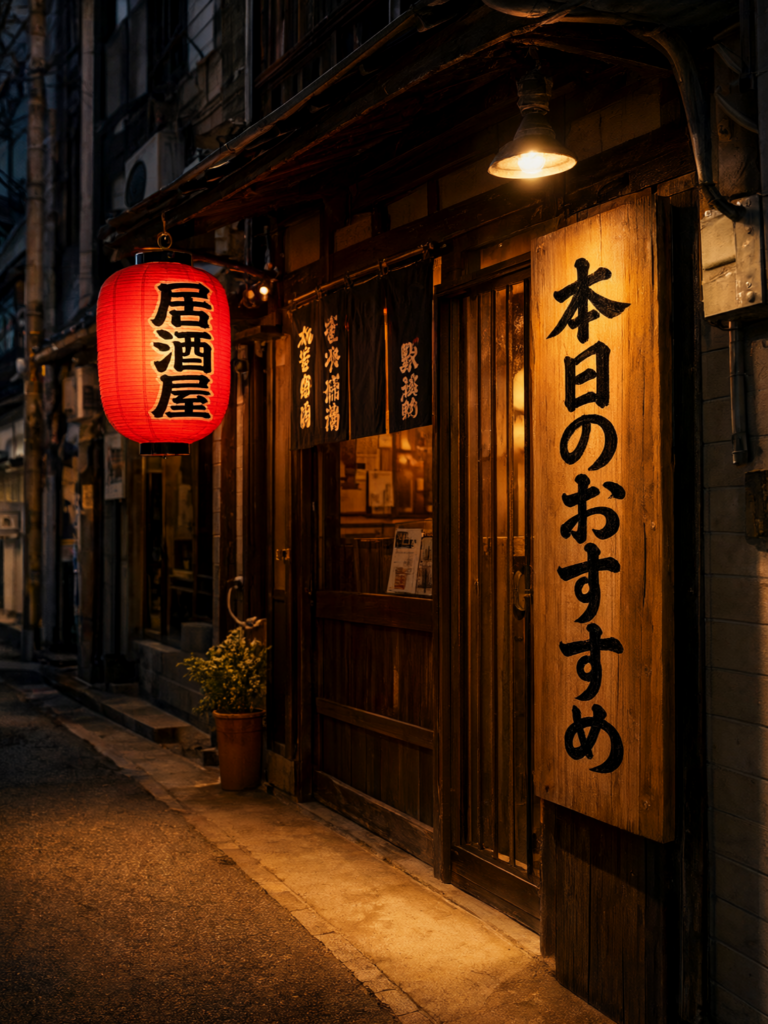
赤提灯に書かれた「居酒屋」の3文字は一画も崩れることなく完璧に描画されていて、木製看板の「本日のおすすめ」も全文字が正確に読み取れる品質でした。
検証1では英語のメニュー詳細が架空テキストになっていたのに対し、日本語のテキストレンダリングは指示どおりの文字が高い精度で再現されています。
Qwen-Image-2.1など生成AIのご相談はWEELへ
Qwen-Image-2.1は、7Bパラメータという軽量さでありながらクローズドソースモデルに匹敵する品質を実現した、注目すべきオープンウェイトの画像生成・編集モデルです。RGBA透過画像のネイティブ生成、最大10枚の参照画像に基づく高品質な編集、ローカル編集の柔軟性など、実務レベルの課題に直結する機能を数多く備えています。
商用利用には別途ライセンスが必要という制約はあるものの、研究・評価目的であれば今すぐ試せる環境が整っています。Diffusers・ComfyUI・vLLM・SGLangといった主要な推論フレームワークがDay 0でサポートしている点も、すぐに導入を検討できる大きなメリットでしょう。
弊社では、AI導入を検討中の企業向けに、業務効率化や新しい価値創出を支援する情報提供・導入支援を行っています。最新のAIを活用し、効率的な業務改善や高度な分析が可能です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
よくある質問