RAGとは?図解付きでわかりやすい!仕組みやメリット・注意点・導入事例を徹底解説
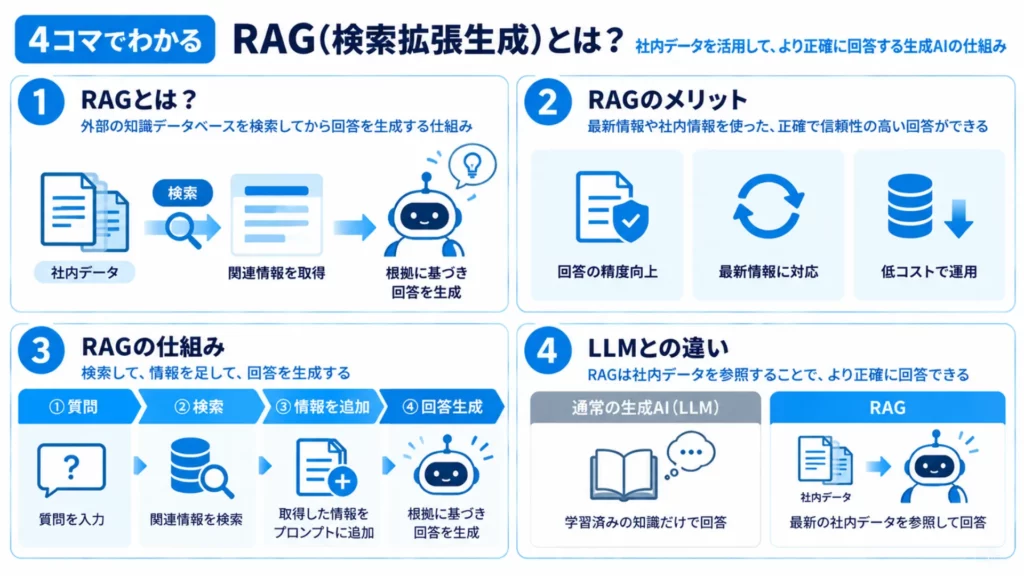
- RAGは、外部の知識データベースを検索してから回答を生成する、検索拡張生成という生成AIの仕組み
- モデルの再学習が不要なため、ファインチューニングよりも低コスト・短期間で知識を更新できる
- ハルシネーションの抑制や最新情報への対応に強く、企業から自治体まで幅広い組織が業務効率化に活用している
多くの企業が業務効率化のために生成AIを導入していますが、一般的な情報だけでは自社特有の業務や規則に対応できない場合が多くあります。
そこで注目されているのが、自社データを生成AIに追加するRAG(Retrieval-Augmented Generation)という手法です。RAGは、外部の知識ベースから情報を検索し、それをもとにAIが回答を生成する技術です。この技術により、回答の精度と信頼性が向上し、企業の特定のニーズに対応した情報提供が可能になります。
本記事では、RAGの仕組みや構築方法をわかりやすく整理しながら、LLMやファインチューニングとの違い、導入のメリットと注意点、実際の企業・自治体の事例、そして実際にDifyでRAGを構築して検証した結果までまとめて解説します。「RAGがよいと聞いたけど、結局どういう技術で、どう作るの?」という方に向けた内容です。ぜひ最後までご覧ください!
\生成AIを活用して業務プロセスを自動化/
RAGとは

RAG(検索拡張生成)は、生成AIの回答精度を向上させる技術です。
通常の生成AIは事前に学習したデータをもとに回答を生成します。しかし、RAGを使用すると質問に応じて外部データベースから関連情報を検索し、それをもとに回答を生成します。
外部データベースからの検索により、最新の情報や特定の分野の専門知識を含んだ、より正確で適切な回答が可能になります。RAGは、生成AIの回答精度を向上させ、ハルシネーション(誤った情報の生成)を減少させる効果があります。
RAGとLLMの違い
大規模言語モデルは、事前に学習した知識だけをもとに回答する、生成AIの「頭脳」にあたる部分です。一方RAGは、そのLLMに外部データベースを検索する仕組みを組み合わせたものです。
LLM単体では学習時点より新しい情報や社内固有の情報には答えられず、ハルシネーションも起きやすくなります。RAGなら検索した根拠に基づいて回答するため、最新性と正確性が高まります。
RAGとLLMの違いをさらに詳しく知りたい方は、下記の記事も併せてご確認ください。
RAGとファインチューニングの違い
RAGとファインチューニングは、どちらも生成AIを自社向けに最適化する方法ですが、アプローチが異なります。
RAGは、モデル自体は変えずに、外部の知識データベースを「検索して参照」させる方法です。知識の追加・更新がデータベースの入れ替えだけで済むため、最新情報への対応が早く、低コストで、回答の根拠も示すことができます。
一方ファインチューニングは、モデルの重みを「追加学習で更新」する方法です。特定の口調や出力フォーマット、専門タスクへの最適化に向いていますが、知識を更新するたびに再学習が必要で、コストや専門知識のハードルが高くなります。
RAGを導入するべき理由
生成AIをそのまま使うだけでは、自社の業務にうまく当てはまらない場面が多くあります。RAGを導入するべき理由は、主に次の4つです。
| 理由 | 詳細 |
|---|---|
| ハルシネーションを抑えられる | 検索した根拠に基づいて回答するため、誤った情報の生成を減らせる |
| 最新情報や社内情報に対応できる | モデルを再学習しなくても、データベースを更新するだけで回答内容を最新化できる |
| 低コストで導入・運用できる | ファインチューニングのような大規模な追加学習が不要で、コストと手間を抑えられる |
| 回答の根拠を示せる | 参照した社内文書を提示できるため、回答の信頼性と検証のしやすさが高まる |
RAGの仕組み

RAGは「Retrieval(検索)」「Augmented(拡張)」「Generation(生成)」の頭文字をとった言葉で、その名のとおり検索して、情報を足して、回答を生成する仕組みです。大きく次の4ステップで動きます。
| ステップ | 内容 |
|---|---|
| 1.質問を受け取る | ユーザーが入力した質問を受け取る |
| 2.関連情報を検索する(Retrieval) | 質問を数値(ベクトル)に変換し、社内文書などをためた知識データベース(ベクトルDB)から、内容が近い情報を探し出す |
| 3.情報を付け足す(Augmented) | 検索で見つかった関連情報を、元の質問とまとめて生成AIへの指示(プロンプト)に追加する |
| 4.回答を生成する(Generation) | 関連情報を踏まえて、生成AI(LLM)が根拠に基づいた回答を作成する |

生成AIに自社データを追加したRAGを導入するメリット

RAGを使って自社データを生成AIに組み込むと、多くのメリットがあります。
例えば、AIの回答精度が向上し、最新の社内情報を反映できるようになります。また、自社特有の知識を活用でき、セキュリティーも向上します。その結果、業務効率が大幅に改善されます。以下では、これらの主要なメリットについて詳しく説明します。
生成内容のコントロール
自社データを生成AIに追加すると、生成する回答やコンテンツの内容をより正確に調整できるようになります。
例えば、社内規定や業務マニュアルの情報を組み込むことで、それらに準拠した回答を得られます。よって、一般的な生成AIでは困難だった自社特有の文脈や規則に沿った回答が可能になります。
結果として、企業の特殊なニーズに合わせたAIの活用が実現し、業務効率の向上や意思決定の質の改善につながります。さらに、機密情報の取り扱いにも配慮した運用ができるため、セキュリティー面でも有利となるのです。
応用範囲の拡大
RAGの導入により、生成AIの応用範囲が大幅に拡大します。
顧客対応や社内問い合わせへの自動回答、社内文書の作成支援など、従来人間が担当していた業務の多くを自動化できる可能性が高まるでしょう。また、自社の製品情報や技術資料を追加することで、より専門的な質問にも対応可能になります。
さらに、業務効率の向上やコスト削減が期待できます。RAGを活用することで、企業独自の知識や最新情報を反映した、より正確で信頼性の高い回答を生成できるようになるのです。
業務時間の短縮
自社データを活用した生成AIを導入すると、情報検索や資料作成の時間を大幅に短縮できます。
例えば、社内規定や過去の事例を瞬時に検索し、適切な回答の生成が可能です。このおかげで、従業員は本来の業務により多くの時間を割けるようになります。
その結果、業務効率の向上と生産性の増加が期待できます。さらに、生成AIは最新の情報や専門知識を活用するため、回答の精度が高まり、企業の競争力も強化されます。
費用対効果の高さ
RAGは、ファインチューニングのような大規模な追加学習が不要なため、少ない初期投資で導入効果を得やすい点も大きな特徴です。
例えば、ナレッジベースとなる文書を用意し検索の仕組みを構築するだけで運用を開始でき、モデル自体を作り直す必要がないため、開発・運用にかかる工数と費用を抑えられます。
その結果、限られた予算でも生成AIの業務活用を始めやすくなり、投資対効果を確認しながら段階的に対象範囲を広げていくことも可能になります。
RAGの構築方法

RAGの構築は、次の5ステップで進めるのが基本です。専門的な開発が必要な部分もありますが、全体像をつかんでおくと導入の検討がしやすくなります。ここからはステップごとに構築方法をご紹介します。
ナレッジ(社内データ)を準備する
マニュアルやFAQ、議事録など、参照させたい社内文書を集めます。誤字や重複を整理し、テキスト形式に整えておくことが精度向上の第一歩です。
文書を分割する(チャンク化)
長い文書をそのまま使うと検索精度が下がるため、適切な長さのチャンクに分割します。分割の単位は検索精度に大きく影響します。
RAGのチャンク化については下記で詳しく解説

ベクトル化してデータベースに格納する
分割した文書を、埋め込み(Embedding)モデルで数値(ベクトル)に変換し、ベクトルDBに保存します。
検索の仕組みをつくる(Retriever)
質問が来たら関連する文書を探し出す検索部分を構築します。キーワード検索とベクトル検索を組み合わせた「ハイブリッド検索」や、検索結果を並べ替える「リランキング」を使うと精度が高まります。
生成AIと連携して回答を作る
検索結果をプロンプトに追加し、生成AIに回答を作らせます。最後に回答精度を評価し、チャンクの大きさや検索件数を調整して改善していきます。
なお、ゼロから開発しなくても、LangChainやLlamaIndexなどのフレームワーク、Difyのようなノーコードツール、Amazon BedrockのナレッジベースやMicrosoftのAzure AI SearchといったクラウドのRAG構築サービスを使えば、より手軽に構築することもできます。
また、Azure AI FoundryやGoogle Vertex AI Agent Builderのように、RAGパイプラインをAPIから直接呼び出せるマネージド型オーケストレーションサービスの普及も進んでおり、既存システムへの組み込みをさらに簡略化できます。
RAGの評価方法は下記で解説

詳しいRAGの構築方法については下記でも解説しています
【実践検証】RAGを実際に構築してみた
本記事では、無料で試せるRAG構築ツール「Dify」を使って、実際に簡易版RAGを構築して検証しました。
ナレッジベースには、リモートワーク手当や経費精算の上限などをまとめた社内規定風のテキストを使用し、同じ質問に対して「RAG未使用時の回答」と「RAG使用時の回答」を比較しています。
検証の手順
手順はシンプルです。まずDifyでチャットボットアプリを作成し、社内規定のテキストファイルをナレッジ(ナレッジベース)としてアップロードします。
アップロードしたテキストは自動でチャンク分割・ベクトル化され、次に作成したナレッジをアプリのコンテキストに追加するだけで、回答時の参照先として設定できました。
最後に、同じ質問をナレッジ未接続の状態と接続した状態の両方で投げ、回答内容を比較しました。
検証結果:RAG未使用 vs RAG使用
検証に使った質問は「リモートワーク手当はいくらもらえますか?条件も教えてください。」です。
RAG未使用時は、「現在参照できる社内規程・資料の中にリモートワーク手当の金額や支給条件に関する情報がありません」と回答され、就業規則や人事部門への確認を案内されるのみで、具体的な数字は一切得られませんでした。
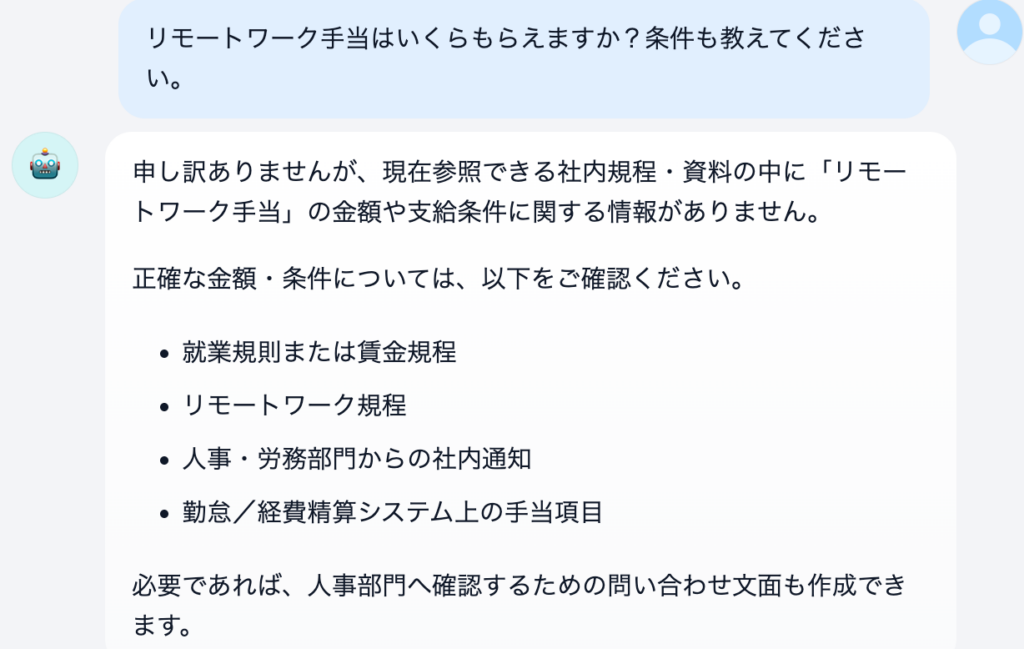
一方RAG使用時は、社内規定のナレッジを参照し、「リモートワーク手当は月額7,800円、条件は月間所定労働日数の6割以上の在宅勤務、申請は毎月20日締め・翌月10日払い」と、具体的な数値と条件を過不足なく回答しました。
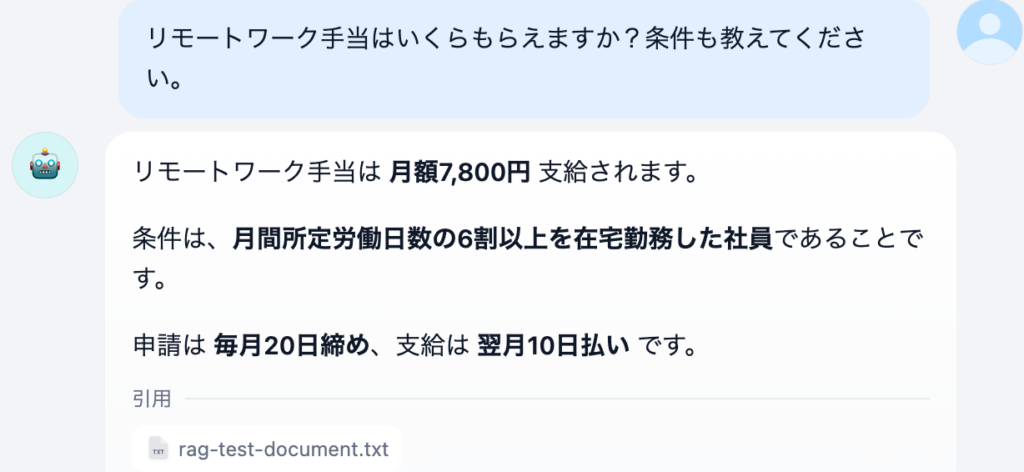
同じ質問でも、参照できる知識があるかどうかで回答の具体性がここまで変わることを、実際に体感できました。
ハルシネーション抑制も確認できた
書籍・研修費の経費精算の上限を尋ねると、RAG使用時は「年間で1人あたり54,000円まで。上限を超える申請は原則対象外だが、部門長の事前承認があれば例外的に認められる」と、例外規定まで含めて正確に回答しました。
さらに、ナレッジに記載のない「出張旅費の日当」についてもあえて質問してみたところ、それらしい数字を作り出すことなく「わかりません。手元の情報では確認できません」と回答し、経理部門への確認を案内しました。
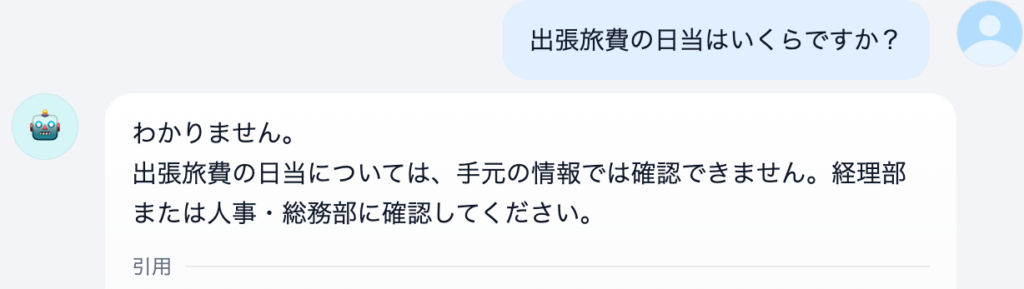
ナレッジにない情報をもっともらしく捏造しなかった点は、RAGを実業務で使ううえで安心材料になります。
うまくいかなかった点:ナレッジの設定漏れと応答速度
検証中、つまずいた点もありました。
Difyでアプリを作成した直後は、ナレッジベースを作成しただけで満足してしまい、肝心のコンテキストへの追加を忘れていたため、最初は通常のAIチャットと変わらない回答しか返ってきませんでした。
ナレッジを作成しても、アプリ側で明示的に参照先として設定しない限りRAGは機能しない、という当たり前だが見落としがちな点を身をもって体験しました。
また、RAGを使った場合は社内規定を検索してから回答を生成するぶん、通常の回答より応答時間が延びる傾向がありました(実測でRAG未使用時は約3.7秒、RAG使用時は約7.9秒)。
精度と引き換えに応答速度がやや遅くなる点は、実務で導入する際に考慮すべきポイントだと感じました。
RAGの注目トレンド
RAGの基本的な仕組みは同じでも、回答精度を高めるための技術は年々進化しています。2025年から2026年にかけて、主流となりつつあるトレンドを押さえておきましょう。
ハイブリッド検索

キーワード検索(単語の一致)とベクトル検索(意味の近さ)を組み合わせる検索方法です。「ベクトル検索だけでは拾いきれない」という課題から普及が進み、検索の取りこぼしを減らせます。
リランキング
検索で集めた候補を、質問との関連性で並べ替え直す工程です。本当に関連性の高い情報を上位に持ってくることで、回答精度を大きく改善できます。ハイブリッド検索と組み合わせるのが一般的です。
エージェント型RAG(Agentic RAG)
AIエージェントが一度検索して終わりではなく、足りなければ追加で検索したり、検索の仕方を変えたりと、自律的に複数回の検索を行う方式です。複雑な質問への対応力が高まります。
GraphRAG(グラフRAG)

文書同士の関係性をナレッジグラフとして整理し、それを検索に活用する手法です。マイクロソフトが研究を進めているほか、国内でもパナソニック コネクトが、AIエージェントがナレッジグラフを参照して回答する技術を開発し、自然言語処理の国際学会ACL 2024で論文が採択されました。点在する情報を横断した、より深い回答が期待できます。※3
Multimodal RAG(マルチモーダルRAG)
テキストだけでなく、画像・音声・動画といった複数の形式のデータも検索対象に含める手法です。マニュアルの図解や会議の録音データなど、テキスト化しづらい情報も参照できるようになり、より幅広い業務での活用が期待されています。
生成AIに自社データを追加したRAGを導入する際の注意点

RAG(検索拡張生成)の導入には多くのメリットがありますが、同時に注意すべき点も存在します。以下では、RAGを導入する際に考慮すべき主な事項について説明します。
これらの点に注意を払うことで、より効果的なRAGシステムの構築が可能になるでしょう。また、将来起こりうる課題を事前に把握し、その解決方法を考えることができます。それでは、具体的な注意点を見ていきましょう。
実装が難しい
RAGの実装には高度な技術力と専門知識が求められます。
自社データを適切に処理し、生成AIと連携させるためには、データエンジニアリングやAI開発の経験が必要です。また、既存システムとの統合やユーザーインターフェースの設計も考慮する必要があります。
これにより、生成AIが自社特有の情報を活用し、より正確で信頼性の高い回答を提供できるようになります。その結果、業務効率の向上や生産性の増加が期待できます。
自社データの整合性や品質
RAGの精度は、追加する自社データの質に大きく左右されます。
データに誤りや矛盾があると、生成AIの出力も不正確になる可能性があります。そのため、データの整合性チェックや定期的な更新、品質管理のプロセスを確立することが重要です。また、データの形式や構造を統一し、効率的に検索できるよう整理することも必要です。
これらの取り組みにより、RAGシステムの信頼性と有効性が向上し、より正確で適切な回答を生成できるようになります。結果として、ユーザーエクスペリエンスの向上やビジネス価値の創出につながるのです。
セキュリティー対策
自社の機密情報や個人情報を含むデータを扱う場合、セキュリティー対策は極めて重要です。データの暗号化、アクセス制御、ログ管理などの対策を講じる必要があります。
また、生成AIの出力内容にも注意が必要でしょう。機密情報の漏えいを防ぐために、適切なフィルタリング機能の実装が求められます。
これらの対策を怠ると、情報漏えいのリスクが高まり、企業の信頼性や競争力に深刻な影響を与える可能性があります。そのため、RAGシステムの導入時には、セキュリティー専門家との連携や、最新のセキュリティー技術の導入を検討すべきです。
定期的なセキュリティー監査も重要な取り組みの一つです。こうしたさまざまな防御策により、安全なRAGシステムの運用が可能となります。
生成スピード低下の可能性
RAGシステムは、質問に応じてデータベースを検索するため、通常の生成AIより応答が遅くなる可能性があります。特に大量データや複雑な検索が必要な場合、この傾向が顕著になるでしょう。
そのため、パフォーマンスの最適化が重要です。具体的には、効率的なインデックス作成、クエリの最適化、キャッシュの活用などが考えられます。また、必要に応じてハードウェアの増強も検討すべきです。
これらの対策により、RAGシステムの応答速度を改善し、ユーザー体験を向上させることが可能となります。
RAGの活用シーン
RAGは業界や部門を問わず、さまざまな業務での活用が進んでいます。ここでは特定企業の導入事例ではなく、多くの企業に共通する代表的な活用シーンを3つ紹介します。
社内ヘルプデスク対応
就業規則や経費精算のルール、ITツールの操作方法など、社内には日々多くの問い合わせが寄せられます。RAGを使えば、社内規定やマニュアルをナレッジベースとして接続し、従業員からの質問に根拠のある正確な回答を自動で返せるようになります。
担当者への問い合わせ件数を減らせるだけでなく、従業員自身もいつでも必要な情報にたどり着けるため、業務のスピードアップにもつながります。
ChatGPTでヘルプデスクを効率化する方法は下記で解説

カスタマーサポート
FAQやマニュアル、過去の問い合わせ履歴をナレッジベースとして活用すれば、RAGは顧客からの質問に対しても製品情報に基づいた回答を生成できます。
オペレーターの一次対応をRAGが肩代わりすることで、問い合わせ対応の一次解決率を高めつつ、担当者はより複雑な相談対応に集中できるようになります。夜間・休日でも一定水準の回答を提供できる点も、サポート品質の底上げにつながります。
カスタマーサポートで生成AIをどう使うかは下記で解説

営業支援
商品カタログや提案資料、過去の商談記録などをナレッジベースに接続すれば、営業担当者は商談の合間に必要な情報をすぐに検索・要約できるようになります。
競合比較や過去の類似案件の提案内容をRAGに尋ねるだけで、根拠となる資料を踏まえた回答が得られるため、資料探しに費やす時間を減らし、提案の質とスピードの両方を高められます。
営業で生成AIをどう用いるかは下記で解説
生成AIに自社データを追加したRAGの導入事例
RAGを活用した生成AIの導入は、さまざまな業界で進んでいます。以下では、実際の導入事例を紹介します。RAGの具体的な応用方法やその効果について理解を深めることができるでしょう。
事例① デロイトトーマツ
デロイト トーマツ グループは、コンサルタント向けの社内対話型生成AIに、2023年10月からRAGの仕組みを導入しました。利用者がファイルをアップロードすると、その内容を要約したり、質問に回答したりできるシステムで、RAGによって社内のデータベースや外部データを検索しながら回答します。
これによって、膨大な資料の読み込みや調べ物にかかる時間を短縮し、コンサルタント業務の効率化につなげています。専門知識を扱う業務でも、根拠に基づいた回答を素早く得られる点が特徴です。※1
事例② コネヒト株式会社
コネヒト株式会社は、Slack上でChatGPTと会話できる社内環境に、自社のマニュアルやナレッジを参照するRAG機能を追加しました。これによって、「経費を精算するにはどんな手順が必要ですか?」といった社内独自の質問にも、社内文書に基づいて回答できるようになっています。
新入社員のオンボーディングや、社内制度に関する問い合わせの一次対応などでの活用が見込まれており、バックオフィス業務の負担軽減につながる取り組みとして注目されています。※2
事例③ 横須賀市(自治体)
神奈川県横須賀市は、生成AI活用を進めるコリニア株式会社と共同で、RAGを活用した生成AIツールの実証実験を行いました。対象としたのは、多くのマニュアルや規則を参照する必要がある「契約締結業務」です。
契約マニュアルや庁内の規則など、業務を規定する文書をRAGで検索・参照し、生成AIが回答する仕組みを構築しており、職員が大量の資料から目的の箇所を探す手間を減らし、業務負担の軽減を目指す取り組みとして注目されています。※5
事例④ 三井住友フィナンシャルグループ(金融)
三井住友フィナンシャルグループは2025年10月、社内向けAIアシスタント「SMBC-GAI」にRAGを活用した社内情報検索機能を搭載しました。社内規程や通達、業務マニュアルなど約130万件のファイルを対象に、横断的な検索・参照ができます。
同社はこれを「国内企業のRAG活用事例として、学習ファイルの量や使用人数において最大級の規模」としており、膨大な社内文書を活かした大規模なRAGの代表例といえます。※6
RAGの事例について詳しく知りたい方は、下記の記事をご確認ください。


生成AI開発・業務活用ならWEELへご相談ください
RAGは社内データを活かした生成AI活用の第一歩です。FAQ対応や社内検索、ナレッジ共有など、自社課題に合わせたRAG構築で業務効率化を具体化できます。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
よくある質問(FAQ)
RAGの構築に使える代表的なツールやサービスは?
開発フレームワークではLangChainやLlamaIndex、ノーコードで試せるDify、クラウドのマネージドサービスではAmazon BedrockのナレッジベースやMicrosoftのAzure AI Searchなどが代表的です。用途や社内のスキルに合わせて選びます。
RAG構築でおすすめなツール・サービスは下記で解説

ノーコードでもRAGは作れますか?
作れます。Difyやクラウドのマネージドサービスを使えば、コーディングなしでも小規模なRAGを構築できます。まずはPoC(試験導入)から始める企業が多いです。
RAGとAIエージェントは何が違いますか?
RAGは検索して根拠に基づき回答する仕組みです。AIエージェントは目的達成のために複数のツールを自律的に使い分ける仕組みで、その一部としてRAGを呼び出す「エージェント型RAG」も広がっています。
RAGの回答精度を上げるにはどうすればいいですか?
文書の分割(チャンク)設計を見直す、ハイブリッド検索やリランキングを取り入れる、メタデータで検索範囲を絞る、といった工夫が有効です。導入後も評価と改善を繰り返すことが大切です。