LLMベンチマークとは?主要な種類とスコアの読み方をわかりやすく解説
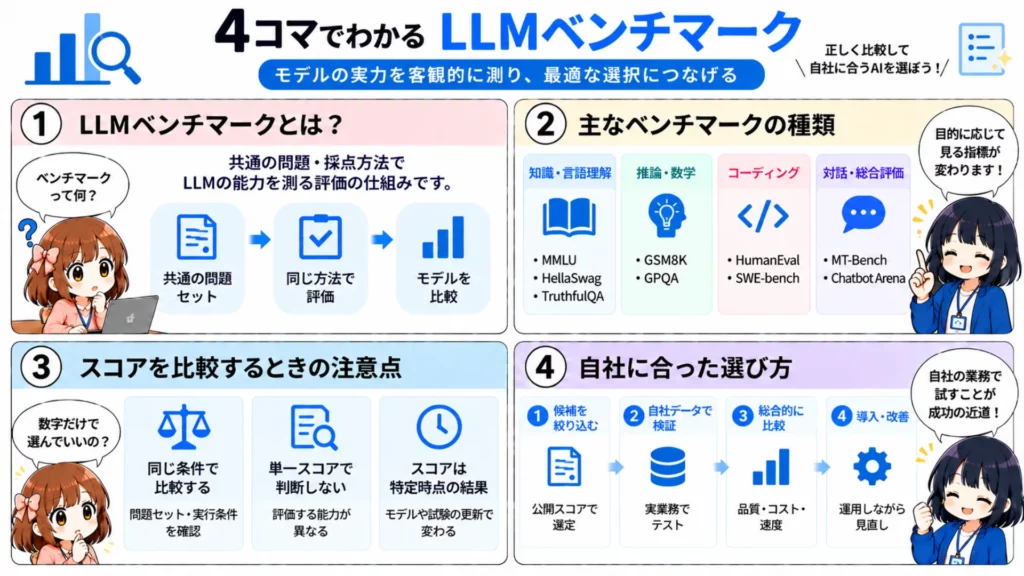
- LLMベンチマークは、共通の問題や採点方法を使ってモデルの能力を測る評価の仕組み
- スコアの比較では、評価対象の能力に加えて問題セットや実行条件の違いを確認することが重要
- 自社に合ったLLM選定には、公開スコアによる候補の絞り込みと業務データを使った検証が必要
LLMベンチマークとは、LLM(大量の文章などを学習した大規模言語モデル)の能力を共通の問題や方法で評価する仕組みです。モデル選定に役立ちますが、ランキング上位のモデルが自社の業務にも最適とは限りません。
本記事では、主要なベンチマークの種類とスコアの読み方をはじめ、日本語評価や自社での検証方法まで解説します。評価結果を正しく読み取り、用途に合ったLLMを選びたい方は、ぜひ最後までご覧ください。
\生成AIを活用して業務プロセスを自動化/
LLMベンチマークとは
LLMベンチマークとは、大規模言語モデルの知識や推論、コード生成などの能力を、共通の問題セットと評価方法で測る仕組みです。開発元ごとに評価条件が異なると公平に比べにくいため、共通の基準で性能を比較することが重要になります。
主な目的は、モデルの得意・不得意を客観的に把握し、用途に合ったモデル選定に役立てることです。例えば、開発支援ではコードの生成・修正能力を重視し、問い合わせ対応では対話の品質を確認するなど、任せたい業務に応じて評価結果を活用しましょう。
ベンチマークの評価プロセス
評価は、セットアップ・テスト・採点の順に進めます。最初に問題セットと採点基準を決め、モデルの版やプロンプト(AIに渡す指示文)などの条件をそろえることが基本です。
次に各モデルへ問題を入力し、回答と実行条件を保存します。最後に正解との一致やコードの動作などを確認し、集計した結果を比較する流れです。自由記述の回答では、人や評価用のLLMが基準に沿って採点する方法もあります。
同じ問題でも、例題を見せるかどうかで結果は変わり得ます。0-shot(例題を示さない条件)と5-shot(例題を5つ示す条件)は区別し、採点方法も併せて記録しましょう。
主要なLLMベンチマーク8選
代表的なLLMベンチマークは、知識・推論・コーディング・対話の4分野に整理できます。それぞれ測定する能力や採点方法が異なるため、得点だけでなく評価対象も押さえることが大切です。
ここでは、固定の問題セットを持つ8種類を分野別に紹介します。併せて、人の好みを反映するChatbot Arenaの評価方法も確認しましょう。
以下の表に各ベンチマークの評価対象とスコア形式をまとめました。まずは全体像をつかみ、各分野の解説で違いを確認してください。
| 分野 | ベンチマーク | 主に測る能力 | スコアの代表的な形式 |
|---|---|---|---|
| 知識・言語理解 | MMLU | 幅広い分野の知識と問題解決 | 選択問題の正答率 |
| 知識・言語理解 | HellaSwag | 日常場面の常識的な推論 | 続きの選択肢を選ぶ正答率 |
| 知識・言語理解 | TruthfulQA | よくある誤解に引きずられず答える能力 | 真実性などの生成評価、選択式のスコア |
| 推論・数学 | GSM8K | 複数の計算手順を要する算数の文章題 | 最終回答の正答率 |
| 推論・数学 | GPQA | 生物・物理・化学の専門的な推論 | 選択問題の正答率 |
| コーディング | HumanEval | 指示に沿った関数の生成 | テストを通過する確率を表すpass@k |
| コーディング | SWE-bench | 既存のソフトウェアの課題解決 | 課題の解決率 |
| 対話・総合評価 | MT-Bench | 複数回のやり取りでの回答品質 | 評価用LLMによる評点 |
知識・言語理解系ベンチマーク(MMLU・HellaSwag・TruthfulQAなど)
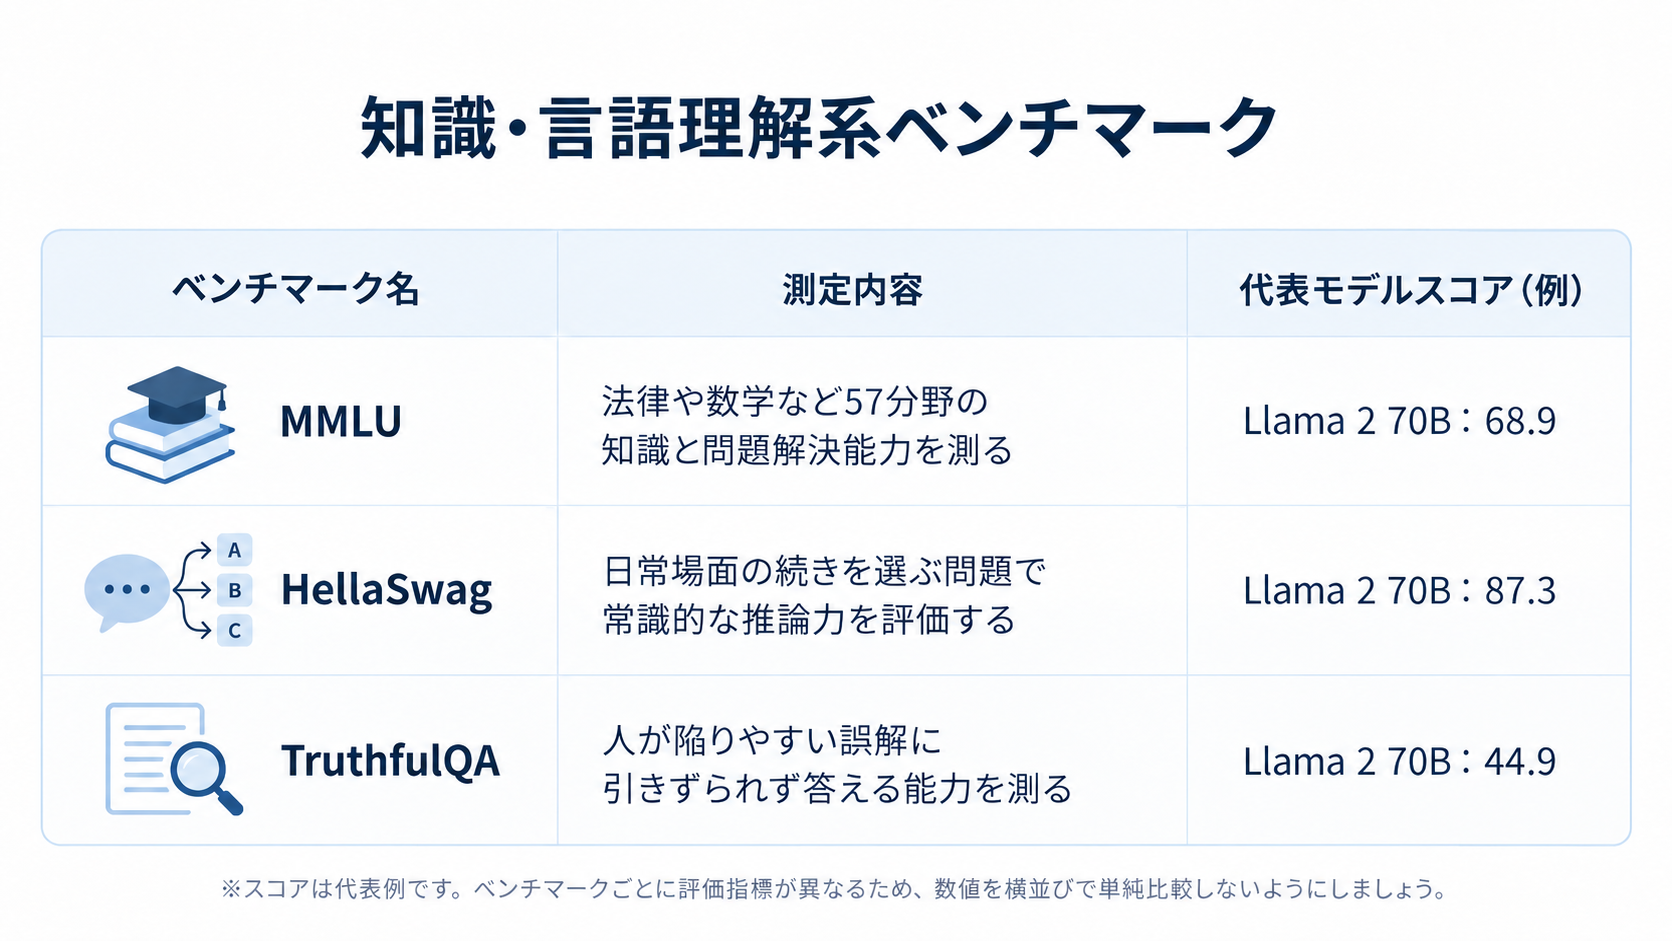
MMLU・HellaSwag・TruthfulQAは、知識や言語理解を異なる観点から評価するベンチマークです。MMLUは法律や数学など57分野の知識と問題解決能力を測ります。
HellaSwagは日常場面の続きを選ぶ問題で、常識的な推論力を評価します。一方、TruthfulQAが測るのは、よくある誤解に引きずられず答える能力です。知識の豊富さと誤情報を避ける力は別の評価軸といえます。
以下の表に、各ベンチマークの測定内容をまとめました。試験ごとに評価対象や採点方法が異なるため、それぞれのスコアを単純に比較しないようにしましょう。
| ベンチマーク | 測定内容 |
|---|---|
| MMLU | 法律や数学など57分野の知識と問題解決能力 |
| HellaSwag | 日常場面の自然な続きを選ぶ常識的な推論力 |
| TruthfulQA | よくある誤解や誤った通説に引きずられず、事実に沿って答える能力 |
推論・数学系ベンチマーク(GSM8K・GPQAなど)
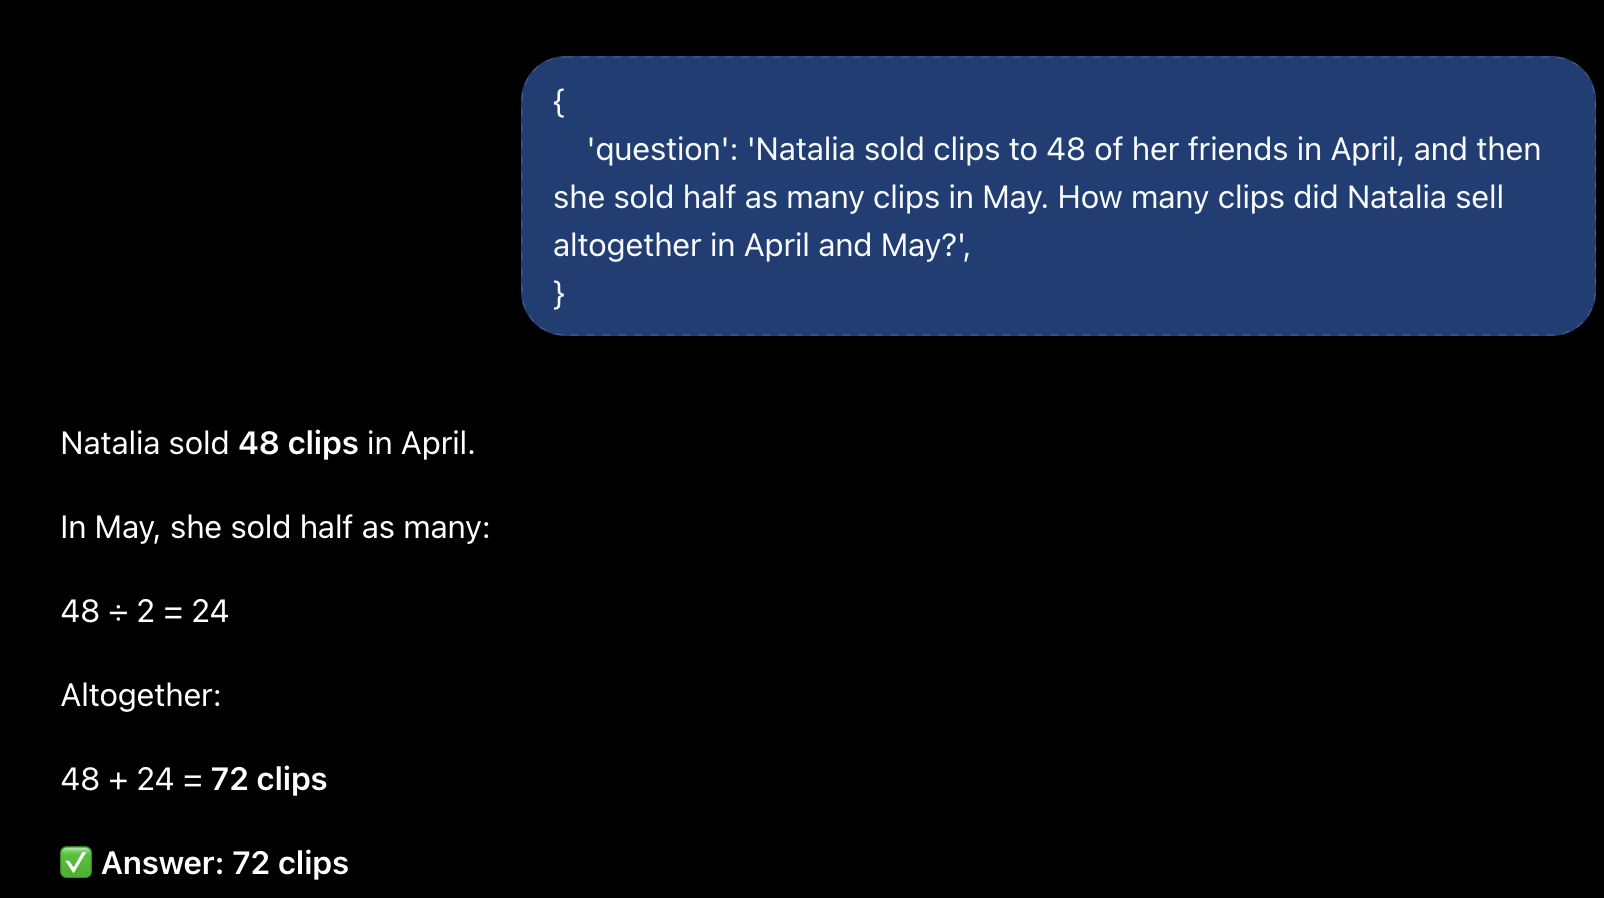
GSM8Kは、複数の計算手順が必要な算数の文章題を集めたベンチマークです。与えられた条件から必要な計算を組み立てる能力を測り、通常は最終回答が正解と一致するかで評価します。
GPQAは、生物・物理・化学の専門家が作成した難しい選択問題を使います。数学専用ではなく、専門知識を踏まえて考える能力を見る指標です。
GPQAとGPQA Diamond(一部の問題を選抜した版)のスコアは区別が必要です。また、途中の考え方を出力させる条件や計算ツールの利用可否も結果に影響するため、モデル名と数値だけを並べないようにしましょう。
コーディング系ベンチマーク(HumanEval・SWE-benchなど)
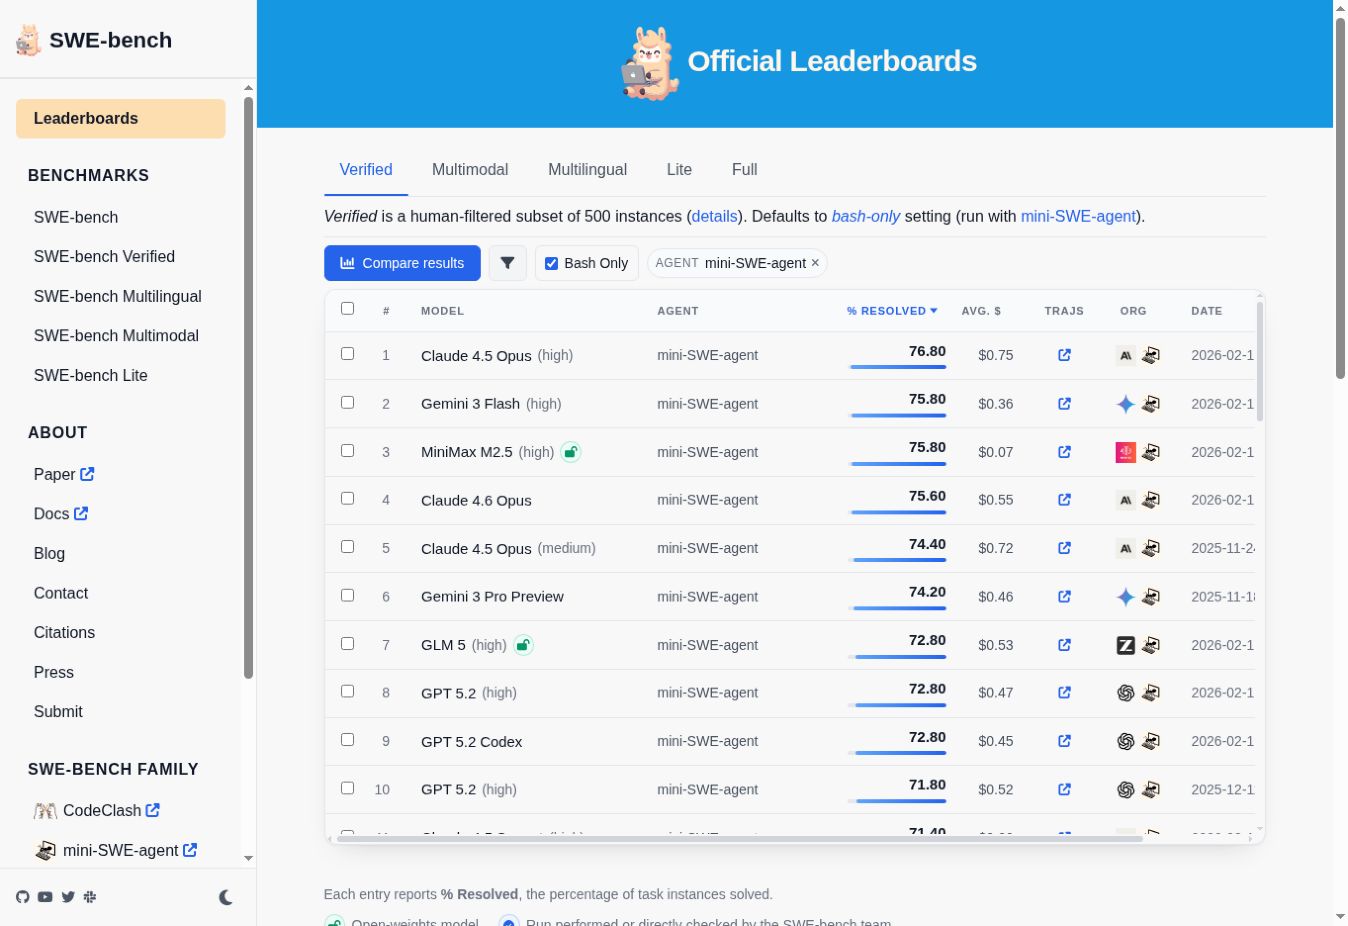
コーディング系ベンチマークは、コード生成やソフトウェア開発の課題に対応する能力を測ります。HumanEvalは、Pythonの関数(特定の処理をまとめたもの)を生成させ、用意されたテストで正しく動くかを確かめる試験です。一方、SWE-benchは既存のコードを修正し、実際のソフトウェアで報告された課題を解決できるかを評価します。短いコードの生成と、既存コードの修正を分けて確認できる点が特徴です。
ただし、生成の試行数や利用ツールによって結果は変わります。スコアを比べる際は、問題セットの版や実行条件も確認しましょう。
対話・総合評価系ベンチマーク(Chatbot Arena・MT-Benchなど)
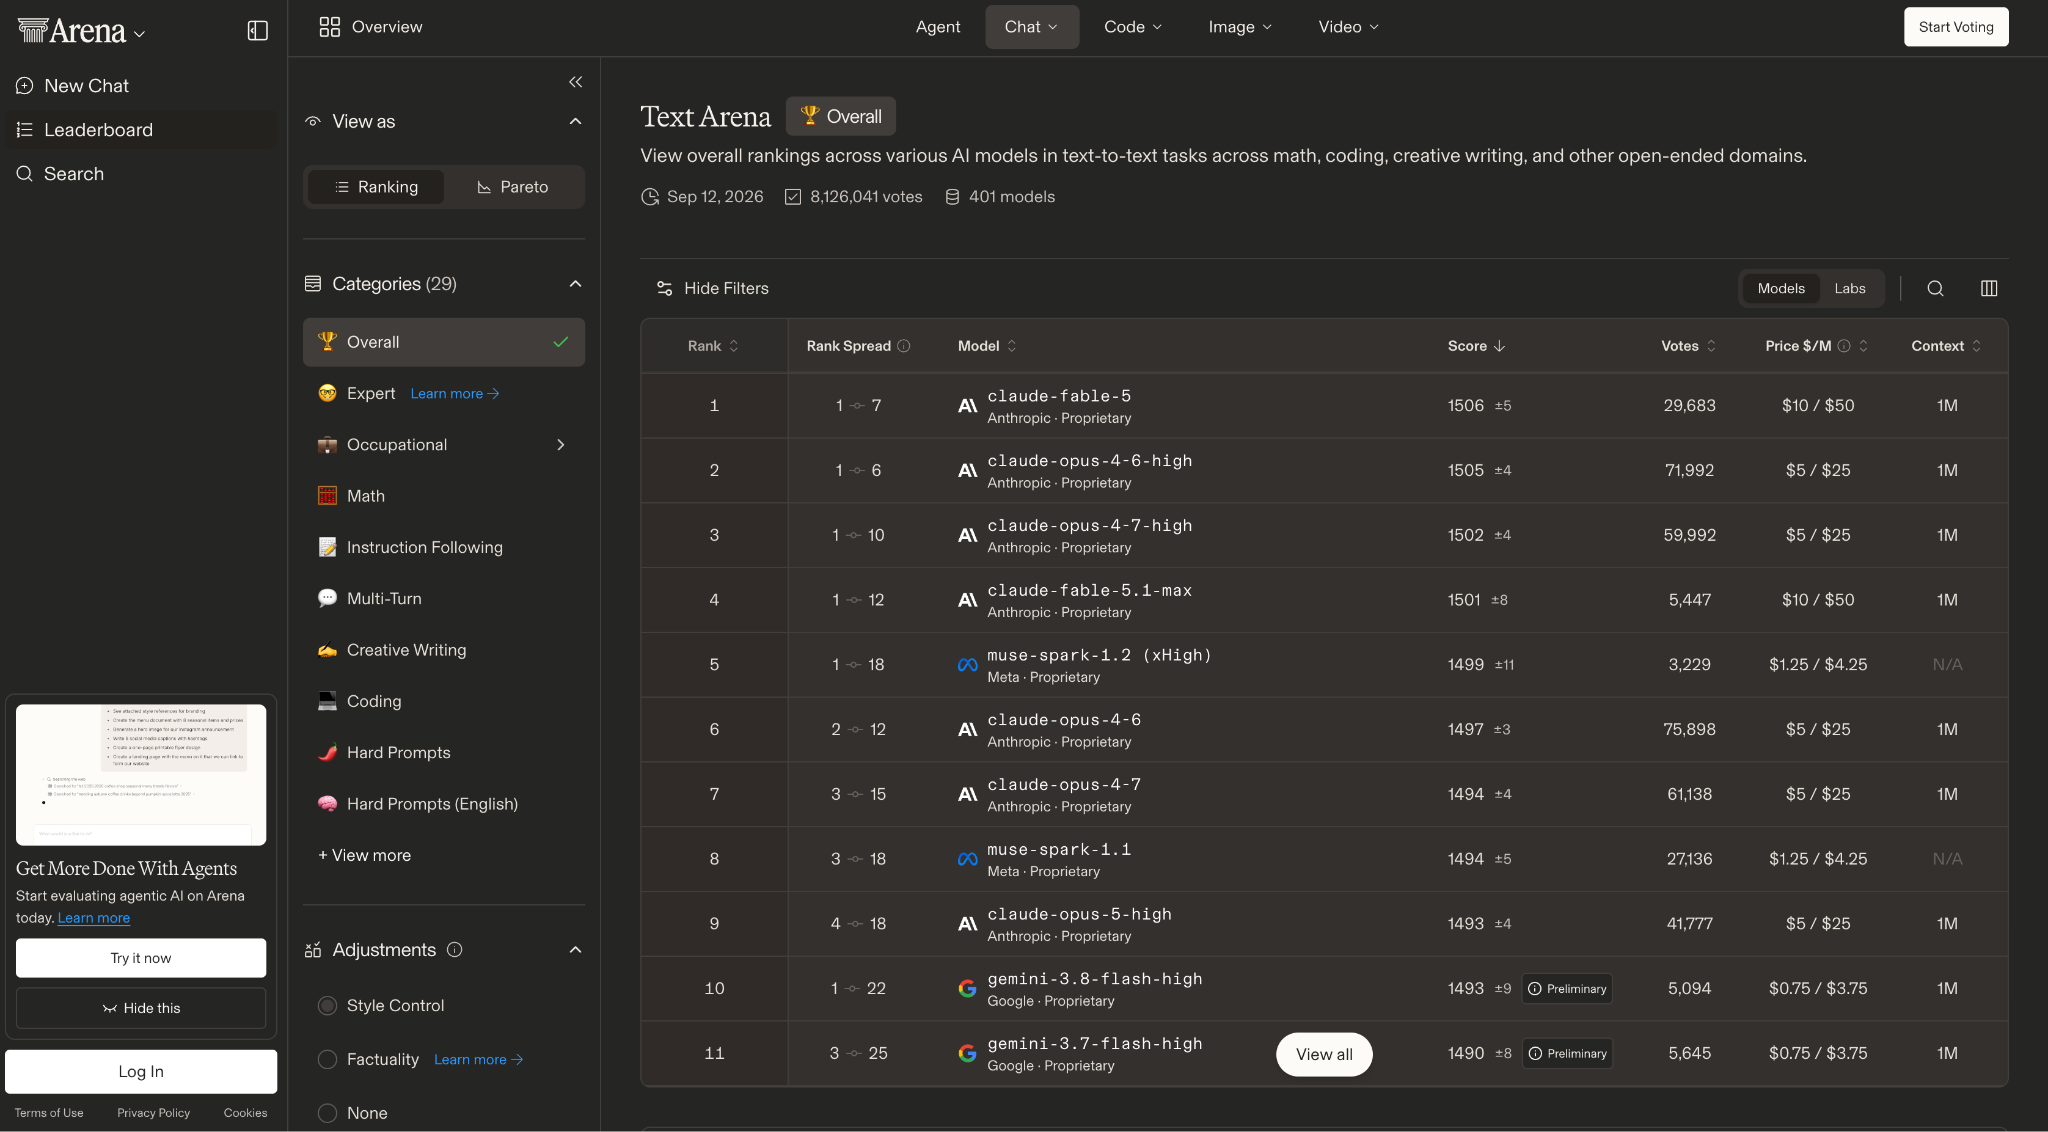
MT-Benchは、追加質問を含む複数回のやり取りで回答品質を評価するベンチマークです。標準的な実装では評価用LLMが採点するため、人の評価そのものではない点を押さえましょう。
一方、Chatbot Arenaは、モデル名を伏せた2つの回答を人が比較し、好ましい回答への投票を集計する評価基盤です。運営元は2026年1月に「Arena」へ改称しましたが、評価手法自体は引き続きChatbot Arenaの名で広く知られています。固定問題への正答率ではなく、参加者の好みを反映した相対評価として読みます。
MT-Benchでは評価用モデルの好み、Arenaでは投票者や質問内容の偏りが結果に影響し得ます。読みやすさの評価が高くても事実の正確さが保証されるわけではないため、採点の仕組みを区別することが大切です。
ベンチマークスコアの注意すべきポイント
スコアは、同じ試験・同じ条件で比較することが基本です。数字が大きいという理由だけで選ぶと、用途の違いや評価方法の違いを見落とすおそれがあります。
確認する順番は「何を測る試験か」「どの条件で実施したか」「自社の用途と近いか」がよいでしょう。まずは以下の4点を押さえると、比較表を読む際の判断が安定します。
単一スコアだけで判断しない
MMLUの成績が高いモデルでも、日本語の文章が自然であるとは限りません。知識問題を解く力と、指定された文体や形式を守る力は別の観点です。
自社の用途に近い指標を主軸にし、異なる能力を測る指標で不足を補うことが大切です。例えば、社内チャットボットなら日本語の対話品質を確認し、資料に根拠がある回答を返せるかは別の業務テストで検証しましょう。
難易度・母集団の違いを考慮する
ベンチマークは、問題の難しさや出題分野、対象言語がそれぞれ異なります。そのため、別の試験で得た80%と60%を比べても、前者のモデルが優れているとは判断できません。
平均点を見る際は、どの問題や回答を集計対象にしているかも確認しましょう。総合点が高くても、自社に必要な分野では成績が低い場合があります。
人の投票を使う評価では参加者や質問の偏りも影響するため、順位や点数だけで優劣を決めないことが大切です。
スコアはあくまで特定時点のスナップショット
ベンチマークのスコアは、特定のモデルと実行条件で測った時点の記録です。同じサービスでもモデルが更新されれば性能が変わるため、過去の結果がそのまま当てはまるとは限りません。
また、ベンチマーク自体の改訂によって問題の内容や難易度が変わる場合もあります。得点の上昇を性能向上と即断せず、同じ条件で測った結果かを確認しましょう。比較に使う際は、評価日やモデル名に加えて、問題セットの版や生成設定も記録することが大切です。
実務での使い勝手と乖離する場合がある
難しい問題を解けるモデルでも、回答までの時間が長ければ対話業務では使いにくい場合があります。処理件数が多い業務では、1件当たりの小さな費用差も運用全体に影響するでしょう。
そのため、回答品質・応答時間・利用コストを同時に確認することが重要です。例えば、文章の下書きでは多少の修正を前提に速度を優先し、根拠の確認が必要な回答では正確さを重視する、といった判断ができます。
LLMの精度をどう捉えるべきかは、以下の記事で詳しく解説しています。

LLMベンチマークの限界・課題
ベンチマークの結果を適切に読んでも、試験で測っていない能力まで保証されるわけではありません。公開問題への対応が得意でも、自社固有の用語や例外処理では失敗する可能性があります。
ここでは、評価結果の信頼性に関わるデータの混入と、試験の対象外になりやすい運用要件を整理します。数値の比較だけでは補えない部分を把握しておきましょう。
ベンチマークへの最適化(テスト対策問題)
公開されたベンチマークの問題や正解が事前学習のデータに混ざると、モデルが答えを覚え、未知の問題への対応力以上に高いスコアを出すおそれがあります。これはデータ汚染(評価用の情報が学習データへ混入すること)と呼ばれる課題です。
また、特定の試験で高得点を取るための調整が、実務での性能向上につながるとは限りません。公開スコアだけに頼らず、未公開の業務問題でも検証し、初めての質問に対応できるかを確かめましょう。
実務観点(コスト・セキュリティなど)はカバーしきれない
知識やコード生成のスコアだけでは、利用コストや入力情報の保存期間、社内のアクセス制御までは判断できません。導入時には、回答品質と運用条件を分けて確認することが重要です。
入力データの取り扱いは提供元の条件を確認し、費用や応答時間は実際の業務に近い条件で検証しましょう。また、担当者による回答の確認や既存システムとの連携にも手間がかかります。モデルの利用料に加えて、導入後の作業負担まで含めた比較が必要です。
用途別・目的別のベンチマークの選び方
ベンチマークは、任せたい業務に近い試験から選ぶと効率的です。コード生成と問い合わせ対応では必要な能力が異なるため、用途に応じて優先する指標を変えましょう。
例えば、開発支援ではコードの動作や修正の成功率を重視し、チャットボットでは回答品質や会話の自然さを確認します。日本語で使う場合は、日本語タスクの評価も判断材料です。
以下の表に、用途ごとに優先したい評価と自社で追加確認する項目を整理しました。まずは自社の目的を明確にし、必要な指標を絞り込みましょう。
| 主な用途 | 優先する評価 | 自社で追加確認すること |
|---|---|---|
| 関数や短いコードの生成 | HumanEval | 使用言語と社内の記述ルールへの対応 |
| 既存コードの修正 | SWE-bench | 自社の開発環境での修正成功率 |
| 問い合わせ対応・文章作成 | MT-Bench、Arenaの対話評価 | 根拠の正確さと指示への対応 |
| 日本語の知識・文書処理 | JMMLU、日本語の複数タスク評価 | 専門用語と社内文書への対応 |
コーディング用途で重視したい指標
短い関数の生成を任せるならHumanEval、既存のソフトウェアの不具合修正ならSWE-benchが判断材料になります。まず、新しく書く仕事か、既存コードを直す仕事かを分けて考えましょう。
HumanEvalでは、1回の生成で使えるコードがほしい場合はpass@1が参考になります。複数候補を生成する前提なら、試行数を増やした評価と追加費用を併せて確認してください。
SWE-benchの結果を見る際は、モデルだけでなく利用ツールや実行回数も比較条件です。最終的には自社のコードでテストが通るかを確認し、レビューにかかる時間まで含めて判断すると実態に近づきます。
業務効率化・チャットボット用途で重視したい指標
文章の自然さや会話の続けやすさを見るには、MT-BenchやArenaの結果が参考になります。ただし、社内の規程や商品情報を正しく答えられるかは、自社の資料を使った回答テストで確かめることが必要です。
RAG(外部資料を検索し、その情報を参照して回答する仕組み)を使う場合は、検索結果と回答の両方を評価しましょう。必要な資料を取得できていなければ、モデルだけを高性能なものに替えても改善しない場合があるためです。
回答の正確さに加えて、根拠がない質問で無理に答えないかも確認します。利用者の満足度だけに頼らず、誤案内の件数や担当者への引き継ぎの適切さを見ることが大切です。
日本語対応を重視する場合の指標
日本語で使うモデルは、日本語の問題による評価も確認しましょう。JMMLUは、日本語で幅広い分野の知識や問題解決能力を評価するベンチマークで、日本史や日本地理、日本語の熟語など、日本語・日本文化に関する問題も含まれています。
また、llm-jp-eval(日本語の複数タスクを評価するツール群)では、読解や言語理解などを分けて確認できます。日本語の知識問題が得意でも敬語や社内特有の言い回しまで適切とは限らないため、実際の文書による検証を組み合わせることが重要です。
代表的なLLMの特徴や比較を知りたい方は、以下の記事も併せてご覧ください。

リーダーボード・ランキングの活用方法
リーダーボード(複数モデルの評価結果を並べた一覧)は、比較する候補を探す入り口として便利です。用途別の項目や個別スコアを確認できれば、総合順位では見えない得意分野も把握できます。
まず自社の用途に近い分類を選び、候補のモデル名と評価条件を控えましょう。順位だけを転載するよりも、どの条件の結果を選定根拠にしたかを残すほうが導入判断の説明に役立ちます。
主要なリーダーボード(Chatbot Arena Leaderboard・Nejumi Leaderboardなど)
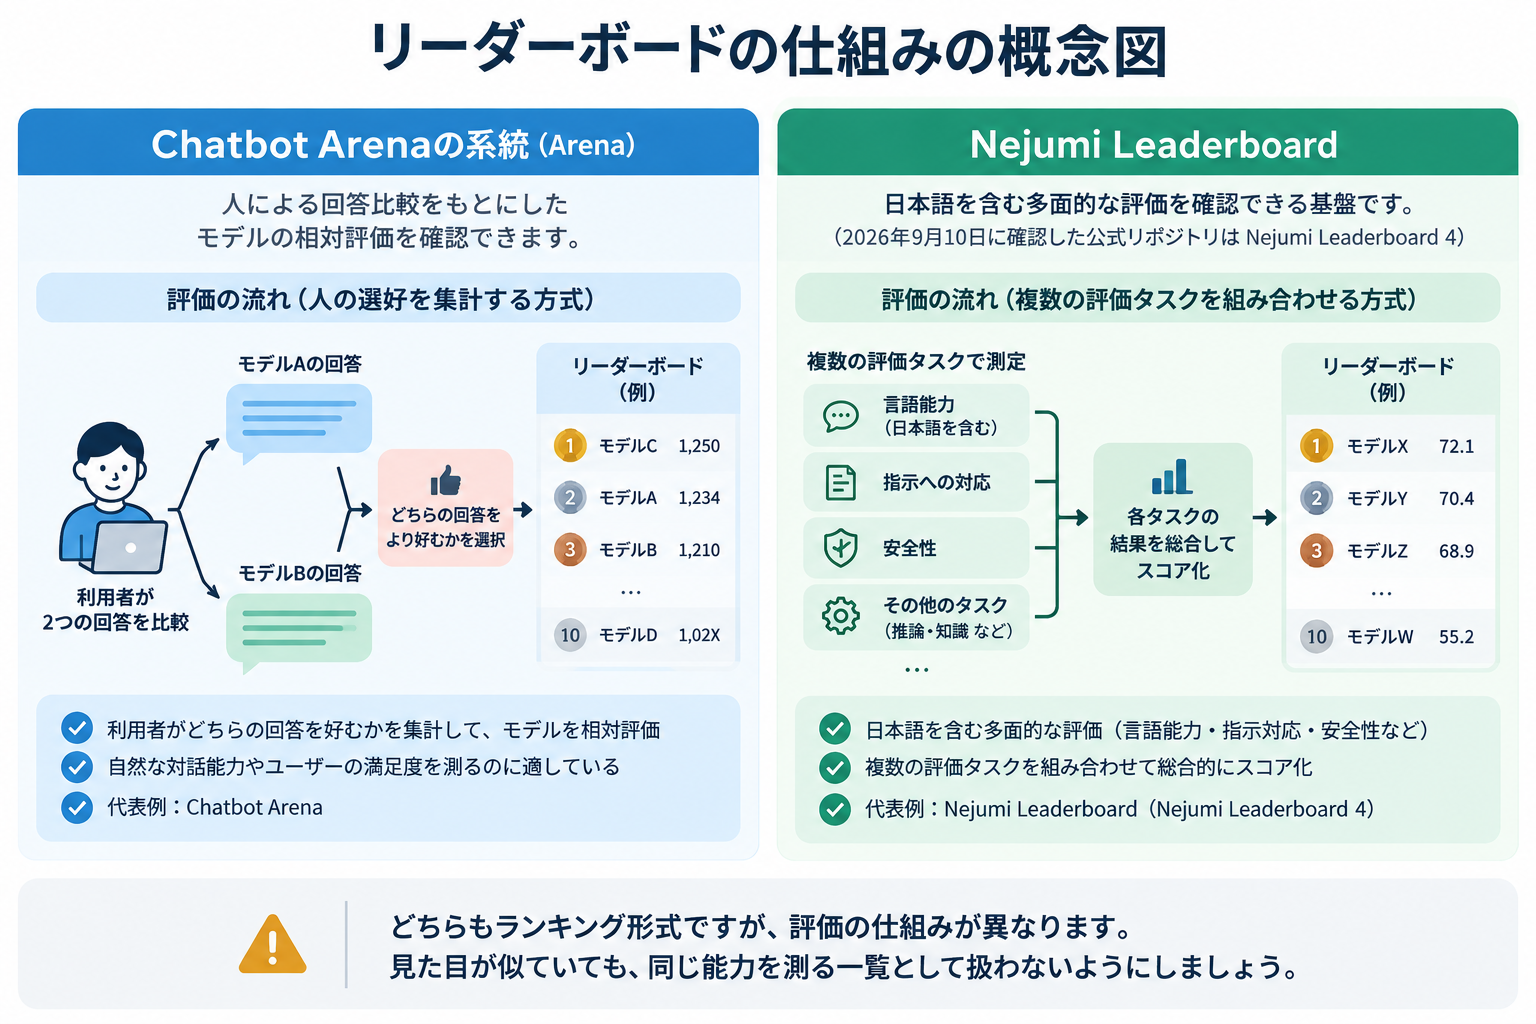
Chatbot Arena系のリーダーボードでは、ユーザーが2つのモデルの回答を比較し、どちらを好むかという評価を集計して相対的な順位を示します。一方、Nejumi Leaderboardは、日本語能力や指示への対応、安全性など複数の評価項目をもとにモデルを比較する基盤です。
前者は人の選好、後者は複数タスクによる評価を軸にしている点が大きな違いです。
リーダーボードを見るときの注意点
リーダーボードを見る際は、更新日・評価対象・集計方法を確認しましょう。掲載モデルが限られている場合、未掲載モデルより優れているとは判断できません。
また、投票数や評価タスク、言語、モデルの版によって順位は変わります。順位だけで優劣を決めず、評価条件や各項目の内訳まで確認することが重要です。
LLMベンチマークを自社のモデル選定に活かす方法
モデル選定では、公開スコアで候補を絞った後に、自社の業務で合格できるかを確かめます。ベンチマークを候補の比較に使い、導入判断は業務テストの結果と運用条件で行う流れです。
評価前に、期待する回答と許容できない失敗を決めておきましょう。ここからは社内FAQ(よくある質問と回答集)への回答を例に、自社テストのやり方を具体化します。
ベンチマークスコア+実運用テストを組み合わせる考え方
公開スコアはモデルの候補を絞る判断材料になりますが、自社の業務でも同じ性能を発揮するとは限りません。導入前には、実際の業務データを使った検証を組み合わせることが重要です。
例えば、社内の問い合わせ対応なら実際の規程と質問を用意し、各モデルに同じ条件で回答させます。正確さだけでなく、資料に答えがない場合の対応や指示した形式を守れるかも確認しましょう。
さらに、応答時間や利用コスト、人による修正の手間も比較対象です。公開スコアと実運用テストの両面から判断することで、自社に合うモデルを選びやすくなります。
導入目的別に優先すべき指標を絞り込むステップ
LLMを選ぶ際は、まず自社の利用目的と必須条件を整理します。コスト重視なら料金や処理効率、精度重視なら用途に合うベンチマーク、日本語対応を重視するなら日本語性能を優先して確認しましょう。
- 対象業務と改善したい点を決める
- 許容できない失敗や必須条件を整理する
- 目的に合う指標で候補を絞る
- 自社データで品質・費用・速度を比較する
- 導入後の再評価時期を決める
すべての指標で最高のモデルを探すのではなく、自社で重要な条件を満たす候補から選ぶことがポイントです。
自社に合ったLLMの選定や導入を相談したい方は、以下の記事をご覧ください。
LLMベンチマークなどのご相談はWEELへ
LLM選定の失敗を防ぐには、スコアの意味と評価条件を確認し、自社の業務で確かめることが重要です。知識や推論、コード生成、対話では測る能力が違うため、総合順位だけで結論を出すべきではありません。
まずは任せたい業務を一つ選び、適したベンチマークから候補を絞りましょう。次に実際の資料と質問でテストし、品質と費用、応答時間を比べることで、自社に合うモデルを判断しやすくなります。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。