大規模言語モデル(LLM)とは?仕組みや代表例、サービス、できることを徹底解説
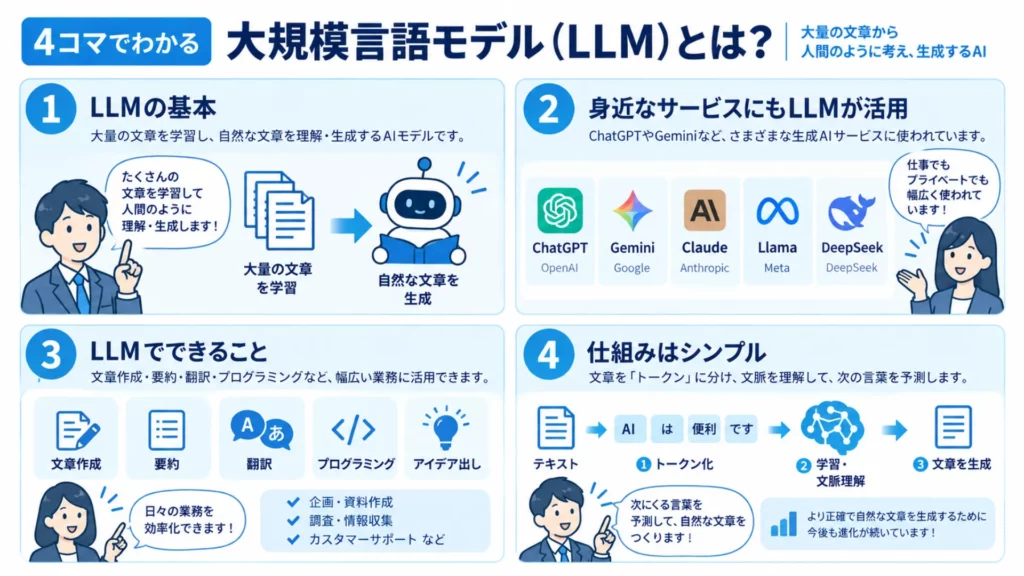
- LLM(大規模言語モデル)は、大量の文章を学習し、自然な文章を理解・生成できるAIモデル
- ChatGPTやGemini、Claudeなど、身近な生成AIサービスにもLLMが活用されている
- LLMは文章作成や要約、翻訳、プログラミングなど幅広い業務に活用できる
LLM(大規模言語モデル)は、大量の文章を学習し、人間のような自然な文章を理解・生成できるAIモデルです。ChatGPTやGemini、Claudeなど、身近な生成AIサービスにも活用されています。
とはいえ、「LLMとは何?」「生成AIとは何が違うの?」と疑問に思う方も多いのではないでしょうか。
この記事では、LLMの基本や仕組み、代表例、できること、注意点までわかりやすく解説します。最後まで読むことで、LLMの基礎を理解し、仕事でどのように活用できるのかイメージできるようになるでしょう。
\生成AIを活用して業務プロセスを自動化/
大規模言語モデル(LLM)とは?
大規模言語モデル(LLM=Large Language Models)とは、大量のテキストデータを学習し、人間のように自然な文章を生成・理解する機械学習モデルのことです。
「テキスト以外のデータ」(例えば画像データや音声データ)を使ってトレーニングした基盤モデルは、当然ながら「大規模“言語”モデル」ではありません。
ChatGPTやGemini、PerplexityAIなどが大規模言語モデルに当たります。以下で、大規模言語モデルの基本からAI全体での立ち位置について詳しく解説していきます。
基本のキ!「言語モデル」とは
言語モデルとは、文章や単語の出現パターンを予測するシステムです。
このモデルは、自然な会話や文章がどのように構成されるかを数学的に分析し、それに基づいて確率を割り当てます。自然な文章には高い確率を、不自然な単語の組み合わせには低い確率を与えることで言語の流れを理解しやすくします。
特に、ニューラルネットワークを用いた大規模言語モデルは、複雑な文章や会話のパターンを学習し自然で人間らしいテキスト生成や言語理解が可能です。
大規模になったのは3点!
言語モデルにおける以下の3点を大規模化したものを、大規模言語モデルと呼びます。
- 計算量
- データ量
- モデルパラメータ数
大規模化したことにより、コンピュータが処理する仕事量や入力される文章データの量、ディープラーニングのパラメータが増加し、モデルの性能が各段に向上しました。
OpenAIの研究によって、計算量やデータ量、パラメータ数の増加が性能向上につながることが証明されており、ChatGPTもこの技術を活用しています。
大規模言語モデルと生成AIの違い
LLM(大規模言語モデル)と生成AIはどちらもAI技術の一種ですが、異なる役割と特化分野を持っています。
生成AIとは、テキスト、画像、音声などのデータを自動的に生成できる技術全般を指します。一方、LLMは生成AIの一種であり、特に自然言語処理に特化しています。LLMは膨大なテキストデータを用いて学習し、非常に高度な言語理解を実現しています。
要するに、LLMは生成AIの種類の1つということですね。
オープンソース型とクローズドソース型の違い
LLMは、モデルの公開方法によってオープンソース型とクローズドソース型に分けて説明されることがあります。
オープンソース型は、モデルの構成や重みなどが公開され、一定の条件のもとで利用・改変できるモデルです。自社の用途に合わせて調整しやすく、社内環境で運用できる場合もあります。ただし、利用できる範囲や商用利用の可否はモデルごとのライセンスによって異なるため、事前の確認が必要です。
一方、クローズドソース型は、モデルの詳細や重みが一般公開されておらず、主に提供企業のサービスやAPIを通じて利用します。利用者側でモデルそのものを自由に改変することは難しいものの、専門的な環境を構築しなくても利用しやすい点が特徴です。
どちらが適しているかは、カスタマイズ性やセキュリティ、導入・運用コストなどを踏まえて選ぶことが重要です。
生成AIの企業導入におけるリスクについて詳しく知りたい方は、下記の記事を合わせてご確認ください。

大規模言語モデル(LLM)が文章を生成する仕組み
大規模言語モデルは、大きく分けて以下の5つのプロセスで文章を生成しています。
- トークン化
- エンコード
- ニューラルネットワークを通した学習
- 文脈(コンテキスト)理解
- デコード
これらのプロセスは、連携することで言語を理解し新たな文を作り出す能力を実現します。
それぞれのプロセスについてわかりやすく説明していきます。
トークン化
トークン化とは、テキストを小さな単位(トークン)に分割する処理のことを指します。LLMがテキストを理解するための最初のステップです。例えば、日本語では形態素、英語では単語や句読点がトークンになります。トークン化により、コンピュータはテキストを数値データに変換しやすくなり、テキストの意味や構造を把握できます。
トークン化は、LLMがテキストデータを効率的に解析し理解するために不可欠なプロセスです。
エンコード(ベクトル化)
エンコード(ベクトル化)とは、トークン化されたデータを数値のベクトルに変換する処理を指します。
最初のプロセスでトークン化によって分割されたデータは、そのままではコンピュータは解析できません。エンコードは、トークンを数値に変換することで、コンピュータが情報を解析できるようにするための処理です。
これにより、モデルがトークン(言葉の最小単位)を数値データとして扱うことができるようになり、より複雑な文脈やニュアンスを理解できるようになります。
ニューラルネットワークを通した学習
ニューラルネットワークは、LLMの核心的な部分であり、多数の層からなる複雑な構造を持っています。
テキストデータがニューラルネットワークを通過する際に、各層でデータは変換・調整され、モデルが入力データの特徴を抽出し学習を行います。また、ニューラルネットワークは単語の出現確率だけでなく、単語間の関係性や文脈も考慮して学習するため、モデルがテキストデータの文脈やニュアンスを理解できるようになります。
ニューラルネットワークを通した学習によって、LLMは高度な言語処理能力を獲得できるのです。
文脈(コンテキスト)理解
文脈(コンテキスト)理解は、LLMがテキストデータを理解するために不可欠なプロセスです。
ニューラルネットワークを通して入力されたテキストの文脈や背景を把握し、それに基づいて意味の解釈を行うため、LLMは単なる単語の並びではなく、文全体の意味や文と文との関連性を理解できるようになります。
たとえば「私は川を渡るために橋を渡った」という文章の場合、LLMは文脈理解によって、「橋」が「箸」ではなく「川を渡るための構造物」であると判断できます。
文脈理解によって、LLMがより人間に近い理解力と応答能力を発揮することができるのです。
デコード
デコードは「テキスト変換」とも呼ばれる、LLM処理の最終段階にあたります。
エンコードされたデータ(出力ベクトル)を修正し、人間が理解できる自然なテキストデータに変換する作業です。LLM内部で処理していたベクトルデータを修正し、最も確率が高い単語やフレーズを選択することで、人間が理解できる自然なテキストデータの形に出力します。
デコードによって、LLMは自然なコミュニケーションを取れるようになるのです。
代表的な大規模言語モデル(LLM)の一覧
LLMの開発は世界各国で進んでおり、OpenAIやGoogle、Anthropic、Metaなどから高性能なモデルが相次いで登場しています。2026年9月時点で注目されている、代表的なLLMは以下のとおりです。
| モデル | 主な特徴 | 開発元 |
|---|---|---|
| GPTシリーズ | 文章生成や推論、コーディングなど幅広い用途に対応 | OpenAI |
| Geminiシリーズ | テキストや画像など複数の形式を扱えるマルチモーダル性能や、推論・コーディングなどに強みを持つ | |
| Claudeシリーズ | 文章生成やコーディング、複雑なタスクの処理など幅広い用途に対応 | Anthropic |
| Llamaシリーズ | モデルを入手して独自環境で利用でき、用途に合わせたカスタマイズにも活用しやすい | Meta |
| DeepSeekシリーズ | 推論やコーディングなどに対応し、公開モデルも展開している | DeepSeek |
| Grokシリーズ | 推論やコーディング、エージェントなど幅広い用途に対応 | xAI |
LLMはそれぞれ特徴が異なり、文章作成やコーディングに加えて、画像など複数の形式を扱うマルチモーダル処理や、複数の作業を自律的に進めるエージェント機能にも活用されています。
また、近年のLLMはパラメータ数の多さだけで性能を単純に比較することが難しくなっています。モデルによって構造や学習方法、得意なタスクが異なるため、利用目的や性能、コスト、利用環境などを踏まえて選ぶことが重要です。
多くのLLMでは、2017年に発表された論文「Attention Is All You Need」で提案されたTransformerと呼ばれる仕組み、またはその発展形が活用されています。
話題のLLMを性能比較について詳しく知りたい方は、下記の記事を合わせてご確認ください。

大規模言語モデル(LLM)を活用した代表的なサービス・モデル
LLMは、対話型AIや検索サービス、業務支援ツールなど、さまざまなサービスに活用されています。また、企業や開発者がモデルを入手し、独自のシステム構築に活用することも可能です。
ここでは、2026年9月時点で代表的なLLM関連のサービス・モデルを7つ紹介します。
ChatGPT
OpenAIが提供する「ChatGPT」は、文章作成や要約、翻訳、プログラミング、画像・ファイルの分析など幅広い作業に対応するAIアシスタントです。
質問に回答するだけでなく、Web上の情報を検索したり、ファイルや画像を読み取って内容を分析したりと、さまざまな用途に活用できます。日常的な情報収集から資料作成、アイデア出し、コーディングまで幅広い業務を支援できるのが特徴です。
Gemini(旧Bard)
Googleが提供する「Gemini」は、テキストや画像など複数の形式の情報を扱えるAIアシスタントです。
GoogleはGeminiシリーズのモデルを継続的に開発しており、推論や情報収集、コンテンツ生成など幅広い用途に対応しています。また、GeminiではGoogleのサービスをはじめ、外部のさまざまなアプリとの連携も拡大しており、情報を回答するだけでなく、ユーザーの作業を支援するAIへと進化しています。
Copilot(旧BingAI)
Microsoftの「Copilot」は、文章作成や情報収集などを支援するAIアシスタントです。
Webやアプリから利用できるほか、Microsoft 365ではWord、Excel、PowerPoint、Outlook、TeamsなどにもCopilotが組み込まれています。普段利用しているMicrosoft製品上でAIの支援を受けられるため、資料作成やメール対応、データ整理など、日常業務の効率化に活用しやすい点が特徴です。
Claude
Anthropicが提供する「Claude」は、文章生成や情報分析、コーディングなど幅広いタスクに対応するAIアシスタントです。
長文の資料やファイルを扱う業務にも活用でき、2026年には知識労働やコーディングを重視したClaude 5世代のモデルも登場しています。また、Claude Codeなど、ソフトウェア開発を支援するサービスも展開されており、複雑な業務をAIに任せるエージェントとしての活用も進んでいます。
PerplexityAI
「Perplexity」は、Web上の情報を検索し、情報源を示しながら質問への回答を生成できるAIサービスです。
情報収集やリサーチに活用できるほか、近年は複数のAIモデルを活用した機能や、複雑な作業を実行する「Computer」なども提供しています。単に質問へ回答するだけでなく、調査や複数ステップの作業をAIに任せる用途にも活用できます。
Llama
Metaが開発する「Llama」は、企業や開発者がモデルを入手し、独自のAIシステム開発などに活用できるLLMシリーズです。
Llama 4では、テキストと画像を扱える「Scout」や「Maverick」などが提供されています。モデルを自社の用途に合わせて活用できるため、独自のAIサービス開発や研究など幅広い用途で利用されています。
ただし、利用条件はモデルごとのライセンスで定められているため、商用利用やカスタマイズを行う場合は事前に確認が必要です。
DeepSeek
中国のAI企業DeepSeekが開発する「DeepSeek」は、推論やコーディング、AIエージェントなどに活用できるLLMシリーズです。
2026年にはDeepSeek-V4が登場し、長い文脈を扱う能力やエージェント機能などが強化されています。モデルや技術情報の公開にも積極的で、企業によるAI開発から研究まで幅広い用途で注目されています。
LLMには、ChatGPTのようにすぐ利用できるAIサービスだけでなく、LlamaやDeepSeekのように開発者が独自のシステム構築に活用できるモデルもあります。利用目的や必要な機能、セキュリティ、カスタマイズ性などを比較して選ぶことが重要です。
大規模言語モデル(LLM)にできること5つ
ここでは、大規模言語モデルにできることを5つご紹介します。
- 質疑応答
- 文章の要約&単語抽出
- 機械翻訳
- 文章の分類や言い換え、感情分析
- ソースコードの生成&チェック
幅広い活用方法を解説していますので、ぜひ参考にしてください。
質疑応答
質疑応答システムは、ユーザーからの質問に対して適切な答えを出す技術です。大規模言語モデルの技術を活用することで、より高度で正確な回答を生成する能力を持つようになりました。
例えば、オンラインショッピングのサイトで顧客が商品について質問をしたとき、製品の特徴や使い方について正確な情報をすぐに教えてくれます。また、教育の分野では学生が化学実験や歴史の事実に関する質問をしたときは、詳細な情報や解説をすぐに提供できます。
このように、大規模言語モデルを活用した質疑応答は、顧客サービスを向上させ教育や商業など、さまざまな分野で役立っています。
文章の要約&単語抽出
大規模言語モデルは、膨大なテキストデータから学習し、言語に関する複雑なタスクを実行できる先進的なAI技術です。これらのモデルは、文章の要約や重要な単語の抽出など、多様な機能を持っています。
例えば、長い記事やレポートを短く要約することで、重要な情報を素早く把握することが可能になります。また、テキストからキーワードや重要なフレーズを抽出することで、特定の内容の概要を理解するのに役立つでしょう。
これらの能力により、情報過多の時代において、私たちの情報処理を大きく助けてくれる存在となっています。
機械翻訳
大規模言語モデルは、機械翻訳の分野で大きな進化を遂げています。そのため、異なる言語間の翻訳がより自然で正確になり、文法や語彙、文化的ニュアンスまで考慮されました。
特に、リアルタイム翻訳の能力が向上し、ビジネスや旅行での即時翻訳ニーズに応えることが可能になっています。
過去の手法と比べて、この技術は翻訳のスピードと品質の両面で大きな進歩を遂げています。したがって、言語の壁を越えたコミュニケーションがよりスムーズになり、世界中の人々が繋がりやすくなるでしょう。
文章の分類や言い換え、感情分析
大規模言語モデルは、文章の分類や言い換え、感情分析などに利用されます。
この技術は、文章を特定のグループに分けることで情報を整理しやすくし、同じ意味を異なる言葉で表現することでコミュニケーションを豊かにします。また、文章の感情分析を行うことで、テキストが伝える感情の傾向を理解できるでしょう。
例えば、文章の分類では、テキストを特定のカテゴリに分けることが可能です。言い換えでは、同じ意味の異なる表現を生成し、感情分析ではテキスト内の感情を識別します。
これらの機能は、カスタマーサポートやマーケティング、教育など多岐にわたる分野で活用されています。
ソースコードの生成&チェック
大規模言語モデルは、テキスト処理やプログラミング言語に特化しています。特に「ソースコードの生成とチェック」の分野では、LLMは開発者の指示に基づいて新しいコードを生成したり、既存のコードを分析してエラーや最適化のポイントを特定したりできます。
この技術は、プログラミング作業をより迅速かつ効率的に行うための強力なサポートツールです。開発者は、LLMを利用してコードの品質を向上させ、複雑な問題を解決するための新しいアプローチを見つけられるでしょう。
このように、大規模言語モデルは、ソフトウェア開発の分野で革新的な変化をもたらす可能性を秘めています。
大規模言語モデル(LLM)の問題点
大規模言語モデルには、いくつかの問題点が存在します。誤った情報や非倫理的な文章を生成するリスクがあり、使用する際は注意が必要です。大規模言語モデルの問題点を理解し、注意深く使用することが重要です。
知ったかぶりをしてしまう「ハルシネーション」
「ハルシネーション」とは、事実と異なる情報や関係のない内容を出力する現象です。これは、AIが実際に学習していない情報を作り出し、誤解を招くことがあります。特に、マイナーな事実や架空のキャラクターに関する質問では、不正確な回答を生成することがあります。
AI技術の進化によりこの問題は減少すると予測されていますが、完全に防ぐことはまだできません。ユーザーは、この可能性を理解して生成AIを使用する必要があります。
敵対的プロンプトの影響を受けてしまう
敵対的プロンプトは、言語モデルに対する攻撃手法で、プロンプトインジェクションやプロンプトリーク、ジェイルブレイクの3種類があります。
プロンプトインジェクションはモデルの出力を乗っ取る危険があり、プロンプトリークは保有情報の漏洩を引き起こす可能性があります。ジェイルブレイクはモデルの制限を外し、非倫理的な内容を引き出す手法です。
これらの攻撃はモデルのセキュリティに重大な脅威をもたらします。ユーザーはこのリスクを認識し、適切に対処する必要があります。
非倫理的もしくは文化的偏見を含む回答をしてしまう
大規模言語モデルはインターネット上のテキストから学習しますが、そのデータに偏りがあるため、時に偏見を含む回答をしてしまうことがあります。
特に、ネット上には特定の地域や文化に対する否定的なイメージが多く存在するため、モデルがこれらの偏った情報を学習した結果、偏見を含む回答を生成する可能性があります。
大規模言語モデルを使う際は、このような偏見が含まれる可能性があることを理解し、注意して使用することが大切です。
大規模言語モデル(LLM)の問題点への対策方法
LLMには、ハルシネーションや情報漏えい、不適切な回答などのリスクがあります。業務で安全に活用するには、LLMだけに対策を任せるのではなく、システムや運用面を含めた対策が重要です。
ここでは、LLMを活用する際に押さえておきたい4つの対策方法を解説します。
ガードレールを導入する
ガードレールとは、LLMへの入力や出力を制御し、意図しない動作を防ぐための仕組みです。
例えば、個人情報や機密情報を含む入力を制限したり、危険な内容を含む回答を出力しないようにしたりする方法があります。利用できる機能や操作の範囲をあらかじめ決めておくことも対策の一つです。
とくに企業でLLMを利用する場合は、用途や想定されるリスクに合わせてルールを設定し、安全に利用できる環境を整えることが重要です。
コンテンツモデレーションを実施する
コンテンツモデレーションとは、LLMに入力される内容や生成された回答を確認し、不適切なコンテンツを検出・制限する仕組みです。
暴力的・差別的な表現など、あらかじめ定めた基準に該当するコンテンツを検出することで、不適切な回答がユーザーに表示されるリスクを抑えられます。
ただし、自動的な判定ですべての問題を防げるとは限りません。重要な用途では人による確認も組み合わせるなど、利用場面に応じた対策が必要です。
データを適切に管理する
LLMを業務で利用する際は、入力するデータやLLMが参照するデータを適切に管理することが重要です。
個人情報や企業の機密情報を安易に入力すると、利用するサービスや設定によっては情報漏えいなどのリスクにつながります。入力できる情報の範囲を決め、アクセス権限を設定するなどの対策が必要です。
また、LLMに社内データなどを参照させる場合は、情報の正確性や更新状況も定期的に確認しましょう。古い情報や誤った情報が含まれていると、回答の品質にも影響する可能性があります。
プロンプトを最適化する
LLMから適切な回答を得るには、指示内容や条件を具体的にしたプロンプトを作成することも重要です。
例えば、「回答の根拠を示す」「わからない場合は推測せず、わからないと回答する」などの条件を指定することで、意図しない回答を減らしやすくなります。
ただし、プロンプトの工夫だけでハルシネーションや情報漏えいなどを完全に防ぐことはできません。ガードレールやデータ管理、人による確認など、複数の対策を組み合わせてLLMを活用しましょう。
なお、ChatGPTのリスクについて詳しく知りたい方は、下記の記事を合わせてご確認ください。

大規模言語モデル(LLM)や生成AIツールのご相談はWEELへ
大規模言語モデルには、幅広い活用方法がありますが、使用する際にはモデルの問題点を理解することが重要です。ハルシネーションや非倫理的な文章を生成する可能性があることを理解したうえで、うまく業務やAIツールの開発に役立てましょう。大規模言語モデルを上手く活用することで、これまでよりさらに業務効率化を図れるはずです。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。