NVIDIA CUDAとは?CPUとの違いからAI開発での役割、導入方法までわかりやすく解説
- CUDAとは、NVIDIA製GPUの並列計算能力を引き出すためのプラットフォーム
- PyTorchやTensorFlowが内部でCUDAを使うため、CUDAのコードを書かなくてもAIの学習・推論を高速化できる
- 導入時はGPUの世代・ドライバ・CUDA Toolkit・AIフレームワークのバージョンの互換性確認が重要
CUDA(クーダ)は、NVIDIA製GPUの並列計算能力を引き出し、AIの学習や推論を高速化するための開発基盤です。PyTorchなど主要なAI開発ツールに対応しており、生成AIの開発にも広く使われています。「CUDAは本当に必要?」「自社でも導入すべき?」と疑問に思う方も多いでしょう。
この記事では、CUDAの仕組みやメリット、対応GPUの確認方法から導入手順まで解説します。最後まで読めば、CUDAの必要性や導入時の注意点がわかります。
\生成AIを活用して業務プロセスを自動化/
NVIDIA CUDAとは
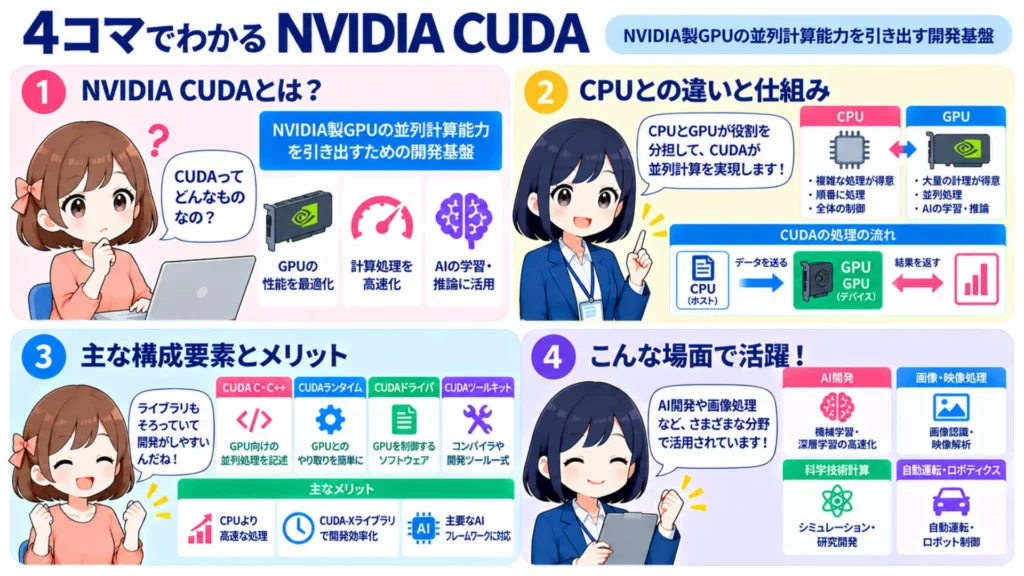
NVIDIA CUDAとは、NVIDIAが提供しているコンピューティングプラットフォームです。CUDAは「Compute Unified Device Architecture」の略称で、「クーダ」と読みます。NVIDIA製GPUの性能を最適化し、並列処理の向上を実現できます。
元々GPUは画像処理や映像処理を目的に開発されていますが、NVIDIA CUDAの登場によって一般的な計算処理(GPGPU)にも応用できるようになりました。
具体的には、機械学習や科学技術計算などに応用可能で、研究や開発の第一線で活用されています。
NVIDIA CUDAが開発された背景
CUDA登場以前、GPUは主に画像や映像の処理に使われていました。一般的な計算にGPUを使う場合も、OpenGLなどの画像処理向けの仕組みを流用する必要があり、開発には手間がかかっていたのです。
しかし、2006年にNVIDIA CUDAが発表されると、画像処理向けの仕組みを介さずにGPUで計算できるようになりました。その結果、科学技術計算をはじめ、幅広い分野でGPUの利用が進みます。
CUDAの登場からAI開発への普及までの流れは、以下のとおりです。
| 年代 | 主な出来事 |
|---|---|
| 2006年以前 | GPUで一般的な計算を行うには、画像処理向けの仕組みを流用する必要があった |
| 2006年 | NVIDIAがCUDAを発表し、GPUによる並列計算を扱いやすくした |
| 2012年 | GPUを使った画像認識AI「AlexNet」が高い成果を収め、ディープラーニングの研究が加速 |
| 2010年代後半 | PyTorchやTensorFlowなどの普及により、CUDAを使ったAI開発が広がる |
| 2020年代 | 生成AIの普及に伴い、大規模なAIモデルの学習や推論を支える技術として重要性が高まる |
特に2012年のAlexNetの成功は、GPUを使ったディープラーニングが広まる大きな転機となりました。PyTorchやTensorFlowなどを通じてCUDA対応GPUを利用できるため、開発者が直接CUDAのコードを書かなくても、AIモデルの学習や推論を高速化できます。
NVIDIAとは
NVIDIAとは、アメリカのカリフォルニア州に本社を置く半導体メーカーです。1993年に設立され、GPUの開発で世界的な知名度を誇る企業です。
個人が使用するパソコン用のGPUを開発しているほか、企業のデータセンター向けにも高性能GPUを提供しています。生成AI分野にも力を入れており、ロボットや自動運転などの物理AI開発を支援する基盤モデル群「NVIDIA Cosmos」を提供しています。
物理AIとは、現実世界の状況をAIが理解し、動きや行動を学習するための技術です。
なお、NVIDIAのAI基盤モデル「Cosmos」について詳しく知りたい方は、下記の記事を合わせてご確認ください。
GPUとは(CPUとの違い)
GPUとは、Graphics Processing Unitの略で、主に画像や映像の描画処理を担当するパーツです。大量の計算を同時に実行する並列処理が得意なため、ディープラーニングなどにも使われています。
一方、CPUはパソコン全体の動作を制御し、複雑な処理を順番に進めることが得意です。CPUとGPUの主な違いを以下の表にまとめました。
| 比較項目 | CPU | GPU |
|---|---|---|
| コア数 | 一般的に数個〜数十個 | 数百〜数万個の小規模な演算コア |
| 得意な処理 | 複雑な計算や順番に進める処理 | 大量のデータを同時に計算する並列処理 |
| 主な役割 | OSやアプリの実行、パソコン全体の制御 | 画像や映像の描画、AIモデルの学習や推論 |
なお、CPUとGPUではコアの構造が異なるため、数だけで性能を比較することはできません。生成AI開発では、CPUが処理全体を管理し、GPUが大量の計算を担当することで、効率よくAIモデルを動かせます。
なお、GPUとNPUの違いについて詳しく知りたい方は、下記の記事も併せてご確認ください。

NVIDIA CUDAでできること・主なメリット
NVIDIA CUDAを活用することで、開発者や研究者はCPU単体では時間がかかる大量の計算を高速に処理できます。ここでは、NVIDIA CUDAがもたらすメリットを解説します。
CPU単体と比べた圧倒的な高速化
NVIDIA CUDAの大きなメリットは、CPU単体と比較して計算処理を高速化できる点です。特にディープラーニングの学習では、大量のデータを同時に処理するため、CUDA対応GPUを使うことで学習時間の短縮が期待できます。
例えば、画像認識モデルの学習では、CPUだけで処理する場合よりも短時間で計算が完了するケースも少なくありません。ただし、実際の処理速度はGPUの性能やAIモデルの規模、データ量などによって異なります。
この高速化を支えているのが、GPUの並列処理能力です。CPUが複雑な処理やプログラム全体の制御を得意とする一方、NVIDIA製GPUは多数のCUDAコアを使い、大量の計算を同時に実行できます。
特に、AI開発で頻繁に使われる行列演算や畳み込み演算は、GPUの並列処理能力が効果を発揮しやすい領域です。NVIDIA CUDAは、こうした計算を効率よく実行するための基盤となっています。
CUDA-Xライブラリによる開発効率化
NVIDIA CUDAは、単なるプログラミングプラットフォームではありません。CUDA-Xと呼ばれるライブラリ群も提供しており、AI開発に必要な計算やデータ処理を効率よく実行できます。
CUDA-Xには、AIモデルの学習を支援するものから、学習済みモデルの推論を高速化するものまであります。代表的なライブラリと用途は以下のとおりです。
| ライブラリ名 | 主な用途 |
|---|---|
| cuDNN | ディープラーニングに必要な計算の高速化 |
| cuBLAS | 行列演算やベクトル演算の高速化 |
| TensorRT | 学習済みAIモデルの推論処理の高速化 |
| cuDF | 大量の表形式データの処理や分析の高速化 |
これらのライブラリを使えば、複雑なGPU向けの処理を一から開発する手間を減らせます。用途に合ったライブラリを選ぶことで、開発効率の向上や処理時間の短縮が期待できるでしょう。
AIフレームワークとの統合
現代のAI開発では、PyTorch・TensorFlow・JAXといった主要フレームワークはいずれもNVIDIA CUDAに対応し、NVIDIA製GPUでの処理に最適化されています。
これらのフレームワークは内部でcuDNNやcuBLASといったCUDA-Xライブラリを呼び出しており、開発者が直接CUDAコードを書かなくても、自動的にGPUの性能を最大限に引き出せる仕組みです。
例えば、PyTorchではmodel.cuda()やtensor.to(‘cuda’)といったシンプルなコマンドでGPU処理に切り替えられます。複雑な最適化は、バックグラウンドで自動的に実行される仕組みです。
TensorFlowも同様に、NVIDIA CUDA対応GPUが検出されると自動的にGPU計算に切り替わり、cuDNNを利用した高速化が適用されます。
この「フレームワークレベルでの深い統合」により、AI開発者はハードウェアの詳細を意識することなく、アルゴリズムやモデル設計に集中できます。
NVIDIA CUDAの仕組み
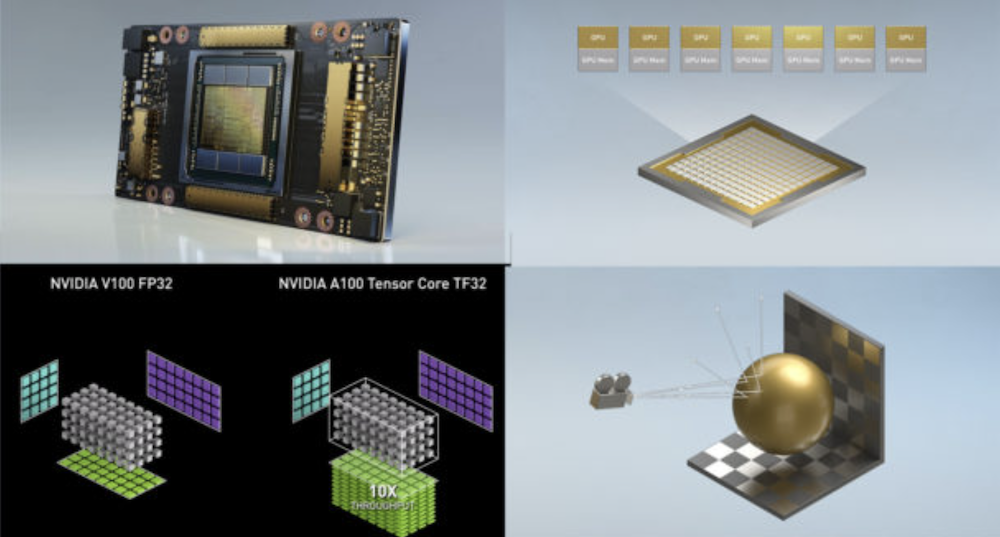
NVIDIA CUDAの仕組みは、GPU上で大量のスレッドを同時に実行し、高速な並列処理を可能にする点にあります。並列処理を高速化できるのは、NVIDIA CUDA対応GPUが数千の小さなコアを持ち、それぞれが独立した処理を実行するためです。
なお、NVIDIA CUDAは、主に以下4つの要素で構成されています。
| 項目 | 内容 |
|---|---|
| CUDA C・C++ | GPU向けの並列処理を記述するためにC・C++を拡張した言語。CPUとGPU両方にまたがるコードを一つのプログラムで書ける。 |
| CUDAランタイム | GPUとのやり取りを担うライブラリ群で、GPUメモリの確保やデータ転送、カーネルの実行などを簡単に扱えるようにする。 |
| CUDAドライバ | GPUをハードウェアとして制御するソフトウェア。プログラム実行時にGPUリソースの割り当てや管理を行う。 |
| CUDAツールキット | GPU開発に必要なツール一式(コンパイラnvcc、デバッガ、性能分析ツールなど)を含む開発用パッケージ。 |
プログラマーがCやPythonなどでCUDA向けのコードを書くと、CPUがそのコードをGPUに渡して実行させる流れです。GPUは多数のスレッドを生成し、各データに対して同時に演算を実行します。
この並列処理構造により、大規模な計算タスクでも高速に処理できるのがNVIDIA CUDAの強みです。
CPUとGPUの役割分担
NVIDIA CUDAのプログラミングモデルは、ホスト(Host:CPU)とデバイス(Device:GPU)という2つの主要な要素を中心に構成されています。
ホスト(CPU)は、プログラム全体の制御を担当します。データの準備やGPU処理の起動指示、結果の受け取りと後処理といった「指揮者」の役割です。複雑な条件分岐や逐次処理が必要な部分はCPUで実行され、プログラムの流れを管理します。
一方、デバイス(GPU)は、大量の計算を並列で処理する「実行部隊」としての役割を担います。数千個のNVIDIA CUDAコアを活用し、同じような演算を一斉に実行することで、行列演算や画像処理といった計算集約的なタスクを高速化できるのが特徴です。
この協調動作の流れは、次のとおりです。
まずホストがCPUメモリからGPUメモリへデータを転送し、GPU上で実行する処理を起動します。デバイスは受け取った指示に従って並列計算を実行し、完了後に結果をホストへ返します。ホストは受け取った結果を使って次の処理に進む、という流れです。
この「CPUが全体を管理し、計算負荷の高い部分だけをGPUに委譲する」という設計こそが、NVIDIA CUDAの高速化を支える基盤となっています。
スレッド・ブロック・グリッドとは?CUDAプログラミングの基本
NVIDIA CUDAの並列処理は、スレッド(Thread)・ブロック(Block)・グリッド(Grid)という3層の階層構造で分けられます。
最小単位であるスレッドが個々の処理を担当し、複数のスレッドがブロックにまとめられ、さらに複数のブロックがグリッドを構成します。同じブロック内のスレッドは「共有メモリ」という高速メモリ領域を使って協調動作が可能です。
例えば、100万要素のベクトル加算では、256スレッド×約3,907ブロックという構成で並列実行します。カーネル関数は<<<グリッドサイズ, ブロックサイズ>>>という特殊な構文で起動され、一気に膨大な数のスレッドが各要素を同時に処理する仕組みです。
// カーネル関数の定義
__global__ void vectorAdd(float *A, float *B, float *C, int N) {
    int i = blockIdx.x * blockDim.x + threadIdx.x;
    if (i < N) C[i] = A[i] + B[i];
}
// カーネル起動(100万要素を256スレッド×約3,907ブロックで処理)
vectorAdd<<<3907, 256>>>(d_A, d_B, d_C, 1000000);開発者は「1つのスレッドが何をするか」を記述するだけで、GPUが自動的に数千〜数万のスレッドを並列実行し、大幅な高速化につながります。
CUDAコアとは?Tensorコアとの違い
CUDAコアとは、NVIDIA製GPUに搭載されている演算用のコアです。一般的な数値計算を幅広く処理するCUDAコアに対し、TensorコアはAIの学習や推論で使われる行列演算の高速化を得意とするのが特徴です。
例えば、AIモデルの学習では、大量の行列演算を効率よく処理するためにTensorコアが役立ちます。ただし、Tensorコアの性能を引き出すには、使用するソフトウェアや計算方式が対応している必要があります。
また、CUDAコア数が多いほど、必ず処理速度が速くなるわけではありません。実際の性能はGPUの世代や動作速度、メモリの転送速度などにも左右されるため、コア数だけでなく用途に合った性能を確認することが大切です。
NVIDIA CUDAを構成する主なコンポーネントと代表ライブラリ
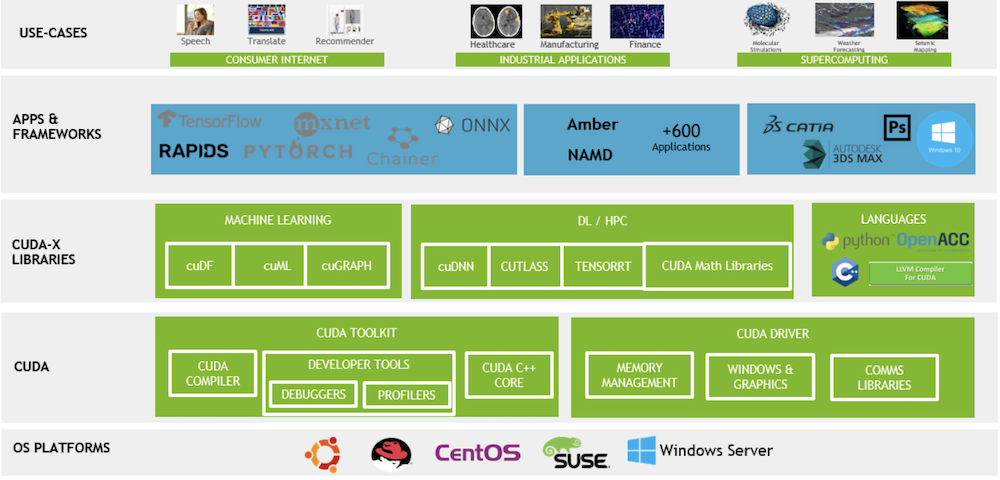
NVIDIA CUDAは、GPU向けの開発環境や実行環境、計算用ライブラリを組み合わせたプラットフォームです。中核となるCUDA Toolkitには、コンパイラのnvccや性能分析に使うNsightツール群、数学ライブラリのcuBLASなどが含まれています。
2026年10月時点のCUDA Toolkitの最新版はCUDA Toolkit 13.4 Update 2です。13.x系では、データをタイルと呼ばれるまとまりで処理するCUDA Tileや、PythonでGPU向けの処理を記述できるcuTile Pythonなどが追加されています。
また、Windows版ではCUDA 13.1以降、NVIDIAドライバがCUDA Toolkitに同梱されなくなりました。そのため、利用する際は対応するGPUドライバを別途インストールする必要があります。
CUDA-Xには、ディープラーニング向けのcuDNNやAI推論向けのTensorRT、データ処理向けのcuDFなどがあります。PyTorchやTensorFlowといったAI開発ツールから対応ライブラリを利用できるため、CUDA向けのコードを直接書かずにGPU計算を実行することも可能です。
CUDA ToolkitとCUDA-Xライブラリの関係
CUDA Toolkitは、GPU開発の土台となる開発環境です。コンパイラ・デバッガ・プロファイラ・基本的な数学ライブラリを含みます。
一方、CUDA-Xライブラリは、この土台の上に構築された専門分野特化型のライブラリ群です。CUDA Toolkitの基本ライブラリを内部で活用しながら、さらに高度な機能を提供しています。
実際の開発では、PyTorch・TensorFlow → cuDNN・TensorRT → cuBLAS・cuFFT → CUDA Toolkitという階層構造で利用されます。
ほとんどの開発者は高レベルフレームワークを使うだけで自動的に最適化されたGPU処理が実行され、独自アルゴリズムを実装したい専門家のみがCUDA Toolkitで直接カーネル関数を記述するのが一般的です。
NVIDIA CUDAが活用される分野
NVIDIA CUDAが活用されるのは、おもに以下3つの分野です。
- 機械学習・ディープラーニング
- 画像・動画処理
- 数値的なシミュレーション
それぞれの分野におけるNVIDIA CUDAの活用法について、以下で詳しくみていきましょう。
機械学習・ディープラーニング
NVIDIA CUDAは、機械学習・ディープラーニングにおいて、大量の並列計算や行列演算を高速に処理するために活用されています。GPUの並列演算能力を最大限に引き出すことで、膨大なデータを扱う深層学習などの処理時間を大幅に短縮できるためです。
特に、PyTorchやTensorFlowなどの主要なライブラリはNVIDIA CUDAと連携しており、研究から実用化まで幅広いAI開発の基盤となっています。
画像・動画処理
NVIDIA CUDAは、画像や動画処理において、処理の高速化や高精度化を果たす目的でも活用されています。たとえば、ノイズ除去や画像の鮮明化、リアルタイム映像解析といった演算処理をGPUの並列計算によって効率化可能です。
高解像度映像を扱う際にもフレーム単位で処理が分散されるため、滑らかな動作と短い応答時間を実現できます。映像編集、医用画像処理、監視カメラのリアルタイム分析など、さまざまな現場で導入が進んでいます。
数値的なシミュレーション
NVIDIA CUDAは、数値的なシミュレーションにおいても、処理の高速化や高精度化を果たす目的で活用されています。たとえば、気象予測・流体力学・構造解析など、大量の数値計算を伴うシミュレーションでは、GPUによる並列処理が有効です。
複雑なモデルの演算を同時に行うことで、従来のCPUベースでは数日かかる計算も短時間で完了することが可能になります。工業分野や研究機関では、実験コスト削減や開発期間の短縮にもつながっています。
NVIDIA CUDAを使うための準備と環境構築
NVIDIA CUDAを実際に使い始めるには、適切な環境構築が不可欠です。以下の4ステップで、スムーズにNVIDIA CUDA環境をセットアップできます。
対応GPUの確認
まず、使用しているGPUがNVIDIA CUDAに対応しているか確認しましょう。NVIDIA製GPUの多くがCUDAに対応していますが、GPUの世代によって必要なCUDAバージョンが異なります。
特に、GeForce RTX 50シリーズはBlackwell世代に該当し、CUDA Toolkit 12.8以降が必要です。主なGPUシリーズと対応バージョンは以下のとおりです。
| GPUシリーズ | 発売時期 | アーキテクチャ | 対応するCUDAバージョンの目安 |
|---|---|---|---|
| GeForce RTX 50シリーズ | 2025年〜 | Blackwell | CUDA 12.8以降 |
| GeForce RTX 40シリーズ | 2022年〜 | Ada Lovelace | CUDA 11.8以降 |
| GeForce RTX 30シリーズ | 2020年〜 | Ampere | CUDA 11.1以降 |
| GeForce RTX 20シリーズ | 2018年〜 | Turing | CUDA 10.0以降 |
| NVIDIA A100 | 2020年〜 | Ampere | CUDA 11.0以降 |
| NVIDIA H100 | 2022年〜 | Hopper | CUDA 11.8以降 |
| NVIDIA B200 | 2024年発表 | Blackwell | CUDA 12.8以降 |
なお、表の数値は、各GPU世代への対応が始まったCUDA Toolkitのバージョンを示しています。実際に利用する際は、GPUドライバやAI開発ツールとの互換性も確認する必要があります。
使用中のGPU名は、Windowsなら「タスクマネージャー」を開き、「パフォーマンス」タブから「GPU」を選択すると確認可能です。Linuxでは、nvidia-smiコマンドを使って確認しましょう。
最新ドライバのインストール
NVIDIAドライバは、CUDAとGPUの橋渡しをする重要なソフトウェアです。使用するCUDA Toolkitのバージョンに対応したドライバをインストールする必要があります。
CUDA Toolkit 13.x系では、バージョンごとに対応するドライバの系列が異なります。2026年10月時点の主な対応関係は以下のとおりです。
| CUDAバージョン | 対応ドライバ系列 |
|---|---|
| CUDA 13.4 | R615 |
| CUDA 13.3 | R610 |
| CUDA 13.2 | R595 |
| CUDA 13.1 | R590 |
| CUDA 13.0 | R580 |
なお、CUDA 13.x系のアプリは、一定の互換性条件を満たす場合、R580以上のドライバでも動作します。ただし、新しい機能や実行時にGPU向けのコードをコンパイルする処理では、対応する新しいドライバが必要になる場合があります。例えば、CUDA 13.4で追加された機能を利用する場合は、対応するR615以降のドライバを確認しましょう。
NVIDIA公式サイトから、使用するGPUに対応したドライバをダウンロードしてインストールします。インストール後は、nvidia-smiコマンドでGPU名やドライバのバージョンを確認しましょう。
nvidia-smiに表示されるCUDA Versionは、ドライバが対応するCUDAのバージョンを示しています。実際にインストールされているCUDA Toolkitのバージョンとは異なるため、混同しないように注意してください。
CUDA Toolkitのインストール
最も重要なのは、使用するAIフレームワーク(PyTorch、TensorFlowなど)が推奨するNVIDIA CUDAバージョンを確認し、それに合わせてインストールすることです。バージョンが合わないと、GPUが認識されない、学習が進まないといったトラブルが起こりやすくなります。
| フレームワーク | 対応CUDAバージョン | 追加要件 | 公式サイト |
|---|---|---|---|
| PyTorch 2.14.1 | CUDA 12.6、13.0、13.2 | Python 3.10以降 | PyTorch |
| TensorFlow 2.21.0 | CUDA 12.5 | cuDNN 9.3 | TensorFlow |
NVIDIA CUDA Toolkit公式ページから、対応バージョンをダウンロードしてインストールしましょう。インストール後、以下のコマンドでバージョンを確認できます。
nvcc --version # CUDA Toolkitのバージョン確認サンプルコード・ベンチマークの実行
環境構築が完了したら、動作確認を兼ねてサンプルコードやベンチマークを実行します。
PyTorchでの確認例は、以下のとおりです。
import torch
print(torch.cuda.is_available())  # True なら成功
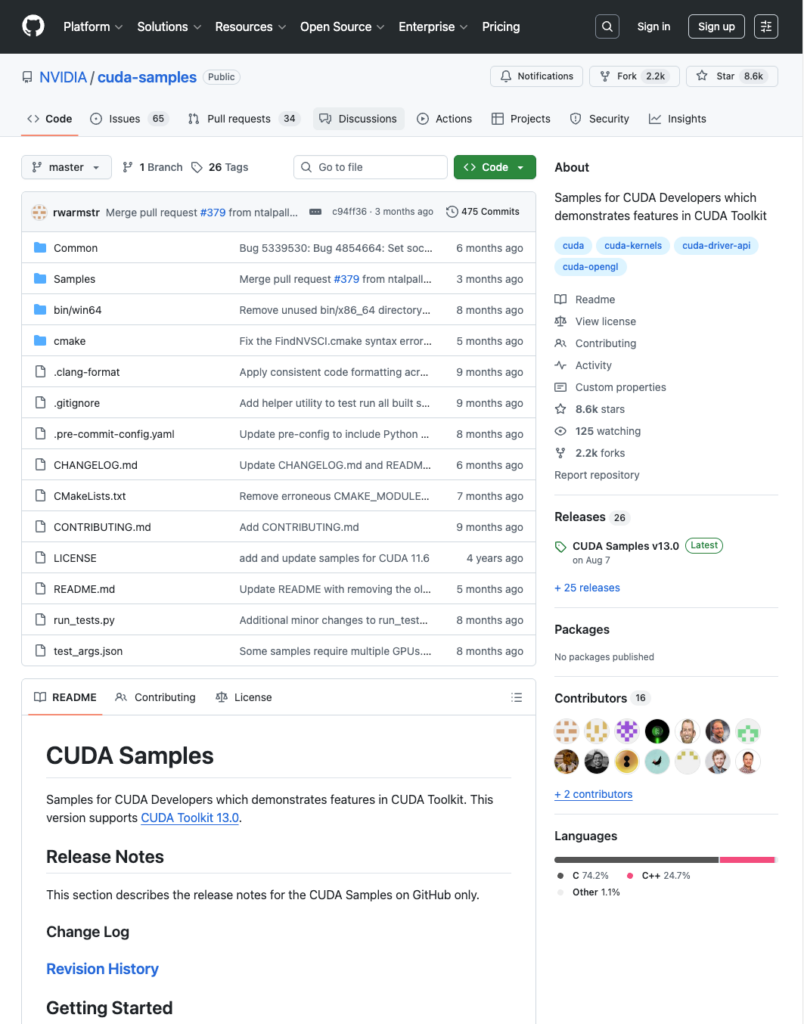
print(torch.cuda.get_device_name(0)) # GPU名を表示NVIDIAは、CUDAのサンプルプログラムをGitHubで公開しています(CUDA 11.6以降はCUDA Toolkitに同梱されていません)。
例えば、deviceQueryサンプルはGPU情報を詳細に表示し、bandwidthTestはメモリ転送速度をベンチマークできます。
これらのステップを踏むことで、NVIDIA CUDA環境が正しく構築され、本格的なGPU開発やAI学習をスタートできます。
GPUが認識されないときの確認ポイント
RTX 5060 Tiなどの新しいGPUでは、古いPyTorchやCUDA対応版を使用していると、画像生成ツールでGPUを使えない場合があります。RTX 50シリーズはBlackwell世代のGPUに該当し、CUDA 12.8以降に対応しています。
PyTorchを使う場合は、Blackwell世代をサポートするCUDA対応版を選びましょう。古いPyTorchではGPUを認識できても、計算時にエラーが発生する可能性があります。
GPUが正常に動作しない場合は、以下の手順で確認しましょう。
nvidia-smiコマンドを実行し、GPU名とドライバのバージョンが表示されるか確認します。
画像生成ツールと同じPython環境でtorch.cuda.is_available()を実行してみましょう。Falseの場合は、CUDAに対応していないPyTorchがインストールされている可能性があります。
torch.version.cudaでPyTorchのCUDAバージョンを確認します。古いバージョンを使用している場合は、公式サイトから対応するPyTorchを導入しましょう。
なお、GPUを認識していても、古いライブラリでは計算時にエラーが発生することがあります。改善しない場合は、画像生成ツール自体の対応状況も確認してください。
なお、Stable Diffusionの環境構築やエラーの対処方法について詳しく知りたい方は、下記の記事も併せてご確認ください。
NVIDIA CUDAのデメリット
NVIDIA CUDAを使うことで得られる恩恵は多くありますが、その一方でNVIDIA CUDAのデメリットも存在します。ここではNVIDIA CUDAのデメリットをいくつか紹介します。
ベンダーロックイン(NVIDIA GPU専用)
CUDAはNVIDIA製GPU専用で、AMDやIntelのGPUでは動作しません。
一度CUDAベースのシステムを構築すると、他社GPUへの移行が困難になるベンダーロックインが生じる点に注意が必要です。
ただし、AMD ROCmやIntel oneAPI、Modularなどマルチベンダー対応の技術も登場しています。PyTorchやTensorFlowといった高レベルフレームワークを使えば、低レベルCUDA依存を抑えて将来的な移行可能性を残せます。
GPU本体の価格が高い
最新世代GPUは高価です。
2025年発売のRTX 50シリーズの発売時の国内参考価格は、RTX 5070が約108,800円からRTX 5090が約550,000円を超えるものまで。データセンター向けGPU(A100・H100など)は数百万円規模です。
初期投資を抑えるには、AWSやGCPのクラウドGPUやスポットインスタンス(AWSではオンデマンド料金から最大90%割引)を活用する方法があります。
学習コストと独自の考え方が必要
並列化設計やメモリ転送の最適化など、GPU特有の考え方を理解する必要があり、CPU向けプログラミングとは異なる学習コストがかかります。
初心者はPyTorchやTensorFlowから始め、NVIDIA Deep Learning Instituteなどの公式リソースで段階的に学ぶのが効率的です。
古いGPUは新CUDA Toolkitで非サポート化
NVIDIAは定期的に古いGPU世代のサポートを終了します。CUDA Toolkit 13.0以降では、Maxwell、Pascal、Voltaがサポート対象外です。古いGPUを使う場合はCUDA Toolkit 12.9以前を利用するか、GPUアップグレードやクラウドGPU移行を検討する必要があります。
NVIDIA CUDAと他GPUプラットフォームの違い
NVIDIA CUDAがGPUコンピューティング市場で圧倒的なシェアを持つ一方で、ベンダーロックインへの懸念から、マルチベンダー対応を目指す動きも活発化しています。
ここでは主要な代替技術と、それらがNVIDIA CUDAとどう異なるのかを解説します。
主要な代替GPUプラットフォーム
AMD ROCmは、AMDが提供するオープンソースのGPUコンピューティングプラットフォームです。
CUDAコードを移植するための互換レイヤーを備えており、AMD製GPUでの並列計算を可能にします。
Intel oneAPIは、GPU・CPU・FPGAなど複数のハードウェアに対応したオープンスタンダード。SYCLというC++ベースの並列プログラミング言語を採用し、Intel製GPUだけでなく、他社ハードウェアでも動作する移植性の高さが特徴です。
OpenCLはクロスプラットフォームの並列計算標準として長年存在していますが、NVIDIA CUDAに比べて開発者向けツールやライブラリのエコシステムが限定的で、実務での採用は限られています。
CUDA依存を減らすミドルウェアの動き
特定のGPUベンダーに依存しないマルチベンダー向けソフトウェアレイヤーが登場しています。
Modularは、複数のハードウェアアーキテクチャに対応した新世代AIコンパイラとして注目されている技術です。NVIDIA・AMD・Intelのいずれのプラットフォームでも動作するコードを記述できる将来性が期待されています。
また、ONNX Runtimeのように、学習済みモデルを異なるハードウェア間で相互運用できるフレームワークも普及しつつあり、NVIDIA CUDAへの直接依存を減らす選択肢が増えています。
NVIDIA CUDAをこれから学びたい人向けロードマップ
NVIDIA CUDAの学習は、いきなり低レベルのGPUプログラミングから始める必要はありません。まずは前述の「NVIDIA CUDAを使うための準備と環境構築」から進めていきましょう。
環境構築ができたら、「PyTorch・TensorFlowでCUDAを使う」「CUDAサンプルを動かす」「カーネル・スレッド・メモリモデルを学ぶ」の順に学習を進めるのがおすすめです。
PyTorch・TensorFlowでCUDAを使ってみる
次に、PyTorchやTensorFlowなど高レベルフレームワークをインストールし、GPU処理を体験します。以下のコードでGPUが認識されているか確認できます。
import torch
print(torch.cuda.is_available())  # Trueなら成功
print(torch.cuda.get_device_name(0))  # GPU名を表示
この段階では、NVIDIA CUDAの内部動作を意識する必要はありません。
フレームワークが自動的にcuDNNやcuBLASを呼び出し、GPU処理を最適化してくれます。画像分類や自然言語処理のチュートリアルを実行して、CPUとGPUの速度差を体感してみましょう。
CUDAサンプルを動かす
NVIDIA公式のCUDAサンプルからdeviceQueryやbandwidthTestなどの基本サンプルを実行します。これらのサンプルは、GPUの仕様やメモリ転送速度を確認できるため、GPU性能の把握に役立ちます。
カーネル・スレッド・メモリモデルを学ぶ
ここから、CUDA独自の並列処理モデルを学びます。
スレッド・ブロック・グリッドの階層構造やホスト(CPU)とデバイス(GPU)の役割分担、グローバルメモリと共有メモリの違いなど、GPU特有の概念を理解しましょう。
簡単なベクトル加算や行列積のカーネルを自分で記述してみることで、並列化設計の基礎を習得できます。
CUDA C++の基本文法と、<<<グリッドサイズ, ブロックサイズ>>>による起動構文にも慣れていきましょう。
生成AI開発・業務活用ならWEELへご相談ください
クラウドに依存せず、社内環境でAIを動かしたいというニーズが高まっています。並列処理の仕組みを活用すれば、大規模な計算も効率よく実行可能に。運用環境に合わせた最適な構成を検討してみませんか?
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。
NVIDIA CUDAに関するよくある質問