【EmbeddingGemma 2】スマホで動くGoogleのマルチモーダル埋め込みモデルの性能・使い方を徹底解説
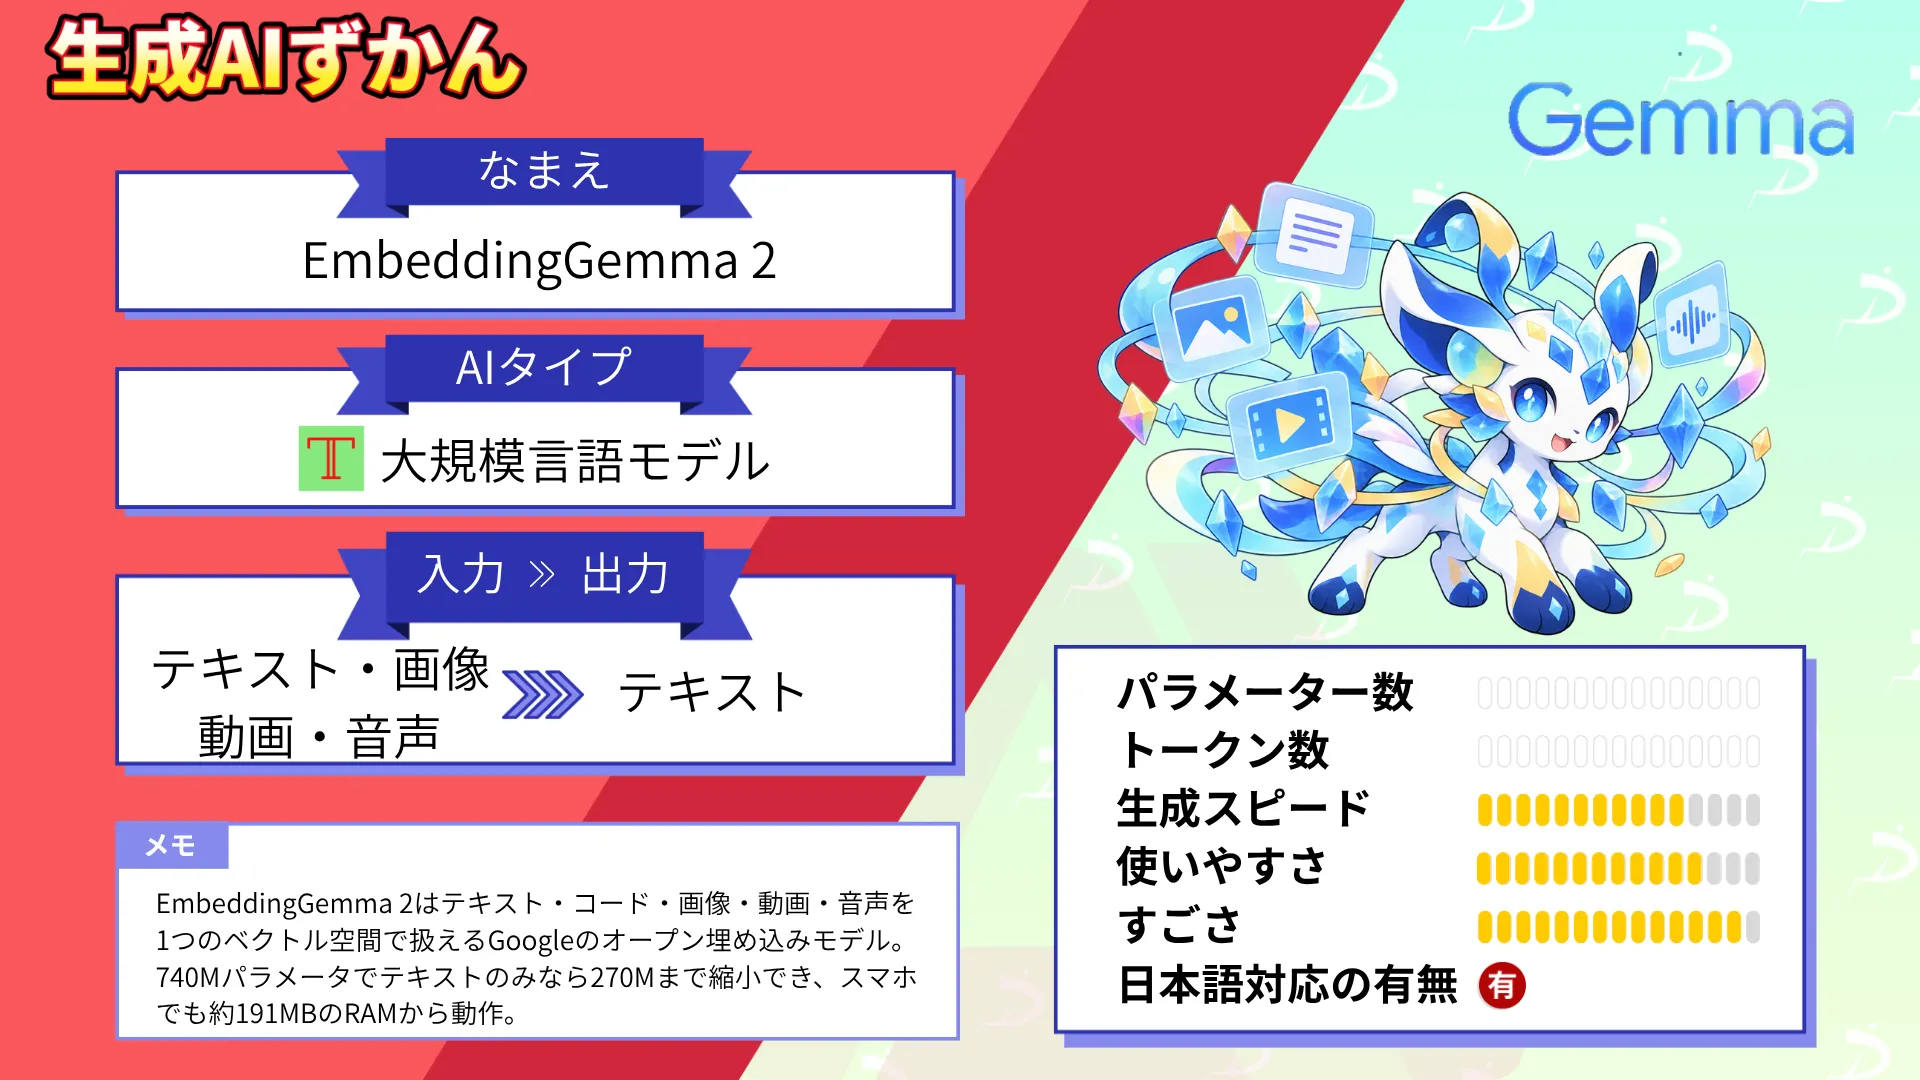
- EmbeddingGemma 2はテキスト・コード・画像・動画・音声を1つのベクトル空間で扱えるGoogleのオープン埋め込みモデル
- 740Mパラメータでテキストのみなら270Mまで縮小でき、スマホでも約191MBのRAMから動作
- Apache 2.0ライセンスで商用利用も可能、Hugging Face・Ollama・ブラウザから無料で試せる
2026年10月7日、Google DeepMindがオープンな埋め込みモデル「EmbeddingGemma 2」を公開しました!
テキストだけでなく、コード・画像・動画・音声まで同じベクトル空間に変換できるGoogle初のオープンかつネイティブなマルチモーダル埋め込みモデルです。しかもテキスト用途なら約191MBのRAMで動き、スマートフォンの中だけで「写真や動画を言葉で探す」検索が組めてしまいます。
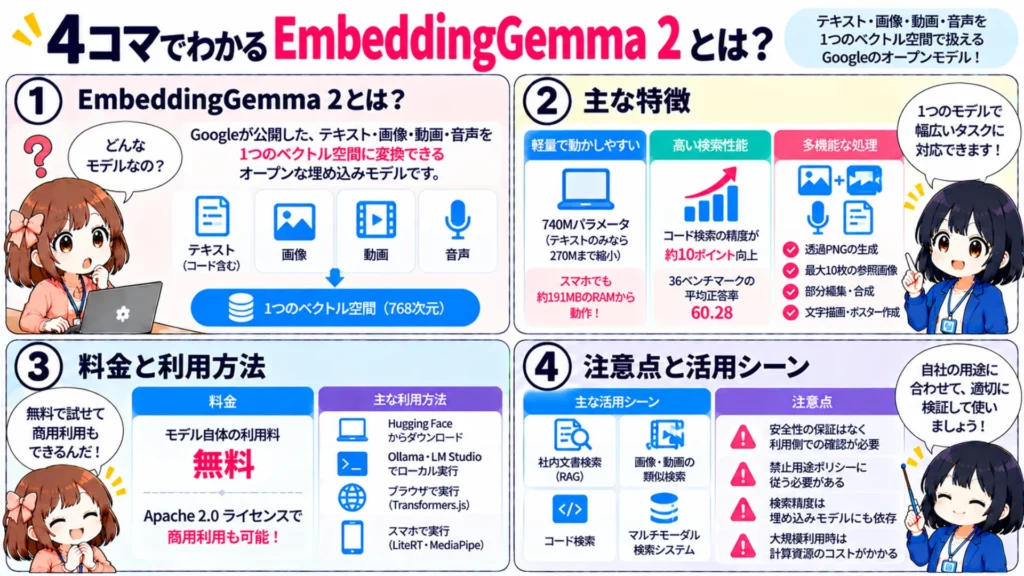
とはいえ「埋め込みモデルって何に使うの?」「日本語の社内データでも精度は出る?」と気になっている方も多いのではないでしょうか。
この記事では、EmbeddingGemma 2の概要・仕組み・ベンチマーク・料金・ライセンス・使い方を詳しく解説します。最後まで読めば、手元のデータを外部に出さずに検索できる仕組みづくりのヒントが手に入ります。
\生成AIを活用して業務プロセスを自動化/
EmbeddingGemma 2とは?
EmbeddingGemma 2は、Google DeepMindが開発した総パラメータ数740Mの軽量なマルチモーダル埋め込みモデルです。テキスト(コードを含む)・画像・動画・音声を、単体でも組み合わせても1つの768次元ベクトル空間へマッピングします。
公式ブログによると、前世代のEmbeddingGemmaは公開から2,000万回以上ダウンロードされた人気モデルでした。初代はテキスト専用でしたが、2世代目ではGemma 4のアーキテクチャをベースに画像・動画・音声まで守備範囲を広げています。
EmbeddingGemma 2の仕組み
EmbeddingGemma 2は、Gemma 4由来のテキストモデルを土台に、画像と音声の専用エンコーダーを「後付けできる部品」として組み合わせた構造です。
モジュール式の3つの部品で構成される
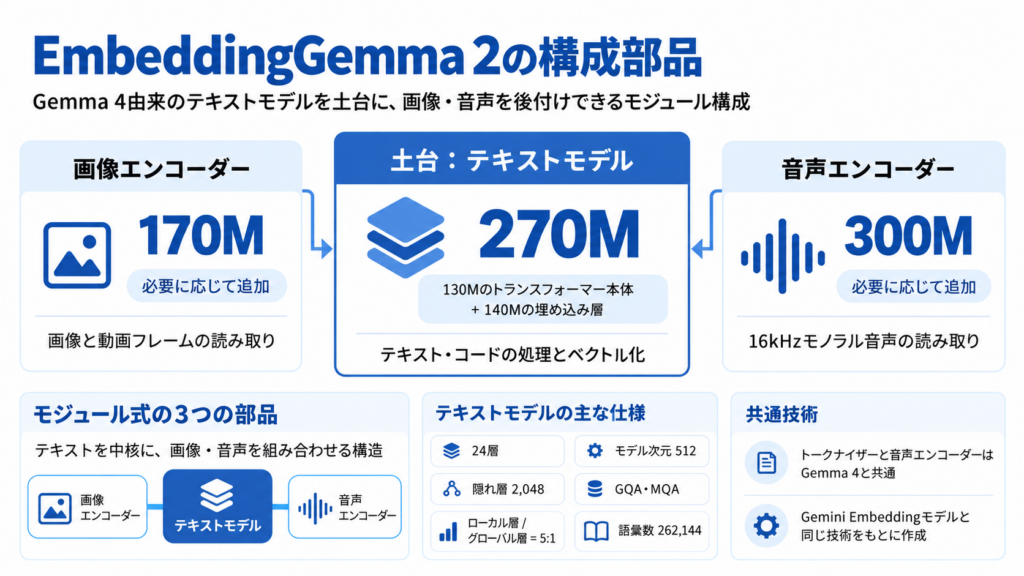
EmbeddingGemma 2の中核は、130Mのトランスフォーマー本体と140Mの埋め込み層からなる270Mのテキストモデルです。ここに170Mの画像エンコーダーと300Mの音声エンコーダーを必要に応じて足せるモジュール構成になっています。
モデルカードによると、テキストモデルは24層で、モデル次元は512、隠れ層の次元は2,048です。注意機構にはGQA・MQAを採用し、近くの文脈だけを見るローカル層と全体を見るグローバル層を5対1の比率で並べています。
語彙数は262,144で、テキストのトークナイザーと音声エンコーダーはGemma 4と共通です。公式ブログでは、Gemini Embeddingモデルと同じ技術をもとに作られたとも説明されていました。
| 構成部品 | パラメータ数 | 役割 |
|---|---|---|
| テキストモデル(本体+埋め込み層) | 270M(130M+140M) | テキスト・コードの処理とベクトル化 |
| 画像エンコーダー | 170M | 画像と動画フレームの読み取り |
| 音声エンコーダー | 300M | 16kHzモノラル音声の読み取り |
入力からベクトルが出力されるまでの流れ
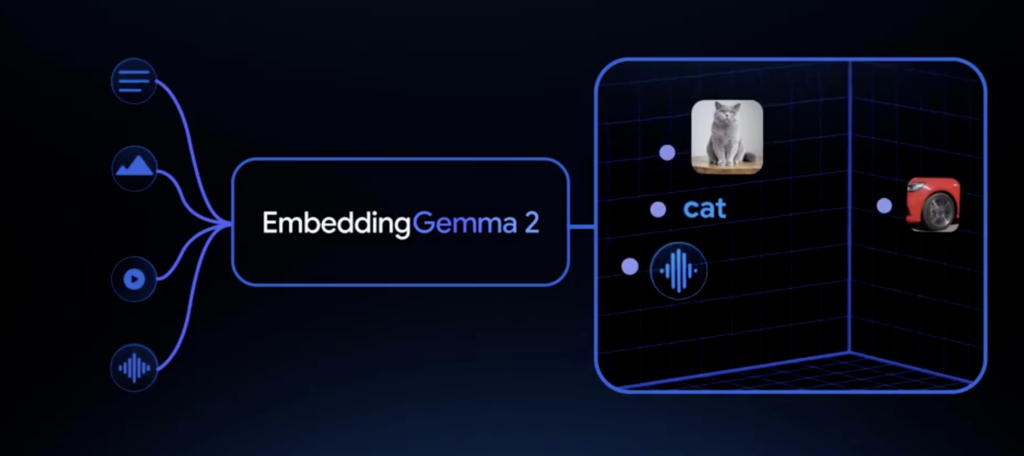
画像や音声は、まず各エンコーダーで「ソフトトークン」と呼ばれる中間表現に変換されます。画像は1枚あたり標準280トークン、動画は1フレームあたり140トークン、音声は1秒あたり25トークンの計算です。
トークン化されたデータはテキストと同じ8,192トークンの枠を共有し、テキストモデルでまとめて処理されます。そのあと全トークンの出力を平均する「平均プーリング」と、512次元から768次元への射影を経て、最終的な埋め込みベクトルが出力される仕組みです。
すべての入力が同じテキストモデルを通るため、「夕焼けの海」という文章と夕焼けの海の写真が近いベクトルになるのがポイントでしょう。テキストの中に<|image|>や<|audio|>といった目印を入れれば、商品説明文と写真と動画をまとめて1本のベクトルにすることもできます。
Matryoshka表現学習でベクトルを短くできる
もう1つのポイントが、Matryoshka Representation Learning(MRL)という学習方法です。ロシアの入れ子人形のように、768次元ベクトルの先頭部分だけを切り出しても意味がなるべく保たれるよう訓練されています。
切り出せるサイズは512・256・128次元の3種類です。128次元まで短くすると、ベクトルの保存容量を最大6分の1に減らせます。
ただし、切り出したあとは長さを1にそろえる再正規化が欠かせません。モデルカードでは、これを忘れるとエラーが出ないまま検索順位の質が静かに落ちると注意されていました。
EmbeddingGemma 2の特徴
EmbeddingGemma 2の強みは、1B未満という小ささと幅広いモダリティ対応を両立している点です。ここからはベンチマークの数値や前世代との比較から、性能面の特徴を深掘りしていきます。
コード検索の性能が前世代から約10ポイント向上
テキスト系で目立つのがコード検索の伸びです。コード検索ベンチマークのMTEB(Code)では、前世代の68.76から78.68へと9.92ポイント上昇しました。割合にすると約14%の向上となります。
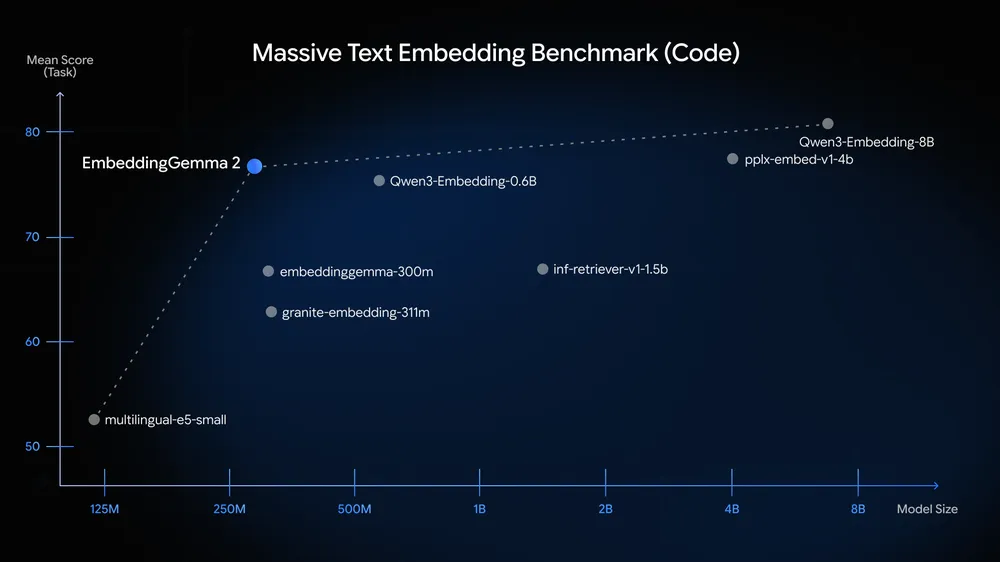
一方で、多言語テキストのMTEB(Multilingual)は61.15から61.36とほぼ同水準でした。テキスト本体のパラメータは前世代の約300Mから270Mへ小さくなっています。サイズを削りながら多言語性能を保ち、コード性能を大きく伸ばしたわけです。
| モダリティ | ベンチマーク | EmbeddingGemma 2 | EmbeddingGemma(初代) |
|---|---|---|---|
| テキスト | MTEB(多言語 v2) | 61.36 | 61.15 |
| テキスト | MTEB(コード v1) | 78.68 | 68.76 |
| 画像 | MIEB(lite) | 64.64 | ― |
| 画像 | MMEB v2(Image) | 57.28 | ― |
| 画像 | MMEB v2(VisDoc) | 67.84 | ― |
| 動画 | MMEB v2(Video) | 50.67 | ― |
| 音声 | MSEB(Retrieval) | 69.54 | ― |
| 音声 | MAEB | 49.39 | ― |
2倍以上大きい専用モデルに迫るマルチモーダル性能
画像・動画・音声のスコアは、初代がテキスト専用だったため比較対象がありません。そのかわり公式ブログでは、1B未満のマルチモーダル埋め込みモデルの中でトップクラスのスコアを記録したと説明されています。
さらに、2倍以上のサイズを持つ一部の専用モデルを上回ったとも紹介されていました。画像の文書ページを探すMMEB v2(VisDoc)で67.84、音声検索のMSEB(Retrieval)で69.54という数値は、740Mという小ささを考えると十分に実用的といえるでしょう。
256次元まで縮めても精度はほぼ維持
MRLによる次元削減の効き方も公開されています。256次元まで縮めた場合、MTEB(多言語)は61.36から60.41への低下にとどまりました。
| 次元数 | 圧縮率 | MTEB(多言語) | MTEB(英語) | MTEB(コード) | MIEB(lite) | MMEB v2全体 | MSEB |
|---|---|---|---|---|---|---|---|
| 768 | 1:1 | 61.36 | 68.46 | 78.68 | 64.64 | 59.01 | 69.54 |
| 512 | 1:1.5 | 61.17 | 68.41 | 77.24 | 64.32 | 58.38 | 69.18 |
| 256 | 1:3 | 60.41 | 67.78 | 76.18 | 63.13 | 56.24 | 66.76 |
| 128 | 1:6 | 57.89 | 65.68 | 71.41 | 59.06 | 45.65 | 56.71 |
128次元になると、マルチモーダル全体を測るMMEB v2が59.01から45.65へ大きく下がります。モデルカードでも、128次元はテキスト中心の用途向けで、マルチモーダルでは事前の検証が必要だと注意されていました。画像や音声を扱うなら256次元以上が無難です。
EmbeddingGemma 2の安全性・制約
EmbeddingGemma 2はオープンモデルのため、安全対策の多くを利用する側が担う必要があります。
モデルカードによると、EmbeddingGemma 2は事前学習のみのモデルで、事後のアライメントや安全性チューニング、出力のモデレーションは行われていません。安全面の取り組みは、学習データの段階でのフィルタリングが中心です。
学習データには、児童性的虐待に関わるデータ(CSAM)の除外や、機微な個人データを取り除く自動フィルタリングが複数の段階で適用されました。そのうえで、検索結果のフィルタリングや公平性のテストといったアプリ側の安全策は、開発者の責任とされています。利用にあたっては、Gemmaの禁止用途ポリシーに従う必要もあるでしょう。
EmbeddingGemma 2の料金
EmbeddingGemma 2はオープンウェイトのモデルのため、モデルそのものの利用料はかかりません。どこで動かすかによって、発生するコストの種類が変わる点を押さえておきましょう。
| 利用方法 | 料金 | 備考 |
|---|---|---|
| Hugging Face・Kaggleから重みをダウンロード | 無料 | Apache 2.0で公開 |
| Ollama・LM Studioなどでローカル実行 | 無料 | PCの電気代などは自己負担 |
| ブラウザで実行(Transformers.js・WebGPU) | 無料 | 初回のみモデルのダウンロードが発生 |
| スマホで実行(LiteRT・MediaPipe) | 無料 | 端末上で処理が完結 |
| Gemini Enterprise Agent PlatformのModel Garden | 未公表 | 2026年10月時点で「近日提供予定」 |
| 自社のクラウド環境でホスティング | クラウドの計算資源料金 | GPU・CPUの利用時間に応じて変動 |
EmbeddingGemma 2なら社内PCや既存のサーバーで回せるため、大量の文書を何度作り直しても追加費用を気にせずに済むでしょう。
EmbeddingGemma 2のライセンス
EmbeddingGemma 2のライセンスは、オープンソースで広く使われているApache 2.0です。
| 利用用途 | 可否 | 条件・備考 |
|---|---|---|
| 商用利用 | ⭕️ | 自社サービスや業務システムへの組み込みも可能 |
| 改変 | ⭕️ | ファインチューニングも可、変更したファイルには変更の旨を明記 |
| 配布 | ⭕️ | ライセンス文と著作権表示の同梱が必要 |
| 特許使用 | ⭕️ | 貢献者から特許ライセンスが付与される(特許訴訟を起こすと終了) |
| 私的使用 | ⭕️ | 個人の学習や検証にも自由に使える |
注意したいのは、ライセンスが自由でも使い方まで無制限ではない点です。モデルカードでは、導入にあたってGemmaの禁止用途ポリシーに従うよう求めています。
EmbeddingGemma 2の使い方
EmbeddingGemma 2は、Python・Ollama・ブラウザ・スマホアプリなど、さまざまな方法で動かせます。ここでは代表的な3つの方法を、実際のコマンドやコード付きで順番に紹介していきましょう。
Sentence Transformers(Python)で使う方法
もっとも機能がそろっているのが、Pythonのライブラリ「Sentence Transformers」を使う方法です。
ライブラリインストール
まずはライブラリをインストールしましょう。画像・音声・動画も扱う場合は、オプション付きで入れるのがポイントです。Sentence Transformersはv6.1.0以降が必要で、transformersも最新版に更新しておきます。
pip install -U "sentence-transformers[image,audio,video]" transformersテキスト検索実行
次は、テキストで検索を試してみましょう。検索クエリにはSearchQuery、検索対象の文書にはDocumentという接頭辞を指定すると、モデルが用途に合ったベクトルを出してくれます。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query = "オーロラはなぜ発生するの?"
document = "オーロラは、太陽から届く荷電粒子が大気中のガスにぶつかって光る現象です。"

query_emb = model.encode(query, prompt_name="SearchQuery")
doc_emb = model.encode(document, prompt_name="Document")

print(model.similarity(query_emb, doc_emb))
画像・音声入力
画像や音声は、辞書形式で渡すだけでベクトル化が可能です。文章で写真や音声を探す「クロスモーダル検索」も、わずか数行で書けるのは魅力でしょう。
image_emb = model.encode({"image": "sunset_beach.jpg"})
audio_emb = model.encode({"audio": "ocean_waves.wav"})
query_emb = model.encode("夕暮れの海の波", prompt_name="SearchQuery")

print(model.similarity(query_emb, image_emb))
print(model.similarity(query_emb, audio_emb))テキストのみ
テキストしか使わない場合は、画像と音声のエンコーダーを外して読み込むとメモリを節約できます。ベクトルを短くしたいときは、truncate_dimを指定しましょう。
# テキストのみ(270M)で読み込む
text_model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"vision_config": None, "audio_config": None},
)

# 256次元に短縮して出力する
query_emb = text_model.encode(
    "オーロラはなぜ発生するの?",
    prompt_name="SearchQuery",
    truncate_dim=256,
    normalize_embeddings=True,
)
同じチェックポイントから読み込んだモデル同士は、同じベクトル空間を共有しています。テキストのみで作ったクエリのベクトルを、フル版で作った画像のベクトルと比べても問題ありません。
なお、GPUで動かすときはfloat16ではなくbfloat16かfloat32を指定してください
Ollamaでローカル実行する方法
コマンド1つで手軽に動かしたいなら、Ollamaが便利です。Ollamaのライブラリには270m・440m・570m・740mの4つのタグがあり、画像入力に対応するのは440mと740mとなっています。
モデルダウンロード
まずはOllamaを最新版にアップデートし、モデルをダウンロードしましょう。
ollama pull embeddinggemma-2テキストだけで十分なら、軽量な270mのタグを指定するのがおすすめです。
ollama pull embeddinggemma-2:270mクエリ実行例
ダウンロードが終わったら、OllamaのAPIにテキストを送るとベクトルが返ってきます。検索クエリには、モデルカードで推奨されている接頭辞を付けておきましょう。
curl http://localhost:11434/api/embed -d '{
  "model": "embeddinggemma-2",
  "input": "task: search result | query: 有給休暇の申請方法"
}'ブラウザ(Transformers.js)で動かす方法
サーバーを用意せずに試したい方には、ブラウザ上で動かす方法がぴったりです。Hugging Faceのonnx-communityが、ブラウザ向けに変換したモデルを公開しています。
Transformers.jsインストール
まずはnpmでTransformers.jsをインストールしてください。
npm i @huggingface/transformersコード実行
続いて、WebGPUを使って検索のスコアを計算するコードです。ブラウザでは4bit量子化のq4が推奨されており、ダウンロードサイズはフル精度の約6分の1に収まります。
import { pipeline, matmul } from "@huggingface/transformers";

const extractor = await pipeline(
  "feature-extraction",
  "onnx-community/embeddinggemma-2-ONNX",
  { device: "webgpu", dtype: "q4" }
);

const query = "task: search result | query: 赤い惑星と呼ばれるのはどれ?";
const docs = [
  "title: none | text: 金星は大きさが地球に近く、地球の双子と呼ばれます。",
  "title: none | text: 火星は赤っぽく見えることから、赤い惑星と呼ばれます。",
];

const emb = await extractor([query, ...docs], { pooling: "mean", normalize: true });
const scores = (await matmul(emb.slice([0, 1]), emb.slice([1, null]).transpose(1, 0))).tolist()[0];
console.log(scores);
コードを書かずに雰囲気をつかみたいなら、Hugging Face Spacesのデモ「Embed Anything」を開くだけでも試せるのでおすすめです。
初回はモデルのダウンロードに少し時間がかかるものの、2回目以降はキャッシュから素早く読み込まれます。
【業界別】EmbeddingGemma 2の活用シーン
EmbeddingGemma 2は、データを外に出さずに意味検索ができるため、機密情報を扱う業界ほど相性がよいモデルです。ここからは業界ごとに、向いている使い方を紹介します。
小売・EC
ECサイトでは、商品名に含まれない言葉で探されることが少なくありません。EmbeddingGemma 2は商品説明・商品写真・紹介動画をまとめて1本のベクトルにできるため、「雨の日でも滑りにくいスニーカー」のような曖昧な検索にも強くなります。
また、128〜256次元に短縮すれば、数十万点規模の商品データでもベクトルの保存容量を抑えられるのが強みです。似た商品のレコメンドや重複出品の検出にも応用しやすいでしょう。
小売業における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
金融・保険
金融や保険の業界では、顧客情報を含む文書をクラウドAPIに送ることに慎重な企業も多いはずです。EmbeddingGemma 2は社内サーバーや業務PCの中だけでベクトル化が完結するため、情報管理の方針と両立しやすくなります。
約款や社内規程、過去の問い合わせ記録をベクトル化しておけば、窓口担当者が質問に近い資料をすぐに探せるでしょう。Gemma 4などのローカルLLMと組み合わせれば、外部に通信しないRAGも構築できます。
上位モデルが分析の方針を決め、Haiku 5.5が複数の資料を並行して読み込み、該当箇所を集めてくる分担が向いているでしょう。AlphaSenseの「Ask in Document」でも、Haiku 4.5を統計的に有意に上回る精度が確認されました。最終的な投資判断や数値の検証は人が担う前提で、下調べの時間を短くする使い方がおすすめです。
金融業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
ソフトウェア開発
コード検索のベンチマークで大きく性能を伸ばしたことから、開発の現場とも相性は抜群です。公式ブログでも、ローカルでのコードベースのインデックス作成や、コーディングエージェントの検索用途が挙げられていました。
「認証まわりでリトライしている箇所」のように、関数名がわからなくても自然な言葉でコードを探せるのがポイントです。ソースコードを外部サービスに送らずに済むため、セキュリティ要件の厳しいプロジェクトでも導入を検討しやすいでしょう。
生成AIを搭載したSaaSについて、詳しく知りたい方は以下の記事も参考にしてみてください。

【課題別】EmbeddingGemma 2が解決できること
EmbeddingGemma 2は、検索・分類・データ管理にまつわる「よくある困りごと」に効くモデルです。ここからは解決できる課題ごとに、どのように役立つのかを整理しました。
機密データを外部に送らずに意味検索できる
クラウドの埋め込みAPIを使うと、検索対象の文書をすべて外部サーバーへ送る必要があります。社外秘の資料や個人情報を含むデータでは、この点が導入のハードルになりがちでした。
EmbeddingGemma 2は端末やオンプレミス環境の中だけでベクトル化できるため、データを一切外に出さずに意味検索を実現できます。公式ブログでも、ローカルで埋め込みを生成することがデータプライバシーの保護につながると説明されていました。
画像・動画・音声をテキストと同じ感覚で探せる
従来の社内検索では、写真や動画にファイル名やタグを手作業で付けないと探せませんでした。タグ付けの手間がかかるうえ、付け忘れたデータは事実上「埋もれた資産」になってしまいます。
EmbeddingGemma 2なら、文章で写真を、写真で似た写真を探すといった検索がタグなしで可能です。画像・動画・音声・テキストを1つのモデルで扱えるので、モダリティごとに別のモデルを管理する手間も省けるでしょう。
ベクトルデータベースの容量とコストを抑えられる
RAGを本格運用すると、ベクトルデータベースの保存容量やメモリ使用量が膨らみがちです。開発者ガイドによると、768次元のbfloat16では100万件あたり約1.5GBの容量がかかります。
MRLで128次元まで短縮すれば、同じ100万件を約250MBに収めることが可能です。テキスト中心の用途なら、精度の低下を抑えながら保存コストを最大6分の1にできるでしょう。データが増えるほど、この差は大きく効いてくるはずです。
EmbeddingGemma 2を使ってみた
ここからは、実際にEmbeddingGemma 2の実力を確かめていきます。今回はSentence Transformersを使い、日本語での検索精度に絞って2つの検証をおこないました。
日本語の社内FAQを言い換えた質問で探せるか
1つ目は、社内ヘルプデスクを想定したFAQ検索です。有給休暇・経費精算・名刺発注など10件のFAQに対し、本文とは言葉をずらした質問を10個投げました。英語の質問から日本語のFAQを探す問題も2つ含め、768・256・128次元で正答数を比べています。
コードはこちら
from sentence_transformers import SentenceTransformer

# テキストのみ(270M)で読み込む
model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"vision_config": None, "audio_config": None},
)

# 社内FAQ(タイトル: 本文)
faqs = {
    "有給休暇の申請": "有給休暇は取得希望日の3営業日前までに勤怠システムから申請してください。上長の承認後に確定します。",
    "経費精算": "交通費や出張費は、領収書の画像を添付して月末までに経費精算システムへ提出してください。",
    "パスワード再設定": "社内アカウントのパスワードを忘れた場合は、ログイン画面の「パスワードを忘れた方」から再設定用メールを受け取れます。",
    "リモートワーク": "在宅勤務は週3日まで可能です。前日までにチームのカレンダーへ予定を登録してください。",
    "健康診断": "年1回の定期健康診断は10月から11月に実施します。予約は総務部の案内メールから行ってください。",
    "PC故障": "貸与PCが起動しない、画面が映らないなどの不具合は、情報システム部のヘルプデスクへチケットを起票してください。",
    "名刺発注": "名刺が必要な場合は、ポータルの申請フォームから発注できます。納品まで約1週間かかります。",
    "育児休業": "子どもが1歳になるまで育児休業を取得できます。申請は開始予定日の1か月前までに人事部へ提出してください。",
    "会議室予約": "会議室はグループウェアの施設予約から最大2週間先まで予約できます。",
    "住所変更": "引っ越しで住所が変わった場合は、人事システムで住所変更届を提出し、通勤経路も更新してください。",
}

# 言い換えた質問と、正解のFAQ
questions = [
    ("来週の金曜に休みを取りたいんだけど、どうすればいい?", "有給休暇の申請"),
    ("出張で立て替えたタクシー代を返してもらうには?", "経費精算"),
    ("ログインできなくなった", "パスワード再設定"),
    ("家で仕事してもいい日数は?", "リモートワーク"),
    ("ノートパソコンの電源が入らない", "PC故障"),
    ("子どもが生まれるので仕事を長めに休みたい", "育児休業"),
    ("取引先に渡すカードを作りたい", "名刺発注"),
    ("打ち合わせ用の部屋を押さえたい", "会議室予約"),
    ("I moved to a new apartment. What paperwork do I need?", "住所変更"),
    ("When is the annual medical checkup?", "健康診断"),
]

titles = list(faqs)
docs = [f"title: {t} | text: {faqs[t]}" for t in titles]
queries = [q for q, _ in questions]

# 768・256・128次元で正答数を比べる
for dim in [768, 256, 128]:
    doc_emb = model.encode(docs, prompt="", truncate_dim=dim, normalize_embeddings=True)
    q_emb = model.encode(queries, prompt_name="SearchQuery", truncate_dim=dim, normalize_embeddings=True)
    scores = model.similarity(q_emb, doc_emb)

    hits = 0
    for (q, answer), row in zip(questions, scores):
        top = titles[int(row.argmax())]
        hits += top == answer
        if dim == 768:
            print(f"{'⭕' if top == answer else '❌'} {q} → {top}({row.max():.3f})")
    print(f"{dim}次元:{hits}/{len(questions)}問正解\n")
出力結果はこちら
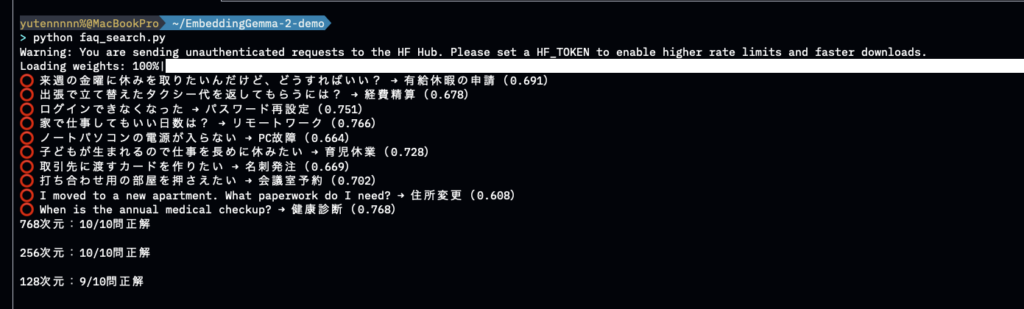
| 次元数 | 768次元 | 256次元 | 128次元 |
|---|---|---|---|
| 正答数 | 10/10 | 10/10 | 9/10 |
768次元では、10問すべてで正しいFAQを1位に表示しました。「取引先に渡すカードを作りたい」から「名刺発注」を、「出張で立て替えたタクシー代を返してもらうには?」から「経費精算」を当てるなど、言い換えにもしっかり付いてきます。英語の質問2問からも、日本語の「住所変更」と「健康診断」を正しく探せていました。
日本語の説明文で写真を探せるか
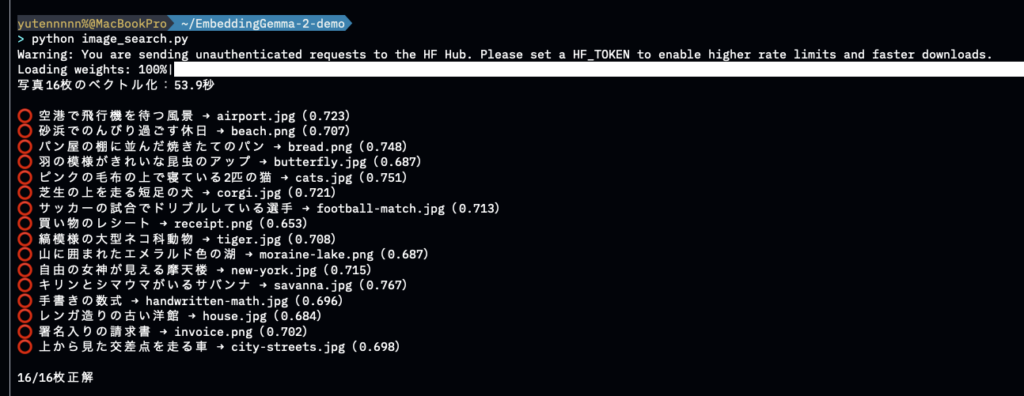
2つ目は、日本語の文章から写真を探す画像検索です。空港・パン屋・コーギー・レシートなど16枚の写真を用意しました。「縞模様の大型ネコ科動物」「山に囲まれたエメラルド色の湖」のように、写真の名前を直接言わない説明で検索しています。
コードはこちら
import time
from sentence_transformers import SentenceTransformer

# テキスト+画像(440M)で読み込む
model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"audio_config": None},
)

# 検索対象の写真(ファイル名: 写真の名前を直接言わない日本語の説明)
BASE = "https://huggingface.co/datasets/Xenova/transformers.js-docs/resolve/main/"
photos = {
    "airport.jpg": "空港で飛行機を待つ風景",
    "beach.png": "砂浜でのんびり過ごす休日",
    "bread.png": "パン屋の棚に並んだ焼きたてのパン",
    "butterfly.jpg": "羽の模様がきれいな昆虫のアップ",
    "cats.jpg": "ピンクの毛布の上で寝ている2匹の猫",
    "corgi.jpg": "芝生の上を走る短足の犬",
    "football-match.jpg": "サッカーの試合でドリブルしている選手",
    "receipt.png": "買い物のレシート",
    "tiger.jpg": "縞模様の大型ネコ科動物",
    "moraine-lake.png": "山に囲まれたエメラルド色の湖",
    "new-york.jpg": "自由の女神が見える摩天楼",
    "savanna.jpg": "キリンとシマウマがいるサバンナ",
    "handwritten-math.jpg": "手書きの数式",
    "house.jpg": "レンガ造りの古い洋館",
    "invoice.png": "署名入りの請求書",
    "city-streets.jpg": "上から見た交差点を走る車",
}
files = list(photos)

# 写真をベクトル化(処理時間も計測)
start = time.time()
img_emb = model.encode([{"image": BASE + f} for f in files], normalize_embeddings=True)
print(f"写真{len(files)}枚のベクトル化:{time.time() - start:.1f}秒\n")

# 日本語の説明文で検索
q_emb = model.encode(list(photos.values()), prompt_name="SearchQuery", normalize_embeddings=True)
scores = model.similarity(q_emb, img_emb)

hits = 0
for i, (f, q) in enumerate(photos.items()):
    top = files[int(scores[i].argmax())]
    hits += top == f
    print(f"{'⭕' if top == f else '❌'} {q} → {top}({scores[i].max():.3f})")
print(f"\n{hits}/{len(files)}枚正解")
出力結果はこちら
| 項目 | 結果 |
|---|---|
| 正答数 | 16/16 |
| 16枚のベクトル化にかかった時間 | 53.9秒(画像のダウンロードを含む) |
結果は、16枚すべての写真を日本語の説明だけで正しく探し当てるという見事なものでした。とくに「買い物のレシート」と「署名入りの請求書」は見た目の似た文書画像ですが、それぞれ正しく見分けてくれています。
EmbeddingGemma 2をはじめとしたAIモデルのご相談はWEELへ!
EmbeddingGemma 2は、テキスト・コード・画像・動画・音声を1つのベクトル空間にまとめられる、Googleのオープンな埋め込みモデルです。740Mと小型ながら、テキストのみなら約191MBのRAMで動き、Apache 2.0で商用利用もできます。
自社の業務データで精度を確かめたり、RAGや社内システムへ組み込んだりするには設計のノウハウも欠かせません。まずは小さな検索システムから試し、自社に合った活用方法を探ってみてください。
弊社では、AI導入を検討中の企業向けに、業務効率化や新しい価値創出を支援する情報提供・導入支援を行っています。最新のAIを活用し、効率的な業務改善や高度な分析が可能です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
よくある質問