Hugging Face(ハギングフェイス)とは?使い方・商用利用・主要機能
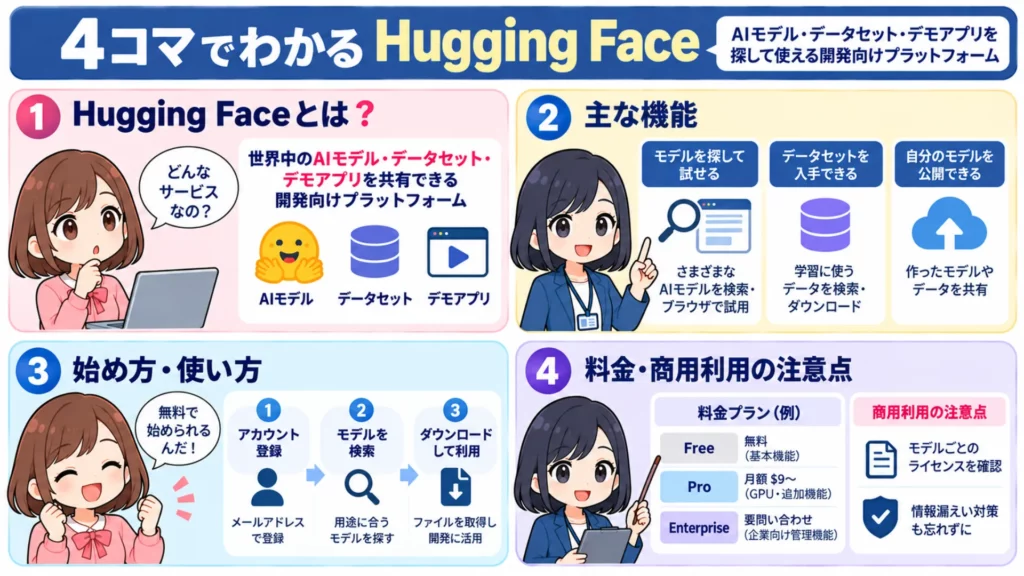
- Hugging Faceでは、AIモデル・データセット・デモアプリを検索して試せる
- 商用利用前に、モデルのライセンスと情報漏えい対策を確認する
- 無料で始められるが、GPUや企業向け管理機能など一部は有料
Hugging Faceは、世界中で公開されているAIモデルやデータセットを探し、実際の開発に取り込めるプラットフォームです。一方で、モデルごとにライセンスや必要な実行環境が異なるため、一覧を見るだけでは選び方に迷うこともあります。
本記事では、基本機能と始め方、モデルのダウンロード方法、料金、商用利用時の注意点を整理します。ローカル環境でモデルを動かした結果も交え、初めて使う方にもわかりやすく解説します。
\生成AIを活用して業務プロセスを自動化/
Hugging Faceとは

Hugging Faceは、AIモデル・データセット・デモアプリを共有・検索・試用できる、AI開発向けのオープンプラットフォームです。AIモデルやデータを管理・共有できることから、AI版GitHubともいわれます。自然言語処理からはじまって、画像認識・画像生成・音声処理などにも対応しており、研究者から企業の開発チームまで幅広く利用されています。
サービス名と同じHuggingFace社は2016年にチャットボット開発企業として創業しました。2020年ごろからモデルやデータセットを共有できる場所として、Hugging Face Hubを展開し、AIプラットフォームとして運営されています。
ノーコード開発について詳しく知りたい方は、こちらの記事もご覧ください。
Hugging Faceでできること
Hugging Faceでできることは主に以下のとおりです。
| Hugging Faceでできること | 詳細 |
|---|---|
| 学習済みAIモデルをダウンロード・利用できる | 画像認識・文章生成・翻訳など、世界中の開発者が公開したモデルを使える |
| モデルをブラウザ上でそのまま試せる | コードを書かなくても、Webブラウザ上でAIの動作を体験できる |
| データセットを探して入手できる | AIの学習に使うデータ(テキスト・画像など)を検索・ダウンロードできる |
| 自分で作ったモデルやデータを公開・共有できる | GitHubのようにモデルをアップロードし、世界中の人と共有できる |
| AIコミュニティに参加・情報収集できる | 研究者・エンジニアが集まるコミュニティで最新のAI動向をキャッチできる |
| AIアプリをクラウド上で動かせる | 自分で作ったAIアプリをサーバーなしで公開・デモできる環境が整っている |
これらの機能は、クラウド上のプラットフォームであるHugging Face Hubと、それらを自在に操作するためのライブラリが連携することで成り立っています。
また、Hugging Faceに公開されているモデルやデータセットは、誰でも手軽に利用できるよう設計が大幅に簡素化されており、これまで複雑だった導入作業も、今ではたった数行のPythonコードを書くだけで適用できるようになりました。
Hugging Faceの始め方
Hugging Faceはアカウントを作成しなくても、以下のことは利用可能です。
- 一般公開されているAIモデルやデータセットの検索・ダウンロード。
- 「Spaces」で公開されているAIのデモアプリをブラウザ上で試すこと。
- モデルの取扱説明書(モデルカード)やコミュニティの議論を読むこと。
しかし、本格的に開発を行うのであれば、アカウント登録は必要です。具体的な登録の手順を説明します。


プロフィール画面では、ユーザーネームとフルネームを入力します。アバターやX(Twitter)・GitHubのユーザーネームは任意です。LinkedInのプロフィール、ホームページ、AI・機械学習への関心も入力しなくて構いません。利用規約と行動規範を確認して同意にチェックを入れ、「Create Account」を選択します。

Hugging Faceモデルのダウンロード方法
一部のモデルはブラウザー上のデモや推論サービスで試せるため、Hugging Faceの利用にダウンロードは必須ではありません。自分のPCで動かす場合は、モデルカードでライセンスと必要なファイルを確認して取得します。以下はHubからファイルをダウンロードする基本的な流れです。


【実践】Hugging Faceを実際に使ってみた
Hugging Face Hubでモデルを探し、ファイルをダウンロードしてPC上で動かすまでを試しました。英語の感情分析モデルを選び、モデルの実行に使える共通形式「ONNX」のファイルを取得しています。計算にはPCの中核部品であるCPUを使い、有料APIや有料GPUは利用していません。
1. 用途に合うモデルを検索する
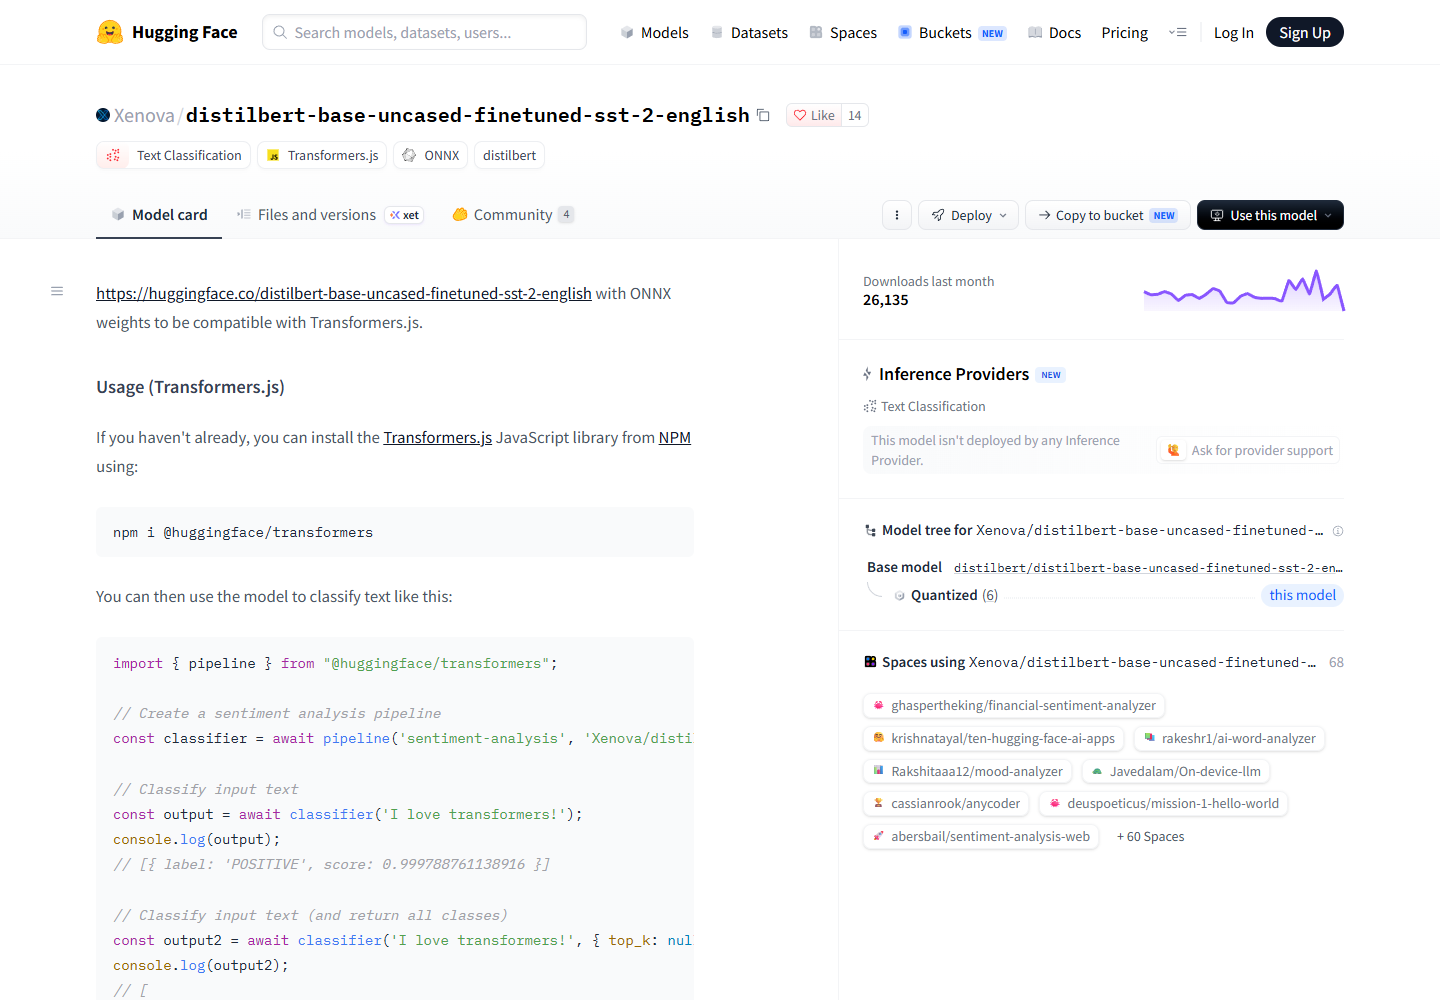
Modelsで感情分析向けの候補を探し、タスク、対応ライブラリ、モデルカード、元モデルを確認しました。選んだのは、DistilBERTをONNX形式に変換した「Xenova/distilbert-base-uncased-finetuned-sst-2-english」です。
2. 実行するファイルを確認してダウンロードする
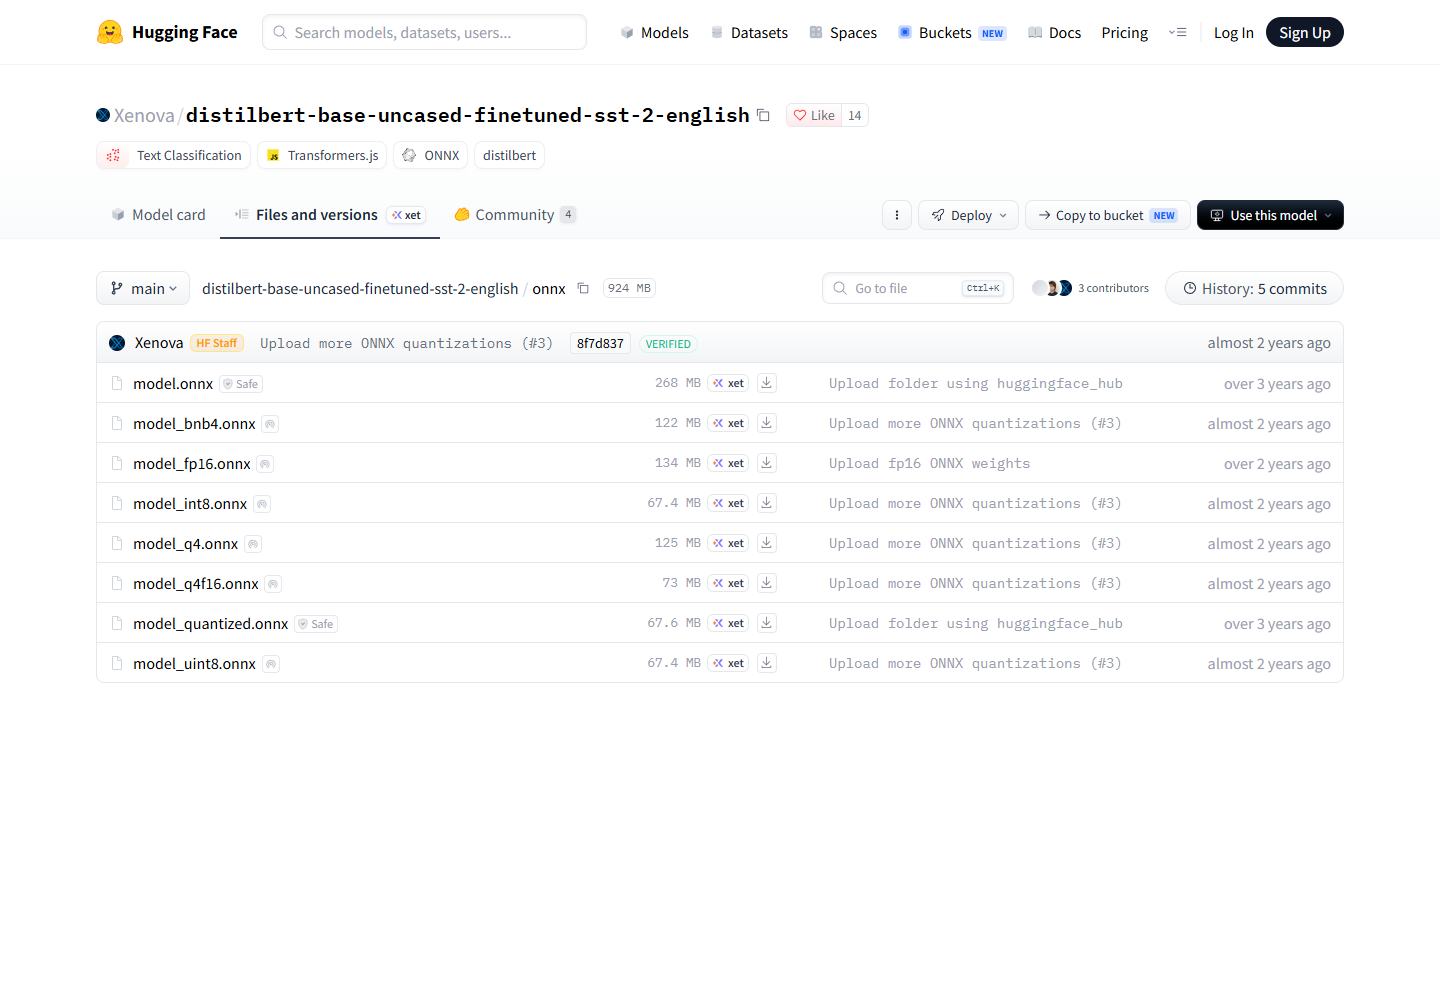
「Files and versions」で、ファイル形式や容量、安全性スキャンの表示を確認しました。今回使った量子化済みのmodel_quantized.onnxは67.6MBで、画面には「Safe」と表示されています。量子化はモデルの数値表現を小さくして、容量や必要なメモリを減らす方法です。ただし、「Safe」の表示だけでコードや利用条件を含む全リスクがなくなるわけではありません。
Python 3.11で以下のコードを「article_sentiment_demo.py」として保存し、コマンドを実行します。コード内でモデルのコミットを指定し、必要な3ファイルをHubから取得します。
【コード】
import json
import numpy as np
import onnxruntime as ort
from huggingface_hub import hf_hub_download
from tokenizers import Tokenizer

MODEL_ID = "Xenova/distilbert-base-uncased-finetuned-sst-2-english"
REVISION = "0b6928efcb76139cae2c6881d49cda67fe119f42"
FILES = ["config.json", "tokenizer.json", "onnx/model_quantized.onnx"]
TEXTS = [
    "Hugging Face makes it easy to find and test open models.",
    "The setup was confusing and the result was disappointing.",
]

paths = {
    name: hf_hub_download(repo_id=MODEL_ID, filename=name, revision=REVISION)
    for name in FILES
}
tokenizer = Tokenizer.from_file(paths["tokenizer.json"])
tokenizer.enable_padding()
tokenizer.enable_truncation(max_length=512)
encoded = tokenizer.encode_batch(TEXTS)
input_ids = np.asarray([item.ids for item in encoded], dtype=np.int64)
attention_mask = np.asarray(
    [item.attention_mask for item in encoded], dtype=np.int64
)

session = ort.InferenceSession(
    paths["onnx/model_quantized.onnx"], providers=["CPUExecutionProvider"]
)
feed = {"input_ids": input_ids, "attention_mask": attention_mask}
input_names = {item.name for item in session.get_inputs()}
if "token_type_ids" in input_names:
    feed["token_type_ids"] = np.zeros_like(input_ids)
logits = session.run(None, {k: v for k, v in feed.items() if k in input_names})[0]
scores = np.exp(logits - logits.max(axis=1, keepdims=True))
scores /= scores.sum(axis=1, keepdims=True)

config = json.loads(open(paths["config.json"], encoding="utf-8").read())
labels = {int(key): value for key, value in config["id2label"].items()}
for text, probabilities in zip(TEXTS, scores, strict=True):
    label_id = int(np.argmax(probabilities))
    print(text, labels[label_id], round(float(probabilities[label_id]), 6))
【実行コマンド】
python -m pip install huggingface_hub==1.6.0 onnxruntime==1.23.2 tokenizers==0.22.2 numpy==1.26.4
python article_sentiment_demo.py
3. CPUで感情分析を実行する
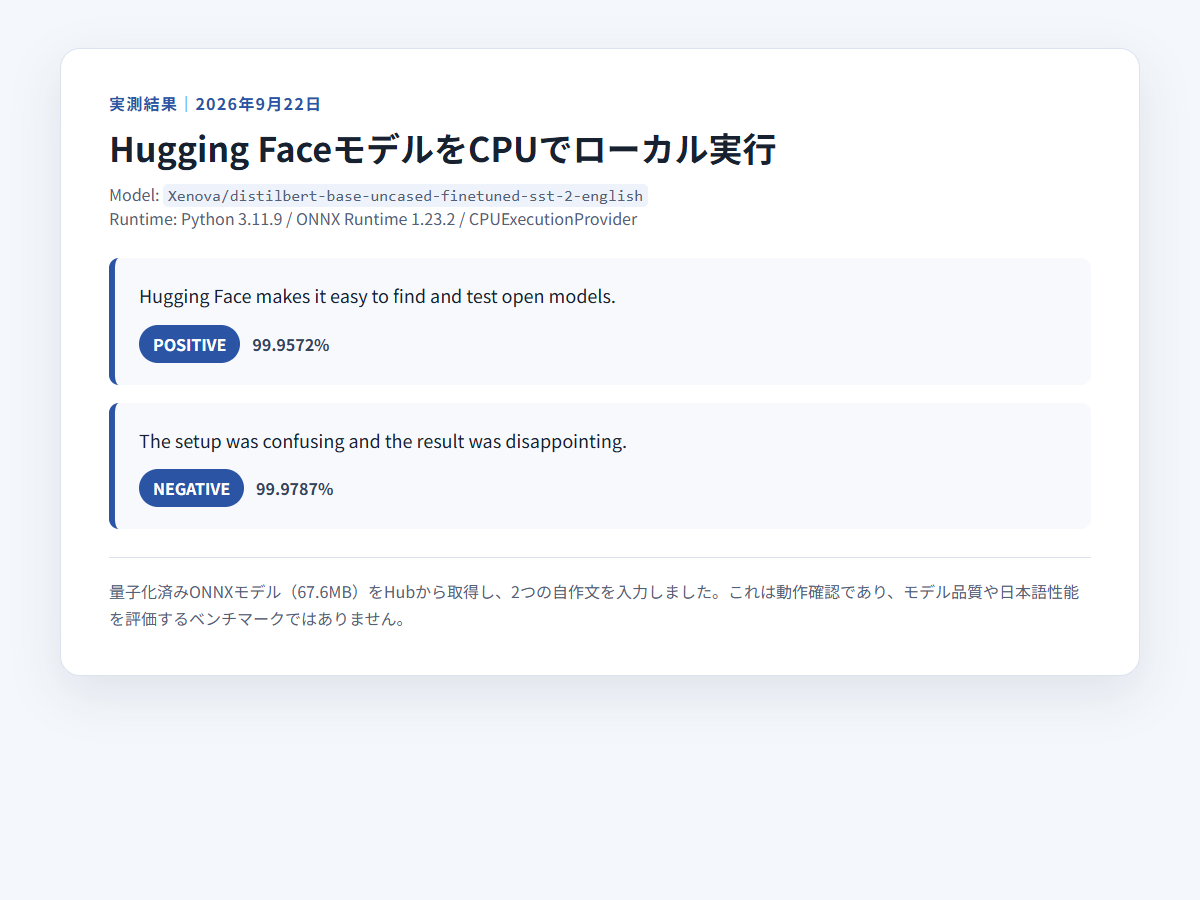
Windows PCのPython 3.11.9、ONNX Runtime 1.23.2で2つの英文を入力しました。肯定的な文は「POSITIVE」、否定的な文は「NEGATIVE」と判定され、有料APIや有料GPUを使わず、モデルの検索からローカル実行まで完了できました。ローカルで動かすには、用途だけでなくファイル形式と容量の確認も大切だとわかりました。
検証日:2026年9月22日/モデルのコミット:0b6928efcb76139cae2c6881d49cda67fe119f42/実行環境:CPUExecutionProvider/入力データ:記事検証用に作成した英文
Hugging Face Hubの使い方
次に、プラットフォームであるHugging Face Hubの機能についてご紹介します。Hugging Face Hubは単なるホスティングサイトにとどまらず、大容量ストレージやコンピュート実行機能などを備えたAI開発の統合プラットフォームへと進化しています。
主に「Models」「Datasets」「Spaces」「Docs」「Leaderboard」の5つの機能に加えてさまざまな拡張機能が利用できるため、それぞれの機能についてみてみましょう。
モデルを検索する(Models)

Hugging Face HubのModelsでは、自然言語処理や画像認識、音声認識などのモデルを公開・検索できます。使い方としては、検索バーに「翻訳」「感情分析」などのキーワードを入力し、目的に合ったモデルを探すのが基本です。
例えばまた、Loraモデルの探し方も簡単で、検索バーに「lora」と入力するだけで一覧が表示されます。

これらのモデルは、トレーニング済みの高品質なモデルなので、自身の環境に取り組むことで開発時間を短縮しつつ、コストも抑えながらアップデートができます。
また、それぞれのモデルには、モデルの説明やライセンス、モデルソースなどのAIモデルの詳細について確認できる「Model card」や、そのAIモデルを使ったユーザーが使用感やトラブル発生時の対応方法などを投稿した「Community」があるので、あまり技術力がない人でも公開されたAIモデルが利用できるような仕組みになっています。
データセットを検索・利用する(Datasets)

Hugging Face Hubにはモデルの他に、自然言語処理や画像認識、音声認識などのさまざまなタスクに対応可能なデータセットも公開されています。Datasets機能を活用することでそれらも自由に利用可能です。
使い方としては、検索バーに「日本語」「感情分析」「画像分類」などのキーワードを入力することで、自分の目的に合ったデータセットを簡単に探せます。
Datasetsに関しても、データセットの説明やライセンスなどが記載された「Dataset card」や「Community」が備えられているので、Modelsと同様にあまり技術力がない人でも公開されたデータセットが利用できるような仕組みになっています。
AIモデルのデモを検索・作成する(Spaces)

Spacesは、クラウド環境でAIモデルのデモを作成して共有できる機能です。
使い方としては、Pythonで動作するデモアプリをGitHubのようにアップロードするイメージで、簡単に実行環境を構築できます。ユーザー側は公開されたSpacesを通じて、モデルの精度や動作を本番環境に導入する前に試すことができ、開発者側はモデルの利用シーンや強みをわかりやすくアピールできます。
公式料金ページによると、Hugging FaceではCPU Basic環境(仮想CPU 2基、メモリ16GB)のSpacesを無料で公開できます。モデルやアプリに必要な計算量を確認し、無料の実行環境で足りるか判断しましょう。
GPUが必要なデモには、アクセス時だけ共有GPUを割り当てるZeroGPUがあります。公式ドキュメントでは、RTX Pro 6000 Blackwellを利用し、アカウント種別ごとに1日の利用枠とキュー優先度を定めています。
| アカウント種別 | 1日のGPU利用枠 | キュー優先度 |
|---|---|---|
| 未ログイン | 2分 | 低 |
| Free | 5分 | 中 |
| PRO | 40分(延長可) | 最高 |
| Team組織のメンバー | 40分(延長可) | 最高 |
| Enterprise組織のメンバー | 60分(延長可) | 最高 |
利用枠は最初にGPUを使ってから24時間後にリセットされます。PRO、Team、Enterpriseは、枠を超えた分をプリペイドクレジットからGPU時間10分あたり1ドルで延長できます。
Hugging Faceの機能を学ぶ(Docs)
Docsでは、Hugging Faceに関するサイト内の機能を学ぶことができる学習コンテンツが公開されています。
これまで紹介してきた、ModelsやDatasetsへの公開方法やSpacesでのデモ作成方法などが網羅的に解説されているため、Hugging Faceを有効活用するためには一度目を通した方が良いでしょう。
使い方としては、トップページからカテゴリを選び、自分の目的に合ったドキュメントを読むだけ。コード例も豊富に掲載されており、実際の開発にすぐ役立つ内容が揃っています。
また、特定のモデルやデータセット、ライブラリ(TransformersやDatasetsなど)に関する詳細な使い方もまとめられているため、自社プロジェクトに合ったリソースを見極める判断材料としても活用できます。
モデルを比較する(Leaderboard)

Leaderboardは、Hugging Faceで公開されているさまざまなモデルを比較できる機能です。自然言語処理(NLP)や大規模言語モデル(LLM)を中心に、各モデルのベンチマークスコアを一覧表で比較できます。
主な使い方は、各項目をタップしてそれぞれのランキングを比較するか、検索欄に特定の単語を入れて、その分野に強いモデルを抽出するなどが一般的です。
高度なデータ管理と実行環境(Data Studio・Buckets・Jobs)
Hugging Face Hubにはチーム開発や大規模開発を支援する周辺機能が続々と追加されています。
| 機能名 | 主な特徴・概要 |
|---|---|
| Data Studio | ブラウザ上で直接DuckDBを使用したSQLクエリを実行したり、データセットの値を直接編集・コミットできる強力な機能。(公開データは誰でも無料で利用可能。プライベートデータセットはPRO/Team/Enterprise向け) |
| Buckets(バケット) | S3ライクの大容量オブジェクトストレージ機能で、大量の学習データやログなどの保存に最適。 |
| Jobs(ジョブ) | Hugging Faceのインフラ(CPUやA100などのGPU)上で、直接スクリプトやDockerイメージなどのコンピュート処理を実行できる機能。(Pro/Team/Enterpriseプラン向け) |
チームの規模やプロジェクトの要件に合わせて、主要な基本機能とこれらの最新機能を組み合わせて活用してみてください。
外部AIエコシステムとの連携強化(API連携・MCP・Agents)
Hugging Faceは、外部のAIツールや既存システムとのシームレスな連携に力を入れています。既存の開発フローからコードをほぼ書き換えずに移行・拡張できる環境が整っています。
| 連携機能 | 開発者にとってのメリット |
|---|---|
| OpenAI互換API | 既存のOpenAIクライアントのコードをほぼ書き換えず、接続先を変えるだけでHugging Faceのモデルを利用可能。 |
| MCP連携強化 | 1,000以上のSpacesがMCPに対応。Cursor等の外部AIエージェントから直接呼び出せる強力なツール。 |
| Agents | Pythonで軽量かつ強力なAIエージェントを手軽に構築できる公式ライブラリ。(smolagents) |
Hugging Face社が提供するライブラリ
前述の通り、Hugging Faceで保管・共有されているモデルやデータセットは、このライブラリを使って開発されたものです。まずは、Hugging Face社が提供する代表的な5つのオープンソースライブラリについて解説します。
Transformersライブラリ
Transformersライブラリでは、自然言語や画像、音声データに特化したモデルが提供されており、これらのモデルは大規模なデータセットで事前学習されているため、そのまま使用しても高い精度を誇っています。
また、PyTorch、TensorFlow、JAXといった有名なディープラーニングのライブラリと一緒に使うことができるので、効率的にAI開発を進めることできるでしょう。
さらに、BERTやGPT-2、Wav2Vec 2.0のような有名なモデルの実装を含んでいるため、機械学習やディープラーニングに携わるユーザーから人気のあるライブラリです。
Tokenizersライブラリ
Tokenizersライブラリは、プログラミング言語のRustで作られていることもあり、テキストの文字列をモデルに使用するために最小単位で分解する「トークン化」をシンプルなコードで行えるライブラリです。
単にトークン化されるだけではなく、使用するモデルに必要な情報となるスペシャルトークンを入力テキストに追加することも可能です。
このように、Tokenizersライブラリはさまざまなモデルのトークン化を簡単かつ高速に行うことができるように設計されたライブラリといえるでしょう。
Diffusersライブラリ
Diffusersライブラリは、特に画像や音声、分子の3D構造を生成するための、最先端の事前学習済みDiffusion Model(拡散モデル)を提供するライブラリです。
Hugging Faceで公開されている画像生成に関する学習済みモデルを簡単に呼び出すことができるという特徴を持っており、主に画像生成や画像編集、データ拡張などのタスクに使用されています。
また、音声認識や分子の3D構造の生成もできるため、Diffusersライブラリを使うことでさまざまなタスクを効率よくこなすことができます。
Accelerateライブラリ
Accelerateライブラリとは、CPU、GPU、TPUなどの異なる環境の計算リソースを共通のコードで処理できるライブラリです。
Accelerateライブラリを活用することで、異なる計算リソースを共通のコードで処理が行えるため、プログラムの実行環境をコード修正せずに変更することができます。
それだけではなく、4行のコードを追加するだけで簡単に学習や大規模なトレーニングと推論が行うこともできるため、異なる環境のリソースを活用して学習したい場合や、CPU、GPU、TPUなどの環境を切り替えを簡単に行いたい時に便利です。
Datasetsライブラリ
Datasetsライブラリでは、AI開発や機械学習に必要となるさまざまなデータセットが公開されており、公開されている音声、画像、テキストなどの学習用データセットへのアクセスが1行のシンプルなコードで読み込むことができます。
Datasetsライブラリを活用することでデータセットを簡単にダウンロードが出来て、機械学習のトレーニング用にデータを素早く準備することできます。
それだけではなく、データの変換やフィルタリングなどの前処理機能も搭載されているので、より効率的に機械学習を行うことが可能です。
AI開発環境やツールの選び方は、こちらの記事でも解説しています。
Hugging Faceのモデル一覧
| モデル | 主な用途・特徴 | ライセンス/利用条件 |
|---|---|---|
| Qwen/Qwen3.5-9B | 文章生成・対話・画像理解に対応する90億パラメータのモデル | Apache-2.0 |
| openai/gpt-oss-20b | 文章生成や推論向けの公開モデル。容量を抑えた量子化形式の重みを公開 | Apache-2.0 |
| google/gemma-4-12B | テキスト・画像・動画・音声を入力し、文章を生成するマルチモーダルモデル | Apache-2.0 |
| black-forest-labs/FLUX.2-klein-4B | テキストからの画像生成と、画像を参照した編集に対応する40億パラメータのモデル | Apache-2.0 |
| openai/whisper-large-v3-turbo | 99言語に対応する音声認識モデル | MIT |
| sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 | 50言語の文章を384次元のベクトルに変換。類似検索やクラスタリング向け | Apache-2.0 |
| facebook/detr-resnet-50 | 画像内の物体と位置を検出するモデル | Apache-2.0 |
Hugging Face Hubには、文章生成、埋め込み、画像生成、音声認識など、用途の異なるモデルが公開されています。上の表は2026年9月24日にモデルカードを確認した代表例で、網羅的な一覧ではありません。
同じ用途でも、必要なメモリ、入力言語、学習データ、出力品質はモデルごとに異なります。派生モデルでは元モデルと異なる条件が付く場合もあるため、利用時点のモデルカードとライセンスを個別に確認してください。
AIモデルの種類や選び方を詳しく知りたい方は、こちらの記事もご覧ください。

Hugging Faceの料金一覧
| プラン | 月額料金 | 主な対象・特徴 |
|---|---|---|
| Free | 0ドル | 公開モデルやデータセットの検索・取得、CPU BasicのSpacesなどを試したい個人 |
| PRO | 9ドル | 個人向け。非公開ストレージ1TB、ZeroGPUの1日40分枠と最優先キュー、20倍の推論クレジットなど |
| Team | 1ユーザー20ドル | 組織向け。シングルサインオン(SSO)、監査ログ、権限管理、トークン管理など |
| Enterprise | 1ユーザー50ドル〜 | Teamの機能に加え、社員管理システムと連携するSCIMでの招待、請求書払い、サポート対応基準付きのメールサポートなど |
| Enterprise Plus | 要問い合わせ | SCIMによるユーザー登録・削除の自動化、ネットワーク制御、管理ユーザー、上位サポートなど |
Hugging Faceは無料で始められます。非公開ストレージ、ZeroGPUの利用枠、組織管理などを広げる場合は、必要な機能に応じて有料プランを選びましょう。
用途に合うプランの選び方
公開モデルを調べたり、小規模なデモを試したりする段階ならFreeから始められます。個人でZeroGPUの利用枠や非公開ストレージを増やしたい場合はPRO、複数人で権限や操作履歴を管理する場合はTeamが候補です。
ユーザー登録を既存の管理システムと連携させたい場合や、サポート対応の基準が必要な場合はEnterprise以上が候補です。登録・削除まで自動化したい場合はEnterprise Plusの条件を確認してください。
GPU・推論・追加ストレージの料金に注意
有料プランに加入しても、有料の計算資源を無制限に使えるわけではありません。モデルをAPI経由で使うInference Providersや専用の推論環境を立てるInference Endpointsなどは、利用量に応じて料金が発生し、付与クレジットがある場合は先に適用されます。アップグレードしたSpaces、単発の計算処理に使うJobs、追加ストレージにも別途料金がかかります。
Hugging Faceを活用するメリット
ここまで、Hugging Faceについて紹介してきましたが、これらの機能を活用することでどのようなメリットを得ることができるのでしょうか。Hugging Faceを活用するメリットについてご紹介します。
コスト削減につながる
Hugging Faceを活用すれば、さまざまなモデルが用意されているため、技術力のない人でもAIを導入することができるようになります。これにより、外部のエンジニアへの外注費を削減できます。
さらに、AIの導入作業を自社のエンジニアが行なっている企業に関しても、Hugging Faceに公開されているデータセットなどを活用することで、0から環境構築するよりも早く環境構築することが可能です。
このように、外注費や時間といったコストに関わる部分を削減することができます。
開発したモデルのフィードバックを得ることができる
開発者は、Hugging Faceに自分で作成したモデルやデータセットを公開することで、ユーザーからフィードバックを得ることができます。本来自分で行うべきデバック作業の一部を短縮することが可能です。
例えば、不具合箇所の報告だったり、あるいはプログラミングに詳しいユーザーであれば、修正案を提示してくれることもあるでしょう。
透明性や信頼性の高いモデルを利用できる
Hugging Faceの特徴は、一部を除く膨大な数のライブラリやモデルがオープンソースで共有されていることです。これにより、開発者や企業はモデルの構造や挙動、学習データの出所などを自ら確認することができ、ブラックボックス化されたAIへの不安を抱く必要がありません。
また、公開されたモデルは、世界中のコミュニティによって日々研究・改善されており、ユーザーはモデル評価機能などを通じて、性能や透明性を確認することができます。さらに、導入時の信頼性評価やセキュリティ要件の厳しい産業用途向けには、詳細なアクセス制御や監査ログを備えたTeamプランやEnterpriseプランも提供されており、安全な開発体制を構築することが可能です。
コミュニティから情報を得られる
Hugging Faceの魅力のひとつが、活発で支援的なグローバルコミュニティの存在です。モデルの使用方法やトラブルへの対処法など、初心者がつまずきやすいポイントもコミュニティを通じて情報を得やすい環境が整っています。
例えば、各モデルページには「Model Card」や「Community」タブが用意されており、利用者による使用例や注意点、問題の報告・議論が共有されています。また、GitHub IssuesやStack Overflowでも活発な質疑応答が行われており、困ったときにはすぐに解決策を探すことが可能です。
さらに、定期的に開催されるハッカソンやオンラインイベントを通じて、他の開発者の事例やノウハウに触れられる機会も多く、実践的な学びとスキルアップにもつながる点も魅力です。
企業向けのセキュリティ・管理機能も充実している
Hugging Faceは、個人開発者だけでなく、セキュリティやガバナンスが求められる企業利用にも対応しています。特にEnterpriseプランでは、セキュリティ強化とチーム運用を支援する多彩な管理機能が提供されています。
代表的な機能は、シングルサインオン(SSO)対応による認証の一元化、チーム単位でのアクセス権限管理、および監査ログの取得などです。これにより、誰が・いつ・どのリソースにアクセスしたかを可視化でき、社内のコンプライアンスやセキュリティ要件に対応しやすくなっています。
さらに、自社インフラ上でのプライベートな運用を可能にする「Private Hub」や、「Inference Endpoints」を活用したセキュアなモデル提供環境の構築も可能。大規模組織におけるAIの安全な展開を強力にサポートしています。
生成AIの導入については下記で解説
Hugging Faceのリスクと対策
Hugging Faceは便利なプラットフォームですが、誰でも自由にモデルやデータセットを公開できる性質上、利用する際にはいくつかの注意点があります。安全に活用するために、事前に把握しておきましょう。
Hugging Faceの安全性
Hugging Faceを活用することで、AI開発を効率よく進められるツールが多くあります。しかし、バックドアが仕組まれていたり、侵入リスクがあったりするなどとして、DevOpsツールを提供しているJFrogが発表しました。侵入されると、システム上の重要な情報にアクセスされ、個人や企業の情報が漏えいする可能性が高くなってしまいます。
この状況はHugging Faceだけに限ったものではなく、他の機械学習モデルでも発生する可能性が高いため、利用者側も対策する必要があります。実際にHugging Faceで実施しているセキュリティ対策は以下のとおりです。
| 機能名 | 説明 |
|---|---|
| マルウェアスキャン | 安全でないファイルをダウンロードする前には警告文を出す仕組みを導入し、リポジトリ所有者へ削除をすすめる。 |
| Pickleスキャン | リポジトリ内でPickleファイルの中身を表示・確認できる機能により、危険性を事前に把握できる。 |
| シークレットスキャン | 環境変数へシークレットキーなどを設定していないかを検知する機能。 |
Hugging Faceの商用利用
Hugging Faceで公開されているモデルやデータセットは、商用利用できるものも多い一方で、すべてを自由に商用利用できるわけではありません。実際の利用可否は、Hugging Face全体で一律に決まるのではなく、各モデル・各データセットに設定されたライセンスによって異なります。
確認すべきポイントは以下のとおりです。
| 項目 | 確認箇所 |
|---|---|
| ライセンス | 商用利用、改変、再配布が認められているか |
| モデルカード | 想定用途、制約、禁止用途、性能上の注意点 |
| データセットカード | 学習データの利用条件や制限 |
商用利用を前提とする場合は、導入前にモデルカード・データセットカード・ライセンスの3点をセットで確認することが大切です。
個人情報とプライバシーの取り扱い
Hugging Faceを活用してAIモデルを開発・利用する際は、個人情報の取り扱いにも注意が必要です。公開されているデータセットの中には、意図せず個人情報が含まれているケースがあります。そのようなデータをそのままモデルの学習に使用すると、法的規制に触れるリスクがあります。
また、自社のデータをHugging Face上にアップロードする際は、機密情報や顧客データが含まれていないかを事前に確認することが求められます。特に企業での活用においては、社内のセキュリティポリシーを確認したうえで利用しましょう。
生成AIの全般のリスクは下記でも解説
Hugging Faceの活用シーン
Hugging Faceは、以下のようなシーンで活用可能です。
- 自然言語処理(NLP)モデルの開発
- 画像認識・画像生成モデルへの応用
- 音声認識・音声処理への応用
- RAG・ファインチューニングによる業務特化型AIの構築
- 医療文書の確認を補助する
- 金融ニュースを分類して確認作業を支援する
- 社内PoC・デモ公開・プロトタイプ開発
それぞれの活用シーンを紹介していくので、自社で真似できそうなものがないか確認してみてください。
自然言語処理(NLP)モデルの開発
Hugging Faceは、BERTやGPTなどのNLPモデルを中心に、多彩な自然言語処理タスクへの対応力が強みです。
テキスト分類・要約・感情分析・質問応答・翻訳といった機能を数行のコードで実装できます。
最終的には、カスタマーサポート用のチャットボットや記事の自動要約ツールなど、業務効率化に直結するNLPアプリを手軽に開発できるのがメリットです。
画像認識・画像生成モデルへの応用
自然言語処理に限らず、画像系タスクへの対応も進んでいます。例えば、OpenAIのCLIPを活用した画像検索やキャプション生成、Diffusersライブラリを使った画像生成などです。
複雑な画像生成AIモデルも、Hugging Faceを活用すれば、プロトタイピングから本番運用までをスムーズに進められます。
音声認識・音声処理への応用
Hugging Faceは音声認識や音声合成などにも対応しています。数多くのオープンソース音声モデルが公開されており、それらを活用することで、会議の自動文字起こしやカスタマーサポート用の音声ボットといったシステムを構築できます。
用途に合ったモデルを選んで組み込むだけで、高度な音声AI機能を自社のアプリケーションに手軽に実装することが可能です。
RAG・ファインチューニングによる業務特化型AIの構築
Hugging Faceでは、事前学習済みモデルを自社データに合わせて微調整(ファインチューニング)できるほか、外部知識を検索して回答を生成するRAG(検索拡張生成)システムの構築に必要なモデルも豊富に揃っています。
こうした方法は、金融文書の分類や医療情報の整理など、専門分野向けの試作品を検討する際にも役立ちます。ただし、実用に必要な精度・費用・安全性は、対象データと運用条件に合わせて検証が必要です。
医療文書の確認を補助する
Hubでは、医療分野向けの日本語モデルも見つかります。例えば、SIP-med-LLMのモデルカードが紹介しているのは、日本語と英語に対応する研究用の医療言語モデルです。医療文書の要約や確認項目の洗い出しを試す場合も、まず匿名化した検証用データで出力を評価してから利用範囲を決めます。
生成AI導入で医療がどう変わるかは下記で解説
金融ニュースを分類して確認作業を支援する
金融分野では、ProsusAI/finbertのように、英語の金融テキストを肯定・否定・中立に分類するモデルが公開されています。英語ニュースの見出しや短い文章を仕分け、担当者が読む順番を決める手掛かりにできます。長い資料や日本語文書に使う場合は、入力長と対応言語を確認し、別途評価が必要です。
生成AIを金融に活用する方法は下記で解説
社内PoC・デモ公開・プロトタイプ開発
Hugging Faceの「Spaces」を利用すれば、開発したAIモデルを実際に動かせるWebアプリとして簡単に公開・共有できます。社内PoC(概念実証)の際にも、操作画面付きのプロトタイプを素早く関係者に共有できるため、フィードバックの収集やAI導入の意思決定を進めやすくなります。
また「Spaces Dev Mode」という機能を用いれば、修正と確認を素早く繰り返せるため、試作品の検証から本番に向けた開発までを効率よく進められます。
生成AIのPoC開発の進め方は、こちらの記事をご覧ください。

生成AI開発・業務活用ならWEELへご相談ください
「Hugging Face」を活用すれば、AI開発のスピードや効率を高め、コスト削減やリソースの最適化が可能。独自のAI導入を検討している方には、ぜひ試してみてください。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。