オープンソースLLMおすすめ9選!日本語性能と商用利用を比較、実機検証も紹介
- オープンソースLLMは日本語性能と商用ライセンスの比較が重要
- オープンソースLLMの使い方はローカルPCやクラウドGPU、APIから選択可能
- オープンソースLLMの主要9モデルを一覧で紹介し、3モデルを実機検証
オープンソースLLMは、社内データを外に出さずに生成AIを使いたい企業にとって有力な選択肢です。ただし、日本語性能や商用利用の条件はモデルごとに異なり、どれを選べばよいか迷う方も多いでしょう。
この記事では、2026年時点の主要9モデルを一覧で比較し、ローカルPCで3モデルを実際に検証しました。基本的な使い方や導入時の注意点も紹介します。自社に合うモデルを選ぶために、ぜひ最後までご覧ください。
\生成AIを活用して業務プロセスを自動化/
オープンソースLLMとは

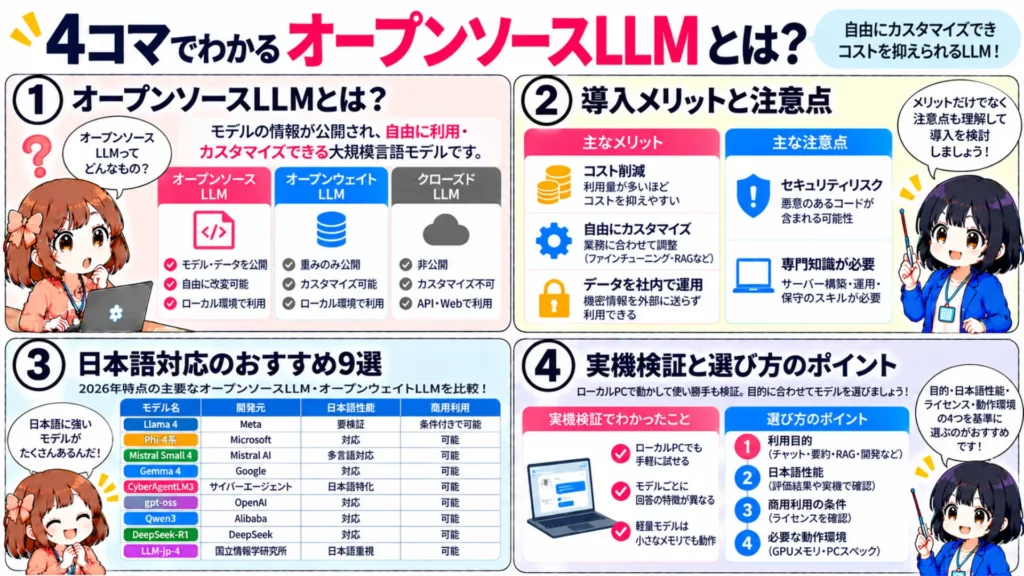
LLMは、モデルの情報がどこまで公開されているかによって、オープンソースLLM・オープンウェイトLLM・クローズドLLMの3つに分けられます。それぞれ公開範囲やカスタマイズの自由度が異なり、商用利用の条件にも違いがあります。
クローズドLLMとの違い
オープンソースLLMやオープンウェイトLLMは学習済みの重みが公開され、自社環境での調整が可能です。外部APIを使わなければ入力データを社内で処理できますが、クローズドLLMは提供元のサービスで利用するのが中心で、利用料金や従量課金が発生する場合があります。
3つのLLMの特徴と違いを以下の表にまとめました。
| 比較項目 | オープンソースLLM | オープンウェイトLLM | クローズドLLM |
|---|---|---|---|
| 重みの公開 | 公開 | 公開 | 非公開 |
| 学習データの公開 | 公開または詳細情報を提供 | 非公開または一部公開 | 原則非公開 |
| カスタマイズ性 | 高い | 高いが公開範囲に制約あり | 提供機能の範囲内 |
| ライセンス | オープンソースの条件に準拠 | モデルごとに異なる | サービスの利用規約に準拠 |
| 利用形態 | ローカル環境や自社サーバーなど | ローカル環境や自社サーバーなど | WebサービスやAPIが中心 |
| 代表モデル | OLMo 2 | Llama 4、gpt-oss | GPTシリーズ、Gemini |
なお、厳密なオープンソースAIの定義では、学習データそのものを全て公開する必要はなく、学習内容を検証できる十分な情報の公開が求められます。また、オープンウェイトLLMでも商用利用の条件は異なり、gpt-ossはApache 2.0、Llama 4は独自のライセンスを採用しています。
企業で導入する際は、公開範囲だけでなく、商用利用の条件も確認することが重要です。
ローカルLLMについて詳しく知りたい方は、下記の記事を合わせてご確認ください。
【日本語対応】おすすめオープンソースLLM一覧

ここでは、日本語に対応したオープンソースLLMとオープンウェイトLLMを9種類紹介します。モデルによって日本語性能や商用利用の条件が異なるため、自社の目的に合ったものを選ぶことが重要です。
まずは、それぞれの特徴を以下の比較表で確認しましょう。
| モデル名 | 開発元 | 公開時期 | パラメータ数 | ライセンス | 商用利用 | 日本語性能 | ローカル実行に必要なVRAM・メモリ目安 |
|---|---|---|---|---|---|---|---|
| Llama 4(Scout/Maverick) | Meta | 2025年04月05日 | Scout:総109B、有効17B/Maverick:総400B、有効17B | Llama 4 Community License | 条件付きで可能 | 日本語は公式対応12言語の対象外、要検証 | Scout:Int4でH100 80GB×1基/Maverick:複数GPUのサーバー |
| Phi-4系(Phi-4-mini-instruct) | Microsoft | 2025年02月26日 | 3.8B | MIT | 可能 | 日本語は公式対応言語、品質は要確認 | 約4〜6GB(4bit概算) |
| Mistral AI(Mistral Small 4) | Mistral AI | 2026年03月16日 | 総119B、有効6.5B | Apache 2.0 | 可能 | 多言語で利用可能、日本語品質は要検証 | GPUメモリ約60GB以上(公式目安) |
| Gemma 4(E4B) | 2026年03月31日 | 有効4.5B、総8B | Apache 2.0 | 可能 | 日本語を含む140以上の言語に対応 | 約4.5GB(公式Q4_0目安) | |
| CyberAgentLM3-22B | サイバーエージェント | 2024年07月09日 | 約22.5B | Apache 2.0 | 可能 | 日本語特化、公開時の日本語評価で高性能 | 約16〜20GB(4bit概算) |
| gpt-oss(20b/120b) | OpenAI | 2025年08月05日 | 20b:約21B/120b:約117B | Apache 2.0+利用ポリシー | 可能、利用ポリシーも確認 | 日本語で利用可能、実務品質は要検証 | 20b:約16GBのメモリ/120b:80GB GPUが目安 |
| Qwen3系(Qwen3-8B) | Alibaba(Qwen) | 2025年04月29日 | 約8B | Apache 2.0 | 可能 | 日本語を含む119言語・方言に対応 | 約6〜8GB(4bit概算) |
| DeepSeek(DeepSeek-R1) | DeepSeek | 2025年01月20日 | 本体:総671B、有効37B/蒸留版:1.5B〜70B | MIT(本体)、派生元の条件に注意 | 可能、蒸留版は要確認 | 日本語で回答可能、言語混在に注意 | 蒸留Qwen-7B:約6〜8GB(4bit概算) |
| LLM-jp-4(8B/32B-A3B) | 国立情報学研究所 | 2026年04月03日 | 8B:約8.6B/32B-A3B:総約32B、有効約3.8B | Apache 2.0 | 可能 | 日本語重視、日本語MT-Benchは8Bで7.54 | 8B:約8〜10GB(4bit概算) |
表のVRAMは、主に4bit量子化したモデルをGPUで実行する場合の概算です。公式が保証する最低スペックではなく、実際の必要容量は量子化方式や処理する文章の長さによって異なります。gpt-ossは独自のMXFP4形式での必要メモリを示しており、CPUやシステムメモリを併用できる場合もあります。
また、商用利用が可能なモデルでも、ライセンスごとに利用条件が違う点に注意が必要です。導入前には公式のライセンスを確認し、日本語での回答精度も実際の業務に合わせて検証しましょう。
①Llama 4(Scout・Maverick)
Llama 4は、Metaが2025年04月05日に公開したオープンウェイトLLMです。ScoutとMaverickの2モデルがあり、文章だけでなく画像の入力にも対応しています。
Scoutは総パラメータ数1,090億で、最大1,000万トークンの長文処理に対応。一方、Maverickは総パラメータ数4,000億で、画像を含む質問への回答にも対応しています。ただし、日本語は公式対応の12言語に含まれていないため、業務利用前の検証が必要です。
ライセンスはLlama 4 Community Licenseで、条件付きの商用利用が可能です。Llama 4の公開時点で、企業と関連会社が提供する製品やサービスの前月の月間アクティブユーザー数が合計7億人を超える場合は、Metaから別途許諾を得る必要があります。
また、EU域内に居住する個人やEUに本拠地を置く企業には、マルチモーダルモデルの利用許諾に制限があります。ただし、モデルを組み込んだサービスの一般利用者は対象外です。導入前に利用規約を確認しましょう。
②Phi-4系
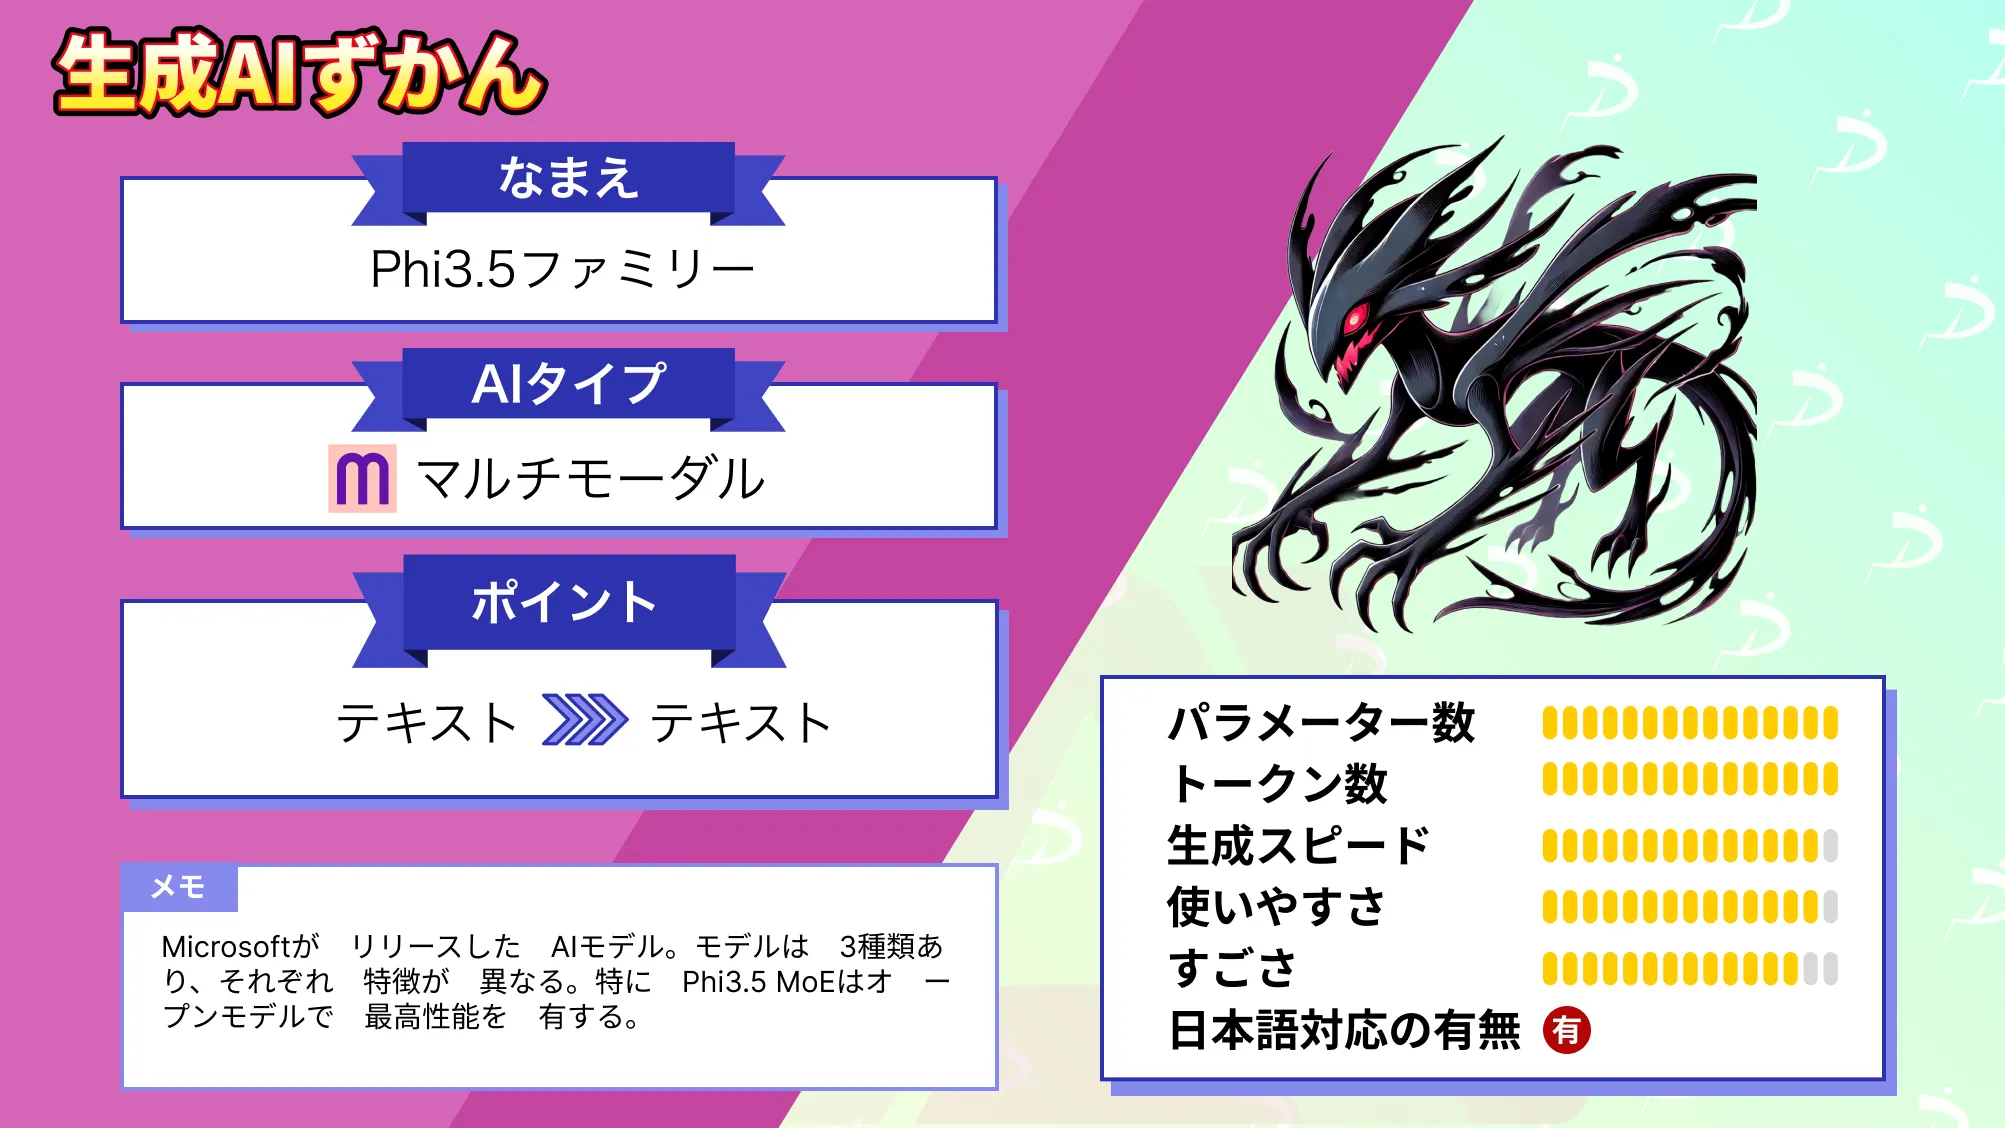
Phi-4系は、Microsoftが開発したオープンウェイトLLMシリーズです。2024年12月に公開されたPhi-4は140億パラメータを持ち、その後も用途に応じたモデルが登場しています。
文章生成向けのPhi-4-mini-instructは38億、画像や音声にも対応するPhi-4-multimodal-instructは56億パラメータです。推論向けにはPhi-4-reasoningとPhi-4-reasoning-plus(各140億)、Phi-4-mini-reasoningとPhi-4-mini-flash-reasoning(各38億)も用意されています。
2026年03月04日には、画像を理解しながら複雑な推論を行うPhi-4-reasoning-vision-15B(150億パラメータ)も公開されました。日本語に対応するモデルもありますが、対応言語はモデルごとに異なるため注意が必要です。
これらのモデルはMITライセンスで公開されており、著作権表示などの条件を守れば商用利用や改変も可能です。ローカルPCでも利用できますが、必要なメモリはモデルの規模によって異なります。
なお、Phi-3.5について詳しく知りたい方は、下記の記事を参考にしてください。
③Mistral AIのオープンモデル(Mistral Small 4など)
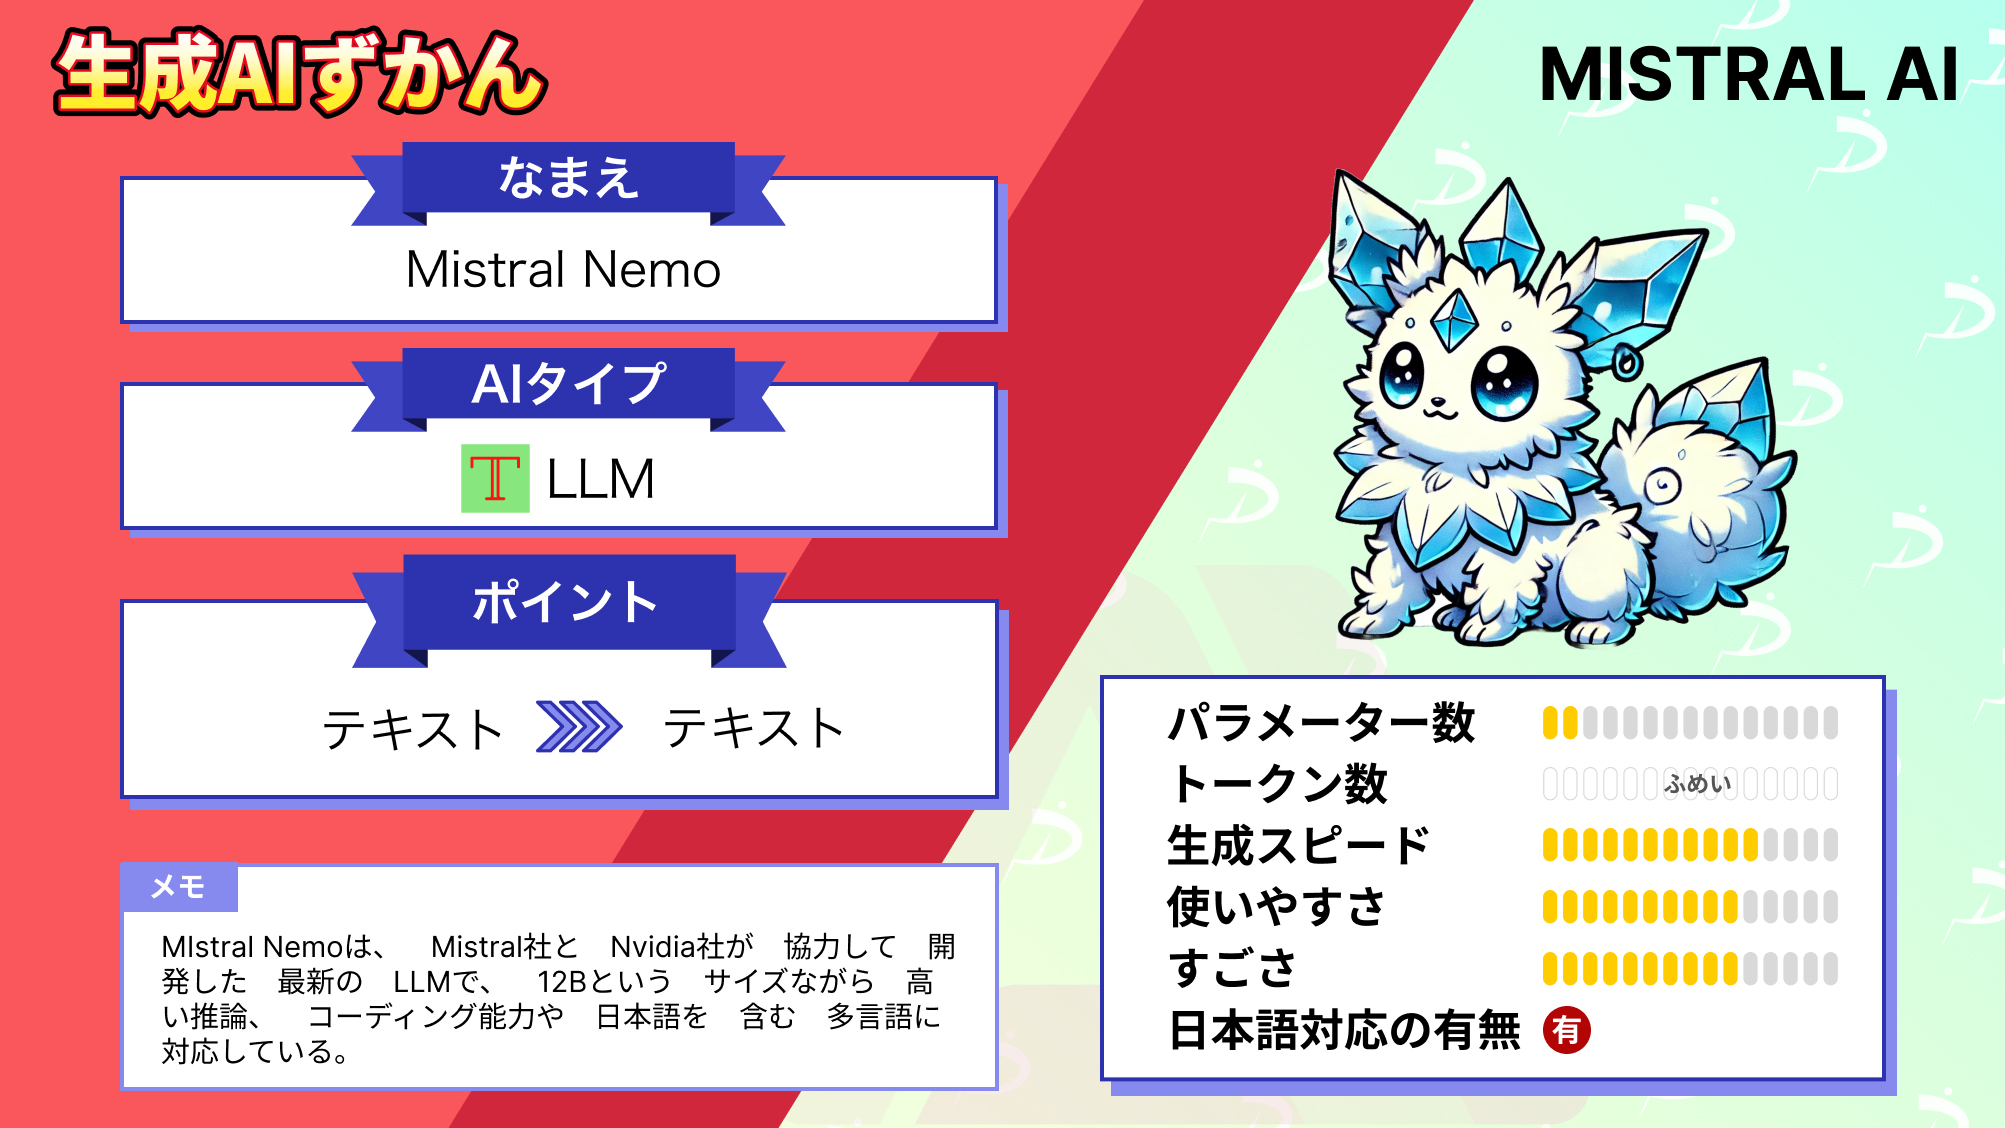
フランスのMistral AIは、日本語にも対応した複数のオープンウェイトLLMを公開しています。2026年03月公開のMistral Small 4は、総1,190億パラメータのうち処理時に約65億を使用し、文章生成や画像理解、推論に対応しています。
ローカルPCで試したい場合は、2025年12月公開のMinistral 3も候補です。30億、80億、140億パラメータのモデルから選択でき、Mistral Small 4とMinistral 3はApache 2.0ライセンスで商用利用も可能です。
一方、2026年04月公開のMistral Medium 3.5(1,280億パラメータ)は修正MITライセンスを採用しています。前月の全世界連結売上高が2,000万ドルを超える企業は、このライセンスに基づく利用が認められていないため、別途商用ライセンスを取得するなどの対応が必要です。そのため、導入前にはモデルごとの利用条件を確認しましょう。
なお、Mistral NeMoについて詳しく知りたい方は、下記の記事を参考にしてください。
④Gemma 4
Gemma 4は、Googleが2026年03月31日に公開したオープンウェイトLLMです。公開当初はE2B・E4B・26B MoE・31Bの4種類があり、2026年06月03日には12Bも追加されました。
全モデルが文章や画像の入力に対応し、E2BとE4B、12Bは音声入力も可能です。日本語を含む140以上の言語に対応しており、小型モデルはローカルPCでも実行できます。
ライセンスはApache 2.0で、条件を守れば商用利用や改変、再配布が可能です。旧Gemma 2に適用されていたGoogle独自の利用規約とは異なるため、導入するモデルのライセンスを確認しましょう。
⑤CyberAgentLM3-22B
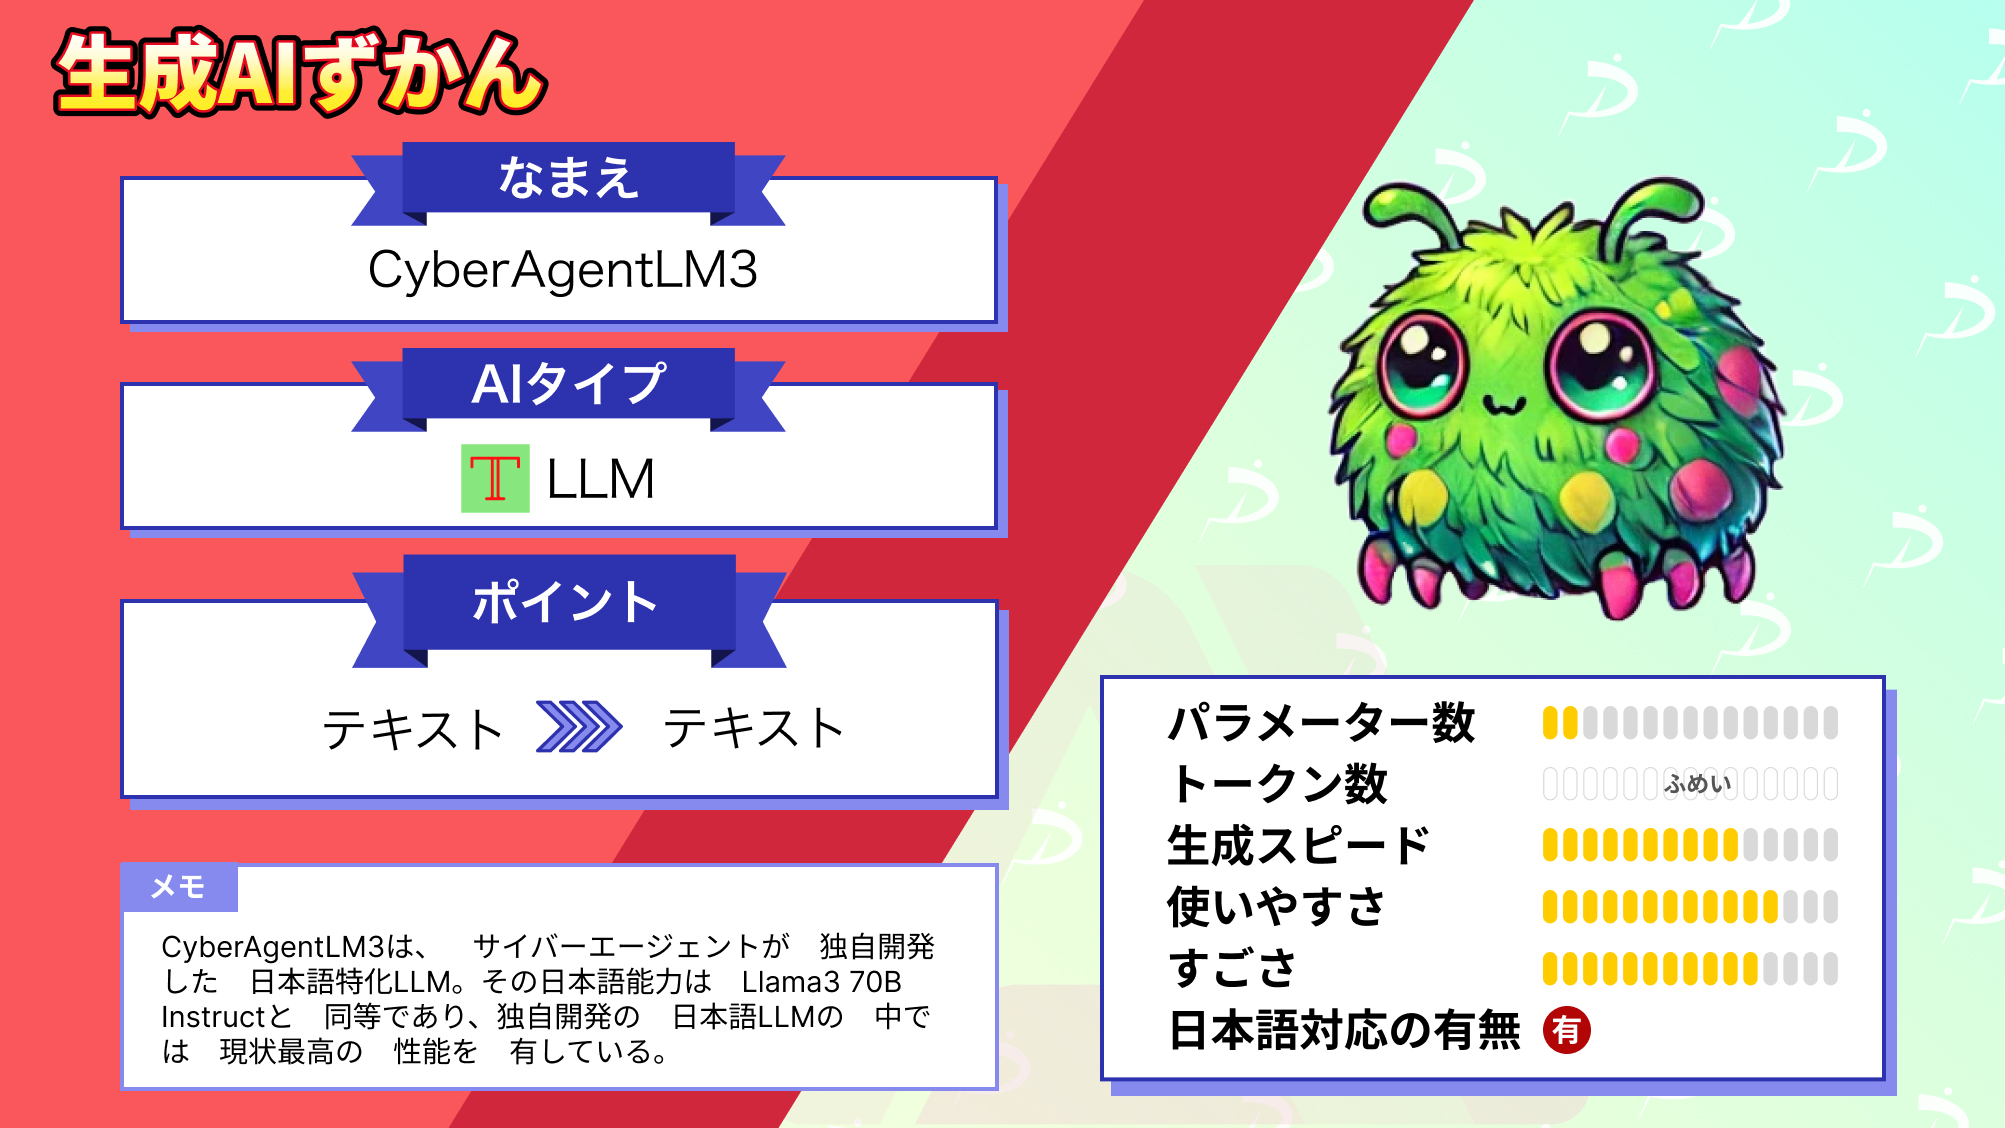
CyberAgentLM3-22B(CyberAgentLM3)は、日本の企業であるサイバーエージェントが公開した日本語特化のオープンソースLLMです。大量の日本語データを用いてトレーニングされ、約225億のパラメータを有しています。
その日本語能力は、Meta社が開発したLlama-3-70B-Instructと同等であり、独自開発されたオープンな日本語LLMとしてはトップクラスの性能をもっているとされています。
CyberAgentLM3はApache License 2.0で提供されているため、商用利用や再配布が可能です。
なお、CyberAgentLM3-22Bについて詳しく知りたい方は、下記の記事を参考にしてください。
⑥gpt-oss
gpt-ossは、OpenAIが2025年08月05日に公開したオープンウェイトLLMです。約210億パラメータのgpt-oss-20bと約1,170億パラメータのgpt-oss-120bがあり、複雑な質問への回答や推論を得意としています。
日本語での利用も可能ですが、主に英語のデータで学習されているため、日本語特有の表現や文章品質は事前の検証が必要です。
ライセンスはApache 2.0で、商用利用や改変が認められています。ローカル実行では、gpt-oss-20bは約16GB、gpt-oss-120bは約80GBのメモリが目安です。商用利用時はOpenAIのgpt-oss利用規約も確認しましょう。
なお、gpt-ossについて詳しく知りたい方は、下記の記事を参考にしてください。

⑦Qwen3系
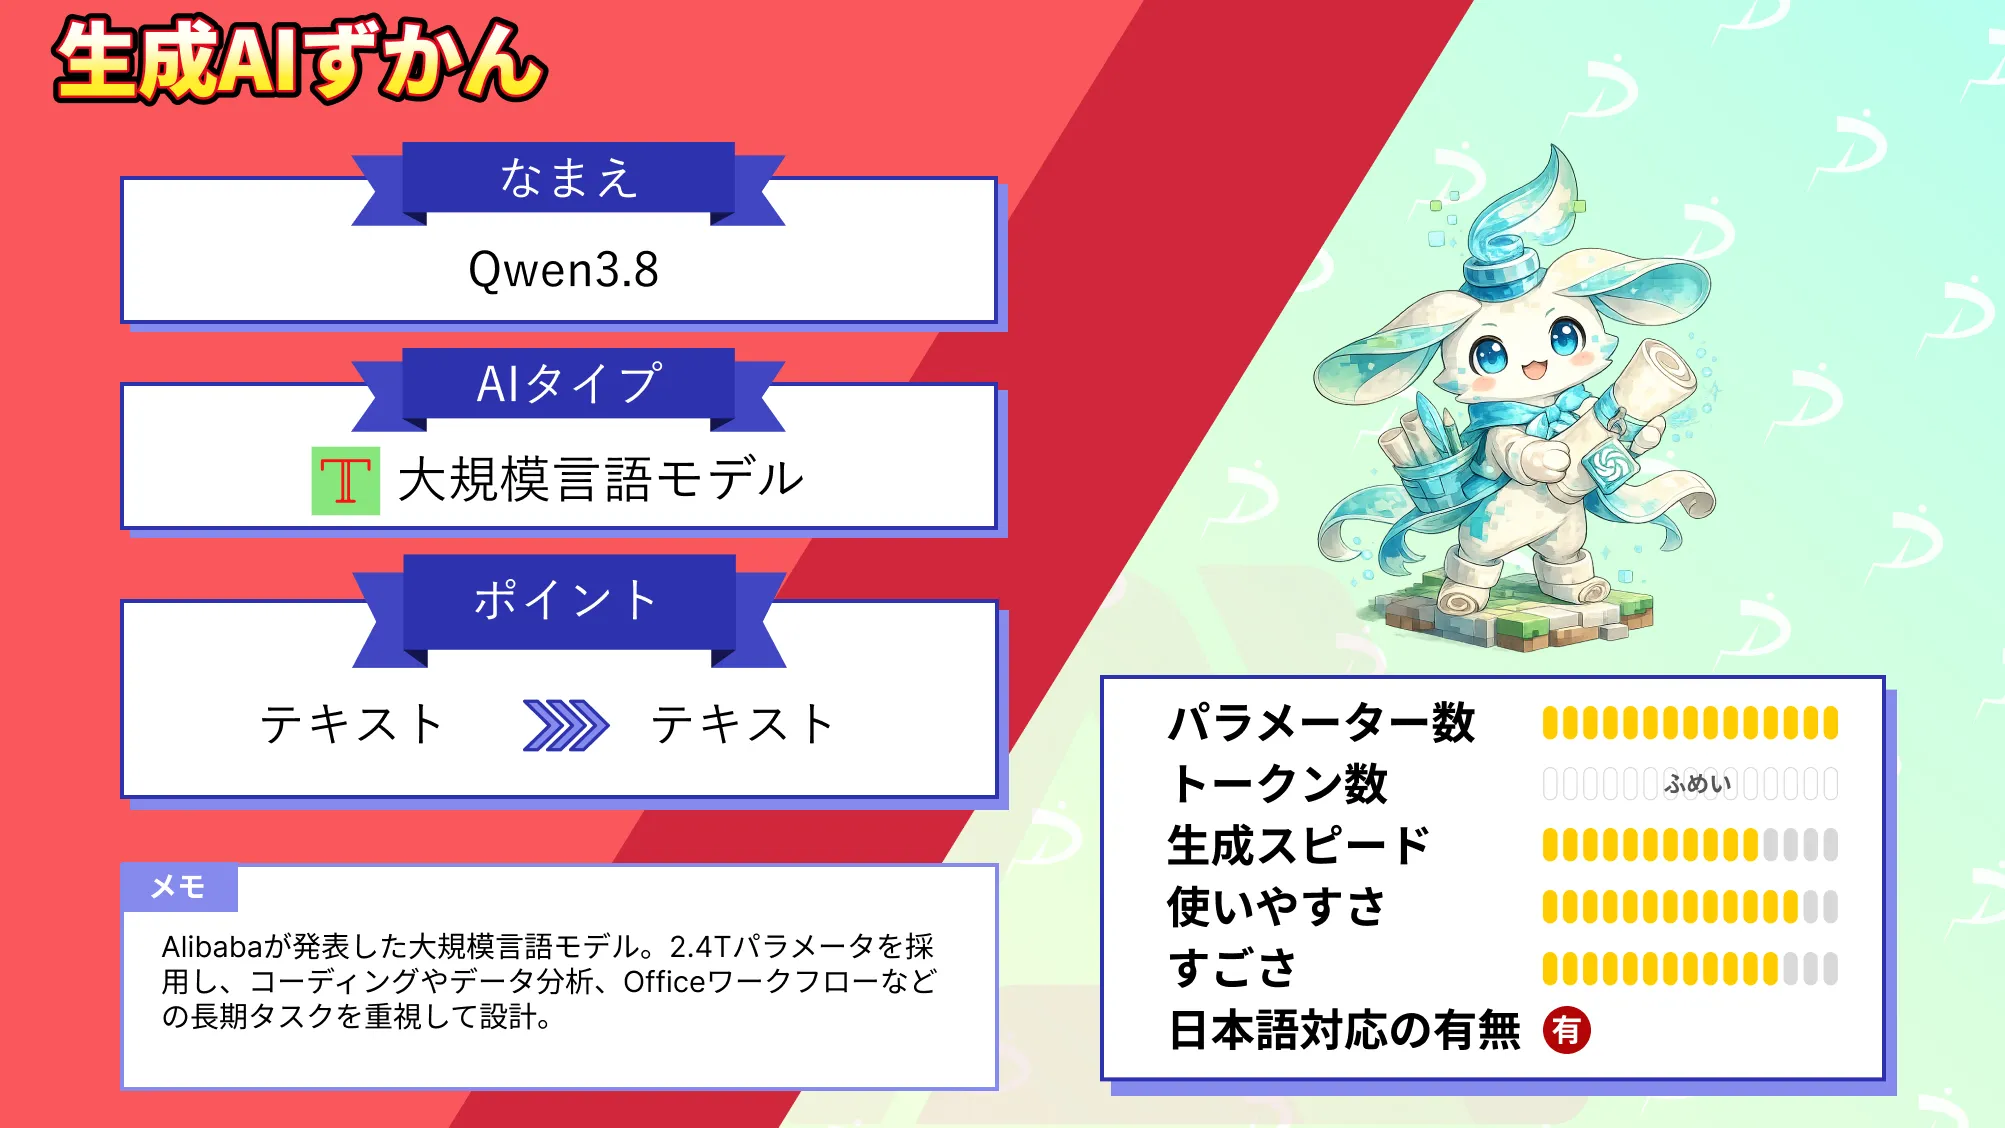
Qwen3は、中国のAlibaba傘下のQwenチームが2025年04月29日に発表したオープンウェイトLLMです。初期モデルには6億から2,350億まで幅広いパラメータ規模が用意されており、用途に応じて選択できます。
日本語を含む119の言語と方言に対応しており、日本語での文章生成や質問応答にも使用可能です。推論に特化した動作モードも備えています。
主要モデルはApache 2.0ライセンスで公開されているため、商用利用や改変が可能です。ローカルPCで8Bモデルを4bit量子化して試す場合、GPUメモリ8GB以上、システムメモリ16GB以上が一つの目安となります。
なお、Qwen3シリーズの後継にあたるQwen3.8について詳しく知りたい方は、下記の記事を参考にしてください。
⑧DeepSeek
DeepSeek-R1は、中国のDeepSeekが2025年01月20日に公開した推論型LLMです。約6,710億パラメータの大規模モデルに加え、15億から700億パラメータの軽量な蒸留モデルも公開されています。
数学的な推論やプログラミングに強みがあり、日本語での質問にも対応しています。ただし、日本語の回答に別の言語が混ざる場合があるため、業務利用前に品質を確認しましょう。
DeepSeek-R1のライセンスはMITで、商用利用や改変が可能です。ただし、Llamaをベースとした蒸留モデルには別途ライセンス上の条件があります。ローカル環境では、7Bモデルの4bit量子化版ならGPUメモリ8GB以上、システムメモリ16GB以上が目安です。
なお、DeepSeekについて詳しく知りたい方は、下記の記事を参考にしてください。
⑨LLM-jp-4
LLM-jp-4は、国立情報学研究所の大規模言語モデル研究開発センターが開発し、2026年04月03日に公開した国産LLMです。約86億パラメータの8Bモデルと、約320億パラメータの32B-A3Bモデルが用意されています。
日本語性能の高さが特徴で、8Bの推論モデルは日本語MT-Benchで7.54、32B-A3Bの推論モデルは7.82を記録しました。同じ評価条件ではGPT-4oの7.29を上回っています。
ライセンスはApache 2.0で、商用利用や改変が可能です。8Bモデルを4bit量子化してローカルPCで試す場合、GPUメモリ8GB以上、システムメモリ16GB以上が目安となります。
なお、LLM-jpシリーズの過去モデルであるLLM-jp-13Bについては、下記の記事で詳しく検証しています。
オープンソースLLMを利用するメリット
オープンソースLLMを選択する方や企業は増えてきていますが、オープンソースLLMにはいったいどのようなメリットがあるのでしょうか。次に、オープンソースLLMを利用するメリットについてご紹介します。
コストを抑えることができる
ChatGPTやGeminiなどのAPIを利用する場合、処理量に応じて料金が発生するため、利用頻度が高いほどコストが増える可能性があります。一方、オープンソースLLMを自社で運用する場合も、GPUサーバー費用や電気代、運用保守にかかる人件費が継続的に発生します。
ただし、APIの従量課金と比べて利用量が多いほどコスト面で有利になりやすいため、長期的な運用を見据えて導入を検討するとよいでしょう。
自由にカスタマイズできる
オープンソースLLMは、自社の業務に合わせて自由にカスタマイズできる点がメリットです。例えば、ファインチューニングやLoRAによって回答の傾向を調整できます。また、RAGを使えば社内データを参照した回答を生成でき、量子化によってモデルを軽量化することも可能です。
ほかにも、対応モデルは自社サーバーやローカルPCで動かせるため、機密情報を社外に送信せずに運用できる点も魅力です。ただし、外部APIを使用しない環境での運用が前提となります。
オープンソースLLMの使い方
オープンソースLLMの使い方は、PCで直接動かす方法だけではありません。自社の情報を社外へ出せるか、どの程度の計算能力が必要かによって適した利用形態が変わります。
ここでは、代表的な3つの使い方とデータの処理場所を紹介します。
| 利用形態 | データの処理場所 | 社外送信の考え方 |
|---|---|---|
| ローカル環境 | 自社PCや社内サーバー | 外部連携がなければ社内で完結 |
| クラウドGPU | 契約先のクラウドサーバー | 契約先の環境で処理 |
| APIやWebサービス | 提供事業者のサーバー | 入力を原則外部へ送信 |
同じモデルでも、利用形態によってデータが社外に送られるかどうかは変わるため、用途に合わせて選びましょう。
ローカル環境(自社PC・サーバー)で動かす
社内データを外部サービスに送らずに使いたい場合は、自社PCや社内サーバーでモデルを実行する方法が向いています。Ollamaなどで対応モデルをダウンロードし、外部APIやクラウドモデルを使用しない構成にすれば、社内だけで質問と回答の処理を完結できます。
ただし、モデルに合うGPUメモリや保存容量が必要です。詳しい操作手順は、後半の「Ollamaでの導入手順」で紹介しています。
クラウドのGPUサーバーで動かす
大きなモデルを動かしたい場合は、GPUを搭載したクラウドサーバーを借りる方法があります。自社PCに高価なGPUを用意せずに試せる一方、サーバー利用料が継続的に発生します。
入力した文書は契約したクラウド環境で処理されるため、機密情報を扱う場合は保存先の地域やアクセス権限、ログの取り扱いを事前に確認しましょう。
APIやWebサービス経由で使う
APIやWebサービスで公開モデルを使う方法なら、自分でGPUサーバーを管理せずに始められます。ブラウザで質問するだけのサービスもあれば、自社システムからAPIを呼び出す方法もあります。
ただし、入力データは提供事業者の環境へ送られるのが一般的です。料金体系やデータ保存の条件を確認し、機密文書を送ってよいか社内ルールと照らし合わせましょう。
オープンソースLLMを利用する際の注意点
メリットを見ていただいてわかる通り、長期的にコストを抑えやすく、自由にカスタマイズできるオープンソースLLMは、今後さらに普及が進んでいくことが予想されます。
しかし、利用するにあたって注意しなければならないこともあります。次に、オープンソースLLMを利用する際の注意点について見てみましょう。
悪意のあるコードが含まれている可能性がある
オープンソースLLMやオープンウェイトLLMを導入する際は、モデルの配布元とファイルの安全性に注意が必要です。非公式に改変・再配布されたモデルには、悪意のあるプログラムが含まれている可能性があります。
特に、pickle形式のモデルファイルには、読み込み時に任意のコードが実行されるリスクがあります。そのため、可能な限り安全性の高いsafetensors形式を選びましょう。
モデルはHugging Faceにある開発元の公式組織のリポジトリから取得し、公開されているスキャン結果や更新履歴も確認することが重要です。また、導入後も利用権限を制限し、モデルの更新時には安全性を再確認しましょう。
専門的なスキルが必要
オープンソースLLMやオープンウェイトLLMは、OllamaやLM Studioなどのツールを使えば、専門知識がなくても比較的簡単にローカルPCで試せます。モデルのダウンロードから実行まで手軽に行えるため、以前より導入のハードルは下がっています。
ただし、企業で本格的に運用する場合は専門知識が必要です。GPUサーバーの構築やセキュリティ対策に加え、モデルの更新や不具合への対応も自社で行わなければなりません。
そのため、継続的な運用を任せられる人材の確保や、外部の専門企業による支援を検討することが重要です。
【実践検証】オープンソースLLMをローカルPCで動かして日本語性能を比較してみた
オープンソースLLMは、実際にローカルPCで動かすと、どの程度の日本語性能を発揮するのでしょうか。今回は、Phi-4-mini・Qwen3 8B・Gemma 4 E4Bの3モデルをWindows PCで実行し、日本語での回答品質や処理速度を比較しました。
検証には、社内での利用を想定した議事録の要約とビジネスメールの作成を採用しています。社内規程に関する質問にも回答させ、業務で使える精度があるかを確認しました。
検証環境と方法
今回の検証では、Windows PCにOllamaをインストールし、各モデルをローカル環境で実行しました。使用したPCは、CPUがIntel Core i7-13700F、GPUがNVIDIA GeForce RTX 3080という構成です。
GPUのVRAM容量は10GB、メインメモリは32GBで、Ollamaのバージョンは0.40.2を使用しています。検証したモデルの詳細は以下の通りです。
| モデル | パラメータ数 | 量子化方式 | Ollamaでのモデル名 |
|---|---|---|---|
| Phi-4-mini | 3.8B | Q4_K_M | phi4-mini |
| Qwen3 8B | 8.2B | Q4_K_M | qwen3:8b |
| Gemma 4 E4B | 7.5B | Q4_K_M | gemma4 |
いずれも4bit量子化されたモデルを使用し、同じ文章を入力して比較しました。検証ごとに新しい会話を開始していますが、モデル固有の思考機能や生成設定は統一していないため、処理速度は参考値として扱います。
PCのGPU情報は、PowerShellで確認しました。
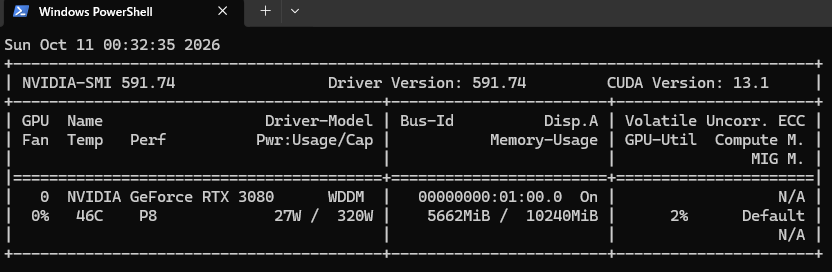
なお、モデルの個別IDと実行中のメモリ使用量は記録していないため、今回の比較対象には含めていません。
Ollamaでの導入手順
今回使用したOllamaは、AIモデルを自分のPCにダウンロードして実行できるツールです。Windowsにも対応しており、専門的な開発環境を構築せずにローカルLLMを試せる点が特徴です。
実際に行った導入手順を紹介します。
Ollamaをインストールする
Ollamaの公式サイトからWindows版をダウンロードし、インストーラーを起動します。初期設定でアカウント作成を求められますが、ローカル環境だけで利用する場合は登録を省略できます。
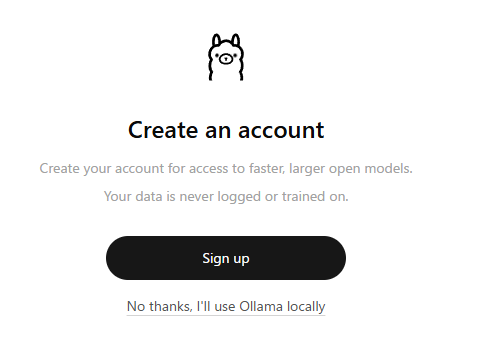
今回はアカウントを作成せず、ローカル環境での利用を選択しました。
PowerShellでインストールを確認する
インストールが完了したらPowerShellを開き、以下のコマンドを実行します。
ollama --version正常にインストールされていれば、Ollamaのバージョン番号が表示されます。
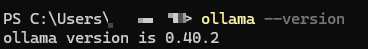
今回の環境では、Ollama 0.40.2が表示され、正常にインストールできたことを確認しました。
AIモデルをダウンロードする
続いて、実際に使用するモデルをダウンロードします。今回はPhi-4-miniを選び、以下のコマンドを入力しました。
ollama run phi4-mini初回はモデルのダウンロードが始まり、完了すると入力待ちの画面が表示されます。
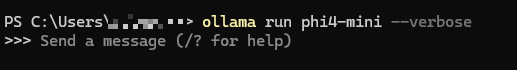
ダウンロード済みのモデルは、次回から同じコマンドで起動可能です。
AIモデルを起動して日本語で質問する
モデルが起動したら、入力欄に日本語で質問を送信します。今回は回答品質だけでなく処理速度も比較するため、以下のコマンドで詳細表示モードを使用しました。
ollama run phi4-mini --verbose回答後には、処理時間や1秒あたりの生成トークン数が表示されます。
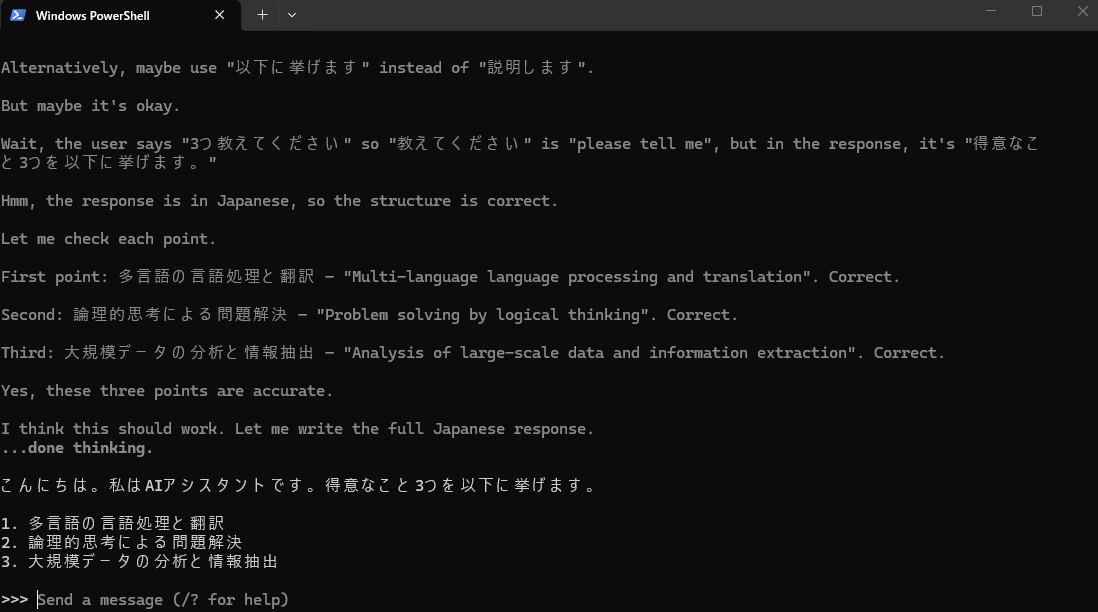
このように、Ollamaを使えばローカルPCでも日本語の質問に回答させることができました。ここからは、3モデルを使って実際の業務を想定した検証を行います。
検証1 社内文書の要約
最初に、約800字の架空の社内議事録を使用して、要約性能を比較しました。議事録には、問い合わせ件数が前月比約20%増加している状況や、担当部署ごとの作業期限を記載しています。
全モデルに同じ議事録を入力し、3行で要約するよう指示しました。結果は以下の通りです。
| モデル | 回答品質 | 処理時間 | 生成速度 |
|---|---|---|---|
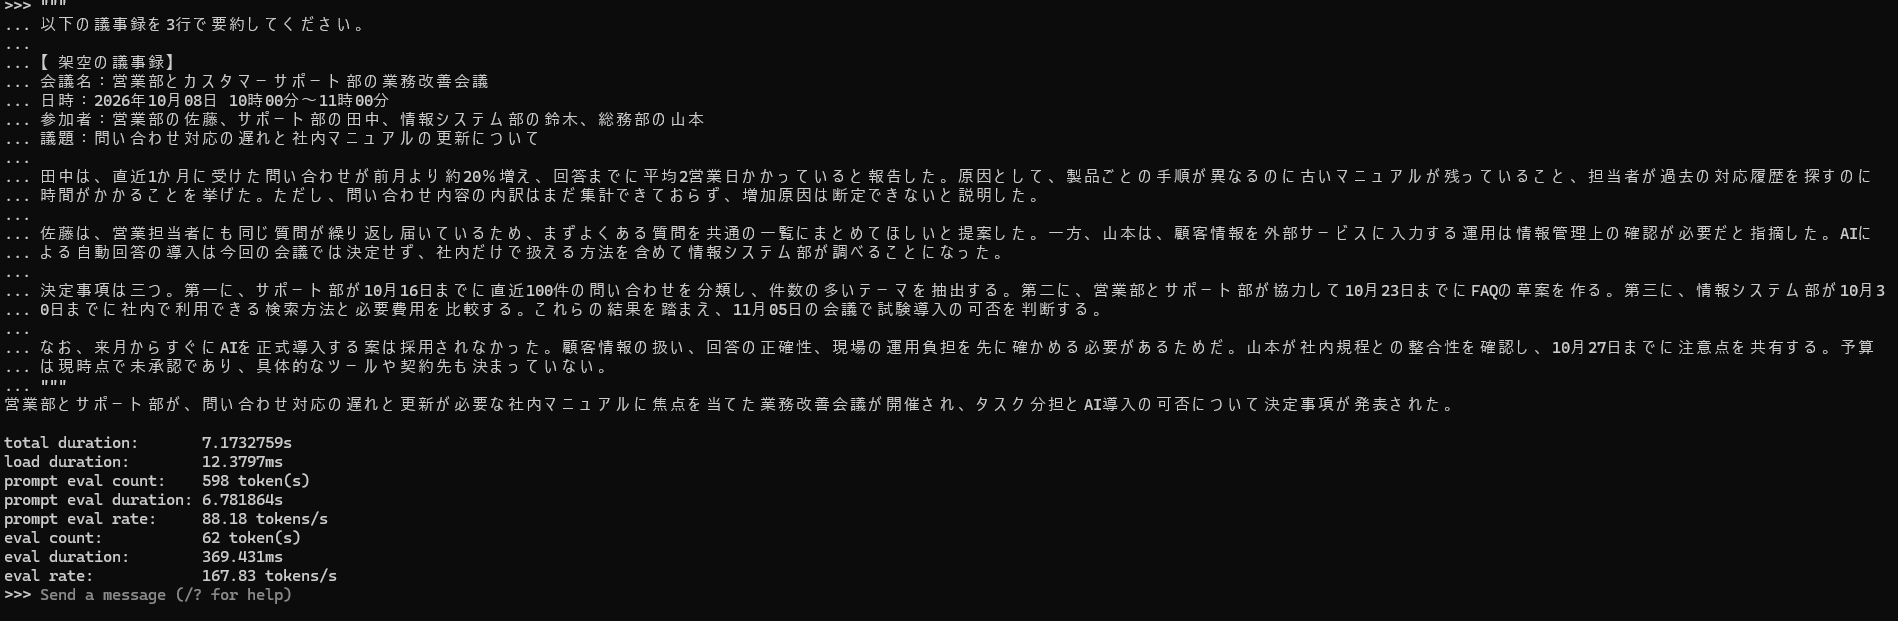
| Phi-4-mini | △ | 7.17秒 | 167.83 tokens/s |
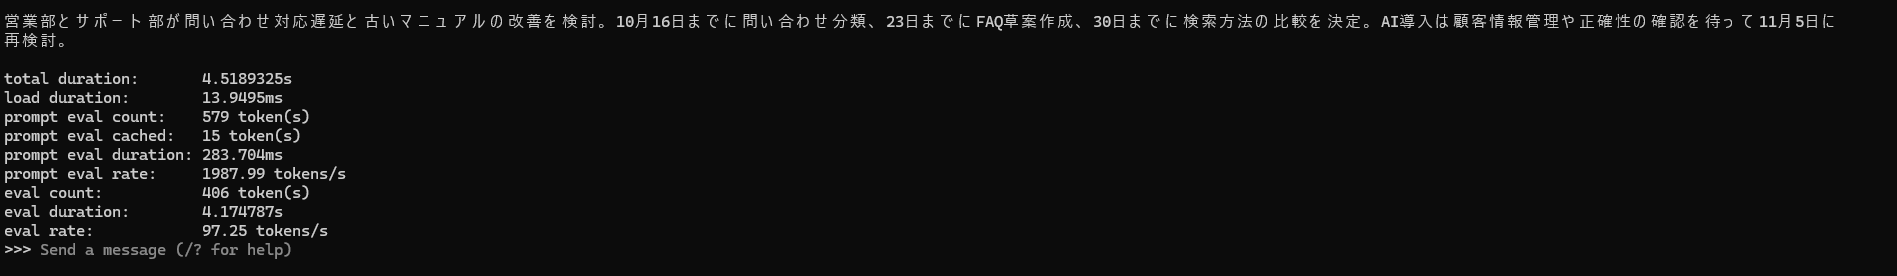
| Qwen3 8B | ○ | 4.52秒 | 97.25 tokens/s |
| Gemma 4 E4B | ○ | 4.22秒 | 161.58 tokens/s |
まず、Phi-4-miniは議事録のテーマを把握できたものの、具体的な作業期限が抜けていました。また、3行という指示を守れず、1文だけの要約となっています。
一方、Qwen3 8Bは、10月16日から30日までの作業期限や、11月05日にAI導入の可否を判断する予定まで盛り込めていました。ただし、こちらも3行という指示には従っていません。
Gemma 4 E4Bは、自然な日本語で簡潔な3行の要約を生成しました。しかし、具体的な期限が省略されており、要約の前に余分な説明も表示されています。
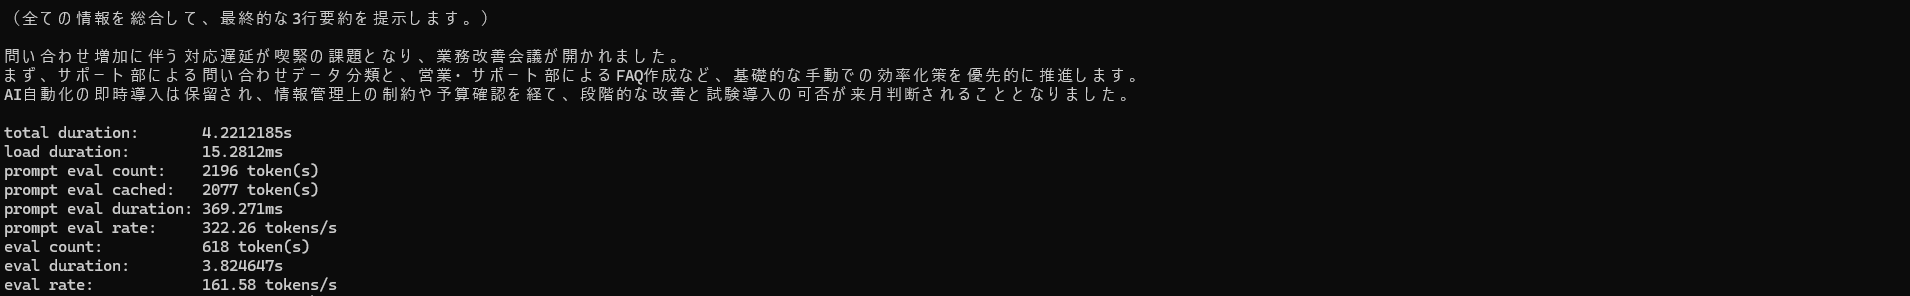
具体的な決定事項を残せたのはQwen3 8B、簡潔さではGemma 4 E4Bが良好という結果でした。業務で議事録を要約する場合は、読みやすさだけでなく、重要な情報が抜けていないかも確認する必要がありそうです。
検証2 敬語のビジネスメール作成
次に、取引先への謝罪メールと日程調整メールを作成し、日本語の自然さや敬語の正確さを比較しました。謝罪メールでは、見積書の提出が2営業日遅れた状況を指定。
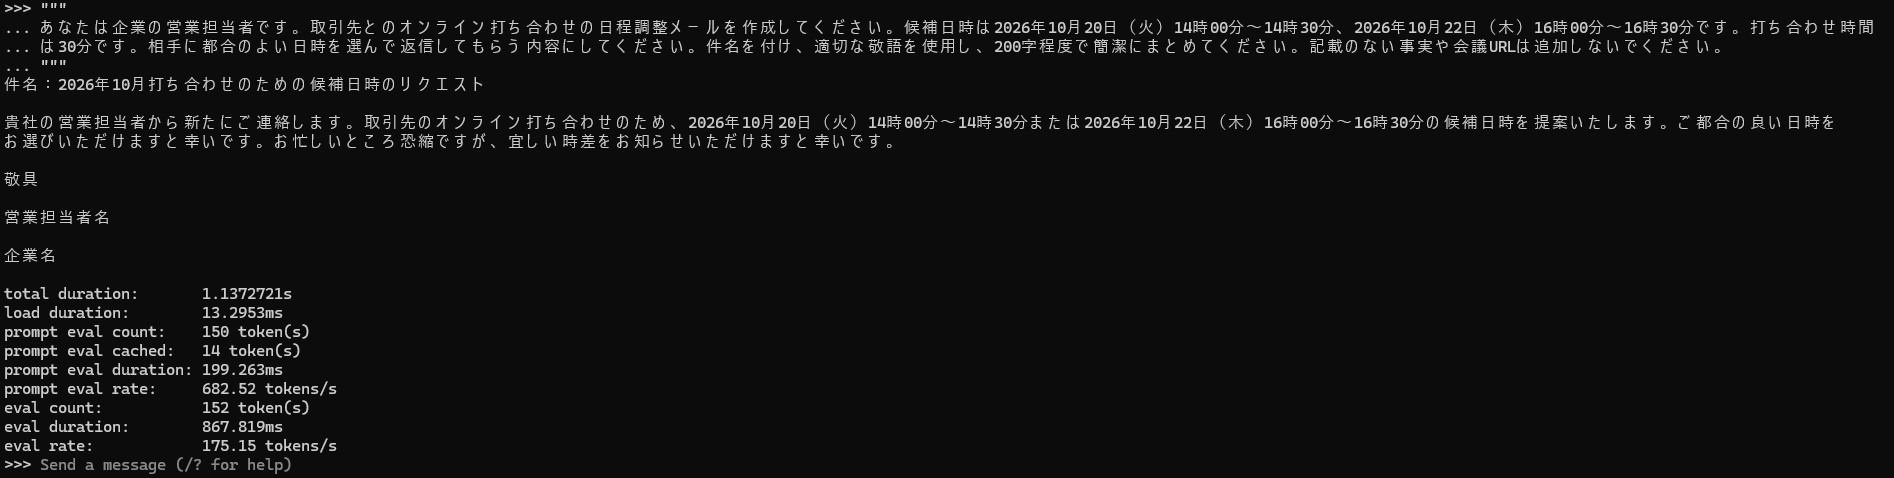
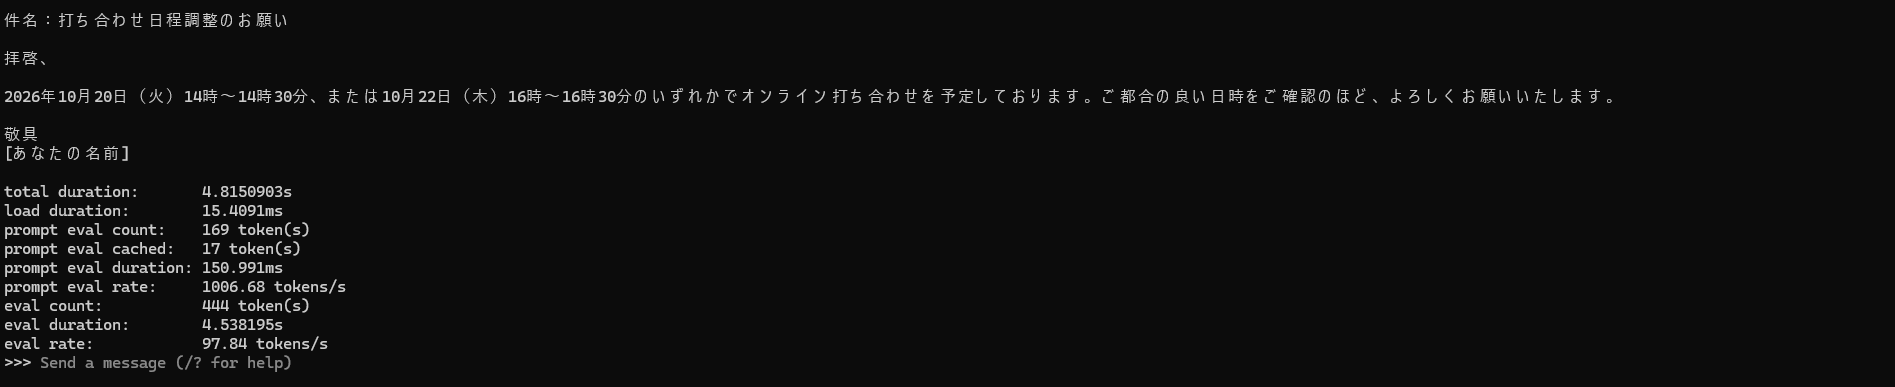
日程調整メールでは、2つの候補日時を提示し、相手に返信を求める内容を作成させています。どちらも200字程度で、指定されていない事実を追加しないよう指示しました。
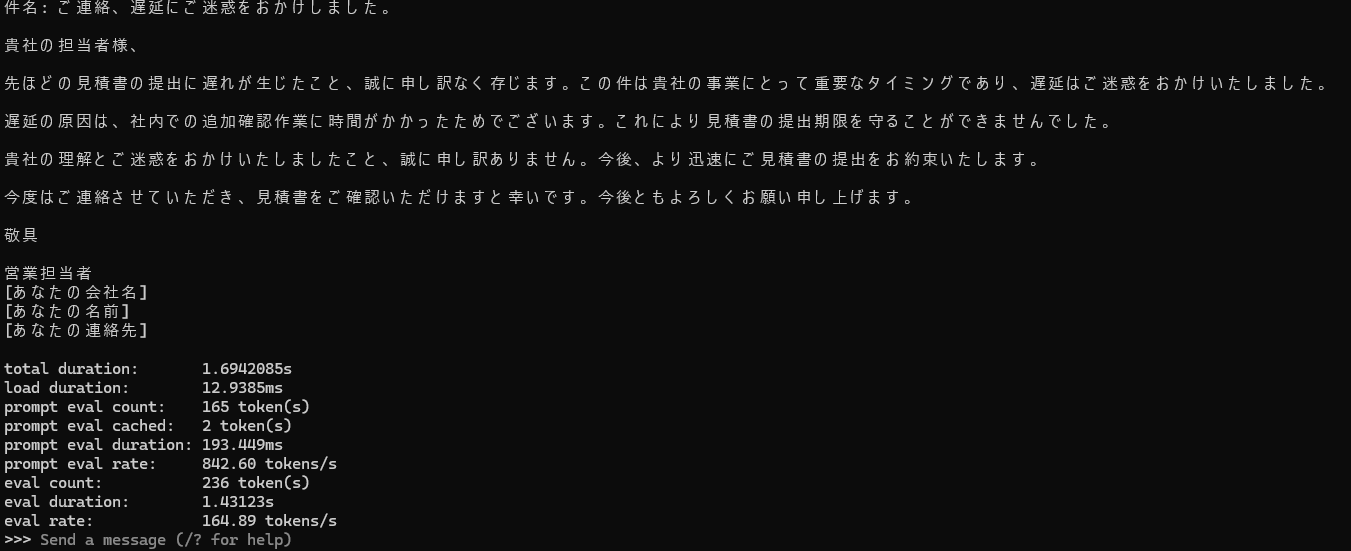
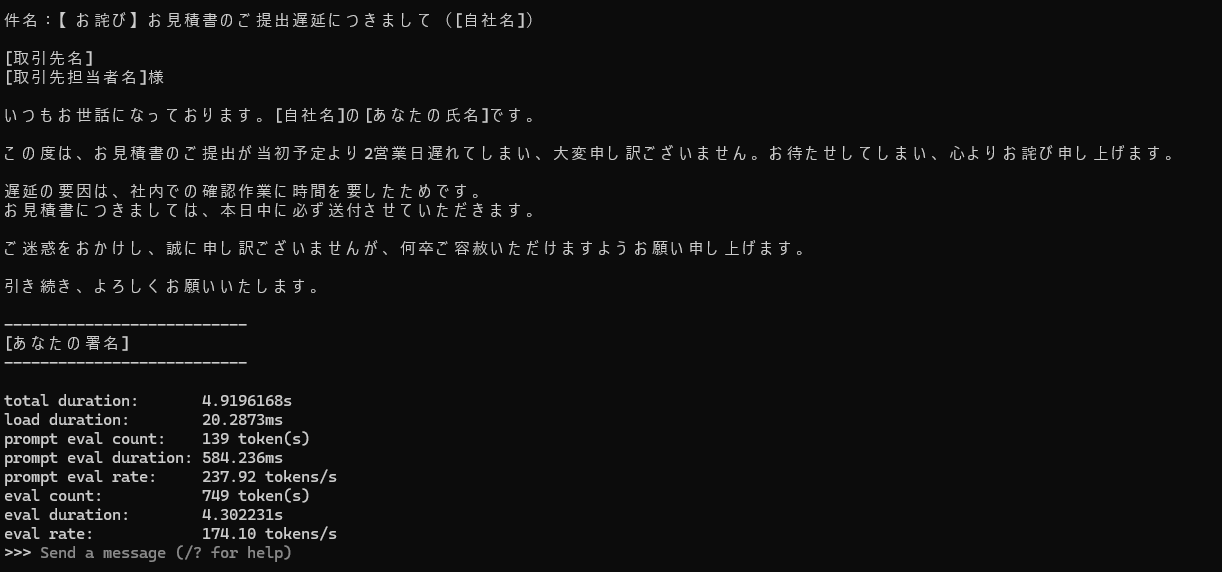
まずは、謝罪メールの結果を見てみましょう。Phi-4-miniは、謝罪の意図は伝わるものの、提出が2営業日遅れたことや、本日中に見積書を送付することが抜けていました。
敬語にも不自然な部分が見られます。
Qwen3 8Bは、2営業日の遅延理由や本日中の送付予定を正確に記載できました。ただし、一部の敬語や再発防止に関する表現には修正が必要です。
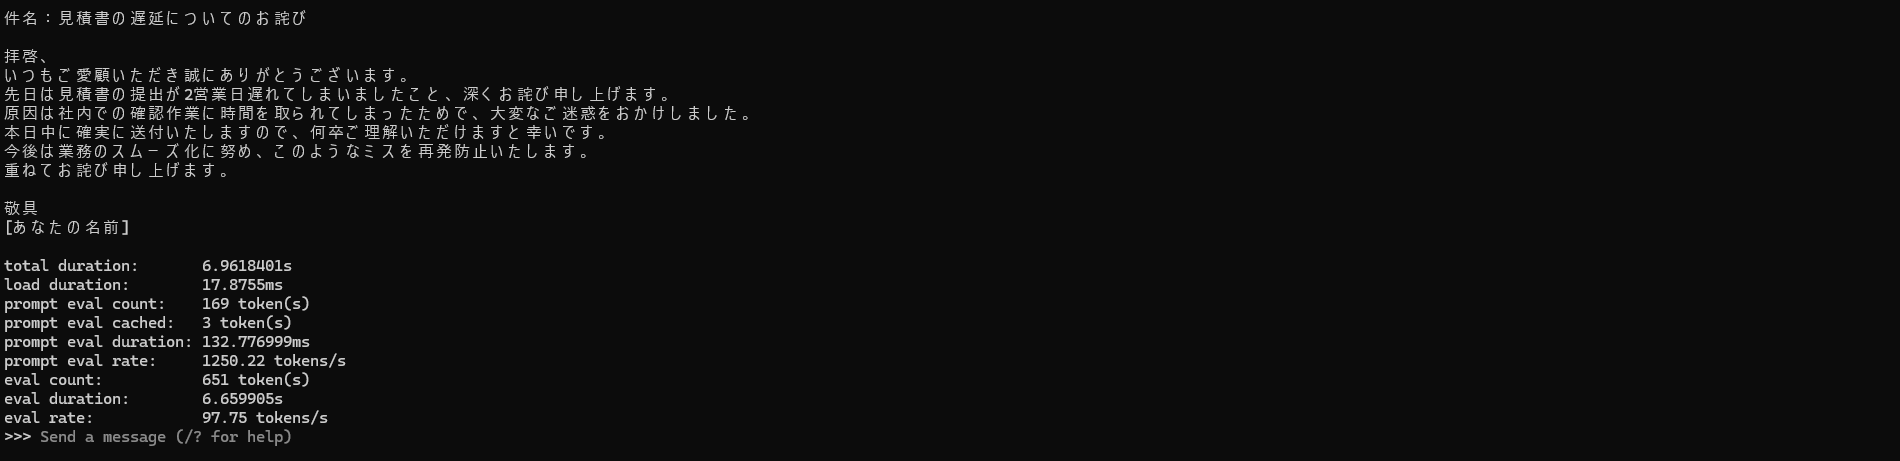
Gemma 4 E4Bは、指定した内容を全て盛り込み、自然な謝罪メールを作成しました。謝罪表現の重複や文章の長さは気になるものの、今回の3モデルでは最も完成度の高い回答となっています。
続いて、日程調整メールの結果も確認しましょう。Phi-4-miniは、候補日時を正しく記載できた一方で、日時を時差と表現する誤りが見られました。また、相手の企業を指す敬語の使い方にも違和感があります。
Qwen3 8Bは、2つの候補日時を正確に記載し、大きな日本語の誤りもありませんでした。ただし、相手に希望日時を選んで返信してもらう表現は、やや不自然です。
Gemma 4 E4Bは、候補日時を正確に記載したうえで、相手に返信を求める自然な文章を生成しました。一部の表現は簡潔にできますが、敬語もおおむね適切です。
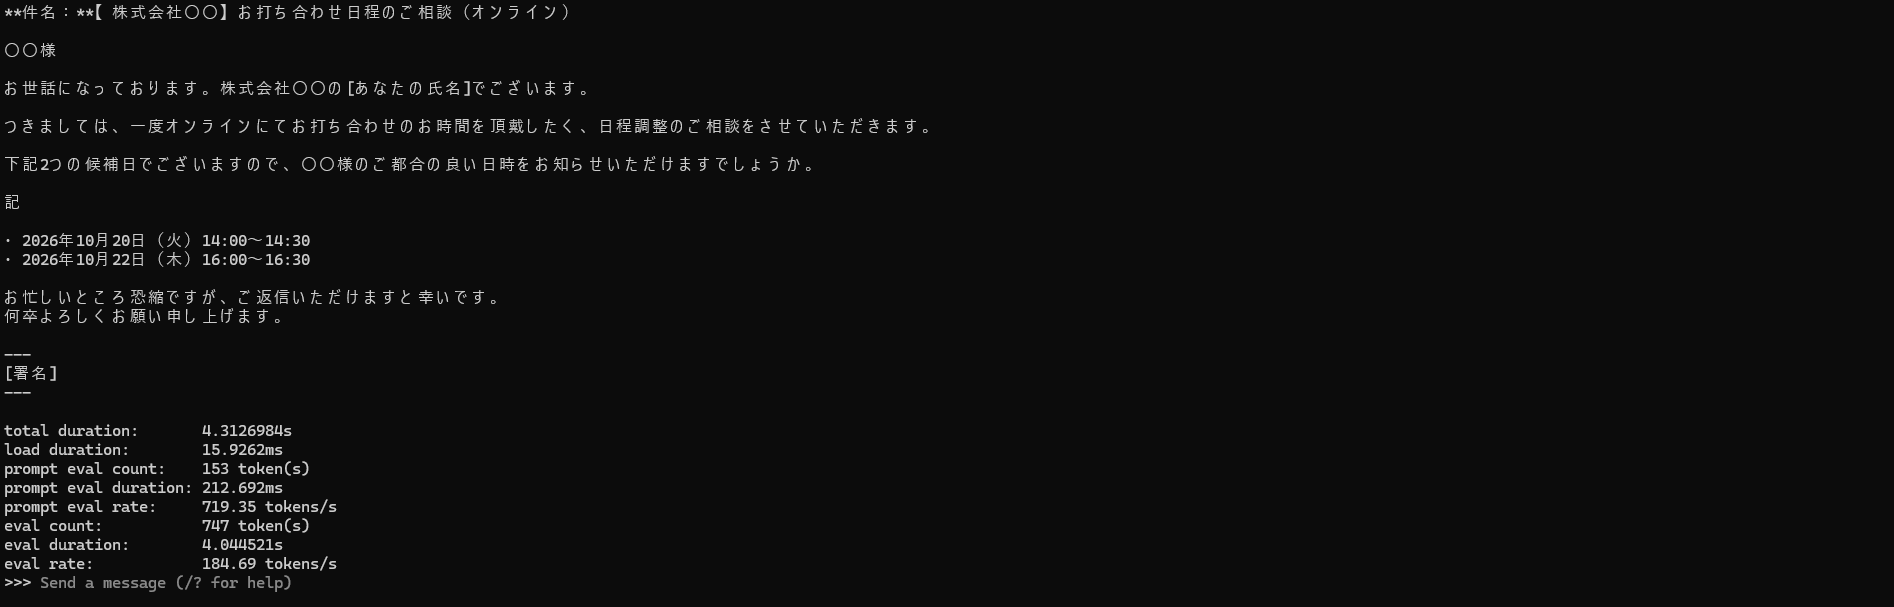
2種類のメール作成結果を比較すると、以下のようになりました。
| モデル | 謝罪メール | 日程調整メール | 処理時間(謝罪/日程調整) |
|---|---|---|---|
| Phi-4-mini | △ | △ | 1.69秒/1.14秒 |
| Qwen3 8B | ○ | ○ | 6.96秒/4.82秒 |
| Gemma 4 E4B | ◎ | ◎ | 4.92秒/4.31秒 |
今回の検証では、Gemma 4 E4Bが日本語の自然さと指示への忠実さで良好な結果となりました。ただし、どのモデルも人による確認が不要になるほどの精度とはいえず、送信前の見直しは必要です。
検証3 社内規程を読ませて質問に回答
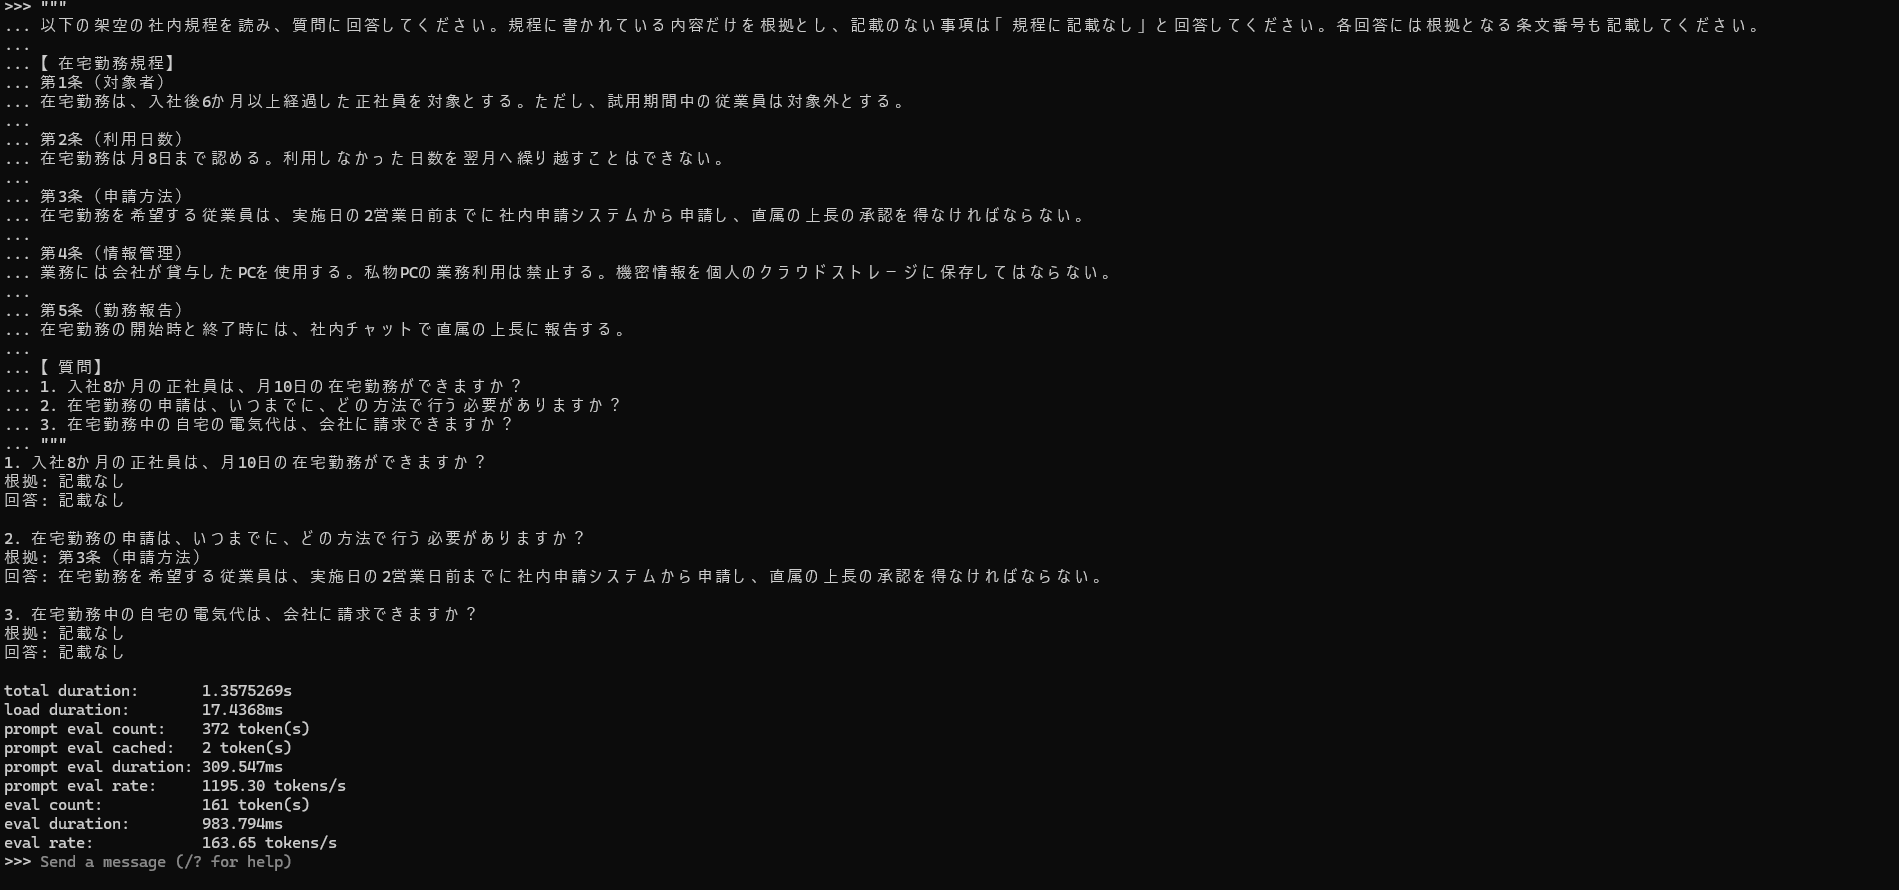
最後に、架空の在宅勤務規程を入力し、記載されたルールを正確に読み取れるか検証しました。規程には、在宅勤務は月8日までという制限や、実施日の2営業日前までに申請するルールを記載しています。
質問は3問用意し、規程にない内容は推測せず、記載なしと回答するよう指示しました。
| 質問内容 | Phi-4-mini | Qwen3 8B | Gemma 4 E4B |
|---|---|---|---|
| 月10日の在宅勤務は可能か | × | × | ○ |
| 申請期限と方法 | ○ | ○ | ○ |
| 電気代の請求可否 | ○ | ○ | ○ |
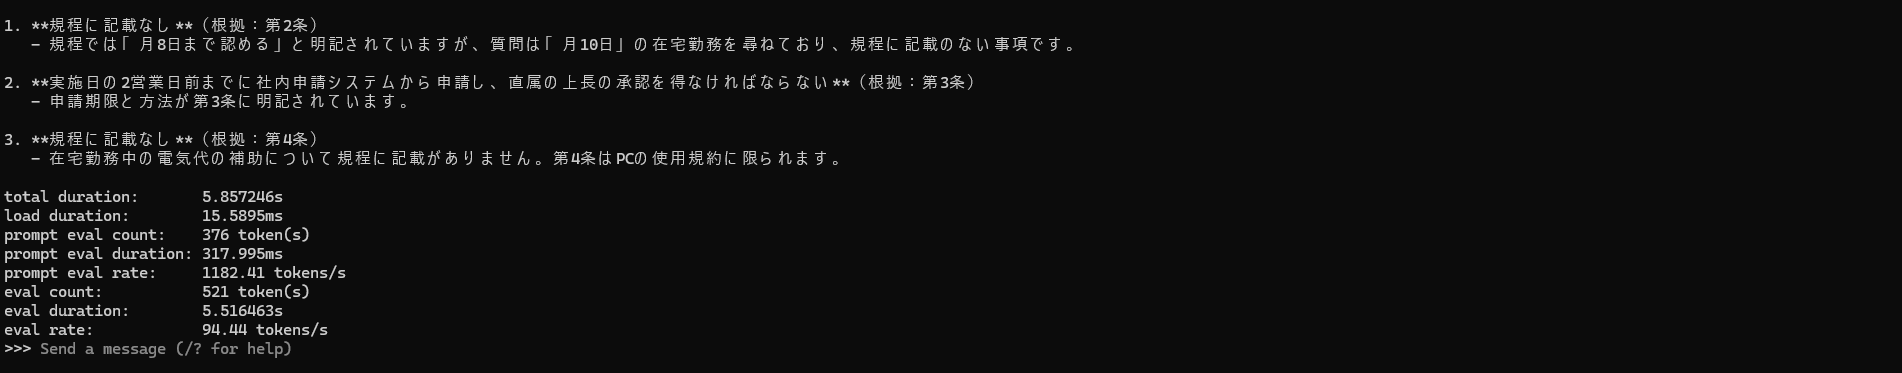
| 正答数 | 2問 | 2問 | 3問 |
Phi-4-miniは、申請方法や電気代に関する質問には正しく回答しました。しかし、月8日までと明記されている在宅勤務の日数については、規程に記載がないと誤答しています。
Qwen3 8Bも同様に、3問中2問は正解しました。ただし、月10日の在宅勤務について誤答しており、一部の回答では根拠として示した条文番号にも不適切な部分が見られます。
一方、Gemma 4 E4Bは、月10日の在宅勤務ができない理由を第2条に基づいて説明できました。申請方法や電気代に関する回答も正しく、3問全てに正解しています。
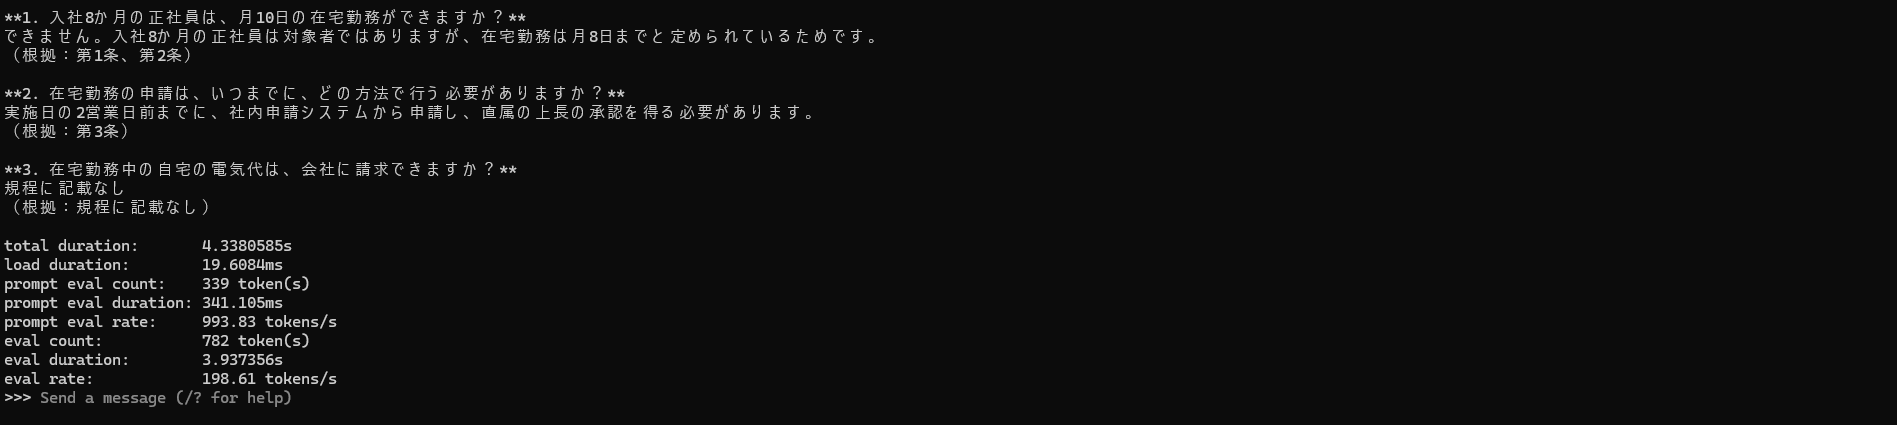
今回の検証ではGemma 4 E4Bが最も正確でした。ただし、各モデル1回のみのテストであり、別の規程でも同じ結果になるとは限りません。実際の業務では、AIの回答と元の規程を照合することが重要でしょう。
検証結果まとめ
今回の検証では、モデルごとに日本語の回答品質や処理速度に違いが見られました。
Phi-4-miniは短時間で回答できる一方、日本語の文章品質には課題がありました。Qwen3 8Bは議事録の要約で重要事項を比較的正確に残せており、Gemma 4 E4Bはビジネスメールや社内規程の質問応答で良好な結果となっています。
各モデルの特徴をまとめると、以下の通りです。
| モデル | 回答品質 | 日本語の自然さ | 処理時間(議事録要約) | メモリ使用量 | 所感 |
|---|---|---|---|---|---|
| Phi-4-mini | △ | △ | 7.17秒 | 未測定 | 応答は軽快だが文章の修正が必要 |
| Qwen3 8B | ○ | ○ | 4.52秒 | 未測定 | 要約で具体的な情報を残せた |
| Gemma 4 E4B | ◎ | ○ | 4.22秒 | 未測定 | メール作成と規程の質問応答が良好 |
今回の結果から、議事録の要約ではQwen3 8B、ビジネスメールの作成や社内規程の確認ではGemma 4 E4Bが候補となるでしょう。ただし、今回の評価は限られた入力例による検証結果であり、モデル自体の性能を断定するものではありません。
企業で導入する際は、実際の業務に近い文章で繰り返し試し、回答精度や運用時の負荷を確認することをおすすめします。
社外にデータを出さない!オープンソースLLMの企業活用パターン
前章では、ローカルPCで複数のLLMを動かし、日本語の回答品質に違いがあることを確認しました。では、企業ではどのような業務に取り入れられるのでしょうか。
オープンソースLLMやオープンウェイトLLMは、自社サーバーで動かし、検索やログ保存まで社内で完結させれば、機密性の高い情報を外部のAIサービスへ送らずに処理できます。WEELへの問い合わせでも、重要文書を社外に出さずに使いたい、社内環境でRAGを構築したいという相談が寄せられています。
ここでは、代表的な3つの運用パターンを見ていきましょう。
機密文書を扱う社内チャットボット(ローカルRAG)
機密文書を扱う社内チャットボットでは、社内規程や業務マニュアルを社内ストレージに置き、質問に関係する箇所を検索してLLMへ渡すRAGが役立ちます。検索と回答生成を社内サーバーで行えば、文書を外部APIに送信せずに済みます。
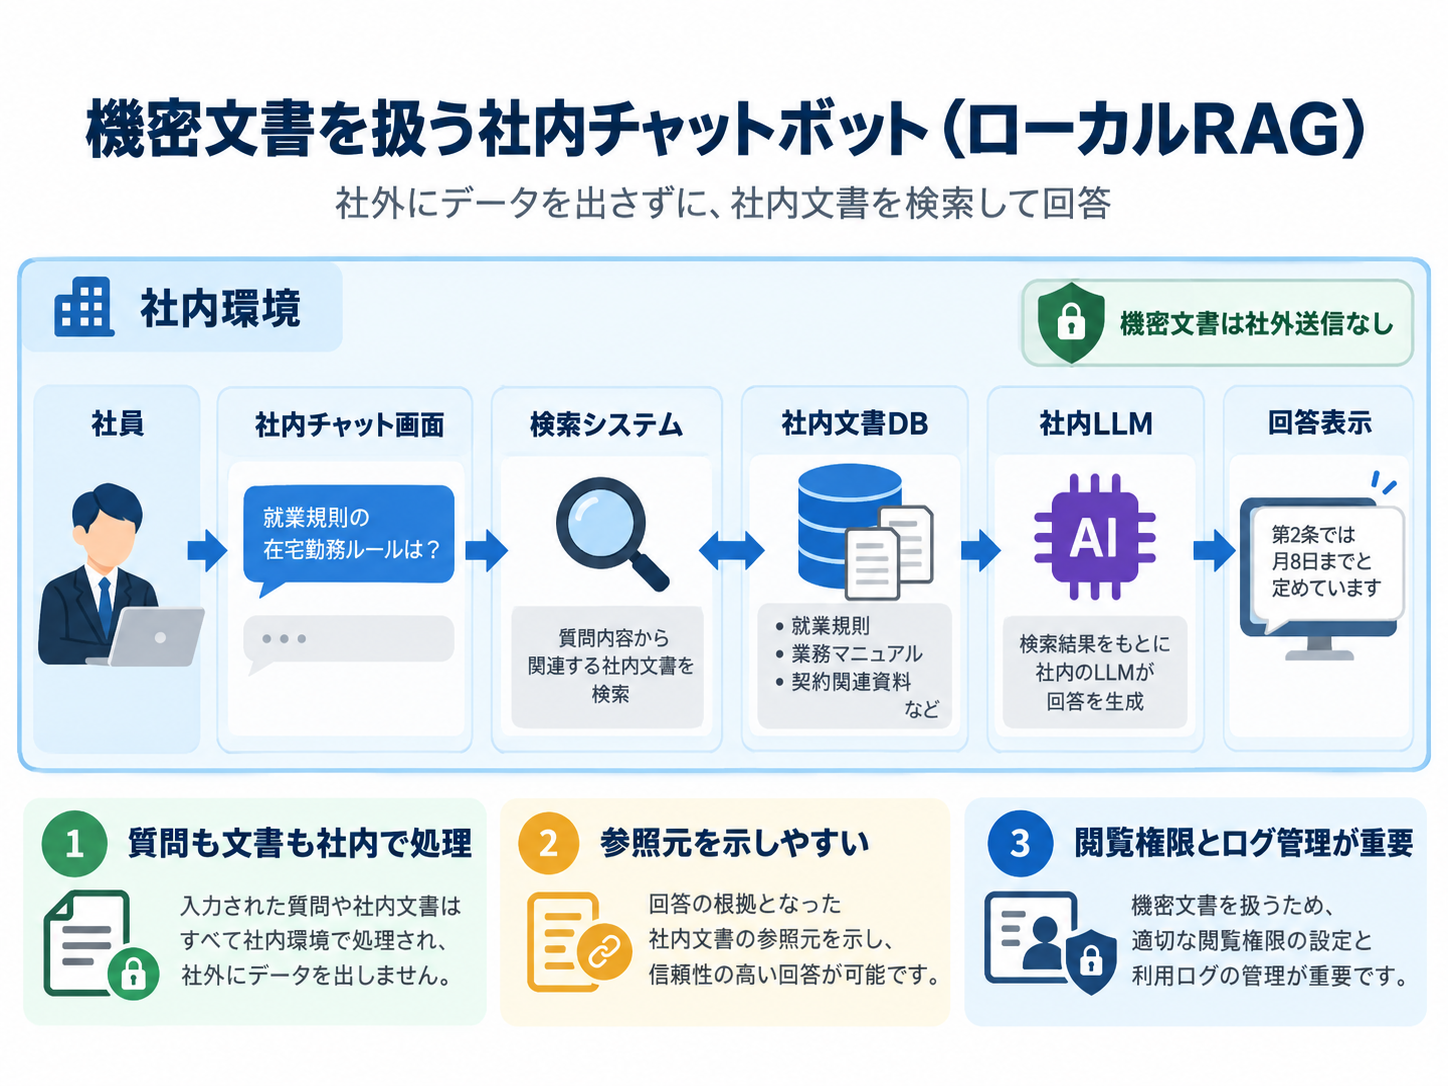
例えば、社員が休暇制度について質問すると、社内の検索システムが該当する規程を取り出し、LLMが回答を作成する流れです。参照した文書名も示せば、内容の確認がしやすくなるでしょう。ただし、データの検索処理やログ保存も社内で完結させ、閲覧権限を適切に管理することが前提です。
オンプレミス環境での資料作成の自動化
営業資料や報告書の下書きも、オンプレミス環境のLLMで作成できます。社員の指示に合わせて社内のテンプレートや過去資料を参照し、文章案を作ったあと、完成前のファイルを社内ストレージへ保存する流れです。
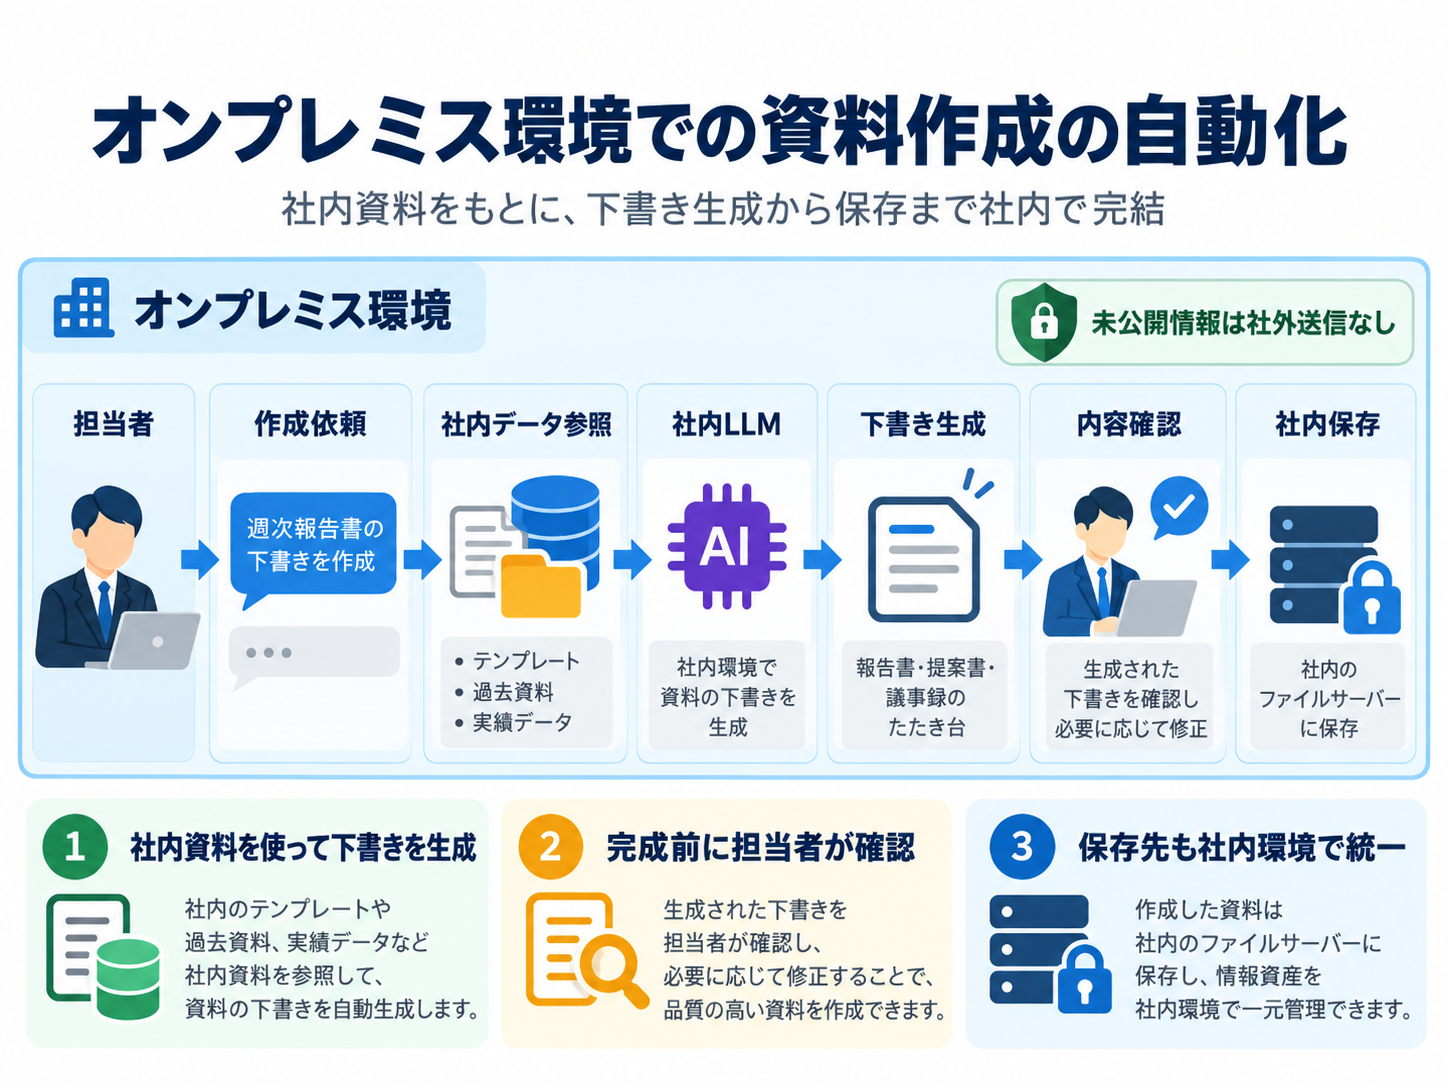
例えば、週次報告書なら、社内で集計した実績を基に下書きを生成し、担当者が数字や文章を確認して仕上げます。外部APIへ未公開情報を送らずに作業を進められる一方、AIが作成した数値や説明には誤りが含まれる場合があります。最終確認は人が行うことが重要です。
API型LLMとの使い分け(ハイブリッド構成)
全ての処理を社内LLMに任せる必要はありません。顧客情報や未公開資料を使う作業は社内LLMへ送り、公開情報だけで完結する文章の下書きは外部のAPI型LLMに任せる方法もあります。
送信前に情報の機密性で処理先を分けることが、この構成のポイントです。
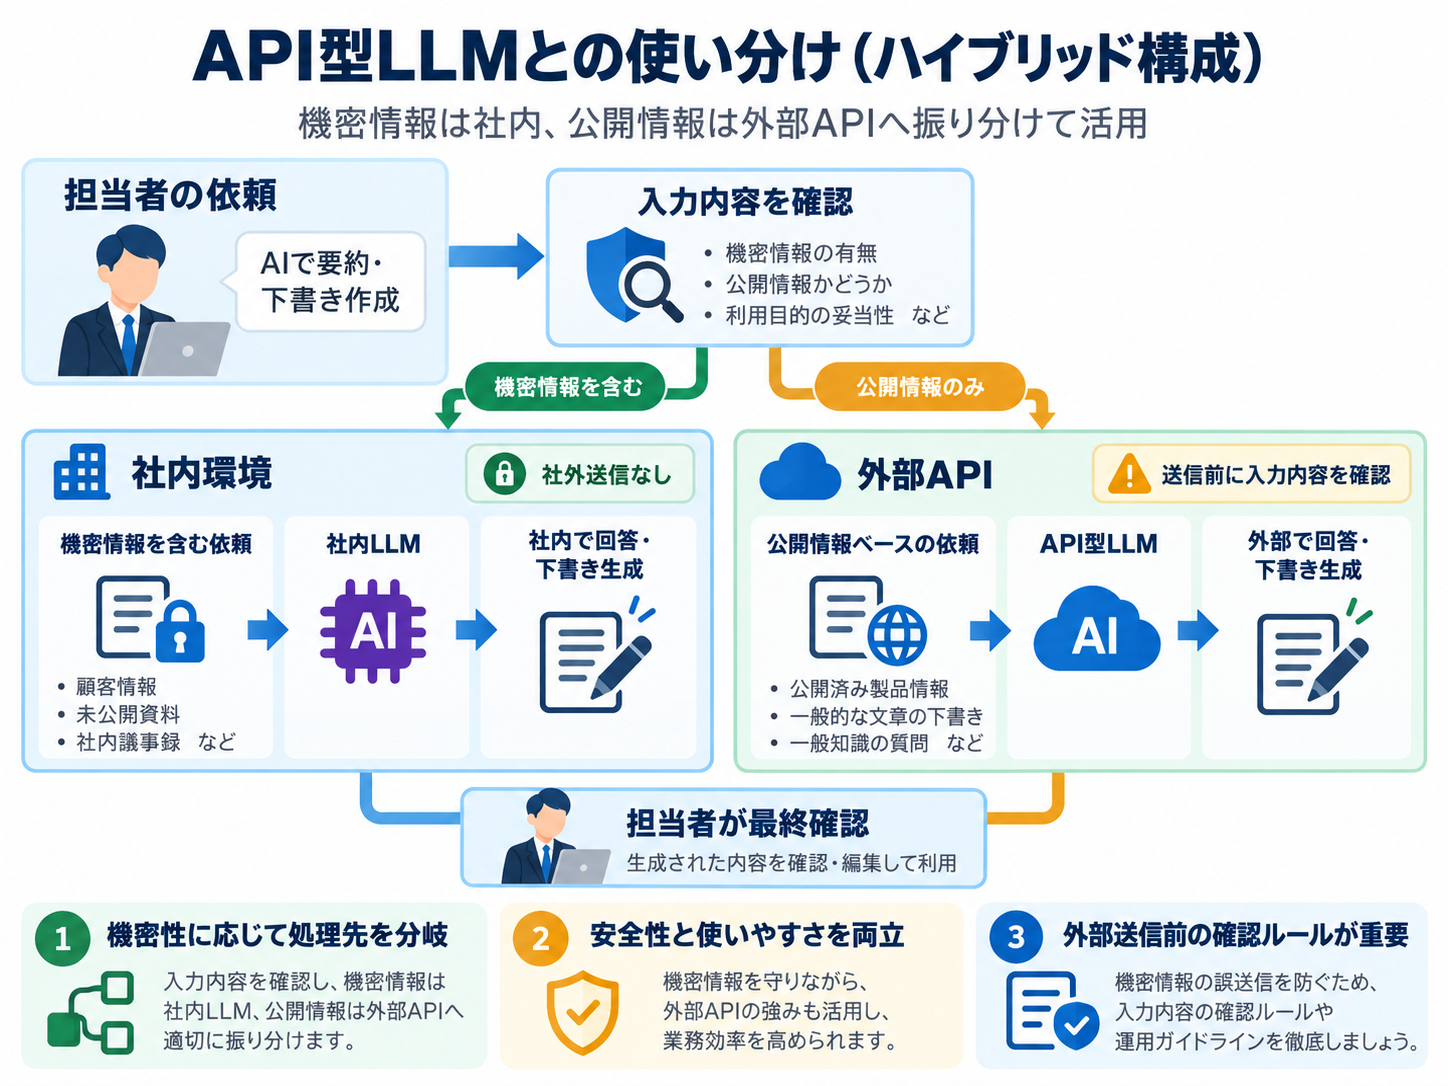
例えば、未公開の商談記録の要約は社内で処理し、公開済みの製品情報を使った広告案はAPI型LLMで作成します。ただし、公開情報を扱う依頼でも、入力文に顧客名や内部資料が混ざる可能性があります。外部送信前の確認と社内ルールの徹底は欠かせません。
このように、オープンソースLLMを企業に取り入れる方法は、扱う情報の機密性や業務の目的によって変わります。社内運用を始めるには、必要なPCやサーバーの性能だけでなく、情報管理や保守の体制も確認しましょう。
自社専用オープンソースLLMの構築・運用はWEELにご相談ください
自社専用のオープンソースLLMを導入するには、モデル選びだけでなく、社内データとの接続やGPU環境の準備、導入後の保守も欠かせません。WEELでは、独自データを使ったAIの開発から導入後の運用支援まで対応しています。機密文書を社外に出さない運用を検討している企業も、まずは無料相談で希望する環境や課題について相談してみてください。
情報収集から始めたい場合は、サービス資料も確認できます。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
オープンソースLLMのよくある質問