Jevとは?LLMの193倍速い「判断だけのAI」System One Modelの仕組み・料金・使い方を徹底解説
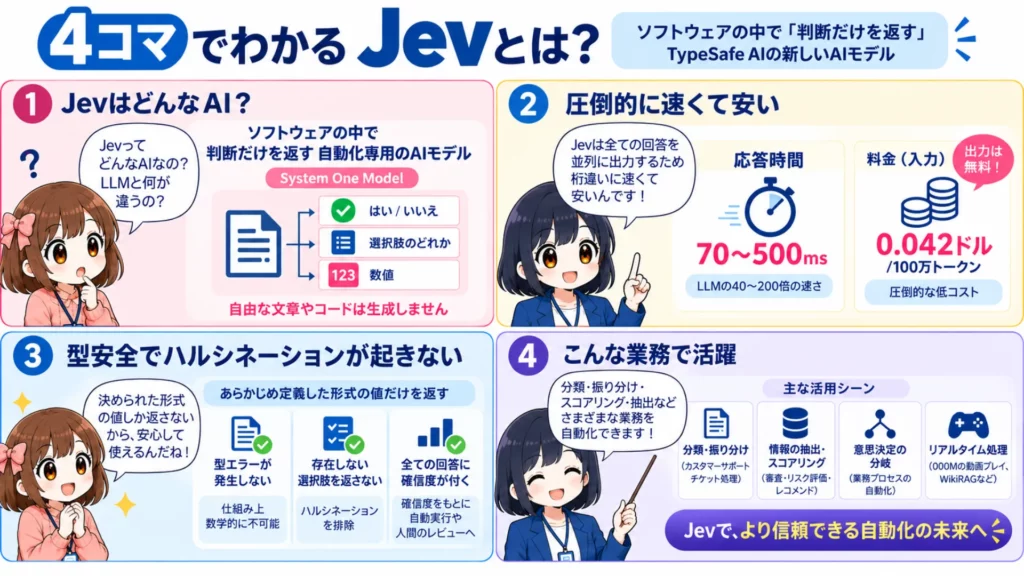
- JevはTypeSafe AIが公開した「判断だけを返す」自動化専用のAIモデルで、自由形式の文章やコードは生成しない
- 全ての回答を並列に出力するため、応答は70〜500ms・入力100万トークン0.042ドル・出力無料と桁違いに速く安い
- あらかじめ定義した形式の値しか返さないため型エラーや存在しない選択肢の回答が仕組み上発生せず、全回答に確信度が付く
2026年9月、米サンフランシスコのTypeSafe AIから初の公開AIモデルが発表されました。
今回登場した「Jev」は、人と対話するのではなくソフトウェアの内部で判断だけを下すという新しい発想のAIモデルです。自由な文章生成を手放す代わりに、System One型タスクでLLMの40〜200倍とされる速度と型エラーや存在しない選択肢を返すハルシネーションが起きない仕組みになっています。
Jevは、状況を説明するデータを送ると「はい/いいえ」「選択肢のどれか」「数値」といった決まった形式で、確信度つきの判断を返します。一方で新しいAIモデルが登場するたびに、「LLMと何が違うのか」「文章を書けないAIに何ができるのか」「自社の業務にどう組み込めばよいのか」といった疑問を感じる方も多いのではないでしょうか。
そこで本記事では、Jevの概要や仕組み、特徴を整理しながら、料金体系や使い方、業界別の活用シーンについて詳しく解説します。最後までお読みいただくことで、Jevがどのような思想で設計され、どのような場面で力を発揮するのかが理解できるはずです。
\生成AIを活用して業務プロセスを自動化/
Jevとは
Jevは、TypeSafe AIが2026年9月に公開した、同社が提唱する「System One Model」と呼ばれる新しいクラスのAIモデルです。
System One Modelとは、ソフトウェアが直接利用できる、高速で構造化された判断を下すために作られた新しいクラスのフロンティアモデル。Jevはその最初の公開モデルで、早期アクセスとして提供が始まりました。
TypeSafe AIを率いるのは、共同創業者兼CEOのDiogo Almeida氏。同氏はOpenAIで言語モデルに指示を従わせる手法の開発に携わり、その成果はChatGPTと同じRLHF系手法の基礎となったInstructGPT論文に結実しています。
| 比較項目 | Jev(System One Model) | 既存のLLM |
|---|---|---|
| 役割 | ソフトウェア内部で判断だけを下す | 人と対話し文章・コードを生成する |
| 出力 | 事前定義した形式の値+確信度 | 自由な文字列(解析・検証が必要) |
| 生成方式 | 全回答を1回の問い合わせで並列出力 | トークンを1つずつ逐次生成 |
| 応答時間 | 70〜500ms | 3〜329秒(TypeSafe AI引用値) |
| 型エラー・スキーマ不一致 | 仕組み上発生しない(判断内容を誤る可能性はある) | 発生しうる |
| 用途 | 分類・振り分け・スコアリング・抽出・分岐 | チャットボット・コパイロット・コーディング |
Jevの仕組み
Jevの速さと堅牢さを支えているのは、自動化だけに焦点を絞って新たに構築されたスタックです。同社によれば新しいモデルアーキテクチャ、効率を最大化する並列サンプラー、そして独自の学習手法「RLCD」の3つで構成されています。
全ての回答を並列に出力する
LLMがトークンを1つずつ、直前の出力に条件付けながら順番に生成するのに対し、Jevは宣言した複数の判断を1回の問い合わせで並列に生成します。
文字列は柔軟で強力ですが、その分コストが高い表現形式。文字列生成を「手放す」ことで、ハードウェアを意識した極めて効率的なサンプリングが可能になっています。
Jevがタスクを処理する基本的な流れは以下のとおりです。
- 開発者が「はい/いいえ」「選択肢のどれか」「数値」など、回答の形式と選択肢をあらかじめ定義する
- 状況を説明するテキスト(プログラムの状態)と複数の質問をまとめて送信する
- Jevが全ての質問に対する確率を並列に出力する
- 各回答に付いた確信度をもとに、周囲のコードが自動実行や人間のレビューへ振り分ける
型安全性で幻覚を仕組みごと排除する
Jevはあらかじめ定義した形式の値しか回答しないため、形式の誤り(型エラー)は仕組みの上で発生しません。TypeSafe AIはこれを「数学的に不可能」と表現しています。
同じ理由で、実在しない選択肢を回答するハルシネーション(幻覚)も発生しないという設計。
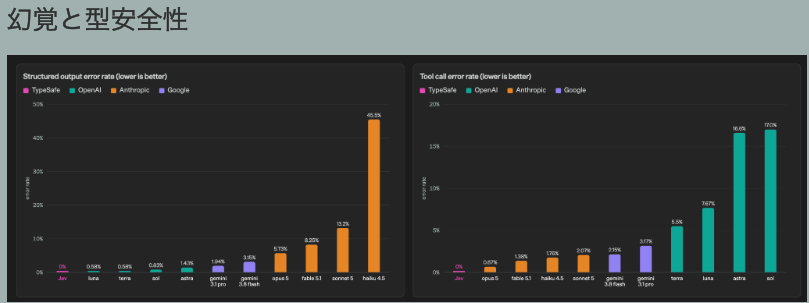
エージェント内でツール呼び出しを幻覚するのは不便で済みますが、レイテンシ保証のあるシステムや依存関係の奥深くに組み込まれた場合には致命的になります。
確信度を鍛える新学習法「RLCD」
学習には、ChatGPTなどで使われるRLHFではなく、独自の「RLCD(Reinforcement Learning for Calibrated Decisions)」を用いています。
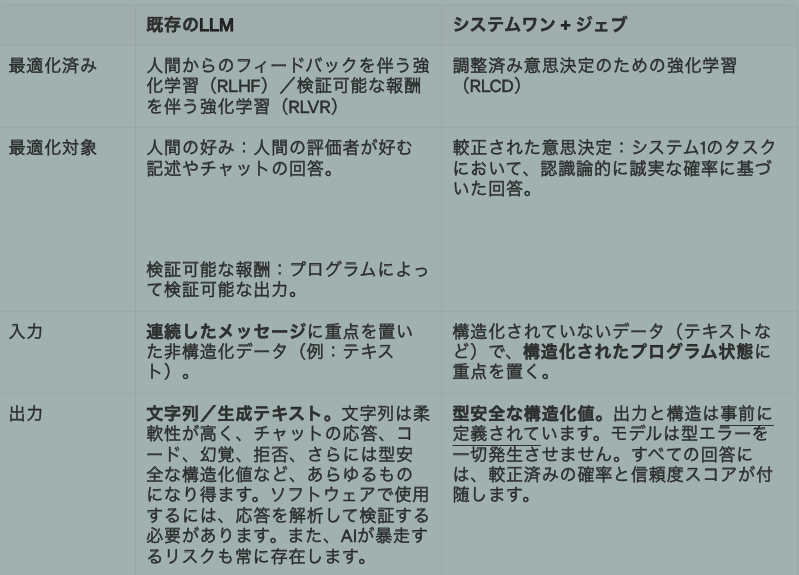
RLHFが人間の評価者に好まれる文章やチャット応答を最適化するのに対し、RLCDは確信度が高いほど実際の正答率も高くなるようモデルを鍛える手法。似た入力には似た答えを返す一貫性も備えています。
| 項目 | RLCD(Jev) | RLHF / RLVR(既存LLM) |
|---|---|---|
| 最適化の対象 | System Oneタスクに対する、認識論的に誠実な確率 | 人間の評価者が好む文章・チャット応答/プログラムで検証できる出力 |
| 入力 | 非構造化データ(構造化されたプログラム状態を重視) | 非構造化データ(逐次的なメッセージを重視) |
| 出力 | 型安全な構造化値+確信度 | 文字列(生成テキスト) |
| 確信度の扱い | 常に確信度と不確実性を伝える。校正済み | 促しても過信気味で一貫性がない |
あるタスクを95%の確率でこなせても、残り5%がいつなのかを申告できなければ自動化はできません。確信度が信頼できることこそ、Jevが自動化に向く最大の理由といえるでしょう。
自律的にタスクを進めるエージェント型AIについて、詳しく知りたい方は下記の記事もあわせてご覧ください。
Jevの特徴
TypeSafe AIはJevを、フロンティア級の判断力を桁違いの速度とコストで提供するモデルと位置づけています。ここでは主な特徴を詳しく見ていきます。
LLMの40〜200倍速く、出力トークンは無料
Jevのエンドツーエンドの応答時間は1回あたり70〜500ms。同社が引用するフロンティアモデルの3〜329秒と比べ、System One型の問い合わせでは同水準の知能で40〜200倍速いとしています。
コストも大幅に低く、入力は100万トークンあたり0.042ドル。出力トークンは「安すぎて課金できない」として無料です。
| 比較項目 | Jev | 比較対象のフロンティアLLM(TypeSafe AI提示値) |
|---|---|---|
| 入力トークン | 0.042ドル / 100万トークン | 0.20〜10ドル / 100万トークン |
| 出力トークン | 無料 | 入力の約5倍 |
| 応答時間 | 70〜500ms | 3〜329秒 |
| ワークフロー評価 | 基準 | Jevが最大で193.6倍高速・444.6倍低コスト(自社評価) |
速度の検証は米西海岸にある同社のノートPCから実行されたもので、サービスも現在は同地域を拠点としています。価格については「補助されていないことは証明できない」としつつ、長期的には上がるのではなく下がると見込んでいる点が興味深いのではないでしょうか。
4種のワークフロー評価で示された速度・コスト優位
TypeSafe AIは、AIがコードの中でどれだけうまく働くかを測る新しいタイプの評価「ワークフロー評価」を作成しました。
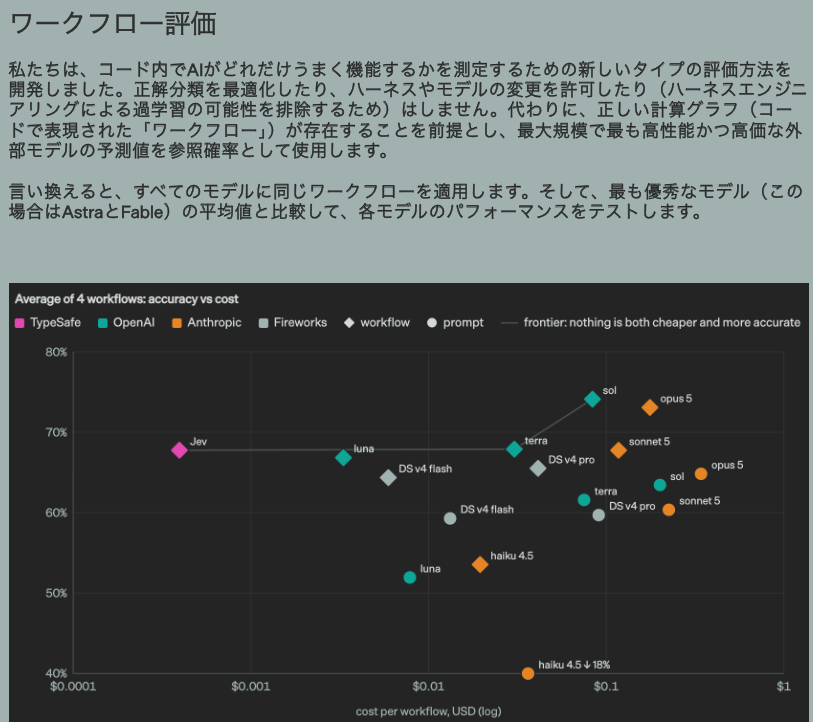
正解ラベルへの最適化やハーネスの変更を許さず、全モデルに同じワークフロー(コードで表現された計算グラフ)を与える方式です。基準となる確率には、GPT-6 AstraとFable 5.1という最大級のモデルの予測の平均を使用。
結果として、Jevはほぼ2桁にわたってパレートフロンティアを独占。冒頭の193.6倍・444.6倍という数字はこの評価全体から導かれたもので、同社自身も実世界での効果としては高めの値と見込んでいます。
DOOMの自動プレイとWikiRaceで示すリアルタイム性
発表ブログで公開された実演の1つが、ゲーム「DOOM」の自動プレイ。ゲーム画面を直接見るのではなく、ゲーム内の状況をテキストで表現した構造化状態から、約100msごとに射撃・移動・回避を判断します。
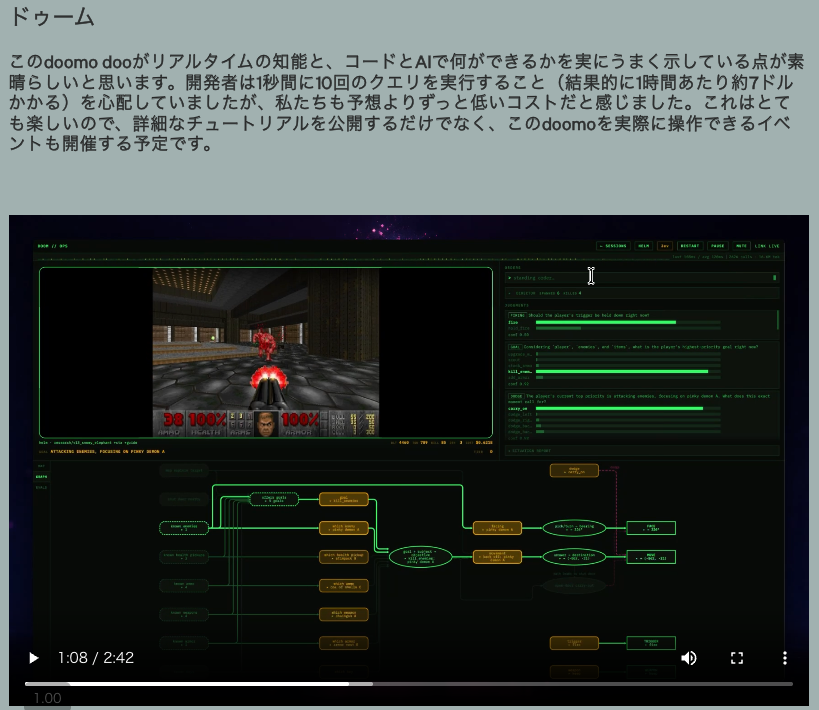
毎秒約10回の問い合わせを続けても、運用費は1時間あたり約7ドル。担当エンジニアはコストを心配していたそうですが、チームの結論は「想定より安い」だったといいます。
もう1つが、Wikipediaのリンクだけをたどって目的の記事に到達する競走「WikiRace」です。各ステップで数百から数千のリンクから1つを選ぶ必要があり、公開デモではJevが0.419秒で完走しました。
このデモの試行では、対戦したGPT-5.6 Terraがページに存在しないリンクを回答する幻覚を起こしてやり直しています。選択肢が多いほど幻覚しないことの恩恵が積み重なることを示す好例といえるでしょう。
AIエージェントサービスの比較について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Jevの安全性・制約
Jevの安全性は、出力の自由度を最初から制限するという設計思想そのものに根ざしています。一方で、できないことも明確です。
| 項目 | 内容 |
|---|---|
| 型安全性 | 事前定義した形式以外の値は返さない。スキーマ不一致は0% |
| ハルシネーション | 存在しない選択肢の回答は仕組み上発生しない |
| 確信度 | 全回答に確信度が付く(TypeSafe AIは校正済みと説明)。閾値で自動実行と人間のレビューを切り分け可能 |
| 周囲のコードによる制約 | 出力の形式が固定されるため、自由形式の出力による想定外の動作を抑えやすい |
| 生成できないもの | 自由形式の文章・コード生成には対応せず、チャットの代わりにはならない |
| 選択肢の上限 | 直接選択できる選択肢数は255まで。超える場合はスコアリング→選択の2段階 |
| 提供状況 | TypeSafe AI直接利用は早期アクセス(招待順)。Vercel AI Gateway経由でも利用可能 |
特に注目したいのが、確信度に閾値を設定できる点。高ければ自動実行、低ければ人間のレビューに回す、というルールをコードで記述できます。
LLMの出力を検証する用途にも使えます。プロンプト・推論トレース・出力のスコアリング、判定、ガードレール、ジェイルブレイクの検知といった「全てを検証する」役割を、100ms級の速度でこなせるのは大きな利点ではないでしょうか。
選択肢が255を超えるような判断では、独立にスコアリングしてから明示的に選ぶ2段階方式を採用。そのぶん処理が遅くなる場合があります。
生成AIのハルシネーションについて、詳しく知りたい方は下記の記事もあわせてご覧ください。
Jevの料金
Jevの料金は入力トークンのみの従量課金で、出力トークンは無料です。プラン制ではなく、価格は公開されています。
| 項目 | 料金 | 備考 |
|---|---|---|
| 入力トークン | 0.042ドル / 100万トークン(約6.5円) | 10億トークンあたり42ドル(約6,510円、1ドル155円換算) |
| 出力トークン | 無料 | 「安すぎて課金できない」ため |
| 参考:DOOM自動プレイ | 約7ドル / 時間(約1,085円) | 毎秒約10回の問い合わせを継続した場合 |
TypeSafe AIが比較対象としたフロンティアLLMの入力トークンが100万あたり0.20〜10ドル、出力が入力の約5倍であることを考えると、桁違いの価格差です。
Jevのライセンス
Jevは、API経由で提供されるモデルです。本記事執筆時点でモデルの重みの公開は確認できていません。
ライセンス情報は確認できませんでした。商用利用などを検討する場合は、TypeSafe AIの利用規約の確認や提供元への問い合わせが必要です。
AIエージェントの開発について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Jevの使い方
JevはTypeSafe AIからの直接利用が早期アクセス(ウェイトリスト制)で、2026年9月16日からはVercel AI Gateway経由でも利用できます。公開情報をもとに、基本的な始め方をステップ形式で解説します。
TypeSafe AIの公式サイトから「Join Waitlist」でウェイトリストに登録します。早期アクセスは招待順に開放されるため、招待が届くまで待つ必要があります。Vercel AI Gatewayを利用する場合は、Gateway経由でJevを指定して呼び出せます。
「解約リスクは高いか」「どの担当部署に回すべきか」など、自動化したい判断を質問として書き出します。それぞれに「はい/いいえ」「選択肢のどれか」「数値」といった回答形式と選択肢をあらかじめ設定。人が読んで分かるキー名を付けておくと出力が理解しやすくなります。
状況を説明するテキスト(プログラムの状態)と複数の質問を、1回の問い合わせでまとめて送ります。Jevは全ての質問に対する確率と確信度を並列に返します。
確信度が閾値以上なら自動実行、未満なら人間のレビューに回す、というルールをコードで記述します。複数の判断を組み合わせてワークフローを構成するのがJevの想定する使い方です。
信頼性の高い実世界のワークフローは、独立した多数の細かい質問に分解され、離散的な判断ではなく確率に依存した挙動を持つ傾向があるとTypeSafe AIは説明しています。最終的な分岐は離散的でも、そこに至るまでの設計はドメイン固有の工夫が必要です。
生成AIによる業務の自動化について、詳しく知りたい方は下記の記事もあわせてご覧ください。
【業界別】Jevの活用シーン
Jevが得意とするのは、分類・振り分け・スコアリング・抽出・分岐といった「賢いif文」。手書きのロジックでは脆すぎる判断を、通常のソフトウェアに組み込めます。ここでは業界別の活用シーンを紹介します。
金融・保険
金融・保険業界では、取引の不正判定や申請の審査など、大量かつ低遅延で判断を下す場面が多くあります。LLMの数秒の応答では、リアルタイムの処理に組み込みにくいのが実情です。
Jevなら100ms級の速度でリスクをスコアリングし、確信度が低い案件だけを人間の審査に回す運用が可能。確信度が校正されていると同社が説明するため、閾値の設計次第で自動化率と安全性のバランスを調整できると考えられます。
金融業界における生成AIの活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。
カスタマーサポート・コールセンター
問い合わせの分類や担当部署への振り分け、優先度の判定は、Jevが最も得意とする「classify・route」の典型です。
チャットボットのように文章で応答するのではなく、LLMが生成した回答の適切さを判定するガードレールとして組み合わせる使い方も期待できます。解約リスクの判定のように、顧客の状態から確率つきの判断を返す用途にも向いているのではないでしょうか。
コールセンターでの生成AI活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。

製造業
製造現場では、センサーやログから得られる状態をもとに異常の有無や次の処理を即座に判断する必要があります。レイテンシ保証が求められるシステムでは、ハルシネーションが生じるツール呼び出しは致命的です。
Jevは型エラーが仕組み上発生しないため、依存関係の奥深くに組み込んでも壊れにくい判断部品として活用できる可能性があります。
製造業における生成AIの活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。

EC・小売
ECサイトでは、レビューの分類、商品データの属性抽出、購買行動からの判定など、ペタバイト級のデータを特徴量や洞察に変える処理が求められます。
Jevは大規模データへのMap-Reduce処理を主要なユースケースに掲げており、出力トークンが無料である点も大量処理では大きな利点。UXが重視されるアプリケーションにAIを組み込む用途にも、100ms級の速度が活きるでしょう。
ECにおける生成AIの活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。
ゲーム
DOOMの自動プレイが示すように、Jevはゲーム内の状態から約100msごとに行動を判断できます。指示に従って異なる状態表現に反応するボットを、1時間約7ドルで動かせる計算です。
NPCの行動判断やリアルタイムのマッチング、不正プレイの検知など、速度が体験を左右する場面での活用が期待できます。TypeSafe AIは詳細な解説の公開や、このデモをハックするイベントの開催も予定しています。
ゲーム業界における生成AIの活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。

Jevを実際に使ってみた
公式のWaitinglistに登録して早期アクセスを待っていますが、まだ利用可能にならないので今回はVercel経由で利用していきます。
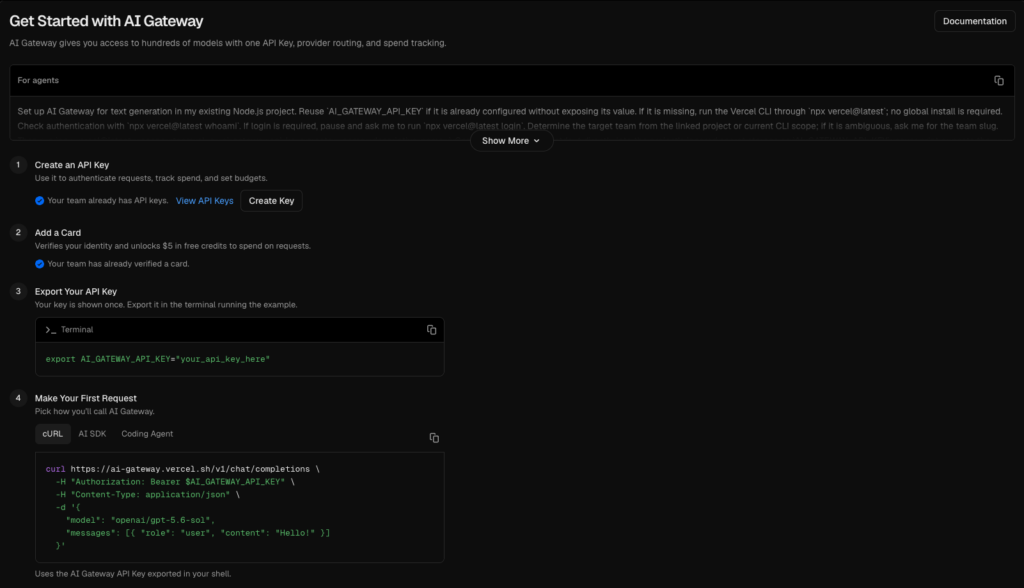
Vercel経由ではNode.jsを使うことになります。ローカル環境でファイルを作成し、.envにAPIキーを入力したら、下記を実行します。
下記のコードでは顧客からの問い合わせ文を渡し、「返金を求めているか」「担当部署はどこか」「緊急度はどれくらいか」の3つを1回で判断させます。
サンプルコードはこちら
// Vercel AI Gateway経由でJevに判断させる最小サンプル
import { experimental_evaluate as evaluate } from 'ai';

if (!process.env.AI_GATEWAY_API_KEY) {
  console.error('AI_GATEWAY_API_KEY が未設定です。.env に貼ってください。');
  process.exit(1);
}

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: '二重に課金されました。返金してください。',
  questions: {
    wantsRefund: {
      type: 'boolean',
      instructions: '返金を求めていますか?',
    },
    route: {
      type: 'choice',
      instructions: '担当部署を選んでください',
      criteria: {
        billing: '課金・返金の問題',
        technical: 'アプリの不具合',
        other: 'その他',
      },
    },
    urgency: {
      type: 'score',
      instructions: '緊急度を評価してください',
      criteria: ['low', 'medium', 'high'],
    },
  },
});

console.log('answers:', JSON.stringify(result.answers, null, 2));
console.log('confidence:', result.providerMetadata?.typesafe?.confidence);
console.log('usage:', result.usage);
結果はこちら
answers: {
  "wantsRefund": {
    "type": "boolean",
    "probability": 0.98
  },
  "route": {
    "type": "choice",
    "choice": "billing",
    "probabilities": {
      "billing": 1,
      "technical": 0,
      "other": 0
    }
  },
  "urgency": {
    "type": "score",
    "score": 1.41,
    "probabilities": {
      "0": 0.01,
      "1": 0.57,
      "2": 0.42
    }
  }
}
confidence: { route: 1, urgency: 0.36 }
usage: { inputTokens: 419, outputTokens: 72, totalTokens: 491 }返金要求は確率0.98、担当部署は確信度1で「billing」を選択。一方で緊急度はmediumとhighの間で割れており、確信度0.36と低めに出ています。
この「迷っている」ことが数値で分かるのがJevの特徴ではないでしょう。部署の振り分けは自動実行し、緊急度だけ人間が確認するといった閾値の設計がそのままコードに落とせます。文章を一切生成しないため、応答も一瞬でした。
次にLLMが書いた顧客への返信文をJevに検品させるというデモをやってみます。
サンプルコードはこちら
// デモ2:LLMが書いた返信文をJevが検品する(Verify everything)
// 返信文は固定の例文3本。ChatGPT等の鍵は不要。
import { experimental_evaluate as evaluate } from 'ai';

if (!process.env.AI_GATEWAY_API_KEY) {
  console.error('AI_GATEWAY_API_KEY が未設定です。.env に貼ってください。');
  process.exit(1);
}

const inquiry = '二重に課金されました。返金してください。あと、いつ返金されますか?';

const replies = {
  '良い返信':
    'お問い合わせありがとうございます。二重課金の件、ご不便をおかけし申し訳ございません。担当部署にて決済履歴を確認のうえ、3営業日以内に対応可否と返金時期をご連絡いたします。',
  '返金を勝手に約束した返信':
    'ご連絡ありがとうございます!二重課金は確認できましたので、本日中に全額返金しますね。返金は明日には口座に反映されます。',
  '質問に答えていない返信':
    'お問い合わせありがとうございます。当社サービスをご利用いただき誠にありがとうございます。今後ともよろしくお願いいたします。',
};

const questions = {
  promisesRefund: {
    type: 'boolean',
    instructions: '返信文は返金の実施や時期を確定的に約束していますか?(担当者の確認前に約束するのはNG)',
  },
  answersTiming: {
    type: 'boolean',
    instructions: '顧客の「いつ返金されるか」という質問に、返信文は何らかの形で答えていますか?',
  },
  politeness: {
    type: 'score',
    instructions: 'ビジネス上の敬語・丁寧さを評価してください',
    criteria: ['不適切', '許容範囲', '丁寧'],
  },
  verdict: {
    type: 'choice',
    instructions: 'この返信をそのまま顧客に送ってよいか判定してください',
    criteria: {
      send: 'そのまま送信してよい',
      review: '人間が確認してから送る',
      reject: '送ってはいけない',
    },
  },
} as const;

const started = performance.now();

for (const [label, reply] of Object.entries(replies)) {
  const t0 = performance.now();
  const r = await evaluate({
    model: 'typesafe-ai/jev',
    state: { customerInquiry: inquiry, draftReply: reply },
    questions,
  });
  const ms = Math.round(performance.now() - t0);
  const a = r.answers;
  const conf = r.providerMetadata?.typesafe?.confidence ?? {};
  console.log(`\n■ ${label}(${ms}ms)`);
  console.log(`  返金を約束している : ${a.promisesRefund.probability.toFixed(2)}`);
  console.log(`  時期の質問に答えた : ${a.answersTiming.probability.toFixed(2)}`);
  console.log(`  丁寧さ(0-2)        : ${a.politeness.score.toFixed(2)}  confidence=${conf.politeness ?? '-'}`);
  console.log(`  判定               : ${a.verdict.choice}  confidence=${conf.verdict ?? '-'}`);
  console.log(`  内訳               : ${JSON.stringify(a.verdict.probabilities)}`);
}

console.log(`\n合計 ${Math.round(performance.now() - started)}ms(3件)`);
結果はこちら
■ 良い返信(770ms)
  返金を約束している : 0.09
  時期の質問に答えた : 0.84
  丁寧さ(0-2)        : 1.98  confidence=0.98
  判定               : send  confidence=0.43
  内訳               : {"send":0.62,"review":0.35,"reject":0.03}

■ 返金を勝手に約束した返信(337ms)
  返金を約束している : 0.92
  時期の質問に答えた : 0.97
  丁寧さ(0-2)        : 1.55  confidence=0.33
  判定               : review  confidence=0.63
  内訳               : {"reject":0.15,"send":0.1,"review":0.75}

■ 質問に答えていない返信(335ms)
  返金を約束している : 0.02
  時期の質問に答えた : 0.02
  丁寧さ(0-2)        : 1.32  confidence=0
  判定               : reject  confidence=0.98
内訳 : {"send":0,"reject":0.99,"review":0.01}担当者の確認前に「本日中に全額返金します」と書いた返信は、返金の約束を0.92で検知して人間の確認にエスカレーションしています。定型文だけで質問に答えていない返信は確信度0.98でrejectと、迷いなく弾いています。
興味深いのは「良い返信」です。
判定はsendでも確信度は0.43にとどまり、reviewにも0.35の確率を残しています。「返金時期を3営業日以内に連絡する」という回答で十分かどうか、Jevも迷っているわけです。この迷いが数値で見えるため、「確信度0.6未満は人間が見る」といった閾値をコードに1行足すだけで、安全側に倒した運用が組めます。
【課題別】Jevが解決できること
Jevが解決できる代表的な課題を紹介します。LLMを業務システムに組み込む際に直面しがちな壁に、どのようにアプローチするかを見ていきましょう。
AIの判断をリアルタイム処理に組み込める
LLMの応答時間は人と対話するには十分でも、コードに組み込むと大きなボトルネックになります。数秒待てないシステムでは、AI活用そのものを諦めていた方も多いのではないでしょうか。
Jevは70〜500msで判断を返すため、UXが重視されるアプリケーションやリアルタイム処理にもAIを組み込めます。
出力の解析・検証工程をなくせる
LLMの文字列出力をソフトウェアで使うには、解析と検証が欠かせません。それでもAIが暴走するリスクは常に残ります。
Jevは可能な出力と構造を事前に定義し、型エラーを決して起こさない設計。周囲のコードが自由度を制約するため、信頼できるシステムに組み立てやすくなります。
自動化してよい判断と人が見るべき判断を切り分けられる
LLMに確信度を尋ねても、過信気味で一貫性に欠けるのが実情です。95%は正しくても残り5%がいつなのか分からなければ、自動化には踏み切れません。
Jevは全ての出力に確信度(TypeSafe AIは校正済みと説明)を添えるため、閾値で自動実行と人間のレビューを切り分けられます。似た入力には似た答えを返す一貫性も、運用の安定につながるといえるでしょう。
| 項目 | 解決できること | 解決できないこと・留意点 |
|---|---|---|
| 速度 | 100ms級の判断でリアルタイム処理に組み込める | 自由形式の文章やコードの生成はできない |
| 信頼性 | 型エラー・スキーマ不一致は0%。存在しない選択肢は返さない | 判断の中身が常に正しいわけではない |
| 自動化の判断 | 確信度で自動実行とレビューを切り分け | 閾値やワークフローの設計は開発者側の責任 |
| 導入 | 入力のみの従量課金で大量処理も低コスト | 早期アクセス段階で一般提供時期は未定 |
生成AIによる業務効率化について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Jevの活用事例
ここではJevの活用事例をXでリサーチして紹介していきます。どのように使っていこうか悩んでいる方は参考にしてください。
ドラッグ&ドロップした瞬間に仕分け先を提案する
こちらの投稿では、Jevを使ってファイルやアイテムをドラッグ&ドロップすると、自動で仕分け先を教えてくれるプロダクト体験を試作しています。
投稿者によると、最初の1回はやや遅いものの、その後はサクサク動くとのこと。ドロップという操作の直後に判断が返ってくる必要があるため、LLMの数秒の応答では成立しにくいUIです。100ms級で選択肢の中から1つを返すJevだからこそ組み込める、リアルタイム分類の事例といえるでしょう。
架空のペルソナ150人に導入意向を一括で聞く
こちらの投稿では、Jevを使って架空のペルソナ150人に製品の導入意向を尋ねる仕組みを構築しています。ペルソナ1人につき12個の質問をAPIで投げる構成です。
150人分の判断にかかった費用は1.8円、時間は約5秒。投稿者は「日本とアメリカ間のレイテンシが含まれているので本来はもっと速いはず」と補足しています。
続く投稿では実測値の内訳も公開されており、1回の応答252msのうち太平洋往復が150ms、推論そのものは約100ms。さらに質問数を1問から8問に増やしても応答時間はほぼ変わらなかったとのことです。
Jevなどの活用のご相談はWEELへ!
Jevを活用することで、LLMでは速度とコストの面で組み込めなかった判断処理を、リアルタイムかつ低コストで自動化できます。一方で、確信度の閾値やワークフローの分解は設計次第で効果が大きく変わるため、まずは小さな判断から試して自社の業務に合う使い方を検証することも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
Jevのよくある質問