【Muse Ember】Haiku 5.5並みを3分の1のコストで!性能・料金・使い方を解説
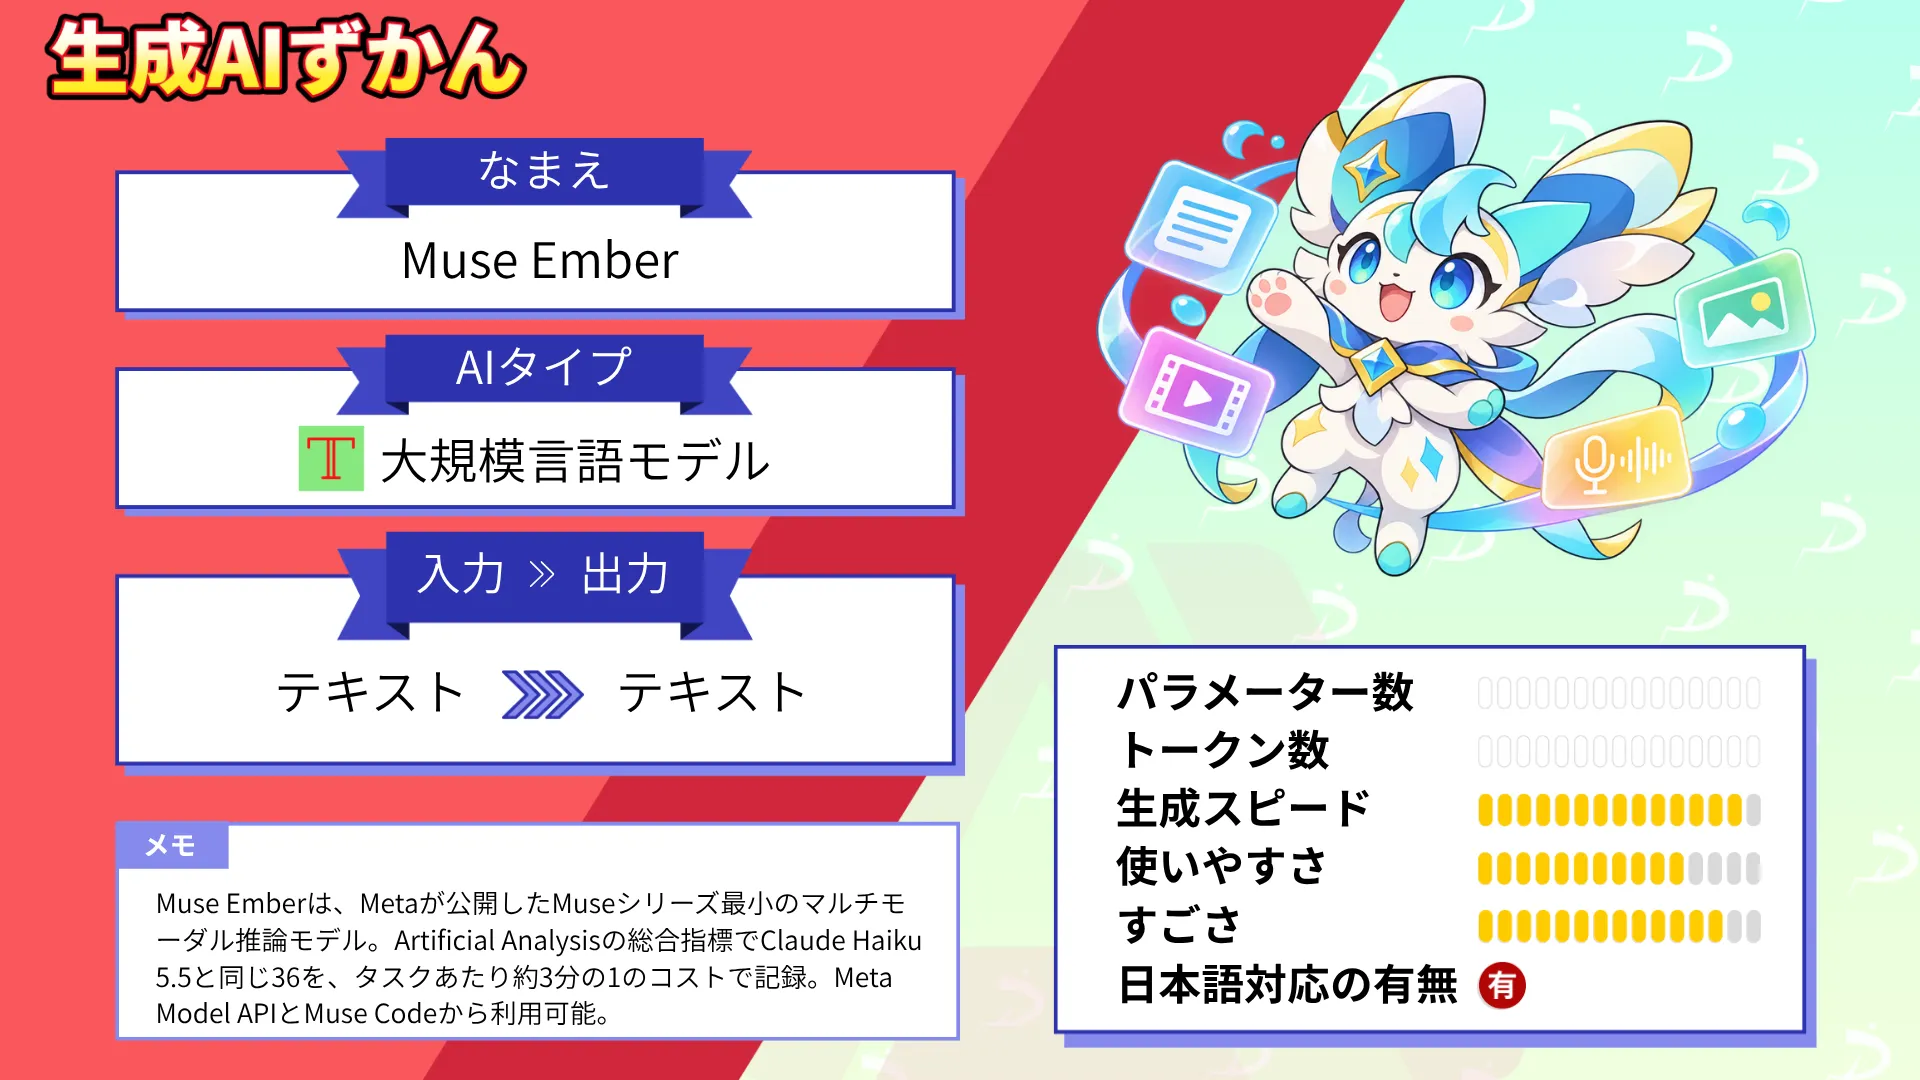
- Muse Emberは、Metaが2026年11月10日に公開したMuseシリーズ最小のマルチモーダル推論モデル
- Artificial Analysisの総合指標でClaude Haiku 5.5と同じ36を、タスクあたり約3分の1のコストで記録
- 料金は100万トークンあたり入力0.10ドル・出力0.50ドルで、Meta Model APIとMuse Codeから利用可能
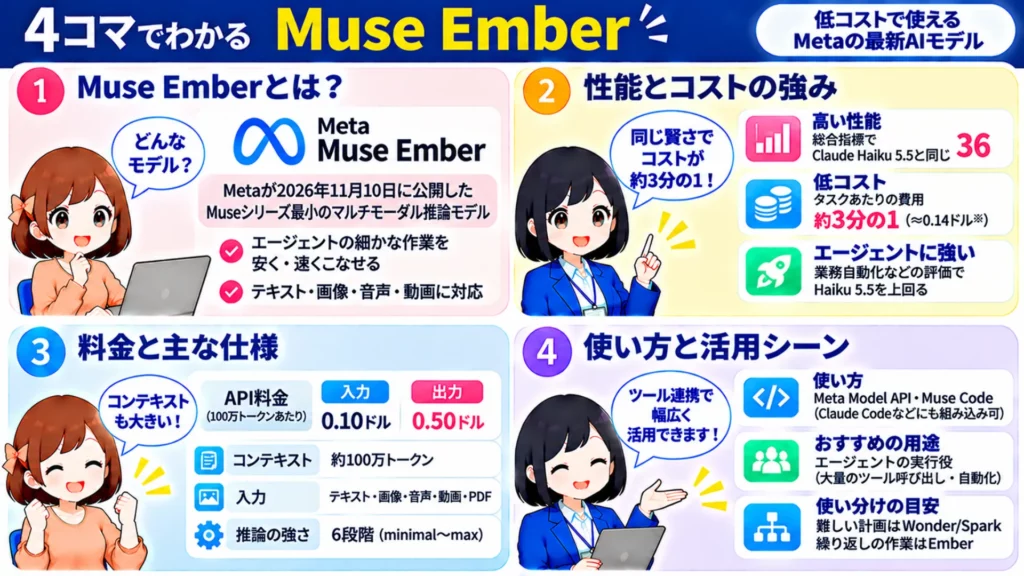
2026年11月10日、Metaが新しい小型の生成AIモデル「Muse Ember」を公開しました!Muse EmberはMuseシリーズでもっとも小さく効率的なモデルで、エージェントが一日中くり返すツール呼び出しやコーディングの細かな作業を、安く速くこなすために作られています。
さらに、Artificial Analysisの総合指標ではClaude Haiku 5.5の最高スコアと同じ36を記録し、タスクあたりのコストは約3分の1というから驚きです。
とはいえ「Haiku 5.5や上位のMuse Sparkとどう使い分ければいいの?」「料金に落とし穴はない?」と気になっている方も多いのではないでしょうか?
この記事では、Muse Emberの概要や仕組み、料金とライセンス、APIやMuse Codeでの使い方までを解説します。ぜひ最後までご覧ください!
\生成AIを活用して業務プロセスを自動化/
Muse Emberとは?
Muse Emberは、Metaが2026年11月10日に公開したMuseシリーズ最小のマルチモーダル推論モデルです。大きなモデルが立てた計画を受け取り、細かい作業を大量に並列でこなす「実行役」として設計されました。
モデルIDは「muse-ember-1.0」で、Meta Model APIとコーディングエージェントのMuse Codeから使えます。入力はテキスト・画像・音声・動画・PDFに対応し、出力はテキストのみ。コンテキストウィンドウは100万トークン、最大出力は512Kトークンと、小型モデルとしては大きな容量です。
Metaはモデルの役割を「Muse Wonderは最難関の問題、Muse Sparkはコーディングとエージェント、Muse Emberは大量の繰り返し作業」と整理しています。2026年11月時点では、Google CloudとOracle Cloudでも提供が始まった段階です。
| 項目 | 内容 |
|---|---|
| 開発元 | Meta |
| 公開日 | 2026年11月10日 |
| モデルID | muse-ember-1.0 |
| 入力 | テキスト・画像・音声・動画・PDF |
| 出力 | テキスト |
| コンテキストウィンドウ | 1,048,576トークン(約100万) |
| 最大出力 | 524,288トークン(512K) |
| 推論の強さ | minimal〜max(指定しない場合はmax) |
| 対応API | Responses API・Chat Completions API・Messages API |
| 提供先 | Meta Model API・Muse Code・Google Cloud・Oracle Cloud |
| 料金 | 100万トークンあたり入力0.10ドル・出力0.50ドル(20万トークン以下) |
上位モデルのMuse Spark 1.3について詳しく知りたい方は、以下の記事も参考にしてみてください。
Claude Haiku 5.5と同じスコアを約3分の1のコストで達成
Muse Emberの一番の売りは、賢さあたりのコストの低さです。Metaの発表ブログによると、Artificial Analysis Intelligence IndexではMuse EmberとClaude Haiku 5.5がどちらも36(小数点以下を四捨五入)で並びました。
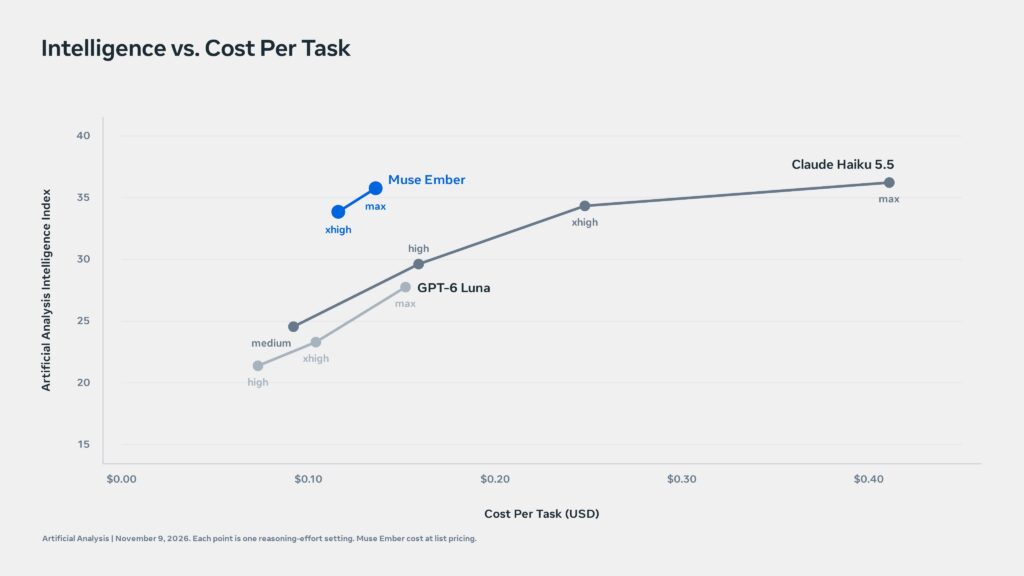
ところが、最大の推論設定で1タスクをこなすコストを比べると、Metaの試算でMuse Emberは約0.14ドル、Haiku 5.5は約0.41ドルと大きな開きがあります。Meta自身も「Haikuの最高スコアに約3分の1のコストで並び、GPT-6 Lunaのどの設定よりも上」とアピールしているほど。
同じMuseシリーズのMuse Spark 1.3(総合37)は1タスク約2.39ドルかかるため、Muse Emberはほぼ同じ賢さを約17分の1のコストで出せる計算。数千回単位で呼び出すエージェントなら、この差がそのまま請求額に響くでしょう。
エージェントの繰り返し作業で同クラスのモデルを上回る
エージェント系のベンチマークでは、Muse Emberが同クラスの2モデルを広く上回りました。業務フローを最初から最後まで自動化するAutomationBench-AAは37.8%で、Claude Haiku 5.5の13.9%を2倍以上引き離しています。
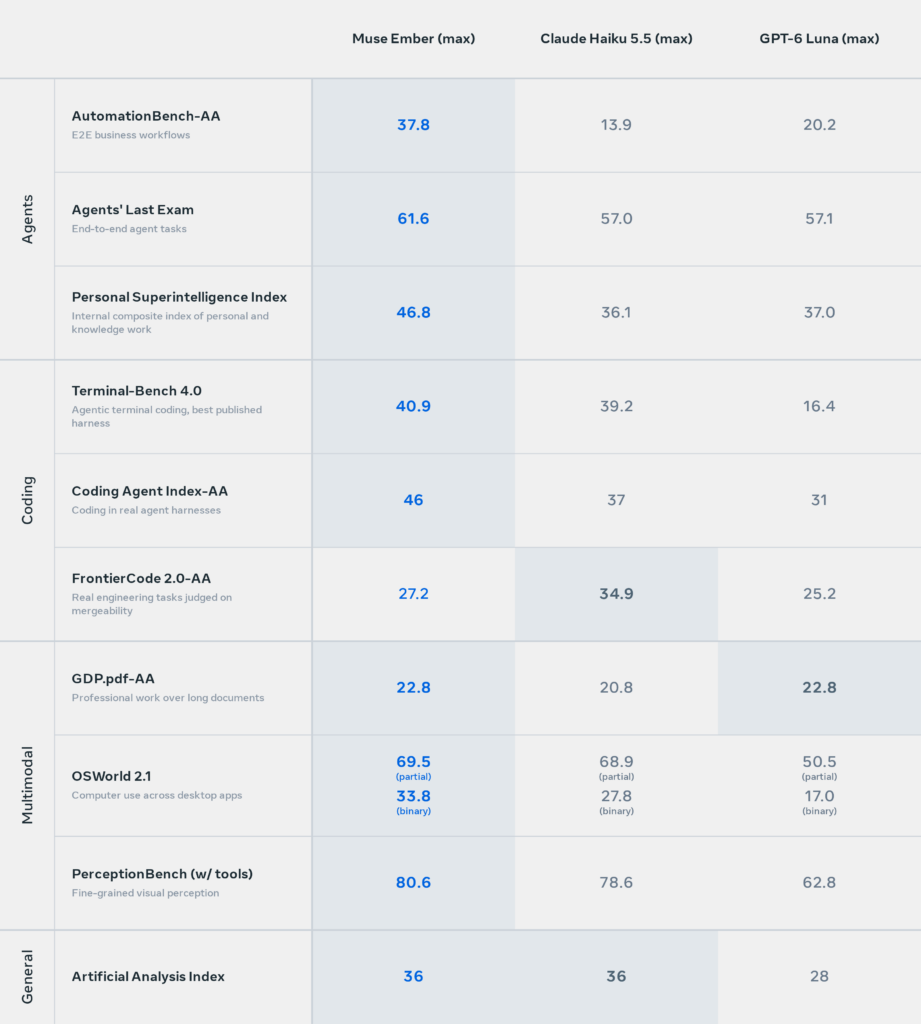
| ベンチマーク | 測る内容 | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|---|
| AutomationBench-AA | 業務フローの自動化 | 37.8 | 13.9 | 20.2 |
| Agents’ Last Exam | エージェントタスク全般 | 61.6 | 57.0 | 57.1 |
| Terminal-Bench 4.0 | ターミナル上のコーディング | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 実際のハーネスでのコーディング | 46 | 37 | 31 |
| OSWorld 2.1(部分点) | デスクトップアプリの操作 | 69.5 | 68.9 | 50.5 |
| PerceptionBench(ツールあり) | 細かな画像認識 | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Index | 総合 | 36 | 36 | 28 |
Terminal-Bench 4.0の40.9%も、軽量モデルとしては健闘している数字です。ツールを順番に呼び出し、テストを流し、狙った箇所だけ直すという「エージェントの手足」の動きに強いことがわかります。
テキスト・画像・音声・動画を1つのモデルで扱える
Muse Emberは、テキスト・画像・音声・動画をネイティブに理解できるマルチモーダルモデルです。スクリーンショットやグラフ、スキャンした書類はもちろん、ボイスメモや会議の録音からも情報を拾えます。
Metaの開発者ブログでは、バグ報告とスクリーンショットをあわせて読ませる・スキャン文書から項目を抜き出す・会議音声からアクションアイテムをまとめる、といった使い方が紹介されていました。
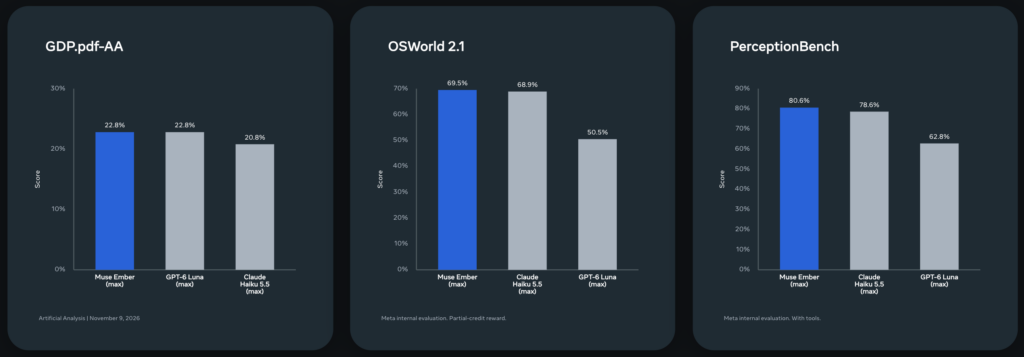
画面のスクショを見ながらPCを操作するOSWorld 2.1では69.5%(部分点)を記録し、Haiku 5.5の68.9%をわずかに上回っています。
これまでは「画像はこのモデル、音声は別のモデル」と分けて組んでいた処理も、Muse Ember1つにまとめられるでしょう。ただし、Metaのモデル選びのガイドでは音声理解の用途にMuse Spark 1.2を挙げているため、音声が中心の処理なら両者を比べてから選ぶと安心です。
苦手な分野もはっきりしている
一方で、すべての指標でトップというわけではありません。マージできる品質のコードを書けるかを測るFrontierCode 2.0-AAでは、Muse Emberが27.2%なのに対し、Haiku 5.5は34.9%と差をつけています。
長い文書を使った専門的な作業を測るGDP.pdf-AAも22.8%で、GPT-6 Lunaと同点でした。Meta自身も、一発で解く必要がある難しいコーディングや知識量が問われる質問、見た目を作り込むコーディングにはMuse SparkかMuse Wonderを使うよう案内しています。
あくまで「細かく区切った作業を大量にこなす係」と割り切って使うのが、Muse Emberを活かすコツと言えるでしょう。
Muse Emberの仕組み
Muse Emberは、大きなモデルと役割を分担する前提で作られた推論型の実行モデルです。パラメータ数やアーキテクチャの詳細は、2026年11月時点では公開されていません。
公開されている情報から読み取れる仕組みは、大きく3つあります。上位モデルを使った学習、推論の強さを切り替える仕組み、そして計画役と実行役の分業です。
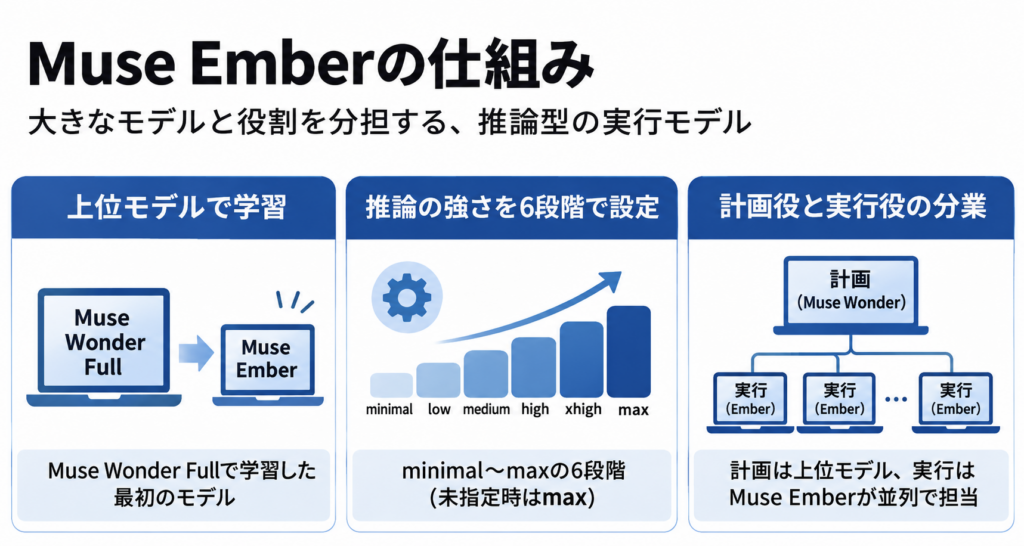
Muse Wonder Fullを使って学習した最初のモデル
Metaは、最上位のMuse Wonderと高性能版のMuse Wonder Fullを発表した際に「これらを使って、誰もが使える専門モデルを作る」と予告していました。Muse Emberは、その方針でMuse Wonder Fullを使って学習した最初のモデルです。
学習方法の細かな中身は明かされていません。ただ、上位モデルの力を借りて小さなモデルを鍛えたことで、総合指標でMuse Spark 1.3の37に迫る36を出せたと考えられます。
Metaは「さらに効率的なモデルを学習中」とも述べているので、今後も小型モデルが増えていくかもしれません。
推論の強さを6段階で切り替えられる
Muse Emberは、回答の前に内部で考える推論モデルです。考える深さは「reasoning_effort」で指定でき、minimal・low・medium・high・xhigh・maxの6段階から選べます。
指定しなかった場合は最大のmaxで動く点には注意が必要です。推論に使ったトークンは出力トークンとして課金されるため、深く考えるほど時間と料金がかさむ仕組み。
なお、推論をオフにする「none」は使えず、指定するとエラーが返ってきます。分類や書式の変換のような単純な作業なら、minimalやlowに下げて速さとコストを優先するとよいでしょう。
計画役と実行役を分ける前提の設計
Muse Emberがもっとも力を発揮するのは、Muse WonderやMuse Sparkが計画を立て、Muse Emberが手を動かす構成です。Metaの開発者ブログでは、この分業でPythonのシンタックスハイライター「Pygments」の字句解析器16種をRustへ移植した事例が紹介されています。
計画と監督はMuse Wonderが担当し、16体のMuse Emberがそれぞれ1言語ずつ並列で移植しました。結果は383件のテスト入力と実在のファイル62件すべてでPython版と一致し、Rust版は3.0〜7.3倍高速に。
かかった費用は約3.96ドルで、そのうちMuse Emberの分は1.84ドルにとどまったそうです。
Muse Emberの使い方
Muse Emberは、APIで呼び出す方法とMuse Codeで使う方法の2通りが基本です。Claude Codeのような既存のエージェントに組み込むこともできるので、環境に合った方法を選んでください。
Meta Model API(Python)で使う
自社のアプリやツールに組み込むなら、Meta Model APIが便利です。APIはOpenAI SDKとそのまま互換のため、ベースURLとモデルIDを変えるだけで呼び出せます。
APIキーを発行する
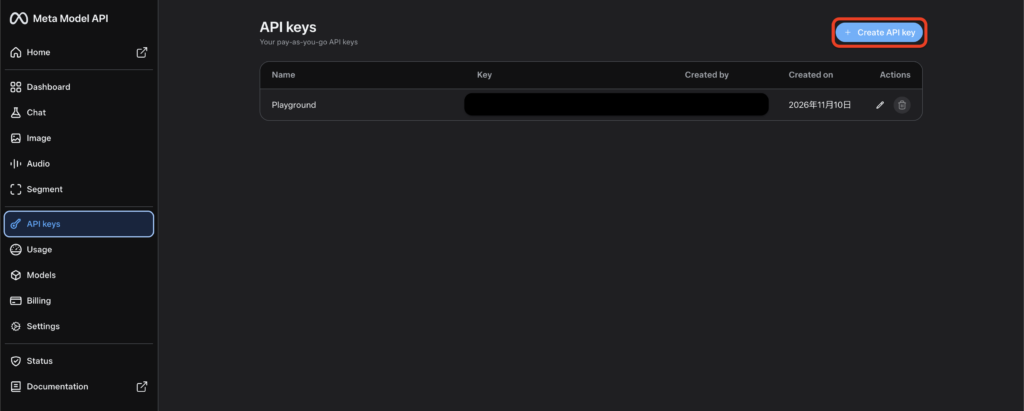
dev.meta.aiでMeta Model APIのアカウントを作成し、ダッシュボードの「API keys」から「Create API key」を選んでキーを発行します。
SDKを入れてキーを設定する
pip install openai
export MODEL_API_KEY="発行したAPIキー"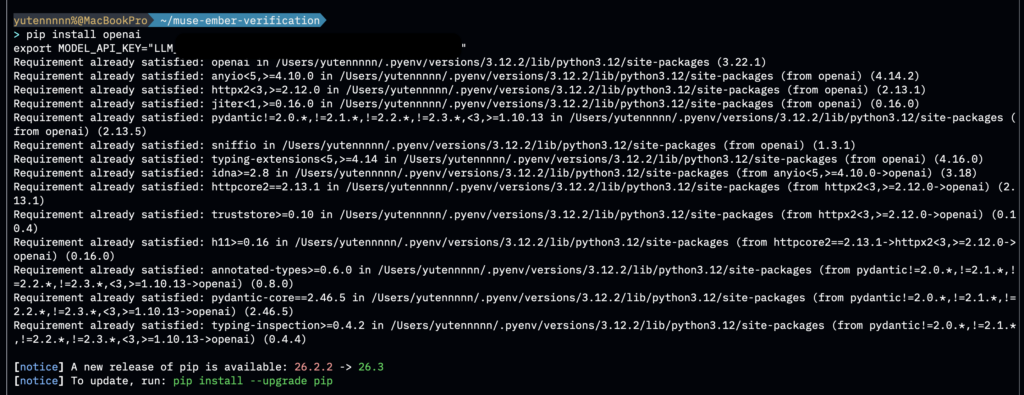
Muse Emberを呼び出す
import os
from openai import OpenAI

# OpenAI SDKはMODEL_API_KEYを自動で読まないため、明示的に渡す
client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.responses.create(
    model="muse-ember-1.0",
    reasoning={"effort": "low"},  # 省略するとmaxで動く
    input="次の問い合わせを「請求」「不具合」「要望」のどれかに分類し、理由を1文で答えてください:10月分の請求が2回引き落とされています。",
)

print(response.output_text)curlで試したい場合は、公式ドキュメントにある次のリクエストをそのまま使ってください。
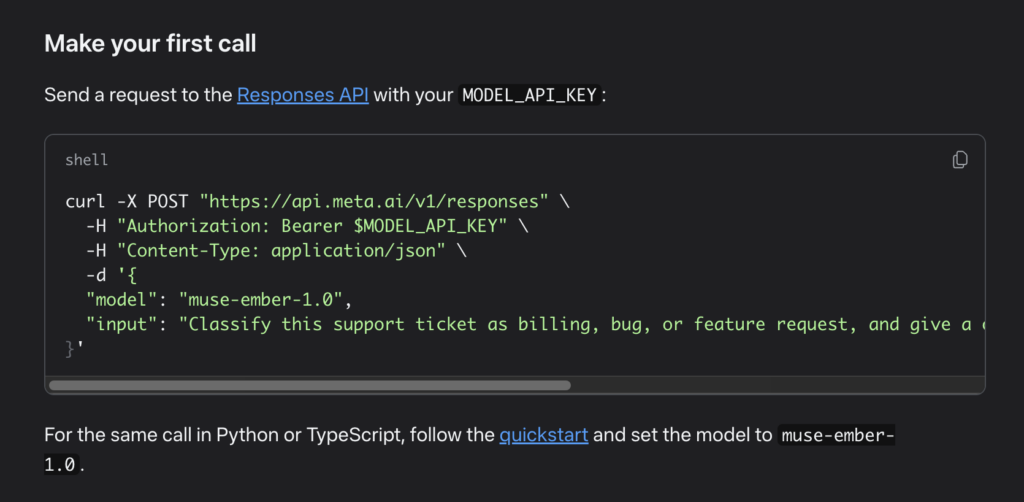
curl -X POST "https://api.meta.ai/v1/responses" \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-ember-1.0",
  "input": "Classify this support ticket as billing, bug, or feature request, and give a one-sentence reason: \"I was charged twice for my October invoice.\""
}'
Muse Codeで使う
ターミナルで動くMetaのコーディングエージェント「Muse Code」なら、APIキーの設定なしでMuse Emberを試せます。Muse Codeのすべてのサブスクリプションプランが、Muse Emberに対応済みです。
Muse Codeをインストールする
macOS・Linuxの場合は次のコマンドを実行します。
curl -fsSL https://dev.meta.ai/install.sh | shWindowsの場合はPowerShellで次を実行してください。
irm https://dev.meta.ai/install.ps1 | iexMuse Emberを指定して起動する
muse --model muse-ember-1.0 --reasoning-effort high初回はブラウザでのサインインかAPIキーの入力を求められます。なお、サブスクリプションでは入力内容を学習に使う「Contributor mode」が初期設定でオンです。業務のコードを扱うなら、起動時に「–contributor-mode off」を付けるか、セッション中に「/settings」から切り替えておきましょう。
Claude Codeのサブエージェントに割り当てる
すでにClaude Codeを使っている方は、環境変数を設定するだけで接続先をMeta Model APIに切り替えられます。公式ドキュメントでは、メインの作業をMuse Wonderに、サブエージェントと軽い処理をMuse Emberに任せる設定が紹介されていました。
export ANTHROPIC_BASE_URL="https://api.meta.ai"
export ANTHROPIC_AUTH_TOKEN="$MODEL_API_KEY"
export ANTHROPIC_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_OPUS_MODEL="muse-wonder-1.0"
export ANTHROPIC_DEFAULT_SONNET_MODEL="muse-spark-1.3"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="muse-ember-1.0"
export CLAUDE_CODE_SUBAGENT_MODEL="muse-ember-1.0"
export ENABLE_TOOL_SEARCH="true"
claude
ポイントは、認証に「ANTHROPIC_API_KEY」ではなく「ANTHROPIC_AUTH_TOKEN」を使うことです。また、すべてのモデル指定をMeta Model APIのモデルにしておかないと、裏側の処理がClaudeのモデルを呼ぼうとして失敗します。
Claude Codeのサブエージェントの仕組みについて詳しく知りたい方は、以下の記事も参考にしてみてください。
【実践】Muse Emberを実際に使って検証してみた!
ここからは、Muse Emberが得意とする「書類の読み取り」「大量の振り分け」「コーディングの小さな作業」の3つを実際に試していきます。どれもMeta Model APIをPythonから呼び出す形で実行し、料金と推論の強さによる違いもあわせて確かめました。
スキャンした請求書から項目を抜き出し、金額の食い違いを見つけられるか
1つ目は、経理の現場でよくある請求書の読み取りです。架空の会社の請求書をスキャン風に作り、明細4行と税率を読み取ったうえで合計を自分で計算し直せるかを試します。
この請求書は、冒頭の「ご請求金額」を57,420円、明細の「合計」を57,900円とわざと食い違わせました。正しい合計は、8%対象31,000円と税2,480円、10%対象22,200円と税2,220円を足した57,900円です。
推論の強さはlowとmaxの2通りで実行し、所要時間とトークン数も記録しました。
コードはこちら
"""
検証1:スキャン風の請求書画像から項目をJSONで抜き出す(Muse Ember)
"""
import base64
import json
import os
import sys
import time

from openai import OpenAI

client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])

SCHEMA = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": ["string", "null"]},
        "issue_date": {"type": ["string", "null"], "description": "YYYY-MM-DD"},
        "due_date": {"type": ["string", "null"], "description": "YYYY-MM-DD"},
        "issuer": {"type": ["string", "null"]},
        "registration_number": {"type": ["string", "null"]},
        "line_items": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "name": {"type": "string"},
                    "quantity": {"type": "number"},
                    "unit_price": {"type": "number"},
                    "amount": {"type": "number"},
                    "tax_rate": {"type": "number", "description": "8 or 10"},
                },
                "required": ["name", "quantity", "unit_price", "amount", "tax_rate"],
            },
        },
        "total_on_header": {"type": ["number", "null"]},
        "total_recalculated": {"type": "number"},
        "issues": {"type": "array", "items": {"type": "string"}},
    },
    "required": ["invoice_number", "issue_date", "due_date", "issuer", "registration_number",
                 "line_items", "total_on_header", "total_recalculated", "issues"],
}

PROMPT = (
    "この請求書画像から項目を抜き出してください。"
    "明細ごとに税率(※印は8%、それ以外は10%)を判定し、税込の合計を自分で再計算して"
    "total_recalculated に入れてください。冒頭の請求金額と食い違いがあれば issues に日本語で書いてください。"
    "読み取れない値は null にしてください。"
)

path = sys.argv[1] if len(sys.argv) > 1 else "invoice_sample.jpg"
b64 = base64.b64encode(open(path, "rb").read()).decode()

for effort in ["low", "max"]:
    t0 = time.time()
    res = client.chat.completions.create(
        model="muse-ember-1.0",
        reasoning_effort=effort,
        messages=[{"role": "user", "content": [
            {"type": "text", "text": PROMPT},
            {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{b64}"}},
        ]}],
        response_format={"type": "json_schema", "json_schema": {"name": "Invoice", "schema": SCHEMA}},
    )
    sec = time.time() - t0
    u = res.usage
    cost = u.prompt_tokens / 1e6 * 0.10 + u.completion_tokens / 1e6 * 0.50
    print(f"\n===== reasoning_effort={effort}  {sec:.1f}秒  入力{u.prompt_tokens}・出力{u.completion_tokens}トークン  約${cost:.5f} =====")
    print(json.dumps(json.loads(res.choices[0].message.content), ensure_ascii=False, indent=2))
生成結果はこちら
lowとmaxのどちらも、明細4行と税率、合計57,900円を正しく読み取り、冒頭の金額との差額480円まで指摘できました。maxは出力トークンが約2倍でも結果は同じで、この程度の書類ならlowで十分でしょう。
問い合わせ60件を並列で振り分けたときの精度とコスト
2つ目は、Muse Emberの本領である大量の振り分けです。正解ラベル付きの問い合わせ60件を「請求」「不具合」「機能要望」「アカウント」「解約」の5つに分ける作業を、16並列で一気に処理させました。
60件には「解約したいが日割り返金はあるか」のように、請求と解約のどちらにも読めるものも含めた構成。推論の強さを最小のminimalと初期設定のmaxで切り替え、正解率・時間・料金の差を見ていきます。
プロンプトはこちら
"""
検証2:問い合わせ60件を並列で一括振り分け(Muse Ember)
"""
import csv
import json
import os
import sys
import time
from concurrent.futures import ThreadPoolExecutor

from openai import OpenAI

client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
LABELS = ["billing", "bug", "feature", "account", "cancel"]
SYSTEM = (
    "あなたはSaaSのサポート窓口の振り分け担当です。問い合わせを次のどれか1つに分類してください。"
    "billing=請求・支払い・プラン変更・領収書、bug=不具合・エラー、feature=機能要望、"
    "account=ログイン・認証・アカウント管理、cancel=解約・利用停止。"
    "解約したい意図が主なら、請求の話を含んでいても cancel にしてください。"
)
SCHEMA = {
    "type": "object",
    "properties": {"label": {"type": "string", "enum": LABELS}, "reason": {"type": "string"}},
    "required": ["label", "reason"],
}

rows = list(csv.DictReader(open(os.path.join(os.path.dirname(__file__), "tickets.csv"), encoding="utf-8")))


def classify(row, effort):
    res = client.chat.completions.create(
        model="muse-ember-1.0",
        reasoning_effort=effort,
        messages=[{"role": "system", "content": SYSTEM}, {"role": "user", "content": row["text"]}],
        response_format={"type": "json_schema", "json_schema": {"name": "Route", "schema": SCHEMA}},
    )
    out = json.loads(res.choices[0].message.content)
    return row, out, res.usage


for effort in (sys.argv[1:] or ["minimal", "max"]):
    t0 = time.time()
    with ThreadPoolExecutor(max_workers=16) as ex:
        results = list(ex.map(lambda r: classify(r, effort), rows))
    sec = time.time() - t0
    ok = sum(1 for r, o, _ in results if o["label"] == r["label"])
    tin = sum(u.prompt_tokens for _, _, u in results)
    tout = sum(u.completion_tokens for _, _, u in results)
    cost = tin / 1e6 * 0.10 + tout / 1e6 * 0.50
    print(f"\n===== reasoning_effort={effort} =====")
    print(f"正解 {ok}/{len(rows)}({ok / len(rows):.0%})  所要 {sec:.1f}秒  入力{tin}・出力{tout}トークン  約${cost:.4f}")
    print(f"1万件に換算すると 約${cost / len(rows) * 10000:.2f}")
    for r, o, _ in results:
        if o["label"] != r["label"]:
            print(f"  × id={r['id']} 正解={r['label']} 予測={o['label']}  {r['text'][:30]}…  理由: {o['reason'][:60]}")
生成結果はこちら
minimalとmaxはどちらも60件中58件を正解し、外したのも判断が分かれやすい同じ2件でした。maxは時間が約1.7倍、料金が約4倍なのに精度は同じで、単純な振り分けならminimalで十分でしょう。
Muse Ember単体にバグ修正を任せてみた
3つ目は、コーディングエージェントとしての実力です。請求書の税計算をする小さなPythonパッケージにバグを5つ仕込み、テスト11件中7件が失敗する状態から、Muse Emberだけで直せるかを試しました。
仕込んだバグは、税率の取り違え・端数の切り上げ・合計の計算ミス・マイナス金額の表記・令和の年数換算の5つです。Muse Emberには「ファイル一覧」「ファイルを読む」「ファイルを書く」「テストを実行」の4つのツールを渡し、Responses APIのツール呼び出しで自由に使わせます。
プロンプトはこちら
"""検証3:API経由でMuse Emberにバグ修正を任せる(ツール呼び出しのエージェント)

Muse Emberに「ファイル一覧」「ファイルを読む」「ファイルを書く」「テストを実行」の4つのツールを渡し、
テストがすべて通るまで自分で調べて直させる。
元のリポジトリ(invoice-calc/)は書き換えず、work/ にコピーしたフォルダで作業します。
"""
import difflib
import hashlib
import json
import os
import shutil
import subprocess
import sys
import time
from pathlib import Path

from openai import OpenAI

client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])
MODEL = "muse-ember-1.0"
EFFORT = sys.argv[1] if len(sys.argv) > 1 else "high"
MAX_TURNS = 30  # 無限ループを防ぐ上限

HERE = Path(__file__).resolve().parent
SRC = HERE / "invoice-calc"
WORK = HERE / "work" / f"run-{time.strftime('%Y%m%d-%H%M%S')}-{EFFORT}"
shutil.copytree(SRC, WORK, ignore=shutil.ignore_patterns("__pycache__", ".pytest_cache"))
EDITABLE = {"invoice_calc/core.py"}  # 書き換えを許すファイル


def tests_hash():
    return hashlib.sha256(b"".join(p.read_bytes() for p in sorted((WORK / "tests").glob("*.py")))).hexdigest()


TESTS_BEFORE = tests_hash()


def resolve(path):
    p = (WORK / path).resolve()
    if WORK.resolve() not in p.parents:
        raise ValueError("作業フォルダの外は扱えません")
    return p


# ---- Muse Emberに渡すツールの中身 ----
def list_files():
    return "\n".join(str(p.relative_to(WORK)) for p in sorted(WORK.rglob("*"))
                     if p.is_file() and "__pycache__" not in p.parts)


def read_file(path):
    return resolve(path).read_text(encoding="utf-8")


def write_file(path, content):
    if path not in EDITABLE:
        return f"拒否:書き換えてよいのは {', '.join(sorted(EDITABLE))} だけです"
    resolve(path).write_text(content, encoding="utf-8")
    return f"{path} を保存しました({len(content)}文字)"


def run_tests():
    r = subprocess.run([sys.executable, "-m", "pytest", "-q", "-p", "no:cacheprovider"], cwd=WORK,
                       capture_output=True, text=True, timeout=120,
                       env={**os.environ, "PYTHONDONTWRITEBYTECODE": "1"})
    return (r.stdout + r.stderr)[-4000:]


FUNCS = {"list_files": list_files, "read_file": read_file, "write_file": write_file, "run_tests": run_tests}
TOOLS = [
    {"type": "function", "name": "list_files", "description": "リポジトリ内のファイル一覧を返す",
     "parameters": {"type": "object", "properties": {}}},
    {"type": "function", "name": "read_file", "description": "ファイルの中身を返す",
     "parameters": {"type": "object", "properties": {"path": {"type": "string", "description": "リポジトリからの相対パス"}},
                    "required": ["path"]}},
    {"type": "function", "name": "write_file", "description": "ファイルを指定した内容で丸ごと上書きする",
     "parameters": {"type": "object", "properties": {"path": {"type": "string"}, "content": {"type": "string", "description": "ファイル全体の新しい内容"}},
                    "required": ["path", "content"]}},
    {"type": "function", "name": "run_tests", "description": "pytest を実行して結果の末尾を返す",
     "parameters": {"type": "object", "properties": {}}},
]

TASK = (
    "このリポジトリの pytest が失敗しています。原因を調べて invoice_calc/core.py だけを直し、"
    "run_tests がすべて通るまで繰り返してください。tests/ は変更しないでください。"
    "最後に、直したバグを1行ずつ日本語で一覧にしてください。"
)

# ---- エージェントのループ ----
stats = {"requests": 0, "input": 0, "cached": 0, "output": 0, "reasoning": 0, "cost": 0.0, "tool_calls": 0}


def record(resp):
    u = resp.usage
    cached = getattr(getattr(u, "input_tokens_details", None), "cached_tokens", 0) or 0
    reasoning = getattr(getattr(u, "output_tokens_details", None), "reasoning_tokens", 0) or 0
    long_ctx = u.input_tokens > 200_000  # 20万トークン超はリクエスト全体が割増単価
    price_in, price_cached, price_out = (0.30, 0.012, 1.50) if long_ctx else (0.10, 0.004, 0.50)
    stats["requests"] += 1
    stats["input"] += u.input_tokens
    stats["cached"] += cached
    stats["output"] += u.output_tokens
    stats["reasoning"] += reasoning
    stats["cost"] += ((u.input_tokens - cached) * price_in + cached * price_cached + u.output_tokens * price_out) / 1e6


print(f"作業フォルダ: {WORK}\nreasoning_effort={EFFORT}\n")
t0 = time.time()
resp = client.responses.create(model=MODEL, reasoning={"effort": EFFORT}, input=TASK, tools=TOOLS)
record(resp)

for turn in range(1, MAX_TURNS + 1):
    calls = [item for item in resp.output if item.type == "function_call"]
    if not calls:
        break
    outputs = []
    for c in calls:
        args = json.loads(c.arguments or "{}")
        shown = {k: (f"<{len(v)}文字>" if k == "content" else v) for k, v in args.items()}
        print(f"[{turn:02d}] {c.name}({shown})")
        try:
            result = FUNCS[c.name](**args)
        except Exception as e:  # ツールの失敗もそのままモデルに返す
            result = f"エラー: {e}"
        if result.startswith(("拒否", "エラー")):
            print(f"      → {result}")
        stats["tool_calls"] += 1
        outputs.append({"type": "function_call_output", "call_id": c.call_id, "output": result})
    resp = client.responses.create(model=MODEL, reasoning={"effort": EFFORT}, input=outputs,
                                   previous_response_id=resp.id, tools=TOOLS)
    record(resp)
else:
    print(f"\n※ {MAX_TURNS}ターンの上限に達したため打ち切りました")

elapsed = time.time() - t0

# ---- 結果の確認(モデルの申告ではなく、こちらでテストを流し直す) ----
print("\n===== Muse Emberの最終回答 =====")
print(resp.output_text)
print("\n===== こちらで再実行したテスト結果 =====")
print(run_tests().strip().splitlines()[-1])
print("tests/ の変更:", "なし" if tests_hash() == TESTS_BEFORE else "あり(ルール違反)")

diff = "".join(difflib.unified_diff(
    (SRC / "invoice_calc/core.py").read_text(encoding="utf-8").splitlines(True),
    (WORK / "invoice_calc/core.py").read_text(encoding="utf-8").splitlines(True),
    "before/core.py", "after/core.py"))
(WORK / "fix.diff").write_text(diff, encoding="utf-8")
print(f"差分: {WORK / 'fix.diff'}")

print("\n===== 実行の記録 =====")
print(f"所要時間 {elapsed:.1f}秒  リクエスト{stats['requests']}回  ツール呼び出し{stats['tool_calls']}回")
print(f"入力{stats['input']}(うちキャッシュ{stats['cached']})・出力{stats['output']}(うち推論{stats['reasoning']})トークン")
print(f"概算料金 約${stats['cost']:.4f}")
生成結果はこちら
Muse Emberは仕込んだ5つのバグをすべて見つけ、1回の書き換えでテスト11件を通しました。関連ファイルをまとめて読んでから直す無駄のない進め方で、約55秒・約0.002ドルで終わる手軽さにも驚かされます。
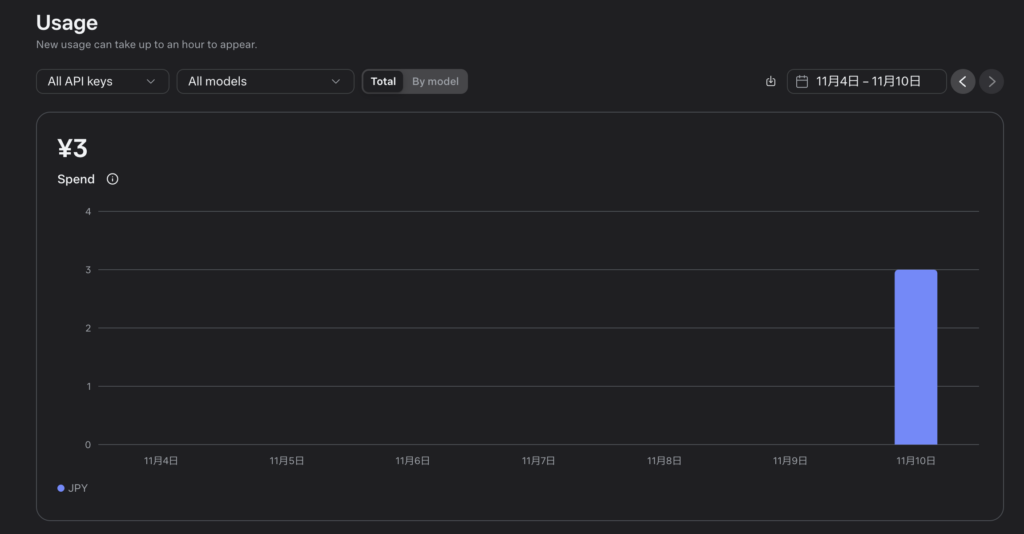
なお、ここまでの3つの検証にかかったAPI利用料は3円でした。
Muse Emberの料金とライセンス
Muse Emberの料金は、100万トークンあたり入力0.10ドル・出力0.50ドルです。上位のMuse Spark 1.3の入力1.25ドル・出力4.25ドルと比べると、トークン単価だけでも10分の1前後に収まります。
ただし、Muse Spark・Muse Wonderにはない長いプロンプト向けの割増料金がある点には注意しましょう。ライセンス面では、オープンウェイトではなくAPI経由で使うクローズドなモデルという位置づけです。
料金
料金ページによると、Meta Model APIは使った分だけ支払う従量課金で、1リクエストの入力トークン数によって料金の段階が変わります。入力が20万トークンを超えると、超えた分だけでなくリクエスト全体が割増料金で計算される仕組みです。
| 利用用途 | 20万トークン以下(100万トークンあたり) | 20万トークン超(100万トークンあたり) |
|---|---|---|
| 入力 | 0.10ドル | 0.30ドル |
| キャッシュ入力 | 0.004ドル | 0.012ドル |
| 出力 | 0.50ドル | 1.50ドル |
この判定にはキャッシュされたトークンも含まれます。previous_response_idで会話を続ける場合は過去のやり取りも入力に数えられるので、長い会話を続けるエージェントでは気づかないうちに20万トークンを超えるかもしれません。
Web検索のツールを使うと、トークン料金とは別に1,000回あたり2.50ドルがかかります。レート制限はチーム単位で、1分あたり3,000リクエスト・400万トークンです。
Muse Codeで使う場合は、次の月額プランも選べます。
| プラン | 月額料金 | 主な内容 |
|---|---|---|
| Everyday Usage | 5ドル | 5時間ごとに10〜50回のプロンプト、画像・動画のアップロード、音声モード、Web検索 |
| High Usage | 15ドル | Everyday Usageの5倍の利用量 |
| Power Usage | 50ドル | Everyday Usageの20倍の利用量、Muse Wonder Fullを利用可能 |
| Maximum Usage | 200ドル | Everyday Usageの80倍の利用量 |
ライセンス
Muse Emberは重みが公開されたオープンモデルではなく、Meta Model API利用規約のもとで使うAPIサービスです。Meta Model API利用規約は2026年10月2日に更新されたもので、限定的なプレビュー期間中に適用される内容とのこと。
| 利用用途 | 可否 | 備考 |
|---|---|---|
| 商用利用 | ⭕️ | 規約上、商用利用を想定したサービス |
| 改変 | ❌️ | 重みは非公開で、リバースエンジニアリングも禁止 |
| 配布 | ❌️ | APIの再販やプロキシ経由での提供は禁止(自社サービスへの組み込みは可) |
| 特許使用 | – | |
| 私的使用 | ⭕️ |
入力と出力の権利は利用者が持ち、Metaは所有権を主張しないと明記されています。また、通常のStandard modeで送った内容は、Metaのモデルの学習には使われません。
一方で、出力を使ってMetaと競合するモデルを学習・蒸留することは禁止です。Muse Codeのサブスクリプションは初期設定が学習に使われるContributor modeのため、機密性の高いコードを扱う前に設定を確認しておくと安心でしょう。
料金とライセンスを合わせて見ると、Muse Emberは「大量の呼び出しを安く回したい企業向け」にかなり使いやすい条件がそろっています。注意したいのは、長いプロンプトでの割増料金と、Muse CodeのContributor modeの2点です。会話履歴を毎回送り直すエージェントは入力トークン数を監視し、業務データを扱う場合は学習に使われない設定かどうかを導入前に確認してください。
【業界別】Muse Emberの活用シーン
Muse Emberは、1回あたりの判断は小さくても回数が多い業務でこそ活躍するモデルです。ここからは業界ごとに、どのような使い方が向いているかを紹介します。ほかのモデルと組み合わせる前提で、置き換えやすい作業から見ていきましょう。
SaaS・カスタマーサポート
問い合わせを内容ごとに担当部署へ振り分ける作業は、Muse Emberにぴったりの仕事です。公式ドキュメントでも、Muse Emberの用途の1つとして分類とルーティングが挙げられています。
構造化出力を使えば、ラベルを決められた選択肢の中から必ず1つ返させることも可能。1分あたり3,000リクエストまで送れるため、夜間にたまった問い合わせをまとめて仕分けるような使い方にも向いています。
難しい問い合わせだけをMuse Sparkへ回す二段構えにすれば、精度を保ちながら全体のコストを抑えられるでしょう。
生成AIを搭載したSaaSについて、詳しく知りたい方は以下の記事も参考にしてみてください。

経理・バックオフィス
請求書や領収書、注文書の読み取りも得意分野です。PDFや画像をそのまま渡せるため、OCRと項目抽出を1回のリクエストで済ませられます。
開発者ブログでは、請求書番号・発行日・合計を抜き出し、項目ごとに「記載あり」「記載なし」「読み取れない」の状態もあわせて返させるプロンプト例が紹介されていました。月末に数千枚の書類を処理するような部署なら、1枚あたりのコストの低さがそのまま効いてきます。
経理業務での生成AI活用に興味がある方は下記も参考にしてください。
法務・人事
契約書や応募書類のチェックのように、決まった基準に沿って1件ずつ判定する業務とも相性がよいでしょう。Boxの担当者は、契約書を交渉方針と条項ごとに照らし合わせてリスクを判定できたと評価しています。
同じコメントでは、詳細な募集要件に沿って候補者を選別し、ボーダーラインでも条件を満たす方を補欠として拾えたことにも触れていました。100万トークンのコンテキストがあるので、長い契約書や社内規程をまとめて読み込ませられる点も心強いところです。
生成AIを活用した法務業務について、詳しく知りたい方は以下の記事も参考にしてみてください。
小売・EC
大量の商品画像に説明文を付けたり、カテゴリごとに分類したりする作業にも使えます。Metaは、1万枚の写真にキャプションを付けて名前を変え、アルバムに仕分ける事例を公開しました。
この事例では、計画役のMuse Wonderが仕分けのルールを決め、16体のMuse Emberが写真を分担して処理しています。商品登録のたびに画像の説明文やタグを手で付けているなら、真っ先に置き換えを検討したい作業です。
小売業における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
Xで話題の内容
Muse Emberの公開直後から、X上では開発者による独自の検証や、料金の細かな注意点に関する投稿が相次ぎました。ここからはリリース直後に注目を集めた話題を紹介します。導入前の判断材料として参考にしてください。
正体は話題のステルスモデル「Crouton Alpha」だった
公開に合わせて、OpenRouterのモデル紹介アカウントが「Crouton Alphaは、Muse Emberの初期版だった」と明かしました。この投稿は約450件のいいねを集めています。
Crouton Alphaは、開発元を伏せて試験提供されていたモデルです。日本のユーザーからも「command codeにあったCrouton Alphaがmuse emberだったのか」という声が上がっていました。
OpenRouterによると、多くの開発者のフィードバックが正式版に反映されたとのこと。正体を知らずに使っていた方も多かったのかもしれません。
日本の開発者による独自ベンチマークでは「満点だがトークンは約3倍」
日本の開発者がts-benchという独自の評価でMuse Emberを試した結果も話題になりました。Muse Spark 1.3と同じく満点を取った一方で、トークン使用量は3倍ほど多く、タスク完了までの時間も長かったそうです。
投稿者は「安いけれど、それ以外はMuse Spark 1.3に劣っている」とまとめていました。投稿では推論の設定に触れていませんが、Muse Emberは推論の強さを指定しないとmaxで動くため、使い方によってはトークンが膨らむ点は覚えておきたいところです。
単価だけでなく、実際のタスクでどれだけトークンを使うかまで確かめてから乗り換えるのが安全でしょう。
「20万トークン超えはリクエスト全体が3倍」という料金の注意喚起
海外では、料金ページを読み込んだユーザーによる注意喚起が120件以上のいいねを集めました。入力が20万トークンを超えると、超えた部分だけでなくリクエスト全体が3倍の単価になる点を指摘したものです。
キャッシュされたトークンや、続きの会話として送った履歴もこの判定に含まれます。投稿者は「毎ターン履歴を丸ごと送り直すエージェントは、誰も気づかないうちにこの線を越える」と警告していました。
長時間動かすエージェントにMuse Emberを使う場合は、履歴の要約や切り詰めを組み込んでおくと安心です。
軽量モデルで3Dシーンを一発生成
コーディングツール「Command Code」のデザイン機能でMuse Emberを試した投稿も注目されました。投稿者はCommand Codeでデザインと開発に携わっている方で、軽量モデルなのに3Dシーンを一発で仕上げたと驚きをつづっています。
比較したGPT-6 Lunaでは、プロンプトが2回必要だったそうです。公式には見た目を作り込むコーディングは上位モデル向けとされていますが、簡単なものなら十分にこなせるという声と言えるでしょう。小さなUIの試作やデモ用の画面づくりなら、まずMuse Emberで試してみる価値はありそうです。
Muse EmberをはじめとしたAIモデルのご相談はWEELへ!
Muse Emberは、Claude Haiku 5.5と同じ総合スコアを約3分の1のコストで出せる、Meta最小の推論モデルです。エージェントの繰り返し作業に強く、テキスト・画像・音声・動画を1つのモデルで扱えるのも魅力。
一方で、難しいコーディングは上位モデルに譲り、20万トークン超の割増料金にも気を配る必要があります。計画は大きなモデル、実行はMuse Emberと分ければ、精度とコストを両立できるはず。まずは社内で回数の多い作業を洗い出し、置き換えられる部分から試してみてください。
弊社では、AI導入を検討中の企業向けに、業務効率化や新しい価値創出を支援する情報提供・導入支援を行っています。最新のAIを活用し、効率的な業務改善や高度な分析が可能です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
Muse Emberに関するよくある質問