MiniMax H3とは?タスクとモダリティの境界を超えるオープンモデルの特徴・料金・使い方を徹底解説
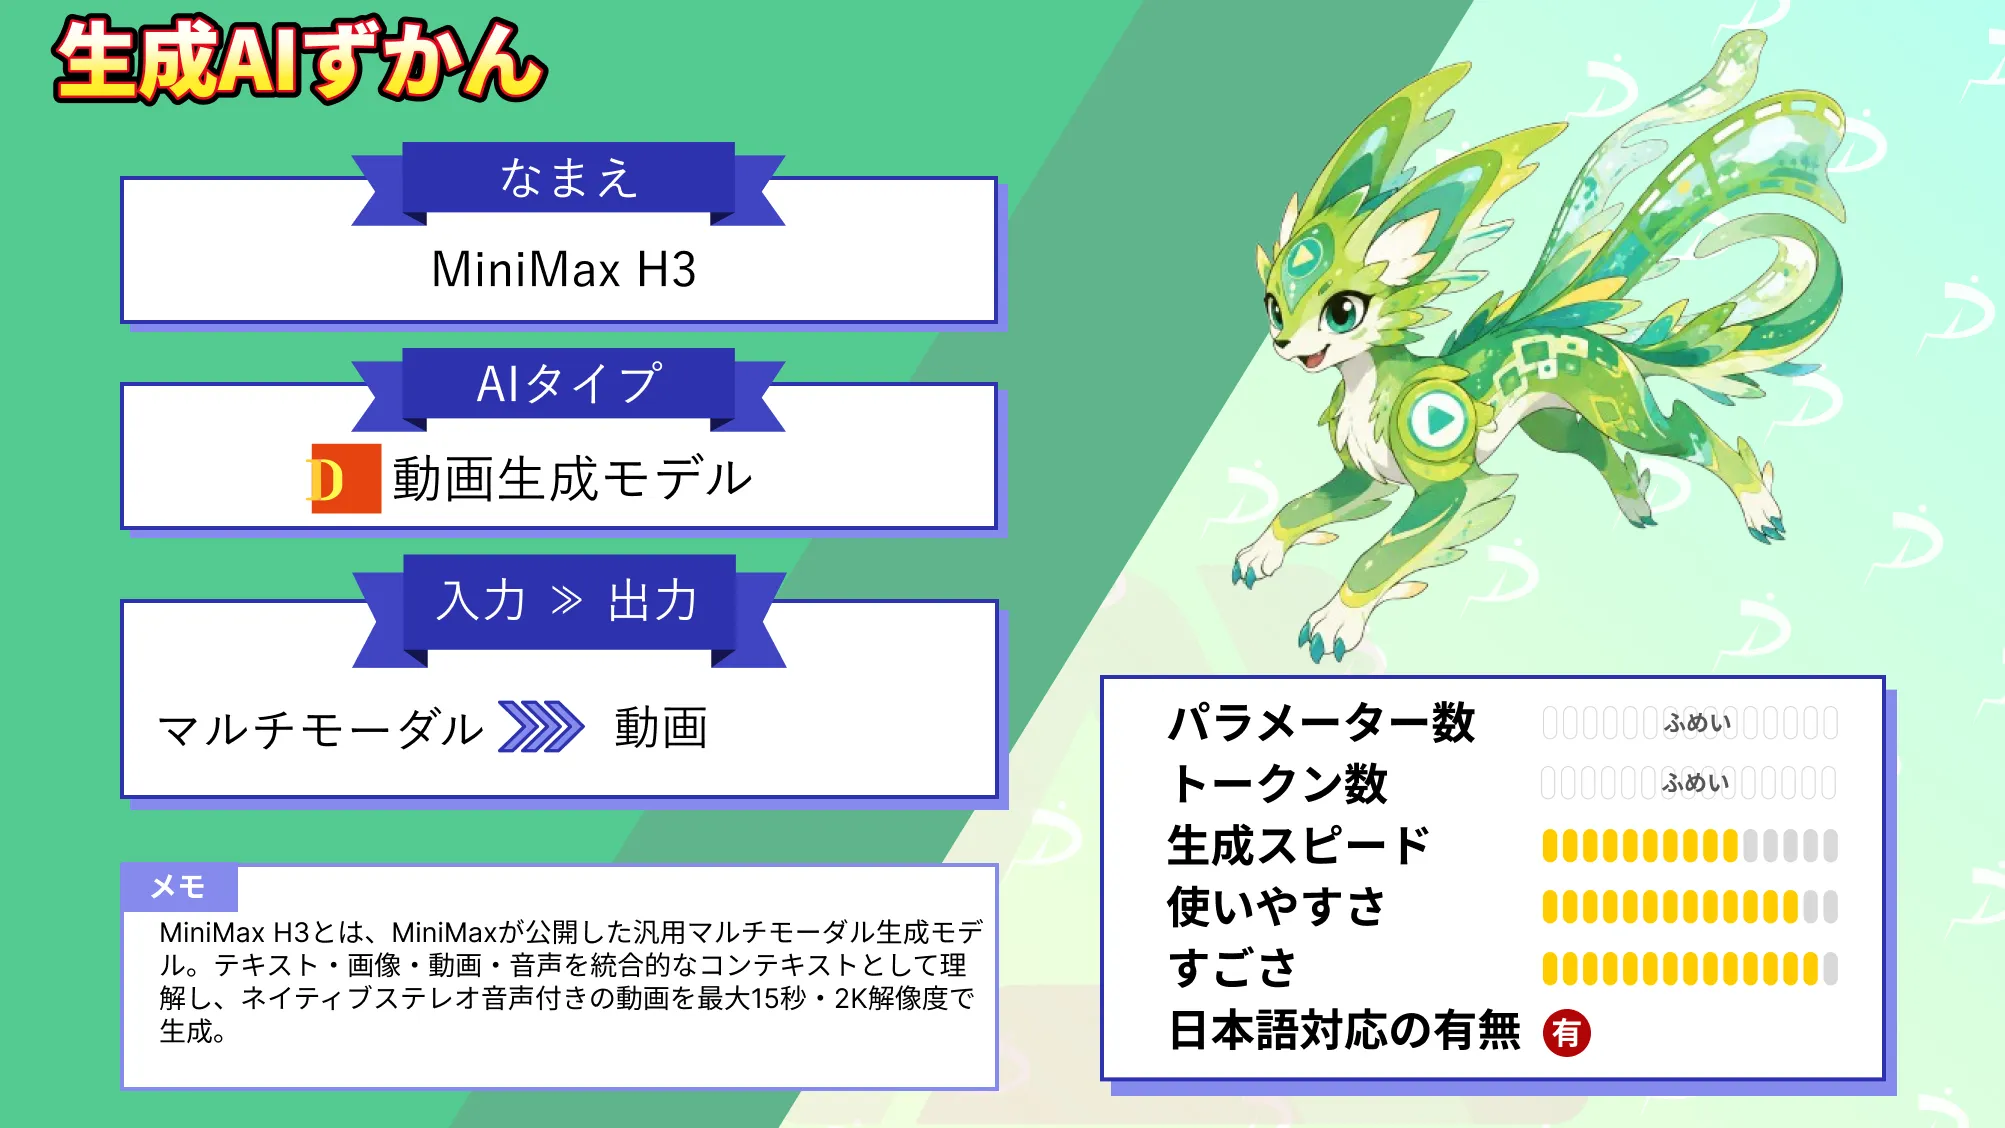
- MiniMax H3はテキスト・画像・動画・音声を1つの文脈として扱う汎用マルチモーダル生成モデル
- ネイティブステレオ音声付きの動画を最大15秒・2K解像度で生成でき、MiniMaxの公式発表では2Kの秒単価が主要モデルの3分の1未満
- 2026年8月3日にHugging Faceでモデルウェイトが公開され、ローカルでも実行できるオープンウェイトモデル
2026年7月、MiniMaxから新しいマルチモーダル生成モデルが発表されました。今回登場した「MiniMax H3」は、テキスト・画像・動画・音声をひとつの統合されたコンテキストとして理解する汎用マルチモーダル生成モデルです。ネイティブステレオ音声付きの動画を、最大15秒・2K解像度で生成できます。
これまでの生成モデルには、「タスクごとに専用モデルが分かれている」「画像・動画・音声のモダリティ間に明確な壁がある」「動画生成はクローズドモデルが中心でエコシステムが閉じている」といった課題がありました。
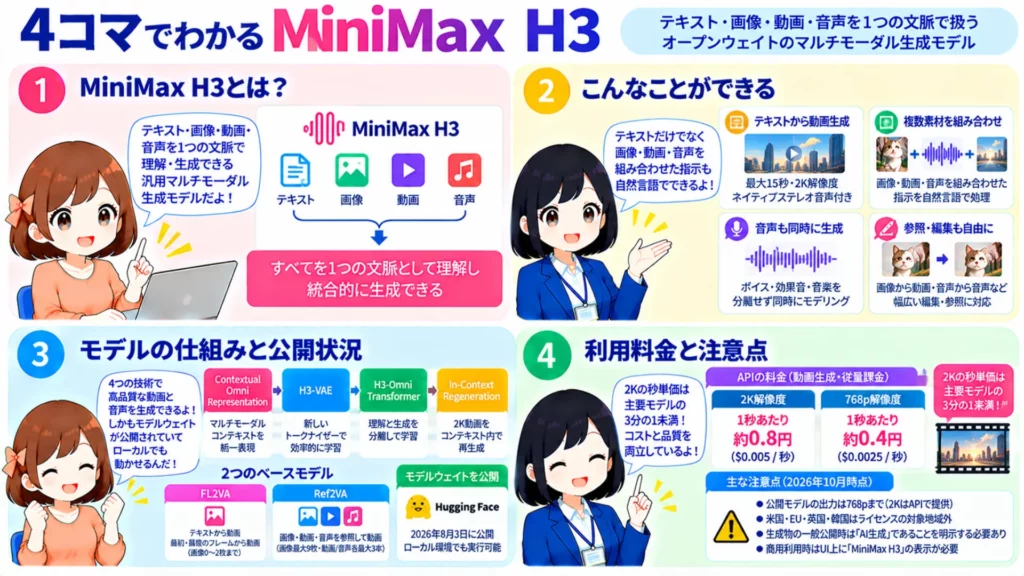
一方でH3は、タスクとモダリティの境界そのものを取り払う設計です。参照・編集の関係性を固定のタスク集合ではなく自然言語で表現することで、事前学習の段階から幅広い指示に対応できる汎用性を獲得しています。さらに2026年8月3日にはHugging Faceでモデルウェイトが公開され、ローカル環境でも動かせるようになりました。
とはいえ、新しい生成モデルが登場するたびに、「従来の動画生成AIと何が違うのか」「コストはどのくらいかかるのか」「実際にどのような制作現場で使えるのか」といった疑問を感じる方も多いのではないでしょうか。
そこで本記事では、MiniMax H3の概要・仕組み・特徴・料金・ライセンスに加え、使い方やローカルで動かす方法、業界別の活用シーンまで詳しく解説します。
\生成AIを活用して業務プロセスを自動化/
MiniMax H3とは
MiniMax H3は、MiniMaxが2026年7月に公開した汎用マルチモーダル生成モデルです。
最大の特徴は、テキスト・画像・動画・音声にまたがる統合的なコンテキスト理解にあります。複数のモダリティを入力として受け取り、それらの関係性を踏まえたうえで、ネイティブステレオ音声を伴う動画を出力できるモデル。
用途としては、広告・ブランディング・EC・プロダクトデザイン・UI/UX・ゲームなどが挙げられます。
| 比較項目 | MiniMax H3 | 従来の生成モデル |
|---|---|---|
| タスクの扱い | タスクの境界を設けず統合的に学習 | T2I・編集・被写体参照・モーション参照などを専用モデルに分割 |
| 音声 | 音声・効果音・音楽を分離せず同時にモデリング | ボイス・効果音・音楽をそれぞれ別領域として研究 |
| 参照・編集の指定 | 自然言語で関係性を記述 | 固定されたタスク集合に沿った入力形式 |
| 公開方針 | モデルウェイトを公開(2026年8月) | クローズドソースが主流 |
動画生成AI全体の動向について、詳しく知りたい方は下記の記事もあわせてご覧ください。
MiniMax H3の仕組み
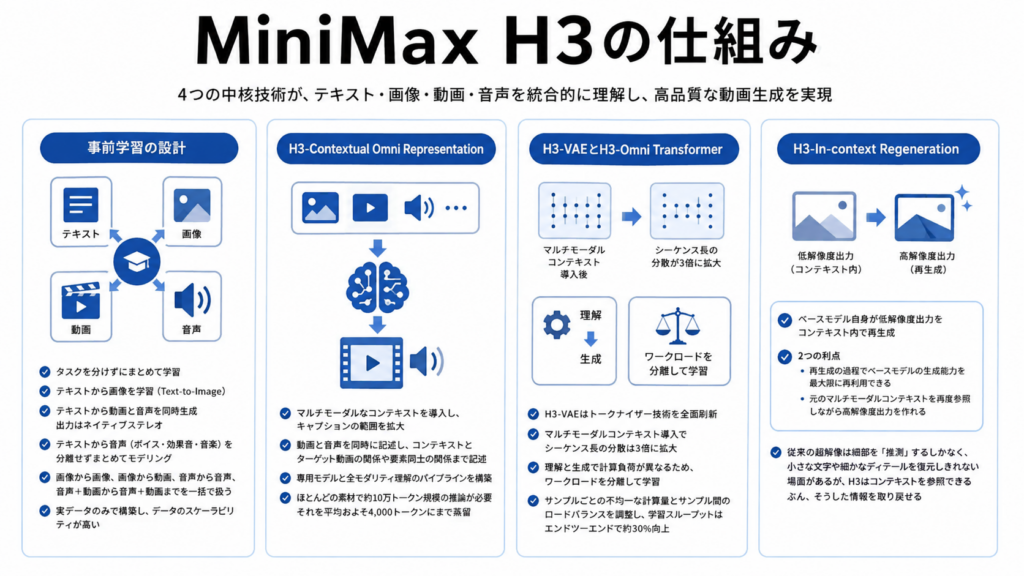
MiniMax H3を支えているのは、Contextual Omni Representation・H3-VAE・H3-Omni Transformer・In-Context Regenerationという4つの技術です。ここでは事前学習の設計と、それぞれの技術が担う役割を見ていきます。
事前学習の設計
| 領域 | 内容 |
|---|---|
| テキストから画像 | Text-to-Imageを統合的に学習 |
| テキストから動画 | 音声を同時生成し、出力は全てネイティブステレオ。マルチショットもネイティブにモデリング |
| テキストから音声 | ボイス・効果音・音楽を分離せず、まとめてモデリング |
| 汎用的な参照と編集 | 画像から画像、画像から動画、音声から音声、音声+動画から音声+動画までを一括で扱う |
MiniMax H3の事前学習は、タスクを分けずにまとめて学習させるという方針で組み立てられています。扱われるデータとタスクは上記のとおりです。
ここでいう「汎用的な参照と編集」は、実データのみから構築されている点に大きな意味があります。合成的に作った学習ペアに頼らないため、データのスケーラビリティが高いという設計です。
H3-Contextual Omni Representation
MiniMax H3の開発で最も重視されたのが、キャプション能力の強化です。マルチモーダルなコンテキストを導入したことで、キャプションが担う範囲は大きく広がりました。
ターゲットとなる動画を説明するだけでなく、コンテキストとターゲット動画の関係、さらにはコンテキスト内部の要素同士の関係まで記述する必要があるためです。
動画と音声を同時に記述する必要もあり、その視聴覚の関係はマルチショットになるとさらに複雑になります。この課題に対してMiniMaxは、専用モデルと全モダリティ理解のパイプラインを構築しました。ほとんどの素材で約10万トークン規模の推論が必要になり、それを平均およそ4,000トークンにまで蒸留しています。
H3-VAEとH3-Omni Transformer
H3-VAEは、Hシリーズが積み上げてきたトークナイザー技術を全面的に刷新したものです。
マルチモーダルコンテキストの導入により、シーケンス長の分散は3倍に拡大。
理解と生成では計算負荷の性質も大きく異なるため、両者のワークロードを分離して学習する構成を採用。サンプルごとの不均一な計算量とサンプル間のロードバランスを同時に調整した結果、学習スループットはエンドツーエンドで約30%向上しました。
H3-In-context Regeneration
2K出力の実現方法は、一般的な超解像モジュールを別途用意するのではなく、H3のベースモデル自身が低解像度出力をコンテキスト内で再生成するアプローチを採っています。
この方式には2つの利点があります。
- 再生成の過程でベースモデルが持つ生成能力を最大限に再利用できる
- 元のマルチモーダルコンテキストを再度参照しながら高解像度出力を作れる
従来の超解像は細部を「推測」するしかなく、小さな文字や細かなディテールを復元しきれない場面がありました。H3はコンテキストを参照できる分、そうした情報を取り戻せるという違いがあります。
2つのベースモデル(FL2VA・Ref2VA)
公開されたMiniMax H3のベースモデルは、FL2VAとRef2VAの2種類です。Hugging Faceのモデルカードによると、どちらも動画と音声を同時に生成し、入力素材の渡し方で使い分けます。
| モデル | 対応モード | 入力の上限 |
|---|---|---|
| H3-Base-FL2VA | テキストから動画、最初・最後のフレームから動画 | 画像0〜2枚(0枚はテキストのみ、1枚は最初または最後のフレーム、2枚は最初と最後のフレーム) |
| H3-Base-Ref2VA | 画像・動画・音声を参照して動画を生成 | 画像は最大9枚。動画と音声はそれぞれ最大3本(1本2〜15秒・合計15秒以内)。種類を混ぜる場合は合計12ファイルまで |
FL2VAは、絵コンテの1コマを起点に動かしたいときなど、フレームを正確に固定したい場面に向いています。一方のRef2VAは、人物の見た目や動き、声などを素材から借りて新しい映像を組み立てるモデルです。
なお、APIでは最初・最後のフレームの指定と参照素材を同じリクエストで併用できません。目的に合わせてどちらか一方を選びましょう。
MiniMax H3の特徴
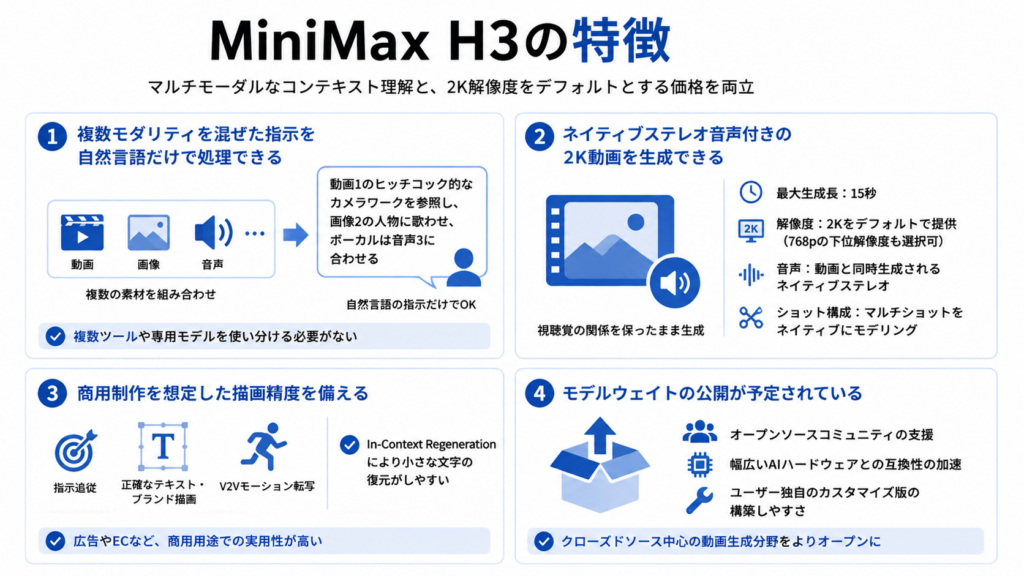
MiniMax H3の強みは、マルチモーダルなコンテキスト理解と、2K解像度をデフォルトとする価格の両立です。ここでは主な特徴を詳しく見ていきます。
複数モダリティを混ぜた指示を自然言語だけで処理できる
実際のクリエイティブ作業では、画像・音声・動画といった複数の素材を組み合わせながら作成していきます。
MiniMax H3では、「動画1のヒッチコック的なカメラワークを参照し、画像2の人物に歌わせ、ボーカルは音声3に合わせる」といった指示が成立します。
従来であれば、モーション参照・被写体参照・音声同期をそれぞれ別のツールや専用モデルで処理する必要がありました。その工程が1つのプロンプトに集約される点は、制作フローそのものを変える可能性があるのではないでしょうか。
ネイティブステレオ音声付きの2K動画を生成できる
| 項目 | MiniMax H3の仕様 |
|---|---|
| 最大生成長 | 15秒 |
| 解像度 | 2Kをデフォルトで提供(768pの下位解像度も選択可) |
| 音声 | 動画と同時生成されるネイティブステレオ |
| ショット構成 | マルチショットをネイティブにモデリング |
| 入力モダリティ | テキスト・画像・動画・音声 |
MiniMax H3は、最大15秒・2K解像度の動画を生成します。音声は後付けではなく、全ての出力がネイティブステレオ。
加えて、マルチショットをネイティブにモデリングしている点も見逃せません。カットが切り替わる映像でも、視聴覚の関係を保ったまま生成できます。
商用制作を想定した描画精度を備える
初期テストでは、指示追従・正確なテキストおよびブランド描画・V2Vモーション転写で高い評価が示されています。
特にテキストやブランドロゴの描画精度は、広告やEC用途で実用に耐えるかどうかを分ける要素。In-Context Regenerationによって小さな文字が復元されやすくなっている点も、この強みを支えています。
モデルウェイトが公開されている
MiniMax H3は、2026年8月3日にHugging Face(MiniMaxAI/MiniMax-H3)でモデルウェイトが公開されました。オリジナル形式とDiffusers形式が同じリポジトリに置かれ、FL2VAとRef2VAの2モデルが提供されています。
動画生成の分野は長らくクローズドソースが優勢で、大規模言語モデルなどと比べると反復の速度が遅く、エコシステムも開かれていない状態が続いてきました。H3の公開は、こうした状況に一石を投じる動きといえるでしょう。
公開と同じ日にはComfyUIも標準対応し、公式テンプレートからすぐに試せる環境が整っています。ただし、公開されたのは768pで生成するベースモデルです。プロンプトを補強するH3-Context-IRと、2Kへ再生成するモジュールは公開されておらず、APIでの提供となります。
MiniMax H3の安全性・制約
| 項目 | 2026年10月時点の内容 |
|---|---|
| ウェイト公開 | 2026年8月3日に公開済み。米国・EU・英国・韓国はライセンスの対象地域外 |
| 生成長 | 最大15秒 |
| 解像度 | 公開モデルの出力は768pまで。2KはAPIで提供 |
| モデルサイズ | 複数の能力面で改善余地があるとMiniMaxが明言 |
| 視覚的なディテール | 一部シーンで改善余地あり。今後さらに高解像度・高忠実度を目指す方針 |
| マルチモーダル理解 | 生成品質の土台として大幅な改善余地があるとされる |
| 入力のモデレーション | APIでは入力と強化後のプロンプトを自動で審査し、違法・性的・権利侵害の疑いがある内容をブロック |
| 利用制限 | ライセンス付属の利用規約(Acceptable Use Policy)で、偽情報の拡散・なりすまし・軍事目的など20項目を禁止 |
| ライセンス上の義務 | 生成物を一般公開するときのAI生成表示、商用製品のUIでの「MiniMax H3」の表示 |
H3の安全面の仕組みは、Hugging Faceのモデルカードとライセンスに記載されています。モデルカードによると、ユーザーが送った文章・画像・動画と強化後のプロンプトは自動でモデレーションされる仕組みです。違法なものや性的なもの、第三者の権利を侵害する疑いがあるものはブロックされます。
ただし、この審査はAPI側の仕組みとして書かれており、ローカル実行でも同じ審査がかかるかは明記されていません。社内で動かす場合は、入力素材のチェック体制を自社で用意しておくと安心です。
利用時の制約として押さえておきたいのが、ライセンス上の義務です。利用規約では、生成物を一般公開するときに機械生成であることを明示しない利用が禁止されています。また、商用の製品やサービスで使う場合は、UI上に「MiniMax H3」と目立つように表示しなければなりません。
注目したいのは、MiniMaxが今後の優先事項を明確に示している点です。次世代のHシリーズではM系列モデルの能力を統合する計画があり、マルチモーダル理解の底上げを図るとしています。
また、現行のモデルサイズには改善の余地があるとして、スケーリングを明確な前進の道筋と位置づけました。タスクの汎化が強まることで、その潜在能力を十分に引き出せると考えられています。
MiniMax H3の料金
MiniMax H3のAPIは、動画出力を中心とする従量課金制です。2026年10月時点の公式料金ページでは、料金体系は「動画生成」「入力素材」「動画再生成」「H3-Context-IR」の4つに分かれており、利用する機能ごとに課金されます。コードを書かずに試したい場合は、Hailuo AIのサブスクリプションも選べます。
動画生成料金
| モデル | 解像度 | 課金方式 | 料金 |
|---|---|---|---|
| MiniMax H3 | 2K | 1秒ごとに課金 | $0.13/秒 |
| MiniMax H3 | 768P | 1秒ごとに課金 | $0.08/秒 |
動画生成は、生成する動画の解像度と長さに応じて1秒単位で課金されます。高解像度の2Kは768Pよりも高価ですが、その分より鮮明な動画を生成できます。
入力素材の料金
| 素材 | 料金 |
|---|---|
| 音声 | 無料 |
| 画像 | 最初の5枚まで無料、6枚目以降は$0.04/枚 |
| 動画 | 入力動画の長さに応じて課金(2K:$0.13/秒、768P:$0.08/秒) |
MiniMax H3では、動画だけでなく画像や音声を入力として利用できます。音声は無料で利用でき、画像は5枚まで無料です。一方、動画を入力する場合は、入力動画の長さに応じて料金が発生します。
画像を数枚使って動画を生成するケースでは追加料金が発生しないため、画像ベースの動画生成を試したい場合でも始めやすい料金体系となっています。
動画再生成(768P→2K)の料金
| モデル | 解像度 | 課金方式 | 料金 |
|---|---|---|---|
| MiniMax H3 | 768P→2K | 再生成後の動画の長さごとに課金 | $0.05/秒 |
768Pで生成した動画を2Kへ再生成する場合は、通常の動画生成とは別料金。再生成後の動画の長さに応じて課金される仕組みです。
動画再生成時の入力素材の料金
| 素材 | 料金 |
|---|---|
| 音声 | 無料 |
| 画像 | 最初の5枚まで無料、6枚目以降は1枚あたり$0.025 |
| 動画 | 元の768P動画の長さ1秒あたり$0.05 |
動画再生成時も、入力素材によって料金が異なります。音声は無料ですが、画像や動画は所定の料金が適用されます。また、再生成では元の768P生成で使った入力素材にもう一度料金がかかる点に注意しましょう。
通常の動画生成と比較すると、追加画像の料金は1枚あたり$0.04→$0.025と安く設定されています。
H3-Context-IRの料金
| モデル | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| MiniMax H3 | $0.90 | $3.60 |
H3-Context-IRは、プロンプトやコンテキスト情報を処理するための機能です。こちらは動画の長さではなく、入力・出力されたトークン数に応じて課金されます。
動画生成APIと組み合わせて利用する場合は、このトークン料金も考慮しておくと、より正確なコストを見積もれます。
MiniMax H3の料金まとめ
| 項目 | 料金 |
|---|---|
| 768P動画生成 | $0.08/秒 |
| 2K動画生成 | $0.13/秒 |
| 768P→2K再生成 | $0.05/秒 |
| 音声入力 | 無料 |
| 画像入力 | 最初の5枚無料(6枚目以降$0.04/枚) |
| H3-Context-IR入力 | $0.90/100万トークン |
| H3-Context-IR出力 | $3.60/100万トークン |
MiniMax H3は、動画生成を秒単位で課金するシンプルな料金体系を採用しています。
一方で、画像・動画などの入力素材や動画再生成、H3-Context-IRはそれぞれ個別に料金が設定されています。そのため、利用する機能によって総コストが変わる点に注意しましょう。
Hailuo AIのサブスクリプション料金
コードを書かずにMiniMax H3を試したい場合は、MiniMaxの動画生成サービスHailuo AIのサブスクリプションを使う方法があります。プランはFree・Standard・Pro・Master・Maxの5種類で、毎月付与されるクレジットを消費して動画を生成する仕組みです。
| プラン | 月払い | 年払い(年額) | 月間クレジット | H3(2K)で生成できる目安 |
|---|---|---|---|---|
| Free | $0 | – | 初回のみ無料トライアルクレジット | – |
| Standard | $10.50/月 | $100.80/年 | 1,000 | 約84秒 |
| Pro | $38.00/月 | $364.80/年 | 4,500 | 約375秒 |
| Master | $89.00/月 | $854.40/年 | 10,500 | 約875秒 |
| Max | $216.00/月 | $2,208.00/年 | 27,000 | 約2,250秒 |
料金ページでは、各プランでH3の768p・2K(4〜15秒)が利用できると案内されています。表示価格は割引を適用したもので、時期によって変わる可能性があります。
なお、Freeプランのカードには「Hailuo models only」とも書かれており、H3をどこまで試せるかははっきりしません。H3を本格的に使うなら、有料プランかAPIを前提に考えましょう。
MiniMax H3のライセンス
MiniMax H3のウェイトは、独自の「MiniMax H3 Community License Agreement」で公開されています。使用料は無料で、条件を守れば商用利用や改変、再配布もできるライセンスです。主な条件は以下のとおりです。
| 項目 | 内容 |
|---|---|
| 商用利用 | 可能(使用料なし) |
| 売上の基準 | 商用の製品・サービスの年間売上が2,000万ドルを超える場合は、MiniMaxから事前に書面での許可を得る必要がある |
| 地域制限 | 米国・EU・英国・韓国はライセンスの対象地域外。ローカルでの利用に加え、生成物の利用・配布も対象地域内に限られる |
| 帰属表示 | 商用の製品・サービスのUIに「MiniMax H3」を目立つように表示する |
| AI生成の表示 | 生成物を一般公開するときは、機械生成であることを明示する(付属の利用規約で規定) |
| 蒸留の禁止 | H3や生成物を使って、H3系以外のAIモデルを改善することは禁止(蒸留も含む) |
| 派生モデル | LoRAやファインチューニングによる派生モデルの作成は可能。ただし同じライセンスを引き継ぐ |
日本は除外地域に含まれていないため、日本の企業は対象地域内として利用できます。年間売上2,000万ドル(1ドル150円換算で約30億円)を超える企業が自社サービスに組み込む場合は、事前の許可申請が必要です。
注意したいのは、生成物を米国・EU・英国・韓国で配信・表示する場合の扱いです。ライセンスでは対象地域外での出力の利用も禁じているため、海外向けの広告やサービスに使うときは法務部門と確認しておきましょう。
なお、MiniMaxが提供するAPIはこの地域制限とは別扱いで、ライセンスのQ&Aでは世界中で利用できると説明されています。
オープンソースモデルの動向について、詳しく知りたい方は下記の記事をご覧ください。
MiniMax H3の使い方
MiniMax H3を使う方法は、Hailuo AIで試す・APIで自社システムに組み込む・ローカルで実行するの3つです。目的と環境に合わせて選びましょう。
Hailuo AIで試す
もっとも手軽なのは、ブラウザから使えるHailuo AIで試す方法です。Hailuo AIはMiniMaxが運営する動画生成サービスで、料金ページでは各プランでH3の768p・2K(4〜15秒)が利用できると案内されています。
コードを書く必要がないため、まずは生成品質を確かめたい企画・制作担当者に向いています。料金はサブスクリプション制で、プランごとに毎月クレジットが付与される仕組みです。プランの詳細は「Hailuo AIのサブスクリプション料金」で紹介しています。
APIで自社システムに組み込む
自社のシステムやワークフローに組み込むなら、MiniMaxのAPIを使います。動画生成は「/v2/video_generation」にリクエストを送り、返ってきたタスクIDで完了を確認する非同期の仕組みです。基本的な進め方をステップ形式で解説します。
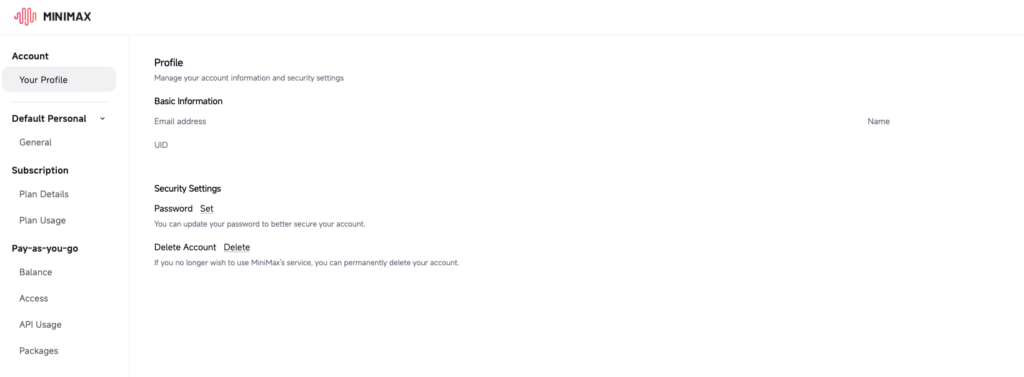
MiniMaxの公式サイトからコンソールにログインします。APIを利用する場合は、開発者向けドキュメントを確認しておきましょう。
参照したい動画・画像・音声を用意します。MiniMax H3はこれらを統合的なコンテキストとして扱うため、モーションの参照元、被写体の参照元、ボーカルの参照元といった役割ごとに素材を分けておくと指示が組み立てやすくなります。
素材を使わず、テキストの指示だけで生成することも可能です。
MiniMax H3では、専用モデルを選び分ける必要はありませんが、API上のtype・role指定が必要です。
動画1のヒッチコック的なカメラワークを参照し、画像2の人物に歌わせてください。ボーカルは音声3に合わせてください。解像度は「2K」か「768P」を指定します。コストを抑えたい検証段階では768Pを選び、本番用の書き出しで2Kに切り替えるという使い分けが現実的でしょう。動画の長さは4〜15秒の範囲で指定しましょう。
音声はネイティブステレオで同時生成されるため、映像と音の両方を確認します。意図とずれている場合は、素材の役割分担や関係性の記述をより具体的に書き直すことで精度が上がります。
ローカルで実行する
ウェイトが公開されたことで、MiniMax H3はローカル環境や自社インフラでも実行できます。素材を外部のサーバーに送らずに生成できるため、社外秘の素材を扱う制作や、生成量が多くAPI費用を抑えたい場面で選択肢になるでしょう。
ただし、ローカルで生成できるのは768pまでで、GPUの性能によっては生成に時間がかかります。具体的な手順と必要スペックは、次の「MiniMax H3をローカルで動かす方法」で解説します。
MiniMax H3をローカルで動かす方法
MiniMax H3をローカルで動かすには、Hugging Faceからウェイトを入手し、ComfyUIなどの推論環境で読み込むのが基本の流れです。ここでは導入の手順と必要なスペック、利用前に確認したい地域制限を解説します。
Hugging Faceからダウンロードする
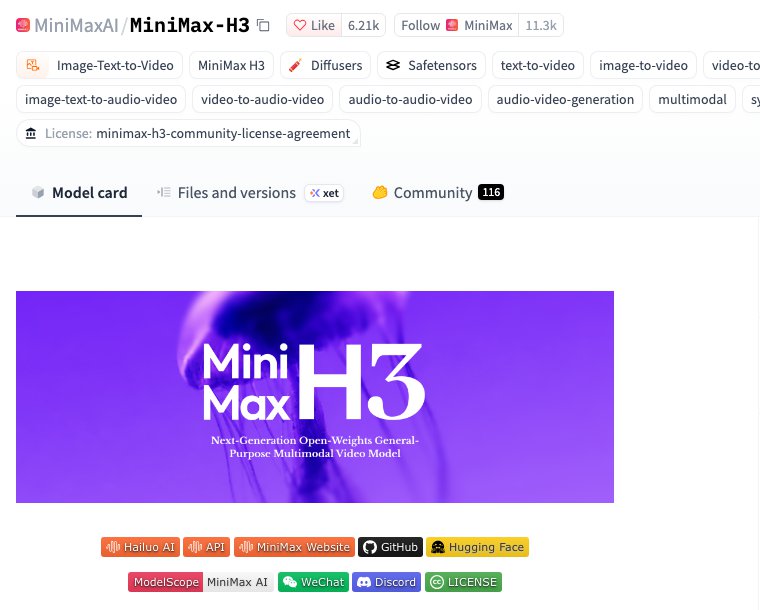
ウェイトはHugging FaceのMiniMaxAI/MiniMax-H3で配布されています。リポジトリにはFL2VAとRef2VAの2モデルが、オリジナル形式とDiffusers形式で並ぶ構成です。
公式のモデルカードでは、Hugging FaceのCLIで必要なモデルだけを指定してダウンロードする方法が案内されています。
# FL2VAとRef2VAの両方をダウンロードする場合
hf download MiniMaxAI/MiniMax-H3 --include "model_index.json" "FL2VA/*" "Ref2VA/*" --local-dir MiniMax-H3
# FL2VAだけをダウンロードする場合
hf download MiniMaxAI/MiniMax-H3 --include "model_index.json" "FL2VA/*" --local-dir MiniMax-H3
リポジトリ全体は約500GBあり、FL2VAとRef2VAのフォルダはそれぞれ約144GBです。Diffusersで使う場合は、ModularPipeline.from_pretrained(“MiniMaxAI/MiniMax-H3”)を実行すると必要なファイルだけが自動で取得されます。
Hugging Faceの使い方について詳しく知りたい方は、下記の記事もあわせてご覧ください。
ComfyUIで動かす
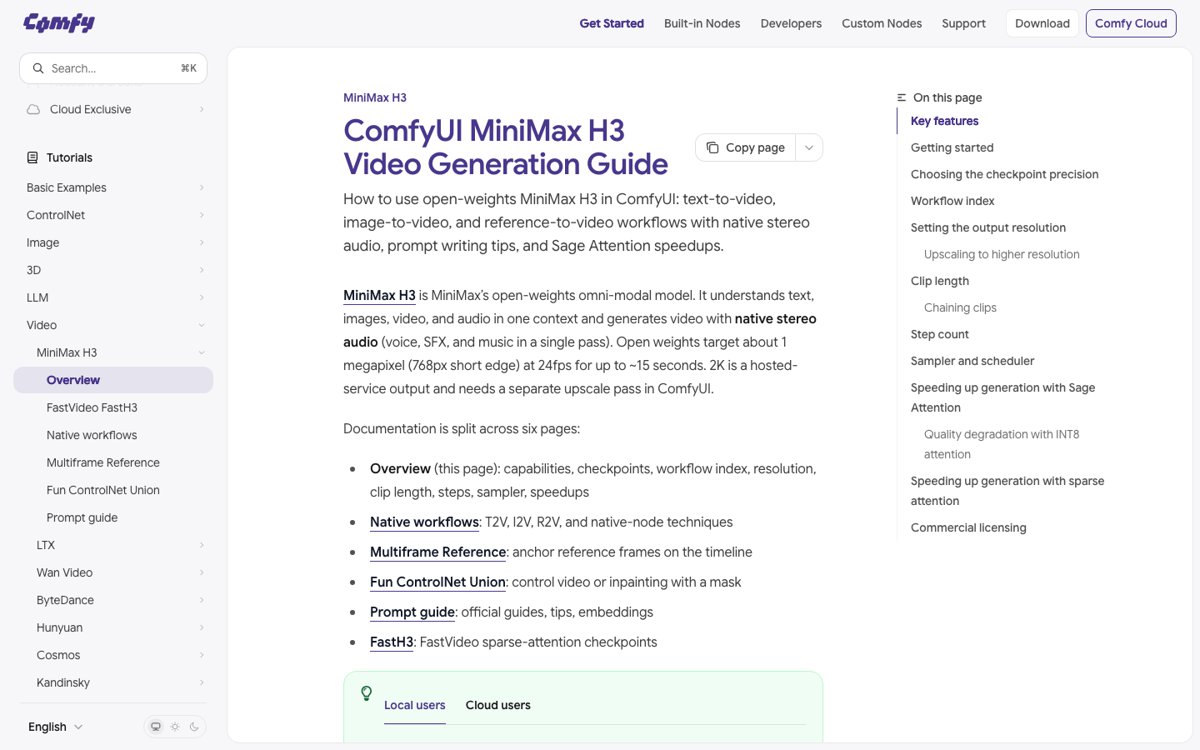
ComfyUIは、2026年8月3日公開のv0.30.0でMiniMax H3に標準対応しました。カスタムノードを追加しなくても、公式テンプレートから動画を生成できます。公式ドキュメントで案内されている手順は以下のとおりです。
| 手順 | 内容 |
|---|---|
| 1 | ComfyUIを0.30.0以上に更新する |
| 2 | Template LibraryのVideoから「MiniMax H3 Image to Video」(テキスト・画像から動画)または「MiniMax H3 Reference to Video」(参照素材から動画)のテンプレートを開く |
| 3 | 表示されるポップアップから、必要なモデルファイルをダウンロードする |
テンプレートの既定の構成では、以下のモデルファイルを使います。ファイルはComfyUI向けに再パッケージされたComfy-Org/MiniMax-H3で配布されています。
| 配置先 | ファイル | 容量 |
|---|---|---|
| models/diffusion_models | minimax_h3_fl2va_pruned_int8_convrot.safetensors(R2Vはref2va版) | 約21GB |
| models/text_encoders | qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors | 約15.7GB |
| models/vae | minimax_h3_video_vae_int8_convrot.safetensors・minimax_h3_audio_vae_fp32.safetensors | 約3.4GB |
| models/loras | Turbo LoRA(T2V・I2Vは8ステップ版、R2Vは4ステップ版) | 約2GB |
なお、Multiframe Referenceは0.34.0以上、高速化版のFastH3は0.36.0以上が必要です。機能によって必要なバージョンが異なるため、使いたいテンプレートに合わせて更新しておきましょう。
ComfyUIの基本的な使い方は、下記の記事で詳しく解説しています。
必要スペックと軽量化
MiniMax H3はTransformer部分だけで33Bパラメータあり、フル精度ではモデル全体で約123.6GBと大容量です。ComfyUI公式ブログによると、量子化したモデルを組み合わせれば約42.5GBまで軽量化でき、VRAMの動的なオフロードと合わせてRTX 3060クラスのGPUでも動かせるとされています。
| 方法 | 内容 | 目安 |
|---|---|---|
| 量子化版safetensors(ComfyUI公式) | pruned_w6a8(16GB)・pruned_int8_convrot(21GB)などを配布 | 公式は「VRAMに収まる最小のビルド」を選ぶよう推奨 |
| 量子化版GGUF(コミュニティ) | Unslothなどが配布。Q2_K(約6.3GiB)〜Q8_0(約20GiB)。ComfyUIではComfyUI-GGUFカスタムノードで読み込む | 配布者の目安では16GBのGPUならQ4_K_M、24GBならQ5_K_M |
| Turbo LoRA | lightx2vが配布するステップ削減用のLoRA | 標準の20ステップを8ステップ(T2V・I2V)、4ステップ(R2V)に短縮 |
Diffusersで動かす場合も、int8量子化とオフロードを組み合わせれば12〜16GBのGPUで動作します。ただし、その場合はメインメモリが約75GB必要です。
また、Turbo LoRAはステップ数を減らす仕組みで、1ステップあたりの時間は変わりません。ComfyUIの公式ドキュメントでは、音声や声質の再現には12ステップ以上が必要とされている点にも注意しましょう。
Macについては、MiniMaxとComfyUIのどちらも公式な対応を明記していません。Apple Silicon上で一部の機能が動かない不具合の報告や、有志によるMLX版の公開はありますが、業務で使うならNVIDIA製GPUを積んだ環境が無難です。
地域制限に注意する
ローカルで動かす前に必ず確認したいのが、ライセンスの地域制限です。MiniMax H3 Community License Agreementでは、米国・EU・英国・韓国が対象地域から除外されています。
除外地域では、ウェイトの利用だけでなく生成物の利用・配布もライセンスの対象外です。日本国内で使う分には問題ありませんが、海外のクラウドGPUで動かす場合や海外向けに生成物を配信する場合は、事前にライセンス原文を確認しておきましょう。
除外地域の企業向けには、MiniMaxが個別ライセンスの申請窓口を設けています。ライセンスのQ&Aでも、地域の制限は「まだ(not yet)」であり、恒久的なものではないと説明されています。
MiniMax H3のプロンプトのコツ
MiniMax H3の精度を引き出すには、素材ごとの役割と素材同士の関係をはっきり書くことが大切です。Hugging Faceでは、公式のプロンプト作成ガイドが公開されています。ここではその内容をもとに、押さえておきたい書き方を紹介します。
素材にラベルを付けて役割を指定する
参照生成(Ref2VA)では、渡した素材を「<Picture 1>」「<Video 1>」「<Audio 1>」のような番号付きのラベルで呼び分けます。登場人物や物は「<Subject 1>」として定義し、どの素材から何を借りるのかを一文で書くのがポイントです。
<Subject 1> is the woman whose appearance comes from <Picture 1> and whose walking motion comes from <Video 1>.
<Audio 1> is the voice-timbre reference for <Subject 1> (S1).
上の例は公式ガイドに載っている書き方で、見た目は画像1、歩き方は動画1、声は音声1から取るように指定しています。素材を渡した順番がラベルの番号になるため、APIやComfyUIに渡す順番とそろえておきましょう。
素材をどこまで残すかを明示する
公式ガイドでは、素材をどの程度そのまま残すかを決まった語で指定する書き方も紹介されています。映像はfully_preserved(そのまま残す)からweak_reference(ゆるく参考にする)まで、音声はfully_copy(そのまま使う)からweak_referenceまでの、それぞれ4段階です。
<Audio 2>: reference - the target speaker follows <Audio 2>'s voice timbre and measured delivery without copying the original signal.この例は、音声2の声質と話し方を参考にしつつ、元の音声はコピーしないという指定です。ナレーションの声だけを借りたいのか、BGMをそのまま使いたいのかで、指定する語を使い分けましょう。
カメラワークや台詞は具体的に書く
テキストやフレームから生成するFL2VA向けのガイドでは、カメラワークを「動きの種類+振れ幅+速さ」で書くよう勧めています。台詞は話者IDとタグで囲み、言語も明記します。
The camera pushes in with small amplitude at slow speed toward the folded letter in her hands.
The young woman with a quiet, breathy voice (S1) says: <d>[English] I get off at the next station.</d>画面に映る文字は、ダブルクォートで囲んで翻訳せずにそのまま書くのがルールです。日本語の看板や商品名を入れたいときは、表示したい文字列を引用符で正確に指定しましょう。
【業界別】MiniMax H3の活用シーン
MiniMaxはH3の想定領域として広告・ブランディング・EC・プロダクトデザイン・UI/UX・ゲームを挙げています。ここでは業界別に、どのような使い方が考えられるかを紹介します。
広告・ブランディング
広告制作では、同じコンセプトを媒体ごとに作り分ける工数が課題になりがちです。
MiniMax H3は正確なテキストおよびブランド描画に強みを持つため、ロゴやコピーが崩れにくい映像素材を量産できると考えられます。ネイティブステレオ音声が同時に生成される点も、短尺広告の制作フローを短縮する要素。
ブランドカラーやトンマナを参照素材として渡し、関係性を言葉で指定するだけで展開できるため、キャンペーン単位での一貫性も担保しやすいのではないでしょうか。
生成AIの広告活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。

EC・小売
ECでは商品点数が多く、1点ごとに動画を用意するコストが導入の障壁になります。
MiniMaxの公式発表では、H3の2Kの秒単価は主要モデルの3分の1未満とされています(比較したモデル名は非公表)。2026年10月時点のAPI料金は2Kで1秒あたり$0.13のため、商品数の多いカタログでも展開しやすい水準です。商品画像を参照素材として渡し、動きの指定を言葉で加えるだけで訴求動画を作れる可能性があります。
小さな文字を復元しやすいIn-Context Regenerationの特性は、パッケージの表記やスペック表示が読める映像を作るうえで有利に働くでしょう。
生成AIのEC活用について、詳しく知りたい方は下記の記事をご覧ください。
ゲーム開発
ゲーム開発では、プロトタイプ段階のカットシーンやプロモーション映像に多くの工数がかかります。
MiniMax H3はマルチショットをネイティブにモデリングしているため、カットの切り替わりを含む短尺映像を一度に生成可能。効果音・音楽・ボイスを分離せずに扱う設計も、雰囲気づくりの試作と相性が良いといえるでしょう。
さらに、ウェイトが公開されたことで、LoRAで自社のアートスタイルに合わせたカスタマイズもできるようになりました。ai-toolkitやmusubi-tunerといった学習ツールがH3に対応しており、キャラクターや画風を覚えさせた専用モデルを作れます。ただし、公開ウェイトはCFG蒸留済みのため、学習方法によっては品質が崩れる点に注意が必要です。
また、ライセンス上は米国・EU・英国・韓国で利用できず、年間売上が2,000万ドルを超える企業は事前の許可が必要です。海外展開するタイトルで使う場合は、とくに慎重に確認しましょう。
AIのゲーム活用に興味がある方は下記も参考にしてください。
マーケティング・SNS運用
SNS運用では投稿頻度が成果を左右する一方、動画の制作リソースが追いつかないという悩みが生まれがちです。
最大15秒という生成長は、ショート動画のフォーマットとよく噛み合います。音声込みで完結した縦型素材を短いサイクルで回せる点は、運用型のコンテンツ制作で効いてくるでしょう。
生成AIのマーケティング活用方法について、詳しく知りたい方は下記の記事をご覧ください。
プロダクトデザイン・UI/UX
プロダクトデザインの現場では、コンセプトを動きとして共有する手段が限られていました。
MiniMax H3ならデザイン案の画像を参照させ、動きや質感の変化を言葉で指定するだけで、イメージムービーやインタラクションのイメージ映像を短時間で作れると考えられます。2Kで細部が保たれる点も、UIの検証用途では重要な要素。
MiniMax H3を実際に使ってみた
ここでは、Google ColaboratoryからMiniMax H3のAPIを呼び出し、実際に動画を生成してみます。
サンプルコードはこちら
import base64, time, requests
from IPython.display import HTML, display

API_KEY = ""

PROMPT = "夕暮れの東京の路地裏。ネオンが水たまりに反射し、傘をさした人物がゆっくり歩いてくる。シネマティック"
RESOLUTION = "768P"
DURATION = 5
RATIO = "16:9"

CREATE_URL = "https://api.minimax.io/v2/video_generation"
QUERY_URL = "https://api.minimax.io/v2/query/video_generation"
HEADERS = {"Authorization": f"Bearer {API_KEY}", "Content-Type": "application/json"}

# 1. タスク作成
res = requests.post(CREATE_URL, headers=HEADERS, timeout=60, json={
    "model": "MiniMax-H3",
    "content": [{"type": "text", "text": PROMPT}],
    "resolution": RESOLUTION,
    "duration": DURATION,
    "ratio": RATIO,
})
res.raise_for_status()
task_id = res.json()["task_id"]
print("task_id:", task_id)

# 2. 完了までポーリング
def query(tid):
    r = requests.get(f"{QUERY_URL}/{tid}", headers=HEADERS, timeout=30)
    r.raise_for_status()
    return r.json()["task"]

while True:
    task = query(task_id)
    print(task["status"])
    if task["status"] == "succeeded":
        break
    if task["status"] in ("failed", "cancelled"):
        raise RuntimeError(task)
    time.sleep(10)

video = requests.get(task["content"]["url"], timeout=600).content
open("output.mp4", "wb").write(video)
print(f"{len(video)/1024/1024:.1f} MB / usage: {task.get('usage')}")

b64 = base64.b64encode(video).decode()
display(HTML(f'<video width="720" controls autoplay loop src="data:video/mp4;base64,{b64}"></video>'))
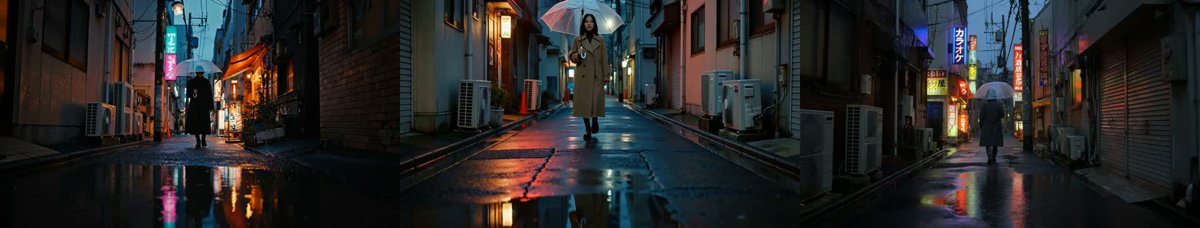
上記のプロンプトで生成した動画がこちら。
生成までは2-3分程度でした。低コストで高品質な動画を生成できるため、多くの場面でMiniMax H3が活用できそうです。
テキストから動画を3回生成した結果
2026年10月時点のAPIドキュメントで、モデル名(MiniMax-H3)とエンドポイント(/v2/video_generation)に変更がないことを確認しました。そのうえで、上記と同じコードとプロンプトを使い、768P・5秒の動画を3回同時に生成しています。
| 回 | 結果 | 所要時間(送信から完了まで) | 出力 |
|---|---|---|---|
| 1回目 | 成功 | 約118秒 | 1344×768・約5秒・ステレオ音声 |
| 2回目 | 成功 | 約129秒 | 1344×768・約5秒・ステレオ音声 |
| 3回目 | 成功 | 約117秒 | 1344×768・約5秒・ステレオ音声 |
2026年10月時点の筆者環境では、3回とも2分前後で生成に成功しました。料金は1本あたり5秒×$0.08で$0.40です。同じプロンプトでも、人物の服装や構図、ネオン看板の位置は毎回異なりました。
参照生成(Ref2VA)を試した結果
次に、H3の強みである参照生成を試しました。参照素材は、MiniMaxの画像生成モデル「image-01」で作った人物画像1枚と、MiniMaxの音声合成で作ったナレーション音声(約7.7秒)です。
クリックで表示
def data_uri(path, mime):
    return f"data:{mime};base64," + base64.b64encode(open(path, "rb").read()).decode()


REF_PROMPT = "画像1の男性が会議室のプロジェクターの前で、聞き手に向かって説明している。男性の声と口の動きは音声1に合わせる。カメラはゆっくり男性に寄っていく。"


res = requests.post(CREATE_URL, headers=HEADERS, timeout=120, json={
    "model": "MiniMax-H3",
    "content": [
        {"type": "text", "text": REF_PROMPT},
        {"type": "image_url", "image_url": {"url": data_uri("ref_speaker.jpg", "image/jpeg")}, "role": "reference_image"},
        {"type": "audio_url", "audio_url": {"url": data_uri("ref_voice.mp3", "audio/mp3")}, "role": "reference_audio"},
    ],
    "resolution": "768P",
    "duration": 8,
    "ratio": "16:9",
})
res.raise_for_status()
task_id = res.json()["task_id"]

# 以降のポーリングとダウンロードは、テキストから動画のコードと同じ
最初はMIMEタイプを「audio/mpeg」で指定したところ、「audio format “.mpeg” not allowed」というエラーで失敗しました。「audio/mp3」に直して再送すると成功し、約3分36秒で8秒の動画が完成しています。
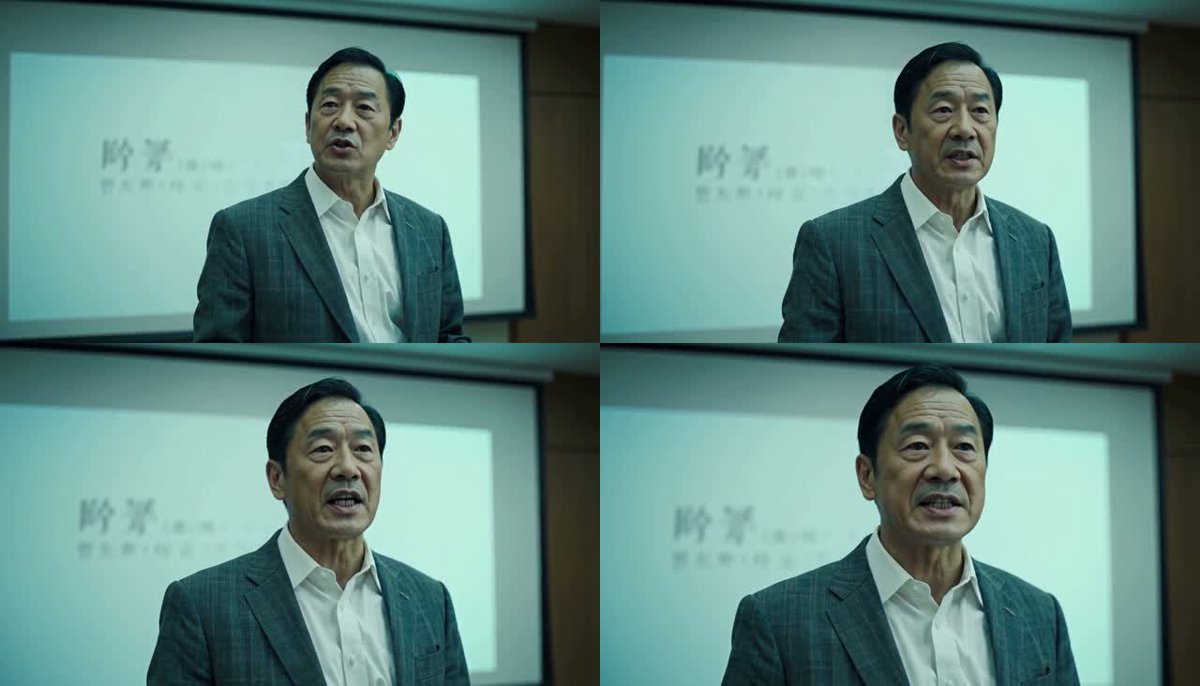
生成された動画には、参照画像の男性がそのまま登場し、プロジェクターの前で口を動かして話しています。カメラが少しずつ寄っていく構図も、プロンプトの指示どおりでした。
口の動きと音声のズレは見られず、音声1のナレーションに合わせて自然に話していました。ただし、声は参照音声の声質がそのまま使われるため、人物の見た目と声の印象が合わないと感じる場面もありました。参照音声は、登場人物の年齢や雰囲気に合う声を選んでおくのがポイントです。
料金は8秒×$0.08で$0.64です。画像1枚と音声は無料の範囲に収まりました。
テキストだけの生成より時間はかかりますが、人物の見た目を固定したまま話させられる点は、広告や社内向け動画の量産で役立ちそうです。
生成AIなどのご相談はWEELへ
MiniMax H3を活用することで、参照・編集・音声同期までを1つの指示に集約し、広告やECの映像制作を大幅に短縮できます。一方で、生成コストや品質は素材の渡し方と指示の書き方で大きく変わるため、小規模な検証から導入範囲を広げていくことも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
MiniMax H3のよくある質問