マルチモーダルAIとは?仕組み・代表モデル・活用事例をわかりやすく解説
- マルチモーダルAIは、テキスト・画像・音声・動画など複数形式の情報をまとめて理解・処理できるAI
- 最新モデルの進化により、文書解析・画像理解・音声対話など幅広い業務で活用が拡大
- 導入時は、AIの出力を元データと照合する運用やデータの取り扱いルールづくりが重要
マルチモーダルAIとは、テキスト・画像・音声・動画など複数形式の情報をまとめて理解・処理するAIです。2026年にはGemini 3.5 FlashやGemini Omniなども登場し、文書解析や画像理解、音声対話など活用範囲が広がっています。
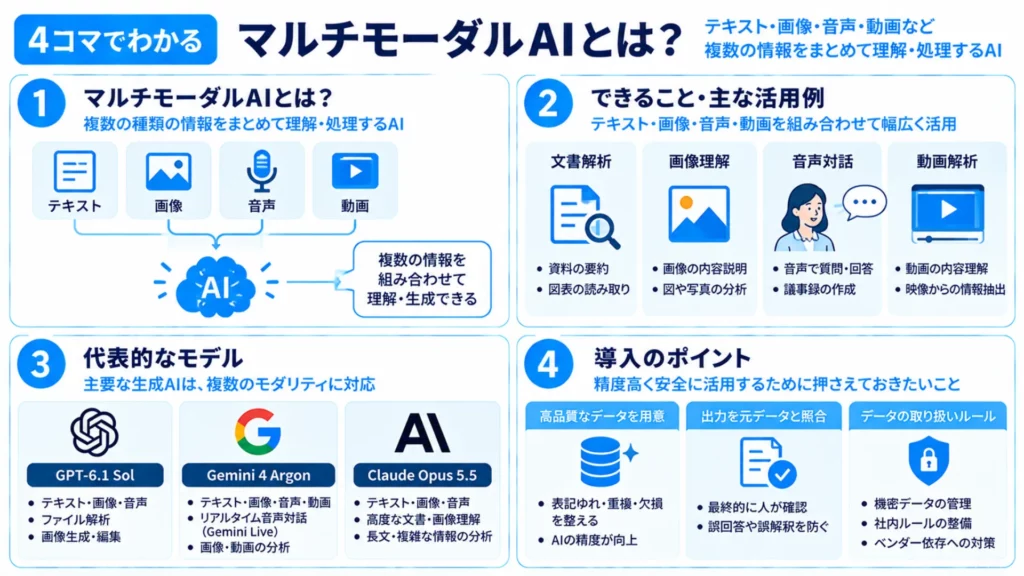
本記事では、仕組みやシングルモーダルAIとの違い・代表モデル・業界別の活用事例・実践検証の結果を解説します。最後まで読んで、自社業務での活用イメージをつかんでください。
\生成AIを活用して業務プロセスを自動化/
マルチモーダルAIとは
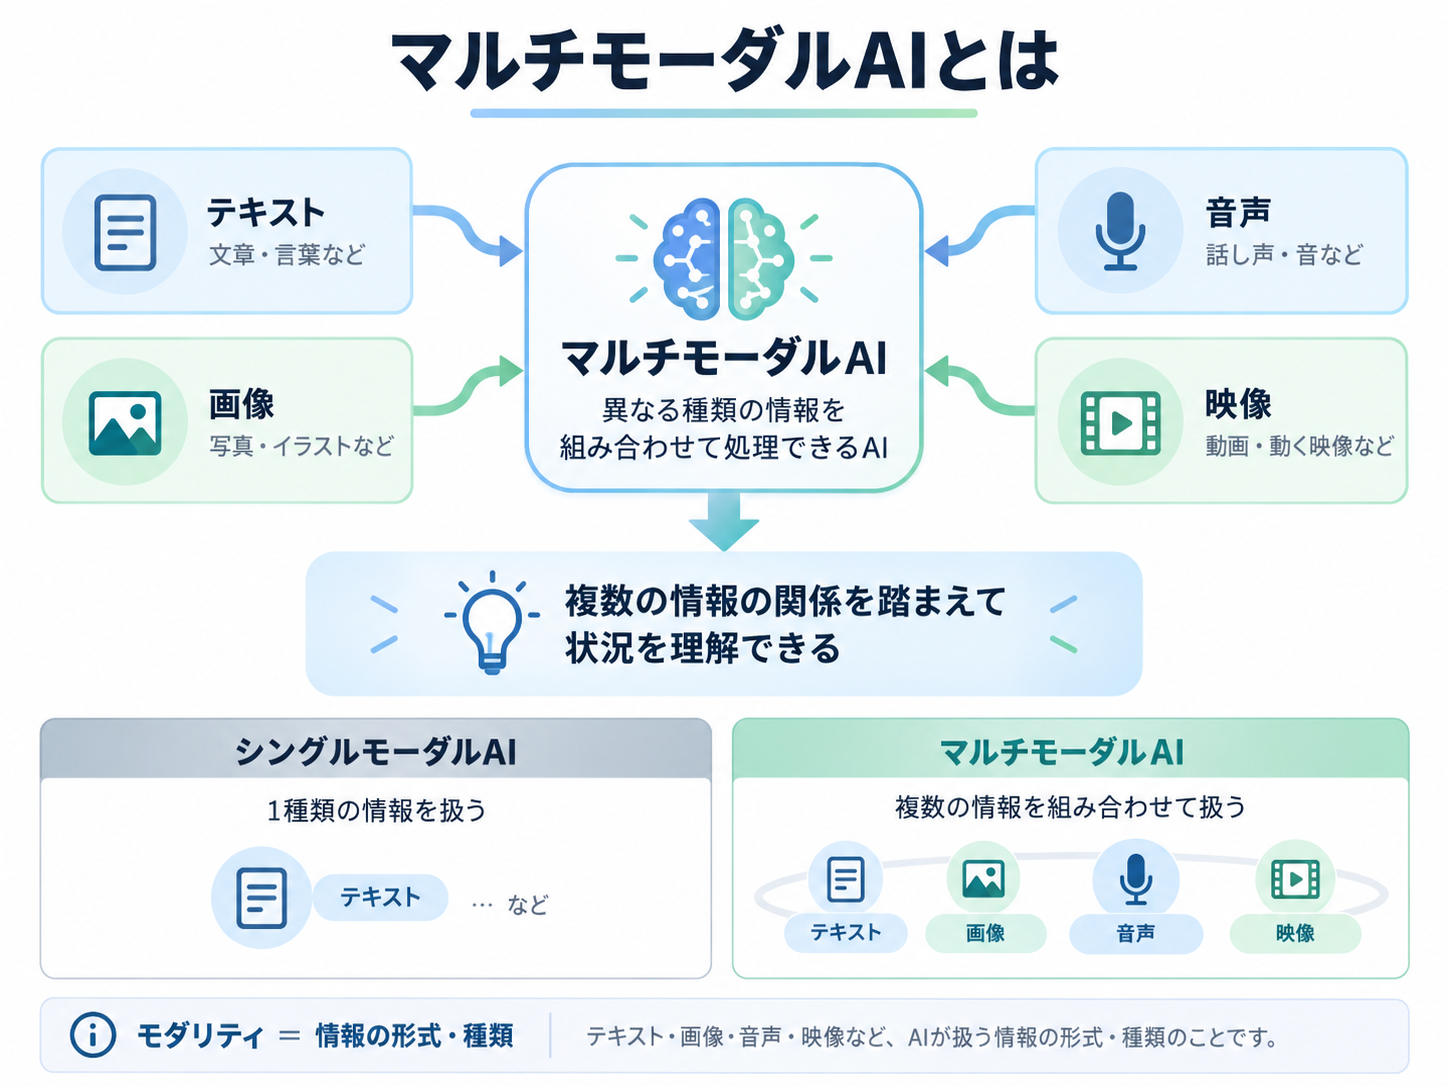
マルチモーダルAIとは、テキスト・画像・音声・映像など、異なる種類の情報を組み合わせて処理できるAIです。単一の情報だけを扱うシングルモーダルAIよりも、複数の情報の関係を踏まえて状況を理解できます。
2026年10月時点の代表例には、OpenAIの「GPT-6.1 Sol」、Googleの「Gemini 4 Argon」、Anthropicの「Claude Opus 5.5」などがあります。いずれも、テキストと画像を組み合わせた理解や分析に対応したモデルです。
なお、「モダリティ」とは情報の形式・種類を指し、複数のモダリティを扱うAIをマルチモーダルAIと呼びます。
LLMへの応用
マルチモーダルAIを大規模言語モデル(LLM)に応用することで、AIはテキストだけでなく、画像や音声などの多様な情報も理解し処理できるようになります。
わかりやすくいうと、スマートフォンのアシスタント機能が単に音声での質問に答えるだけでなく、ユーザーが送った写真を理解して、その内容について話してくれるようなものです。この技術は、医療・教育・エンターテイメントなど多岐にわたる分野での応用が期待されています。
実際にChatGPTでは、音声・画像・テキストを組み合わせてリアルタイムに会話できるインターフェースが提供されており、会議の議事録作成やプレゼン資料のレビューなどに活用され始めています。
なお、LLMについて詳しく知りたい方は、下記の記事を合わせてご確認ください。
生成AIとの違い・関係
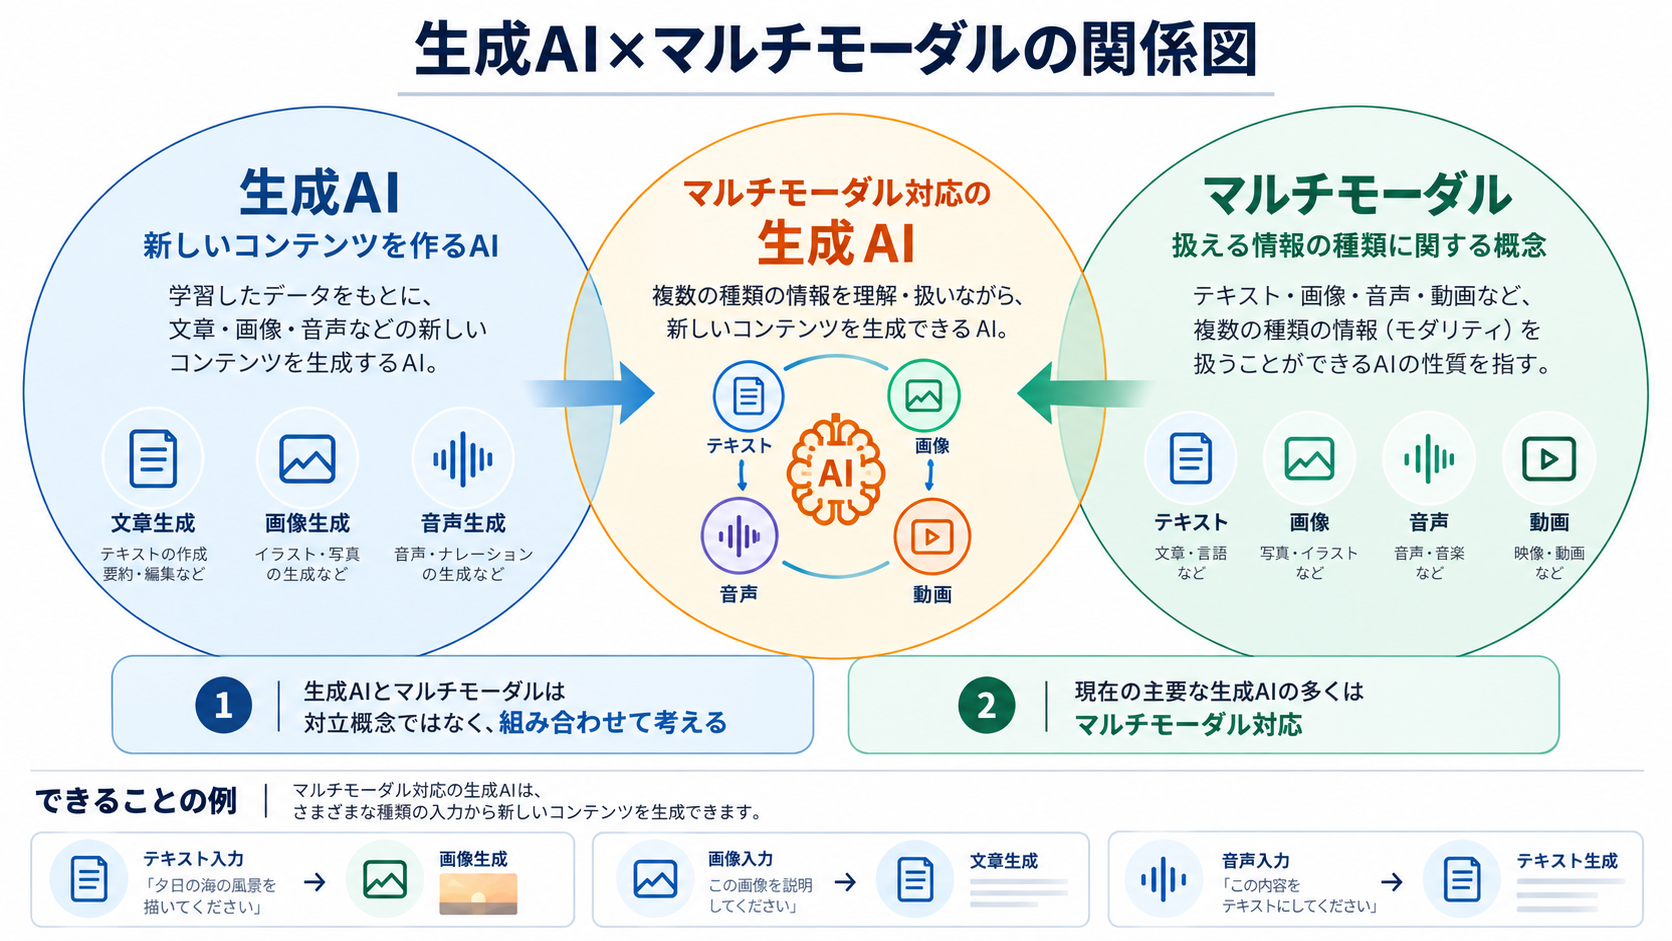
生成AIとマルチモーダルAIは、対立する概念ではありません。生成AIは、文章・画像・音声などの新しいコンテンツを生成するAIを指します。一方、マルチモーダルAIは、テキスト・画像・音声・動画など、複数種類の情報を扱えるかどうかを示す概念です。
2026年10月時点の主要な生成AIの多くは、複数のモダリティを扱えるようになっています。たとえば、文章で質問しながら画像を読み取ったり、音声で会話しつつ資料を分析したりできます。つまり、生成AIの中にマルチモーダル対応のモデルが増えていると理解するとわかりやすいでしょう。
マルチモーダルAIの仕組み
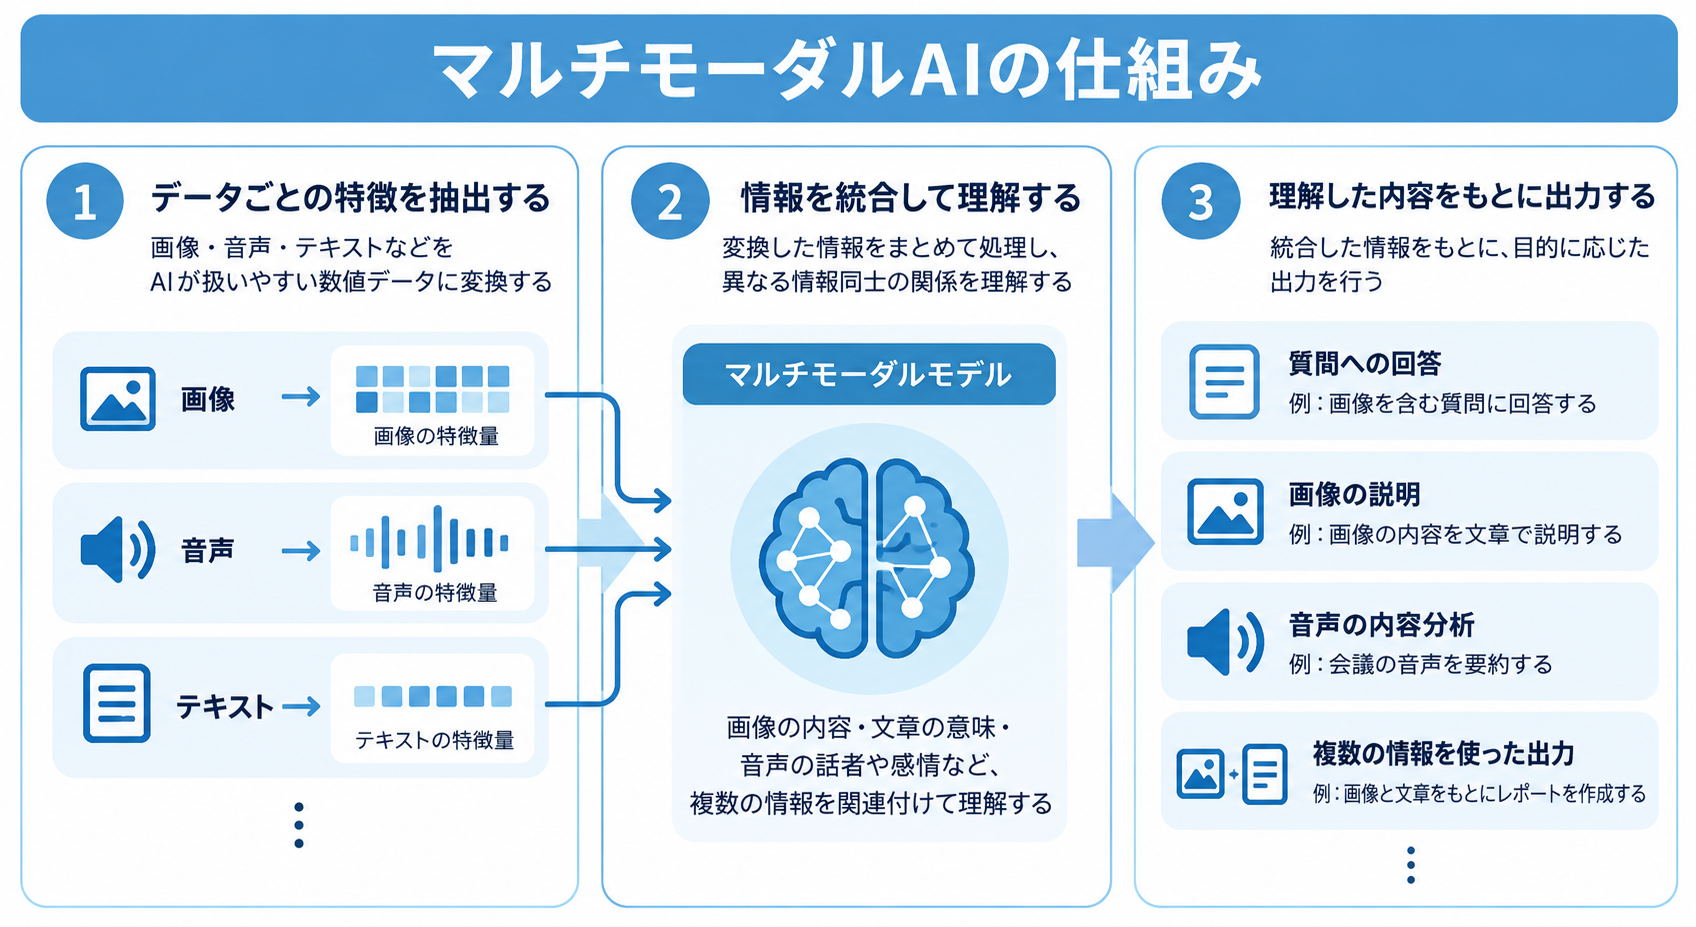
マルチモーダルAIは、画像・音声・テキストなど異なる種類の情報を、それぞれAIが扱いやすい数値データに変換するところから始まります。これがデータごとの特徴抽出です。
次に、変換した情報を統合し、「画像の内容」と「文章の意味」のように異なる情報同士の関係をまとめて理解します。最後に、統合した情報をもとに出力を行い、質問への回答や画像の説明、音声の内容分析などにつなげます。
つまり、「情報を読み取る→まとめて理解する→結果を返す」という3段階が基本的な仕組みです。
マルチモーダルAIとシングルモーダルAIの違い
マルチモーダルAIと対照的なのが、シングルモーダルAIです。マルチモーダルAIはテキスト・画像・音声など複数の入力モードを扱えるのに対し、シングルモーダルAIは一つのモードのみを扱います。
両者の違いは、以下の表のとおりです。
| AIの種類 | マルチモーダルAI | シングルモーダルAI |
|---|---|---|
| データの種類 | 複数のモードを組み合わせて処理できる(テキスト、画像、音声など) | 単一のモードのみを処理できる(テキストまたは画像など) |
| 処理能力 | 異なるモード間の関係を理解できる | 各モードを個別に処理する |
| 実用例 | 画像とテキストの関連性分析、動画解析など | テキスト分析、画像認識など |
マルチモーダルAIは複数の情報(モード)を組み合わせることで、より精度の高い出力を得られ、複雑な問題にも対応できます。
これは人間が視覚と聴覚を使って情報を得ている状態に該当します。一方、シングルモーダルAIは、テキスト分析や画像認識などを個別に処理することしかできません。
人間でいうと、視覚のみで状況を分析しようとしているのと同じですね。よって、比較的単純な業務にはシングルモーダルAI、高度で複雑な業務にはマルチモーダルAIが適しています。
マルチモーダルAIの歴史
マルチモーダルAIの研究は、音声・画像・言語など複数の情報を組み合わせて処理する試みとして、1980年代以前から進められてきました。1980〜1990年代には、音声と映像を組み合わせた認識などが研究され、現在のマルチモーダルAIにつながる基礎が築かれています。
2011年には、スタンフォード大学の研究チームが、ディープラーニングを用いて音声と映像から共通する特徴を学習する「Multimodal Deep Learning」を発表しました。複数の情報をAIがまとめて学習する研究が本格化し、その後の画像認識や音声処理などの発展につながっています。
2013年には「Expressive Visual Text-to-Speech」の研究が発表され、入力したテキストから表情を伴う人物映像を生成する仕組みが示されました。テキスト・音声・映像を組み合わせた表現の研究が進み、マルチモーダル技術の応用範囲も広がっています。※1
その後は、画像に関する質問へ回答するAIや、画像・音声・文章を組み合わせて理解するモデルが登場し、研究と実用化が加速しました。
こうした技術の進化により、2026年10月時点では製造・医療・自動運転だけでなく、動画解析・リアルタイム音声対話・コールセンター支援など幅広い業務でマルチモーダルAIの活用が進んでいます。
代表的な最新モデルは、OpenAIの「GPT-6.1 Sol」やGoogleの「Gemini 4 Argon」などです。対応する情報の種類はモデルによって異なりますが、テキストと画像を組み合わせた理解をはじめ、音声や動画まで扱えるモデルも登場しています。複数種類の情報を関連付けて処理できることで、従来は別々の仕組みが必要だった業務をまとめて行いやすくなっています。
マルチモーダルAIにできること
マルチモーダルAIは、テキスト・画像・音声・動画といった異なる種類の情報を組み合わせることで、さまざまな業務を可能にします。情報の組み合わせごとにできることを紹介いたします。
テキスト⇄画像or音声or動画
テキストから画像への変換、画像からテキストへの分析、テキストと画像の同時入力からの分析指示など、幅広い処理が可能です。まさかと思うかもしれませんが、マルチモーダルAIの代表格ともいえる「GPT-4」は、問題文と図を参照する物理の問題を解けることが報告されています。※2
さらに、音声とテキスト間では音声をテキストに、テキストを音声に変換でき、言語間の翻訳でもその能力が注目されています。
日本語の音声を英語のテキストに変換したり、逆に日本語のテキストを中国語の音声に変換したりできるため、海外の方との円滑なコミュニケーションが期待できるでしょう。
また、テキストと動画間では、テキストから動画を生成したり、動画の内容をテキストで解析したりできます。動画の解析は、防犯対策や危険察知などに役立つ技術として注目されています。
画像⇄音声or動画
画像と音声間では、写真やカメラの映像を見せながら音声で質問し、AIが画像の内容を音声で答えるといった使い方が可能です。この機能はすでにChatGPTに実装されており、目の前の物や資料について話しながら確認できるのです。※3
一方、画像・動画間においては、静止画から短時間の動画を生成できます。外観の一貫性を保ちながら動きを加えられるため、広告やSNS用動画などへの活用が進んでいます。※4
音声⇄動画
音声・動画間では、音声と動画を統合して解析できるため、より複雑な状況や行動を認識できます。
たとえば、監視カメラにマルチモーダルAIを搭載すれば、音声と動画の両方の情報を読み取ることができます。※5
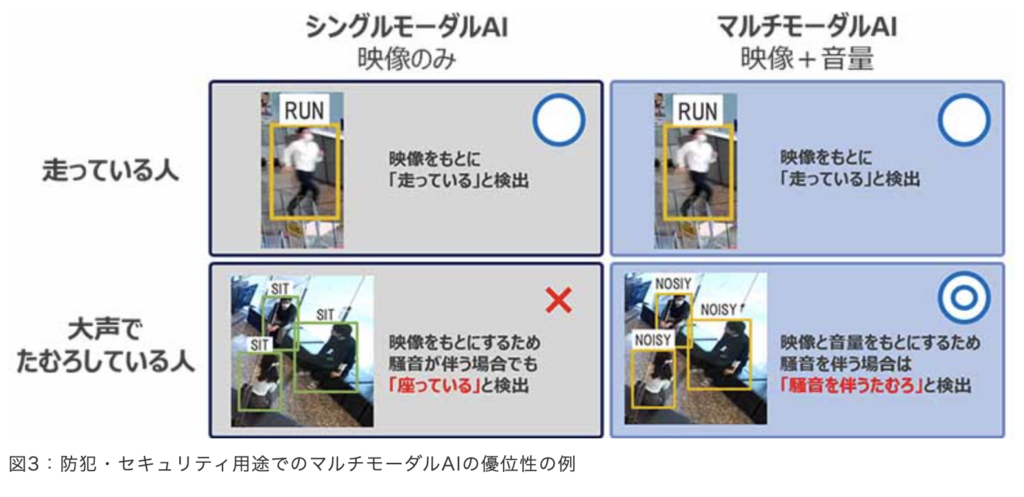
従来のカメラでは、複数人が建物内でたむろしていても特に問題は検出されませんでした。しかし、動画と音声情報を認識できるマルチモーダルAIなら、音声から「大声で会話している」という状況を認識して、トラブルの防止策を実行できるようになります。
なお、画像・音声入力に対応したGPTについて詳しく知りたい方は、下記の記事を合わせてご確認ください。
代表的なマルチモーダルAI
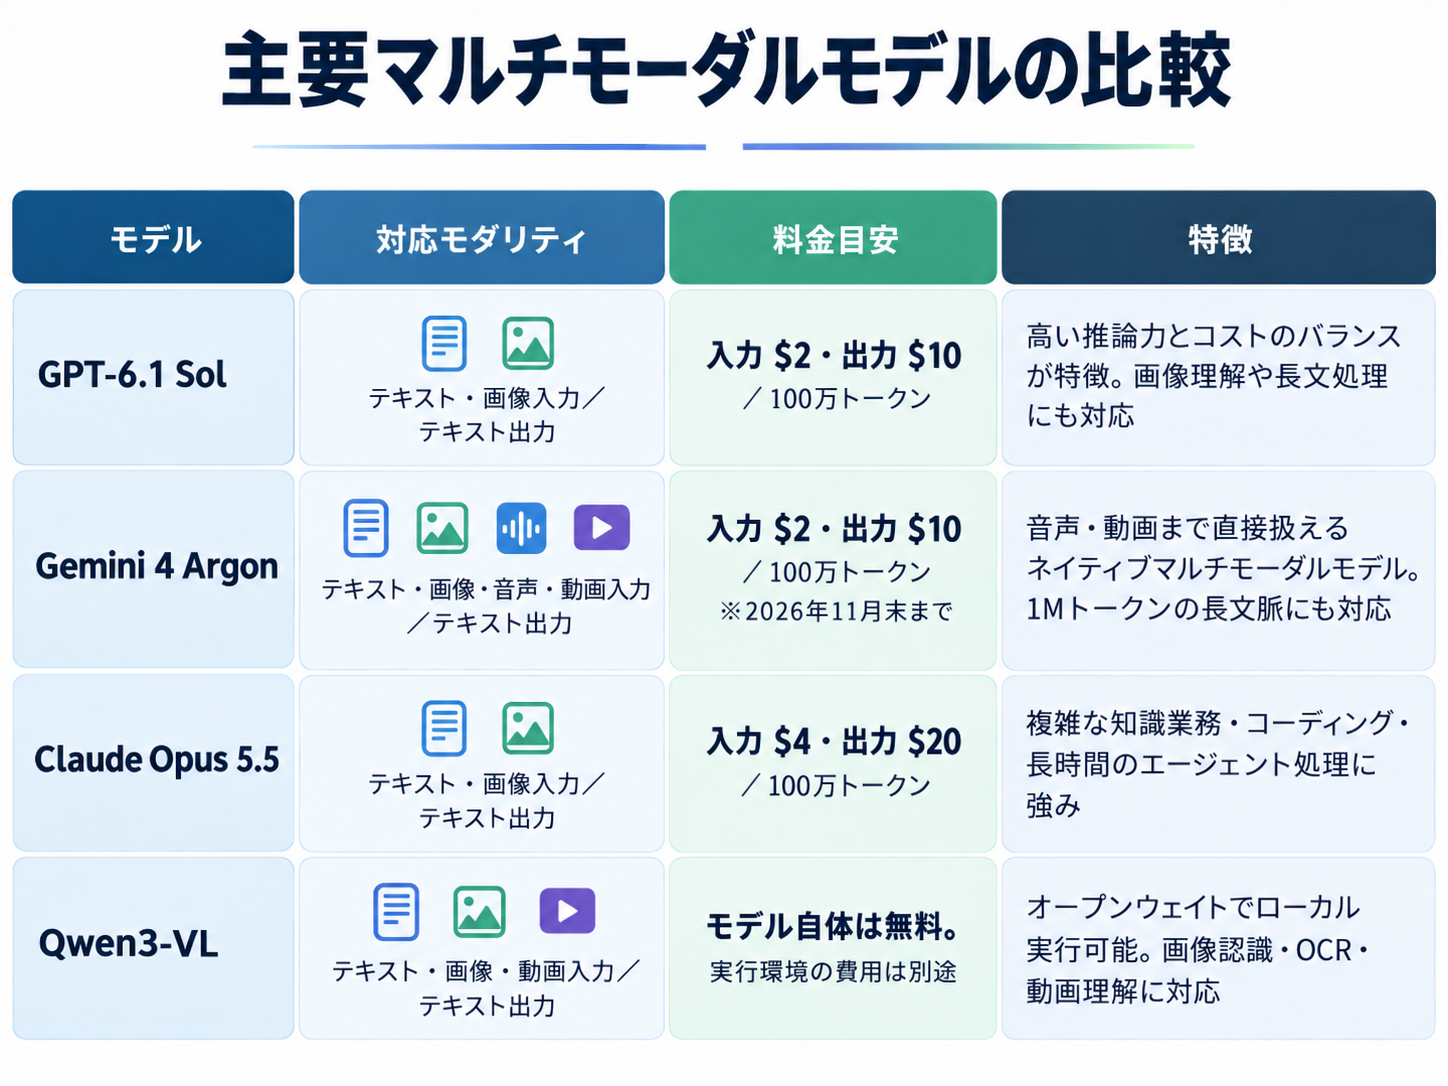
世の中には、すでにマルチモーダルAIを活用したサービスが多数登場しています。ここでは、代表的なマルチモーダルAIをご紹介するので、導入を検討してみてください。
ChatGPT【GPT-6】
ChatGPTは、OpenAIが提供する生成AIサービスです。2026年10月時点では、対象プランでGPT-6系モデルを利用できます。
テキストによる対話だけでなく、画像の読み取り・画像生成・音声会話・ファイル解析などに対応している点が特徴です。画像をアップロードして内容を質問したり、PDFや表計算ファイルを読み込ませて要約・分析したりできます。
| 機能 | 概要 |
|---|---|
| 画像入力 | 写真・スクリーンショット・図表などを読み取り、内容の説明や分析が可能 |
| 画像生成・編集 | ChatGPT Images 2.5を使い、文章からの画像生成や既存画像の編集に対応 |
| 音声会話 | GPT-Live-1.1を利用したリアルタイムの音声対話に対応 |
| ファイル解析 | PDF・表計算・プレゼン・音声ファイルなどを読み込み、要約やデータ分析が可能 |
また、画像生成・編集やリアルタイムの音声会話も利用でき、複数形式の情報を扱える代表的なマルチモーダルAIとして幅広い業務に活用できます。
Google Gemini
Google Geminiは、Googleが提供するマルチモーダル生成AIです。旧称「Bard」は2024年2月に「Gemini」へ名称変更されました。
2026年10月時点では、テキスト・画像に加えて、音声や動画ファイルもアップロードして内容を分析できます。動画は映像の内容について質問したり、音声は要約・分析したりできます。
さらにGemini Liveでは、音声で自然に会話しながらスマートフォンのカメラ映像や画面を共有し、その場で見えている内容について質問できるのが特徴です。Googleの現行Live系モデルでは「Gemini 3.8 Live」がリアルタイム音声対話向けモデルとして提供されています。
なお、Geminiの使い方について詳しく知りたい方は、下記の記事を合わせてご確認ください。
ローカルで動くマルチモーダルAI
マルチモーダルAIの中には、クラウドサービスだけでなく、PCや社内サーバーなどのローカル環境で動かせるモデルもあります。代表例のQwen3-VLは、テキストと画像を組み合わせた理解や分析に対応しています。
ローカル環境で利用すれば、機密性の高い画像や文書を外部サービスへ送信せずに処理しやすい点がメリットです。一方で、モデルの規模によっては高性能なGPUや十分なメモリが必要になるため、導入前に動作環境や運用コストを確認しましょう。
Runway Gen-4.5
Runway Gen-4.5は、Runwayが提供する動画生成AIモデルです。2026年10月時点では、テキストから動画を生成する「Text to Video」と、画像から動画を生成する「Image to Video」に対応しています。
複雑な指示への追従や映像内の動き、視覚的な一貫性などが強化されており、文章や静止画から動画を作成できます。広告動画やSNS素材、映像制作など、動画を扱うマルチモーダルAIの代表例として活用できるモデルです。
Copilot(旧BingAI)
Microsoft Copilotは、Microsoftが提供するAIアシスタントです。無料版では、AIチャットやWeb検索、画像生成に加え、画像・PDF・Officeファイルなどをアップロードして内容を分析できます。
有料のMicrosoft 365では、Word・Excel・PowerPoint・Outlookなどと連携でき、利用上限も高くなります。法人向けでは、メールやファイルなどの業務データを参照した回答に対応している点も特徴です。
なお、Copilot(旧BingAI)について詳しく知りたい方は、下記の記事を合わせてご確認ください。
Copilotを無料で試したい方は、以下の記事もご覧ください。
業務で多いマルチモーダルAIの活用シーン
マルチモーダルAIは、テキストだけでなく画像・音声・PDFなども扱えるため、これまで人手で行っていた確認や転記、整理作業の効率化に活用できます。特に、複数形式のデータをまたいで処理する業務では効果を発揮しやすいでしょう。ここでは、代表的な活用シーンを紹介します。
図面から数量を拾い、積算する
建設・製造などの現場では、図面を画像やPDFとして読み込ませ、部材や設備の種類、数量を抽出する用途があります。人が目視で数えていた作業をAIで補助することで、積算前の数量確認や集計にかかる時間を短縮しやすい点がメリットです。
複数ページの図面を横断して確認したい場面にも向いています。ただし、図面の形式や記号、画質によって認識精度は変わるため、最終的な数量や金額は人が確認する運用が必要です。
見積書・帳票を自社フォーマットへ転記する
取引先ごとに形式が異なる見積書や請求書、帳票を読み取り、自社の指定フォーマットへ必要項目を整理して転記する使い方もあります。画像やPDFから金額・品名・日付・取引先名などを抽出し、表形式にまとめれば、手入力や確認作業の負担を減らしやすくなります。
帳票処理が多い経理・営業部門などでは、定型業務の効率化に役立つでしょう。ただし、転記後の数値や項目は原本と照合する必要があります。
通話音声を文字起こししてデータベース化する
会議や商談、問い合わせ対応などの音声を文字起こしし、要点を整理して社内データベースへ蓄積する用途もあります。発言内容をテキスト化するだけでなく、要約や分類まで組み合わせれば、必要な情報を後から検索・再利用しやすくなる点がメリットです。
営業記録や顧客対応履歴の整理にも活用できます。個人情報や機密情報を含む音声を扱う場合は、保存先やアクセス権限などの管理も確認しておきましょう。
写真から看板・設備などの情報を判別する
現場写真や設備写真をAIに読み込ませ、看板の文字や機器の種類、状態などを判別する使い方もあります。画像から必要な情報を抽出して記録へ反映すれば、点検や報告作業の効率化につながります。
製造・建設・小売など、写真を使った確認作業が多い現場で活用しやすい方法です。ただし、撮影角度や明るさ、解像度によって認識結果が変わるため、重要な判断は人による確認も組み合わせましょう。
画像やPDFから文字情報を読み取る技術について詳しく知りたい方は、生成AIを活用したOCRについて解説した以下の記事もあわせてご覧ください。
マルチモーダルAIの活用事例
マルチモーダルAIは、医療・製造・介護・教育など幅広い分野ですでに活用されています。ここでは、実際の事例を8つ紹介いたします。
マルチモーダルAIと医療ビッグデータの活用
日本電気株式会社(NEC)と理化学研究所、日本医科大学は、医療分野での電子カルテとAIの融合の研究を進めていて、さまざまな医療ビッグデータを統合的に解析するマルチモーダルAIを構築しました。
前立腺がんを対象としたもので、病気の早期発見や治療計画の最適化を可能としました。また、医療費の削減や医療従事者の負荷の軽減が期待されています。
このAIシステムでは、複数種類の検査データから病気の状態や経過を多角的に判断・予測が可能です。
電子カルテのデータや、がんの組織画像などを用いてマルチモーダルAIが解析したところ、手術後から再発までの年数によりAIが捉えた予測因子のパターンに違いが見られており、さらなる研究が進められています。※6
材料データからさまざまな機能を予測
産業技術総合研究所(産総研)、日本ゼオン株式会社などが共同で、AIを用いて複雑な構造を持つ材料データより、高精度で複合材料の機能を予測できる技術を開発しました。このマルチモーダルAI技術は、様々な配合を持つ複雑材料系でのマテリアルズ・インフォマティクスに対して非常に有効なツールとなります。
画像データや分光スペクトルなどの異なる複数のデータを計測し統合することにより、複雑な材料系でも異なる特性を高精度で予測することが可能となりました。膨大な条件から選定・成形加工・評価といった材料開発プロセスの大幅な高度化・効率化が可能となりました。※7
自動車の自動運転
自動車の自動運転技術は、複数の情報を処理する「マルチモーダルAI」の特徴的な事例です。中央線をはみ出したら、自動的に戻す技術などは、この技術の最たるものといえるでしょう。車両には複数のカメラのほか、車両や人物の速度を検知するミリ波センサーや加速度センサー・GPS・踏切などの音を聞き取るマイクが搭載されています。これらの情報を組み合わせて状況を判断し、処理を行う仕組みです。
例えばTuring株式会社は、『We Overtake Tesla』をミッションに掲げ、完全自動運転の実現を目指して開発を進めています。※8
産業用ロボットへの活用
マルチモーダルAIの産業用ロボットへの応用は、画像・角度・速度・力覚などの複数の情報を組み合わせて判断することで、ロボットアームによる繊細な作業ができます。デンソーウェーブによって開発されたマルチモーダルAIロボットは、多指ハンドを装着した双腕型ロボットアームをディープラーニングでリアルタイム制御し、不定形物を扱う作業が可能です。
さらに、デンソーウェーブが開発した「AI模倣学習」システムは、人の動作を模倣して学習する技術で、産業用ロボットによるサラダの盛り付けやタオルたたみなどの動作を可能にしています。※9
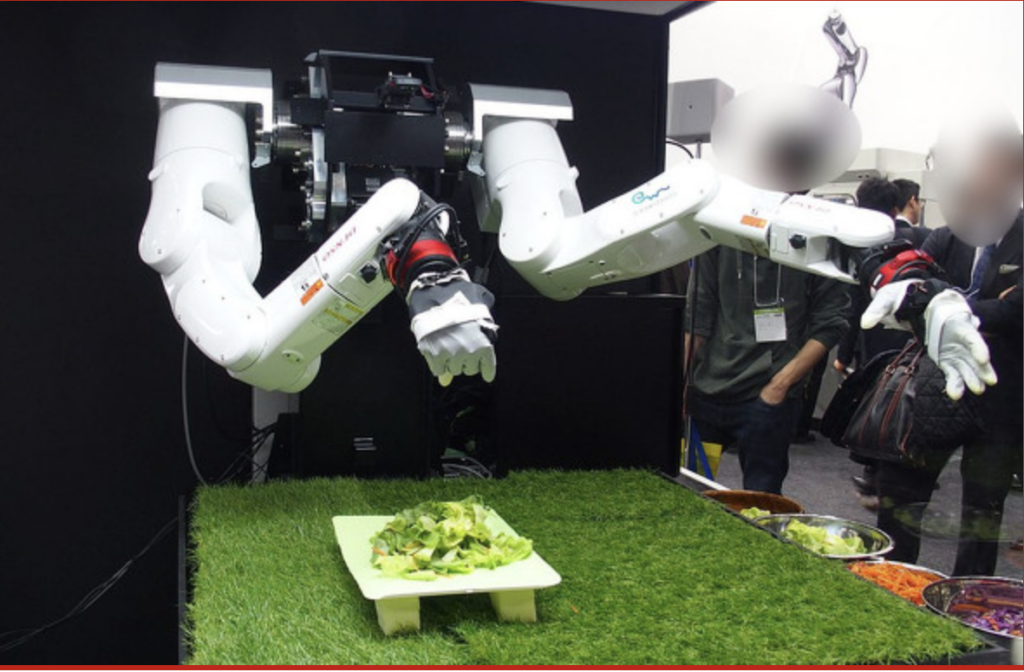
マルチモーダルAIを活用した産業用ロボットは、工場内の作業だけでなく、医薬・医療・農業・物流などさまざまな分野での活躍が期待されています。
ホームロボットへの活用
介護支援ロボット「RoBoHoN」は、従来の対話型AIに加え、マルチモーダルAIシステム「MICSUS」を搭載しています。このシステムは、言語だけでなく身振り手振りなどの非言語コミュニケーションも組み合わせて理解する、マルチモーダル対話処理技術を用いています。※10
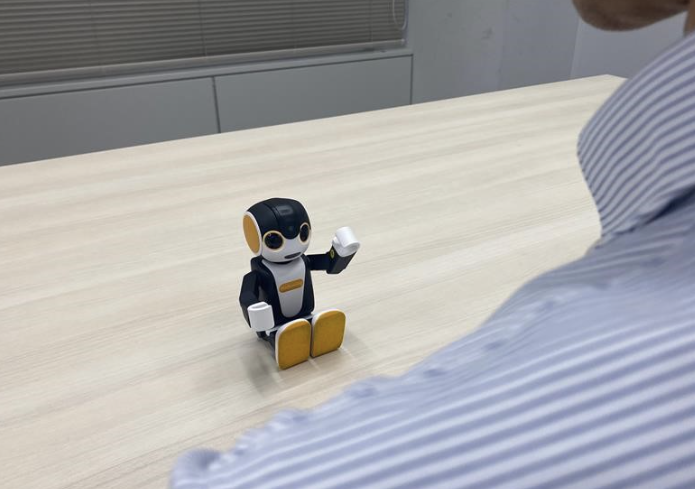
実証実験では、「RoBoHoN」を使って高齢者の健康状態や生活状況の変化に関する情報を収集し、ケアマネジャーや家族とのコミュニケーションを支援しました。
また、高齢者がロボットに話しかけることでいつでも雑談ができ、高齢者の関心事などの情報もケアマネジャーや家族へ共有されるようになっています。
防犯カメラへの活用
防犯カメラの映像解析AIは、映像のみで解析されていることが一般的です。これは人間に例えると視覚情報のみで迷惑行為などを検出しているといえます。ここにマルチモーダルを導入することで、映像に加えて音の情報を分析が可能です。※5
映像だけでは曖昧な状況が、音声データが加わることで危険性が高い状況なのか判断できるようになるでしょう。
スポーツへの活用
愛知県立大学の情報科学部によると、ロボカップサッカーの標準プラットフォームリーグにおいて、MLLMを用いて自動で試合の実況・解説をするシステムの実験が行われました。生成された実況・解説文章に対して、面白さ・明瞭さ・適切さの観点からアンケートを行ったところ、どの項目においても肯定的な結果が半数以上得られたそうです。※11
将来的に実況がAIによって行われるようになる可能性があるといえるでしょう。
【実践検証】ChatGPT・Gemini・Claudeでマルチモーダル機能を試してみた
ここでは、ChatGPT・Gemini・Claudeに同じ素材を入力し、マルチモーダル機能を比較します。検証には、手書きメモの写真、表を含む帳票画像、30秒程度の動画を使用しました。
各AIにはできるだけ同じプロンプトを入力し、読み取りの正確さ・誤読した箇所・無料プランでの制限を確認します。なお、検証素材には実際の機密情報や個人情報を使用していません。
手書きメモの写真を読み取れるか検証
まず、日時・金額・人名などを含む手書きメモの写真を、ChatGPT・Gemini・Claudeに読み込ませました。3つのAIには「推測で補完せず、読み取れない箇所は判読不能と記載する」という同じ指示を入力しています。
クリックで表示
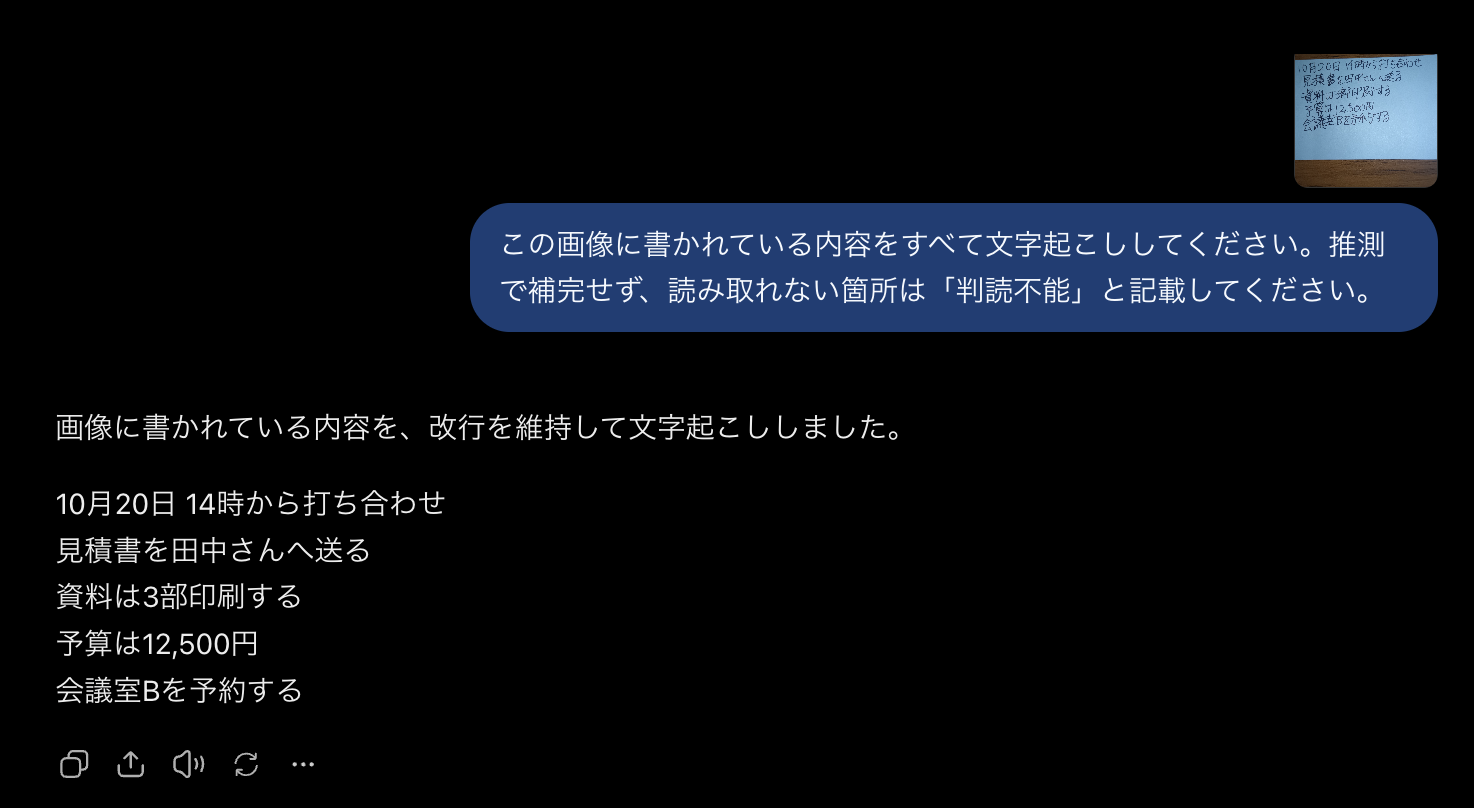
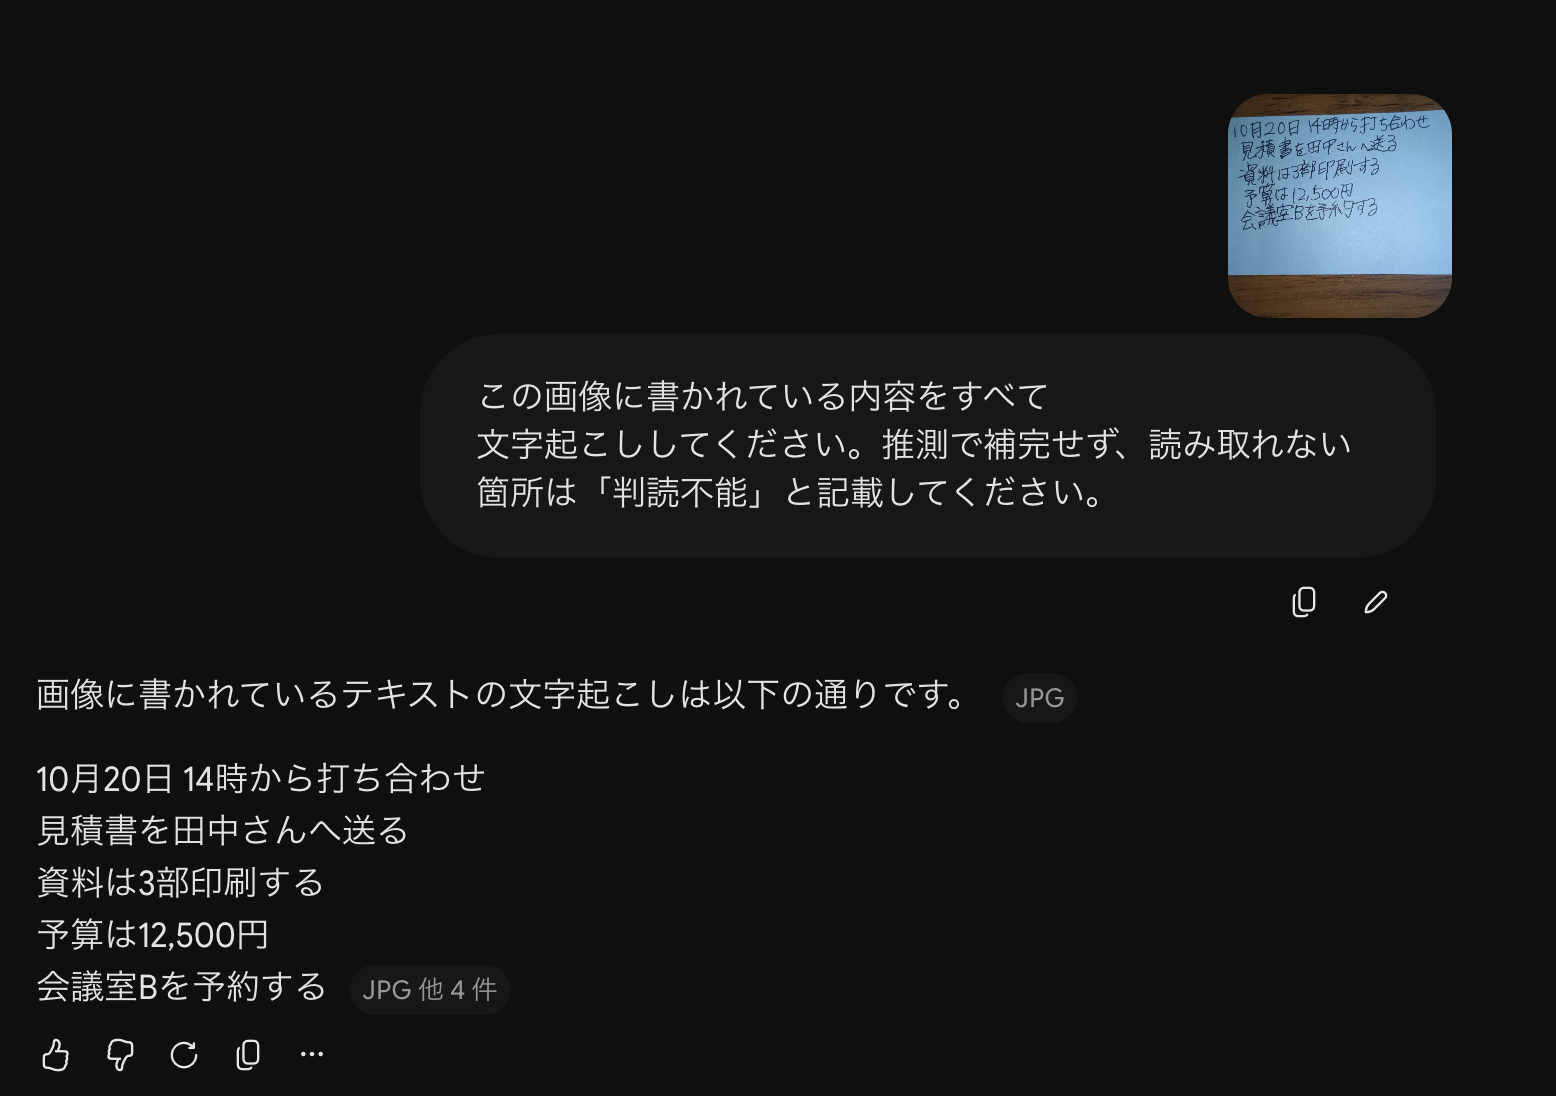
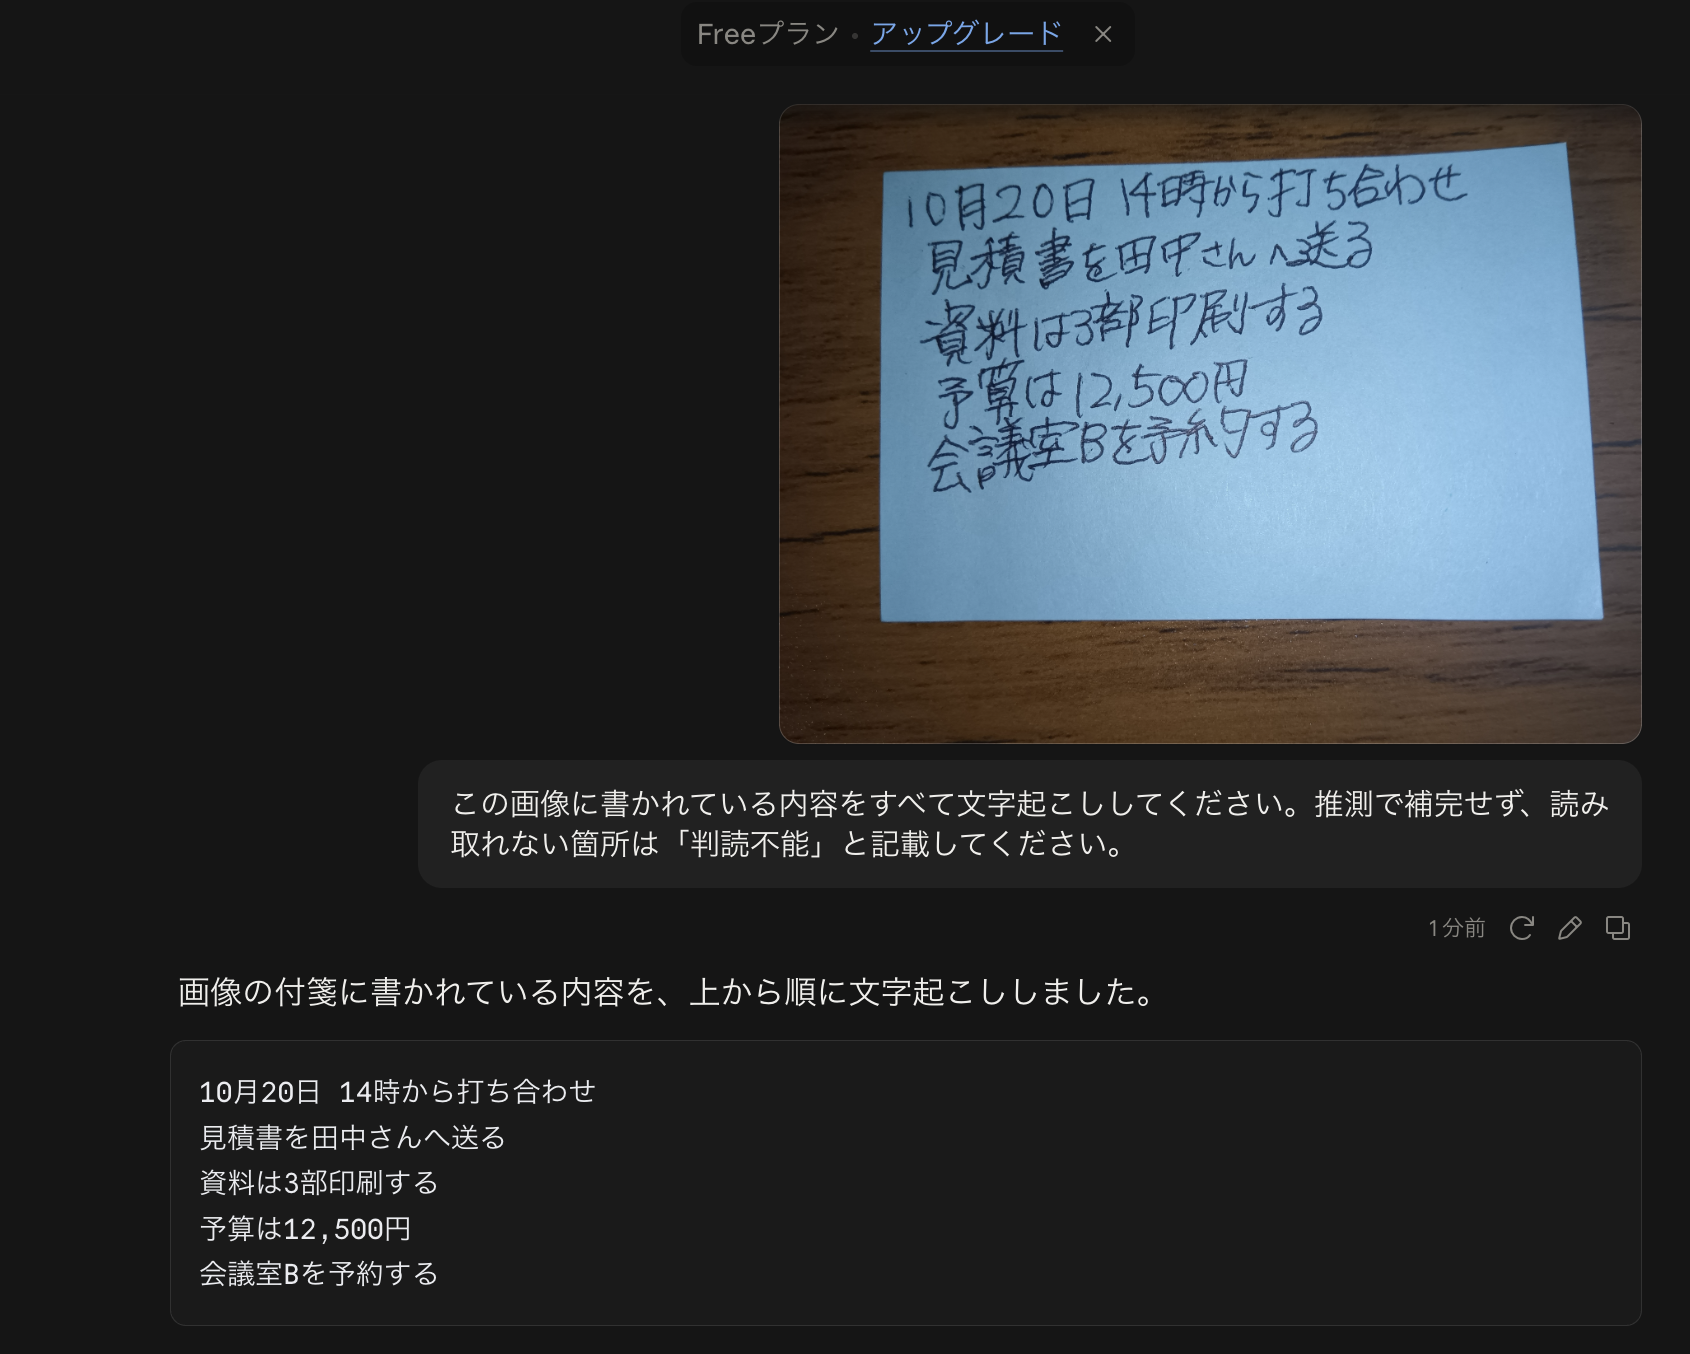
検証したところ、3つとも5行すべてを正確に文字起こしでき、誤読はありませんでした。今回使用した手書きメモでは、3つのAIとも正確に認識できました。
| AI | 判定 | 誤読した箇所 |
|---|---|---|
| ChatGPT | ○ | なし |
| Gemini | ○ | なし |
| Claude | ○ | なし |
※○=主要情報を正確に読み取れた、△=一部に誤読・抜けあり、×=大きな誤読または入力不可
表入りの帳票画像を読み取れるか検証
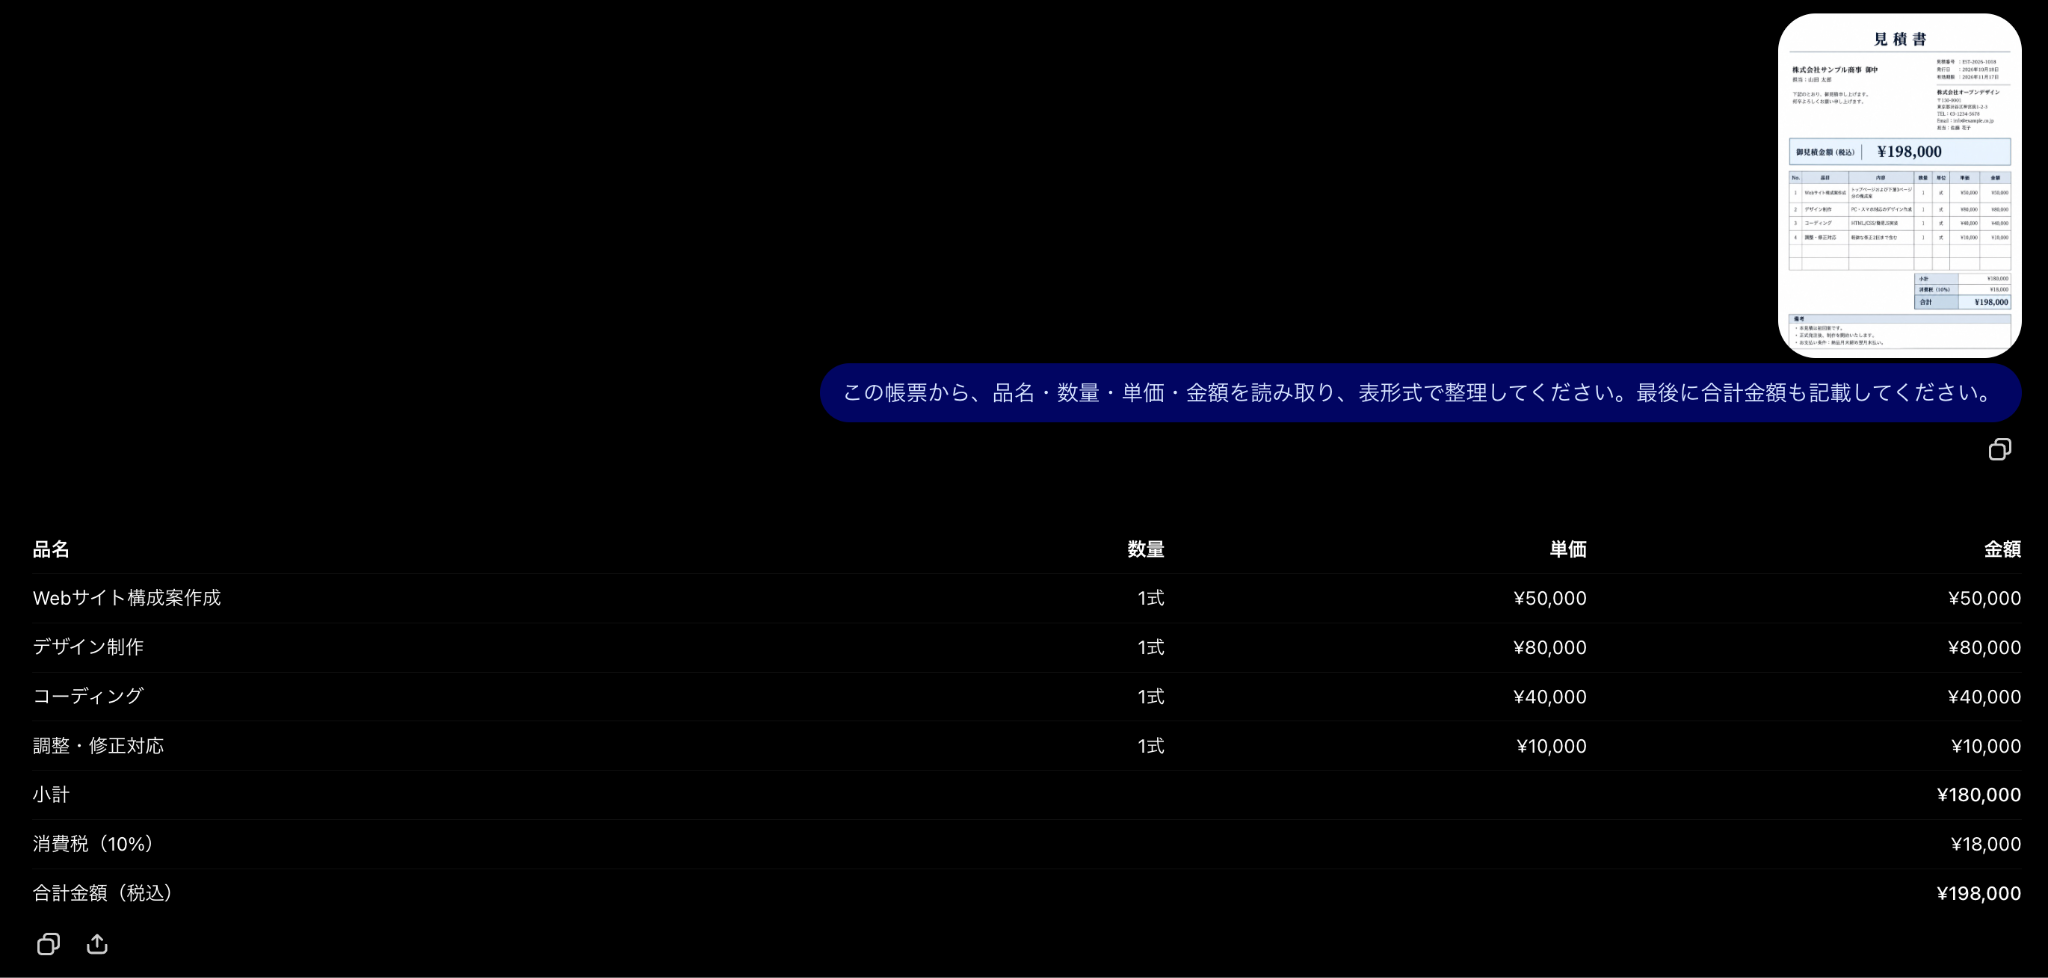
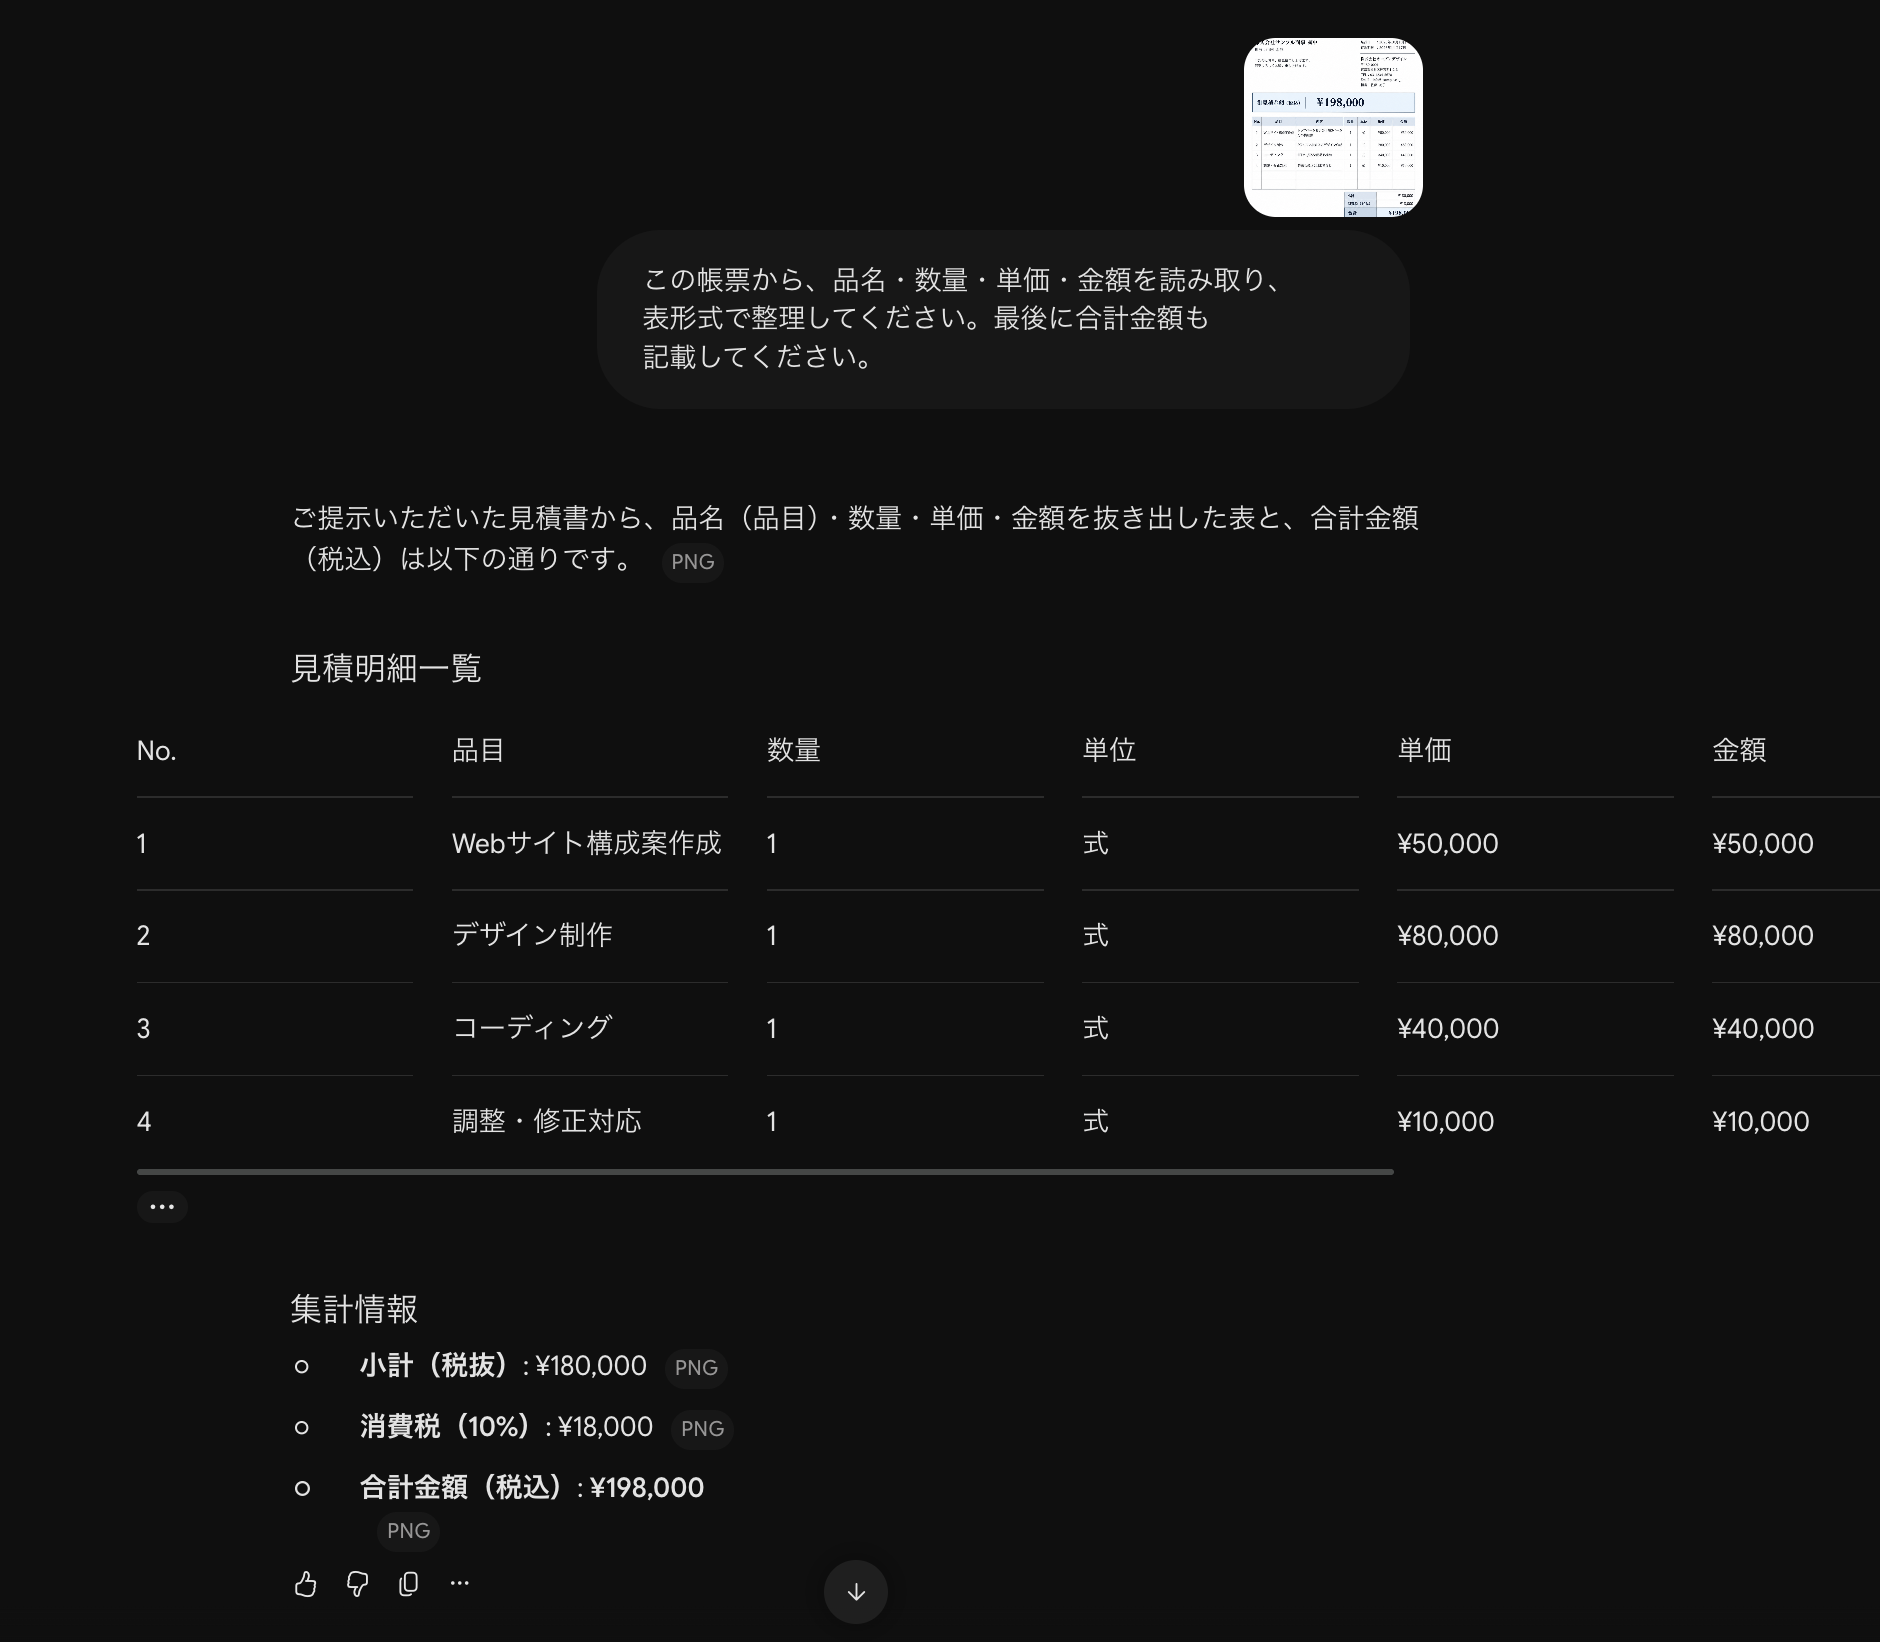
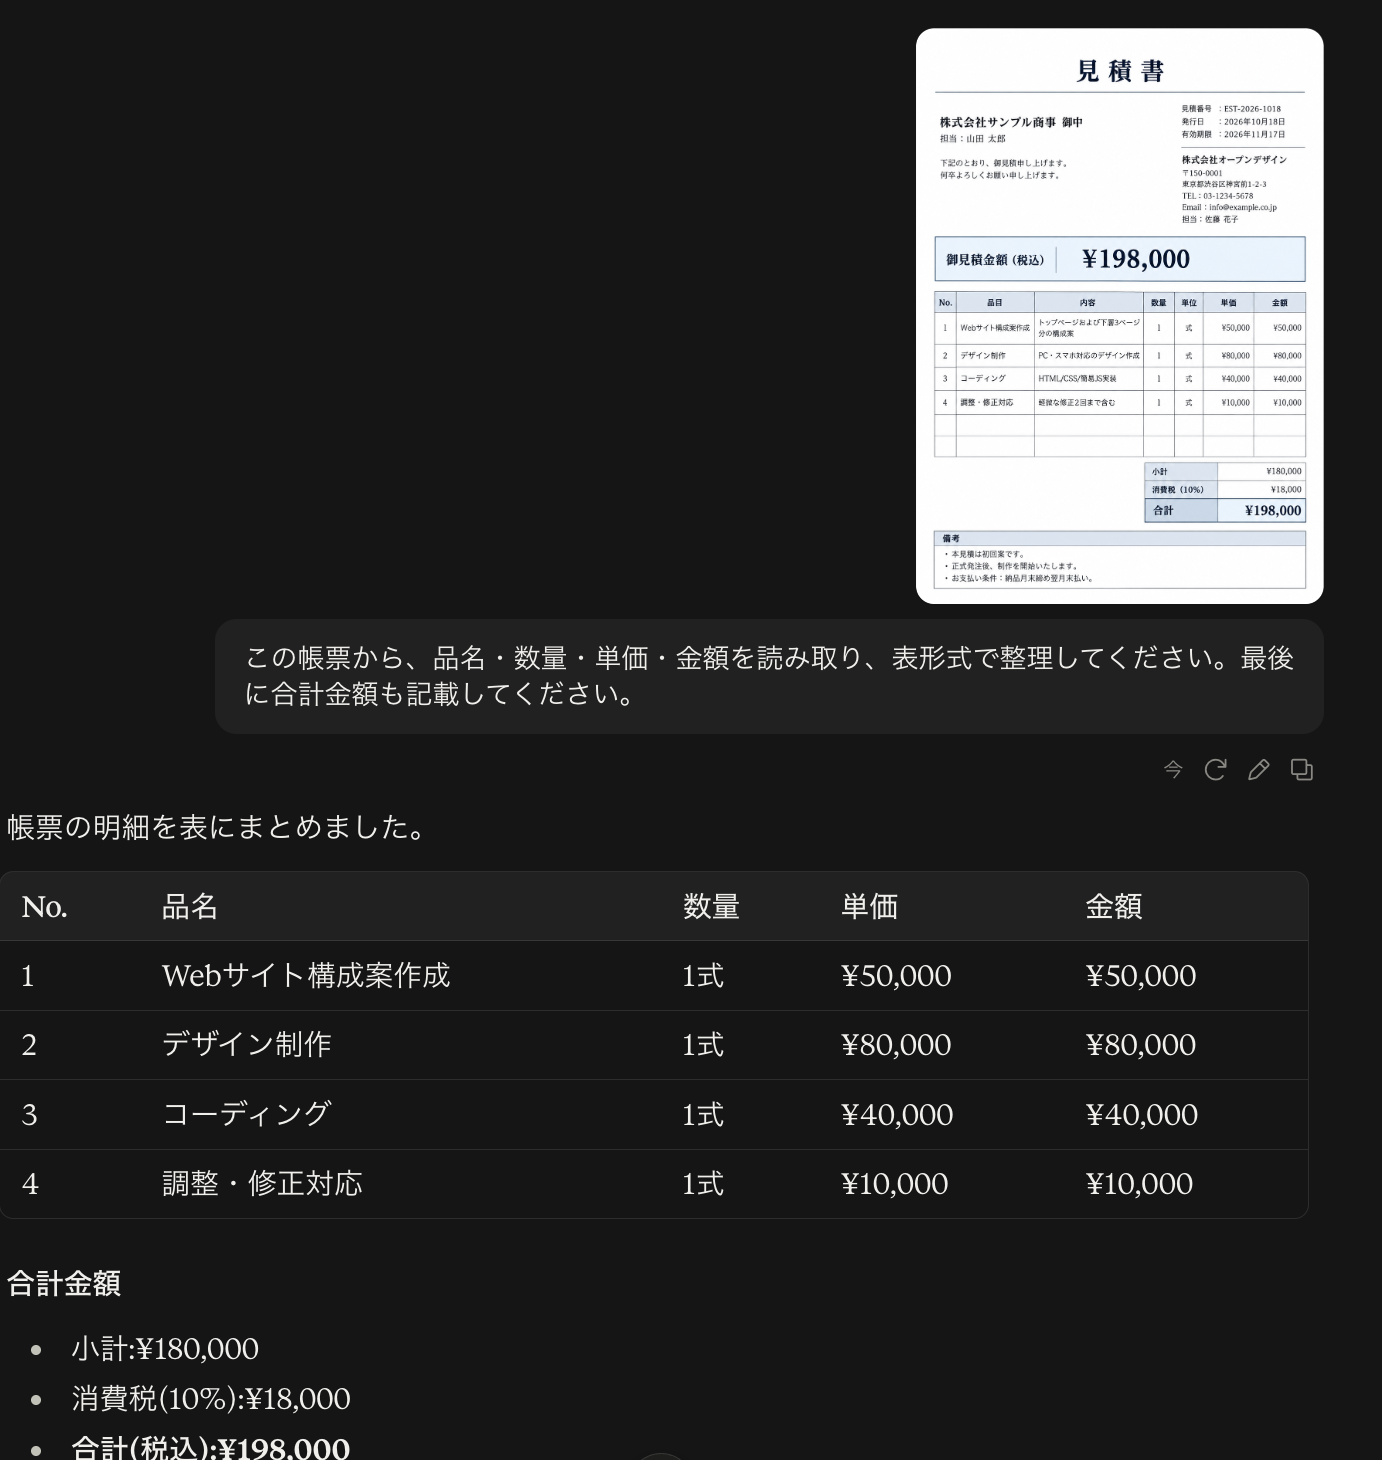
次に、品名・数量・単価・金額を記載した架空の見積書を、ChatGPT・Gemini・Claudeに読み込ませました。3つのAIには「各項目を読み取り、表形式で整理し、最後に合計金額も記載する」という同じ指示を入力しています。
検証したところ、3つとも4項目の品名・数量・単価・金額を正確に読み取れました。また、小計18万円・消費税1万8,000円・税込合計19万8,000円も正しく認識でき、今回の帳票では誤読は確認できませんでした。
クリックで表示
| AI | 判定 | 誤読した箇所 |
|---|---|---|
| ChatGPT | ○ | なし |
| Gemini | ○ | なし |
| Claude | ○ | なし |
30秒程度の動画を読み取れるか検証
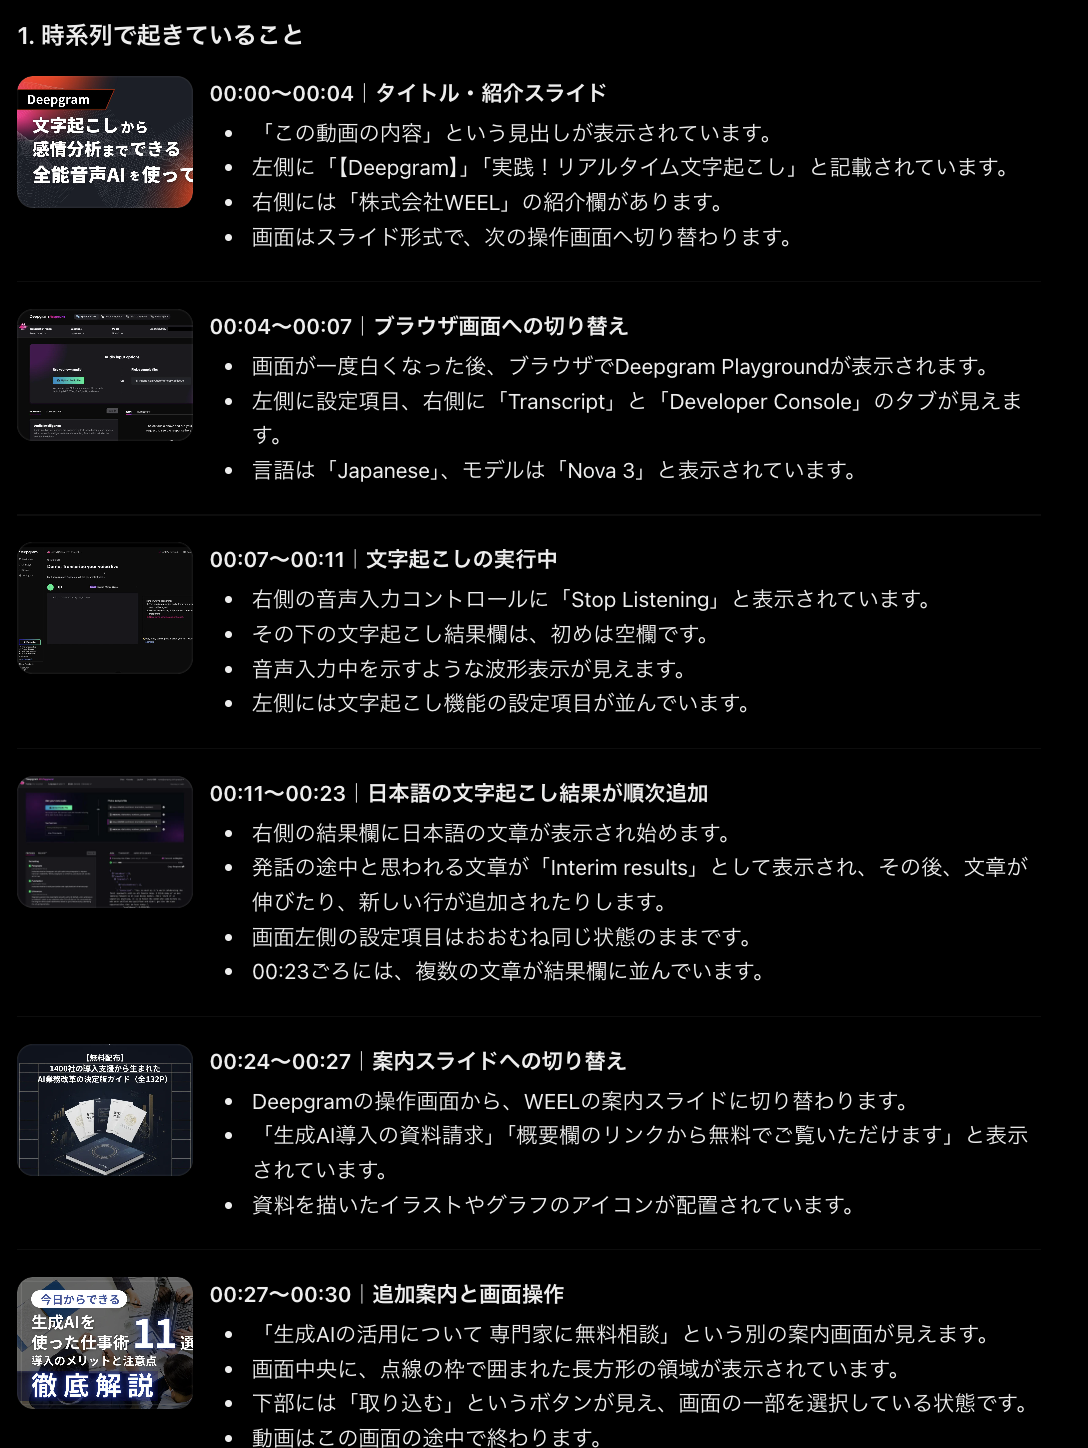
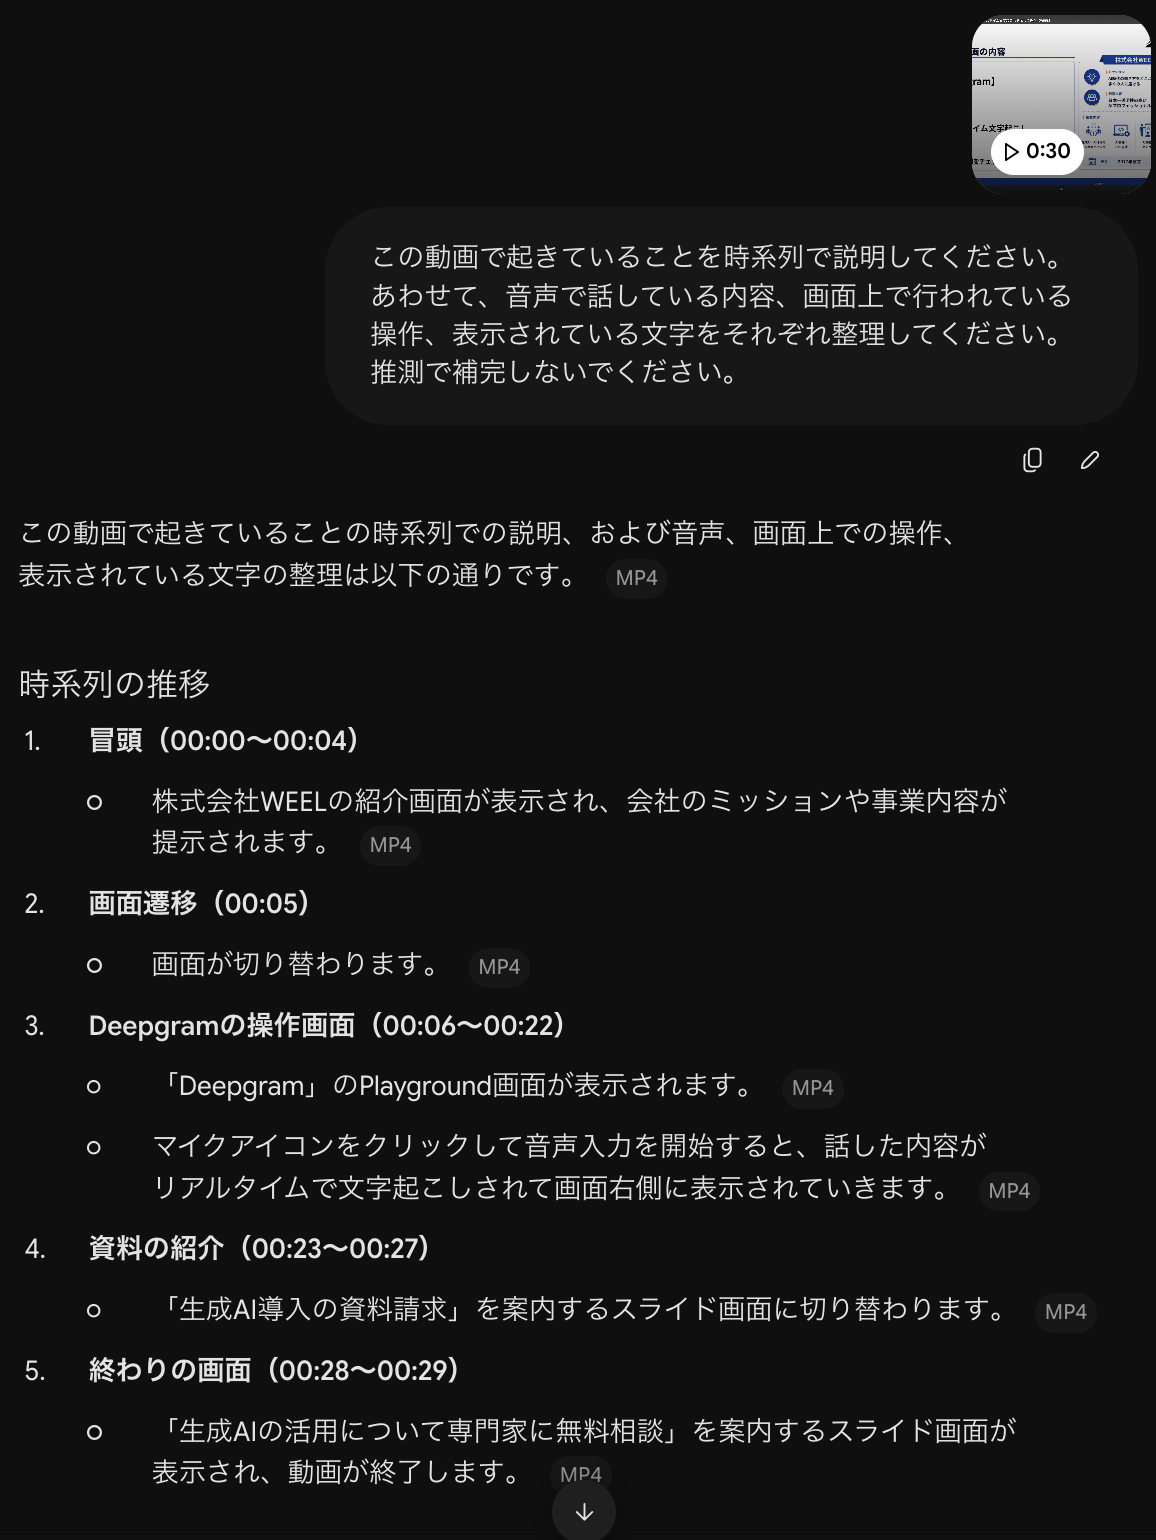
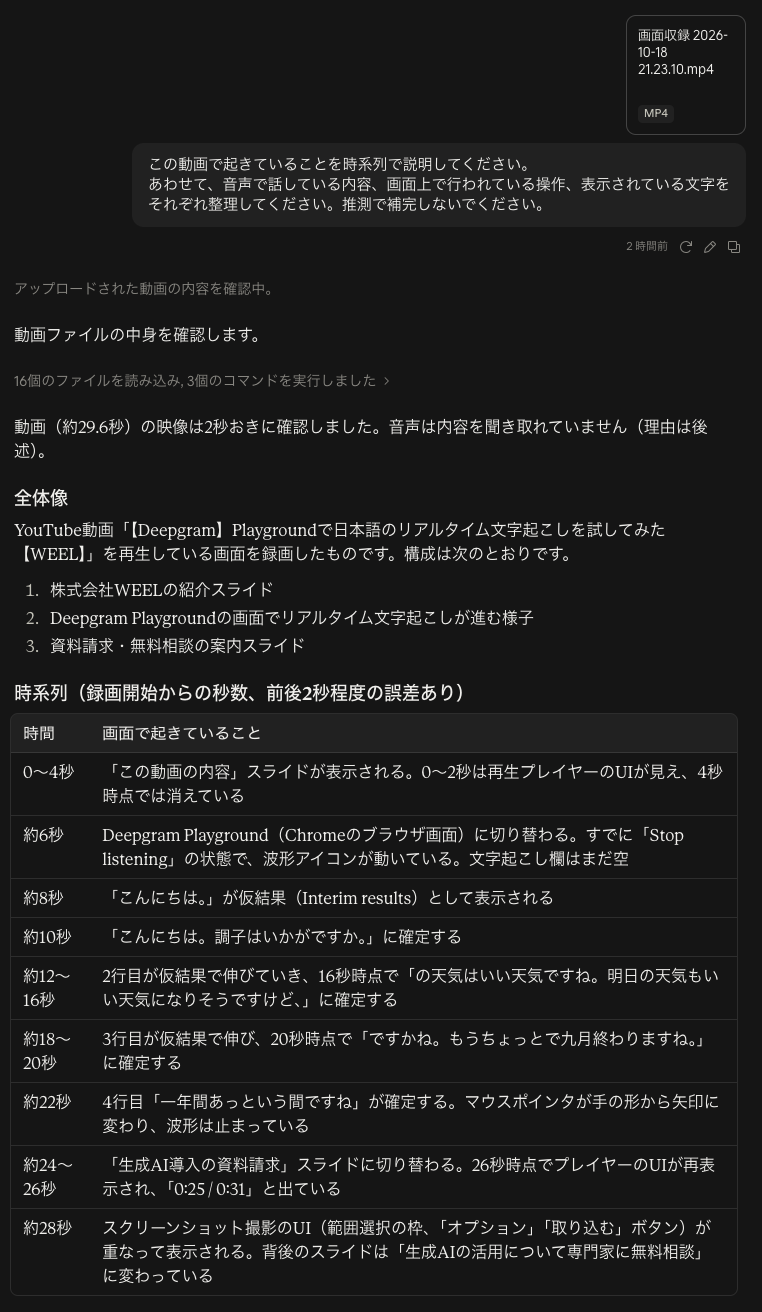
最後に、WEEL公式YouTube動画「Deepgram Playgroundで日本語のリアルタイム文字起こしを試してみた」の約30秒間を画面録画し、同じMP4ファイルを3つのAIに入力しました。映像の流れに加えて、音声・画面上の操作・表示されている文字をそれぞれ整理するよう指示しています。
Geminiは、映像の流れや画面内の文字に加え、発話内容まで認識できました。一方、Claudeは映像を細かく解析できたものの、音声については聞き取れないと回答しています。
ChatGPTも映像や文字を詳しく読み取れましたが、音声は独立して確認できず、画面上の文字起こしに「9月始まりますね」という誤読がありました。
クリックで表示
| AI | 判定 | 誤読・気になった箇所 |
|---|---|---|
| ChatGPT | △ | 音声を独立して確認できず、「9月終わりますね」を「9月始まりますね」と誤読 |
| Gemini | ○ | 発話内容まで認識。ただし、画面上で確認しにくい「マイクアイコンをクリック」という操作を補完 |
| Claude | △ | 映像・画面内文字は認識できたが、音声内容は確認できず |
※○=主要情報を正確に読み取れた、△=一部に誤読・抜けあり、×=大きな誤読または入力不可
ChatGPT・Gemini・Claudeの検証結果を比較
今回の検証では、手書きメモと帳票画像は3つのAIすべてが正確に読み取れました。一方、約30秒の動画では違いが見られ、今回の条件ではGeminiのみ○判定となっています。
| 検証項目 | ChatGPT | Gemini | Claude |
|---|---|---|---|
| 手書きメモ | ○ | ○ | ○ |
| 帳票画像 | ○ | ○ | ○ |
| 約30秒の動画 | △ | ○ | △ |
| 主な誤読・制限 | 動画内文字を一部誤読 | 操作を一部推測 | 動画の音声を認識できず |
| 検証時に確認した制限・注意点 | 素材のアップロードは可能 | シークレットモードではファイルをアップロードできず | 動画は解析できたが音声内容は確認できず |
今回の検証では、画像や帳票の読み取り精度に大きな差はありませんでした。ただし、映像・音声・文字を同時に扱う動画では、AIによって認識できる情報に違いが見られます。
また、AIが実際には確認できていない操作を補完したり、文字を誤読したりするケースもありました。業務で利用する際は、AIの回答をそのまま採用せず、元データとの照合や人による確認を組み合わせることが重要です。
マルチモーダルAIの今後
今後のマルチモーダルAIは、画像や音声を理解するだけでなく、画面や周囲の状況を認識しながら自律的に作業するAIエージェントへ発展していくと考えられます。PC画面を見て操作したり、複数のツールを使い分けたりすることで、より複雑な業務の自動化も期待できるでしょう。
さらに、カメラやセンサーから得た情報を基にロボットが判断・行動するフィジカルAIへの応用も進んでいます。また、画像・文書など複数形式の社内データを検索して回答に活用するマルチモーダルRAGも、企業における重要な活用方法の一つです。デジタル空間から物理世界まで、活用範囲はさらに広がっていくと考えられます。
生成AI開発・業務活用ならWEELへご相談ください
マルチモーダルAIを活用すれば、テキスト・画像・音声・動画をまとめて処理し、業務の効率や成果を高められます。自社に合った活用方法を検討してみてください。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
マルチモーダルAIに関するよくある質問
- ※1:Expressive Visual Text-to-Speech Using Active Appearance Models
- ※2:GPT-4で「マルチモーダル」の威力痛感、アプリの世代交代に技術者は生き残れるか
- ※3:「ChatGPT」が見て、聞いて、話せるように ~音声・画像対応のマルチモーダルAI
- ※4:1枚の静止画から動画作成する「AnimateDiff」、Googleの画像学習改良版「HyperDreamBooth」など5本の重要論文を解説(生成AIウィークリー)
- ※5:マルチモーダルAIとは?身近な事例で解説します!
- ※6:NEC 、理化学研究所、日本医科大学、電子カルテとAI技術を融合し医療ビッグデータを多角的に解析
- ※7:AIが生成した材料の構造画像を用い、物性を予測する技術を開発
- ※8:Turing株式会社 公式サイト
- ※9:デンソーウェーブが産業用ロボット向けのAI模倣学習システムを2021年3月に発売:産業用ロボット – MONOist
- ※10:介護人材不足解消に向け、対話AI搭載型ロボットによる介護実証を実施 | KDDI ニュースルーム
- ※11:大規模マルチモーダルモデルを用いたロボカップサッカー標準プラットフォームリーグにおける自動実況システム