【Grok 4.7】SpaceXデータで鍛えたSpaceXAIの最強コーディングモデルの性能・使い方・料金を徹底解説
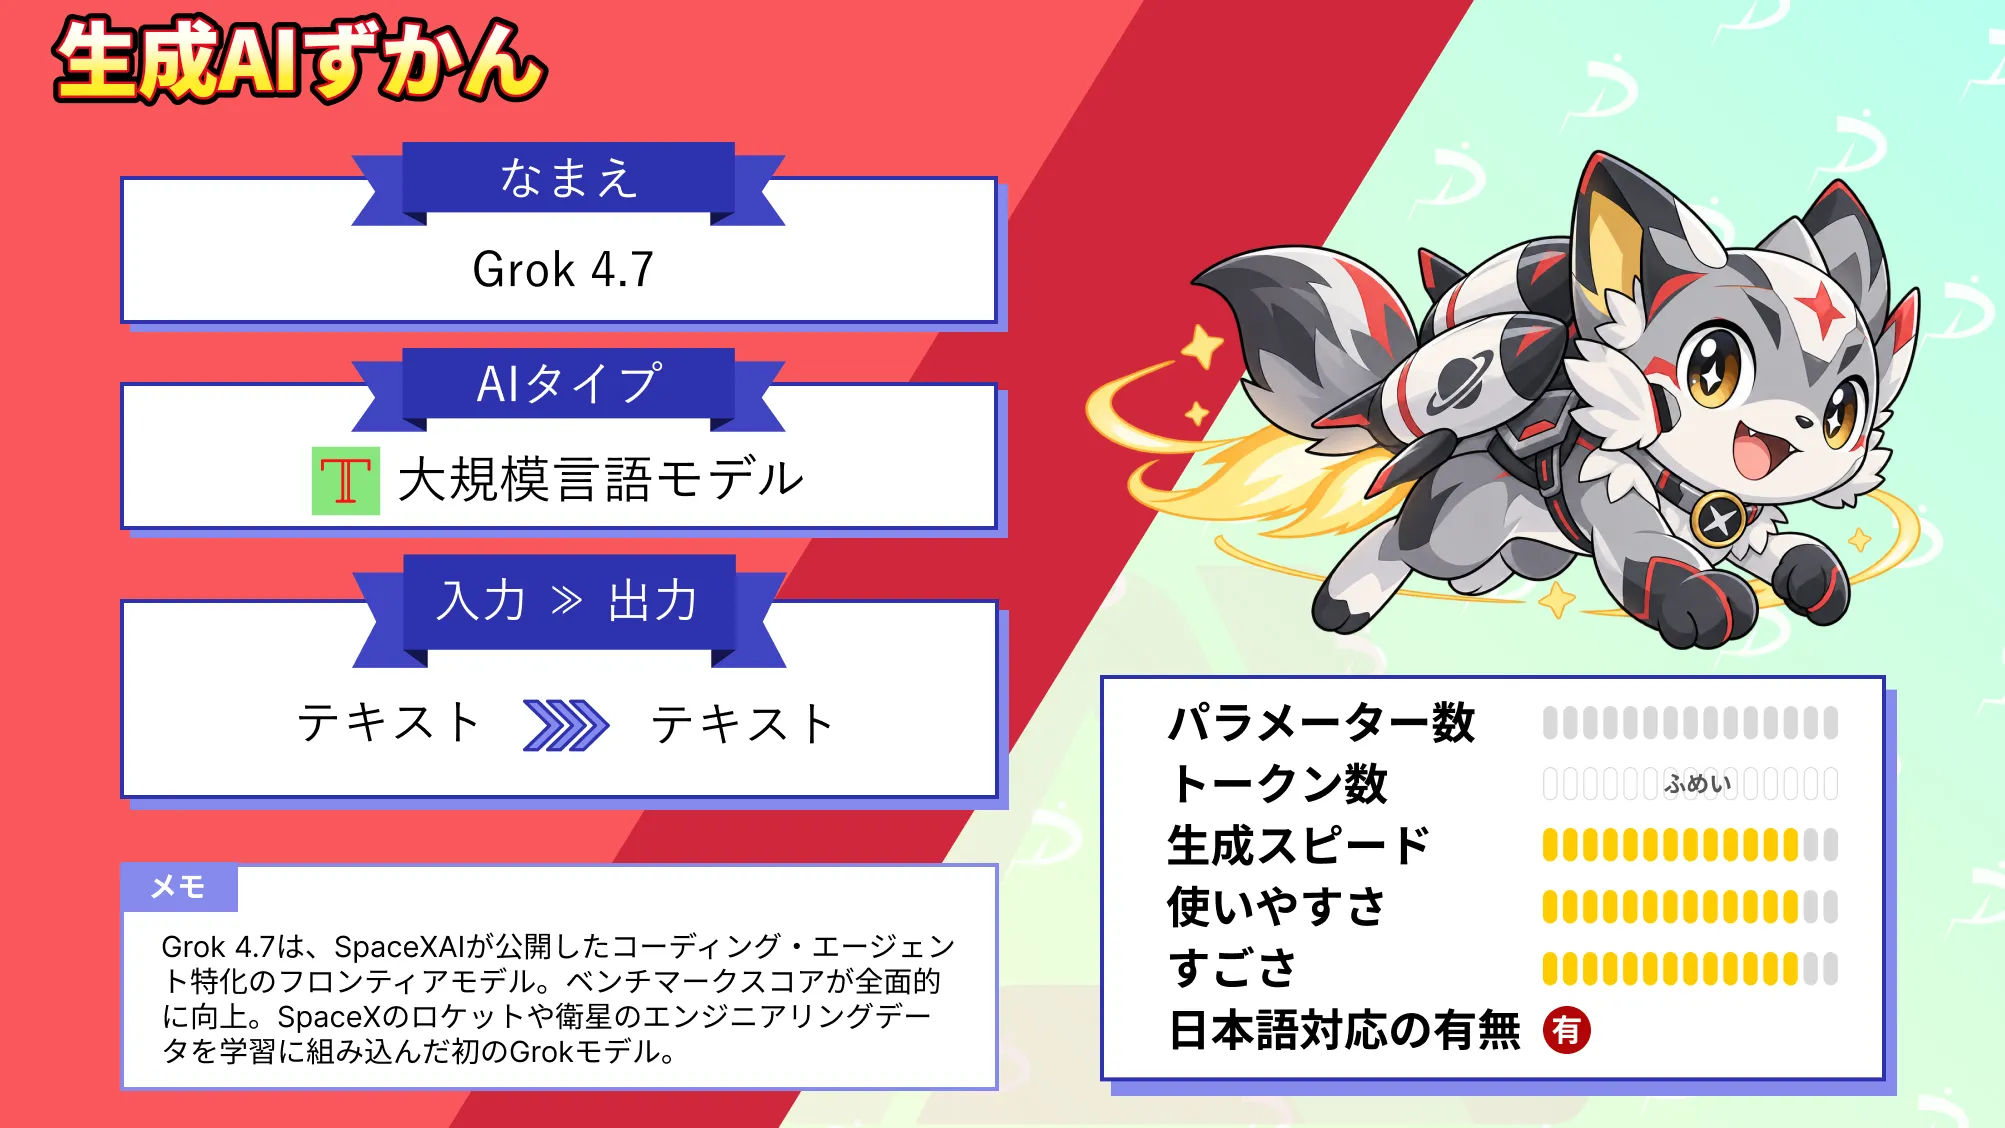
- Grok 4.7は、SpaceXAIが2026年9月22日に公開したコーディング・エージェント特化のフロンティアモデル
- 前モデルGrok 4.6と同一価格(入力2ドル/出力6ドル)を維持しつつ、ベンチマークスコアが全面的に向上
- SpaceXのロケットや衛星のエンジニアリングデータを学習に組み込んだ初のGrokモデル
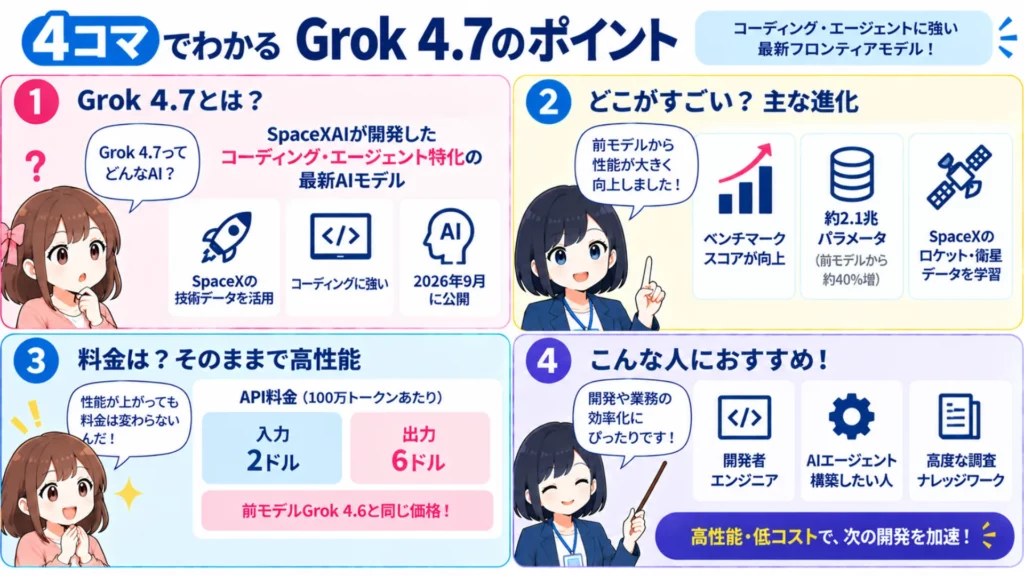
2026年9月22日、SpaceXAIはGrokシリーズの最新モデル「Grok 4.7」をリリースしました!Grok 4.7は、前モデルGrok 4.6からわずか約1か月というスピードでのリリースとなり、SpaceXAIの猛烈な開発ペースを象徴するモデルとなっています。パラメータ数は約2.1兆にまで拡大し、Grok 4.6の1.5兆から約40%の増加を達成しました。
とはいえ、「具体的にどこが変わったの?」「自分の業務にどう活用できる?」と気になっている方も多いのではないでしょうか。
この記事では、Grok 4.7の概要から仕組み、ベンチマーク性能、料金体系、具体的な使い方までを徹底解説します。ぜひ最後までご覧ください!
\生成AIを活用して業務プロセスを自動化/
Grok 4.7とは?
Grok 4.7は、SpaceXAIが開発したコーディング・エージェントタスク・ナレッジワーク向けのフロンティア大規模言語モデルです。
SpaceXAI(旧xAI)は、Elon Musk氏が2023年に設立した生成AI企業で、2026年2月にSpaceXの子会社となりSpaceXAIへとリブランディングしました。Grok 4.7は、そのSpaceXAIとして開発された最新のフラッグシップモデルにあたります。
前モデルGrok 4.6が2026年8月12日にリリースされてからわずか約40日でのアップデートとなり、SpaceXAIの開発速度は業界でも群を抜いています。Grok 4.7は、Grok 4.6と同じ価格帯(100万トークンあたり入力2ドル・出力6ドル)を維持しながら、すべてのベンチマークでスコアが向上しているのが最大の注目ポイントです。
Grok 4.7の仕組み
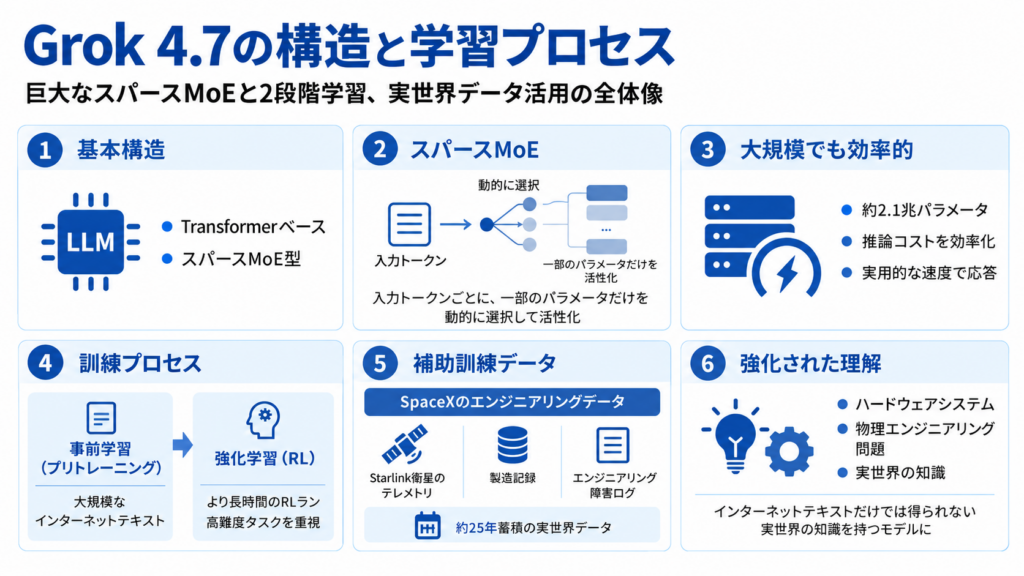
Grok 4.7のアーキテクチャは、スパースMixture of Experts(MoE)型のTransformerベースモデルです。
スパースMoEとは、入力トークンごとにパラメータの一部だけを動的に選択して活性化する仕組みのことです。これにより、パラメータ数が約2.1兆と膨大でありながらも、推論時の計算コストを効率的に抑えることが可能になっています。つまり、巨大なモデル容量を持ちながら、実用的な速度でレスポンスを返せる設計です。
Grok 4.7の訓練プロセスには、大きく2つのフェーズがあります。まず、大規模なインターネットテキストを用いた事前学習(プリトレーニング)が行われ、続いてより長時間にわたる強化学習(RL)ランが実行されています。この強化学習では、完了に何時間もかかるような難易度の高いタスクに重みを置いた課題ミックスが使われました。
さらに、Grok 4.7ならではの特徴として、SpaceXのエンジニアリングデータを補助訓練に組み込んでいる点が挙げられます。
Starlink衛星のテレメトリデータ、製造記録、エンジニアリング障害ログなど、SpaceXが約25年間にわたって蓄積してきた実世界のハードウェアデータが学習に活用されています。これにより、ハードウェアシステムや物理エンジニアリングの問題に対する理解力が強化されていて、インターネットテキストだけでは得られない実世界の知識を持つモデルに仕上がっています。
Grok 4.7の特徴
Grok 4.7の性能面では、前モデルGrok 4.6から全面的にベンチマークスコアが向上しています。
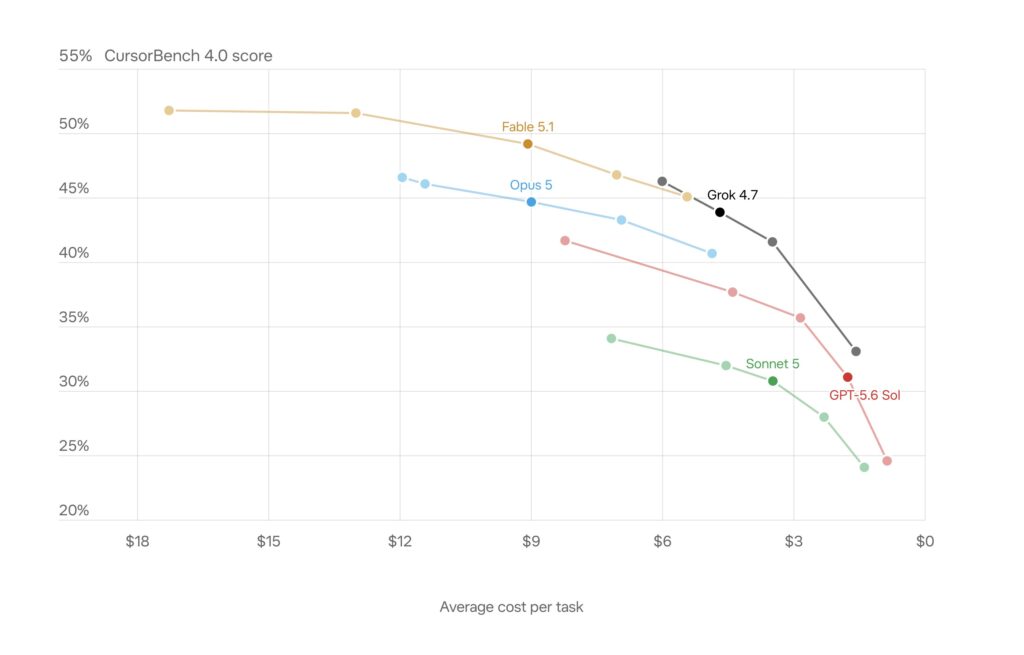
特筆すべきは、コーディングベンチマーク「CursorBench 4.0」におけるスコアです。長時間のコーディングタスクを評価するこのベンチマークで、Grok 4.7は46.3%を記録し、Grok 4.6の40.4%から約6ポイント向上しました。GPT-5.6 Solの41.7%も上回っていて、コスト対性能ではフロンティアクラスの水準に達しています。
以下に、公式発表のベンチマーク比較を整理します。
| ベンチマーク | Grok 4.7 (xHigh) | Grok 4.6 (High) | GPT-5.6 Sol (Max) | Fable 5.1 (Max) |
|---|---|---|---|---|
| CursorBench 4.0(コーディング) | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1(コーディング) | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench(電気工学) | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1(オフィスワーク) | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0(ターミナル作業) | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent(法務) | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional(臨床推論) | 56.7% | 48.5% | 60.5% | 62.1% |
Terminal-Bench 4.0では、Grok 4.6の20.3%から38.0%へとほぼ2倍近いスコア向上を達成しています。これは、長時間のターミナル操作を伴うエージェント的なワークフローにおいて、モデルの持続力と自己修正能力が大幅に改善されたことを意味します。
また、GDPvalベンチマーク(弁護士・看護師・金融アナリストなどのプロフェッショナルタスクを再現するベンチマーク)では1,695のEloスコアを記録しています。Claude Fable 5.1の1,735には及ばないものの、GPT-6 Astraの1,542を大幅に上回っています。
ただし、すべてのベンチマークでトップというわけではありません。Terminal-Bench 4.0ではFable 5.1の57.9%に大きく差をつけられていますし、HealthBench ProfessionalでもFable 5.1やGPT-5.6 Solに劣る場面があります。得意・不得意の領域を把握した上で活用することが重要です。
Grok 4.7の安全性・制約
Grok 4.7には、完全に刷新されたセーフガードスタックが搭載されています。
SpaceXAIによると、Grok 4.7はジェイルブレイク耐性と不適切なリクエストへの拒否能力において、これまでテストした中で最も強力なモデルとのことです。サイバーセキュリティと生物学的な分野における「デュアルユース(軍民両用)」の領域では、正当なタスクへのユーティリティと危険な要求への拒否の両方で最高水準のバランスを実現しました。
具体的には、悪意あるサイバータスクを評価するHackerBench v0.3において、危険なデュアルユースプロンプトの通過率をわずか3.3%に抑え込みつつ、正当なセキュリティ業務への過剰なブロックを最小限にとどめています。生物安全性ベンチマーク「LatchBio」でも62.4%のスコアを達成し、この分野でトップの成績を収めています。
Grok 4.7の料金
Grok 4.7の料金体系は、API利用とサブスクリプションプランの2種類に大別されます。Grok 4.6と同一価格が維持されていて、性能が向上しつつもコスト据え置きという点は大きな魅力です。
API料金
| 項目 | 標準料金(200Kトークン未満) | ロングコンテキスト料金(200Kトークン以上) |
|---|---|---|
| 入力(100万トークンあたり) | 2ドル | 4ドル |
| キャッシュ入力(100万トークンあたり) | 0.50ドル | 1ドル |
| 出力(100万トークンあたり) | 6ドル | 12ドル |
なお、CursorとGrok Build限定で提供されるGrok 4.7 Fast(高速バリアント)は、標準のトークン料金の2倍の価格で、2倍の出力速度を実現します。また、USリージョナルエンドポイントを利用する場合は10%のプレミアムが加算されます。
サブスクリプションプラン
| プラン | 月額料金 | Grok 4.7の利用 | 特徴 |
|---|---|---|---|
| Free | 0ドル | ⭕️(制限あり) | 基本的なGrokアクセス、Grok Build無料お試し |
| SuperGrok Lite | 10ドル | ⭕️ | 2倍長い会話、画像・動画作成 |
| SuperGrok | 30ドル | ⭕️ | Grok Bot利用可、5倍長い会話、高速返答 |
| SuperGrok Plus | 100ドル | ⭕️ | 大幅に高い使用量上限 |
| SuperGrok Heavy | 300ドル | ⭕️ | 最高レベルの使用量、マルチエージェント |
Grok 4.7のライセンス
Grok 4.7はプロプライエタリ(独自仕様)モデルとしてAPI経由で提供されるサービスです。Grok-1はApache 2.0でオープンソース公開されましたが、Grok 4.7のモデルウェイトは非公開となっています。
| 利用用途 | 可否 | 備考 |
|---|---|---|
| 商用利用 | ⭕️ | API・サブスクリプション経由で利用可 |
| 改変 | ❌️ | モデルウェイト非公開 |
| 再配布 | ❌️ | モデルウェイト非公開 |
| 特許利用 | – | |
| 私的利用 | ⭕️ |
Grok 4.7の使い方
Grok 4.7には複数のアクセス方法があります。今回は、代表的な3つの方法をステップバイステップでご紹介します。
xAI API(Python)から利用する
プログラムに組み込む場合の標準的な方法です。
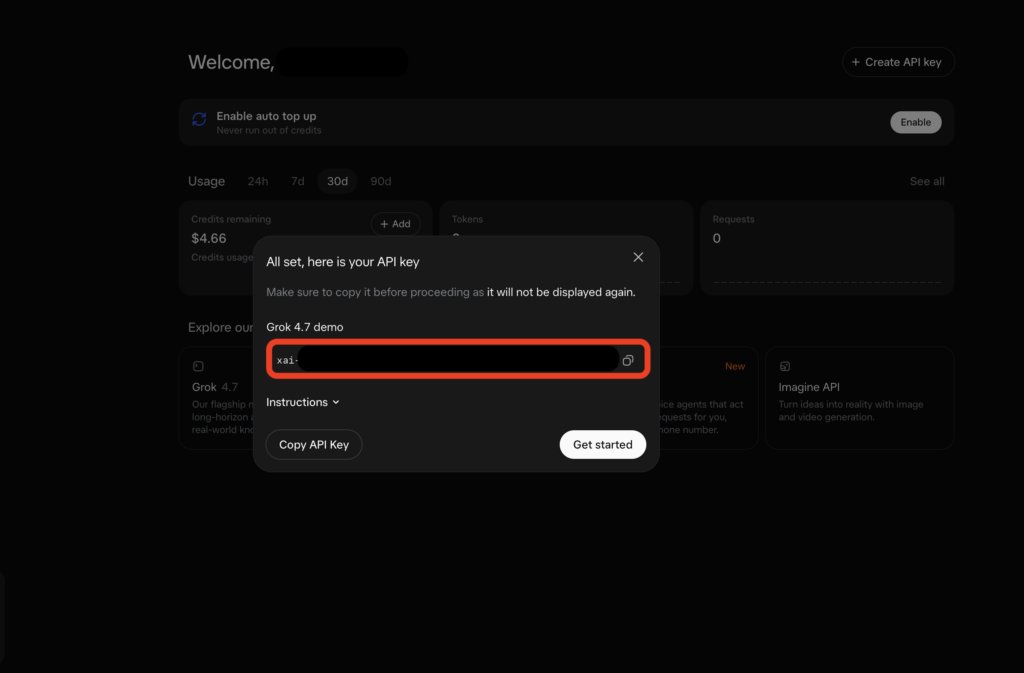
SDKをインストール
pip install xai-sdkPythonコードを実行
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.7")
chat.append(user("このPythonコードのバグを見つけて修正してください: function median(a){a.sort();return a[a.length/2]}"))

response = chat.sample()
print(response.content)
CLIからGrok Buildを利用する
ターミナル上でGrok 4.7をエージェントとして活用したい場合は、Grok Build CLIが便利です。
CLIをインストール
curl -fsSL https://x.ai/cli/install.sh | bash認証を設定
インストール完了後、xAIアカウントで認証を行います。
タスクを実行
ターミナル上で直接タスクを指示できます。Grok 4.7がファイル操作やコマンド実行を含むマルチステップのタスクを自律的に処理します。
Cursorで利用する
CursorはSpaceXAIの子会社となったAIコーディングエディタで、すべてのプランでGrok 4.7を利用できます。
モデルをGrok 4.7に切り替え
エディタの設定画面またはモデルセレクターからGrok 4.7を選択してください。
コーディング支援を活用
コード補完、バグ修正、リファクタリングなど、開発作業のあらゆる場面でGrok 4.7の支援を受けられます。
【業界別】Grok 4.7の活用シーン
Grok 4.7はさまざまな業界で活用が期待されます。ここからは、業界別にGrok 4.7の活用シーンを紹介します。
ソフトウェア開発・IT
Grok 4.7のCursorBench 4.0で46.3%、DeepSWE v1.1で71.0%というスコアは、実務レベルのソフトウェア開発を十分にサポートできる水準です。バグの検出と修正、マルチファイルにまたがるリファクタリング、テストコードの自動生成など、コーディングの生産性向上に直結するタスクに適しています。
特にCursorとの統合により、エディタ上でシームレスにGrok 4.7の支援を受けられる点は、日々のコーディング業務において大きなメリットとなるでしょう。
生成AIを搭載したSaaSについて、詳しく知りたい方は以下の記事も参考にしてみてください。

金融・コンサルティング
50万トークンのコンテキストウィンドウを活用すれば、長大なレポートや財務データを一括で読み込んで分析することが可能です。AA Briefcase v1.1(プロフェッショナルのオフィスワークを再現したベンチマーク)でも1,657という高いスコアを記録していて、分析レポートの作成や戦略立案の補助に活用できます。
金融業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
研究・学術
Terminal-Bench 4.0での38.0%というスコアは、長時間にわたるターミナル操作を伴う実験や分析タスクへの対応力を示しています。論文のサーベイ、データ分析のパイプライン構築、研究コードの検証など、研究のあらゆるフェーズでアシスタントとして活用できるでしょう。
教育業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。

【課題別】Grok 4.7が解決できること
続いて、Grok 4.7が解決できる具体的な課題も確認しておきましょう。
長時間のコーディングタスクの自動化
Grok 4.7は完了に何時間もかかるような難しいタスクに重点を置いて訓練されています。マルチステップのバグ修正やリファクタリングなど、従来のモデルでは途中で精度が落ちていたような長時間タスクを最後まで高品質に完遂できます。
Terminal-Bench 4.0のスコアがGrok 4.6の20.3%から38.0%へ大幅に向上したことが、その証拠です。
エージェント運用のコスト削減
フロンティアモデルの中で最も安い価格帯(入力2ドル/出力6ドル)を維持しているため、大量のトークンを消費するエージェント的なワークフローでもコストを抑えて運用できます。Fable 5.1と比較して入力コストは5分の1、出力コストは約8分の1で済みます。
自己検証による出力品質の向上
Grok 4.7は自分の出力をチェックする能力が強化されています。コード生成後に自動でテストを実行し、エラーがあれば修正するといった自己検証のサイクルを、モデル自身が回せるようになりました。人間によるレビューの負担を軽減し、出力のファーストパス品質を高めます。
Grok 4.7を使ってみた
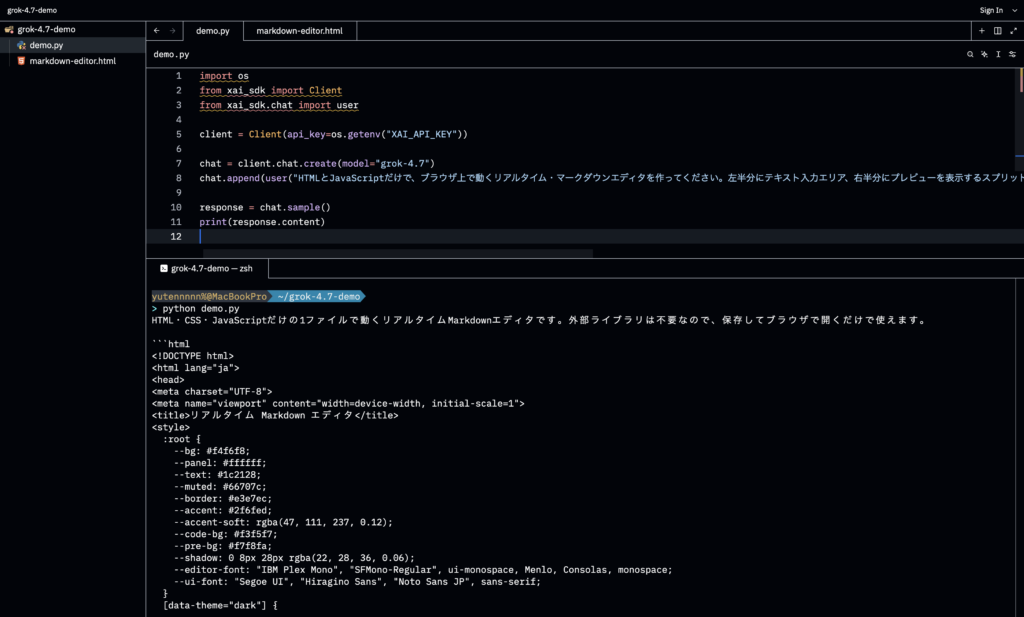
それでは実際にGrok 4.7を試してみましょう。今回はxAI APIのPython SDK経由で、ファイルやデータを一切用意せずプロンプトだけで試せる検証を2つ実施しました。
検証①:プロンプト一発でマークダウンエディタを生成
まずはコード生成力の検証です。以下のプロンプトで、ブラウザ上で動くWebアプリを丸ごと作らせてみました。
プロンプトはこちら
HTMLとJavaScriptだけで、ブラウザ上で動くリアルタイム・マークダウンエディタを作ってください。左半分にテキスト入力エリア、右半分にプレビューを表示するスプリットビュー構成にしてください。見出し・太字・リスト・コードブロック・リンクに対応し、ダークモードとライトモードの切り替えボタンも付けてください。CSSも含めて1ファイルで完結させてください。出力結果(一部抜粋)はこちら
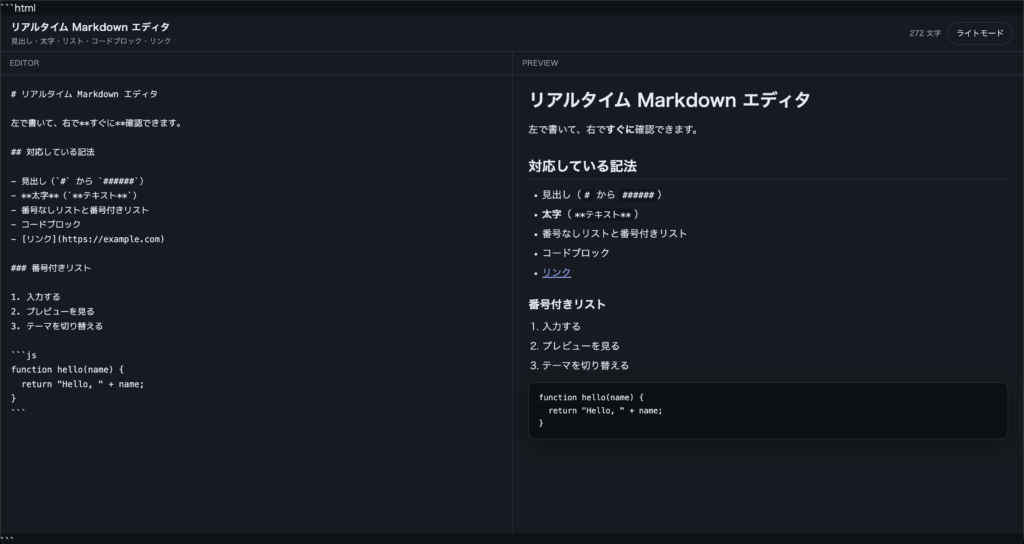
実際にブラウザで開くと、左の「EDITOR」パネルにマークダウンを入力すると右の「PREVIEW」パネルにリアルタイムで反映されます。CSS変数によるダークモード/ライトモード切り替えも正常に動作し、プロンプトに書いていない文字数カウンター機能まで自動で実装されていたのが嬉しい誤算でした。
フォント指定にも「IBM Plex Mono」や「Hiragino Sans」が含まれていて、日本語環境をしっかり考慮してくれていますね。
検証②:アルゴリズム実装+テストコードの自動生成
2つ目は、実務寄りのアルゴリズム実装タスクです。同じくAPI経由で以下のプロンプトを投げました。
プロンプトはこちら
Pythonで以下の要件を満たすスケジューラーを実装してください。
1. 複数のタスク(名前・所要時間・締切・優先度)を受け取る
2. 締切と優先度を考慮して最適なスケジュールを組む(EDF+優先度のハイブリッド)
3. 締切に間に合わないタスクがある場合は警告を出す
4. 結果をガントチャート風のテキストで表示する
5. pytestで動作を検証するテストコードも一緒に書いてください
出力結果(一部抜粋)はこちら
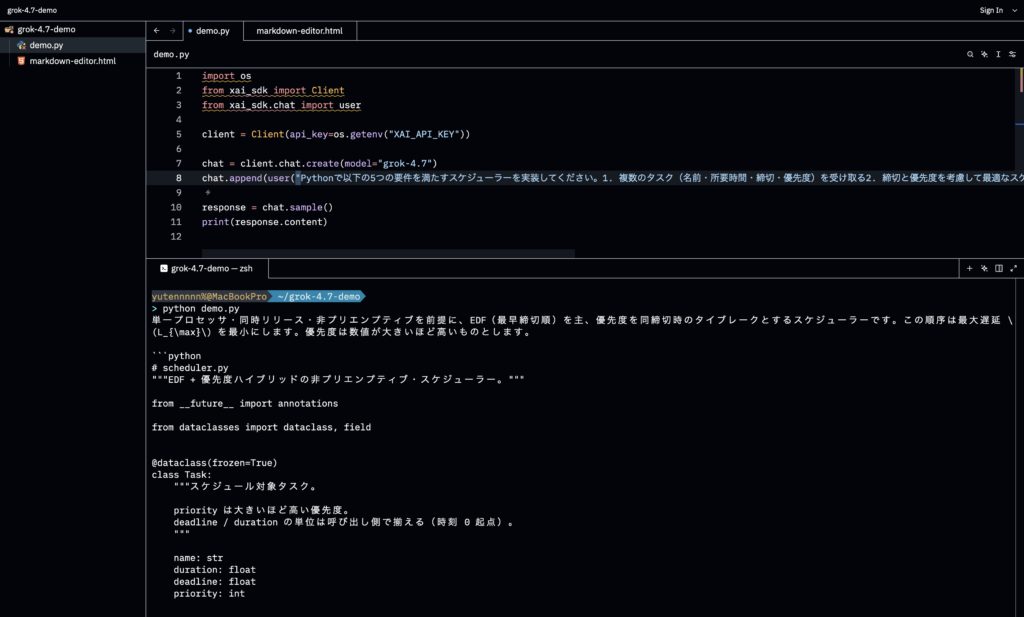
Grok 4.7は、scheduler.pyとtest_scheduler.pyの2ファイルを一回の応答で出力してくれました。
スケジューラー本体はTaskやScheduledTaskをdataclassで定義し、Jackson の規則(EDF)を主軸に同締切時は優先度降順でタイブレークするクラス設計になっています。締切超過タスクを!で表示するガントチャート描画や、Task・dict・tupleの3形式を受け付けるparse_tasks関数まで、プロンプトの5要件を超える実装が含まれていました。
特筆すべきはテストコードの充実度です。プロンプトでは「テストも書いて」と一言で指示しただけですが、出力されたtest_scheduler.pyには11のテストケースが含まれていました。EDF順序の検証、同締切時の優先度タイブレーク、さらに同優先度時の名前順ソートまで段階的にテストされていて、pytest.mark.parametrizeで空文字名・負の所要時間・負の締切・float型優先度を一括バリデーションするなど、防御的プログラミングを前提としたテスト設計だと思います。
AI開発のご相談はWEELへ!
Grok 4.7は、SpaceXAIが開発したコーディング・エージェントタスク特化のフロンティアモデルです。前モデルGrok 4.6から価格を据え置きながら全面的にベンチマークスコアを向上させ、SpaceXのエンジニアリングデータで鍛えられた実世界の知識も備えています。
特に、入力2ドル/出力6ドルという圧倒的なコストパフォーマンスは、大量のトークンを消費するエージェント運用やコーディング支援において大きなメリットとなるでしょう。Grok BuildやCursor経由で無料で試せるため、気になった方はぜひ一度体験してみてください。
弊社では、生成AIを活用した業務効率化やシステム開発の支援を行っています。「自社の業務にGrokをどう活用できるか知りたい」「生成AIを使った開発プロジェクトを検討している」という方は、ぜひお気軽にご相談ください。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
よくある質問