ローカルSLMとは?メリット・導入手順・代表モデルの性能を徹底検証
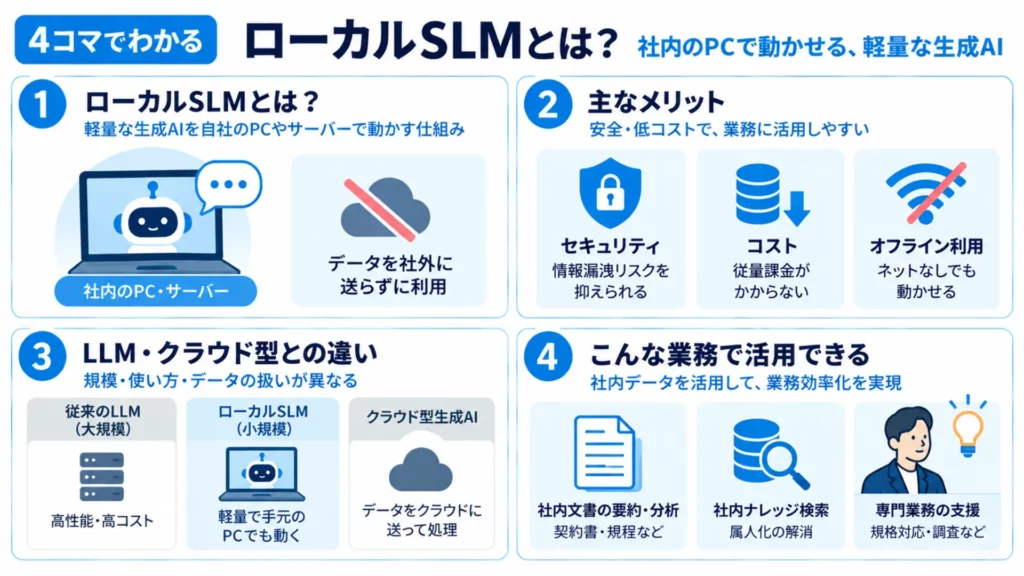
- ローカルSLMは、軽量な言語モデルを社内のPCやサーバーの中だけで動かす使い方
- 入力したデータを社外に送らずに生成AIを使えるため、情報漏洩リスクを抑えやすい
- 3つのモデルを同じMacで比べたところ、生成の速さと日本語の出来の順位はほぼ逆
「生成AIを使いたいけれど、社内の情報をクラウドに送るのは不安」という企業は少なくありません。そこで選択肢になるのがローカルSLMです。社内の機器の中だけで動かすため、情報漏洩リスクを抑えながら生成AIを業務に活用できます。
本記事では、SLMの基礎知識から弊社WEELによる検証結果、導入手順、活用シーンまで解説します。ぜひ最後までご覧ください!
\生成AIを活用して業務プロセスを自動化/
ローカルSLMとは
まずは、ローカルSLMの全体像と、LLMやクラウド型生成AIとの違いを整理しておきましょう。
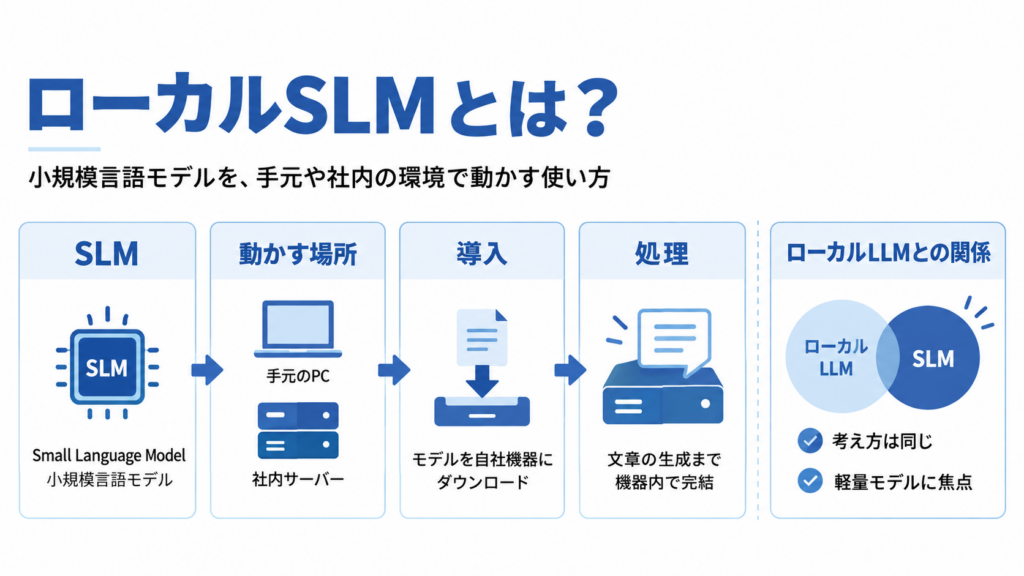
ローカルSLMとは、SLM(Small Language Model=小規模言語モデル)を、手元のPCや社内サーバーで動かす使い方のことです。
モデルを自社の機器にダウンロードし、文章の生成まで機器の中で完結させます。「ローカルLLMとは」と調べると同じ考え方が出てきますが、その中でも軽量なモデルに焦点を当てた呼び方です。
ローカルLLMについてはこちら
SLM(Small Language Model)の特徴
SLMの特徴は、パラメータ数が少なく、モデル自体が軽量な点です。
パラメータ数とは、AIが学習した知識を蓄える「つまみ」の数のことで、多いほど表現力が増す一方、必要なメモリや計算量も大きくなります。明確な線引きは公式に定まっていませんが、数億〜数十億パラメータ程度のモデルを指すことが多いです。
例えばGoogleは、Gemma 3について、比較的小さいためノートPCやデスクトップPCなどリソースの限られた環境にも展開できると説明しています※1。少ない計算資源でも動かせることが強みです。
LLMとの違い(パラメータ数・処理速度・精度)
LLM(大規模言語モデル)は幅広い知識や複雑な推論に強い一方、高性能なサーバーやクラウドが前提になりがちです。対してSLMは、得意分野を絞る代わりに、手元の機材でも動かせる手軽さがあります。
| 項目 | SLM | LLM |
|---|---|---|
| パラメータ数 | 数億〜数十億程度のものが多い | SLMより桁違いに多い(数値を公開していないモデルも多い) |
| 処理速度 | 同じ機材なら軽快に動きやすい | 大きな計算資源がないと応答に時間がかかりやすい |
| 精度 | 定型的なタスクは得意だが、複雑な推論や長文は苦手な傾向 | 幅広い知識と複雑な推論に強い傾向 |
| 必要なスペック | 一般的なPCや社内サーバーでも動かせるものがある | 高性能GPUを積んだサーバーやクラウドが前提になりやすい |
クラウド型生成AIとの違い
クラウド型生成AIとの一番の違いは、インターネット通信を介さず、PCやサーバーの中で処理が完結する点です。
クラウド型では入力した文章が事業者のサーバーに送られるため、社外へのデータ持ち出しを禁じる企業では大きな違いです。
また、クラウド型のAPIは使った分だけ課金されるのが一般的ですが、ローカルSLMは通信やAPI利用に伴う従量課金がかかりません。
ローカルSLMを導入するメリット・デメリット
ここからは、ローカルSLMを導入するメリットとデメリットを整理します。導入前に知っておきたい注意点もあわせて確認しておきましょう。
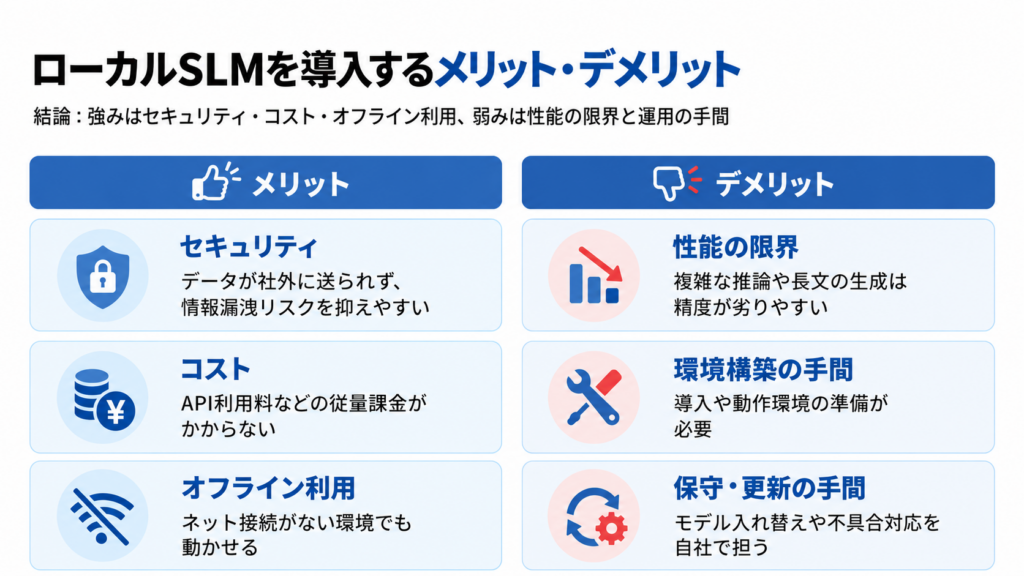
結論からいうと、メリットはセキュリティ・コスト・オフライン利用、デメリットは性能の限界と運用の手間に集約されます。
| メリット | デメリット |
|---|---|
| 【セキュリティ】入力したデータが社外に送られないため、情報漏洩リスクを抑えやすい | 【性能の限界】複雑な推論や長文の生成では、クラウドの大規模モデルに精度が劣りやすい |
| 【コスト】API利用料などの従量課金がかからない | 【環境構築の手間】ツールの導入や動作環境の準備を自社で行う必要がある |
| 【オフライン利用】インターネットにつながらない環境でも動かせる | 【保守・モデル更新の手間】モデルの入れ替えや不具合への対応を自社で担う必要がある |
オンプレミス導入のメリット・デメリットについてはこちら
メリット(セキュリティ・コスト・オフライン利用)
1つ目は、入力したデータが外部に送られないことです。契約書や顧客情報を読み込ませても処理は自社の機器の中で行われるため、情報漏洩のリスクを抑えられます。
ただし、リスクがゼロになるわけではありません。端末やサーバー自体のアクセス管理は、引き続き必要です。
2つ目は、API利用料がかからない点です。機器さえ用意すれば、何度使っても従量課金は発生しません。3つ目は、インターネット接続が制限された工場や研究施設などでも使える点です。
デメリット(性能の限界と運用の手間)
ローカルLLMのデメリットとしてよく挙げられるのが、性能の限界で、これはローカルSLMにも当てはまります。
複雑な推論や長文の生成では、クラウドの大規模モデルに精度が劣る場面が出てきます。後ほど紹介する検証でも、細かい日本語表現では苦戦しました。
もう1つは、環境構築・モデル更新・保守の手間です。クラウド型と違い、ツールの導入やモデルの入れ替えを自社で担う必要があります。
【実践】代表的なローカルSLMを実際に導入・検証してみた
ここからは、WEELが実際にローカルSLMを導入して試した結果を紹介します。カタログスペックだけではわからない動き方を見ていきましょう。
今回は、Google・Microsoft・Metaの3つのモデルを同じMacに導入し、同じ条件で比べました。ほかのアプリを開いたままの「普段使いのPCでの値」で、厳密なベンチマークではない点をご了承ください。
| モデル | 応答速度(生成速度・計測値) | 日本語の出力精度 | メモリ消費量(読み込み後) |
|---|---|---|---|
| gemma3:4b | 15.84/15.63/15.82 tok/s | 課題Aは12問中12問正答。今回の3つの課題では3モデルで最も安定していた | 3.5GB |
| phi4-mini:3.8b | 19.84/19.94/20.19 tok/s | 課題Aは12問中8問正答。指定の文字数を大きく超える回答や意味の通らない語が混じった | 3.1GB |
| llama3.2:3b | 25.58/25.54/25.55 tok/s | 課題Aは12問中11問正答。課題Bでは3回とも英語が混ざった | 2.5GB |
ollama psの表示値)結果は、生成の速さと日本語の出来の順位がほぼ逆でした。
検証環境・使用モデル
検証PCはMacBook Proで、チップはCPUとGPUを1つにまとめたApple Mシリーズ、SSDは256GB、OSはmacOS 26.5.2です。
導入ツールはOllama 0.32.9(公式アプリ版)です。公式ドキュメントによれば、Apple Mシリーズを搭載したMacではCPUとGPUの両方を使って動作します※2。
モデルはgemma3:4b、phi4-mini:3.8b、llama3.2:3bの3つで、パラメータ数はOllamaの表示で4.3B・3.8B・3.2Bです。量子化(モデルの数値を粗く丸めて軽くする処理)は、いずれもOllamaの標準の量子化版であるQ4_K_Mです。
取得には自宅のWi-Fiでphi4-miniがおよそ4分、llama3.2:3bがおよそ3分かかりました。生成の設定は既定値のまま、コンテキスト長はOllamaの既定の4096です。
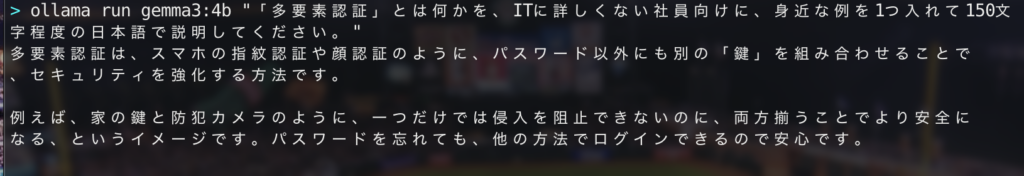
ollama run モデル名 "質問"で動作確認したところ、3つとも日本語で応答が返りました。
検証結果①応答速度・処理性能
計測スクリプトからOllamaに同じプロンプト(「新入社員向けに、生成AIに入力してはいけない情報の例と理由を300文字程度で説明して」)を、読み込みを含む初回に1回、読み込み後に3回送り、Ollamaが返す計測値を記録しました。
初回のモデル読み込み時間は、gemma3:4bが10.61秒、phi4-miniが3.87秒、llama3.2:3bが3.07秒でした。
生成速度は上の表のとおりで、tok/sは1秒あたりに生成したトークン(文字のかたまり)の数です。今回のPCでは、llama3.2:3bが最も速く、gemma3:4bが最も遅い結果でした。
回答を書き終えるまでの時間(3回の計測値)は、gemma3:4bが9.93/11.28/11.30秒(300/329/351字)、phi4-miniが15.86/17.35/13.43秒(437/486/380字)、llama3.2:3bが8.21/10.55/9.57秒(324/381/375字)です。
読み込み後は3モデルとも1秒以内に書き始めました。ただしphi4-miniは300字の指定を大きく超えて書いたため、生成速度はgemma3:4bより速いのに、書き終えるまでの時間は最も長くなりました。
検証結果②日本語の出力精度
3種類の課題を各3回解かせ、回答の全文を採点します。基準は、課題Aが「書かれた事実どおりに答えたか」、課題Bが「内容と例が正しく自然な日本語か」、課題Cが「敬語の誤り2か所を直せたか」です。
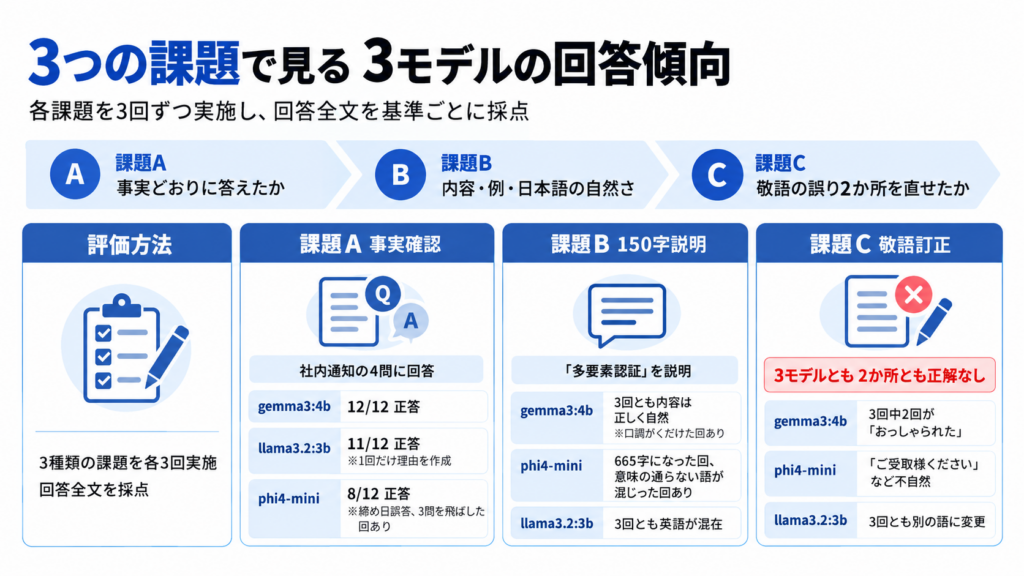
課題Aは架空の社内通知について4問に答えさせ、うち1問は通知に書かれていない「停止の理由」です。gemma3:4bは12問中12問正答、llama3.2:3bは11問正答で1回だけ書かれていない理由を作り、phi4-miniは8問正答で締め日の誤答や3問を飛ばした回がありました。
課題Bは「多要素認証」の150文字程度の説明です。gemma3:4bは3回とも内容が正しく自然でしたが口調がくだけた回があり、phi4-miniは指定の4倍を超える665字になった回や意味の通らない語が混じった回、llama3.2:3bは3回とも「banking アプリ」のように英語が混ざりました。
課題Cは「部長が申された通り、資料は受付でいただいてください。」の訂正で、2か所とも正しく直せた回答はどのモデルにもありませんでした。gemma3:4bは3回中2回が「おっしゃられた」という二重敬語、phi4-miniは「ご受取様ください」のような存在しない表現になり、llama3.2:3bは3回とも意味ごと別の語に変えていました。
速さだけでなく、日本語の出力を実際に確かめてからモデルを選ぶ必要があることが見えました。
検証結果③メモリ消費・省スペース性
読み込み後のメモリ使用量(ollama psの表示)は、gemma3:4bが3.5GB、phi4-miniが3.1GB、llama3.2:3bが2.5GBでした。
ディスク上のサイズは、gemma3:4bが3.3GB、phi4-miniが2.5GB、llama3.2:3bが2.0GBで、いずれもディスク2〜3GB台・メモリ2.5〜3.5GB程度で動きました。
モデルが小さいほど読み込みが速く使用量も少なく、llama3.2:3bが読み込み3.07秒・2.5GBで最も軽い結果でした。gemma3:4bが大きいのは、画像入力に対応している分を含むためと考えられます。

処理の配分は、phi4-miniとllama3.2:3bが「100% GPU」だったのに対し、gemma3:4bだけ「20%/80% CPU/GPU」で、2割がGPUに載りきっていませんでした。gemma3:4bの生成速度が低かったのは、これが一因と考えられます(切り分けはしていません)。
ほかのアプリを開いたままでも3モデルとも問題なく応答しました。なお、Windows PCでの動作や7B以上のモデルは今回は試していませんので、気になる方はぜひお手元で試してみてください。
代表的なローカルSLMモデルの比較(Gemma・Phi・Llamaなど)
ここからは、検証で使った3つのモデルを公式情報をもとに比較します。モデル選びでは、性能だけでなくライセンスの条件も欠かせません。
各社の公式モデルカードとライセンス文書で確認できた内容を、以下の表にまとめました。いずれも商用利用は可能ですが、条件はライセンスごとに異なるため、導入前に原文を確認しておきましょう。
| モデル名 | パラメータ数 | 対応言語 | 商用利用の可否(ライセンス) |
|---|---|---|---|
| Google Gemma 3 | 270M・1B・4B・12B・27B※1 | 140以上の言語※1 | 可(Gemma Terms of Use。禁止用途ポリシーの順守が必要で、再配布する場合は利用制限の引き継ぎと規約の写しの提供が必要)※5 |
| Microsoft Phi-4-mini-instruct | 3.8B※4 | 日本語を含む23言語※4 | 可(MITライセンス)※4 |
| Meta Llama 3.2(軽量版) | 1B(1.23B)・3B(3.21B)※3 | 英語・ドイツ語・フランス語・イタリア語・ポルトガル語・ヒンディー語・スペイン語・タイ語の8言語※3 | 可(Llama 3.2 Community License。リリース時点で月間アクティブユーザーが7億人を超える場合はMetaへの許諾申請が必要。配布時は「Built with Llama」の表示が必要)※3 |
Google Gemma
Gemmaは、Googleが公開している軽量なオープンモデルのシリーズです。公式のモデルカードによれば、Gemma 3は270M〜27Bの5サイズがあり、4B以上は画像の入力にも対応しています※1。
用途や機材に合わせてサイズを選べるのが特徴です。今回のgemma3:4bは生成速度こそ最も遅かったものの、日本語の出来は3モデルで最も安定していました。
Microsoft Phi
Phiは、Microsoftの小規模言語モデルのシリーズで、少ないパラメータ数でも高い精度を狙った設計が特徴です。
公式モデルカードでは、知識を問うMMLUで67.3、算数の文章題を解くGSM8Kで88.6と、同じ表のLlama-3.2-3B-Instruct(61.8、75.6)を上回るスコアが公表されています※4。
一方、今回の日本語の課題では、指定の文字数を大きく超えたり、意味の通らない語が混じったりする場面がありました。
Meta Llama(軽量版)
Llama 3.2には、1Bと3Bの軽量版が用意されています。公式モデルカードでは、モバイル端末のような制約の大きい環境での利用が想定されています※3。
ただし、公式の対応言語は8言語で、日本語は含まれていません※3。今回の検証でも、llama3.2:3bは最も速く軽かった一方、日本語の回答に英語が混ざる場面がありました。
ローカルSLMの導入手順
ここからは、ローカルSLMを導入する流れを紹介します。流れさえ押さえれば、手順自体はシンプルです。
導入の流れは、「ツールの準備→モデルのダウンロード→動作確認」の3ステップです。上述した検証でも、この順番でOllamaを使いました。
自社での導入を相談したい方はこちら
必要な環境・ツール(WSL・Docker・Ollamaなど)
代表的なツールがOllamaで、Windows・macOS・Linux向けに配布されています※6。
公式ドキュメントによれば、WindowsではWindows 10 22H2以降に対応したネイティブアプリとして動き※7、macOSではmacOS Sonoma(v14)以降が必要です※2。今回はWindowsでの動作は試していません。
WSLやDockerは、使い方によって必要になる選択肢です。WSLはWindows上でLinux環境を動かすWindowsの機能で※8、DockerはOllamaの公式イメージを使ってコンテナで動かしたい場合に使えます※9。
モデルのダウンロードとセットアップ
ツールを入れたら、コマンド1行でモデルをダウンロードできます※10。
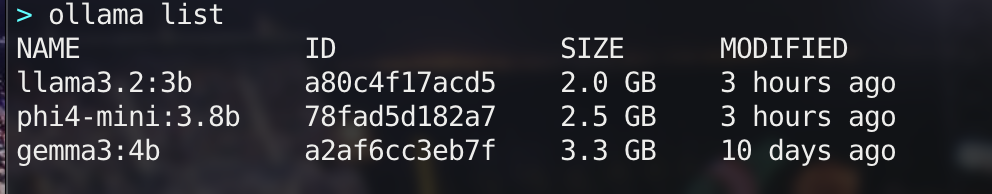
ollama pull gemma3:4b取得後はollama listで手元のモデルを一覧できます。モデル名を「phi4-mini:3.8b」や「llama3.2:3b」に変えれば、今回と同じモデルを取得できます。
動作確認・チャット実行
ollama runのあとにモデル名と質問を続けると、ターミナル上に回答が返ってきます※10。
ollama run gemma3:4b "日本語で、自己紹介を1文でしてください。"質問を付けずに実行すれば、チャット形式でやり取りを続けられます。今回もこの形で動作確認を行い、3つのモデルとも日本語で応答が返りました。ollama psでは、動いているモデルとメモリの使用量を確認できます※10。
企業がローカルSLMを活用すべきシーン
ここからは、ローカルSLMが活きる業務シーンを紹介します。自社の業務に当てはめながら読み進めてみてください。
ローカルLLMの活用方法を考えるポイントは、「データを社外に出せない業務」ほど効果を発揮しやすいという点です。特定企業の活用事例ではなく一般的な活用シーンですが、ローカルLLMを業務に取り入れる際のヒントとしてご覧ください。
機密情報・契約書など社内文書の要約・分析
1つ目は、契約書や社内の機密文書の要約・分析です。
取引条件や個人情報を含む文書も、社外に出さないまま要点の抜き出しに使えます。実際にWEELにも、契約書や社内の機密文書を外部のAIサービスに出さずに要約・分析したいというご相談が寄せられています。
ただし、今回の検証では長文の要約は試しておらず、最終確認は人が行う前提で使うのが現実的です。
社内ナレッジ検索・属人化解消のためのRAG活用
2つ目は、社内ナレッジの検索です。
属人化したノウハウの共有には、ローカルSLMとRAGの組み合わせが役立ちます。RAG(検索拡張生成)とは、AIが社内文書から関連情報を探して答える仕組みのことです。社内マニュアルを検索対象にすれば、データを社外に出さずにナレッジを誰でも引き出せる状態に近づけられます。
WEELにも、属人化した社内ナレッジをAIで共有・検索できるようにしたいというご相談が実際に寄せられています。
自社データを使ったRAG構築を検討したい方はこちら
業界規格・コンプライアンス対応が必要な業務での活用
3つ目は、業界規格やコンプライアンスへの対応が求められる業務です。
品質マネジメント規格など、業界によっては情報の管理方法に独自のルールがあり、クラウドサービスの利用が難しいケースもあります。ローカルSLMならデータを社外に出さずに扱えるため、手順書の文面チェックや社内規程の確認などで担当者を補助する使い方が考えられます。
生成AIなどのご相談はWEELへ!
ローカルSLMは、入力したデータを社外に出さずに使えるため、情報漏洩リスクを抑えながら生成AIを業務に活用できる選択肢です。
今回の検証では、3〜4B前後のモデルがいずれも普段使いのMacで動いた一方、生成の速さと日本語の出来の順位はほぼ逆になり、敬語の訂正のような細かい日本語は3モデルとも不得意でした。
だからこそ、自社の業務内容やセキュリティ要件に合わせて、モデルと環境を選ぶことが欠かせません。実際の業務で出力を確かめながら、自社に合ったモデル選定と環境構築を検討してみてください。
弊社では、AI導入を検討中の企業向けに、業務効率化や新しい価値創出を支援する情報提供・導入支援を行っています。最新のAIを活用し、効率的な業務改善や高度な分析が可能です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。
よくある質問