Qwen4-Maxとは?アリババ次世代フラッグシップのプレビュー版の特徴・料金・使い方を徹底解説
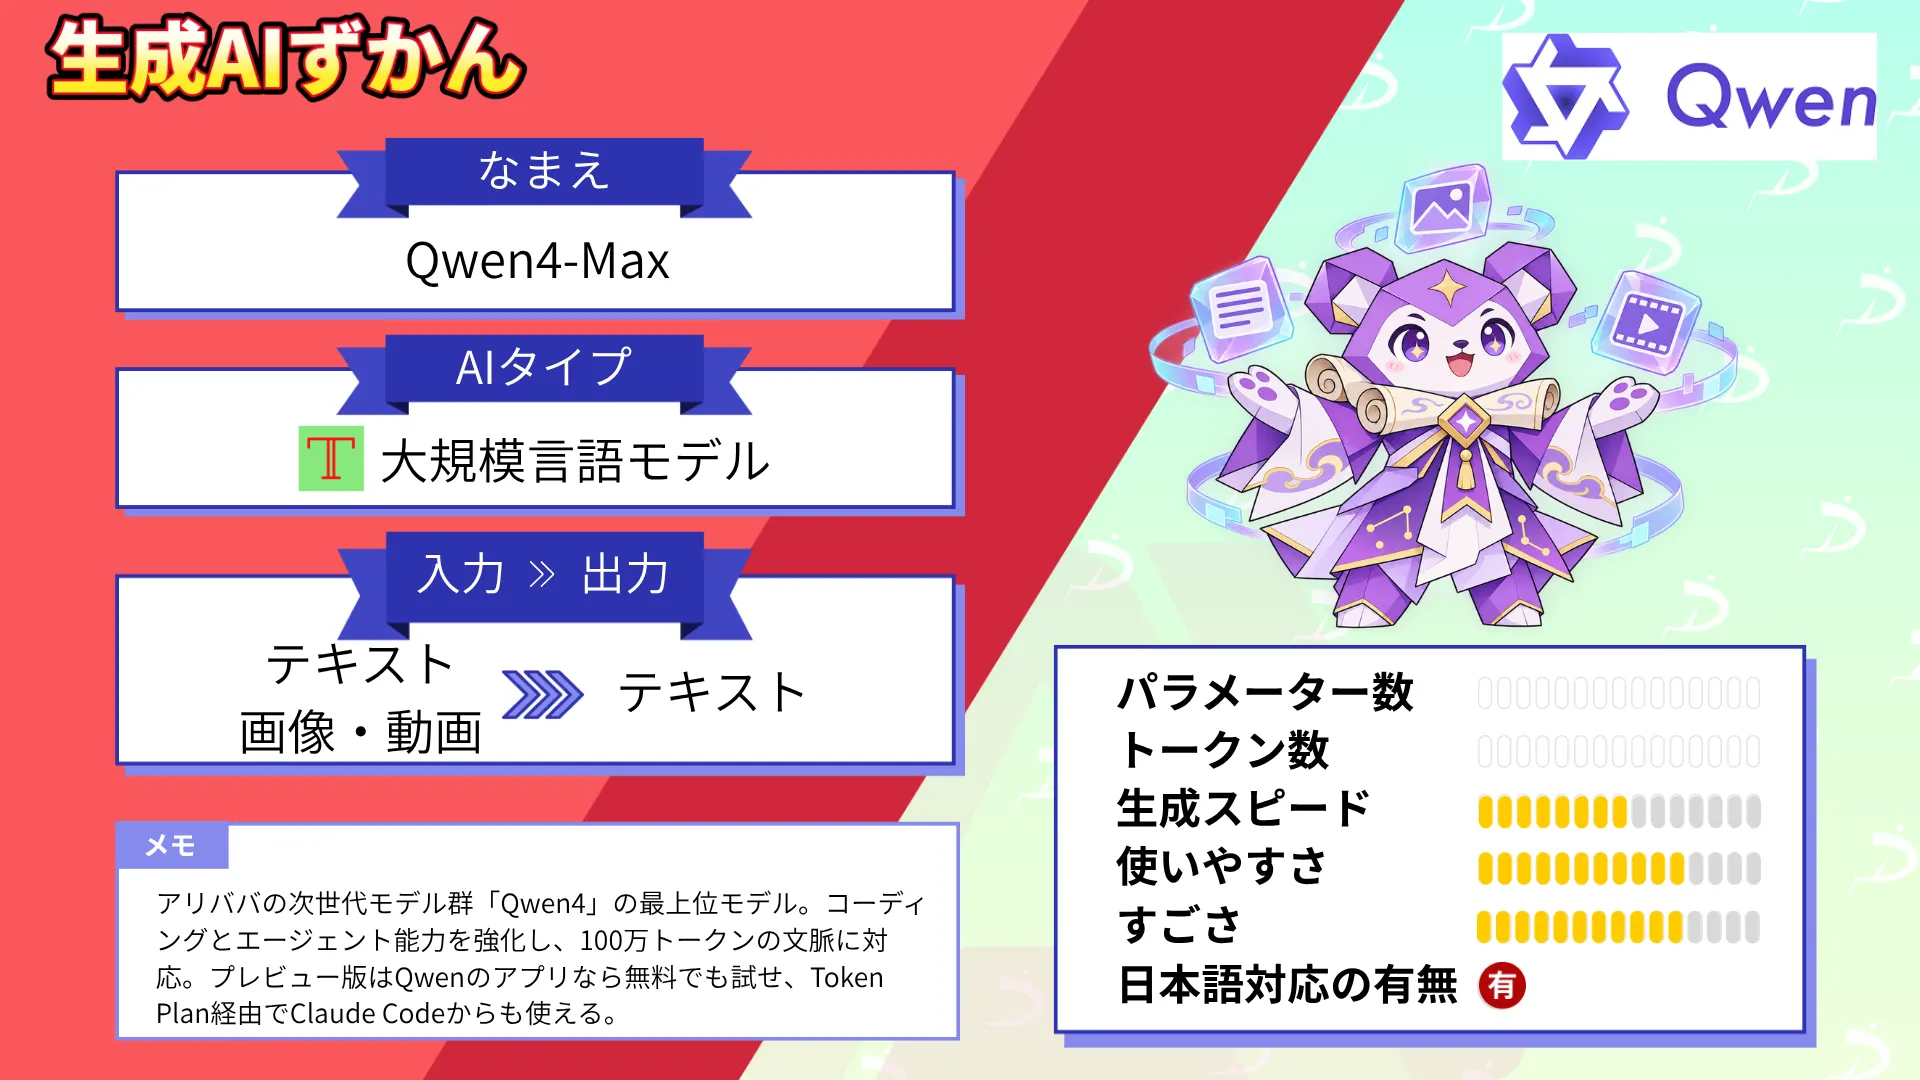
- Qwen4-Maxは次世代モデル群「Qwen4」の最上位で、2026年11月11日にプレビュー版の提供が始まった
- Qwenのアプリの無料プランやToken Planで試せ、Token Planのプレビュー期間は日本時間11月26日1時まで
- コンテキスト長は100万トークンだが、パラメータ数・ベンチマーク・正式提供日は未公表
2026年11月、アリババのQwenチームから次世代AIモデル群「Qwen4」の最上位モデルが登場しました。
今回登場した「Qwen4-Max」は、知識の深さと現実世界への理解を高めたうえで、コーディングとエージェント能力を強化したモデルです。プレビュー版としてすでに提供が始まっており、無料プランでも試せるのが特徴。これまでの大規模モデルの活用では、「手順の長い実務を任せにくい」「高性能なモデルは利用コストがかさみやすい」「最新モデルを気軽に試しにくい」といった課題が挙げられてきました。
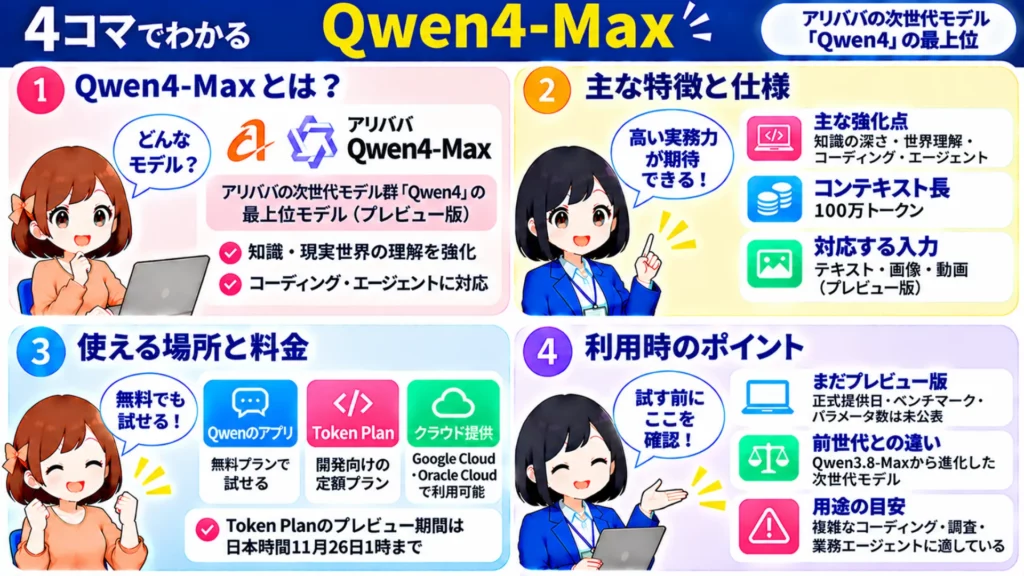
一方で、新しいモデルが登場するたびに、「Qwen3.8-Maxと何が違うのか」「どこでいくらで使えるのか」「業務で使っても問題ないのか」といった疑問を感じる方も多いのではないでしょうか。
そこで本記事では、Qwen4-Maxの概要や仕組み、特徴を整理しながら、使い方や料金、利用時の注意点について詳しく解説します。最後までお読みいただくことで、Qwen4-Maxがどのように設計され、どのような場面で力を発揮するのかが理解できるはずです。
\生成AIを活用して業務プロセスを自動化/
Qwen4-Maxとは
Qwen4-Maxは、アリババのモデル開発チームQwenが開発中の次世代モデル群「Qwen4」の最上位モデルです。
Qwenは2026年11月に「Qwen4 is coming」とQwen4の登場を予告し、同時にQwen4-Maxのプレビュー版を公開しました。正式版に先立つ、先行利用の位置づけです。
2026年9月に杭州で開かれたApsara Conferenceでは、Qwen4の学習状況と製品構想を紹介。基調講演で、新しいアーキテクチャのQwen4が当時すでに学習中であることが語られています。
会場取材によると、同じ場ではQwen4-Max・Qwen4-Flash・Qwen4-Plus・Qwen4-27Bの4つのモデル名が示されたとのこと。その時点では詳細な仕様は示されず、11月11日にQwen4-Maxのプレビュー提供が始まりました。
| 比較項目 | Qwen4-Max(プレビュー版) | Qwen3.8-Max(正式提供済みの旗艦) |
|---|---|---|
| 位置づけ | 次世代モデル群Qwen4の最上位 | Qwen3.8世代の最上位 |
| パラメータ数 | 公表されていない | 総2.4T・アクティブ95BのMoE型 |
| コンテキスト長 | 100万トークン | 100万トークン(QwenCloud版) |
| 最大出力 | 393,216トークン(思考と回答の合計) | ― |
| ベンチマーク | 公表されていない | 公開済み |
| 提供状況 | プレビュー版(Qwenのアプリ・Token Planなど) | 正式提供(API・Token Planなど) |
知識と世界理解を深めたフラッグシップ
Qwenは、Qwen4の強化点としてより深い知識と現実世界へのより豊かな理解を挙げています。知識と理解力の両面での向上を前面に押し出しています。
コーディングとエージェント能力を強化
もう一つの柱が、コーディングとエージェントの能力強化。単発の質問に答えるだけでなく、ツールを使いながら作業を進める場面を重視しています。
公式の仕様では、Function CallingやWeb検索などのツール呼び出し、JSON形式での構造化出力に対応。思考の深さはlow・medium・xhighの3段階から選べ、標準はxhighです。
実務のタスクを想定した設計
想定する用途として示されたのは、複雑なコーディング、知識労働やオフィス業務、フロントエンド開発、複雑なエージェント処理です。ベンチマークの点数よりも、現実の仕事をこなせるかを前面に出しているといえるでしょう。
発表と同時に無料でも試せる
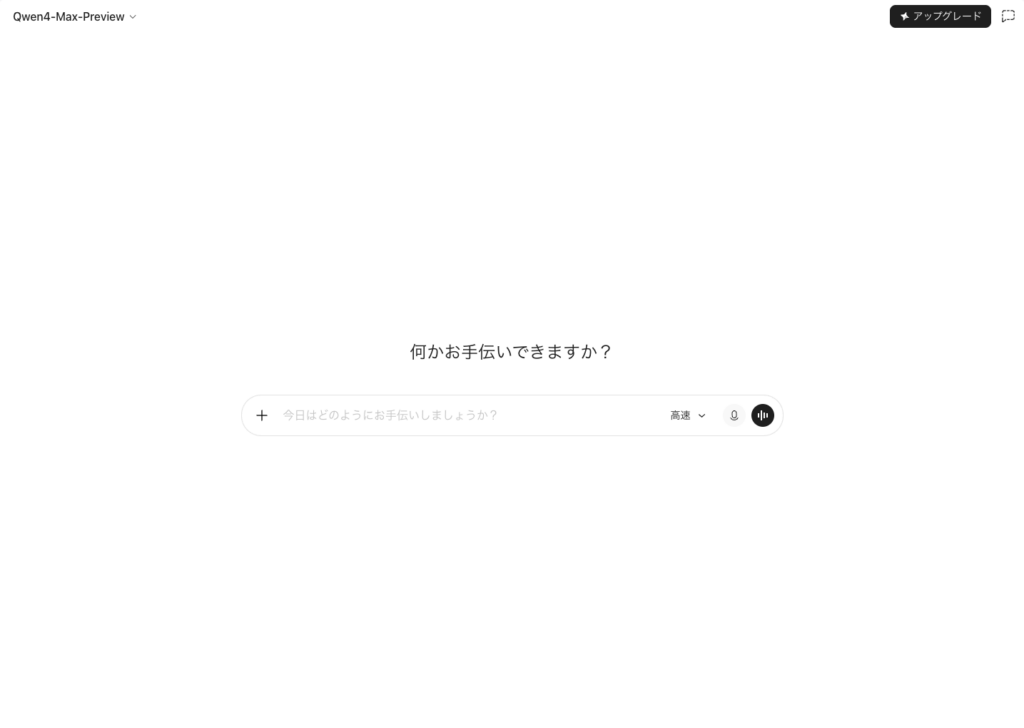
Qwen4-Maxは、Qwenのアプリ(Qwen Studioなど)で先行利用できます。無料プランでも試せるため、発表当日から手軽に触れる点は大きな魅力といえるでしょう。
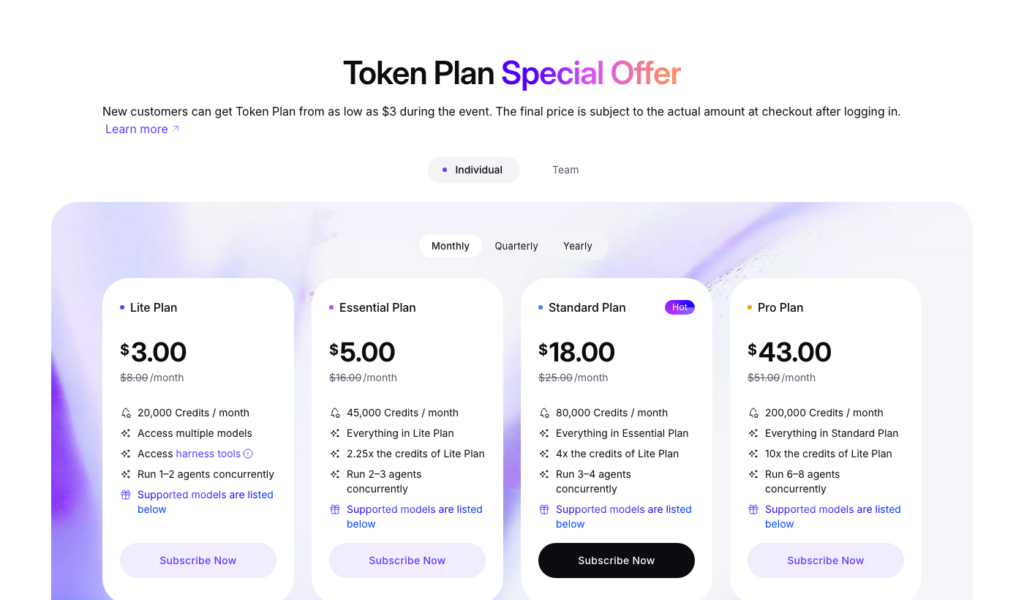
開発者向けには、Alibaba Cloudの定額プラン「Token Plan」や、エージェント製品の「QwenWork」「Qoder」からも利用可能。Claude CodeやCursorなどの外部ツールから呼び出せる点もポイントです。
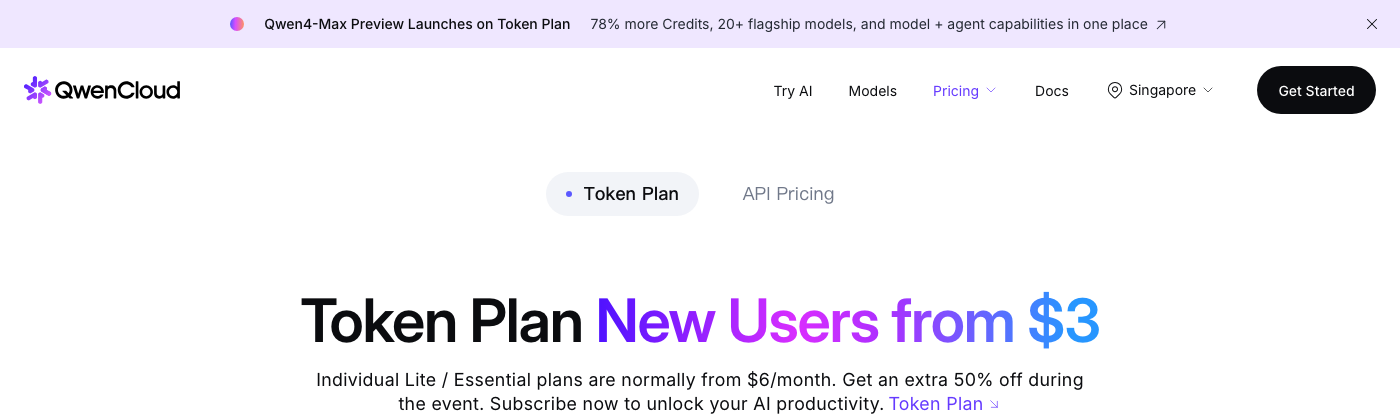
本記事執筆時点で新規登録ユーザーはLiteプランが3ドルで利用可能。
公開されている仕様と未公表の情報
公式の仕様ページでは、コンテキスト長100万トークン、最大出力393,216トークン、画像・動画の理解への対応が示されています。一方で、パラメータ数・ベンチマークスコア・正式提供の時期は、いずれも公表されていません。
内部構造を説明するモデルカードや技術レポートも確認できません。
Qwen4の一つ前の世代にあたる「Qwen3.8」について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Qwen4-Maxの仕組み
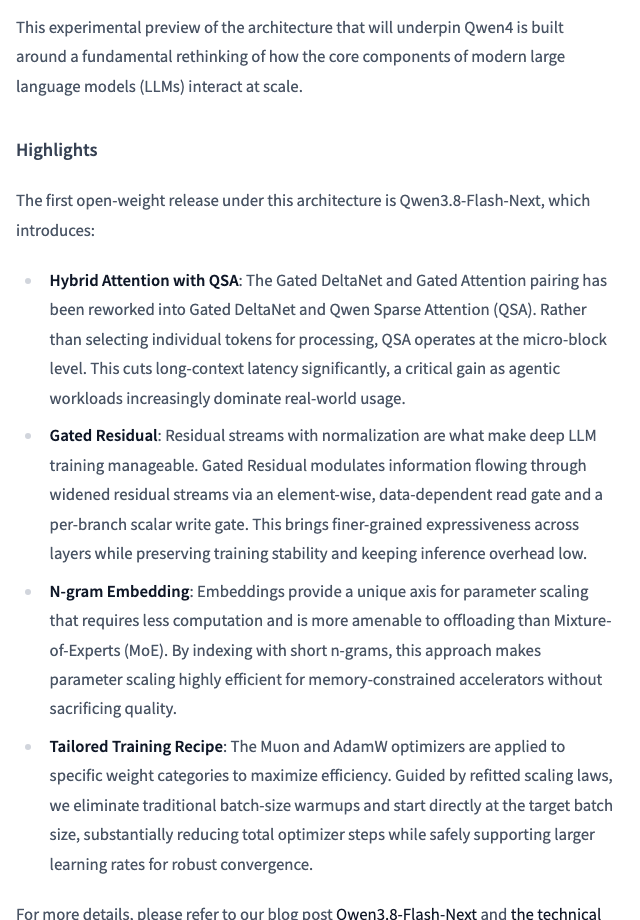
Qwen4-Max自体の内部構造は公開されていません。ただし、Qwen4世代の設計の一端は、2026年8月に公開された「Qwen3.8-Flash-Next」から読み取れます。
Qwen4の設計を先取りしたQwen3.8-Flash-Next
Qwen3.8-Flash-Nextは、Qwen自身が「Qwen4を支えるアーキテクチャの実験的なプレビュー」と位置づけるオープンウェイトモデルです。この新アーキテクチャで最初に重みが公開されたモデルになります。
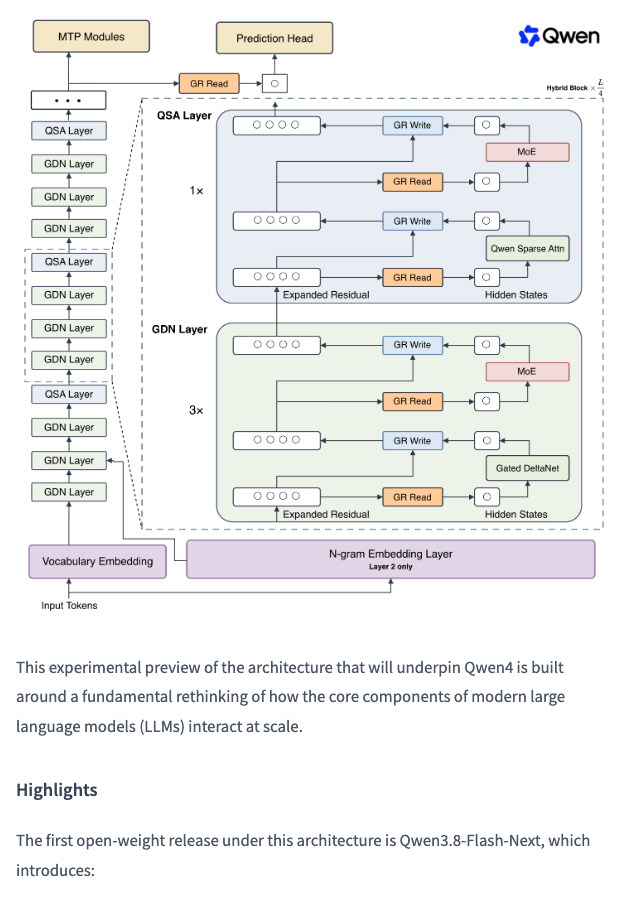
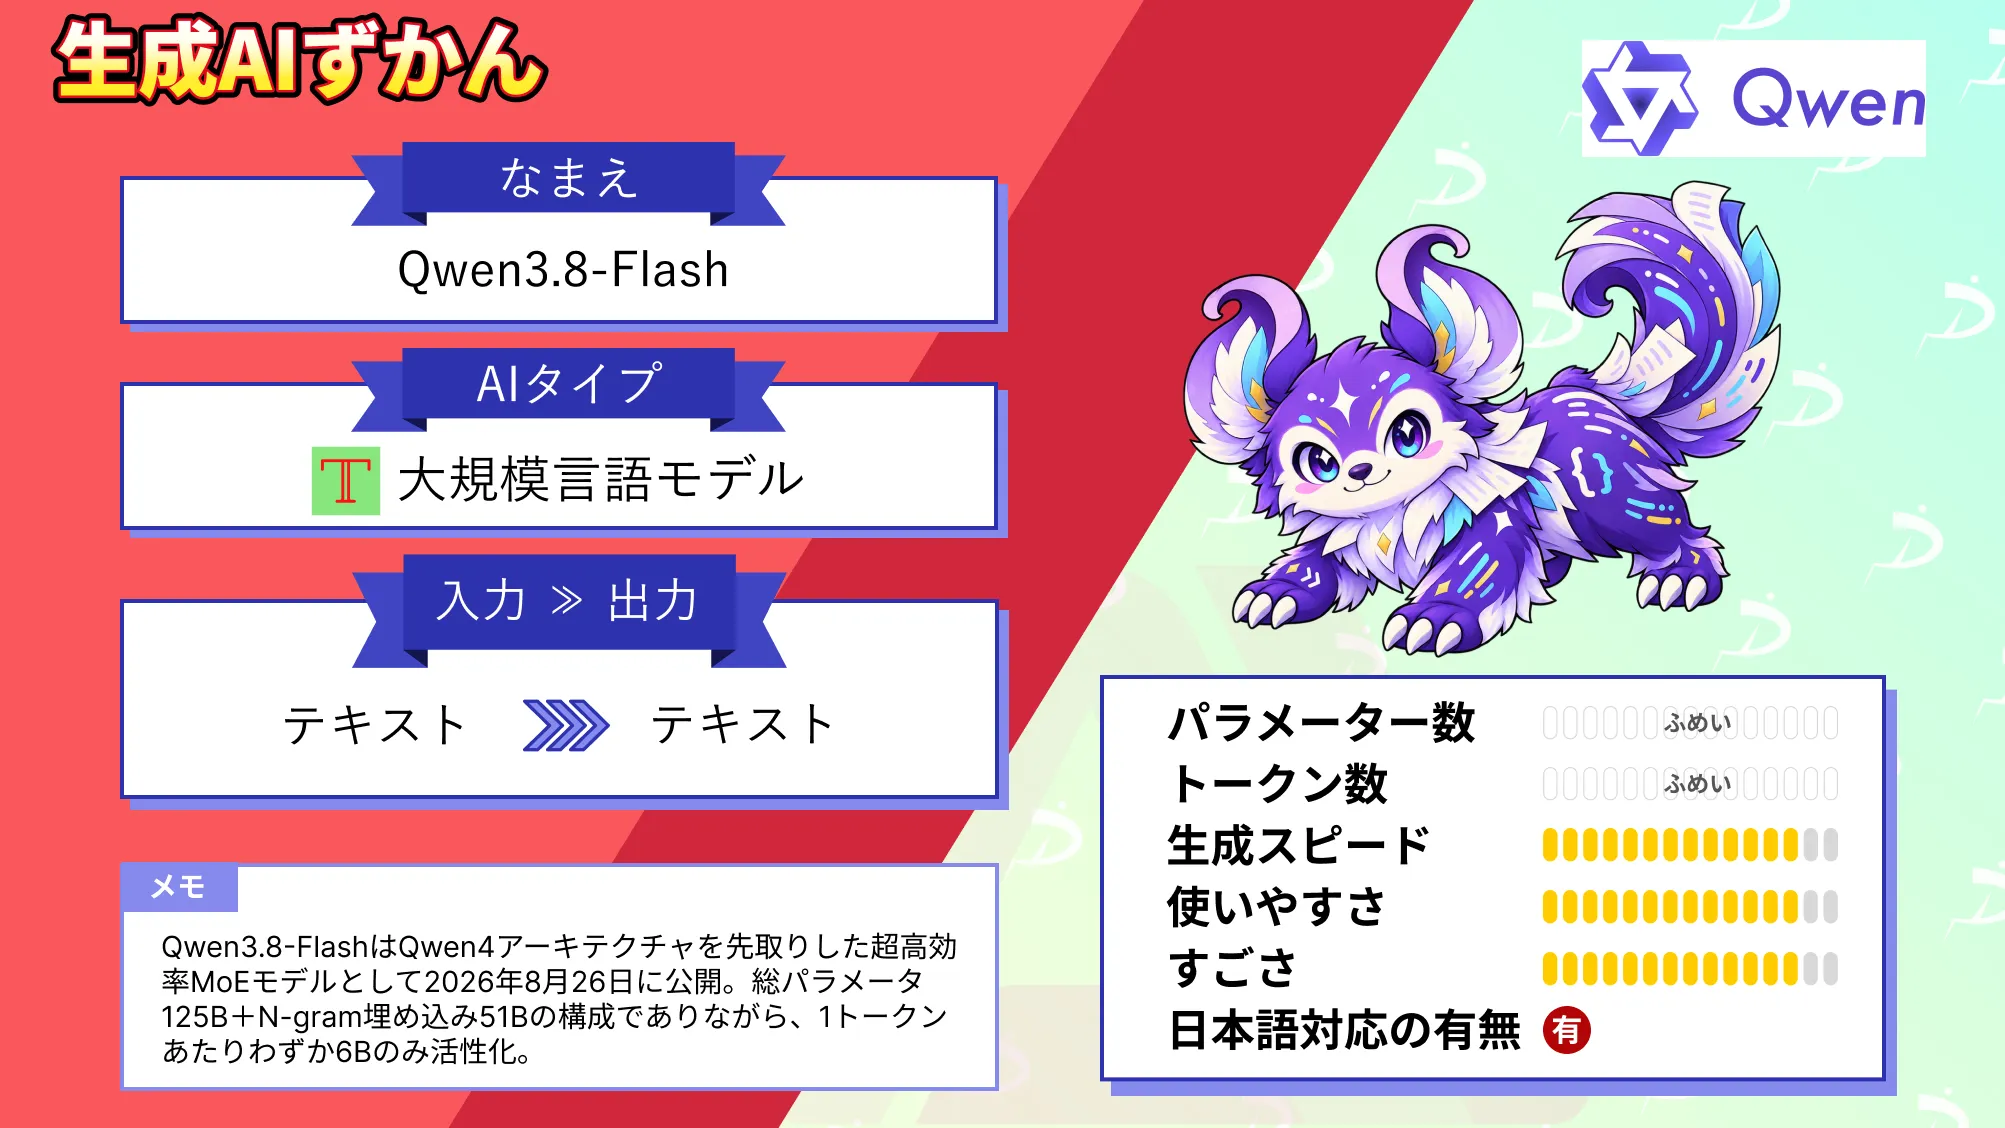
規模は本体125B(1,250億)のうち、1トークンあたり6Bだけを動かすMoE型。これとは別に、51BのN-gram埋め込みと4BのMTP(複数トークン予測)モジュールを持ちます。
4つの設計上の工夫
Qwen3.8-Flash-Nextで導入された主な工夫は、次の4つです。
| 工夫 | 内容 | ねらい |
|---|---|---|
| QSAによるハイブリッドアテンション | Gated DeltaNetと、細かなブロック単位で注目箇所を選ぶQwen Sparse Attention(QSA)を組み合わせる | 長い文脈を扱うときの遅延削減を狙う |
| Gated Residual | 層の間を流れる情報の読み書きをゲートで調整する | 表現力と学習の安定性の両立を図る |
| N-gram埋め込み | 短いトークンの並び(n-gram)を索引にした埋め込みを持つ | 少ない追加計算量でモデルの容量を増やす |
| 専用の学習レシピ | 重みの種類ごとに主にMuonとAdamWを使い分け、バッチサイズの設定も見直す | 学習の効率と安定性を高める |
ルーティング対象のエキスパートは512個で、1トークンごとに10個を選び、共有エキスパート1個も併用する仕組み。コンテキスト長は標準で262,144トークン、最大100万トークンまで拡張可能です。
現行の最上位Qwen3.8-Maxとの関係
Qwen4-Maxの比較対象となる、正式提供済みの旗艦がQwen3.8-Max。総パラメータ2.4T(2.4兆)、アクティブパラメータ95BのMoE型で、100万トークンのコンテキストに対応しています。
Qwen4-Maxとのパラメータ規模や、能力・効率の違いは明らかにされていません。長文脈の効率化と低コストでの拡張を狙ったQwen3.8-Flash-Nextの方向性が、どこまで最上位に引き継がれるかが注目点といえるでしょう。
Qwen3.8-Flash-Nextの製品版にあたる「Qwen3.8-Flash」に興味がある方は下記も参考にしてください。
Qwen4-Maxの使い方
Qwen4-Maxを試す方法は、大きくQwenのアプリで使う方法と、Token Plan経由でコーディングツールから使う方法の2つです。
Qwenのアプリで使う
手軽に試すなら、無料プランから始められるQwenのアプリがおすすめ。Web版での手順は次のとおりです。
Qwenの公式サイトを開きます。ブラウザで使う場合は「Qwen を試す」、アプリを使う場合は「ダウンロード」を選びましょう。
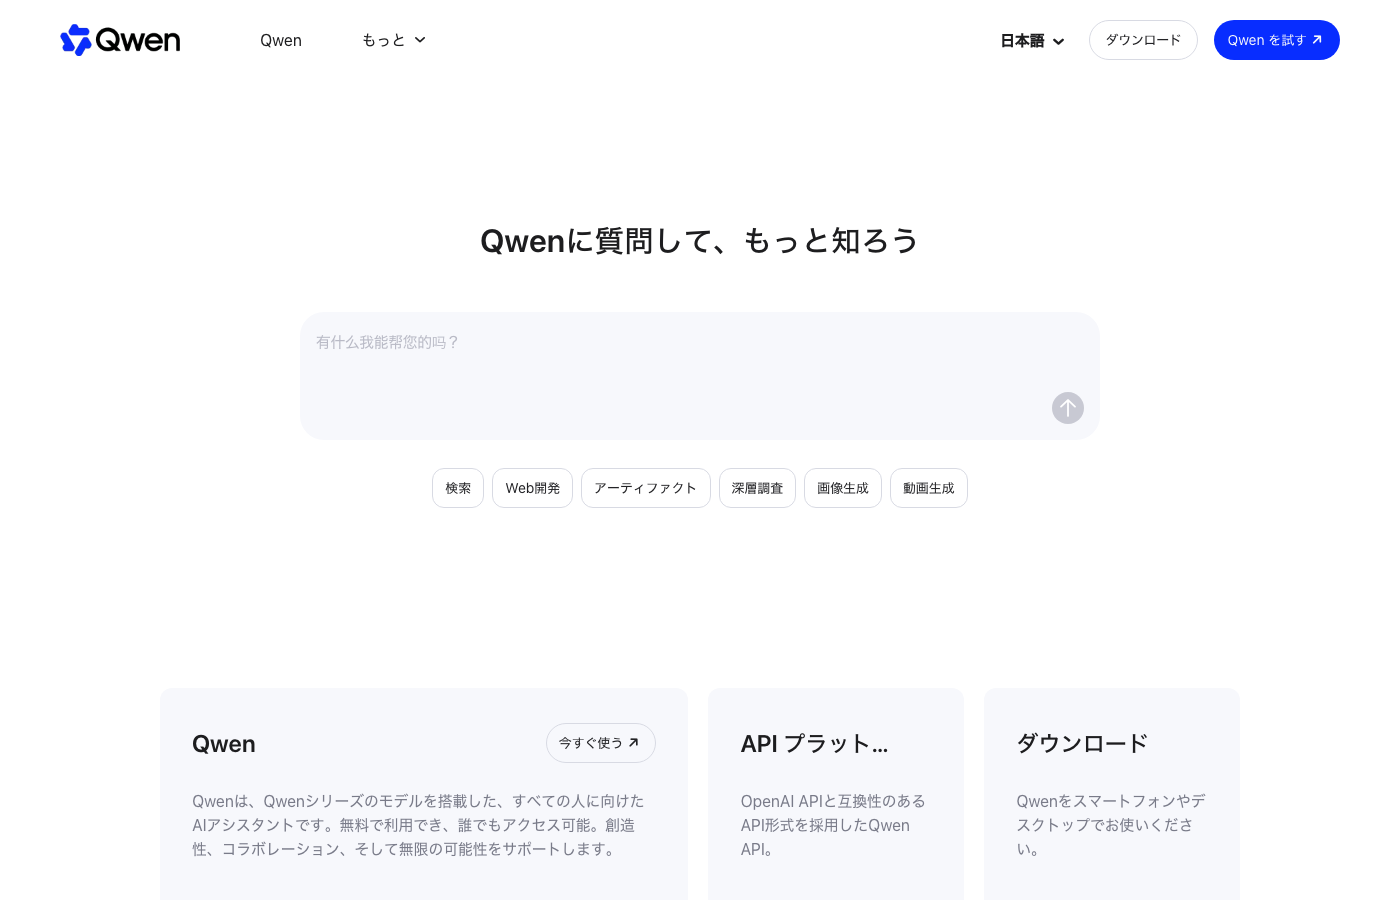
Web版では右上の「サインアップ」または「ログイン」からアカウントを用意します。アプリはWeb・Windows・macOS・iOS・Android向けに案内されています。
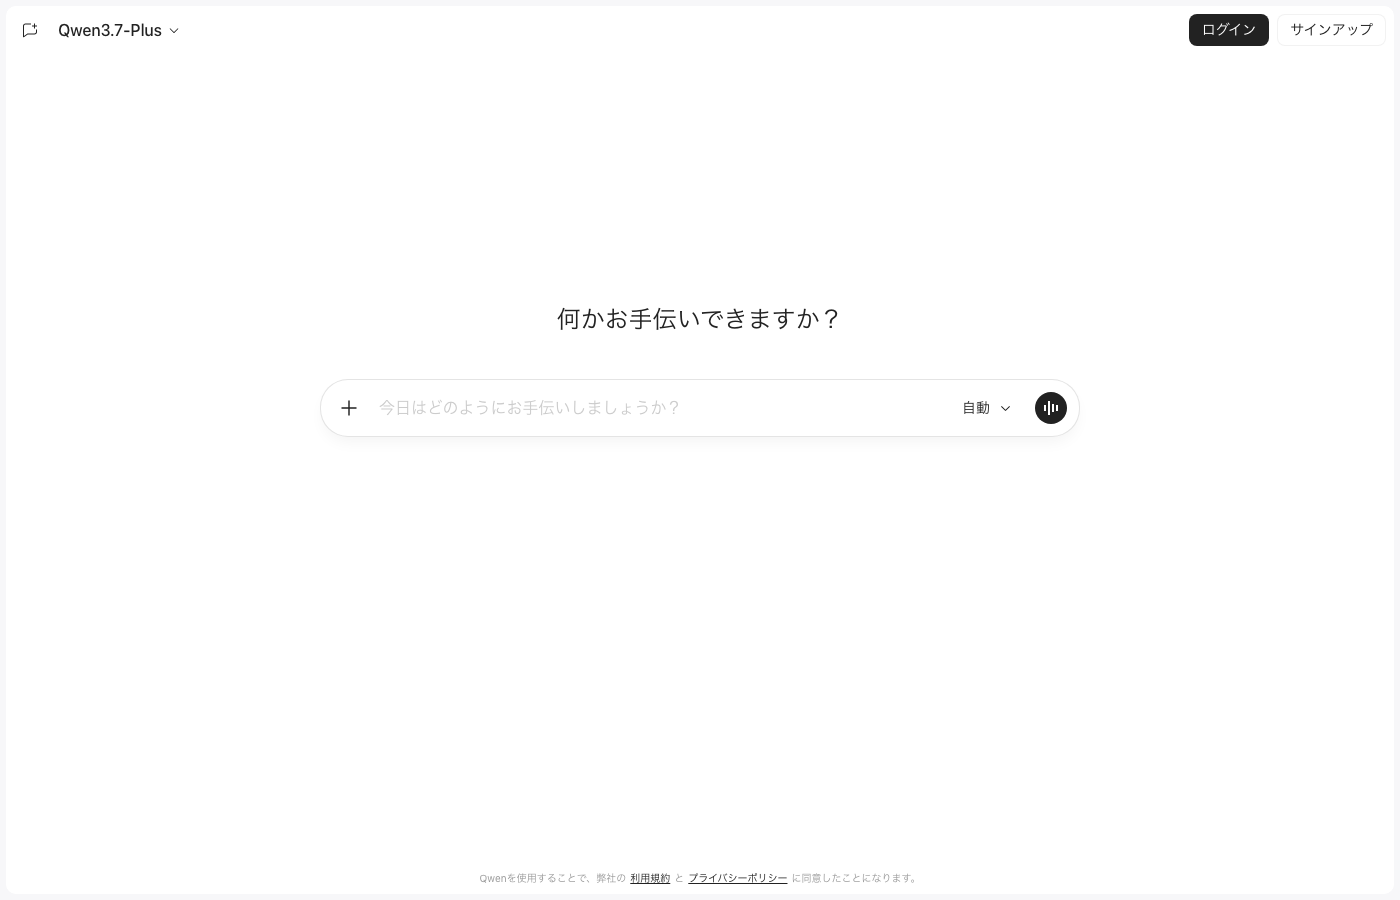
画面左上のモデル選択メニューを開き、「Qwen4-Max-Preview」を選びます。一覧では「最先端の性能を備えた、フラッグシップモデルQwen4 のプレビュー版」と説明されているモデル。
あとは入力欄に指示を書いて送信するだけです。
Token Plan経由でClaude Codeなどから使う
Token Planは、OpenAIとAnthropicの互換APIに対応したコーディングツールやエージェントツールから、Qwenなどのモデルを定額で使えるプランです。Claude Code・Cursor・Qwen Code・Codex・Clineなどが対応ツールとして挙げられています。
国際版のQwenCloud(Singaporeリージョン)の料金ページ(Pricing→Token Plan)で個人向けのプランを選び、契約しましょう。料金の詳細は後述の料金セクションで紹介します。
コンソールのAPIキーのページで、Token Plan用のAPIキーとBase URLを確認してください。キーは「sk-sp-」で始まり、通常のAPI用とは別のキー・接続先になる点に注意しましょう。
使うツールにBase URLとAPIキーを設定し、モデル名にqwen4-max-previewを指定します。Claude Code(導入済み)の場合は、Opusの枠にqwen4-max-previewを割り当て、モデルに「opus」を指定する形。
export ANTHROPIC_BASE_URL="https://token-plan.maas.qwencloudapi.com/apps/anthropic"
export ANTHROPIC_AUTH_TOKEN="(Token PlanのAPIキー)"
export ANTHROPIC_DEFAULT_OPUS_MODEL="qwen4-max-preview"
export ANTHROPIC_MODEL="opus"
claude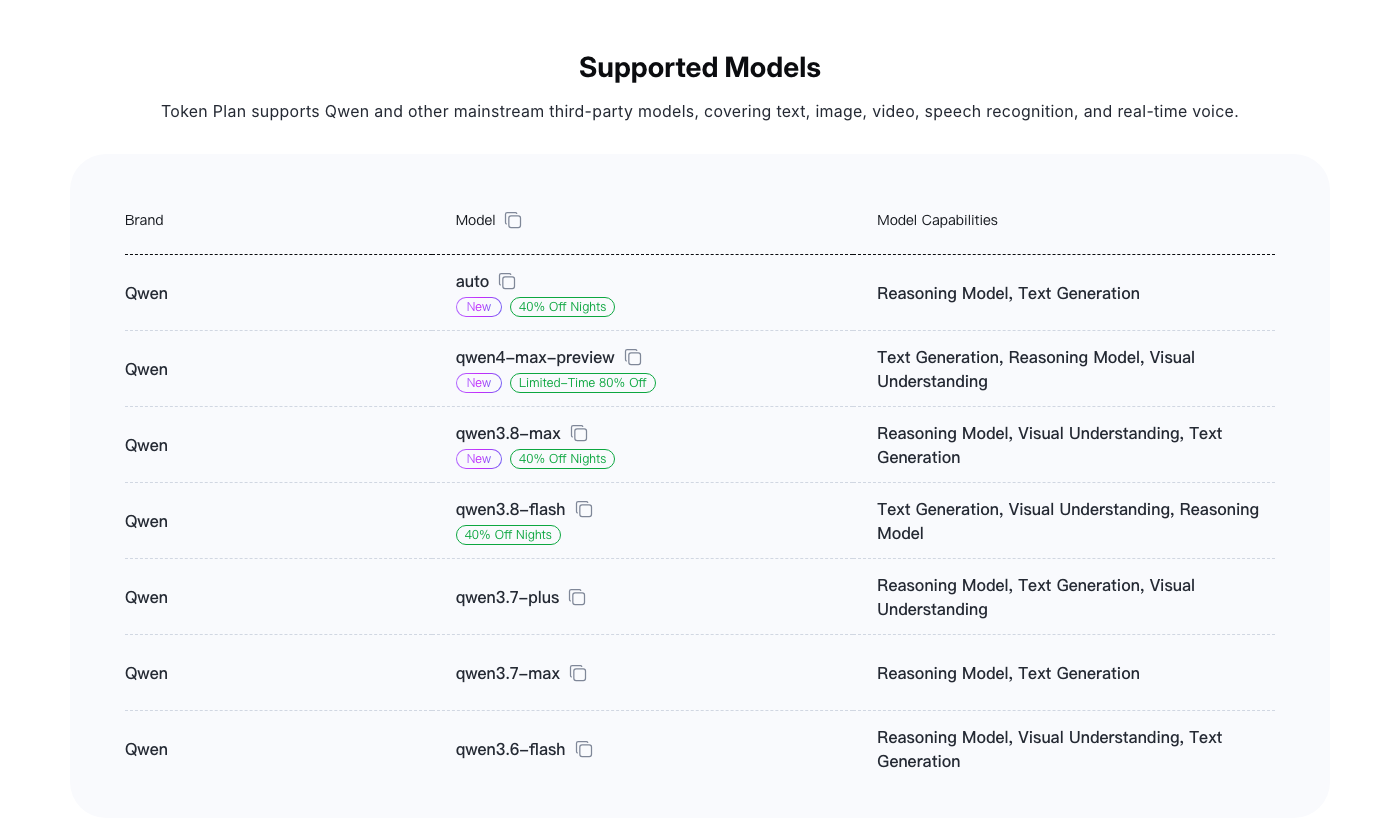
ターミナルで動くQwen公式のコーディングツール「Qwen Code」について、詳しく知りたい方は下記の記事をご覧ください。

【実践】Qwen4-Maxを実際に使って検証してみた!
ここでは、Qwen4-Maxのプレビュー版を使って、チャット・エージェントモード・Claude Codeの3つの方法で検証してみたいと思います。いずれも2026年11月11日に試した結果になります。
| 検証 | 使った環境 | 見たいこと |
|---|---|---|
| ①LPの作成 | Qwenのチャット(Qwen3.8-Maxと並べて比較) | フロントエンド開発の実力 |
| ②補助金のリサーチ | Qwenのエージェントモード | 調べものから資料作りまで任せられるか |
| ③既存コードの修正 | Token Plan経由のClaude Code | 複数ファイルにまたがるコーディング |
検証①チャットで整体院のLPを作る
まずは公式が想定用途に挙げるフロントエンド開発から。同じ指示を、前世代のQwen3.8-Maxと並べて送っています。
架空の整体院「ほぐしの森」のLPを1ページで作ってください。
ファーストビュー、施術メニュー3つ(料金つき)、お客様の声、予約ボタンを入れて、
スマホでも崩れないようにしてください。落ち着いた緑系の配色で。結果を比べると、Qwen4-Maxは完成までに倍近い時間がかかりました。Qwen3.8-Maxがすぐにコードを書き始めたのに対し、Qwen4-Maxはコードインタープリターを何十回も実行してからコードを書き出しています。
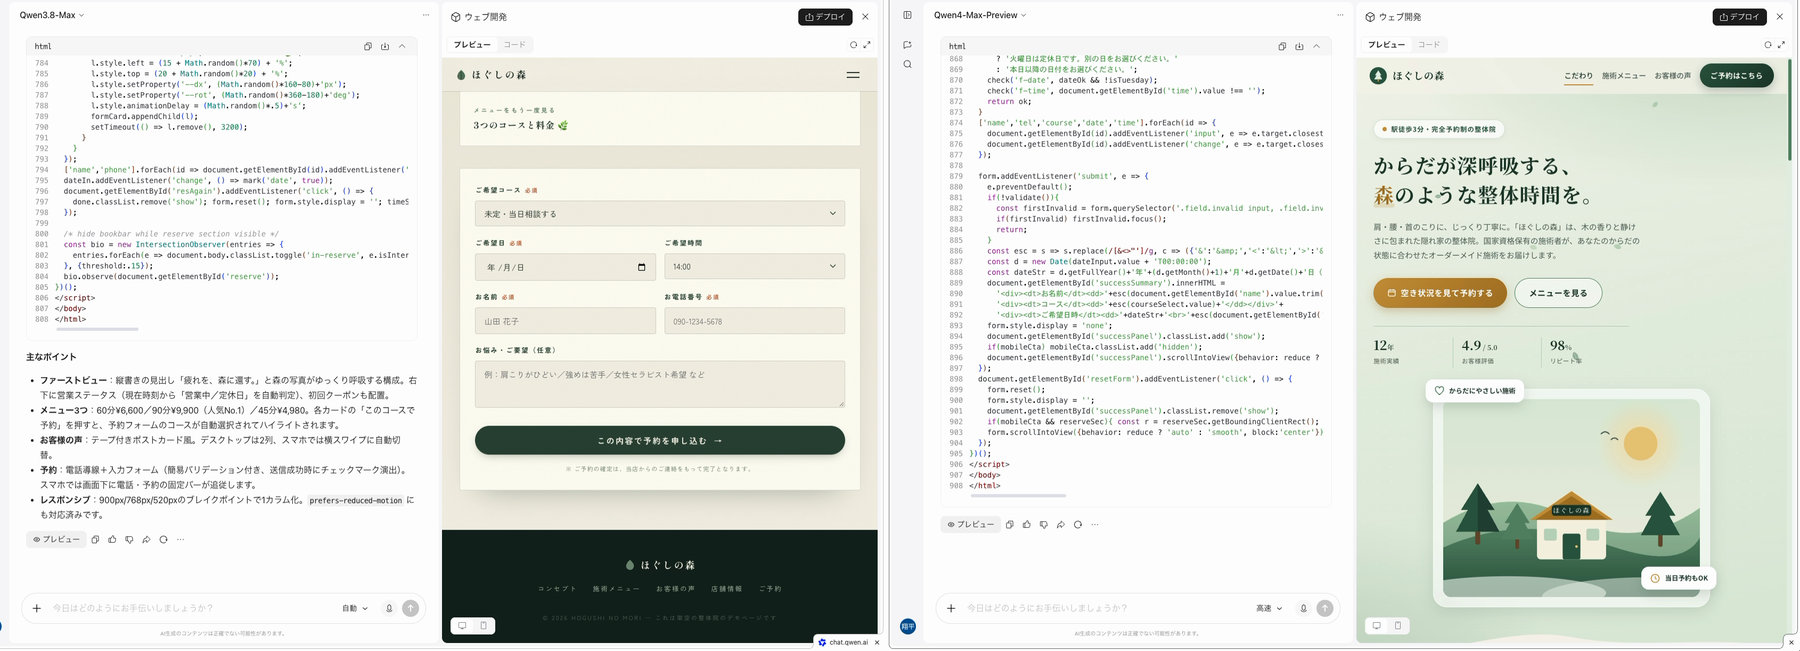
| 比較項目 | Qwen4-Max-Preview | Qwen3.8-Max |
|---|---|---|
| 完成までの時間 | 約17分 | 約9分半 |
| HTMLの行数 | 908行 | 808行 |
| 進め方 | コードインタープリターを繰り返し実行してから一気に出力 | 最初からコードを書き始める |
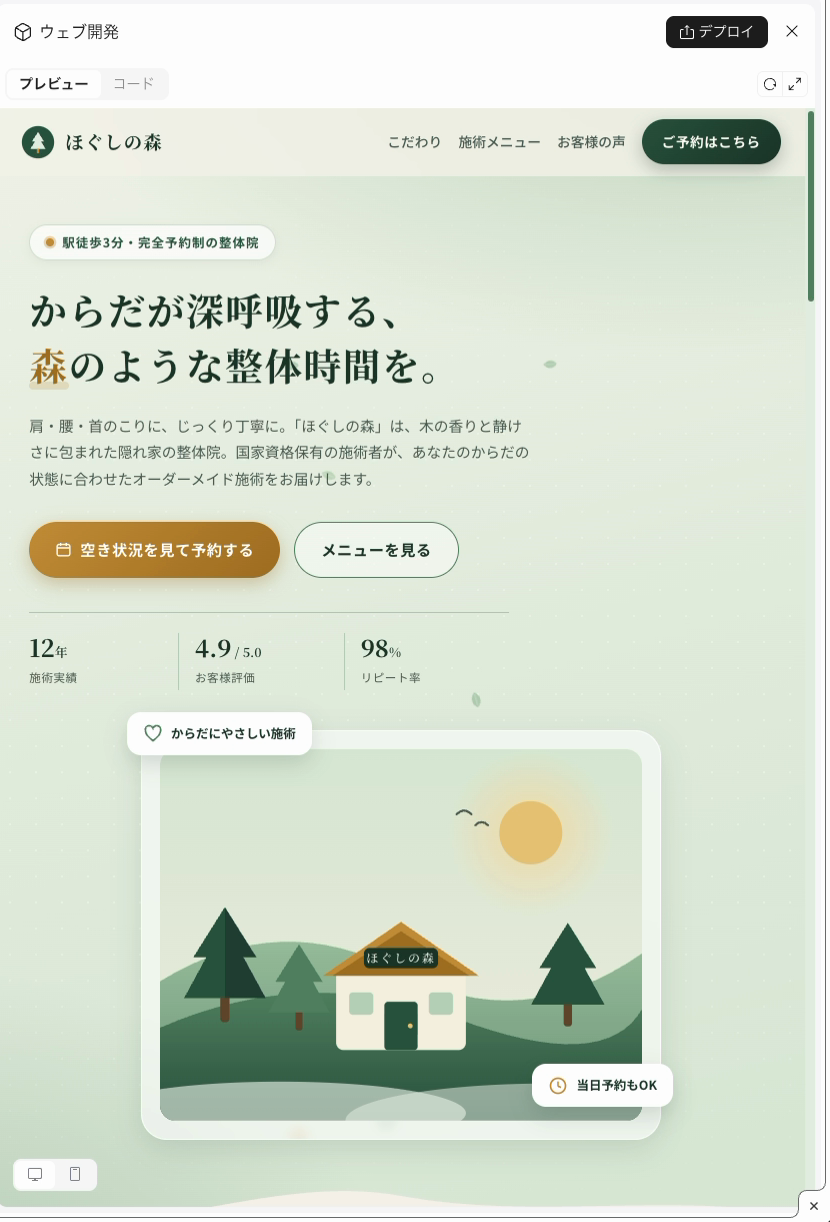
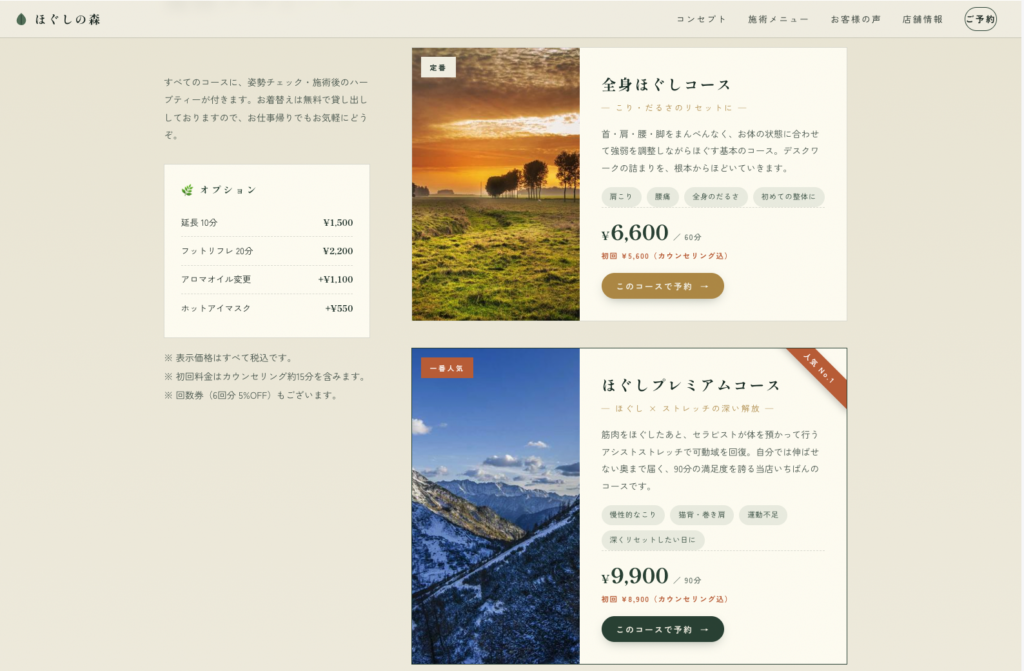
| 画像の扱い | 森と建物のイラストをSVGで自作 | 外部の写真素材を読み込む(整体院と関係のない写真も混ざる) |
| キャッチコピー | からだが深呼吸する、森のような整体時間を。 | 疲れを、森に還す。 |
出来上がったLPを見ると、Qwen4-Maxは緑系の配色とイラストで世界観が統一されていました。実績の数字や「当日予約もOK」のバッジまで入っており、そのまま提案のたたき台に使えそうな完成度。
一方のQwen3.8-Maxは、フォームや店舗情報まで作り込まれているものの、ビル群や雪山など整体院と関係のない写真が表示されていました。外部の写真素材をランダムに読み込む作りだったためと考えられます。
検証②エージェントモードで補助金を調べて比較表にまとめる
次は、調べものから資料作りまでを任せる知識労働の検証です。Qwenのチャットで「エージェントモード」をオンにし、次の指示を送っています。
2026年に中小企業が使えるAI導入向けの補助金・助成金を調べて、
対象・上限額・申請期限を比較表にまとめ、最後に「どれから検討すべきか」を3行で提案して。Qwen4-Maxは、検索と公的機関のページの読み込みを自分で何度も繰り返しました。中小機構や厚生労働省のページを読み、情報が揃ったところで比較表のファイルを作り始めています。
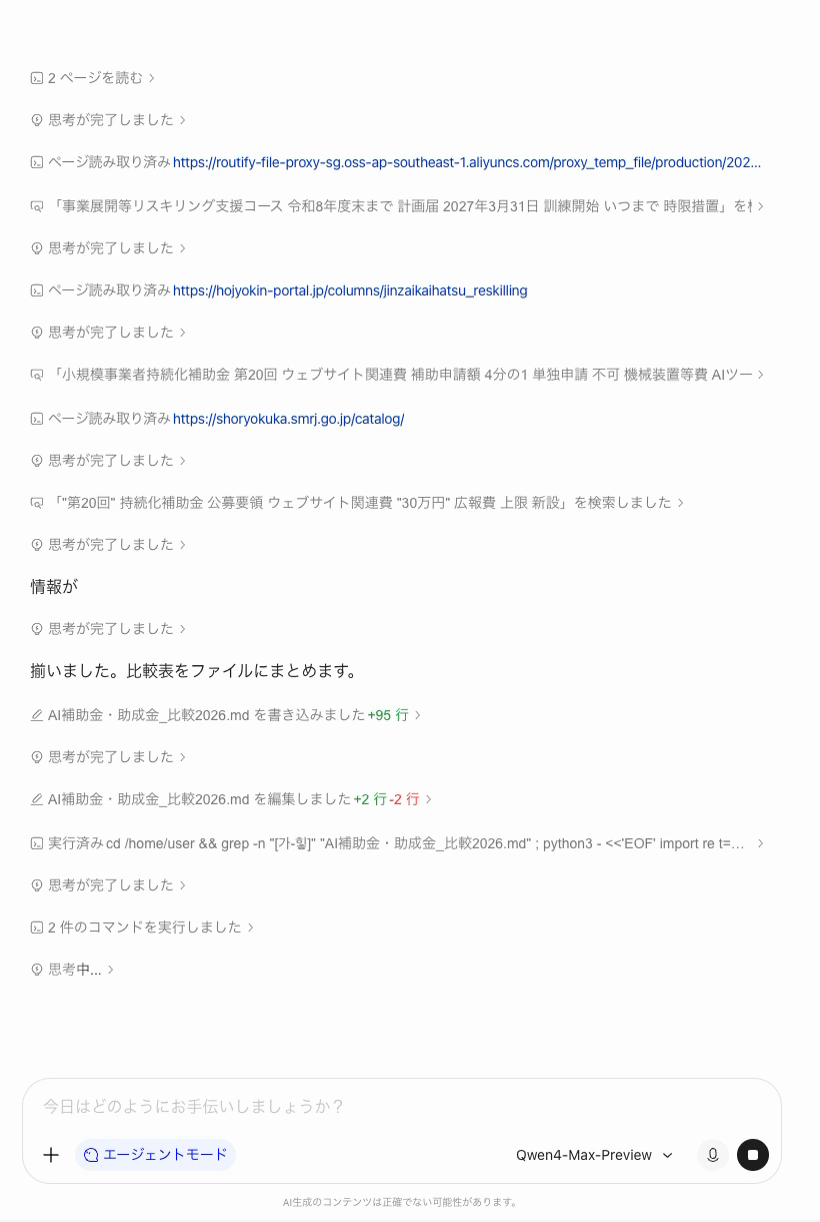
ファイルを書いたあとには、grepやPythonのコマンドで自分の書いた内容を点検する動きもありました。指示から完成までは約8分です。
出来上がったのは、ワークスペースに保存されたMarkdownファイル「AI補助金・助成金_比較2026.md」。中身は次の4部構成でした。
- ツール・設備の導入に使う補助金の比較表
- 研修・リスキリングに使う助成金の比較表
- 近い順に並べた締切カレンダー
- 用途別の選び方
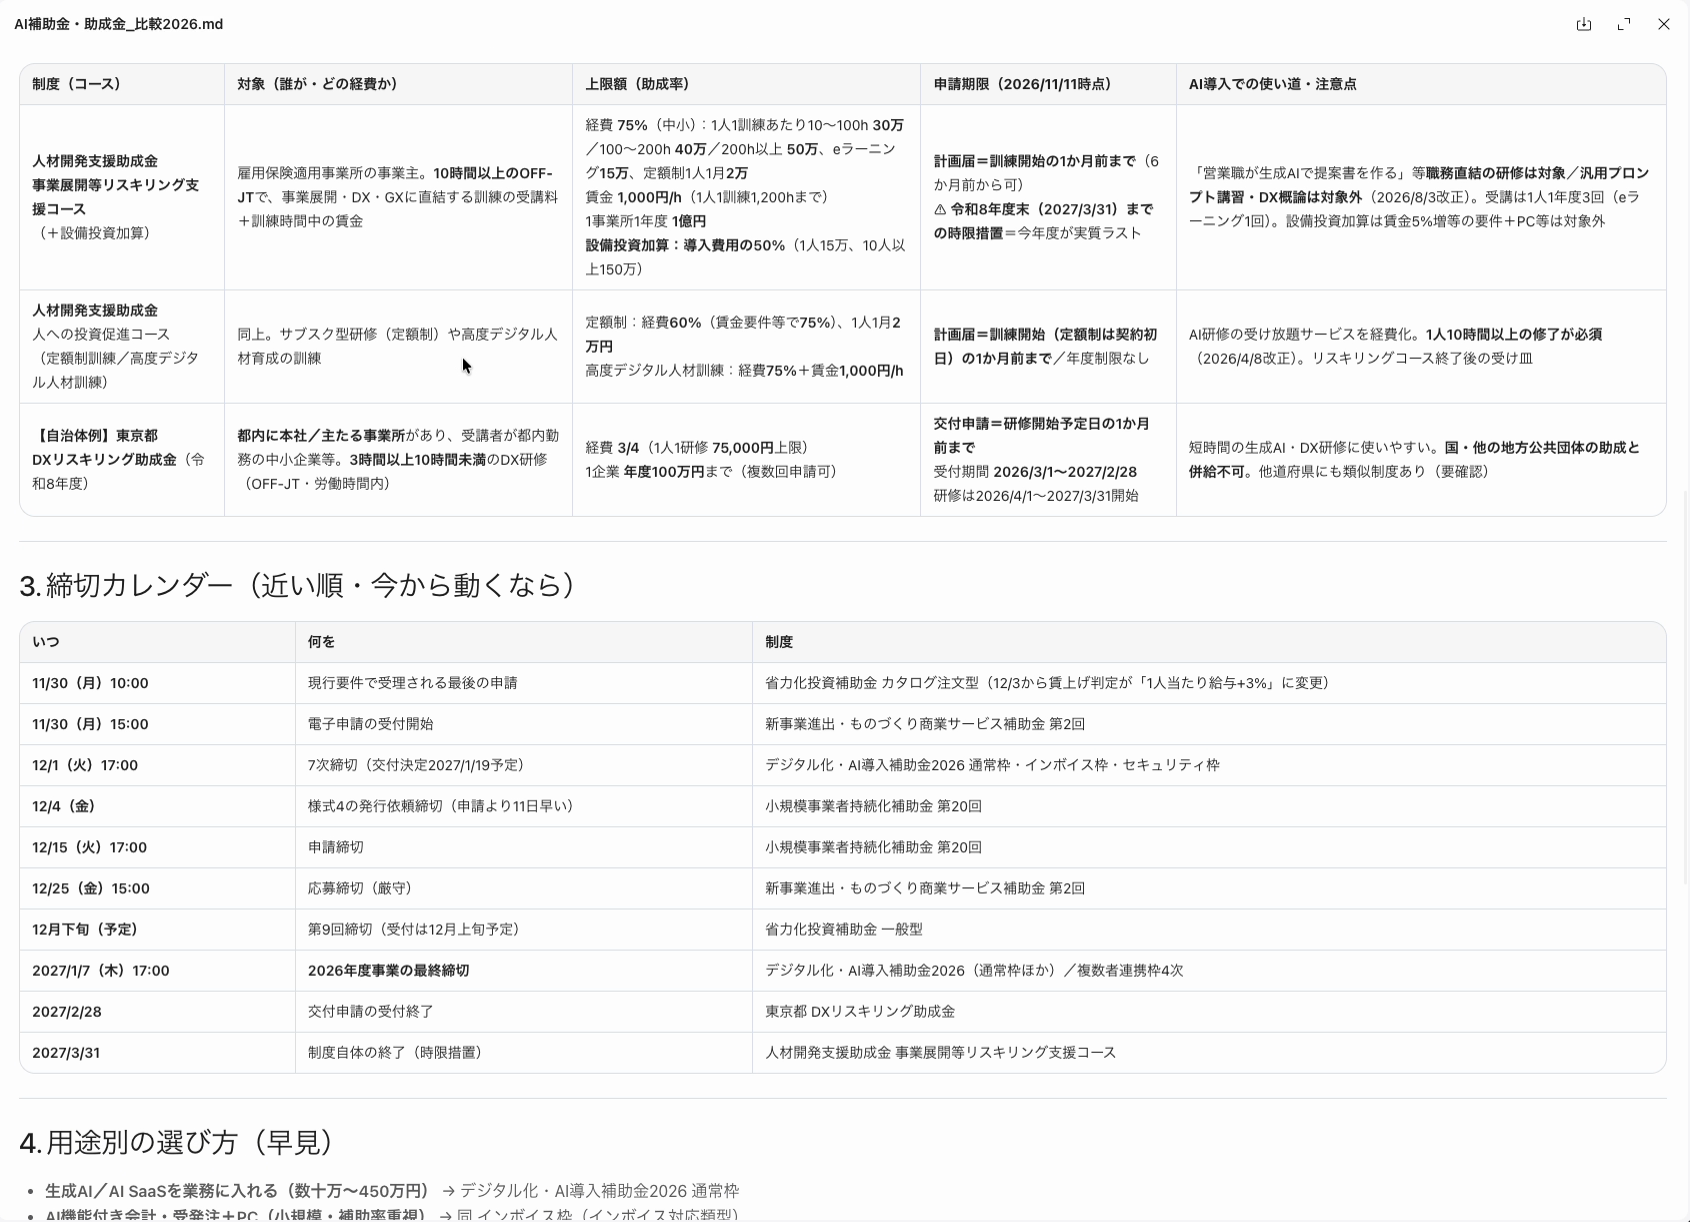
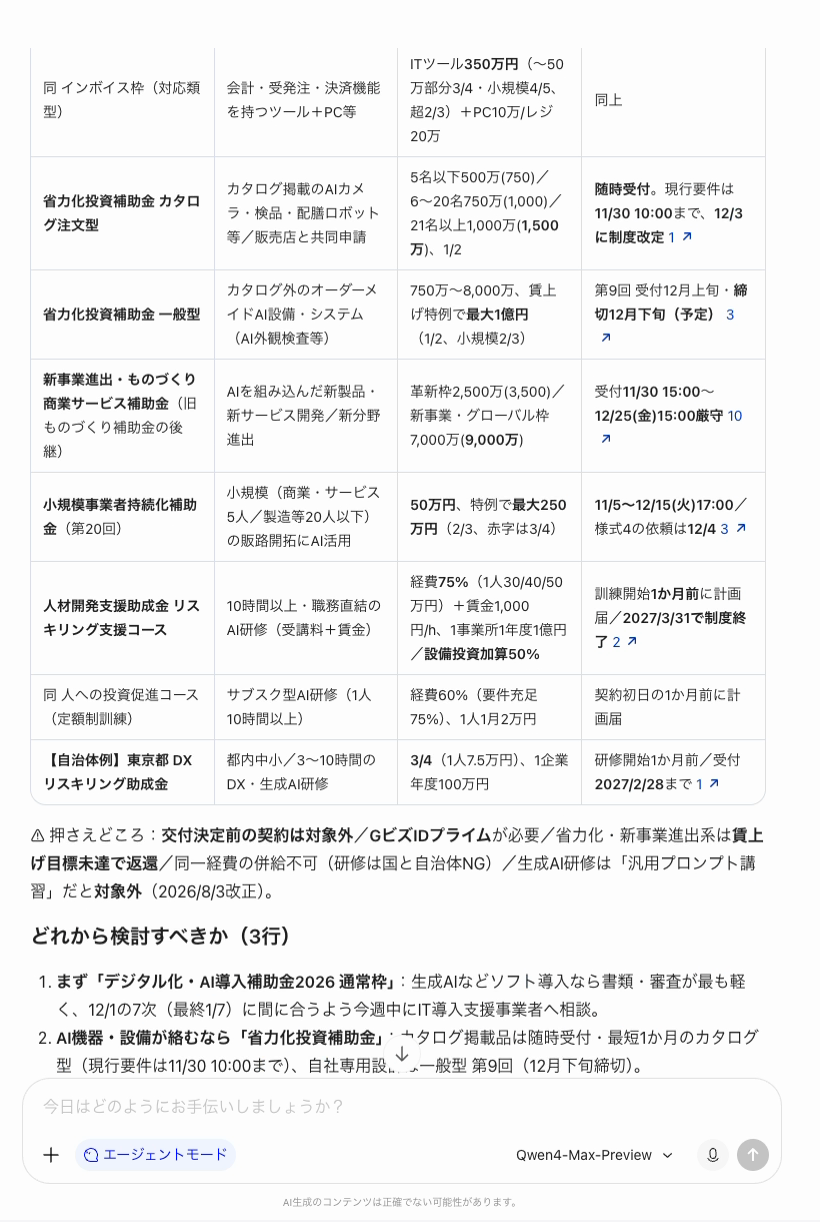
チャットの回答では、表の要点に加えて「交付決定前の契約は対象外」「GビズIDプライムが必要」といった注意点と、指示通り3行の提案もまとめてくれました。表の各行には出典へのリンクも付いています。
検証③Claude Codeから既存コードにCSV出力を追加する
最後は、Token Plan経由でClaude CodeからQwen4-Maxを呼び出し、既存のコードを修正させる検証です。題材には、支出の追加・一覧・月別集計ができる小さな家計簿CLI(Python・テスト22件)を用意しました。
この家計簿CLIに、結果をCSVファイルに書き出す機能を追加して。
- list と summary の両方に --csv <出力先パス> オプションを付ける
- Excelで開いても日本語が文字化けしないようにする
- 既存の構成とコードスタイルに合わせて実装する
- テストも追加して、最後に python -m pytest -q を実行して全部通ることを確認して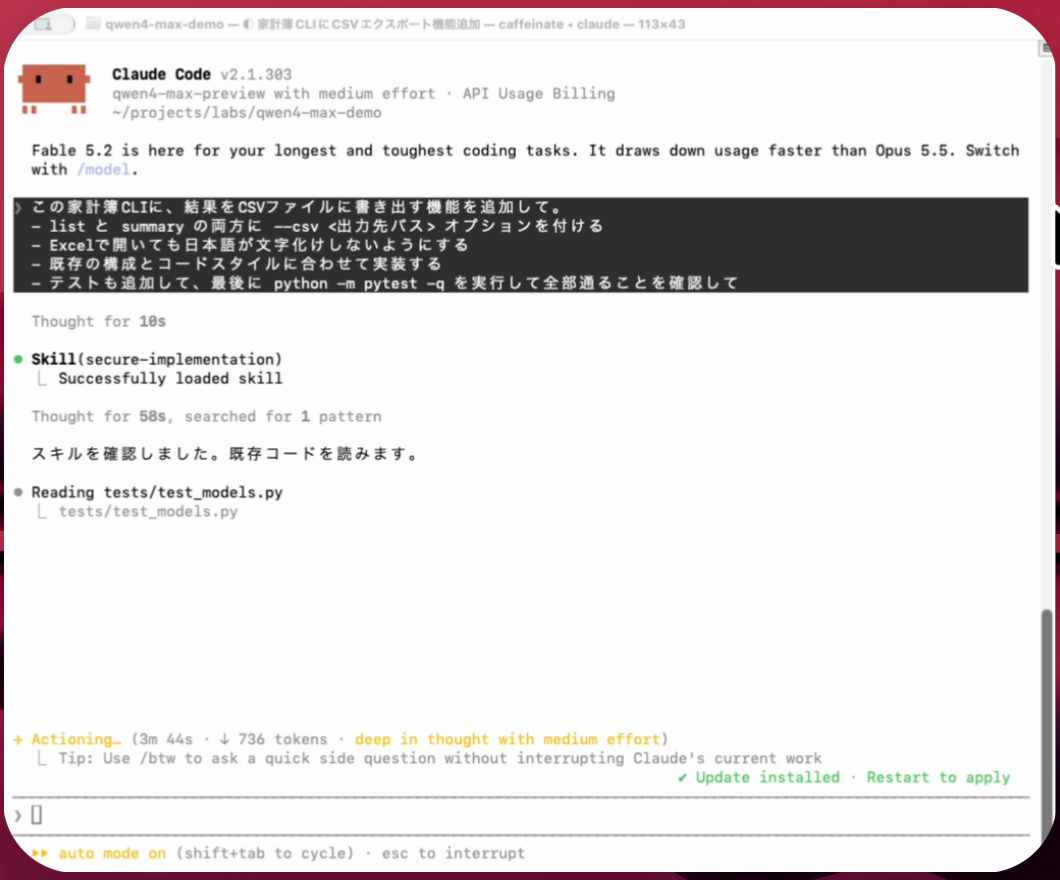
Qwen4-Maxは、最初の3〜4分を既存コードの読み込みと方針決めに使いました。全11ファイルを読んでから設計をまとめ、集計の処理(report.py)と引数の処理(cli.py)に分けて修正しています。
途中、追加したテストのうち2件が失敗する場面もありました。原因は「-100円」で始まるメモがオプションと誤認されたことと、CSVを読み込む際の改行の扱いで、どちらもQwen4-Maxが自分で原因を突き止めて直しています。
| 見たところ | 結果 |
|---|---|
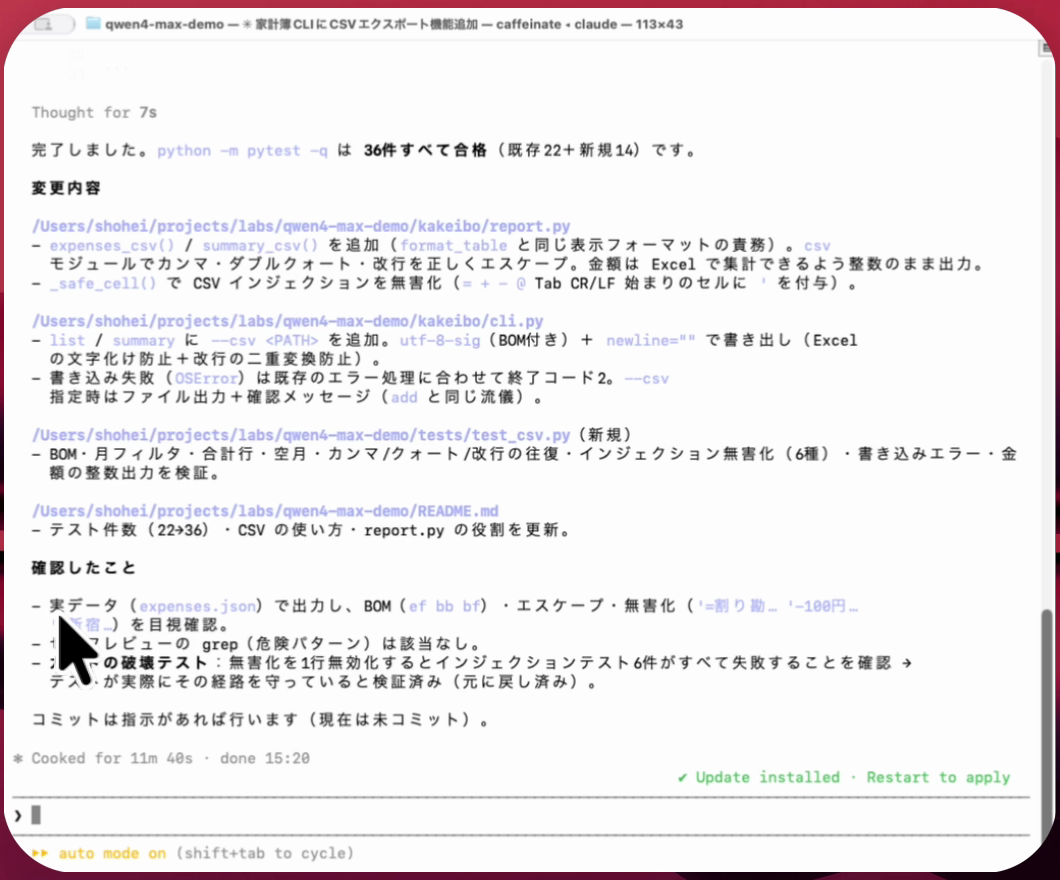
| 完了までの時間 | 11分48秒 |
| 修正したファイル | report.py・cli.py・README.mdの3つと、テストファイル1つを新規作成 |
| テスト | 既存22件+新規14件の36件すべて合格 |
| クレジットの消費 | Liteプランの残量が99.9%→99.5%(月20,000クレジットのうち約0.4%) |
| 文字化け対策 | BOM付きUTF-8(utf-8-sig)で書き出し |
| CSVの書き方 | csvモジュールでカンマ・ダブルクォート・改行を正しくエスケープ |
| CSVインジェクション対策 | 「=」「-」「@」などで始まるセルの先頭に引用符を付けて無害化 |
印象的だったのは、テストが通ったあとの確認の丁寧さです。危険なコードのパターンを検索し、実データでCSVを書き出して中身を確かめるところまで自分で行っていました。
さらに、CSVインジェクションの対策をわざと1行だけ外し、関連するテスト6件がすべて失敗することを確かめてから元に戻しています。
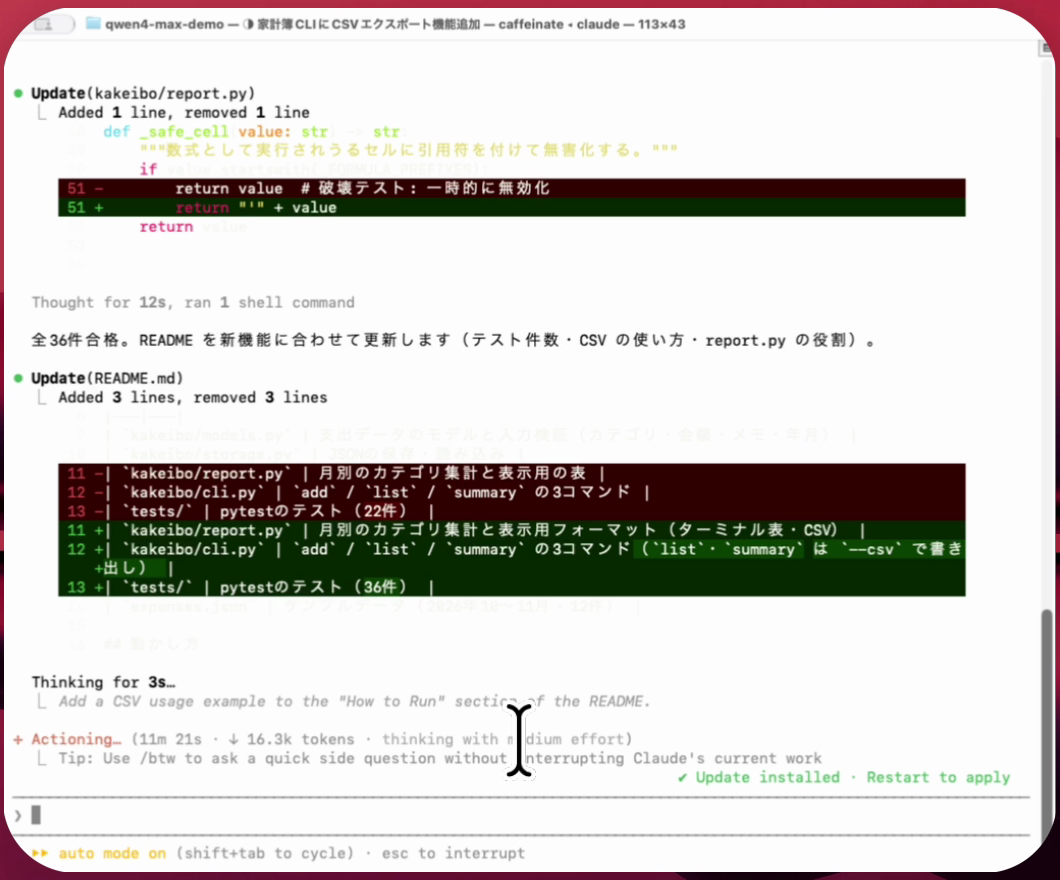
それでも、読み込んだ手順を最後まで省略せずに実行し、変更内容と確認したことを日本語で分かりやすく報告してくれました。
12分近く動かして使ったクレジットは、Liteプランの月間枠の約0.4%。プレビュー期間中の割引(通常の20%の消費)が効いている状態とはいえ、月3ドルからのプランでもこの規模の修正を月に約250回こなせる計算です。
検証のまとめ
3つの検証を通して、Qwen4-Maxは速さよりも、手順を踏んで仕上がりの質を上げるタイプのモデルという印象を受けました。
| 検証 | かかった時間 | よかった点 | 気になった点 |
|---|---|---|---|
| ①LPの作成 | 約17分 | イラストまで自作し、世界観が統一されたLPになった | Qwen3.8-Maxの倍近く時間がかかる |
| ②補助金のリサーチ | 約8分 | 公的機関のページを読み、出典つきの比較表と締切カレンダーまで作った | 内容の正しさは人が公式サイトで確かめる必要がある |
| ③既存コードの修正 | 約12分 | 失敗したテストを自力で直し、36件すべて合格させた。クレジット消費はLiteの約0.4% | 最初の3〜4分は読み込みと方針決めで画面が動かない |
すぐに答えが欲しい作業より、多少待ってでも完成度を上げたい作業に向いているといえるでしょう。
Qwen4-Maxの料金とライセンス(商用利用の可否)
Qwen4-Maxは、Qwenのアプリの各プランか、Token Planの範囲内で使う形で、QwenCloudでのAPI利用はToken Plan経由に限られ、本記事執筆時点ではまだ従量課金には対応していません。
Qwenのアプリのプラン
Qwenのアプリには、無料プランのほかにLite・Plus・Proの3つの有料プランがあります。プランによって、使えるモデルやエージェント機能の利用枠が変わる仕組み。
| プラン | 月額 | 備考 |
|---|---|---|
| 無料 | 0円 | Qwen4-Maxのプレビュー版を試せる |
| Lite | 690円 | モデルやエージェント機能の利用枠が広がる |
| Plus | 2,890円 | Qwen Codeでも契約を利用できる |
| Pro | 16,800円 | Qwen Codeでも契約を利用できる |
※料金は2026年11月11日時点の日本のApp Store(Qwenアプリ)の表示価格と報道にもとづきます。購入経路によって異なる可能性があるため、最新の金額はアプリ内の表示で確認してください。
Token Planの料金
Token Planは、アプリのプランとは別契約のQwenCloudの定額プラン。1つの契約で、QwenのほかDeepSeekやGLMなど対応一覧に載った複数のモデルに接続できるのが特徴です。
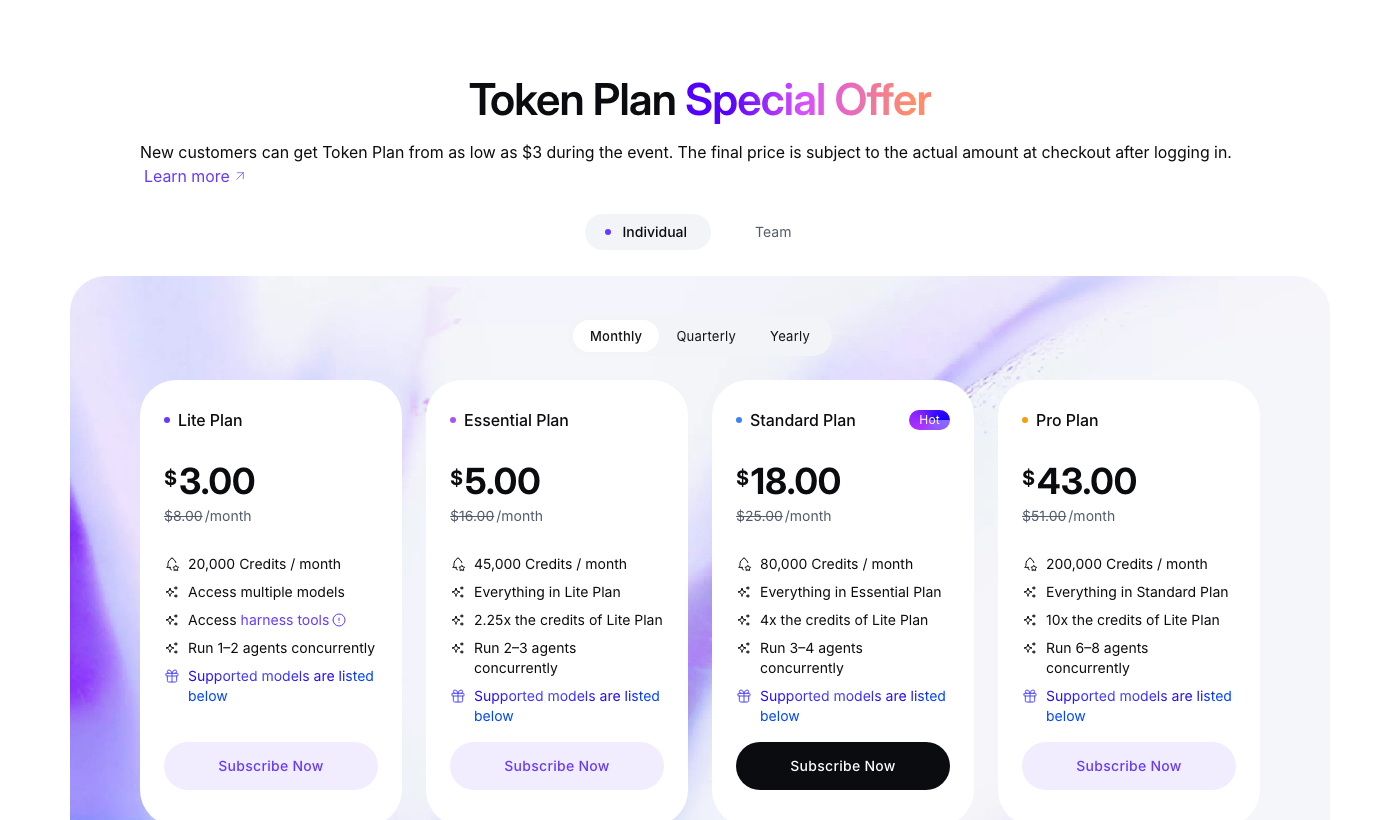
| プラン | 月額 | 新規ユーザー価格 | 月間クレジット | 同時に動かせるエージェント |
|---|---|---|---|---|
| Lite | 6ドル | 3ドル | 20,000 | 1〜2 |
| Essential | 10ドル | 5ドル | 45,000 | 2〜3 |
| Standard | 18ドル | ― | 80,000 | 3〜4 |
| Pro | 43ドル | ― | 200,000 | 6〜8 |
個人版を購入したことのないアカウントは、2026年11月30日23時59分(UTC+8)までLiteを月額3ドルから契約可能。
プレビュー期間中の優遇
Token PlanでのQwen4-Maxのプレビュー期間は、2026年11月11日10時から11月25日24時まで(UTC+8)です。日本時間では11月11日11時から11月26日1時までにあたる計算。
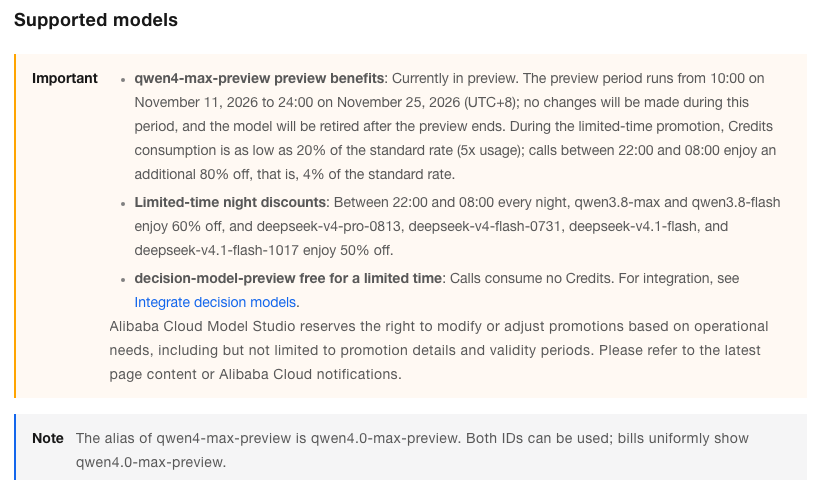
期間中のクレジット消費は最低で通常の20%(同条件なら5倍使える計算)まで抑えられ、22時から8時(UTC+8)はさらに80%オフとなり、通常の4%まで下がります。日本時間なら23時から翌9時が対象。
ライセンスと利用上の注意点
本記事執筆時点で、Qwen4-Maxの一般向けの重み公開は確認できず、重みに適用するライセンスも確認できませんでした。アプリやToken Planの利用には各サービスの規約が適用されるため、商用利用を検討する場合は事前に規約と提供元への確認が必要です。
なお、Token Plan個人版には利用規約上の制約があります。主なものは次のとおり。
| 項目 | 内容 |
|---|---|
| 利用できる場面 | コーディングツールやエージェントツールでの対話的な利用に限られる |
| 禁止されている使い方 | 自動化スクリプト、自社アプリのバックエンドなど非対話的な自動呼び出し |
| 入力・出力データ | 個人版はサービス改善とモデル最適化に使われると記載(Team版は学習に使わないと明記) |
| アカウント | 他人との共有は禁止で、1アカウントにつき個人版1契約(自分の複数端末での利用は可能) |
Qwenの最上位モデルのプレビュー版が以前どのように提供されたかに興味がある方は、Qwen3.6-Max-Previewについての下記も参考にしてください。
【業界別】Qwen4-Maxの活用シーン
Qwen4-Maxは、コーディング・フロントエンド開発・知識労働といった実務での利用を想定したモデル。ここでは3つの業界での活用シーンを紹介します。
ソフトウェア開発
ソフトウェア開発では、複数ファイルにまたがる修正やテストの実行など、手順の長い作業にAIを活用することが考えられます。ただ、途中で文脈を見失うと、手戻りが大きくなりがち。
Qwen4-Maxはエージェント能力とプロの開発ワークフローを重視して開発されました。Token Plan経由でAPIキーと接続先を設定すれば、Claude CodeやQwen Codeなど使い慣れたツールから試せる点は導入のしやすさにつながるでしょう。
AIを開発工程に組み込む「AI駆動開発」について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Web制作・フロントエンド開発
Web制作では、例えばデザイン案から動く画面のたたき台を作る用途が考えられます。修正のたびにエンジニアの手を借りる体制だと、確認のサイクルが遅くなる場合もあるでしょう。
Qwen4-Maxの想定用途には、フロントエンドの設計・構築が明記されています。LPや管理画面のたたき台をQwen4-Maxに作らせ、人が仕上げる分担が考えられるのではないでしょうか。
自然言語の指示でアプリや画面を作る「バイブコーディング」に興味がある方は下記も参考にしてください。
コンサルティング・企画などの知識労働
コンサルティングや企画の仕事では、調べもの・分析・資料作成を支援する用途が考えられます。情報を集めて整理する工程は、担当者の負担になりやすい部分。
Qwen4-Maxは知識の深さと現実世界への理解の強化をうたい、オフィス業務などの知識労働を想定用途に含めています。エージェント製品のQwenWorkと組み合わせれば、リサーチから資料のたたき台作りまで任せられる可能性があります。
業務へのAIエージェント導入の進め方について、詳しく知りたい方は下記の記事をご覧ください。
Qwen4-Maxに関するXの話題
プレビュー版の公開直後から、X上では実力を試した感想や他モデルとの比較が投稿されていました。ここではその一部を紹介します。
こちらは、Qwen4-Max-Previewのフロントエンド能力を他のモデルと比べた投稿です。DeepSeek-V4.1-Flashより明らかに進歩している一方、GPT-6 Astraとはまだ差があるという評価でした。
Token PlanやQoderでのプレビュー公開を伝えつつ、Qwen4-Maxの実力がどの程度なのかを問いかける投稿もありました。ゲームの評価がQwen4-Flashより低い理由を気にする声も見られます。
一方で、実際に触ったうえで「強化学習が足りていない感じ」と厳しめに評価する日本語の投稿もありました。「Previewの名に偽りなし」とあるように、正式版での改善に期待する見方といえるでしょう。
生成AIなどのご相談はWEELへ!
Qwen4-Maxを活用することで、コーディングやリサーチなど手順の長い実務をAIに任せられる範囲が広がる可能性があります。一方で、プレビュー版のモデルは提供期間や利用条件が限られるため、業務での使いどころを見極める小さな検証から始めることも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
Qwen4-Maxのよくある質問