ベクトルデータベースとは?仕組みとChatGPT・生成AIでの活用方法をわかりやすく解説
- ベクトルデータベースは文章や画像の特徴を数値で保存し、近い情報を探すデータ基盤
- 社内資料を検索して回答に使うRAGなど、生成AIの活用を支える仕組み
- 無料・ローカルでの試行と、検索条件を変えた検証が導入判断の出発点
ベクトルデータベースは、文章や画像の特徴を数値の並びで保存し、意味や特徴が近い情報を探すためのデータ基盤です。社内資料を検索して生成AIの回答に使うRAGでも利用されます。
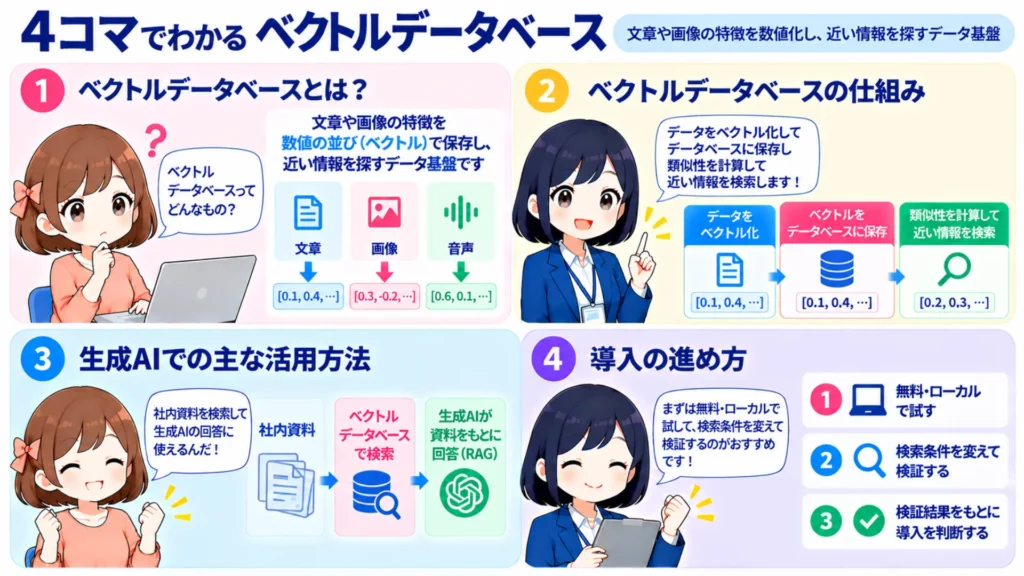
ただ、導入するだけで必要な情報を正しく取り出せるとは限りません。この記事では仕組みと既存データベースとの違いを整理し、製品の選び方や無料・ローカルで試す方法を解説します。検索条件を変えた実測結果から、自社で検証する際の着眼点も確認できます。
\生成AIを活用して業務プロセスを自動化/
ベクトルデータベースとは?
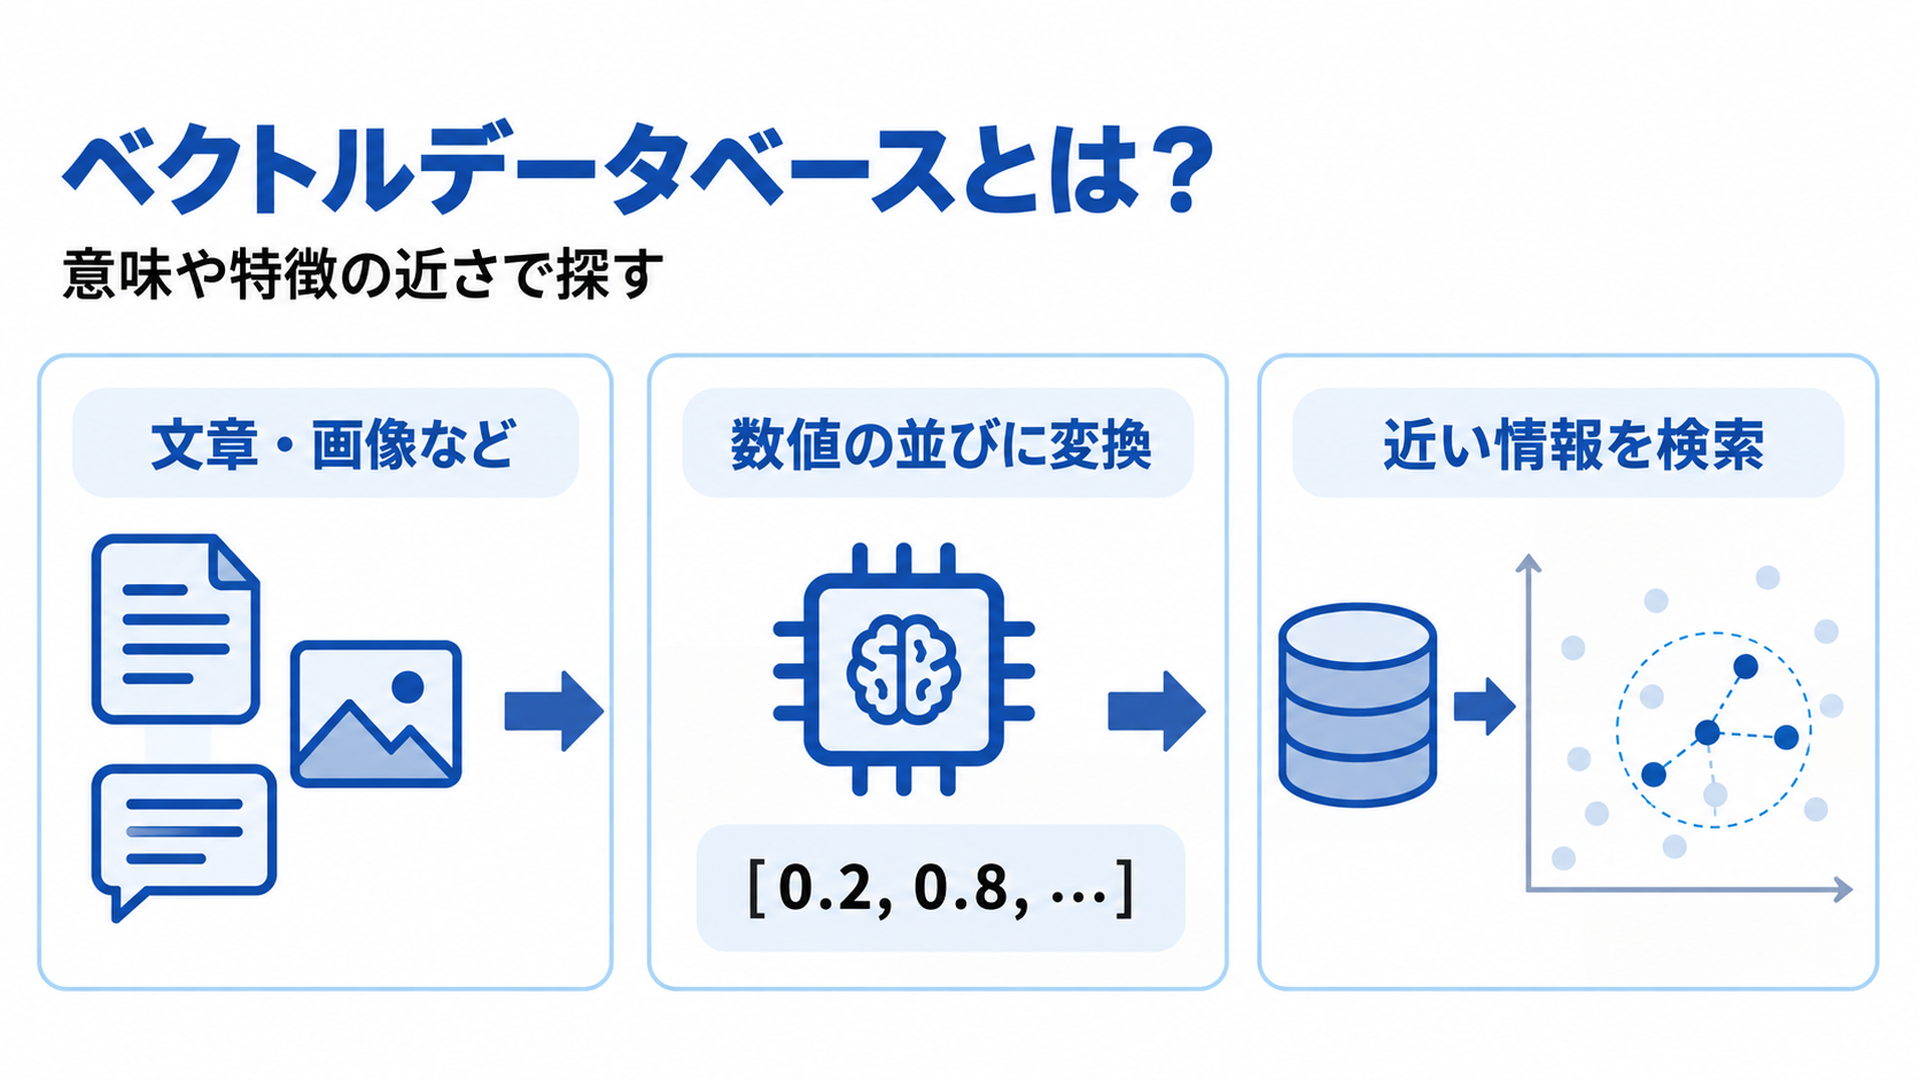
ベクトルデータベースとは、その名の通り、ベクトルという数学的概念を用いてデータを管理するデータベースシステムのことを指しています。
この説明だとわかりにくいと思うので、ベクトルデータベースの特徴を以下にまとめました。
| 項目 | 特徴 |
|---|---|
| 高次元データの処理能力 | 大規模なデータセットや高次元のベクトルデータを効率的に処理できます。 |
| 類似性検索の高速性 | データ間の類似度を計算し、最も似ているアイテムを迅速に検索できます。 |
| スケーラビリティ | データ量の増大に対しても性能を維持しやすい設計がなされています。 |
| リアルタイム処理 | クエリに対する応答時間が短く、リアルタイムでのデータ分析が可能です。 |
| 非構造化データのサポート | テキスト、画像、音声などの非構造化データを数値ベクトルに変換して取り扱うことができます。 |
| 柔軟なデータ構造 | 様々なタイプのデータを一定の形式に変換せずに扱うことができます。 |
| 機械学習との統合性 | 機械学習モデルが生成するベクトル表現をそのまま利用してデータの保存、検索、分析が行えます。 |
これらの性能によって、ベクトルデータベースは多様なAIアプリケーションにおいて、中心的な役割を果たしています。
ベクトルデータベースについてもう少し詳しく説明するために、以下ではベクトルとデータベースに分けてそれぞれの意味を解説していきます。
ベクトルとは
ベクトルとは、高校数学でも習うように、大きさと向きを持つ量を表すためのものです。多次元空間内での位置関係や特徴を表現することができ、その性質を利用してデータ間の類似性などを計算します。
具体的には、機械学習やデータ分析の領域でよく用いられています。例えば、商品やユーザーの特徴を多次元のベクトルで表現し、それぞれのベクトル間の角度や距離を計算することで、類似度を測定します。これにより、高度な検索や推薦などのタスクが可能となります。
身近な応用例だと、AmazonやYouTubeのレコメンドシステムにも使われています。
YouTubeの場合、1つ動画を見たら、その動画の関連動画が出てくると思います。これは、動画1つ1つをベクトルに見立てて、システムが「似ているか否か」を判定し、「似ている」と判定された動画たちが表示されているのです。
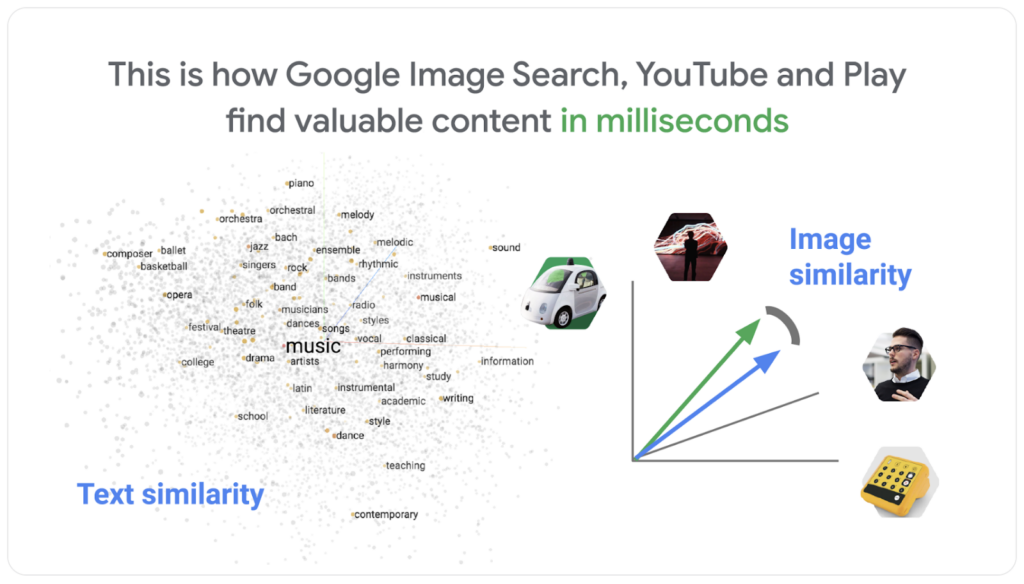
ベクトルデータベースは、こうしたベクトルの特性を活かし、YouTubeの動画のような高次元データや非構造化データも、効率よく格納し、処理することが可能になります。
データベースとは
データベースは「データを効率的に管理、検索、分析するためのシステム」を指しています。ちなみに、データとは「情報そのもの」のことです。
ここでは、データベースとデータの違いについても解説しておきます。ベクトルデータベースにおける「データ」と「データベース」の違いを理解するには、基本的な概念を把握することが重要です。
データ(Data)
| 項目 | 内容 |
|---|---|
| 定義 | データは、情報の基本的な単位です。これは、数字、テキスト、画像など、様々な形で存在できます。 |
| ベクトルデータベースにおける役割 | ベクトルデータベースでは、データはしばしばベクトル形式に変換されます。この変換は、非構造化データ(例えばテキストや画像)を数値ベクトルに変換し、これをデータベースで効率的に処理することを可能にします。 |
データベース(Database)
| 項目 | 内容 |
|---|---|
| 定義 | データベース(DBと略されることが多い)は、データを整理・保存し、アクセスするためのシステムです。これはデータの集合を管理し、クエリに基づいて情報を取りだす機能を提供します。 |
| ベクトルデータベースの特徴 | ベクトルデータベースは、特にベクトル形式のデータを効率的に扱うように設計されています。これには、類似性に基づく検索(例えば最も近いベクトルを見つけること)や高次元データの高速処理などの機能が含まれます。 |
ベクトルデータベースは、特にベクトル化されたデータを取り扱うことに特化しており、類似性検索や高度なデータ解析を可能にする高度な機能を備えています。
ベクトル埋め込みとは
ベクトルデータベースを理解する上で重要な概念「ベクトル埋め込み(Vector Embedding)」についても説明をしておきます。
ベクトル埋め込みとは、高次元のデータセットを、より低次元のベクトル空間に変換するプロセスを指します。この変換により、複雑なデータ構造や関係性を保持しながら、データの操作や解析を効率的に行うことが可能になります。
| 特徴 | 用途 |
|---|---|
| 次元削減 | ベクトル埋め込みは、大規模なデータセットや複雑なデータ構造をより扱いやすい形式に変換するために用いられます。例えば、テキストや画像のような非構造化データを数値ベクトルに変換し、これをデータベースで効率的に処理します。 |
| 類似性の計算 | ベクトル空間に変換されたデータは、類似性を計算するのに適しています。例えば、ベクトル間の距離(後述するユークリッド距離やコサイン類似度など)を計算することで、アイテム間の類似性を測定可能です。 |
| 機械学習との連携 | 機械学習モデルは、多くの場合、入力データをベクトル形式で受け取ります。ベクトル埋め込みは、これらのモデルにデータを供給するための前処理ステップとして機能します。 |
| 検索と推薦システム | ベクトル埋め込みは、検索エンジンや推薦システムにおいて重要な役割を果たします。類似性に基づいてアイテムを検索したり、ユーザーの好みに合った推薦を生成したりする際に使用されます。 |
ベクトル埋め込みは、データの特性や関係性を保持しながら、効率的な計算や解析を可能にする強力なツールです。ベクトルデータベースは、これらの埋め込みベクトルを利用して高速で精度の高い検索やデータ分析を実現します。
大規模言語モデル(LLM)におけるベクトルデータベースとは
大規模言語モデル(LLM)は、自然言語処理(NLP)技術を使用して大量のテキストデータから学習する機械学習モデルです。テキストの生成、翻訳、要約など、さまざまな言語タスクを実行できます。
その中においてベクトルデータベースは、データをベクトル(数値の配列)として保存し、検索します。この特性は、LLMが生成する大量のテキストデータや、言語データを効率的に処理するのに特に有用です。
例えば、ユーザーが入力した質問に対して最も関連性の高い回答を検索する際、LLMはテキストをベクトルに変換し、ベクトルデータベース内で類似性の高いベクトルを検索します。これにより、関連する情報を迅速かつ正確に見つけることができます。
LLMにおけるベクトルデータベースは、膨大な言語データを効率的に処理し、高度な自然言語処理タスクを可能にするための強力なツールです。
RAGにおけるベクトルデータベースの役割
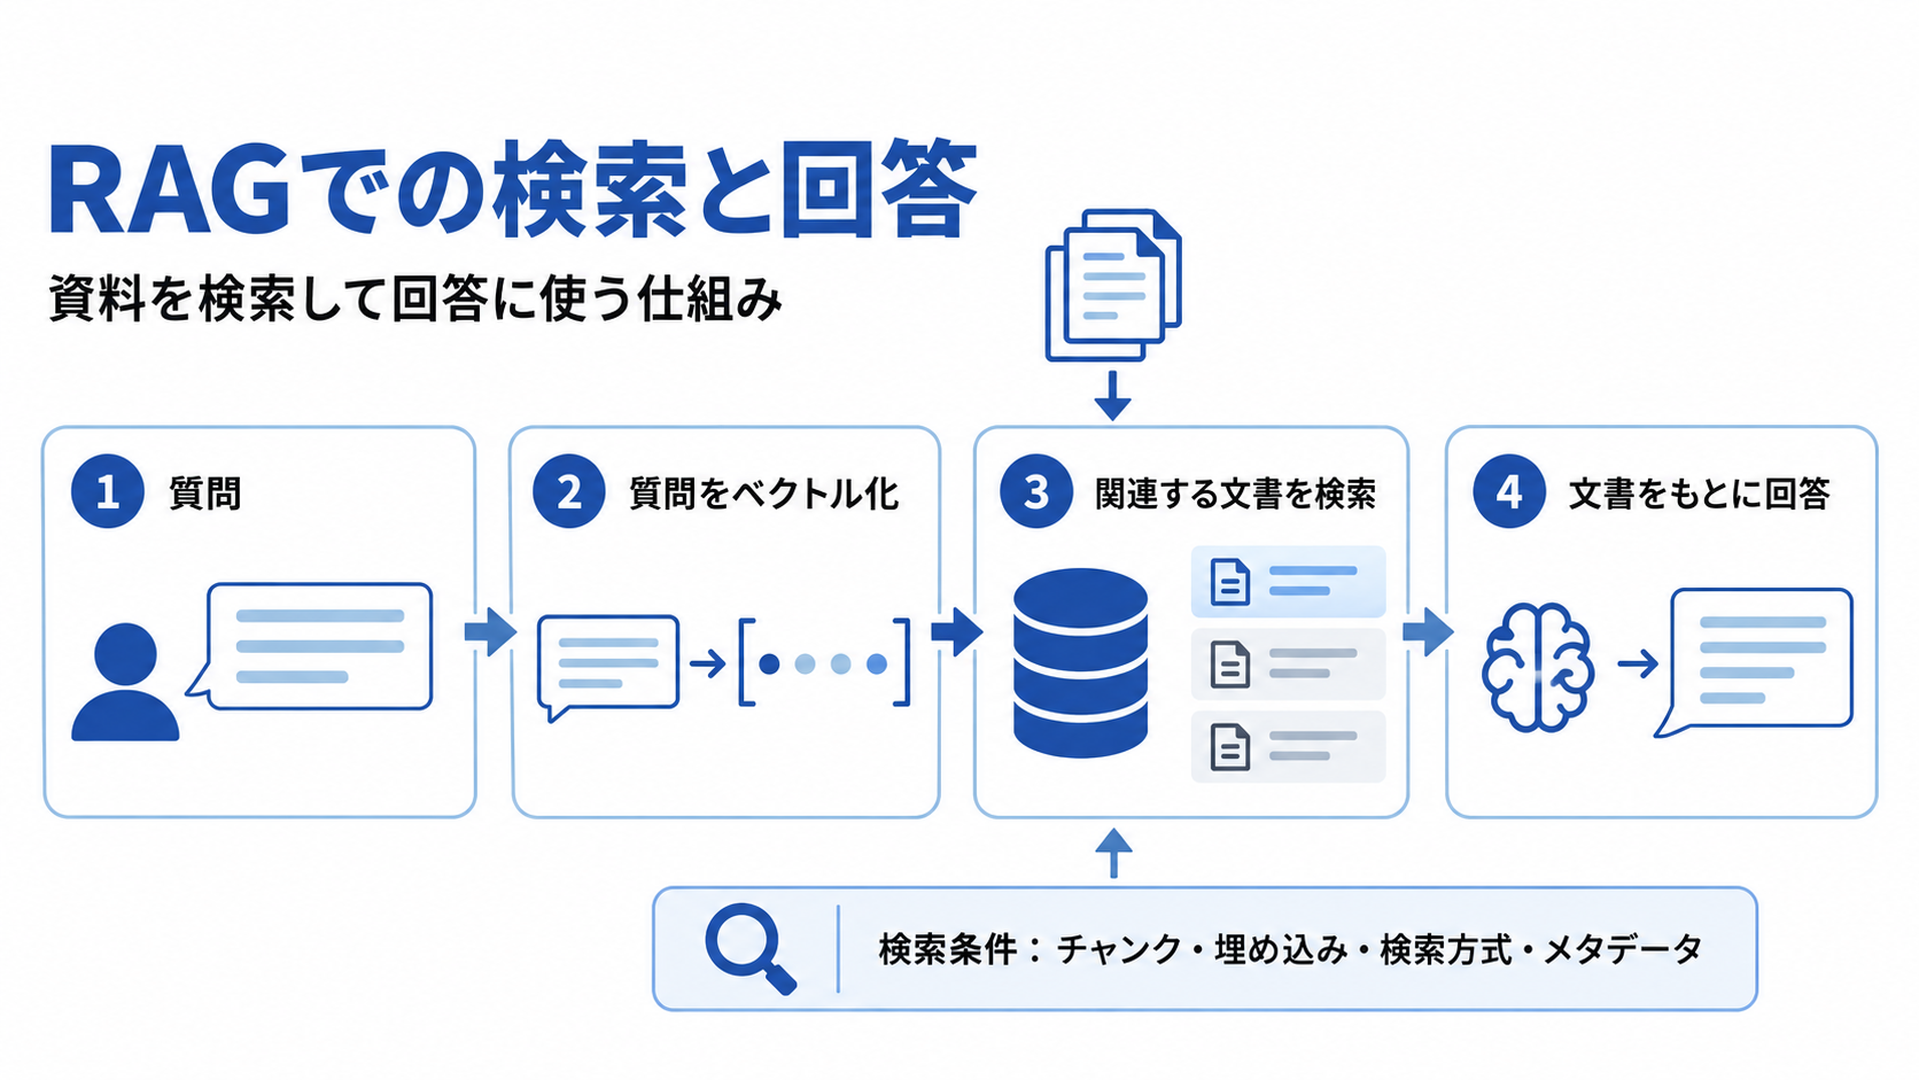
RAGは、検索した資料を生成AIに渡して回答に使う仕組みです。アプリケーションが質問をベクトル化し、ベクトルデータベースで関連文書を検索します。回答を作る大規模言語モデル(LLM)には、見つかった文書の本文を渡します。
検索結果を左右するのは、文章の区切り方であるチャンク分割や埋め込みモデルの選択です。単語の一致も使うハイブリッド検索、部署や更新日などのメタデータによる絞り込みも検討対象です。Pineconeの検索設計ガイドでも、検索信号の組み合わせと条件による絞り込みは区別されています。
WEELに寄せられた相談には、RAGの回答精度や社外にデータを出せない制約に関するものがあります。製品選定と併せて、資料の整備・検索評価・データの送信先を確認することが必要です。
社内データを使うRAGの構成は、こちらの記事でも解説しています。

ベクトルデータベースの仕組み
ベクトルデータベースでは、機械学習やベクトル埋め込みなどの手法でさまざまな情報をベクトルに変換しています。そして、データベースにある無数のベクトルから類似性を検索しているのです。
例えば、下記の表はECサイトでユーザーが何に関心があるかを購入点数で表しています。
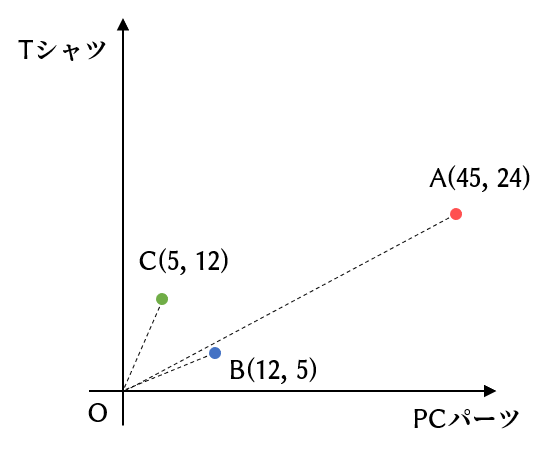
こちらの表を見るとBとCの類似性が高いと判断できるはずです。実際には、ユークリッド距離・コサイン類似度・内積などを用いて類似性を測っています。
このように、膨大なデータをベクトルで表し類似性のデータを抽出するのがベクトルデータベースの仕組みなのです。
ベクトルデータベースにおける検索の原理
データベースが持つデータに対する要求(データの検索や更新など)をクエリといいます。
今回は、ベクトルデータベースのクエリ処理の「検索」について話します。ベクトルデータベースでの検索では、以下の大きな流れをたどります。
- 検索時の類似度指標を決める
- 生データをベクトル化
- ベクトルデータをDBに格納
- ベクトルデータを抽出し、近似最近傍探索
- クエリに対する最近傍の検出(検索)
それでは順番に見ていきましょう!
最初に行うことは、ベクトルの類似性を測るための、類似度指標を決めることです。類似度指標によって用途が異なるため、必要に応じて使い分ける必要があります。
ベクトルの類似性を測るには、主に以下の3つが使われます。
- ユークリッド距離
- コサイン類似度
- 内積
どれもベクトル間の類似度を測るための指標として、よく使われます。例えば、ユークリッド距離はベクトルの大きさも考慮したい場合などに使います。
また、コサイン類似度や内積は、ベクトルの大きさは考慮せず、ベクトルの向きだけに着目したい場合に用います。分かりやすくするために、「ベクトルの大きさを考慮したい場合」や「ベクトルの向きだけに着目したい場合」の具体例を以下に示します。
まず、下にあるレコメンドシステムの図をご覧ください。この図は、各カテゴリの購入点数でベクトル表現したものから、各ユーザー間の好みの類似度を可視化するための図です。
各ユーザー(A, B, C)が何に関心があるかを、各カテゴリの購入点数でベクトル表現しています。
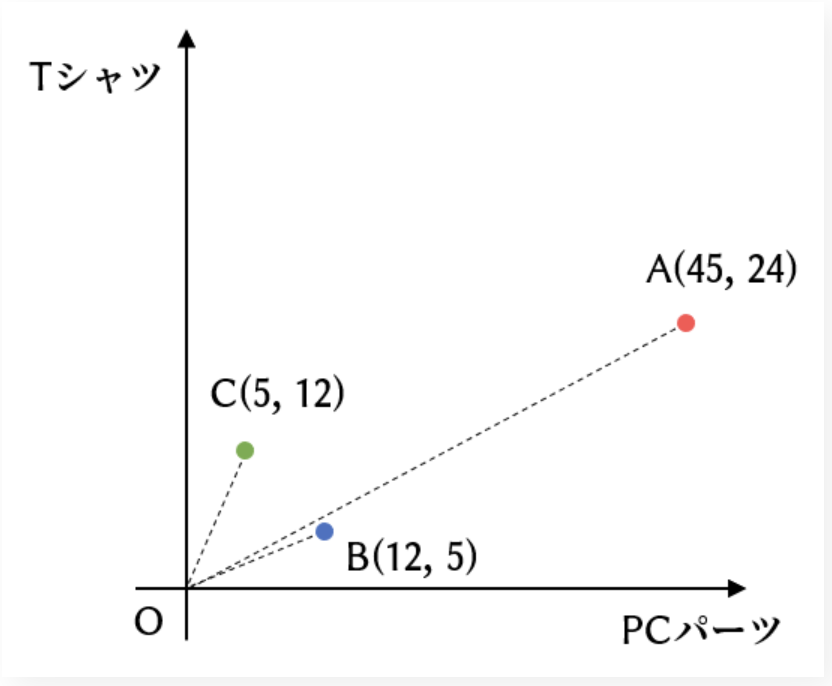
上記の画像を見ると、ユークリッド距離の観点で最も似ているベクトルのペアはBとCです。(ユークリッド距離が一番近いため。)
しかし、コサイン類似度の観点で見ると、角度が一番小さい、つまり最も似ているベクトルのペアはAとBになります。
このように、ベクトルの類似度指標によって結果が異なります。
ベクトルの大きさは「ユーザーの利用頻度」を表しているので、ユーザーの利用頻度を考慮したい場合は、ユークリッド距離を使うのが望ましいです。
一方、それらの利用頻度は考慮せず、単純に商品の購入傾向だけからユーザー間の好みの類似度を計算したい場合は、コサイン類似度や内積を用います。
これらの指標の決め方は、「インデックス」の作成時に引数に渡すだけです。
インデックスというのは、ベクトルデータを管理する単位のことで、リレーショナルデータベースでいう「テーブル」と同じ位置付けです。
次に、深層学習などの技術を用いて、「生データ」からベクトルを生成します。
生データとは、文書データや音声データなどのことです。
機械が理解できるのは数値のみなので、生データからベクトルを作る必要があります。その中でも、ベクトルは表現力が高く、機械が理解しやすい形です。
ベクトル化のもう一つの重要な利点は、データ間の類似度を測定しやすいことです。具体的には、データ間の類似度を測るためには、ベクトル間の類似度を計算するだけです。これにより、検索時にデータがどれだけ似ているかを簡単に判断できます。
ベクトル化の一例として、文章データを考えてみましょう!以下は、文章がベクトル化された例です。
| 文章例 | ベクトル |
|---|---|
| 猫は可愛い | [0.234, -0.567, 0.890, 0.123, -0.456, 0.789] |
| 今日は晴れた日だった | [0.567, -0.123, 0.456, -0.789, 0.234, -0.567] |
| 人工知能の発展が進んでいる | [0.890, 0.123, -0.456, 0.789, -0.234, 0.567] |
| 最新のディープラーニング技術について学びたい | [0.123, -0.456, 0.789, -0.234, 0.567, -0.890] |
| 自然言語処理の応用は幅広い | [-0.456, 0.789, -0.234, 0.567, -0.890, 0.123] |
このように、Transformerなどのライブラリを用いることで、文章をベクトルに変換することができます。
また、他の深層学習ライブラリを用いることで、「画像→ベクトル」や「音声→ベクトル」のような変換も可能です。
生データをベクトル化した後は、次にこれらのベクトルをデータベースに格納します。
これは、大量のデータの高速な検索や類似性の比較を可能とするためです。
以下の図は、データの格納時の違いです。ベクトルデータベースでは、ベクトル化したデータをDBに格納しています。
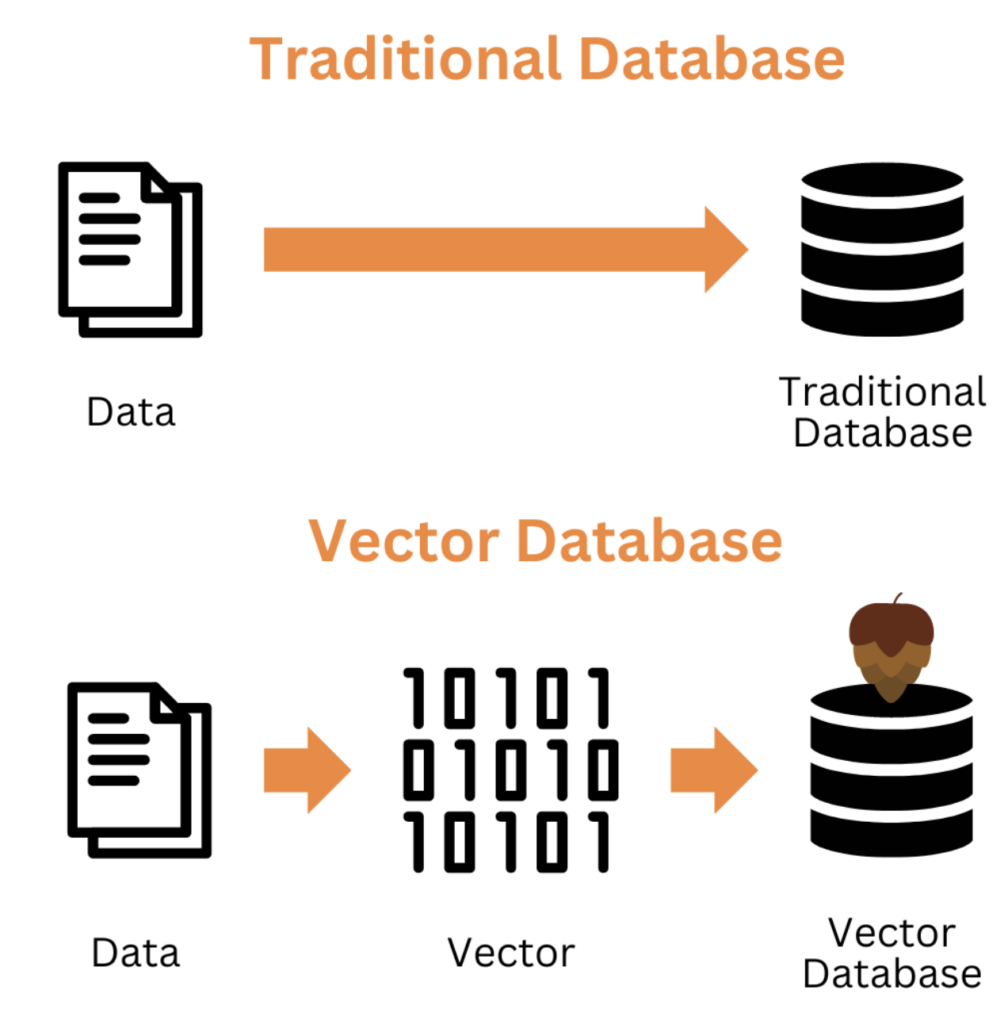
ベクトルデータベースでは、ベクトル化したデータをDBに格納していることがわかります。従来型のリレーショナルデータベースは一般的な利用では生データを主に格納しており、そのままではベクトル類似検索には最適化されていません。ただし、設定次第でベクトルを格納すること自体は可能です。
このように、ベクトルデータベースでは、データをベクトルとしてDBに格納する点が特徴的です。
データの格納ができたら、近似最近傍探索というベクトル量子化手法を実行します。
この処理は、検索効率を上げるために必要な処理です。
もし、この手法を施していない場合どうなるでしょうか。
仮に、ベクトル数が1,000,000で、それぞれの次元数が1,000だとしたら、1,000,000×1,000個の値全てを確認して検索しなくてはなりません。
そこで、以下のように似た者同士を集め、1つのベクトル(代表点)とみなす処理が考えられました。
こうすることで、似たものだけを検索すれば良いので検索効率がアップしました。
ただし、正確性と速度はトレードオフの関係にあるため、検索精度をある程度犠牲にしなければなりません。
代表点からの距離が近ければ、より細かく検索することになるので、正確性は上がります。
反対に、距離を大きくとって、「ある程度近ければ1つのベクトルでいいよ」というふうにすれば、処理速度は上がります。距離を大きくとるということは、おおざっぱに探索するイメージです。
最後に、クエリに対して似たデータの検索です。
先ほどは、似たベクトルたちを1つの「グループ」にまとめました。ここの検索では、クエリと似ている「グループ」を検出します。グループを検出するために、「代表点」を見つけています。
つまり、「クエリのベクトル」と「DB内の代表点のベクトル」との類似度を計算しているのです。
ここまでが、ベクトルデータベースにおける検索の仕組みです。
なお、ChatGPTに自社データを学習させる方法が気になる方は、以下の記事もご覧ください。
ベクトルデータベースと従来のデータベースとの違い
現代の情報社会において、データは様々な形で存在します。
これまでは主に、以下のようなシステムを用いてデータを管理してきました。
- リレーショナルデータベース
- グラフデータベース
しかしその性質上、リレーショナルデータベース・グラフデータベースとベクトルデータベースの間にはいくつかの重要な違いが存在します。
以下の表は、それらの主な違いを簡潔に示しています。
| ベクトルデータベース | リレーショナルデータベース | グラフデータベース | |
|---|---|---|---|
| データ表現 | ベクトル | 表 | ノード(点)とエッジ(線)のグラフ |
| データの処理速度 | 高次元データにおいても処理速度が速い | データの規模が大きくなるにつれて処理速度が落ちる | 関連するデータを高速で処理できる |
| 対応するデータの種類 | 非構造化データも可能 | 構造化データ | 関係性が複雑なデータやネットワークデータ |
| クエリ処理 | ベクトル間の類似度や距離に基づくクエリ処理 | テーブル間の関係や条件に基づくクエリ処理 | ノード間の関係性に基づくクエリ処理。 |
| 得意とする用途 | 画像、音声、テキストなどの非構造化データの検索。 | 在庫管理システム、顧客情報管理、会計システムなどの構造化データの管理。 | SNS分析、レコメンドシステムなどの関連性が複雑なデータの分析。 |
ベクトルデータベースと従来のデータベースとの違いについて、以下で詳しく解説していくので、ぜひ参考にしてみてください。
データの保存方法や得意なクエリ
ベクトル検索に対応するかどうかは、専用データベースか既存データベースかだけでは決まりません。PostgreSQLにはpgvectorがあり、OracleにはAI Vector Searchがあります。Amazon S3 Vectorsのようにストレージでベクトルを扱う選択肢も登場しています。
リレーショナルデータベースが得意とするのは、条件に合う行の抽出や集計、表同士の結合です。ベクトル検索は、質問と文章などの特徴の近さを順位にする処理です。両方を一つの基盤で扱うか、専用サービスへ分けるかは、検索量や運用要件から判断しましょう。
検索処理のコスト
ベクトルデータベースと従来のデータベースでは、検索処理にかかるコストが異なります。
ここでは、リレーショナルデータベースとグラフデータベースの検索処理のコストについて紹介し、ベクトルデータベストとどのように違うのか解説していきます。
リレーショナルデータベースの検索処理のコスト
リレーショナルデータベースで検索を行う場合、ベクトルデータベースと比較すると計算時間がかかります。そう考えられる理由としては、以下の2つです。
- 「データをわざわざDBから出してからベクトル演算」という工程が必要
- 近似最近傍探索のために、外部ツールとのやり取りが必要
詳しく説明していきます!
まず1つ目。
検索処理の中に、ベクトル演算という工程を必要とします。
ベクトルデータベースでは、対象となるデータを直接ベクトル形式で操作でき、一部のデータに対して高度な数値演算(ベクトル演算)を直接適用できるため、短時間で処理が可能です。
これに対して、リレーショナルデータベースでは、必要なデータを一度DBから取り出し、外部の計算環境(例えばPythonなどのプログラミング環境)でベクトル演算を行う必要があります。
この工程は、データの取り出しやデータの変換、そしてベクトル演算自体に時間がかかる可能性があります。
2つ目。
検索スピードをアップさせるために、近似最近傍探索という処理が必要です。
ベクトルデータベースでは、この処理が可能ですが、リレーショナルデータベースでは外部ツールが必要となります。
加えて、これらの要素がプログラムの複雑さを増すため、メンテナンスもより時間を要することになります。
そうすると、データベースと外部ツールとの間で、データのやり取りが増えるため、ベクトルデータベースに比べ遅くなってしまいます。
※DB内には、生データをベクトルデータに変換したものが格納されているとします。
以上2つのようなことがあると、処理を実行するプログラムが複雑になってしまいます。
そうなると、処理時間だけではなく、プログラムの修理や管理にも時間がかかるようになります。
グラフデータベースの検索処理のコスト
またグラフデータベースのデメリットについても、以下のコストが考えられます。
- スケーラビリティの問題
- クエリの複雑性
まず1つ目は、スケーラビリティの問題。
グラフデータベースはノードとエッジの複雑な関係を管理します。大規模なグラフになると、データの量が増えるにつれて、ノード間の接続を追跡し管理するのが難しくなります。これは、大量のデータを扱う場合にパフォーマンスの低下を招く可能性があります。
次に2つ目。
クエリの複雑性の問題です。グラフデータベースのクエリは、リレーショナルデータベースに比べて複雑になることがあります。ノードとエッジの関係性を理解し、それに基づいたクエリを作成する必要があります。このため、クエリの設計や最適化には特別な知識が必要になります。
これらの点は、グラフデータベースが特定の用途には非常に有効である一方で、すべてのデータストレージや処理のニーズに適しているわけではないことを示しています。
適材適所を見極めて、利用することが重要そうですね。
【実演】ベクトルデータベースと従来のデータベースの性能差を比較
同じ埋め込みを使い、Pinecone・pgvector・sqlite3で検索しました。Pineconeはクラウド、ほかは手元のPCです。通信条件が異なるため、数値をデータベース製品そのものの優劣と解釈しないことが前提になります。
公開テキストデータAG Newsから、先頭64トークンまでに区切った異なる文章を10万件選びました。text-embedding-3-smallで1,536次元に変換し、長さを正規化しています。先頭1,000件・1万件・10万件を各条件に使い、別の10文章から生成した質問ベクトルで検索しました。記事本文を質問にした負荷テストであり、人が付けた関連性の正解ラベルではありません。
環境はWindows、Ryzen 9 5900HX、メモリ約15.4GB、Python 3.11.9です。PostgreSQL 16.15とpgvector拡張0.8.6を別環境で用意しました。PineconeはStarter・AWS us-east-1、Python SDK10.0.0です。Chroma1.5.9、OpenAI SDK3.13.0、NumPy1.26.4で実行しています。
Pineconeで処理
pip install pinecone openai numpyで導入し、APIキーを環境変数へ設定します。今回のインデックスはPineconeとServerlessSpecで作成したサーバーレス構成です。1,536次元・dotproductを指定し、各件数を別の名前空間へ登録しました。検索は本文・ベクトルを返さず、IDとスコアだけを取得します。
クリックで表示
def pinequery(q):
    response = index.query(
        namespace=namespace,
        vector=q.tolist(),
        top_k=10,
        include_values=False,
        include_metadata=False,
    )
    return [int(item.id) for item in response.matches]
qは同じAPIモデルで変換した質問ベクトル、namespaceは対象件数の名前空間です。登録処理とインデックスの準備時間は、以下の検索時間に含めていません。
SQLで処理
PostgreSQLではvector(1536)列へ同じ値を登録し、HNSWインデックスを作りました。HNSWは近い候補へ効率よく到達するための索引方式です。m=16、ef_construction=64、検索時のef_search=100に固定しました。
小さい表ではPostgreSQLが総当たりを選んだため、今回のHNSW測定ではenable_seqscan=offを設定し、実行計画で索引利用を確認し直しています。HNSWを使う条件での測定であり、この設定を本番環境へそのまま推奨するものではありません。
クリックで表示
connection.execute("SET hnsw.ef_search=100")
connection.execute("SET enable_seqscan=off")
def pgquery(q):
    rows = connection.execute(
        "SELECT id FROM bench_100000 "
        "ORDER BY embedding <#> %s LIMIT 10", (q,)
    ).fetchall()
    return [row[0] for row in rows]
<#>は負の内積で並べる演算子です。ベクトルの長さを揃えているので、内積による順位を共通の基準にしました。sqlite3は比較の参考として全行を走査し、Pythonの関数で内積を計算します。これはSQLite全体の最適な検索性能を示す実装ではありません。
クリックで表示
def sqlquery(q):
    db.create_function(
        "score", 1,
        lambda value: float(np.frombuffer(value, dtype="float32") @ q)
    )
    rows = db.execute(
        "SELECT id FROM vectors ORDER BY score(v) DESC,id LIMIT 10"
    )
    return [row[0] for row in rows]
検索スピードの比較結果
| 件数 | 検索先 | 中央値(ms) | 95パーセンタイル(ms) | 上位10件の一致率 |
|---|---|---|---|---|
| 1,000 | Pinecone | 214.17 | 265.41 | 100.0% |
| 1,000 | pgvector HNSW | 0.63 | 0.95 | 100.0% |
| 1,000 | sqlite3 exhaustive | 17.66 | 21.92 | 100.0% |
| 10,000 | Pinecone | 199.69 | 240.35 | 100.0% |
| 10,000 | pgvector HNSW | 1.40 | 2.93 | 100.0% |
| 10,000 | sqlite3 exhaustive | 137.61 | 164.41 | 100.0% |
| 100,000 | Pinecone | 202.13 | 234.28 | 100.0% |
| 100,000 | pgvector HNSW | 2.06 | 25.72 | 100.0% |
| 100,000 | sqlite3 exhaustive | 1507.53 | 1561.87 | 100.0% |
各方式でウォームアップを1回行い、その後30回を計測しました。中央値は真ん中の値、95パーセンタイルは遅い側の傾向を見る値です。上位10件の一致率は、全件の内積計算で求めた10件と何件重なったかを示します。文章内容の正しさや、RAGの回答精度の指標ではありません。
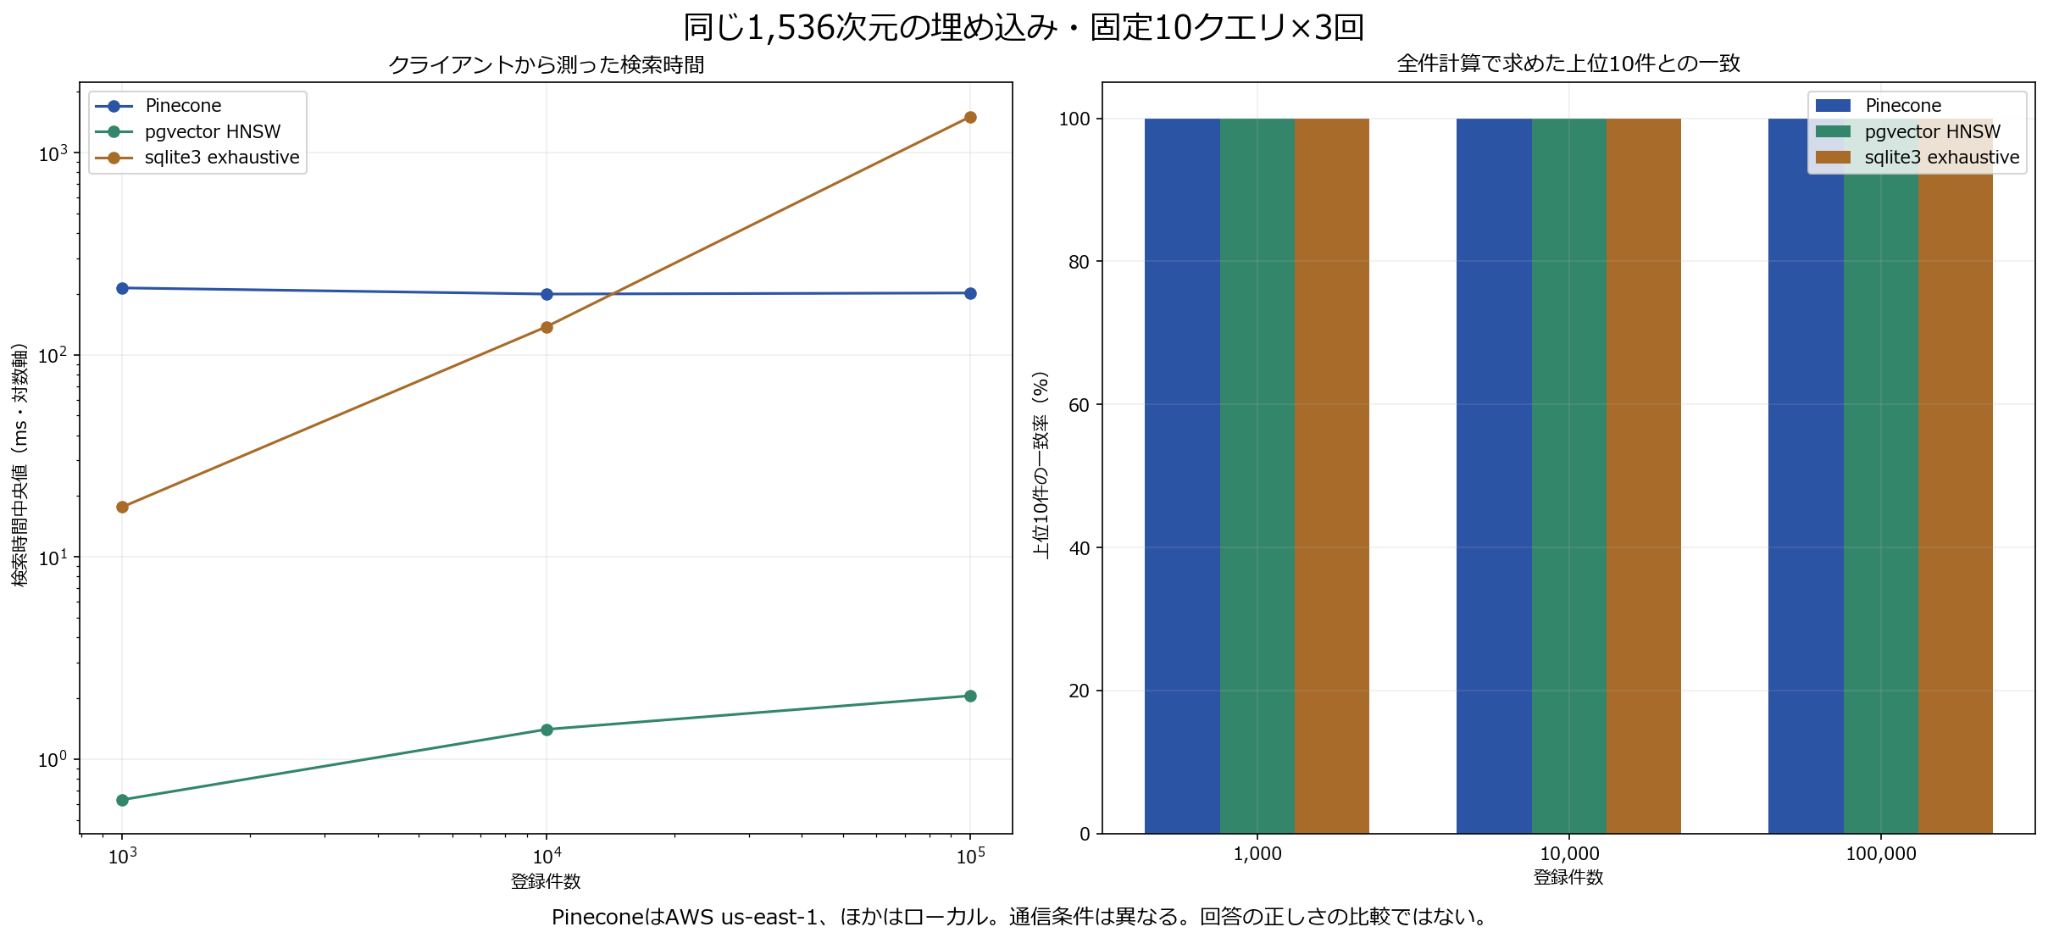
Pineconeの時間にはクラウドまでの往復通信が含まれます。pgvectorとsqlite3は同じPCで動かしており、サーバーを同条件に揃えた比較ではありません。データ登録、索引構築、同時アクセス、長時間の負荷は別途検証が必要です。
コード量の比較結果
| 方法 | セットアップで行った作業 | 検索コードの捉え方 |
|---|---|---|
| Pinecone | アカウント・キー・インデックス・名前空間を準備 | SDKのqueryを呼び出す。クラウド側の実装は含めない |
| pgvector | PostgreSQL起動、拡張導入、表とHNSW索引を作成 | SQLと接続処理が必要。データベース内部の実装は含めない |
| sqlite3 | ローカルファイル・表・内積計算関数を用意 | 総当たりの計算関数もアプリケーション側に含む |
短い検索関数だけでは、実装・運用の手間は比較できません。今回はPineconeにサーバー管理が不要な一方、pgvectorではローカルのデータベースと拡張を準備しました。共通の埋め込み生成や計測処理を除き、接続・保存・索引・検索のどこまで数えるかを揃えて評価する必要があります。
掲載した検索コードの非空行数は、Pineconeが9行、pgvectorが8行、sqlite3が9行です。コメント・空行を除き、掲載範囲だけを数えています。接続や保存処理を含むコード全体の短さを表す数値ではありません。
ベクトルデータベースが重要である理由
新しいアプローチであるベクトルデータベースが注目されているのは、進化しつつあるAIにおける「データの特性」と「処理の要求」に非常に適しているからです。
具体的な理由は以下のとおりです。
| 項目 | 内容 |
|---|---|
| 非構造化データの増加 | 現代では、画像、ビデオ、音声、テキストなどの非構造化データが爆発的に増加しています。ベクトルデータベースは、これらのデータタイプを効率的に処理し、分析するのに適しています。 |
| 高速な類似性検索 | AIアプリケーションでは、類似性に基づく検索が頻繁に必要とされます。ベクトルデータベースは、類似または関連するアイテムを迅速に検索する能力に優れています。 |
| 機械学習との親和性 | 機械学習モデルは、データをベクトル空間内で解釈します。ベクトルデータベースは、これらのモデルが生成するベクトル表現を直接的に保存・検索できるため、機械学習ワークフローとの統合が容易です。 |
| スケーラビリティ | AI社会では膨大なデータを扱う必要があります。ベクトルデータベースは、大量のデータセットに対しても高速でスケーラブルな検索を提供します。 |
| リアルタイム分析 | AIアプリケーションはリアルタイムのデータ分析を要求することが多いです。ベクトルデータベースは、リアルタイムでのデータのクエリと分析に適しており、即座の意思決定をサポートします。 |
これらの理由から、ベクトルデータベースは現代のAI社会におけるデータ処理の要求を満たす重要な技術となっています。
従来型のデータベースの検索のアプローチでは効率が悪い
「検索」は、データベースにおいて重要な処理の一つです。データベースに蓄積された情報の中から、特定の条件に合致するデータを効率的に見つけ出す必要があります。
データベース内の各アイテムを数値のベクトルとして表現し、要求されたベクトルに最も近いアイテムを見つけ出す検索手法を「ベクトルサーチ」と呼びます。
例えば、Amazonなどのレコメンドシステムでは、ユーザーが購入した商品のデータと、類似するDB内のデータを検索し、それらのデータをユーザーに表示します。
従来のデータベースで、構造化データを扱う前提で類似データの検索を行う場合は、以下のような手法が用いられてきました。
- パターンマッチング
- 全文検索
ただし、これらの手法はデータベース内の全データに対して検索をかけるため、データ数が増えるほど時間がかかります。
Amazonの商品データはDB内に大量にあるので、上記の方法で検索を行うと、かなりの計算時間を必要とするでしょう。これでは、レコメンドシステムの際に、ユーザーにおすすめ商品がなかなか表示されない、という問題が起こります。
この問題を解決するために、以下のような手法が使われています。
- インデックス
- クラスタリング
- カーネル法
これらの手法はデータの特性を利用し、検索効率を向上させることを目指しています。
ただし、リレーショナルデータベースは主に構造化データを扱う設計となっているため、非構造化データを扱う際には限界があります。例えば、画像や音声などの非構造化データをリレーショナルデータベースで直接的に管理しようとするのは難しいです。
そこで、データベース内の特定のカラムに、非構造化データをバイナリ形式で格納するためのBLOBデータ型を使用することがありますが、データの検索や処理は制限される場合があります。
なお、生成AIでシステム開発する方法が詳しく知りたい方は、以下の記事をご確認ください。
ベクトルデータベースで解決できる問題と具体的な用途
ベクトル検索は、言葉が一致しない情報や特徴が似たデータを探す場面で役立ちます。以下は用途を説明する想定例であり、特定企業での導入成果ではありません。必要な埋め込みモデルや評価方法は対象データによって変わります。
RAG・社内文書検索
質問と関連する社内マニュアルを探し、生成AIの回答の根拠として渡します。「在宅勤務」と「リモートワーク」のような言い換えを含む検索も用途の一つです。検索された文書が閲覧可能か、最新版かの確認も欠かせません。ベクトルが近いという理由だけで、正しい回答の根拠になるとは限らないためです。
レコメンド
商品や閲覧履歴の特徴をベクトルで表し、近い候補を推薦します。説明文が似た商品を探す処理も、その一例です。類似度は推薦候補を作る手掛かりであり、在庫や利用者の希望といった別の条件も合わせて判断します。埋め込みの公式ガイドにも、推薦が用途の一つとして挙げられています。
画像の類似検索
画像に対応するモデルで特徴を抽出し、見た目や内容が近い画像を検索します。商品画像から似た商品を探す、といった使い方です。文章用の埋め込みモデルをそのまま画像に使えるとは限りません。対象画像で候補を確認し、色や形など何を似ていると評価したいのかを先に決めます。
異常検知
通常の状態の特徴と比較し、離れたデータを確認候補にする用途もあります。例えば、設備の記録を特徴量に変換し、普段と異なる傾向を探す方法です。距離が大きいことだけで故障や不正と断定しないことが前提になります。異常の定義や確認手順を設け、見逃しと誤検知の両方を評価します。
ベクトルデータベースの作り方
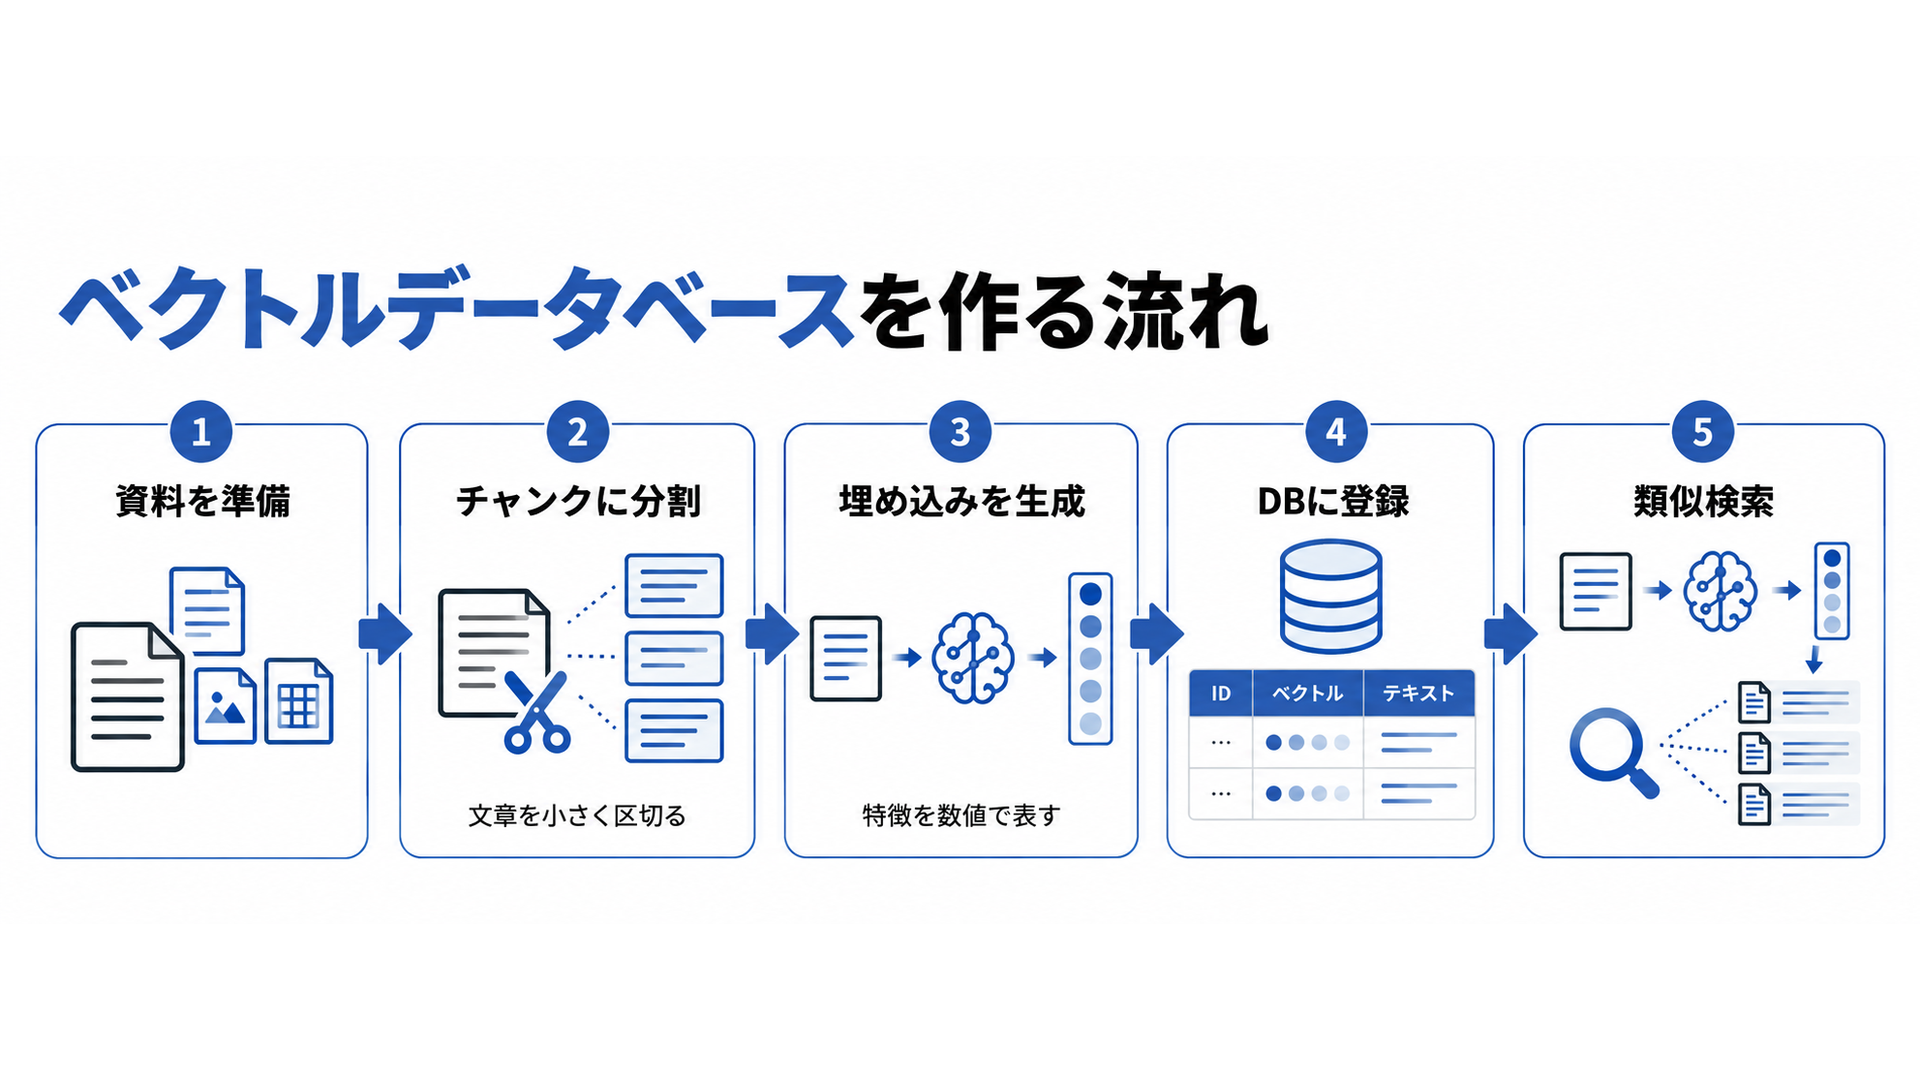
資料の準備→チャンク分割→埋め込み生成→登録→検索の順に進めます。埋め込みとは、意味や特徴を数値の並びで表す方法です。登録する文章と検索する質問には、対応する同じモデル・次元数を使います。
まず更新日や閲覧権限を確認し、資料を検索しやすい単位へ区切ります。埋め込みと本文は識別用のIDで対応づけて保存し、質問から生成したベクトルで検索する仕組みです。取り出した本文が質問に答えられるかまで確認しましょう。
次はChromaをローカルで動かす最小例です。Pythonにpip install chromadb sentence-transformersで導入し、以下を実行します。初回は公開モデルの取得に通信が必要です。このコードの埋め込み生成・保存・検索はローカルで行い、OpenAI APIは使いません。
クリックで表示
import chromadb
from sentence_transformers import SentenceTransformer

# 初回は公開モデルのダウンロードに通信を使う
model = SentenceTransformer("intfloat/multilingual-e5-small", device="cpu")
client = chromadb.PersistentClient(path="./chroma_minimal_data")
collection = client.get_or_create_collection(
    "fictional-policy", metadata={"hnsw:space": "cosine"}
)
docs = [
    "【架空規程】在宅勤務は3営業日前までにチーム責任者へ申請します。",
    "【架空規程】出張の宿泊費は1泊12,000円が上限です。",
    "【架空規程】貸与端末NX-420の紛失は30分以内にIT窓口へ連絡します。",
]
vectors = model.encode(
    ["passage: " + text for text in docs], normalize_embeddings=True
)
collection.upsert(
    ids=["work", "travel", "device"], documents=docs, embeddings=vectors.tolist()
)
question = "家で働くとき、いつまでに誰の許可が必要ですか?"
query = model.encode(["query: " + question], normalize_embeddings=True)
result = collection.query(
    query_embeddings=query.tolist(), n_results=1, include=["documents"]
)
print(result["documents"][0][0])
実行結果は「【架空規程】在宅勤務は3営業日前までにチーム責任者へ申請します。」でした。これは架空規程3件の動作確認であり、実際の社内資料での検索精度を示す検証ではありません。
埋め込みの考え方や関連技術との違いは、こちらも参考になります。
【実践検証】RAGの検索精度はどこで変わる?チャンク・埋め込みモデル・ハイブリッド検索を比べてみた
今回の10問では、200字の分割で1問を取りこぼし、ほかの条件では10問とも根拠を取得しました。ただし、架空規程を使った小規模な検索テストです。回答生成の正しさや、どの製品・モデルが優れているかを測った結果ではありません。
検証条件
Chromaをローカルで実行し、架空の社内規程12章を12ページに分けた資料を用意しました。質問は言い換え、端末名NX-420・NX-420B、システム名Orion・Orion-Lなどを含む10問に固定しています。実在の社内文書は使っていません。
上位3件のいずれかに、正解として定めた文が全文含まれる割合を集計しました。途中で分断された文は不正解とします。チャンクの重なりは20%、検索距離はコサイン距離で統一しました。LLMによる回答生成は実行していません。
チャンクサイズ比較
| チャンク上限 | 埋め込みモデル | 検索方式 | チャンク数 | 上位3件で根拠を取得できた質問 |
|---|---|---|---|---|
| 200字 | text-embedding-3-small | ベクトル検索のみ | 60 | 9/10(90%) |
| 500字 | text-embedding-3-small | ベクトル検索のみ | 24 | 10/10(100%) |
| 1000字 | text-embedding-3-small | ベクトル検索のみ | 12 | 10/10(100%) |
| 500字 | multilingual-e5-small | ベクトル検索のみ | 24 | 10/10(100%) |
| 500字 | text-embedding-3-small | ベクトル+キーワード | 24 | 10/10(100%) |
text-embedding-3-smallで比較すると、200字は9問、500字と1,000字は10問で根拠を取得しました。短く区切れば必ず検索しやすくなるわけではありません。今回の採点は正解文の全文を要求するため、文の分断も得点に影響します。
埋め込みモデル比較
500字でOpenAIのモデルとmultilingual-e5-smallを比較し、どちらも10問で根拠を取得しました。OpenAIはAPI、e5はCPUでのローカル実行です。e5のモデルカードに従い、資料にpassage: 、質問にquery: を付けて数値化しました。
この10問ではモデル間の差を確認できませんでした。日本語での一般的な性能や、長い文書への適性まで同等と判断する根拠にはなりません。e5側の入力上限による切り詰めにも注意が必要です。
ベクトル検索のみとハイブリッド検索の比較
500字の条件では、ベクトル検索のみも、BM25を組み合わせた検索も10問で根拠を取得しました。BM25は単語の出現を使う検索方式です。日本語は簡易的な最大2文字単位、英数字・型番は連続した文字列として扱いました。
両方式の上位20件を順位から統合するRRFで合成し、定数は60に固定しています。今回はハイブリッド化による得点の改善は見られません。本番では実際の型番・略語を含む質問を増やし、分かち書きや候補件数も検証する必要があります。
検証してわかったこと
| 根拠を取得できなかった条件 | 質問 | 正解として定めた規程文 |
|---|---|---|
| OpenAI・200字・ベクトル検索のみ | 在宅勤務の許可は何日前に誰に頼めばよいですか? | リモートワークは勤務予定日の3営業日前までに、所属チームの責任者へ申請する。 |
この質問では、申請期限の文ではなく、差し戻しや受付に関する一般規定が上位に入りました。似た説明が各章にある資料のため、見出し単位の分割や定型文の整理も次の検証候補になります。その効果は今回まだ測っていません。
製品を選ぶ前に、実際の質問と正解の根拠を固定することが必要だとわかります。WEELにもRAGの回答精度に関する相談が寄せられています。原因を切り分けるには、まず検索された資料と質問を照合することが必要です。今回の結果を、自社資料でも再現する保証はありません。
チャンクの分け方と注意点は、こちらの記事でも整理しています。

ベクトルデータベースはどこがおすすめ?3タイプで比較
| タイプ | 製品・機能 | 料金・無料枠の考え方 | ローカル利用 | 向いている用途 |
|---|---|---|---|---|
| フルマネージド型 | Pinecone | Starterは無料枠あり。有料プラン・従量課金は別条件 | 不可(クラウド) | サーバー運用をサービス側へ任せたい場合 |
| OSS型 | Chroma | OSSを無償導入可能。端末・運用費は別 | 可 | 小規模なRAGの試作・ローカル検証 |
| OSS型 | Weaviate | OSSの自己ホストと有料クラウドを区別 | 可 | 自社環境での検索基盤構築 |
| OSS型 | Qdrant | OSSの自己ホストとクラウドプランを区別 | 可 | ベクトル検索と条件絞り込みの検証 |
| OSS型 | Milvus | OSSの自己ホストではサーバー・運用費を考慮 | 可 | 大きな検索基盤を自社運用する場合 |
| 既存DB・ストレージ拡張型 | PostgreSQL+pgvector | 拡張は無償。PostgreSQLの実行環境は別 | 可 | SQLのデータ管理とベクトル検索を組み合わせる場合 |
| 既存DB・ストレージ拡張型 | Oracle AI Vector Search | 製品・エディション・契約ごとに確認。無償版の制限も確認 | 対応製品で可 | Oracleを使う既存システムへの組み込み |
| 既存DB・ストレージ拡張型 | Elasticsearch | 自己管理・クラウド・契約によって条件が異なる | 自己管理で可 | 全文検索とベクトル検索の組み合わせ |
| 既存DB・ストレージ拡張型 | Amazon S3 Vectors | ストレージ・登録・クエリ等の従量課金。無料とは扱わない | 不可 | AWSでのベクトル保管と検索 |
運用を任せるか、自社で管理するか、既存基盤を拡張するかが選び方の出発点です。Chroma・Weaviate・Qdrant・Milvusは、ローカルや自己管理環境の導入方法を公開しています。OSSはソースコードが公開され、ライセンスに従って利用できるソフトウェアです。無償導入でも、端末や管理の費用は発生します。
製品の分類と導入形態の分類は別の軸です。Pineconeなどの専用ベクトルデータベース、Faiss・Annoyなどの検索ライブラリ、Elasticsearch・pgvectorなどの検索機能を持つ既存基盤を区別しましょう。ライブラリだけで永続保存や利用者管理まで揃うとは限りません。Elasticsearchは公式のkNN検索に対応しています。
Oracleの条件は公式製品情報、S3 Vectorsの費用はAWSの料金表で確認できます。表示上の無料枠だけで決めず、必要な構成と運用費を見積もることが必要です。
選定時は、無料枠だけでなく、検索条件・運用負荷・データの保存先を同じ条件で比較しましょう。
Pinecone
| プラン | 基本料金・最低利用額 | 主な確認点 |
|---|---|---|
| Starter | 無料 | 保存2GB、月200万WU・100万RU、送出1GB、最大5インデックス |
| Builder | 月20米ドルの定額 | Starterより大きい利用枠。含まれる上限を確認 |
| Standard | 月50米ドルの最低利用額 | 利用額が最低額を超えると従量課金 |
| Enterprise | 月500米ドルの最低利用額 | 組織向け機能・契約条件を確認 |
Pineconeは、ベクトルの保存と検索をクラウドで提供するサービスです。サーバーレス構成では、利用者が検索サーバーを直接管理する必要はありません。公式料金表では、無料のStarterと有料プランが分かれています。
WUは書き込み、RUは読み取りの使用量を計る単位です。StarterはAWSのus-east-1を利用します。無料枠はベクトル件数だけで決まらず、次元数・メタデータ・検索量も影響します。埋め込みモデルのAPI料金も別に確認してください。
APIキーはコンソールの「API keys」で管理し、コードへ直接書かず環境変数から読み込みます。旧SDKの初期化用Environment値やpod_typeを、今回のサーバーレスコードへ持ち込む必要はありません。現行Python SDKはpineconeパッケージとPineconeクライアントを使います。
PineconeのHybrid Searchとは?
意味の近さを表す密なベクトルと、単語の一致を表す疎なベクトルを組み合わせる検索を試します。密なベクトルは多くの成分に値があり、疎なベクトルは一部の成分だけに値がある表現です。公式の単一インデックス方式は、dense型とdotproductの組み合わせを使います。
今回は型番と単語の一致を0・1で表す簡単な疎ベクトルを使いました。BM25による重み付けではありません。前節の日本語RAG実験のBM25+RRFとも別の方法です。
Pineconeを使ってみた
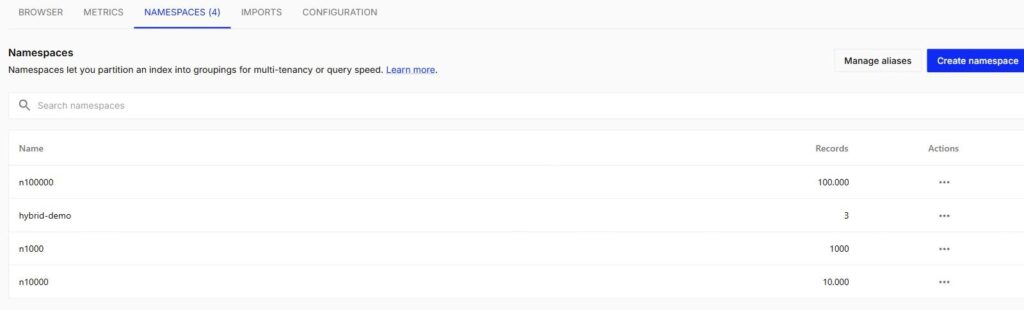
テスト用の3文章を登録し、「NX-420 battery」で検索しました。実在する端末の仕様を説明する資料ではなく、型番の違いを扱う架空の検証データです。疎な信号と密な信号を一つのリクエストで送れることを確認する例であり、検索品質の優劣を測るものではありません。
pip install pinecone openai numpyで導入します。PineconeとOpenAIの既存APIキーを環境変数に設定し、コードへ直接記載しないでください。OpenAIの埋め込みにはAPI料金がかかります。
クリックで表示
import os, time
import numpy as np
from openai import OpenAI
from pinecone import Pinecone, ServerlessSpec

pc = Pinecone(api_key=os.environ["PINECONE_API_KEY"])
name = "weel-vdb-20261020"
if name not in pc.list_indexes().names():
    pc.create_index(
        name=name, dimension=1536, metric="dotproduct",
        spec=ServerlessSpec(cloud="aws", region="us-east-1")
    )
while not pc.describe_index(name).status["ready"]:
    time.sleep(2)
index = pc.Index(name)
docs = [
    "NX-420 battery replacement guide",
    "NX-420B screen replacement guide",
    "Employee remote work application guide",
]
question = "NX-420 battery"
response = OpenAI().embeddings.create(
    model="text-embedding-3-small", input=docs + [question],
    dimensions=1536, encoding_format="float"
)
vectors = np.asarray([item.embedding for item in response.data], dtype="float32")
vectors /= np.linalg.norm(vectors, axis=1, keepdims=True)
既存インデックスを使う場合も、次元数と距離指標が一致している必要があります。この例で使うのは、テスト用の名前空間だけです。業務データがあるインデックスへの登録・削除は行わないでください。
語彙の位置を共通にして、文中に含まれる語へ1を設定します。質問側の密・疎ベクトルをそれぞれ0.5倍し、寄与を調整してから検索します。0.5が最適という検証結果ではありません。両者のスコア尺度が異なるため、実際の質問で調整する必要があります。
クリックで表示
vocabulary = ["nx-420", "nx-420b", "battery", "screen", "remote"]
def sparse(text):
    words = text.lower().split()
    ids = [i for i, word in enumerate(vocabulary) if word in words]
    return {"indices": ids, "values": [1.0] * len(ids)}

index.upsert(vectors=[
    {"id": f"h{i}", "values": vector.tolist(),
     "sparse_values": sparse(text), "metadata": {"text": text}}
    for i, (text, vector) in enumerate(zip(docs, vectors))
], namespace="hybrid-demo")
while index.describe_index_stats().namespaces.get(
    "hybrid-demo", {}
).get("vector_count", 0) != len(docs):
    time.sleep(2)
query_sparse = sparse(question)
query_sparse["values"] = [value * 0.5 for value in query_sparse["values"]]
result = index.query(
    namespace="hybrid-demo", vector=(vectors[-1] * 0.5).tolist(),
    sparse_vector=query_sparse, top_k=3,
    include_metadata=True, include_values=False
)
for item in result.matches:
    print(f"{item.id}: {item.score:.6f} / {item.metadata['text']}")
実行結果は以下のとおりです。画像は、実行時に保存したJSONを表示したもので、Pineconeコンソールの画面ではありません。
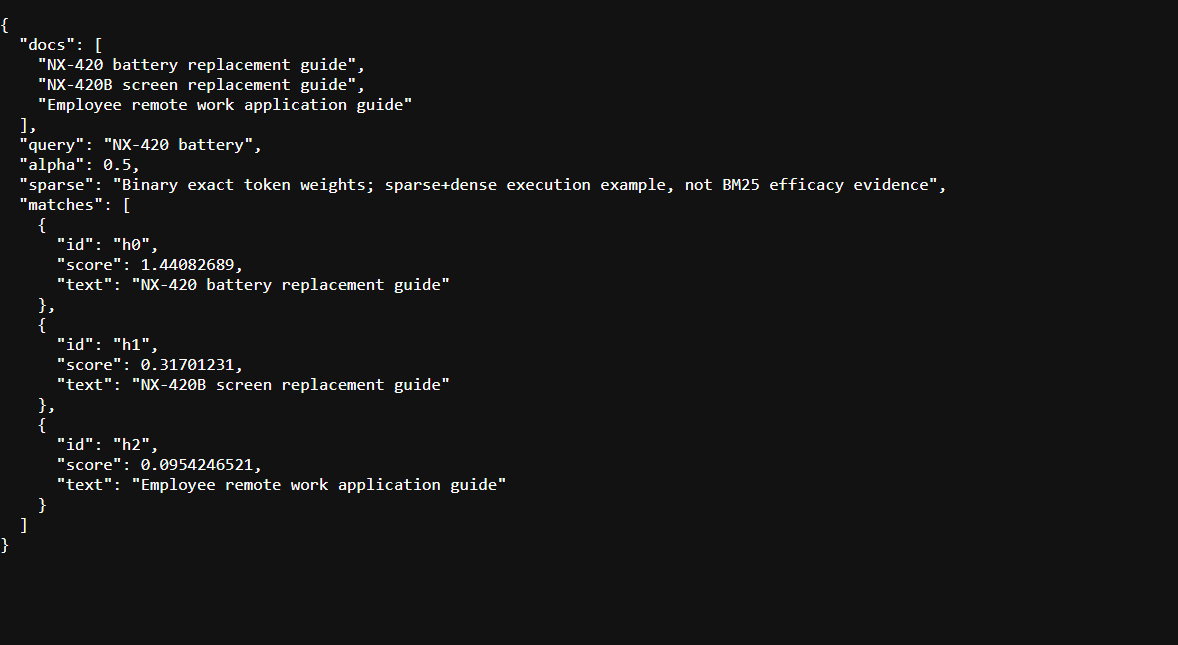
h0: 1.440827 / NX-420 battery replacement guide
h1: 0.317012 / NX-420B screen replacement guide
h2: 0.095425 / Employee remote work application guide
「NX-420 battery replacement guide」が先頭に返りました。今回確認したのは3件への登録と疎密ベクトル検索の動作です。多数の型番や同義語を含む実データでの再現性は確認していません。
Weaviate
Weaviateは、Weaviate社が提供しているオープンソースのベクトルデータベースです。MLモデルをモジュールとして組み込むことで、データベースの内部でオブジェクトのベクトル化ができる仕組みを採用しています。
また、さまざまなモジュールが用意されており、拡張性が高いのもポイント。ベクトル化やバックアップもオプションのモジュールによって実現できます。
Chroma
Chromaは、AIアプリケーション開発のために設計されたオープンソースのベクトルデータベースです。自然言語をベクトル表現で格納できるほか、高精度かつ高速な類似性検索を実現するベクトル検索ができます。
Chromaは、ローカルでデータを保存して類似検索を試せるOSSのデータベースです。公式の導入例では、Pythonから文書を登録して検索する流れを確認できます。小さなRAGの試作や、実現性を確かめるPoCに使える構成です。
今回もローカルのChromaで検索条件を比較しました。無償のOSS版と有料のクラウドサービスは区別してください。Chromaがローカルでも、外部の埋め込みAPIを使えば文章はそのAPIへ送られます。社外送信を避ける場合は、モデルの実行場所と通信先も合わせて確認します。
Oracle
Oracle社が提供しているOracle Databaseは、堅牢性と機能の豊富さが魅力のサービスです。リレーショナルデータベースとして有名な同サービスですが、ベクトルデータベースを活用した検索機能「Oracle AI Vector Search」も提供しています。
Oracle AI Vector Searchを使用すれば、検索した値の意味や意義に基づいて、構造化データと非構造化データをそれぞれ検索できるのが特徴。大規模言語モデル(LLM)なら、検索拡張生成(RAG)を使用して高精度な回答結果を提供できるようになるのが魅力です。
ベクトルデータベース導入時の注意点
ベクトルデータベース導入時は、以下3点に注意する必要があります。
- データの前処理が必要
- システム設計時はスケーラビリティや処理能力を考慮する
- パフォーマンスの最適化が必要
以下でそれぞれ解説するので、ベクトルデータベース導入前に確認しておいてください。
データの前処理が必要
ベクトルデータベースを効果的に活用するには、事前のデータ処理が不可欠です。ベクトル化の前に、データのクリーニングや正規化を実施することで、検索の精度を向上できます。
例えば、テキストデータは不要な単語の除去や単語の形の統一をすると、より意味のあるベクトル表現を作成できます。
また、ベクトルの次元数も考慮すべき要素です。次元が多すぎると計算コストが増大し、逆に少なすぎると十分な情報を保持できない可能性があります。そのため、次元削減技術を活用して適切なバランスを見つけることが重要です。
システム設計時はスケーラビリティや処理能力を考慮する
ベクトルデータベースをシステムに組み込む際には、データ量の増加に対応できる設計が求められます。とくに、大規模なデータセットを扱う場合、データの分散管理やクエリ処理の負荷分散を適切に行うことが重要です。
また、リアルタイム検索が求められる環境では、インデックスの更新頻度や検索遅延の最小化にも注意を払う必要があります。バッチ処理とリアルタイム処理を組み合わせることで、システム全体の効率を最適化できます。
パフォーマンスの最適化が必要
データ量や検索頻度に応じたパフォーマンスチューニングも欠かせません。例えば、頻繁に使用される検索結果をキャッシュすることで、応答時間を短縮できます。
また、インデックスのパラメータ(クラスタ数やツリーの深さなど)を適切に調整することで、検索精度と処理速度のバランスを最適化できます。
さらに、大規模データの検索や更新を高速化するために、GPUを活用する方法もあります。ただし、GPUの導入にはコストがかかるほか、システム管理が複雑になる可能性があるため、事前に十分な検討が必要です。
ベクトルデータベースの課題と将来性
最後に、ベクトルデータベースが抱える主要な課題と将来性について説明します。
ベクトルデータベースが抱える課題
ベクトルデータベースは、高次元データの類似性検索に優れた強力なツールですが、下記のような課題も抱えています。
| 項目 | 内容 |
|---|---|
| スケーラビリティの問題 | 大量のデータや高次元ベクトルを効率的に管理し、処理することは技術的に困難です。これは、特にビッグデータを取り扱う環境でのスケーラビリティに影響を与えます。 |
| 複雑なクエリ処理 | ベクトルデータベースは、類似性検索に特化しているため、従来のリレーショナルデータベースのような複雑なクエリ処理や集計機能には制限があります。 |
| 専門知識の必要性 | ベクトルデータベースの運用や最適化には、専門的な知識や技術が必要です。これにより、一部の組織では導入や管理が難しい場合もあります。 |
ベクトルデータベースは、高次元データの類似性検索に優れた強力なツールですが、上記のような課題も抱えています。導入を検討する際は、システムの要件やデータの特性を踏まえ、適切な設計と運用方針を策定することが重要です。
ベクトルデータベースの将来性
ベクトルデータベースは、AI社会における重要なデータ管理ツールとしての地位を確立しつつあり、今後の技術進化によりその役割と影響力はさらに増すことが予想されます。
| 項目 | 内容 |
|---|---|
| AIと機械学習の進化に伴う需要増 | AIと機械学習の分野が進化するにつれて、非構造化データや高次元データの処理がより重要になります。ベクトルデータベースは、これらのデータを効率的に扱うことができるため、需要が高まると予想されます。 |
| 新しい技術の統合 | 進化する技術との統合により、ベクトルデータベースの性能や機能が向上する可能性は高いです。これには、クラウドコンピューティング、分散処理、AIの最適化技術などが含まれます。 |
| 多様な応用分野への適用 | 類似性検索やパターン認識などの機能は、医療、金融、リテール、エンターテイメントなど多岐にわたる分野で応用される可能性があります。 |
ベクトルデータベースは、AI社会における重要なデータ管理ツールとしての地位を確立しつつあり、今後の技術進化によりその役割と影響力はさらに増すことが予想されます。
理解を深め、しっかりと活用していきたいですね。
なお、AIエージェントの開発方法を知りたい方は、以下の記事をご覧ください。
生成AI開発・業務活用ならWEELへご相談ください
ベクトルデータベースの導入により、高速な類似検索や非構造化データの活用が可能になります。貴社のデータ管理やAI活用の最適な方法を検討してみませんか?
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
ベクトルデータベースについてよくある質問