Llamaindexを使った開発とは?RAG構築の流れや事例、費用相場を解説
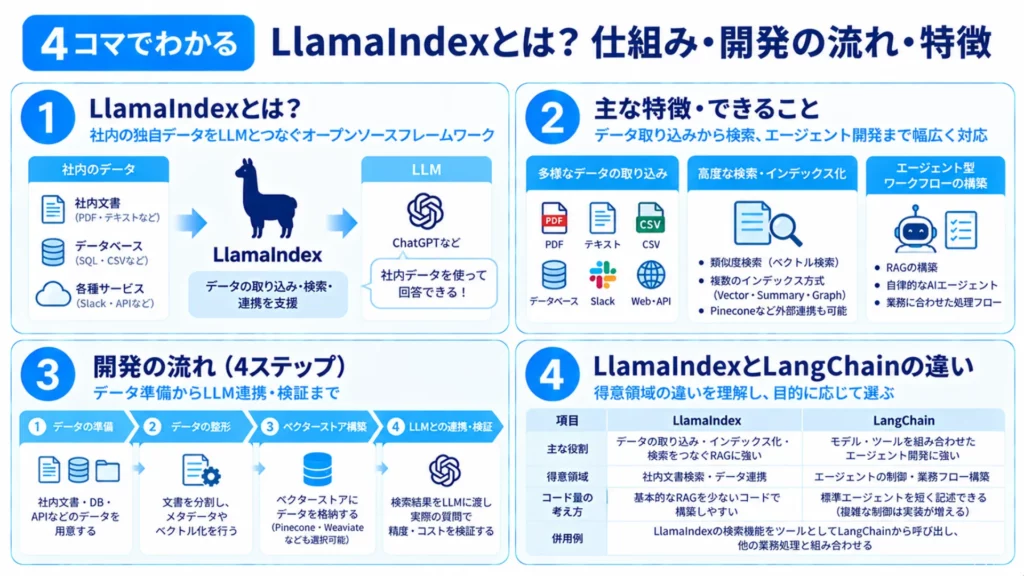
- LlamaIndexは、社内文書やDBなどの独自データをLLMと連携させるためのオープンソースフレームワーク
- 単なるデータ検索にとどまらず、データ読み込みからエージェント型ワークフロー構築まで包括的にサポート
- API機能と組み合わせることで、高精度な社内文書検索や自律的なAIエージェントの開発が可能
LlamaIndexは、社内文書やデータベースをChatGPTなどで使われるLLMとつなぐ開発用フレームワークです。2026年10月時点で、公式サイトは月間2,500万件以上のパッケージダウンロードを公表しています。社内データを使うには、どのような準備が必要なのでしょうか。
この記事では、LlamaIndexの仕組みや開発の流れ、LangChainとの違い、費用・事例を解説します。導入に必要な構成を整理するために、最後までご覧ください。
\生成AIを活用して業務プロセスを自動化/
LlamaIndexとは
LlamaIndexは、自社のデータとLLM(大規模言語モデル)をつなぐオープンソースフレームワークです。LlamaIndex社が開発しており、フレームワークの旧称は「GPT Index」です。
Python版とTypeScript版がありますが、TypeScript版の公式リポジトリは2026年4月30日にアーカイブされています。新規開発では保守状況を確認し、本記事ではPython版を中心に説明します。
LlamaIndex自体はLLMではなく、データの取り込みや検索を組み立てるための部品です。検索結果を回答時の参考情報としてLLMへ渡すRAG(検索拡張生成)に加え、Workflowsを使ったエージェントの処理フローも設計できます。
ベクターストアは、文書を数値化したベクトルなどを保存して検索するための仕組みです。LlamaIndexの標準機能のほか、用途に応じてPineconeなどの外部サービスとも連携できます。
LlamaIndexについて詳しく知りたい方は、下記の記事を併せてご確認ください。
LlamaIndexにできること
LlamaIndexを使ってできることは主に以下の領域に整理されます。
- データコネクタによる多様なデータソースの取り込み
- 高度な検索とインデックス作成
- エージェント型ワークフローの構築
以下では、各機能の役割とLLMとの連携方法を見ていきましょう。
さまざまなデータを読み込み、インデックス化して扱える
LlamaIndexでは、さまざまな形式のデータを読み込み、インデックス化して扱えます。対象となるのは、テキスト・PDF・CSVのほか、SQLデータベースやAPIから取得したデータです。
さらに、データのインデックス化(検索用に整理して保存すること)において、LlamaIndexは用途に応じた複数の手法を提供しています。
| 手法 | 説明 |
|---|---|
| VectorStoreIndex | 文書を分割したノードと埋め込みベクトルを扱い、質問に近いノードを検索する方式。意味に基づく文書検索に利用します。 |
| SummaryIndex | ノードを順番に保持する方式。基本の検索では全ノードを回答生成へ渡すため、文書全体の要約などに利用できます。 |
| PropertyGraphIndex | 情報と関係をラベル付きのグラフとして保持する方式。関係性をたどる検索やベクトル検索を組み合わせられます。 |
VectorStoreIndexは、質問と意味が近い文書を探すRAGで利用できます。PropertyGraphIndexは、人物・組織などの情報とその関係をグラフとして整理する方式です。文章の意味の近さに加えて関係性も検索に使うGraphRAGの構成要素として活用でき、ベクトル検索との組み合わせにも対応します。
インデックスの分類は、公式ドキュメントの「How Each Index Works」を基に整理しています。
類似度検索ができる
LlamaIndexのベクターストアは、データを取り出す際の利便性にも優れています。
各データをベクトルで表現していて、その方向性が近い、つまり似ているもの同士を近くに集めているのがベクターストアの特徴です。これを備えたLlamaIndexはクエリを渡すと、類似度検索を行って関連性の高いデータだけを瞬時に返してくれます。
この長所はLLMとの連携時に活きてきます。最新情報や事実のうち関連性の高いものだけをベクターストアから取り出して、テキスト断片やメタデータとしてプロンプトの文脈に埋め込めるのです。
LlamaIndexはOllamaと組み合わせて開発できる
LlamaIndexは、ローカル環境でLLMを動かすためのツール「Ollama」と連携できます。回答生成用のLLMに加え、埋め込みモデルや文書処理もローカルで動かす構成にすれば、外部APIへ文書データを送信せずにRAGシステムを構築できます。
クラウドのAPI費用を抑えつつ、オンプレミスでのセキュアなAI開発を実現したい企業にとって、この組み合わせは有効な選択肢です。
LlamaIndexはRAG開発に向いている
LlamaIndexは、データの取り込みから検索、LLMへのコンテキスト提供までの一連の流れ(RAGパイプライン)の構築に特化した設計です。特に、複雑なドキュメントのチャンク化(分割)やメタデータの付与、ベクトル検索の最適化など、RAGの精度を高めるための機能が豊富に揃っています。そのため、社内規程やマニュアルなどの大量の文書をベースにしたQ&Aシステムを開発する用途などで活用できます。
LlamaIndexとLangChainの違い
LlamaIndexはデータの取り込み・検索を、LangChainはモデルやツールを組み合わせたエージェントの処理を構成しやすくしています。どちらもRAGとエージェントに対応しており、作りたいシステムの要件から選ぶことが大切です。
| 比較項目 | LlamaIndex | LangChain |
|---|---|---|
| 得意領域 | 文書の取り込み・インデックス化・検索をつなぐRAG。文書を使うエージェントにも対応。 | モデル・ツール・プロンプトなどを組み合わせるエージェント。検索処理も組み込める。 |
| コード量の考え方 | 標準部品で基本のRAGを短く記述できる。評価・権限管理などの実装は別途必要。 | 標準のエージェントを短く記述できる。処理の制御や状態管理に応じて実装が増える。 |
| 併用構成の例 | 文書の取り込みと検索を担当し、検索結果や回答を関数として返す。 | 左記の関数をツールとして呼び出し、ほかの業務処理と組み合わせる。 |
コード量は、同じ機能・モデル・運用条件で比較する必要があります。表は各公式ドキュメントに基づく設計上の整理であり、行数や速度を実測した結果ではありません。
併用する場合は、LlamaIndexの検索処理を関数として公開し、LangChainのツールから呼び出す構成が一例です。LlamaIndex側でもWorkflowsによる処理制御が可能なため、併用が必須というわけではありません。

LlamaIndexを使った開発の流れ
ここからはLlamaIndexとLLMを使って、社内用のAIツールを開発する際の流れを紹介します。まずは以下の4ステップをご覧ください。
- 参照データ(データソース)の準備
- 参照データの整形
- ベクターストアの構築
- LLMとの連携・検証
以降の見出しでは、各工程の作業内容を説明します。開発に必要な準備や注意点を確認していきましょう。
参照データ(データソース)の準備
LlamaIndexとLLMを繋ぐよりも前に、データの準備が最優先です。自社のシステム・サービス・文書など、プロンプトに埋め込みたいデータを用意しましょう。
以下のファイルやデータソースは、対応するReaderや連携機能を使って読み込めます。
- テキスト(.txt)
- ドキュメント(.docx)
- CSV
- SQLデータベース
X(旧Twitter)にはTwitterTweetReader、SlackにはSlackReaderというReaderが用意されています。Readerは各サービスから情報を読み込む部品で、利用にはAPIの認証情報や必要なアクセス権限の設定が必要です。
X APIは2026年10月時点で従量課金制のため、取得費用と利用制限を確認してください。HTML形式のページやメールも、対応するReaderなどで本文を取り出して利用します。
表や図が多いPDFには、レイアウトを考慮して解析するLlamaParseも選択肢です。単純なテキスト抽出で表の対応関係が崩れる場合は、解析結果を比較すると改善につながる可能性があります。
参照データの整形
LlamaIndexにおけるデータ整形(Ingestion)は、精度の高いRAGを構築するための重要なプロセスです。公式のパイプライン(IngestionPipeline)では、以下の3段階で処理が行われます。
| 段階 | 内容 | 説明 |
|---|---|---|
| 1 | Load(読み込み) | 各種データソースからドキュメントを取得します。 |
| 2 | Transform(変換) | ドキュメントを適切なサイズのノードに分割(Chunking)し、メタデータの抽出(Metadata Extraction)やベクトル化(Embedding)を行います。 |
| 3 | Index and store(インデックス化と保存) | 処理されたノードをベクターストアに格納します。 |
IngestionPipelineにドキュメントストアを組み込むと、重複検知が可能です。ベクターストアも連携させることで、変更された文書の再処理・更新にも対応できます。
ベクターストアの構築
データの準備・整形が終わり次第、LlamaIndexのベクターストアにデータを格納していきます。
方法自体は簡単で、数行のPythonコードを実行するだけでベクターストアの構築が完了します。格納先についてはLlamaIndex純正のベクターストアのほか、下記のような外部のベクトルデータベースも選択可能です。
| 名称 | 特徴 | 向いている用途 |
|---|---|---|
| Pinecone | マネージド型のベクトルデータベース。検索基盤の運用をサービス側に任せられます。 | クラウドでの運用負担を抑えたい構成 |
| Weaviate | オープンソースのベクトルデータベース。自社環境での運用やクラウドを選べます。 | 自社運用も含めて配置先を選びたい構成 |
| Chroma | ローカルのインメモリ実行や永続化に対応。インメモリのデータは終了時に失われます。 | ローカルでの試作や検索方法の検証 |
| Qdrant | ベクトル検索と、付随情報による絞り込みに対応。自社運用とクラウドを選べます。 | 文書の属性条件も使う検索 |
| pgvector | PostgreSQLへベクトル検索機能を追加する拡張機能です。 | 既存のPostgreSQLとデータ管理をまとめたい構成 |
各製品の仕様はPinecone・Weaviate・Chroma・Qdrant・pgvectorの公式情報で確認できます。上表の用途は、各製品の特徴を踏まえた選定の目安です。検索速度や精度はデータ量・索引・検索条件によって変わるため、自社の文書と質問で検証しましょう。
LLMとの連携・検証
最後に、検索した参照データをLLMへ渡し、回答を生成する処理を組み込みます。回答生成用のLLMと、類似検索用の埋め込みモデルを区別することが大切です。
ベクトル検索を使う場合、埋め込みモデルで文書と質問を数値の列に変換し、意味の近さを比較します。外部のEmbeddings APIだけでなく、ローカルの埋め込みモデルも利用できるため、有料APIが必須というわけではありません。
OpenAIを利用する場合のAPIとモデルの例を下表にまとめました。2026年10月時点の通常処理・短いコンテキストに対する標準単価で、100万トークン当たりの米ドル表示です。
| API・役割 | モデル例 | 入力料金 | 出力料金 |
|---|---|---|---|
| Responses API 回答生成 | gpt-6-astra | 10.00ドル | 50.00ドル |
| Responses API 回答生成 | gpt-6.1-sol | 2.00ドル | 10.00ドル |
| Responses API 回答生成 | gpt-6-luna | 0.10ドル | 0.50ドル |
| Embeddings API 文書・質問のベクトル化 | text-embedding-3-small | 0.02ドル | 対象外 |
| Embeddings API 文書・質問のベクトル化 | text-embedding-3-large | 0.13ドル | 対象外 |
埋め込みモデルの単価は、text-embedding-3-smallとtext-embedding-3-largeの公式モデルページを参照しています。料金はキャッシュ未使用の場合で、Batch・Flex・Fastなどの別料金やツール利用料は含みません。長いコンテキストやリージョン指定では適用条件が変わるため、公式料金表も確認してください。
LLMにはOpenAIのモデル以外にClaude・Gemini、Ollamaで動かすローカルモデルも選べます。連携後は、実際の質問と正解・根拠文書を用意し、検索結果と生成された回答をそれぞれ検証しましょう。
LlamaIndexを使った開発の費用相場
弊社ではLlamaIndex搭載型AIツールの開発にあたって、プロトタイプ開発とソリューション開発の2プランを用意しております。それぞれの費用相場や開発期間については、下表をご覧ください。
| プロトタイプ開発 | ソリューション開発 | |
|---|---|---|
| 費用相場(総額) | 3,600,000~4,800,000円 | 個別お見積 |
| 期間 | 3ヶ月 | 4ヶ月~ |
| 開発手法 | ウォーターフォール方式 | ハイブリッド方式 (設計&検証はウォーターフォール方式で、各機能の開発はアジャイル方式) |
| 開発できるもの | 既存の基盤モデルを使った、社内向けAIツール | 基盤モデルまで特注の、社外向けAIサービス |
| 内容 | ・学習元データクレンジング ・自社データを学習したチャットボット開発 ・AIと自社システムの連携 ・業務のAI化 | ・AI基盤開発 ・Web開発 ・ネイティブアプリ開発 ・クラウドインフラ開発 |
この2プランのうち、おすすめはローコスト・短期間で取り組めるプロトタイプ開発です。まずは社内業務のAI化・DXからお試しください。
開発費用を抑える方法について詳しく知りたい方は、下記の記事を併せてご確認ください。
LlamaIndexで開発できるもの
LlamaIndexを使えば、自社のデータとAIを連携させた実用的なアプリを手軽に作れます。業務の効率化やサポート対応の改善に役立つ、代表的な5つの開発例を見ていきましょう。
社内文書検索
PDFやWord、社内Wikiなど、あちこちに散らばっているデータをLlamaIndexに読み込ませることで、自然言語で横断的に検索できる仕組みを構築できます。従来のようにフォルダを一つひとつ開いて探す必要がなくなり、「〇〇の手順を教えて」といった曖昧な質問にも対応可能です。
また、検索結果には該当箇所の要約や参照元リンクを含めることができるため、回答の根拠を確認しやすくなります。ナレッジの属人化を防ぎ、業務効率の向上も期待できるでしょう。
社内文書検索を生成AIで実現する方法について、詳しく知りたい方は、以下の記事もご確認ください。
カスタマーサポート向けFAQ検索
大量の製品マニュアルや過去の問い合わせ対応履歴、FAQなどをあらかじめベクトル化しておくことで、カスタマーサポート向けの高度な検索基盤を構築できます。従来のキーワード検索では見つけにくかった情報でも、ユーザーの質問内容に含まれる文脈や意味をもとに、関連性の高い情報を柔軟に抽出できる点が特徴です。
また、検索結果をそのまま回答生成に活用することで、オペレーターの対応時間短縮や回答品質の均一化にもつながります。結果として、顧客満足度の向上と業務効率化の両立が期待できます。
生成AIをカスタマーサポートとして活用する方法について、詳しく知りたい方は、以下の記事をご確認ください。
文書QA
読み込ませた契約書やマニュアル、社内規程などのドキュメントに対して、「この契約書の解約条件は?」といった自然な質問を投げるだけで、該当箇所を引用しながら回答するQAアプリケーションを構築できます。単に該当箇所を検索するだけでなく、内容を要約した上で分かりやすく提示できる点も特徴です。
また、参照元を明示することで回答の根拠を確認しやすくなります。即座に検索できるため、情報確認にかかる時間を削減し、業務効率の向上が期待できます。ただし、正確性が求められる業務では、原文との照合や担当者の確認が必要です。
複数のドキュメントを読み込ませてまとめることができるNotebookLMについて、詳しくは、以下の記事も併せてご確認ください。
SQL連携
LlamaIndexのText-to-SQL機能を活用することで、「先月の売上トップ商品は?」といった自然言語の質問を入力するだけで、裏側で自動的にSQLクエリを生成し、データベースから必要な情報を取得する仕組みを構築できます。
SQLの知識がない非エンジニアでもデータを簡単に活用できる点が特徴です。また、複雑な条件指定や集計処理にも柔軟に対応できるため、分析業務の効率化や意思決定の迅速化につながります。データ活用のハードルが下がれば、組織全体の生産性向上も期待できるでしょう。
LLMとデータベースをつなぐことができるMindsDBについて、詳しく知りたい方は、以下の記事も併せてご確認ください。
エージェント型ワークフロー
複数のデータソース(社内ドキュメントやデータベース、外部APIなど)を横断して情報を取得し、その結果をもとに次のアクションを自動で実行するAIエージェントを構築できます。例えば、問い合わせ内容に応じて関連情報を検索し、必要に応じて社内システムへの登録や通知処理までを一貫して行うことが可能です。
LlamaIndexには、このような一連の処理を柔軟に設計できるワークフロー機能(Workflows)が用意されており、業務プロセスの自動化や高度化を実現しやすくなっています。自動化することで、人手に依存していた複雑な業務の効率化と省力化が期待できます。
AIエージェントのManusについて、詳しく知りたい方は、以下の記事も併せてご確認ください。
LlamaIndexの開発事例4選
ここからはLlamaIndexを使ったAIツールの開発事例を紹介します。いずれもChatGPTと組み合わせたチャットボットですが、工夫したポイントや開発のねらいは異なります。社内用チャットボットを開発する際の参考にしてください。
自社サービスのQ&Aツール
2023年公開の事例として、GMOインターネットグループのグループ研究開発本部は、LlamaIndexとChatGPTを組み合わせたQ&Aツールを紹介しています。自社のVPSサービス「ConoHa」のAPIについて回答する仕組みです。※1
その処理フローを以下に示します。
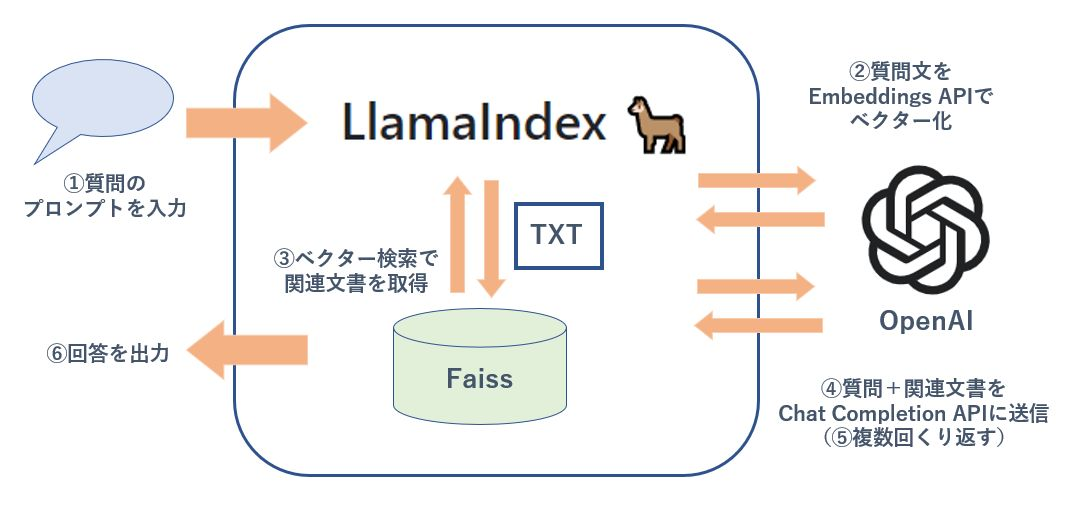
上記の図で注目していただきたいのがLlamaIndexの下部、Metaが開発するベクトル検索ライブラリ「Faiss」の箇所です。この検証では、Faissを使うことで、保存ファイルの容量がSimpleVectorStore使用時の約3分の1になったと報告されています。
ブログのQ&Aチャットボット
2023年公開の事例として、株式会社システムサーバーは、LlamaIndexとChatGPT APIを使ったブログのQ&Aチャットボットを紹介しています。以下は、LINEのトークルームで質問を受け付ける仕組みの処理フローです。※2
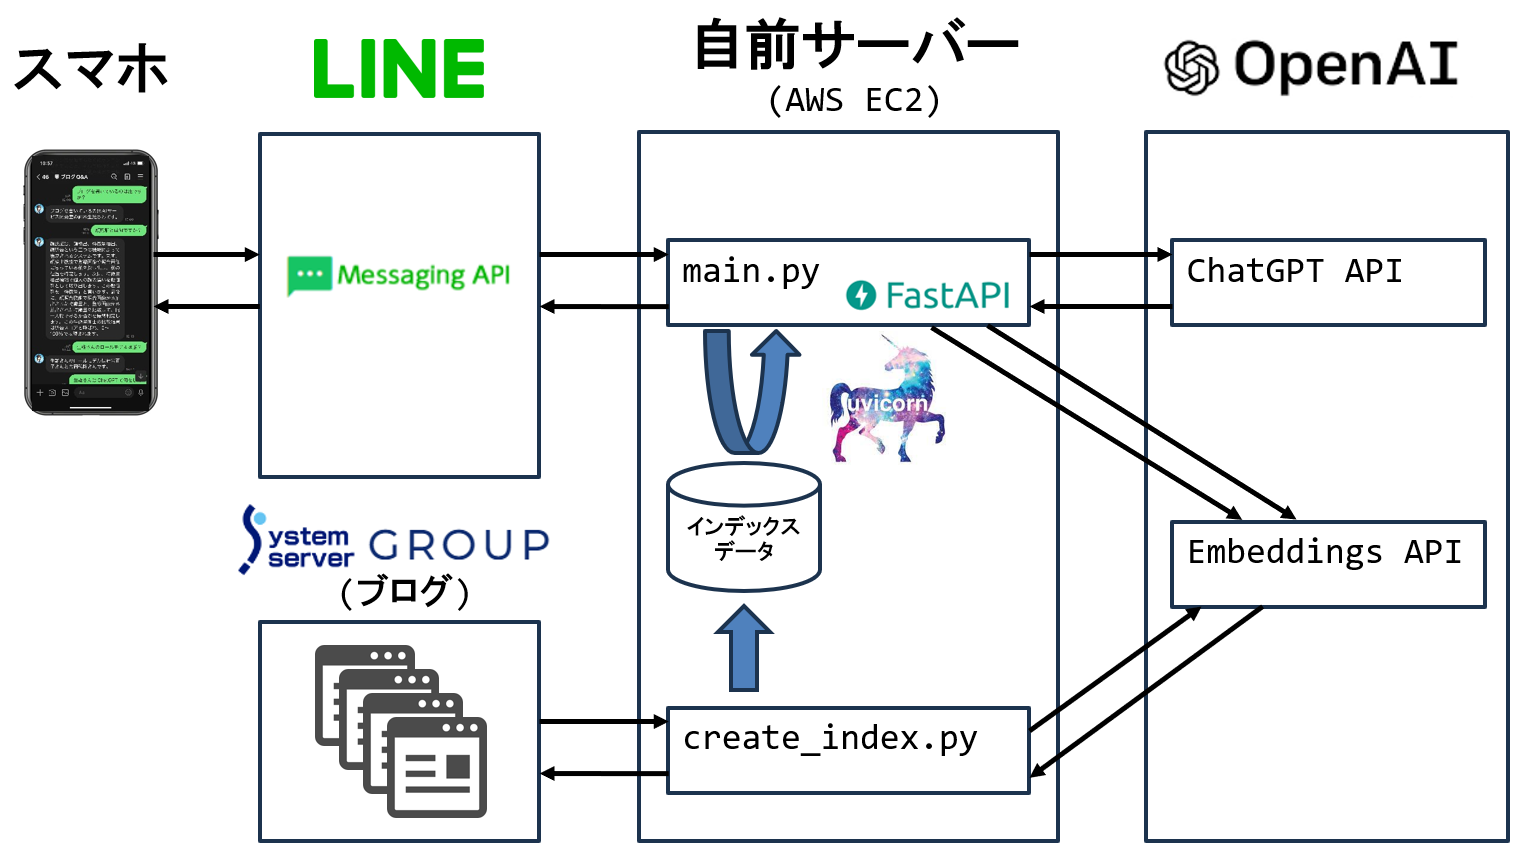
このようにMessaging APIを採用したことで、LINEのトークルーム上での質疑応答を実現しています。ドメイン登録などMessaging APIを使うための準備に手間がかかったそうですが、それでも1時間程度で開発が完了したとのことです。
取扱説明書の質問ボット
2023年公開の事例として、株式会社GIGは、LlamaIndexとGPT-4を組み合わせた質問ボットの検証を紹介しています。TANITAの体重計の説明書PDFを読み込み、「乗るピタ」機能について質問したところ、機能の説明と注意点を含む回答が得られたと報告しています。※3
株式会社GIGの事例のようにLlamaIndexとChatGPTを組み合わせれば、コンテンツの制作時に必要な専門情報の確認を効率化できるでしょう。
AIチャットボットについて詳しく知りたい方は、下記の記事を併せてご確認ください。
社内問い合わせ対応の自動化
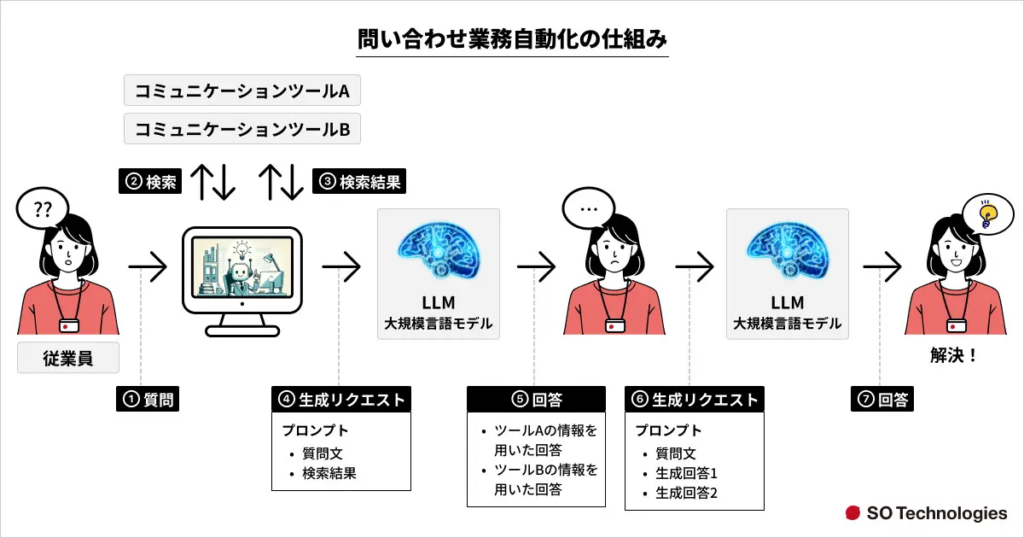
SO Technologies株式会社では、ChatGPT(GPT-4o)とLlamaIndexを活用し、契約・取引・受発注・経理・総務などの社内問い合わせ対応を自動化する事業支援AIチャットボットを開発しました。※4
正確な事実が蓄積されたNotionと、流動的な情報が多いSlackから関連情報を取得して回答を生成する仕組みを構築しており、発表時点では、社内問い合わせ対応工数を約3割削減できる見込みとしています。
生成AI開発・業務活用ならWEELへご相談ください
LlamaIndexを使うと、社内文書の取り込みや検索、LLMと連携した回答生成を組み合わせたRAGシステムを開発できます。実務で使うには、参照データの整備から検索精度の検証、更新・権限管理までを設計することが重要です。
まずは対象業務を絞り、少量の文書で必要な回答が得られるかを確かめましょう。WEELでは、LlamaIndexを活用した開発や生成AIの業務導入についてご相談を受け付けています。構成選びや本番運用への移行にお悩みの方は、無料相談をご利用ください。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
LlamaIndexのよくある質問