DeepSeek-R1とは?料金・使い方・性能や日本語対応モデルについて解説
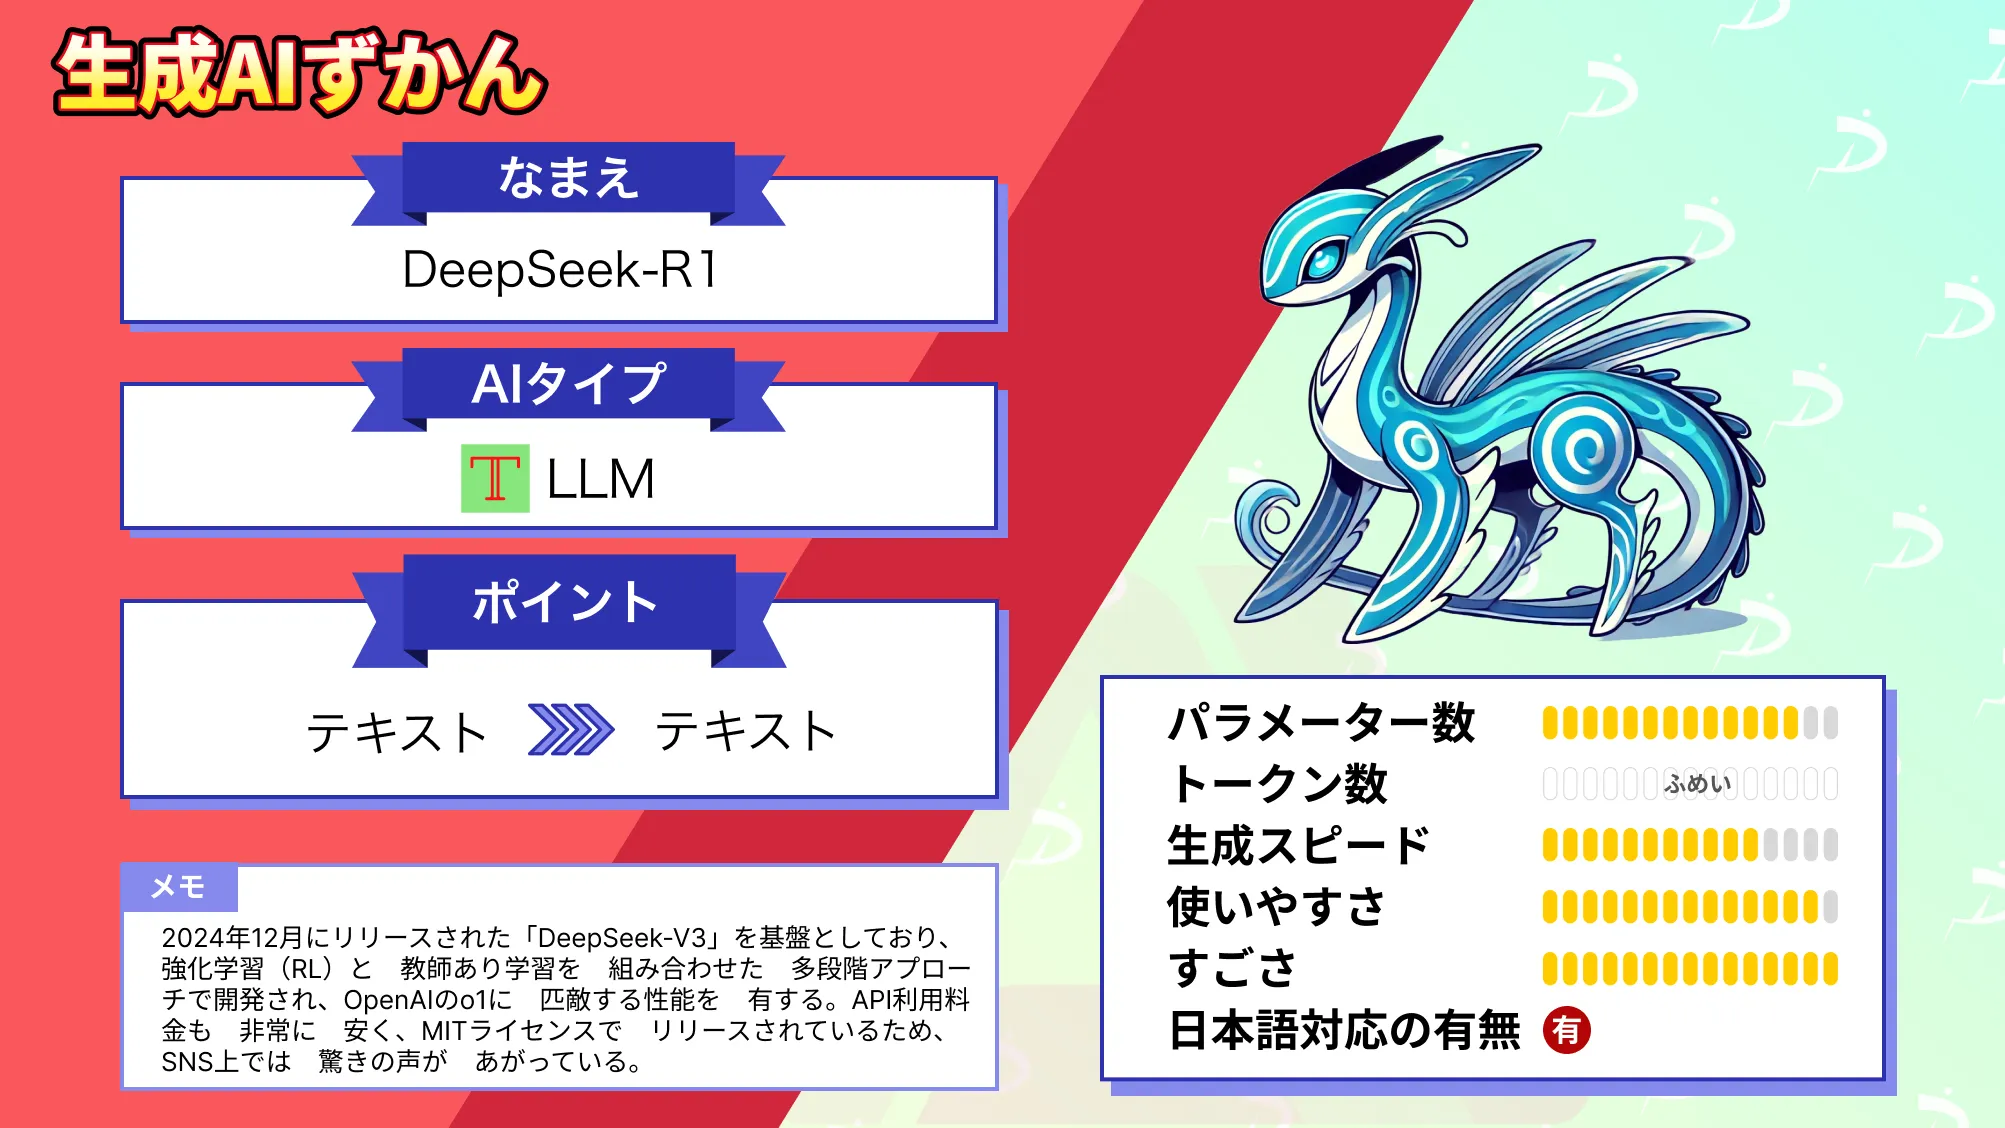
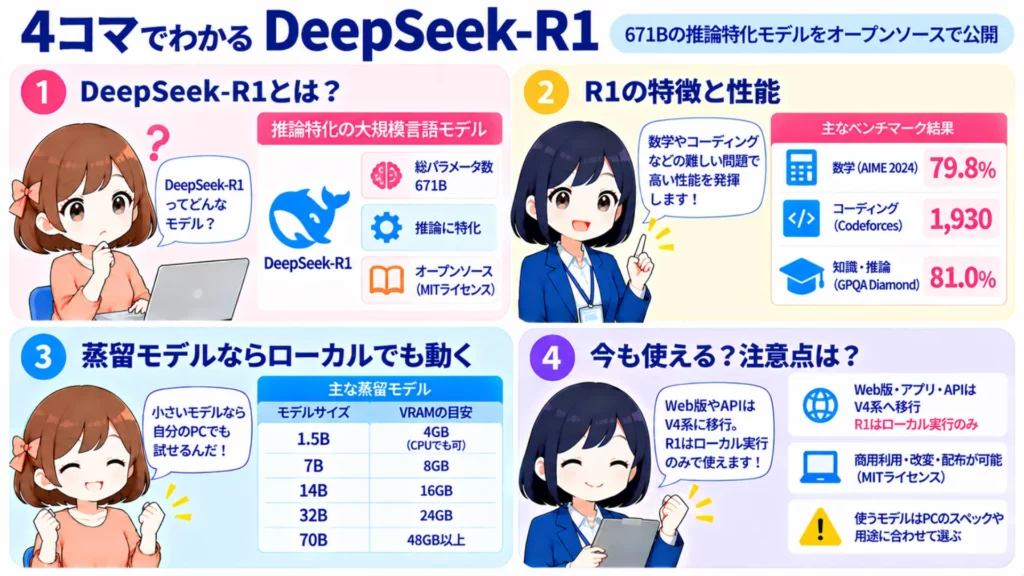
- DeepSeek-R1は総パラメータ数671Bの推論特化モデルで、1.5B〜70Bの蒸留モデルならローカルでも動作
- Web版・アプリ・APIは2026年7月までにV4系へ移行し、R1そのものを使えるのはローカル実行のみ
- MITライセンスで商用利用が可能で、日本語の追加学習モデルも公開
2025年1月、DeepSeekは推論型大規模言語モデル「DeepSeek-R1」をオープンソースで公開しました!
DeepSeek-R1は、総パラメータ数671Bの大規模モデルです。数学やコーディングではOpenAI o1に並ぶ性能を示し、1.5B〜70Bの蒸留モデルなら手元のPCでも動かせます。
本記事では、DeepSeek-R1の性能・料金・日本語モデル・ローカルでの使い方を解説し、後継のV4 Flashと比べた検証結果も紹介します。
\生成AIを活用して業務プロセスを自動化/
DeepSeek-R1とは
DeepSeek-R1は、2024年12月にリリースされた「DeepSeek-V3」を基盤としており、強化学習(RL)と教師あり学習を組み合わせた多段階アプローチで開発されています。
初期モデル「DeepSeek-R1-Zero」は、自己進化プロセスを通じ、推論能力は格段にパワーアップしましたが、可読性の低さや言語の混在といった課題があったようです。これを改善するため、教師あり学習と強化学習(RL)を組み合わせて開発されたのが「DeepSeek-R1」です。
研究コミュニティを支援するため、「DeepSeek-R1-Zero」「DeepSeek-R1」と、LlamaとQwenをベースにR1から抽出した6つの高密度モデルがオープンソース化されています。
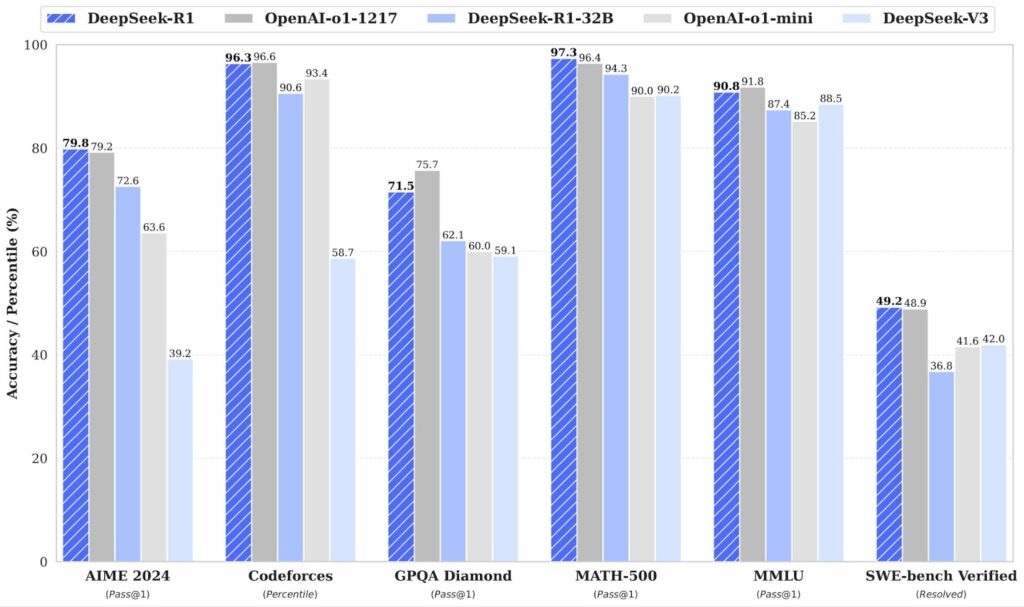
「DeepSeek-R1-Distill-Qwen-32B」は、様々なベンチマークでOpenAI-o1-miniを上回る性能を叩き出したようです。
| 項目 | 内容 |
|---|---|
| 提供元 | DeepSeek(中国) |
| 公開日 | 2025年1月20日 |
| ベースモデル | DeepSeek-V3 |
| パラメータ数 | 総パラメータ671B/アクティブ37B(MoE) |
| コンテキスト長 | 128K |
| ライセンス | MIT(蒸留モデルはベースモデルのライセンスを継承) |
| 最終アップデート | DeepSeek-R1-0528(2025年5月28日) |
| R1を使える手段 | ローカル実行(Hugging Face・Ollamaなど)のみ |
重みが公開されたオープンウェイトモデル
DeepSeek-R1の大きな特徴は、モデルの重みそのものがMITライセンスで公開されている点です。Hugging FaceやOllamaからダウンロードすれば、ネットに接続しない環境でもR1を動かすことが可能。
Web版やAPIがV4系に切り替わった今、R1そのものを使い続けられるのはこのオープンウェイトがあるからです。社外にデータを出せない業務や、オンプレミスでの推論モデル導入を考えている企業にとって、今も検討する価値のあるモデルではないでしょうか。
DeepSeek-R1は今も使える?V3・V4との違いと現在の位置づけ
2026年10月時点でDeepSeek-R1そのものを使えるのはローカル実行だけです。Web版・アプリ・APIは、すでに後継のV4系へ切り替わっています。
R1の登場後、DeepSeekのモデルは次のように移り変わってきました。
| 時期 | モデル・出来事 | 内容 |
|---|---|---|
| 2024年12月 | DeepSeek-V3 | 汎用のMoEモデル。R1のベース |
| 2025年1月 | DeepSeek-R1 | 推論特化モデル。APIでは「deepseek-reasoner」として提供 |
| 2025年5月 | DeepSeek-R1-0528 | R1の最終アップデート |
| 2025年8月 | DeepSeek-V3.1 | 思考モードと非思考モードを1つのモデルで切り替えるハイブリッド推論。deepseek-reasonerの中身もV3.1へ |
| 2025年12月 | DeepSeek-V3.2 | deepseek-chat・deepseek-reasonerがV3.2へ |
| 2026年4月 | DeepSeek-V4(Pro・Flash) | 1Mコンテキストの次世代モデル。旧モデル名の廃止を予告 |
| 2026年7月 | 旧モデル名の廃止 | deepseek-chat・deepseek-reasonerが7月24日に提供終了 |
| 2026年9月 | DeepSeek-V4.1-Flash | 新アーキテクチャの最小モデル。APIの「deepseek-flash」 |
注目したいのは、APIの「deepseek-reasoner」という名前のまま、中身が途中で入れ替わっていた点です。2025年8月以降はV3.1・V3.2の思考モードが応答しており、R1のつもりで呼び出していても実際には後継モデルが使われていました。
では、R1と現行のV4系は何が違うのでしょうか。R1-0528と最新のV4.1-Flashを比べると、次のようになります。
| 項目 | DeepSeek-R1(R1-0528) | DeepSeek-V4.1-Flash |
|---|---|---|
| 位置づけ | 推論特化の第1世代 | 汎用・エージェント向けの次世代 |
| パラメータ数 | 総671B(アクティブ37B) | 総552B(MoE) |
| コンテキスト長 | 128K | 1M |
| 画像の入力 | 非対応 | 対応 |
| 得意な領域 | 数学・単発のコーディング問題 | ツール実行・エージェント処理・長文処理 |
| ライセンス | MIT | MIT |
| 使える場所 | ローカルのみ | Web版・アプリ・API |
ベンチマークでも差は明らかです。GPQA DiamondはR1-0528の81.0に対してV4.1-Flashが90.9、Codeforcesのレーティングも1930と3471で大きく開いています。
DeepSeek-R1のライセンス
DeepSeek-R1はMITライセンスでリリースされており、詳細については以下の通りです。
| 利用用途 | 可否 |
|---|---|
| 商用利用 | ⭕️ |
| 改変 | ⭕️ |
| 配布 | ⭕️ |
| 特許使用 | 不明(明記なし) |
| 私的利用 | ⭕️ |
商用利用や改変等、問題なく利用できますね。
これだけコストパフォーマンスの高いモデルを、自由に商用利用・改変等できてしまうのは驚きですね。
ただし、ライセンスについては変更となる可能性もありますので、利用する際は最新情報をチェックするようにしましょう!
また、R1の出力を使って別のモデルを学習させる蒸留も認められているのが特徴。商用利用や改変を含め、自由度の高いライセンスです。
一方で、蒸留モデルはベースモデルのライセンス条件を引き継ぐ点に注意が必要です。
| 蒸留モデル | ベースモデル | 引き継ぐライセンス |
|---|---|---|
| R1-Distill-Qwen-1.5B・7B・14B・32B | Qwen2.5系 | Apache 2.0 |
| R1-0528-Qwen3-8B | Qwen3-8B | Apache 2.0 |
| R1-Distill-Llama-8B | Llama-3.1-8B | Llama 3.1コミュニティライセンス |
| R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | Llama 3.3コミュニティライセンス |
DeepSeek-R1の性能
DeepSeek-R1の本体は、総パラメータ数671B(6,710億)のうち、推論時には37Bだけを動かすMoE構造の大規模モデルです。ここでは、ベンチマークから見た推論性能と、1.5B〜70Bまでそろった蒸留モデルのモデルサイズを順に解説します。
高度な推論能力
英語タスクではMMLUが90.8%、MMLU-Reduxが92.9%、MMLU-Proが84.0%を記録し、いずれもGPT-4oやClaude 3.5 Sonnet以上の性能を示しています。
| モデル名 | パラメータ数 | MMLU | MMLU-Redux | MMLU-Pro | 特徴 |
|---|---|---|---|---|---|
| DeepSeek-R1 | 6,710億 | 90.8 | 92.9 | 84.0 | ・数学、コーディング、推論タスクが高性能・APIアクセス料金がお手頃・パラメータ15億〜700億の蒸留モデルも公開 |
| Claude-3.5-Sonnet-1022 | 非公開 | 88.3 | 88.9 | 78.0 | ・高度な文脈理解と会話能力 |
| GPT-4o 0513 | 非公開 | 87.2 | 88.0 | 72.6 | ・高度な自然言語処理能力 |
| DeepSeek V3 | 6,710億 | 88.5 | 89.1 | 75.9 | ・生成速度が高速(60トークン/秒) |
| OpenAI o1-mini | 非公開 | 85.2 | 86.7 | 80.3 | ・推論能力を強化した小型モデル |
| OpenAI o1-1217 | 非公開 | 91.8 | 非公開 | 非公開 | ・複雑な問題解決能力を持つ |
数学タスクの性能は特に優れており、MATH-500が97.3%、AIME 2024が79.8%と最高水準の結果を記録しています。
これはOpenAI o1-1217(AIME 2024:79.2%、MATH-500:96.4%)をわずかに上回る数値です。こうした推論能力のもとになっているのは、教師データを使わず強化学習だけで「答える前に考える」力を引き出した、R1-Zeroの開発手法です。
軽量モデル
DeepSeek-R1本体は671Bと巨大なため、そのまま動かすにはデータセンター規模の設備が必要です。そこでDeepSeekは、R1の推論能力を小さなモデルに移し替えた蒸留モデルも同時に公開。
蒸留モデルは1.5B・7B・8B・14B・32B・70Bと豊富なサイズバリエーションがあり、32BモデルはOpenAI o1-miniと同等の性能を示しています。
※ただし、32Bモデルは量子化して軽くしても20GB前後のVRAM(GPUメモリ)が目安となり、十分なメモリを備えたPCで実行可能です。
小さいモデルほど必要なGPUメモリは少なく、1.5BならGPUのないPCでも試せます。用途やPCのスペックに合わせてパラメータ数を選べるのが、蒸留モデルの利点といえるでしょう。
R1-0528で推論の深さと正確性が向上
2025年5月には、改良版の「DeepSeek-R1-0528」が公開されました。計算資源の追加と学習後の調整の最適化により、推論の深さと推論能力が大きく向上。
変化がわかりやすいのは、考える量そのもの。AIMEの1問あたりに使うトークン数は平均1万2,000から2万3,000へとほぼ倍増し、より時間をかけて考えるモデルになりました。
| ベンチマーク | DeepSeek-R1 | DeepSeek-R1-0528 |
|---|---|---|
| AIME 2024(数学) | 79.8 | 91.4 |
| AIME 2025(数学) | 70.0 | 87.5 |
| HMMT 2025(数学) | 41.7 | 79.4 |
| GPQA-Diamond(知識・推論) | 71.5 | 81.0 |
| LiveCodeBench(コード) | 63.5 | 73.3 |
| Codeforces(コード) | 1530 | 1930 |
| SWE Verified(コード) | 49.2 | 57.6 |
| Aider(コード) | 57.0 | 71.6 |
性能面だけでなく、使い勝手も改善されました。ハルシネーションが抑えられたほか、JSON出力や関数呼び出し、システムプロンプトにも対応。
あわせて、R1-0528の推論過程をQwen3-8Bに学習させた蒸留モデル「DeepSeek-R1-0528-Qwen3-8B」も登場。8Bクラスの手軽なサイズで最新のR1系を試せる選択肢といえるでしょう。
DeepSeek-R1の蒸留モデル一覧と必要なGPUメモリ
DeepSeek-R1をローカルで動かすなら蒸留モデルが主な選択になります。モデルごとのベース・ライセンス・必要なVRAMの目安は以下のとおり。
| モデル | ベースモデル | ベースのライセンス | 4bit量子化時のサイズ | VRAMの目安 | Ollamaのタグ |
|---|---|---|---|---|---|
| R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | Apache 2.0 | 約1.1GB | 4GB(CPUでも可) | deepseek-r1:1.5b |
| R1-Distill-Qwen-7B | Qwen2.5-Math-7B | Apache 2.0 | 約4.7GB | 8GB | deepseek-r1:7b |
| R1-Distill-Llama-8B | Llama-3.1-8B | Llama 3.1ライセンス | 約4.9GB | 8GB | なし(8bタグはR1-0528-Qwen3-8Bに更新) |
| R1-0528-Qwen3-8B | Qwen3-8B | Apache 2.0 | 約5GB | 8GB | deepseek-r1:8b |
| R1-Distill-Qwen-14B | Qwen2.5-14B | Apache 2.0 | 約9GB | 16GB | deepseek-r1:14b |
| R1-Distill-Qwen-32B | Qwen2.5-32B | Apache 2.0 | 約18〜20GB | 24GB | deepseek-r1:32b |
| R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | Llama 3.3ライセンス | 約40GB | 48GB以上(複数GPU) | deepseek-r1:70b |
| R1-0528(本体) | – | MIT | 約335GB | データセンター規模 | deepseek-r1:671b |
※VRAMの数値は量子化の方式・コンテキスト長・実行環境によって変わるため、あくまで目安です。
手持ちのGPUからモデルを選ぶなら、次のように考えると良いでしょう。
| GPUメモリ(VRAM) | 選びやすいモデル |
|---|---|
| 4GB程度・GPUなし | 1.5B |
| 8GB | 7B・8B(R1-0528-Qwen3-8B) |
| 16GB | 14B |
| 24GB | 32B |
| 48GB以上 | 70B |
迷ったら、R1-0528の推論過程を学習したDeepSeek-R1-0528-Qwen3-8Bから試すのがおすすめ。8GBクラスのGPUで動き、R1系の最新の挙動を確かめられます。
32Bモデルは、量子化しても20GB前後のVRAMが必要です。16GB以下のGPUを積んだ一般的なPCでは動かないと考えておきましょう。
DeepSeek-R1の料金
2026年10月時点で、DeepSeek-R1そのものはAPIで提供されていません。R1を使うならローカル実行(無料)、APIを使うなら後継のV4系の料金がかかります。
| 利用形態 | 料金 | 動いているモデル |
|---|---|---|
| Web版 | 無料 | V4系(R1は選べない) |
| スマホアプリ | 無料 | V4系(R1は選べない) |
| API | 従量課金 | deepseek-flash・deepseek-v4-pro |
| ローカル | 無料(GPUなどの機材費は別) | R1・R1-0528・蒸留モデル |
APIの料金は以下のとおり。時間帯によって単価が変わる2段階制を採用しています。
| 項目 | deepseek-flash(V4.1-Flash) | deepseek-v4-pro |
|---|---|---|
| コンテキスト長 | 1M | 1M |
| 最大出力 | 384K | 384K |
| 入力(キャッシュヒット) | $0.003~$0.006 | $0.022~$0.044 |
| 入力(キャッシュミス) | $0.15~$0.30 | $0.66~$1.32 |
| 出力 | $0.60~$1.20 | $1.98~$3.96 |
ピーク時間はUTC基準で決められています。日本時間に直すと次のとおりです。
| 日本時間 | 区分 |
|---|---|
| 平日 10:00〜13:00 | ピーク |
| 平日 15:00〜19:00 | ピーク |
| 平日 上記以外の時間帯 | オフピーク(半額) |
| 土日・中国の祝日 | 終日オフピーク(半額) |
つまり、平日の昼〜夕方に使うと割高で、夜〜朝と土日は半額。急ぎでない大量処理を夜間に回せば、コストを大きく抑えられるでしょう。
もう一つ見逃せないのが、キャッシュの効果です。deepseek-flashの入力はキャッシュヒット時とミス時で50倍の差があり、同じ前置きのプロンプトを繰り返し使う設計にするほど安くなります。
DeepSeekの安全性
DeepSeekの安全性は、公式のWeb版・アプリ・APIを使うか、モデルをダウンロードしてローカルで動かすかで大きく変わります。ここでは、それぞれの使い方で押さえておきたい注意点を解説します。
アプリ・API利用時の注意点
公式のWeb版・アプリ・APIに入力したデータは、中国のサーバーで収集・処理・保存されます。プライバシーポリシーには、入力内容やアップロードしたファイル、チャット履歴をモデルの学習や技術改善に使う旨も記載されています。
学習への利用を止める「オプトアウト」の権利は用意されているものの、設定画面で切り替えるのではなく、privacy@deepseek.comへのメール申請が必要です。
こうした点を受けて、2025年には日本を含む各国の公的機関が注意喚起や利用制限を行いました。
| 国・機関 | 時期 | 内容 |
|---|---|---|
| 個人情報保護委員会 | 2025年2月3日 | データが中国のサーバーに保存され、中国の法令が適用されることを情報提供※1 |
| デジタル庁(デジタル社会推進会議幹事会事務局) | 2025年2月6日 | 政府機関に対し、要機密情報を扱わないなど生成AIの業務利用時の注意を喚起※2 |
| イタリア | 2025年1月 | データ保護当局がアプリのブロックを命令 |
| 韓国 | 2025年2月 | 新規ダウンロードを停止(2025年4月28日に再開) |
| 台湾 | 2025年2月 | 政府部門での利用を禁止 |
| オーストラリア | 2025年2月 | 政府端末での利用を禁止 |
| 米国 | 2025年1月〜 | テキサス州などが州政府端末での利用を禁止 |
オープンモデル(ローカル)利用時の注意点
Hugging FaceやOllamaからモデルをダウンロードしてローカルで動かす場合、入力したデータが外部のサーバーに送られることはありません。機密情報を扱う必要があるなら、こちらの方法がおすすめです。
一方で、運用の責任は全て自分たちで負うことになります。主な注意点は以下のとおりです。
| 注意点 | 内容 |
|---|---|
| 出力の正確性 | ハルシネーションはゼロではないため、重要な判断は人が確認する |
| ライセンス | 蒸留モデルはベースモデルの条件を引き継ぐ |
| 機材とコスト | GPUの購入費・電気代・保守の手間がかかる |
| モデルの入手元 | 公式のリポジトリなど、信頼できる配布元から取得する |
| 今後の更新 | R1系の新モデルは公開されておらず、性能の改善は見込めない |
DeepSeek-R1の日本語モデルについて
サイバーエージェントは2025年1月27日に、日本語に対応したLLM「DeepSeek-R1-Distill-Qwen-14B/32B-Japanese」をHugging Face上で公開しました。※3
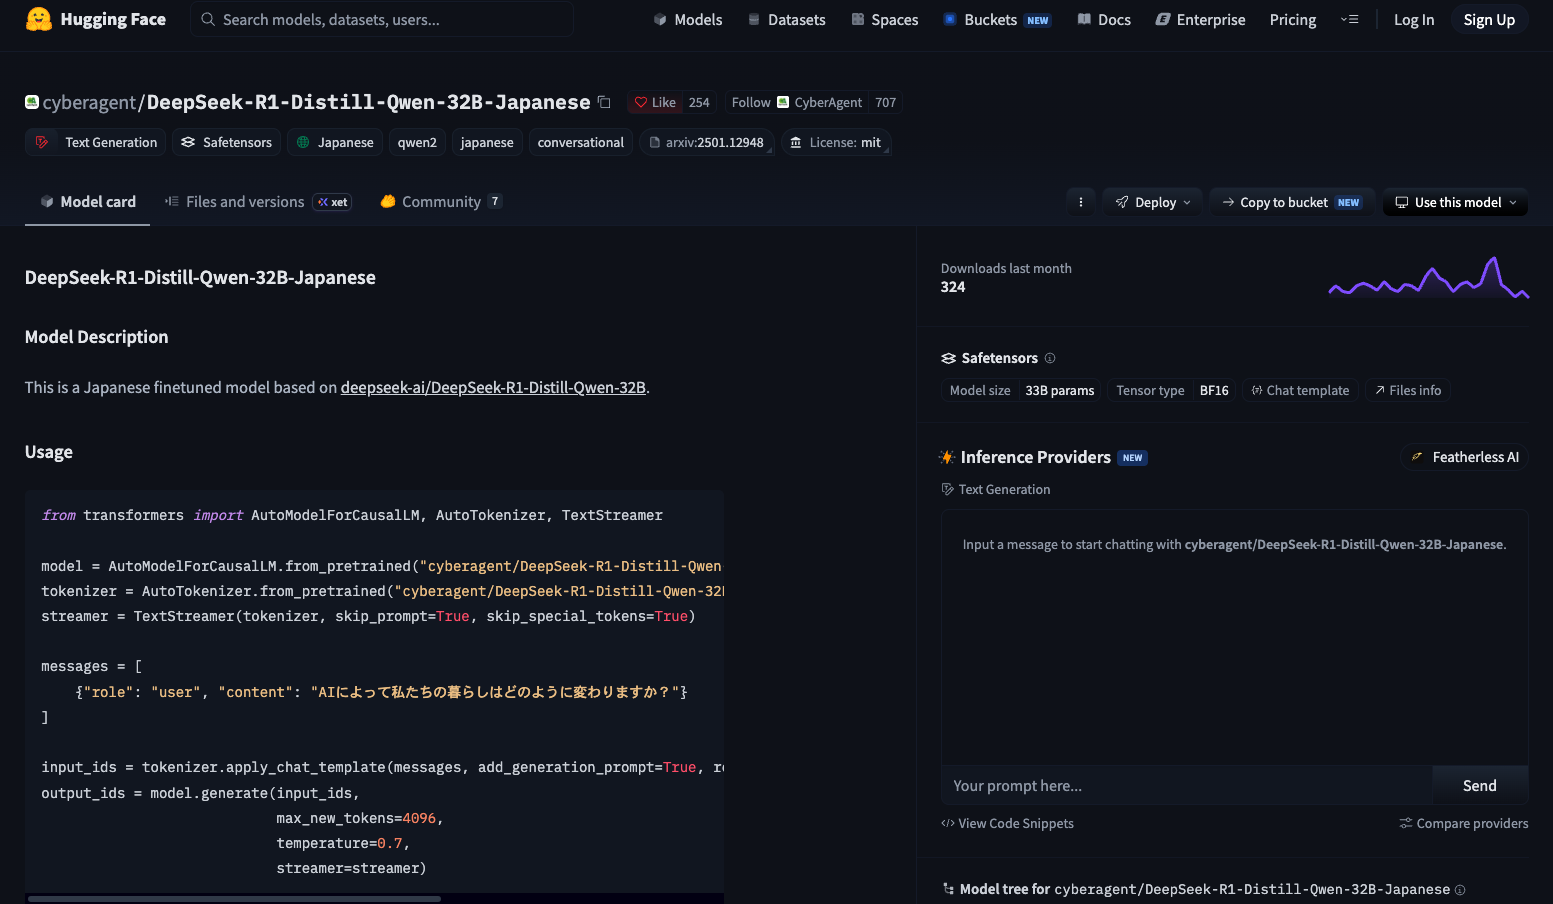
このLLMは「DeepSeek-R1-Distill-Qwen-14B/32B」をベースに、日本語を追加学習させたモデルです。32B(320億)のパラメータを持つ大規模モデルをベースにすることで、日本語の複雑な文脈やニュアンスを正確に捉えることを可能にしました。
| 項目 | DeepSeek-R1-Distill-Qwen-14B-Japanese | DeepSeek-R1-Distill-Qwen-32B-Japanese |
|---|---|---|
| 開発元 | サイバーエージェント | サイバーエージェント |
| 公開日 | 2025年1月27日 | 2025年1月27日 |
| ベースモデル | DeepSeek-R1-Distill-Qwen-14B | DeepSeek-R1-Distill-Qwen-32B |
| パラメータ数 | 約140億(14B) | 約320億(32B) |
| ライセンス | MIT | MIT |
| VRAMの目安(4bit量子化) | 16GB | 24GB |
| VRAMの目安(量子化なし・BF16) | 約30GB | 約65GB |
| 向いている用途 | まず日本語のR1系を試したい場合 | 日本語の精度を重視する場合 |
DeepSeek-R1の使い方
実際に「DeepSeek-R1」を使っていきましょう!
2026年10月時点で、DeepSeekを使う方法は以下の5つです。
| 利用方法 | 料金 | 動作するモデル | R1を使えるか |
|---|---|---|---|
| 1.WebUI | 無料 | V4系 | × |
| 2.スマホアプリ | 無料 | V4系 | × |
| 3.API | 従量課金 | deepseek-flashなど | × |
| 4.ローカル環境(Hugging Face) | 無料(機材費は別) | R1・蒸留モデル | ○ |
| 5.Ollama | 無料(機材費は別) | R1・蒸留モデル | ○ |
WebUI・アプリ・APIは、R1ではなく後継のV4系で動作しています。R1そのものを使いたい場合は、4・5のローカル実行を選んでください。
各利用方法の設定フローを1つずつまとめていきます。
1.WebUI
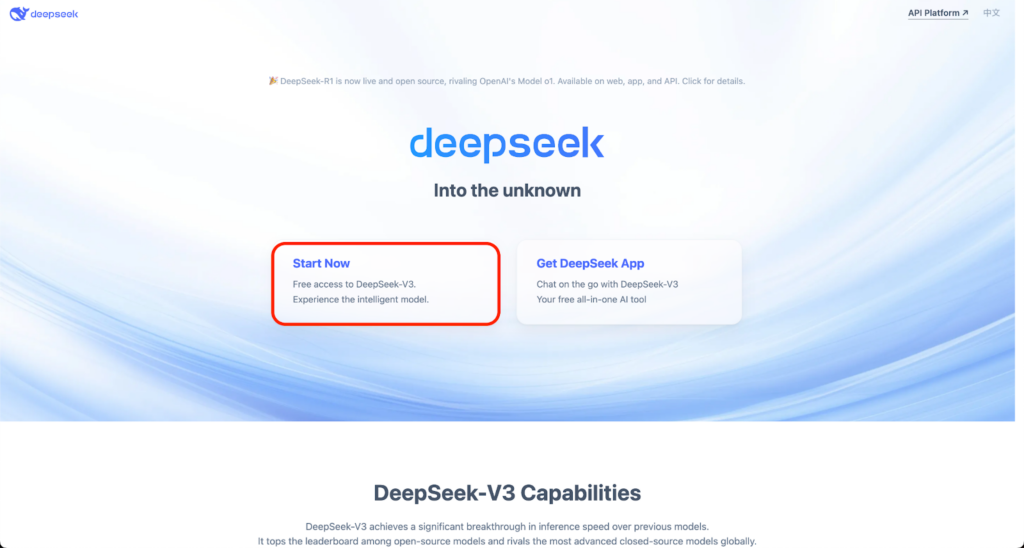
公式サイトにアクセスし「Start Now」をクリック
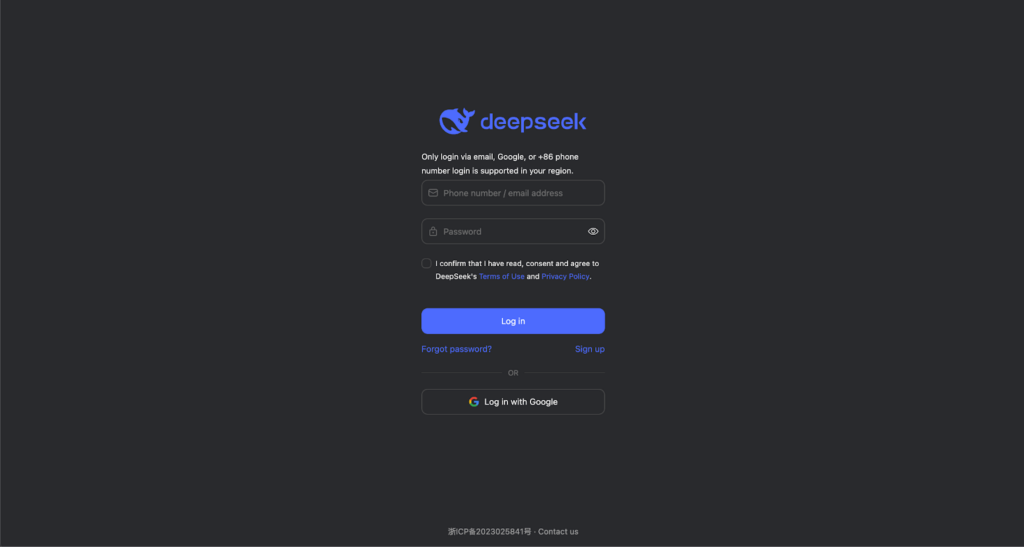
メールアドレスとパスワードを登録するかGoogleでログイン
WebUIが表示されれば利用開始
ログインするとWebUIが表示されるので、これで利用可能になりました。
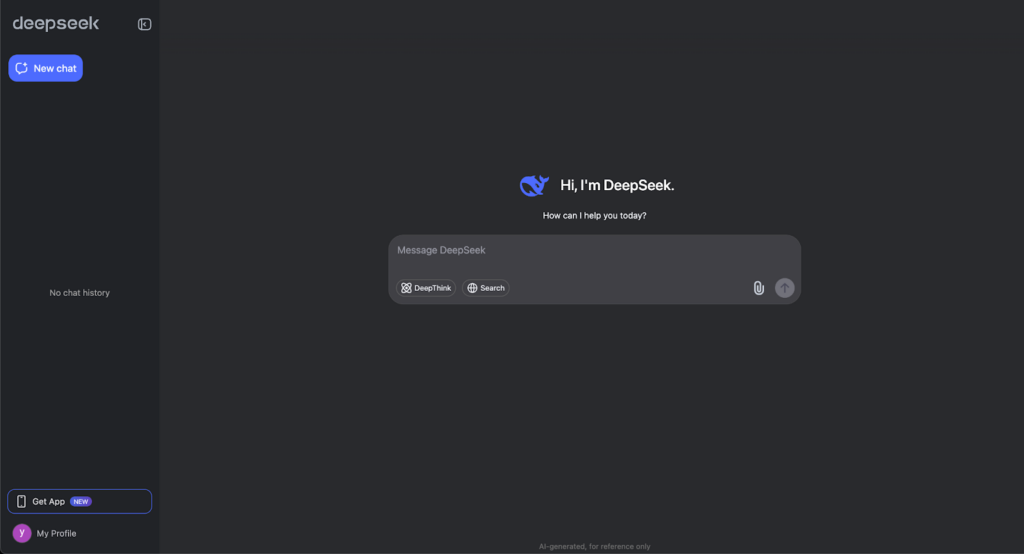
かなりChatGPTやChatbot-UIに似たインターフェースで使いやすそうですね。
簡単に設定できるのも非常にポイントが高いです。
Chatbot-UIについて気になる方は、以下の記事も参考にしてみてください。
2.スマホアプリ
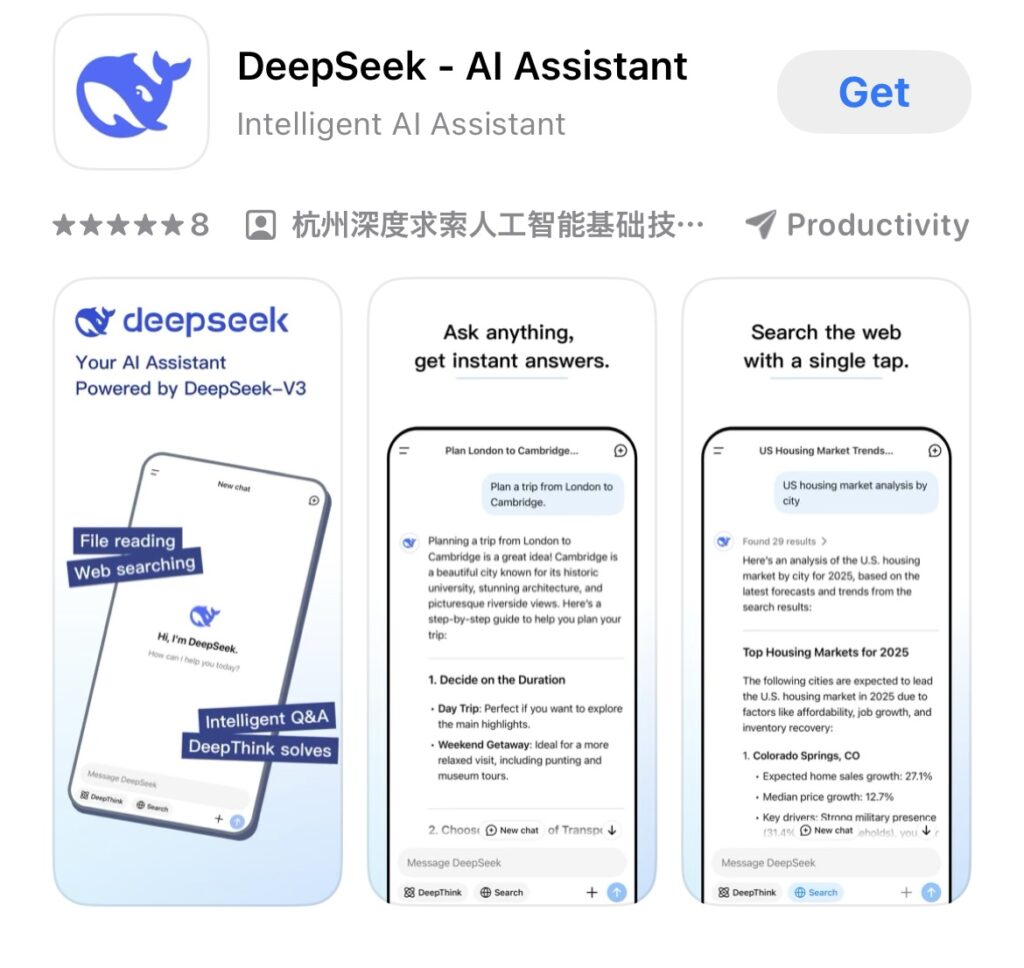
DeepSeekスマホアプリ版は、App StoreやGoogle Play Storeから無料でダウンロード可能です。
ストアで「DeepSeek」と検索すれば上位に出てくると思います。
アプリをダウンロード
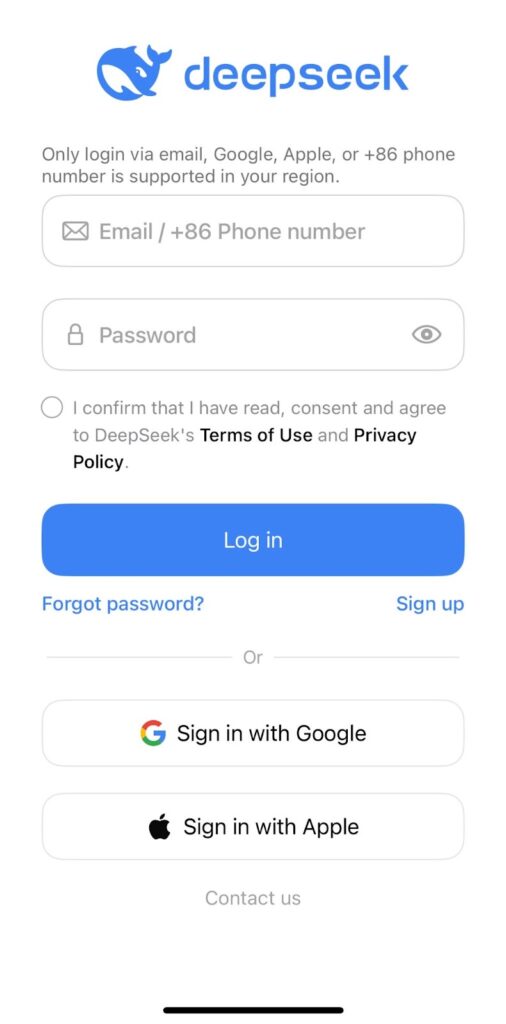
メールアドレスとパスワードを登録するかGoogleでログイン
チャット画面で質問を入力
ログインするとチャット画面が表示されます。
赤枠の「DeepThink」をオンにすると、考える過程を経てから回答する思考モードで使えます。ただし、2026年10月時点でアプリ内で動いているのはR1ではなく後継のV4系です。
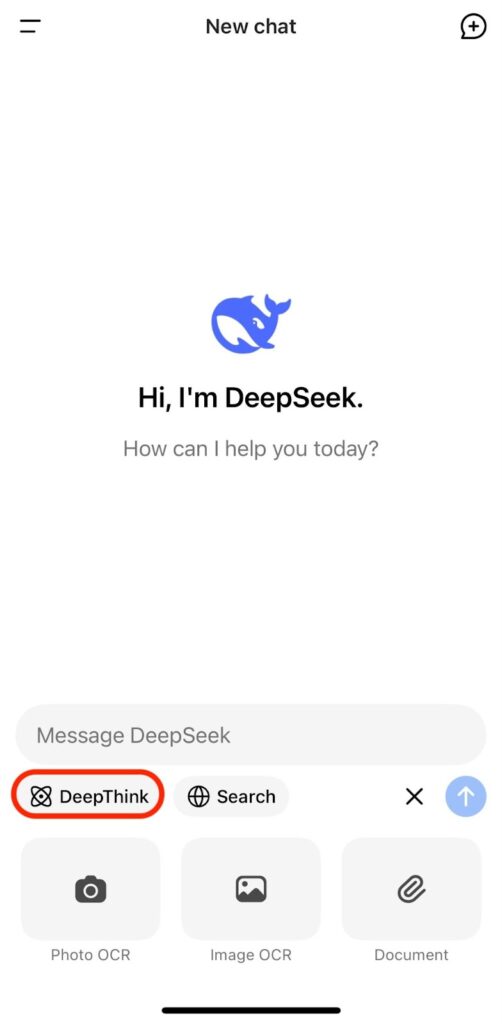
アプリ版もWeb版と同様に、ChatGPT等のインターフェースに似ていますね。
3.API
DeepSeek-R1はAPIを発行することで、さまざまな方法で利用できます。
今回はAPIを使ってGoogle Colab上でdeepseek-flash(V4.1-Flash)を使う方法をご紹介します。
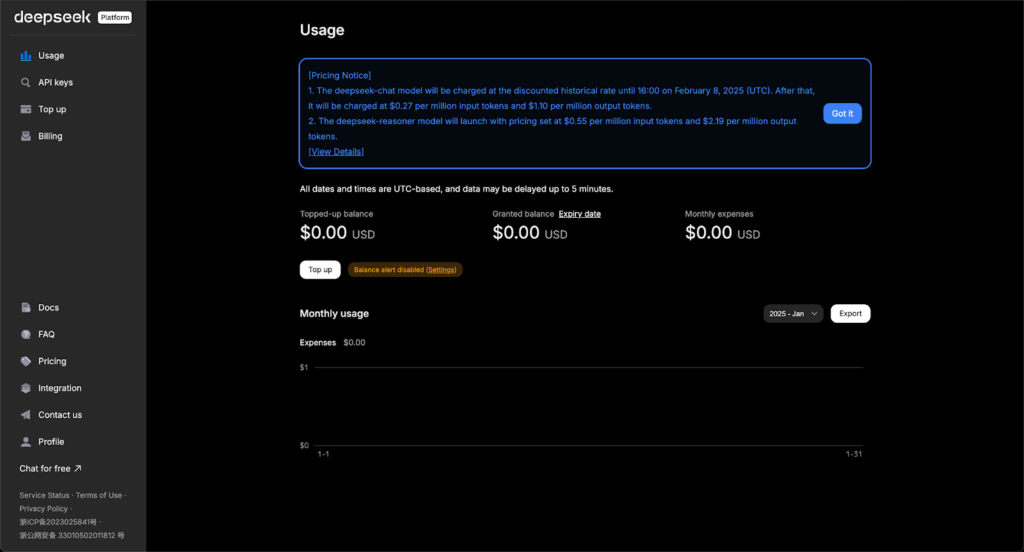
DeepSeek APIプラットフォームにアクセス
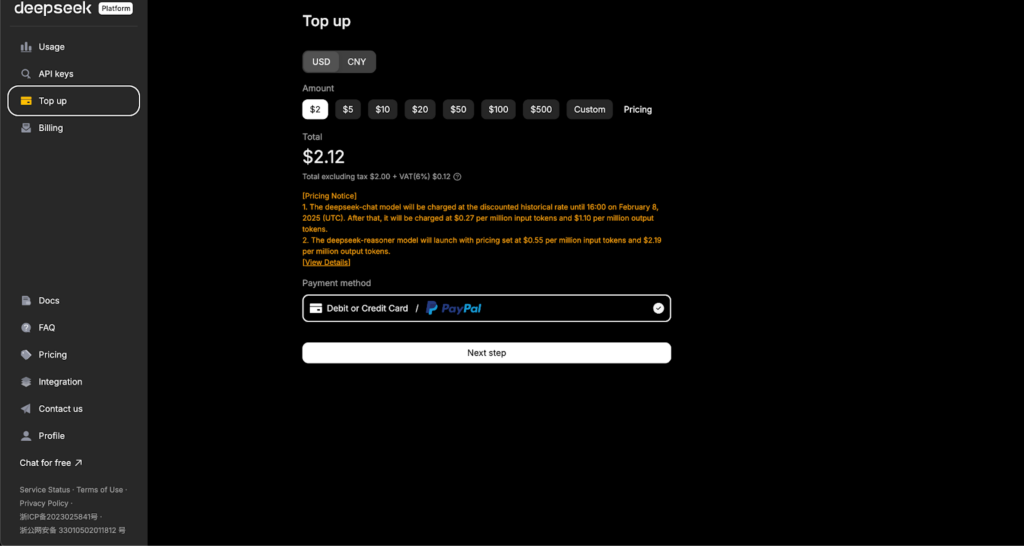
「Top up」タブから料金をチャージ
「Top up」タブからクレジットカードもしくはPayPalで料金をチャージ、使用料に応じてチャージ残高が使われます。
今回はミニマム価格の$2.12チャージして試してみます。
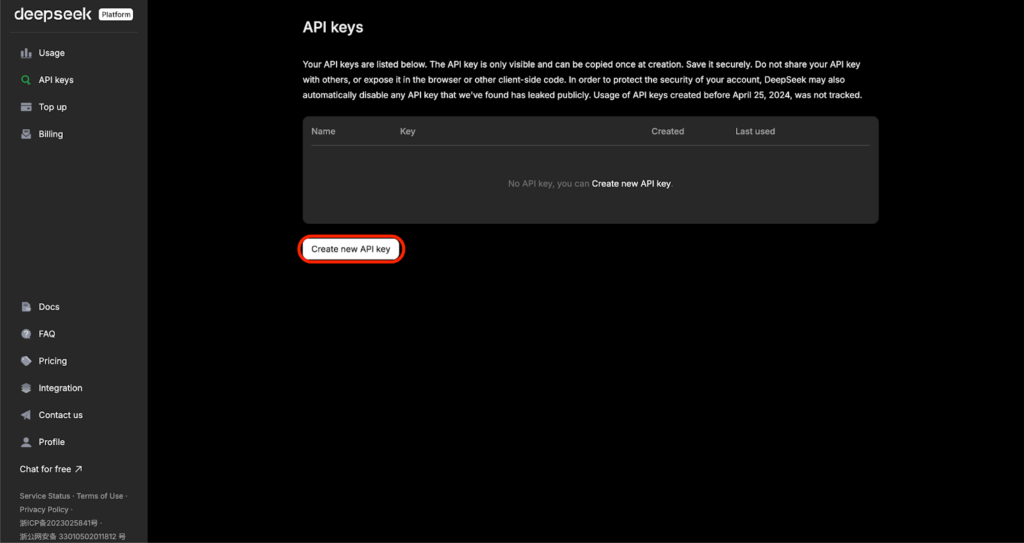
「API keys」タブからAPIキーを作成
「API keys」タブ → 「Create new API key」をクリックしてAPIを作成
作成するとAPI keyをコピーできるのでクリップボードにコピーしておきましょう。
Google Colabでコードを実行
Google Colabにアクセスし、新しいノートブックで以下のコードを実行します。
クリックで表示
import requests
import json
# DeepSeek APIの設定
API_URL = "https://api.deepseek.com/v1/chat/completions"  # エンドポイント
API_KEY = ""  # 手順3で取得したご自身のAPIキーを設定してください
headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}
user_input = "DeepSeek-R1の特徴を教えてください" # 入力プロンプト
data = {
    "model": "deepseek-flash",
    "messages": [
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": user_input}
    ],
    "thinking":{"type":"enabled"},
    "reasoning_effort":"high",
    "max_tokens":4000
}
response = requests.post(API_URL, headers=headers, data=json.dumps(data))
if response.status_code == 200:
    result = response.json()
    print("AIの応答:", result['choices'][0]['message']['content'])
else:
    print("エラー:", response.status_code, response.text)
出力結果は以下の通りです。
クリックで表示
Potential final:
DeepSeek-R1は、DeepSeekが公開した推論特化型のオープンソースLLMです。特に「考える」過程を長く生成してから答える点が特徴です。
主な特徴:
1. 推論特化・長いCoT
2. 強化学習中心の訓練
3. DeepSeek-V3ベースのMoE
4. 高性能
5. オープンソース
6. 蒸留モデル
7. API/使い方
8. 制限・注意
Let's ensure no false claims. "128Kコンテキスト" I think correct. "671B total, 37B active" correct. "MIT" correct. "R1-Zero pure RL no SFT" correct. "GRPO" correct. "AIME 2024 79.8" correct? Let's check: DeepSeek-R1 AIME 2024 pass@1 79.8%. Yes. "MATH-500 97.3" yes. "Codeforces 2029" yes. "GPQA Diamond 71.5" yes. "MMLU 90.8" yes. "SWE-bench Verified 49.2" yes. Good. But maybe not necessary. Include a few.
"o1に匹敵" correct. "一部上回る" on math/code.
"初期版は関数呼び出し非対応" correct. "0528版で改善" I think yes. Could say "後続の0528版などでは関数呼び出しやJSON出力の対応が改善". If uncertain, maybe "一部改善". That's safe.
"言語混在" yes. "プロンプトに敏感" yes. "幻覚" yes.
"テキスト専用" yes. "マルチモーダル非対応" yes.
"APIのreasoning_content" yes. "OpenAI互換" yes. "temperatureなどは無視/非対応" for deepseek-reasoner initially. Good.
"蒸留モデルはRLではなくSFTでR1の出力を学習" correct.
Need maybe mention "DeepSeek-R1-Distill-Qwen-1.5B/7B/14B/32B, Llama-8B/70B". Good.
Let's write final. Keep moderate length. Use bullet points. Japanese. Ensure no mention "I think".
Maybe start: "DeepSeek-R1は、中国のDeepSeekが2025年1月に公開したオープンソースの推論特化型LLMです。簡単に言うと、OpenAI o1と同様に『答える前に長く考える』モデルで、数学・コーディング・論理推論に強いのが特徴です。"
Then sections.
Let's final.
AIの応答: DeepSeek-R1
回答が長いので最終出力のみを貼り付けていますが、上記のような結果が返ってきました。
4.ローカル環境(Hugging Face)
ここではHugging Faceをローカル環境で使う方法をご紹介します。Hugging Faceから利用することで、DeepSeek-R1-Distill-Qwen-14B-Japaneseを使用できるので、日本語に対応したモデルを使用したい方はこちらをご覧ください。
Pythonが自身のPCにインストールされているか確認する
おすすめのバージョンはPython 3.8以上です。インストールされていない場合は、公式サイトからダウンロード・インストールしてください。
必要なライブラリのインストール
DeepSeek-R1を使うには、Hugging Faceの「Transformers」ライブラリが必要です。また、PyTorchというAIライブラリも利用します。以下のコマンドを使ってインストールします。
pip install transformers torchモデルとトークナイザーを読み込む
DeepSeek-R1は、Hugging Faceのライブラリから直接ダウンロードできます。モデルを使用するためには、以下のPythonコードを実行します。
クリックで表示
from transformers import AutoModelForCausalLM, AutoTokenizer
# モデルとトークナイザーの読み込み
model_name = "cyberagent/DeepSeek-R1-Distill-Qwen-14B-Japanese"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)入力データをモデルに渡す
トークナイザーを使って、入力テキストを数値データ(input_ids)に変換し、それをモデルに渡します。
クリックで表示
# 入力テキスト
input_text = "AIモデルの用途は何ですか?"
# 会話形式に整えてトークン化
input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": input_text}],
    add_generation_prompt=True,
    return_tensors="pt"
).to(model.device)
# モデルで推論を実行(推論モデルは考える過程も出力するため長めに設定)
outputs = model.generate(input_ids, max_new_tokens=1024, do_sample=True, temperature=0.6)モデルの出力を解読する
モデルが生成したデータは数値形式のため、トークナイザーを使ってテキストに戻します。
クリックで表示
# 入力部分を除いて、生成された部分だけをテキストに戻す
result = tokenizer.decode(outputs[0][input_ids.shape[-1]:], skip_special_tokens=True)
# 結果を表示
print(result)
これによりDeepSeek-R1が生成した応答や文章を確認できるでしょう。
以下に、上記の手順をすべて含んだフルコードをまとめます。
クリックで表示
from transformers import AutoModelForCausalLM, AutoTokenizer
# モデルとトークナイザーの読み込み
model_name = "cyberagent/DeepSeek-R1-Distill-Qwen-14B-Japanese"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    torch_dtype="auto"
)
# 入力テキスト
input_text = "AIモデルの用途は何ですか?"
# 会話形式に整えてトークン化
input_ids = tokenizer.apply_chat_template(
    [{"role": "user", "content": input_text}],
    add_generation_prompt=True,
    return_tensors="pt"
).to(model.device)
# モデルで推論を実行
outputs = model.generate(input_ids, max_new_tokens=1024, do_sample=True, temperature=0.6)
# 生成された部分だけをテキストに変換
result = tokenizer.decode(outputs[0][input_ids.shape[-1]:], skip_special_tokens=True)
# 結果を表示
print("生成された応答:", result)
5.Ollamaでローカル実行する方法
Ollamaは、ローカルLLMをコマンド1つでダウンロード・実行できるツールです。量子化済みのモデルが用意されているため、Hugging Faceの方法よりも少ないGPUメモリでR1を動かせます。
Ollamaをインストールする
macOS・Windowsは、公式サイトからインストーラーをダウンロードして実行します。
Linuxの場合は、ターミナルで以下のコマンドを実行してください。
curl -fsSL https://ollama.com/install.sh | shモデルを指定して起動する
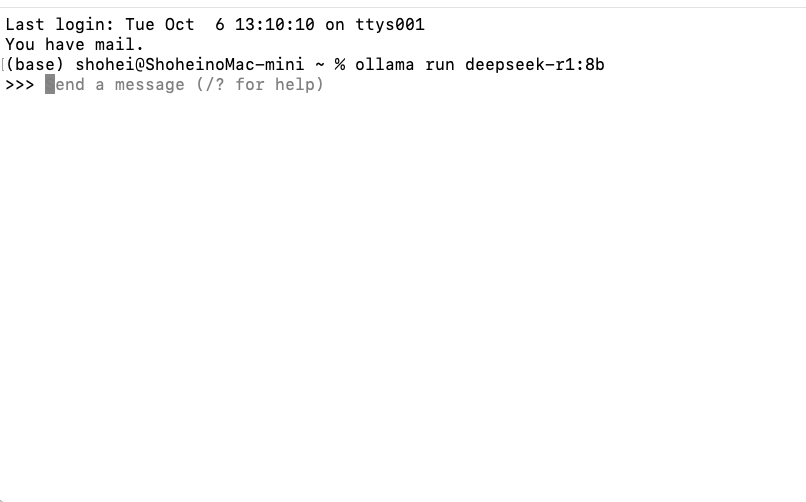
ターミナルで以下のコマンドを実行。初回はモデルのダウンロードが自動で始まり、完了するとそのまま対話できる状態になります。
ollama run deepseek-r1:8b「8b」の部分を「14b」「32b」などに変えれば、別のサイズのモデルを使えます。GPUメモリに合わせて、前述の「蒸留モデル一覧と必要なGPUメモリ」の表から選んでください。
質問を入力する
プロンプトを入力してEnterキーを押すと、モデルが考えた過程に続いて回答が表示されます。終了するときは「/bye」と入力してください。
今回は下記の質問を入れてみました。
A、B、Cの3人のうち1人だけが嘘をついています。A「Bは嘘つきだ」B「Cは嘘つきだ」C「AとBは両方嘘つきだ」。嘘をついているのは誰?一意に回答が導き出せない問題を出しましたが、延々と考え続け、結論を出してくれませんでした。
【検証】ローカルのDeepSeek-R1とV4 Flashを比較してみた
ここでは、ローカルで動かしたDeepSeek-R1の蒸留モデルと、APIで提供されている後継のV4 Flash(deepseek-flash)に同じプロンプトを入力し、回答を比較します。
今回使用するR1はdeepseek-r1:8bです。ローカル側の実行環境はMac mini(Apple M4 Pro・メモリ64GB)です。
英語タスク
今回は、以下のプロンプトを入力しました。
ビジネスメールの英語版を作成してください。宛先は海外の取引先です。V4 Flashの回答
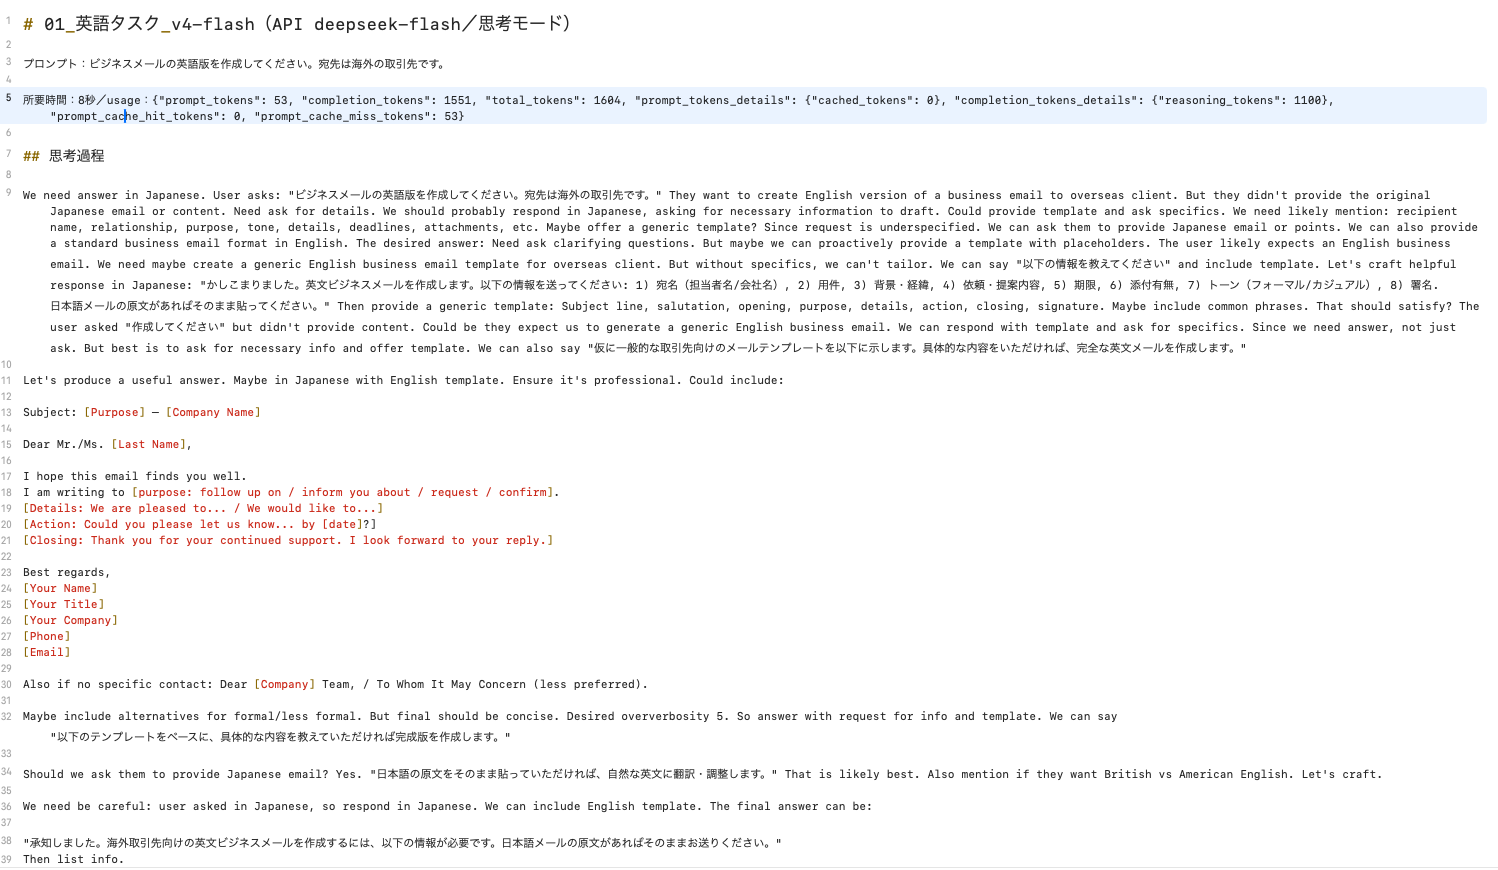
汎用的な英文テンプレートを提示したうえで、「用件」「期限」「添付ファイルの有無」など完成版を作るために必要な情報を8項目で質問してきました。日本語の原文を送れば翻訳・調整するという提案まで添えられています。
ローカルR1の回答
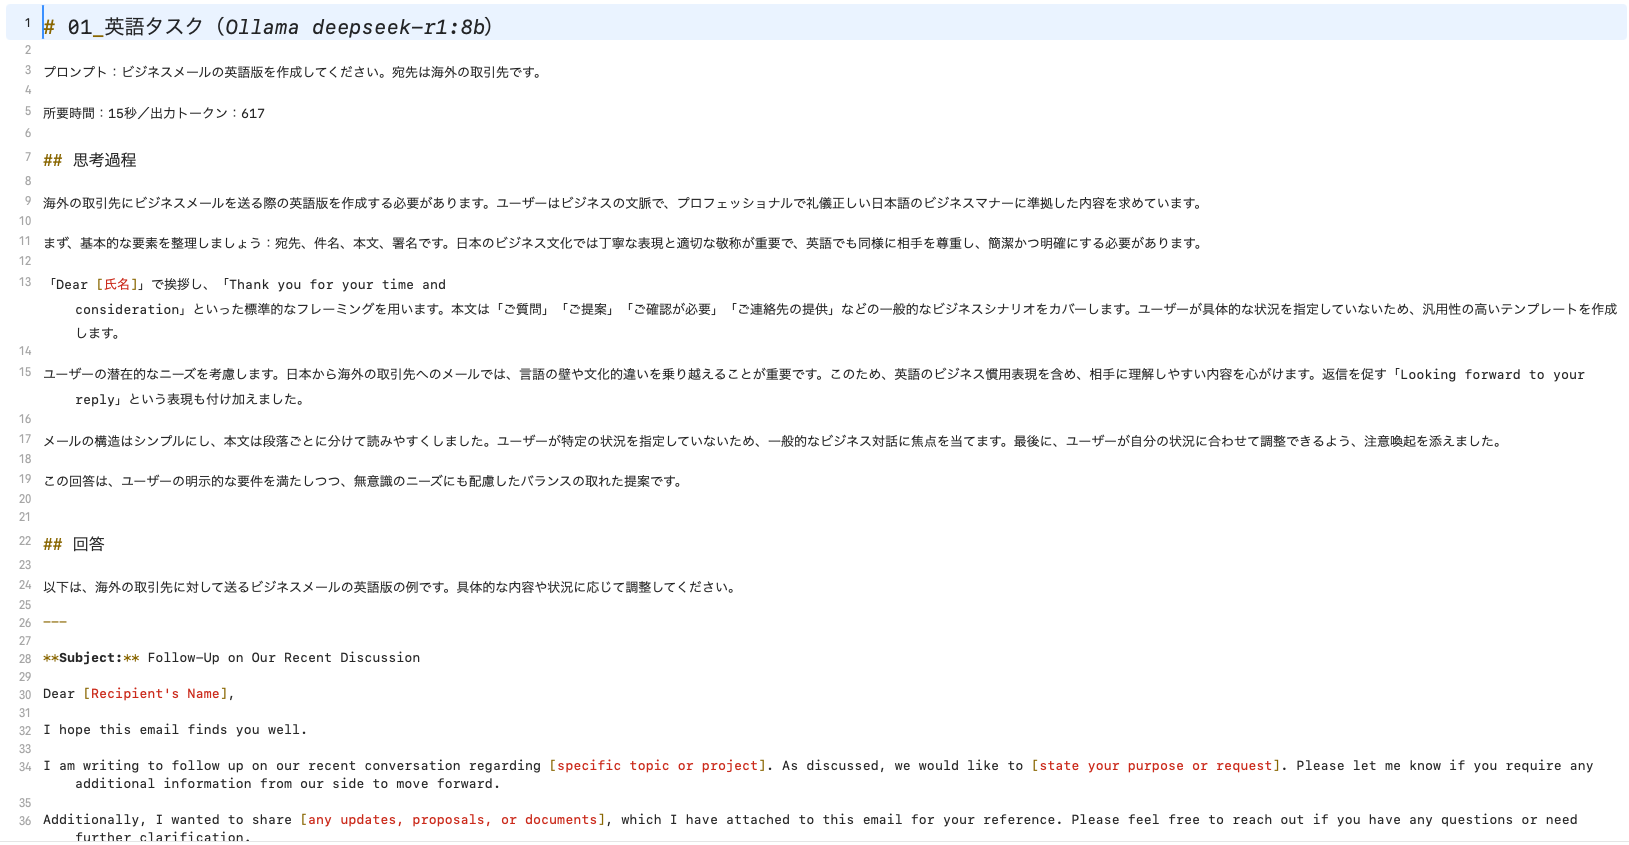
フォローアップを想定したシンプルな英文テンプレートを出力しました。件名・本文・署名がひととおりそろっており、そのまま書き換えて使える内容です。
英語タスクは、どちらも実用的なテンプレートを返しており大きな差はありません。足りない情報を聞き返してくるV4 Flashのほうが、実務では一歩進んだ対応といえるでしょう。
数学タスク
今回は、以下のプロンプトを入力しました。
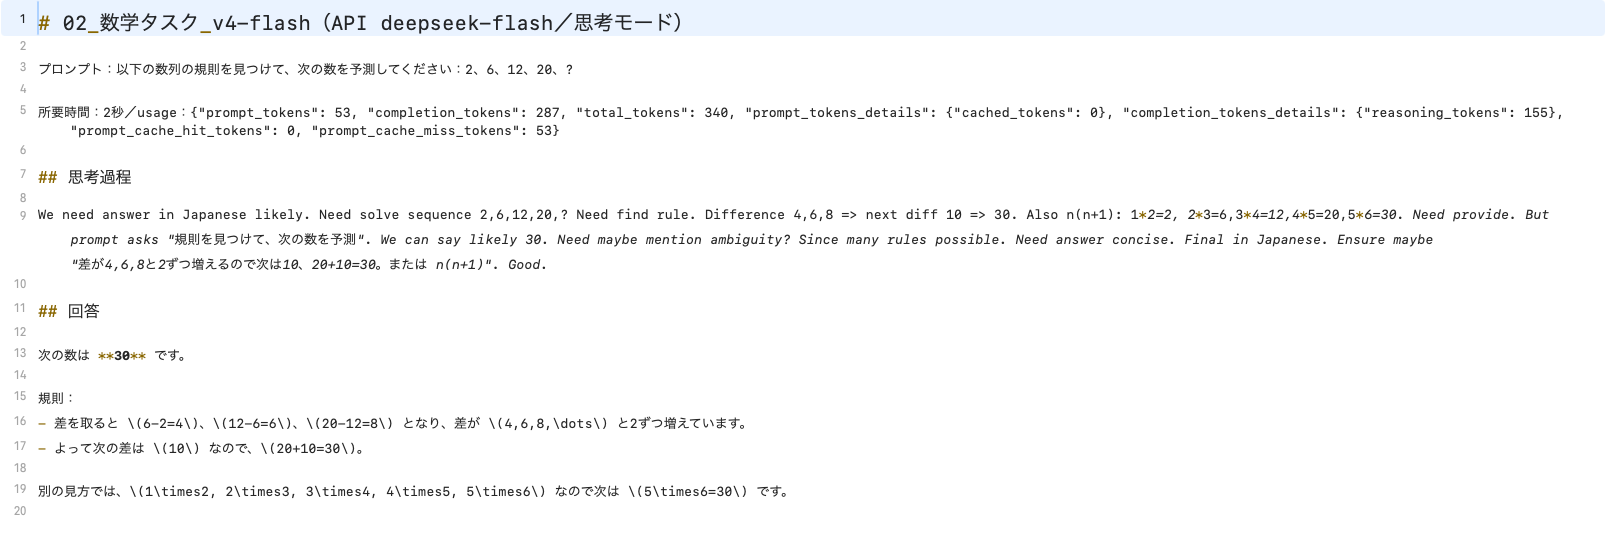
以下の数列の規則を見つけて、次の数を予測してください:2、6、12、20、?V4 Flashの回答
次の数は30です。差が4、6、8と2ずつ増えているため、次の差は10で20+10=30。別の見方として、1×2、2×3、3×4、4×5と並んでいるので、次は5×6=30になると説明しています。
ローカルR1の回答
The given sequence is 2, 6, 12, 20. The pattern is that each term is given by the formula a(n) = n × (n+1)……(以下、英語で解説が続き、最終的に30と回答)。
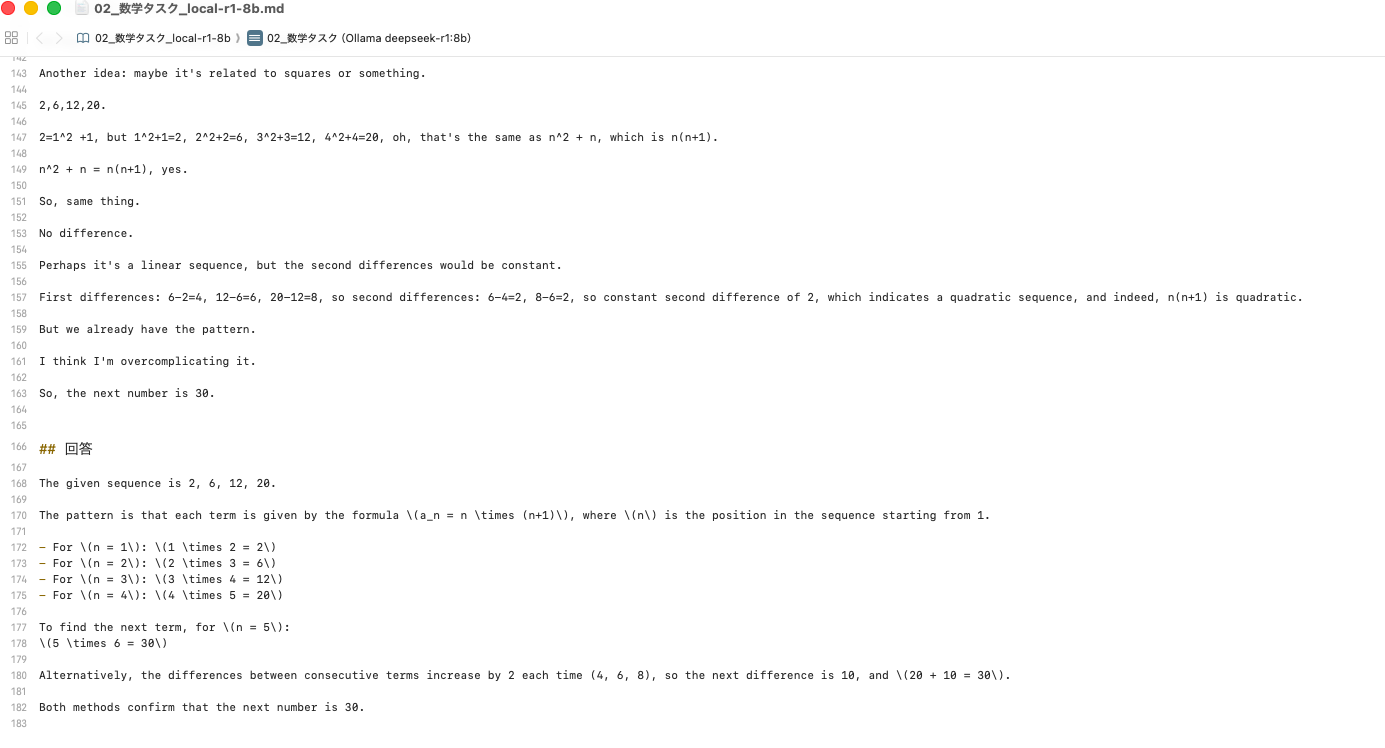
どちらも正解の30にたどり着き、2通りの解き方を示した点も共通しています。ただし、ローカルR1は日本語で質問したのに英語で回答しました。
R1-Zeroの頃から指摘されている言語の混在が、蒸留モデルでも残っていることがわかります。
コーディングタスク
今回は、以下のプロンプトを入力しました。
クイックソートアルゴリズムをPythonで実装し、100万件のデータをソートするコードを書いてください。V4 Flashの回答
データを並べ替えながら追加のメモリをほとんど使わない「インプレース」方式で実装してきました。ピボットの選び方の工夫、小さな区間での挿入ソートへの切り替え、再帰を使わないスタック処理など、大量データを想定した最適化が一通り入っています。
実際に実行したところ、100万件のソートは0.72秒で完了しました。Python標準のsorted()と結果を突き合わせる検証処理まで含まれています。
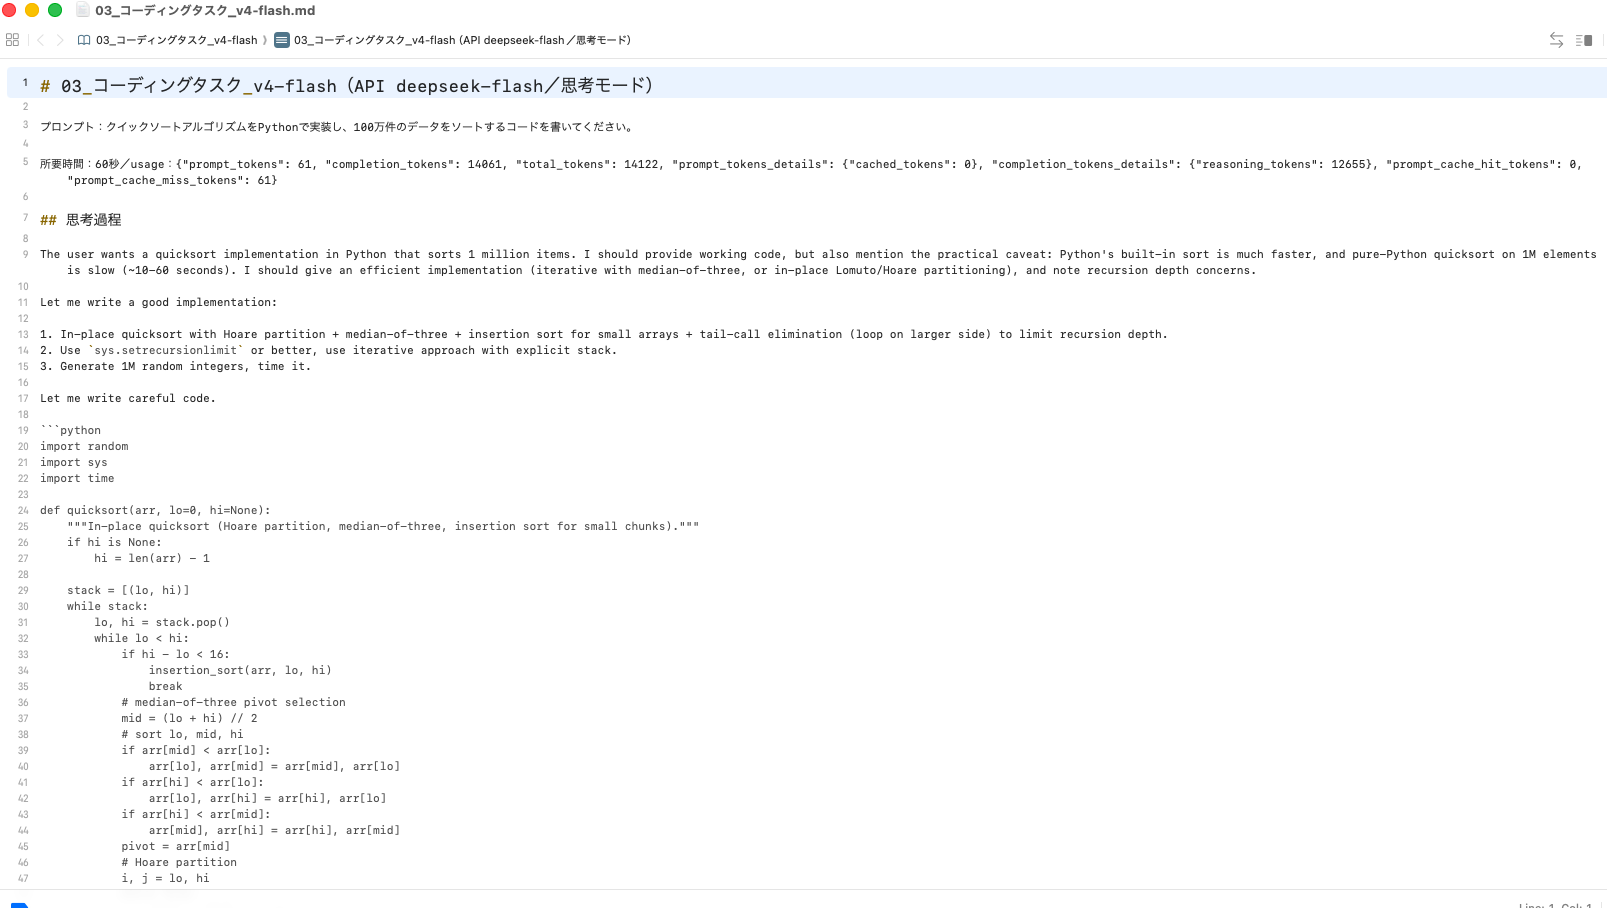
ローカルR1の回答
リスト内包表記で配列を3つに分ける、シンプルで読みやすい実装です。実際に実行すると、データ生成を含めて約1.4秒で正しくソートできました。
ただし、分割のたびに新しいリストを作るためメモリ効率は良くありません。再帰の上限を200万まで引き上げる必要のない設定も入っていました。
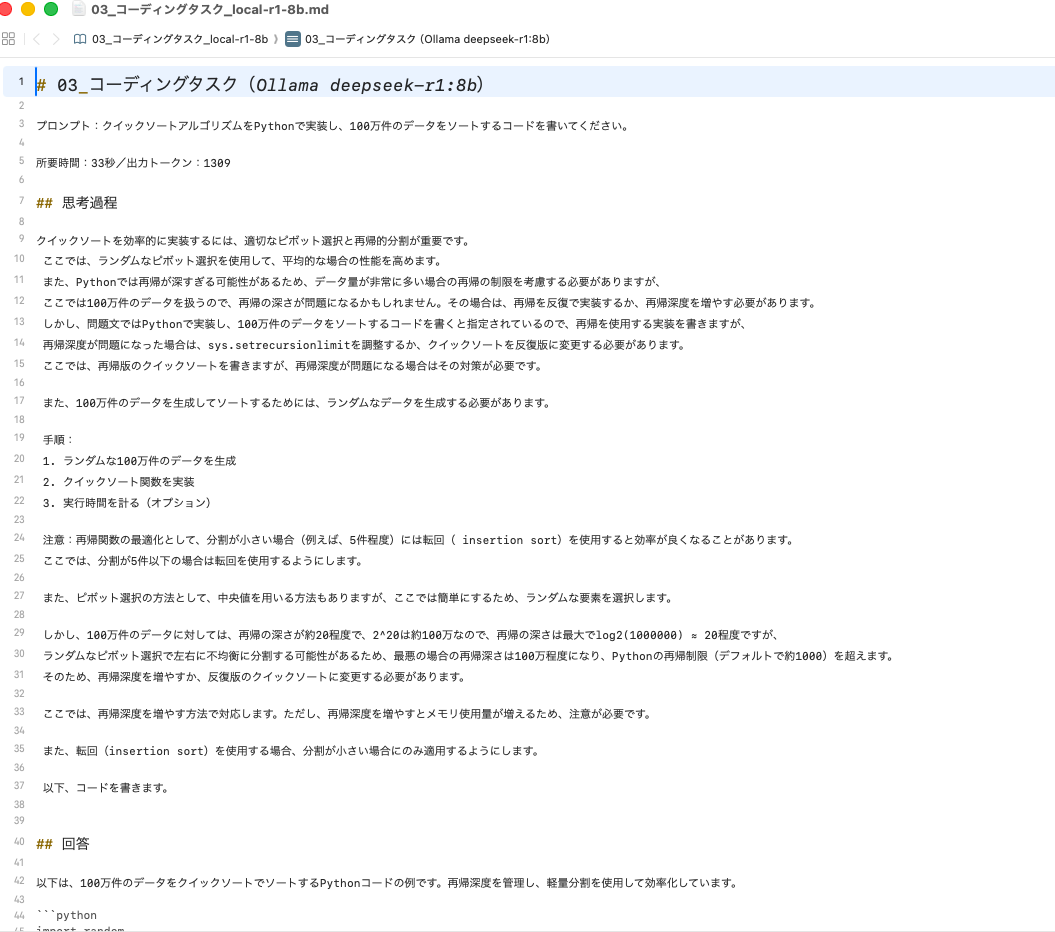
どちらのコードも正しく動きましたが、実装の質はV4 Flashが明らかに上です。
検証結果
回答の質は、3つのタスクともV4 Flashが上回る結果になりました。特に、日本語で質問して英語で返ってくるローカルR1の挙動は、実務で使ううえで気になる点です。
一方で、ローカルR1も数学とコーディングでは正しい答えを出しており、8Bという小さなサイズでも推論モデルとして十分に機能しています。データを外に出さず、無料で何度でも試せる点は、V4 Flashにはない強みといえるでしょう。
性能を求めるならV4 Flash、機密データを扱う処理や、社内で気軽に試したい場面ではローカルR1という使い分けが良さそうです。
| 項目 | V4 Flash(API) | ローカルR1(deepseek-r1:8b) |
|---|---|---|
| 英語タスク | 8秒・テンプレート+確認事項8項目 | 15秒・シンプルなテンプレート |
| 数学タスク | 2秒・正解(日本語で回答) | 37秒・正解(英語で回答) |
| コーディングタスク | 60秒・最適化済みのインプレース実装 | 33秒・シンプルだがメモリ効率は低い |
| 費用 | 従量課金(今回4回の実行で約0.01ドル) | 無料(電気代のみ) |
| データの送信先 | DeepSeekのサーバー(中国) | 外部に送信されない |
DeepSeek-R1などオープンソースLLMの導入・構築ならWEELへ
生成AIの導入に関する詳細なアドバイスをもとに、最適な活用方法を見つけるために、実績豊富な専門家からのサポートを受けてみませんか?
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
DeepSeek-R1のよくある質問