Gemini 3.8 Flash TTSとは?Googleの最も表現力豊かな音声生成AIの特徴・使い方を徹底解説
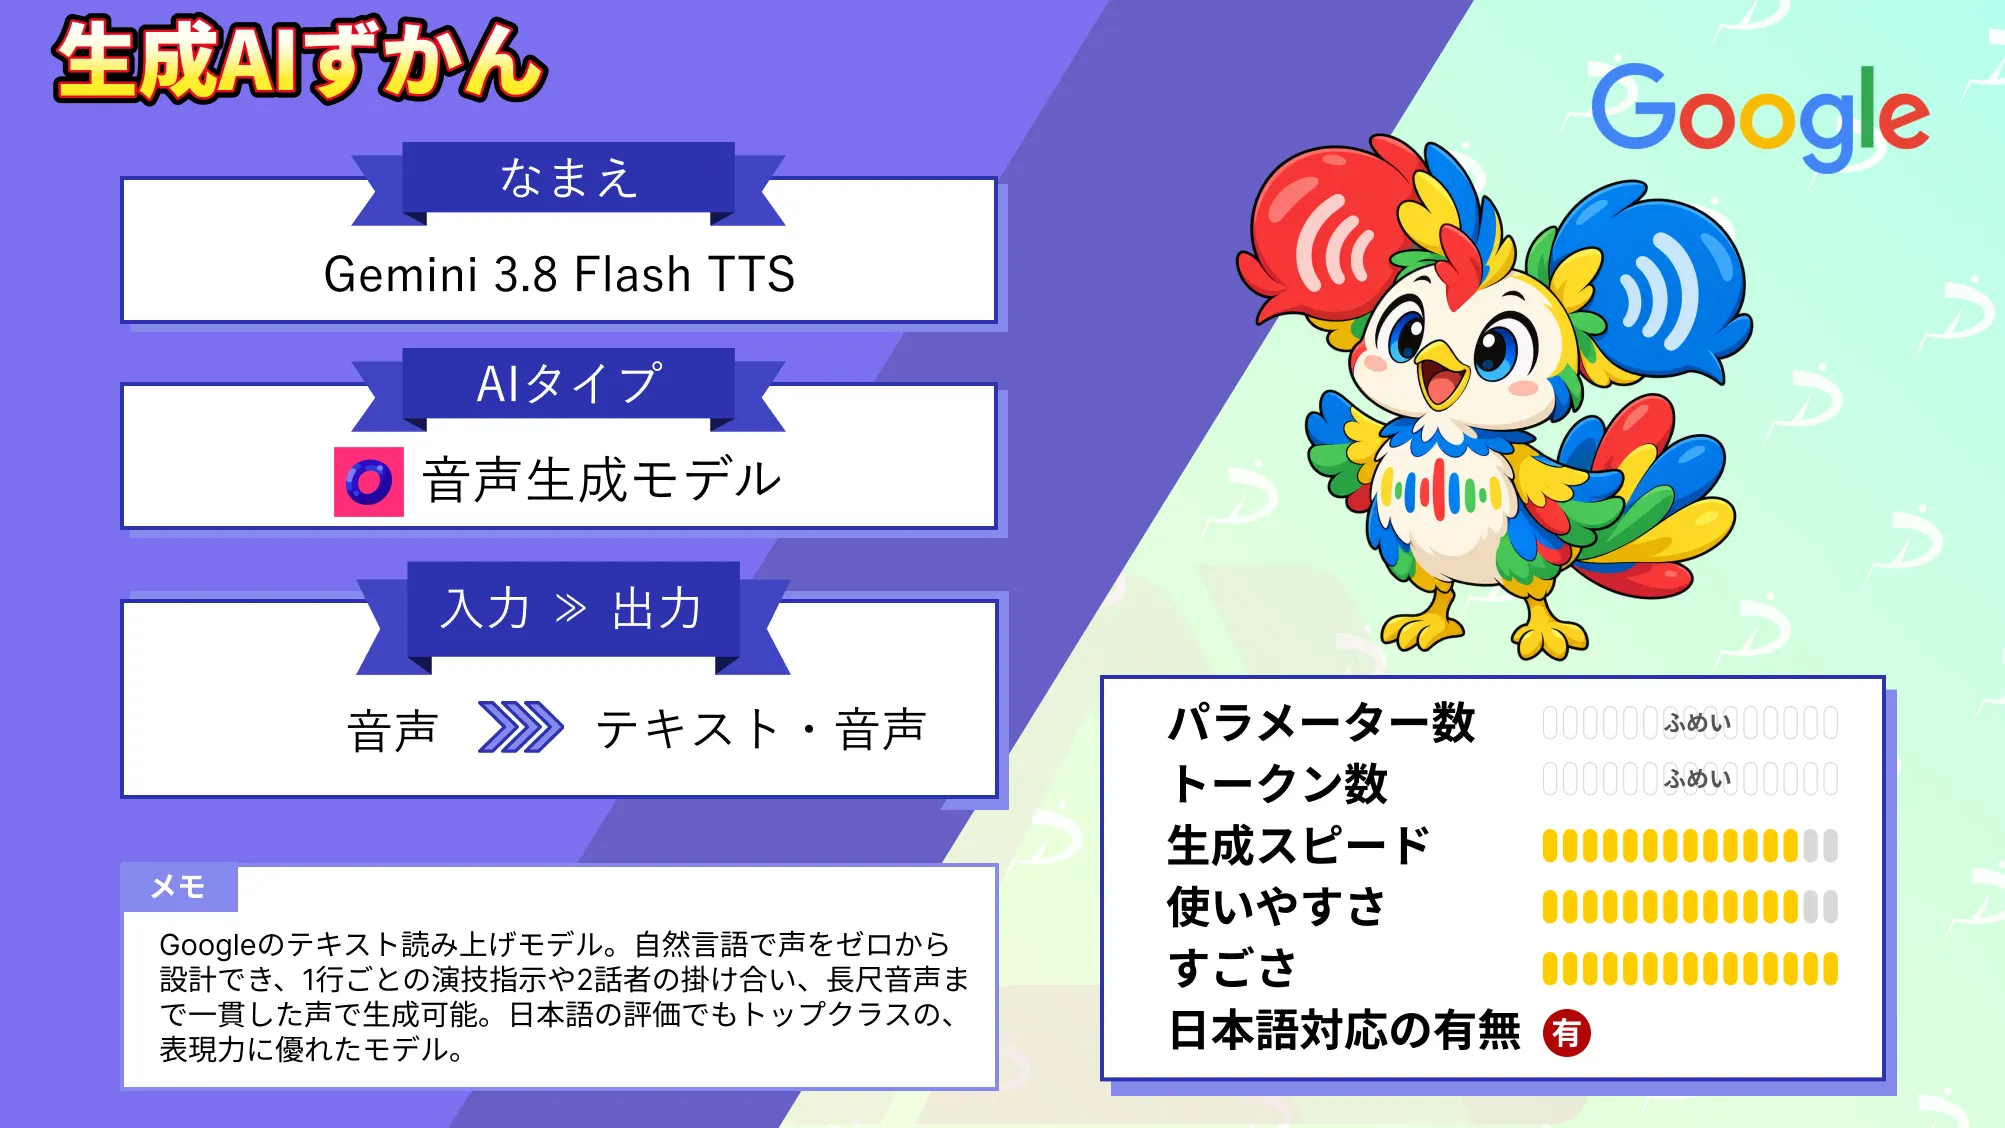
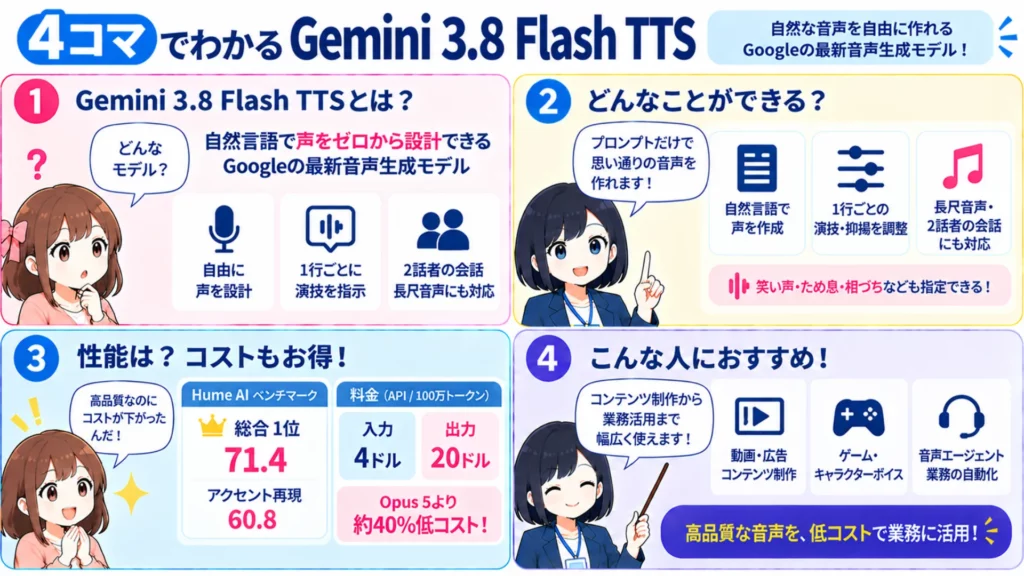
- Gemini 3.8 Flash TTSは自然言語で声をゼロから設計できるGoogleの最新音声生成モデル
- 1行ごとの演技指示や2話者の会話、数時間の長尺音声まで一貫した声で生成
- Hume AIのベンチマークで総合1位、日本語のブラインド評価でも上位を獲得
2026年9月、Googleから新たな音声生成モデルが発表されました。
今回登場した「Gemini 3.8 Flash TTS」は、自然言語のプロンプトだけでキャラクターの声をゼロから設計し、1行ごとに演技を指示できるテキスト読み上げ(TTS)モデルです。同時に、大量生成向けの「Gemini 3.8 Flash-Lite TTS」も公開され、Googleは両モデルをこれまでで最も表現力の高い音声生成モデルと位置づけています。
しかし、新しい音声モデルが登場するたびに、「従来のGemini TTSと何が違うのか」「日本語の品質はどうなのか」「声の複製は安全に使えるのか」といった疑問を感じる方も多いのではないでしょうか。
そこで本記事では、Gemini 3.8 Flash TTSの概要や仕組み、特徴を整理しながら、安全対策や提供範囲、使い方、業界別の活用シーンについて詳しく解説します。最後までお読みいただくことで、Gemini 3.8 Flash TTSがどのように設計され、どのような場面で力を発揮するのかが理解できるはずです。
\生成AIを活用して業務プロセスを自動化/
Gemini 3.8 Flash TTSとは
Gemini 3.8 Flash TTSは、Googleが2026年9月に発表したGeminiファミリーのテキスト読み上げモデルです。
Googleはこのモデルを、音声生成を「固定のプリセット」から「ダイナミックなクリエイティブスタジオ」へ変えるものと説明しています。
今回は用途の異なる2つのモデルが同時に登場しました。違いは以下のとおりです。
| 比較項目 | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS |
|---|---|---|
| 設計の狙い | 深いクリエイティブ演出とキャラクター設計 | 大量生成とコスト効率 |
| 主な用途 | ゲーム、没入型オーディオブック、ポッドキャスト、インタラクティブメディア | 大量の吹き替え、音声コンテンツ制作、表現力のある音声エージェント |
| 声のゼロからの設計 | 対応(自然言語プロンプトで作成) | 対応 |
| 対応言語数(API) | 130言語 | 101言語 |
| モデルID | gemini-3.8-flash-tts | gemini-3.8-flash-lite-tts |
| 演技の制御 | 演技指示・ペース・方言の切り替え・相づちまで1行ごとに制御 | トーン・ペース・表現のニュアンスをきめ細かく制御 |
| 一般向けの提供先 | Gemini Notebook | Google Vids |
両モデルは、3.5 Live Translate、3.5 Transcribe、3.8 Live、3.8 Live Extended Thinkingに続くラインナップとして追加されました。
前世代のGemini 3.1 Flash TTS Previewと比べて、長尺コンテンツや2話者の台本制御など幅広いユースケースで大きな改善認めています。APIでは、Flash-Lite TTSが3.1 Flash TTS Previewの推奨移行先です。
Gemini 3.8 Flash TTSの仕組み
Gemini 3.8 Flash TTSは、声を作る工程と演技を指示する工程の2段階で音声を生成します。
モデルのアーキテクチャやパラメーター数など、内部構造の詳細は公開されていませんが、公開されている機能から、音声ができあがるまでの流れを整理すると以下のようになります。
- 自然言語のプロンプトで役柄・アクセント・声質を指定し、新しい声を設計する(または音声ライブラリから選ぶ、30秒の音声サンプルから複製する)
- 設計した声を保存し、プロジェクトをまたいで同じ声を使い回す
- 台本に演技指示や非言語タグを書き込み、1行ごとの読み方を指定する
- 1本の台本から2話者の掛け合いや数時間の長尺音声を生成する
- 生成された音声には全てSynthIDの電子透かしが埋め込まれる
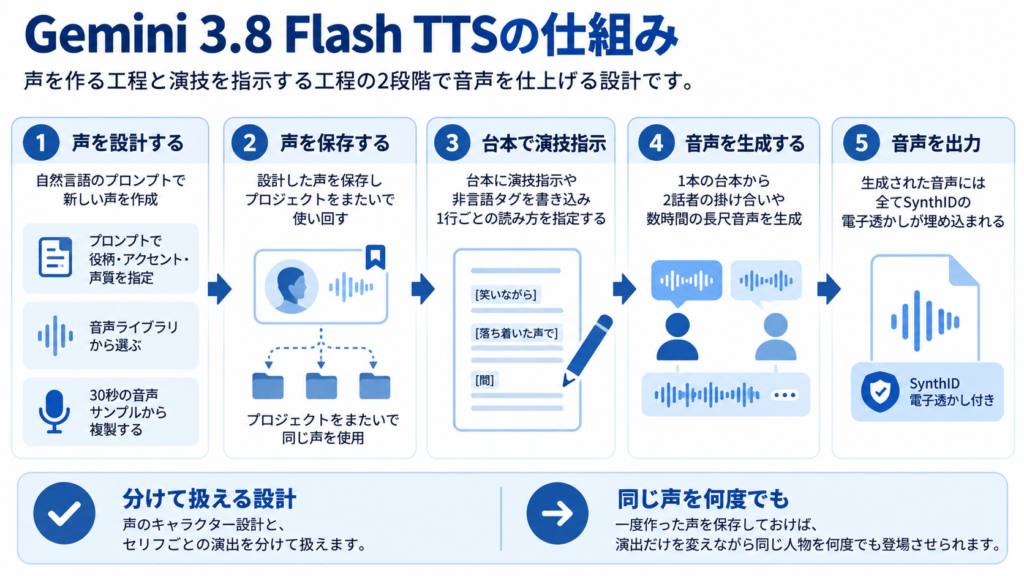
ポイントは、声のキャラクター設計と、セリフごとの演出を分けて扱えることです。一度作った声を保存しておけば、演出だけを変えながら同じ人物を何度でも登場させられます。
低コスト・高速で使えるFlash-Liteシリーズについて、詳しく知りたい方は下記の記事もあわせてご覧ください。
Gemini 3.8 Flash TTSの特徴
Gemini 3.8 Flash TTSの強みは、声を自由に作れる柔軟さと、演技を細かく指示できる制御性の両立。ここでは主な特徴を見ていきます。
自然言語で声をゼロから設計できる
従来のTTSでは、用意された音声の中から近いものを選ぶのが一般的でした。
Gemini 3.8 Flash TTSの生成型ボイスデザインでは、100以上の言語・方言で、役柄やアクセント、声の特徴をプロンプトで指定してオリジナルの声を作れます。火を吹くドラゴンの迫力ある声から、地域特有の抑揚を持つカリスマ的なナレーターまで対応可能。
声づくりの手段はプロンプト以外にも用意されています。
| 機能 | 内容 | 提供状況 |
|---|---|---|
| 生成型ボイスデザイン | 役柄・アクセント・声質を自然言語で指定し、声をゼロから作成 | 提供中 |
| 音声ライブラリ | メキシコのスペイン語、ケベックのフランス語、スコットランド英語などを含む、本番利用可能な2,000以上の音声(Googleの発表値) | 提供中 |
| ボイスレプリケーション | 自分の声、または使用権を持つ声の30秒のサンプルから一貫した声を再現(Flash-Lite TTSも対応) | 提供中 |
| 保存とスケール | 作成した声を保存・管理し、継続プロジェクトでも声のぶれを最小限に抑える | 提供中 |
| ボイスリミックス | ライブラリの声を選び、音色・ピッチ・スピード・アクセントをプロンプトで微調整 | 近日提供予定 |
ボイスリミックスでは、「さりげない米国南部なまりを加える」「話し方を柔らかくする」といった指示で既存の声を調整できるようになる予定です。
1行ごとに演技を指示できる
声を決めたあとは、セリフ1行ずつの読み方を細かく指示できます。この制御は、Flash TTSとFlash-Lite TTSの両方で利用可能です。
自分で演技指示を書くこともできますし、台本の自然な文脈からGeminiに読み方を任せることも可能。落ち着いたカスタマーサービス担当者から、ささやき声のサスペンスシーンまで演じ分けられます。
| 機能 | できること |
|---|---|
| 1行ごとの演技指示 | 独自の演技指示、または台本の文脈から読み方を制御 |
| 長尺生成 | Googleによれば、数時間の連続音声でも声質・自然なペース・キャラクターの音色を維持し、話者のぶれを最小限に抑える |
| 2話者のシーン演出 | 1本の台本から複数ターンの会話を生成し、2人の声をはっきり分けたまま自然に掛け合う |
| 非言語タグと相づち | 笑い声・ため息・息をのむ音などの非言語表現や、「うんうん」といった相づちを台本に挿入 |
API仕様では、<laugh>・<sigh>・<cough>・<breath>・<short pause>のような山かっこのタグで指定。
笑い声やため息まで台本で指定できるため、コメディの間やリアクションのタイミングを狙いどおりに作り込めます。人間らしい会話の質感を出したい場面で役立つのではないでしょうか。
主要ベンチマークで首位を獲得
Googleが公表したHume AIの評価では、Gemini 3.8 Flash TTSがVoice Design Benchmarkで総合1位(71.4)を獲得。アクセントの再現でも60.8と、比較対象の中で最も高いスコアです。
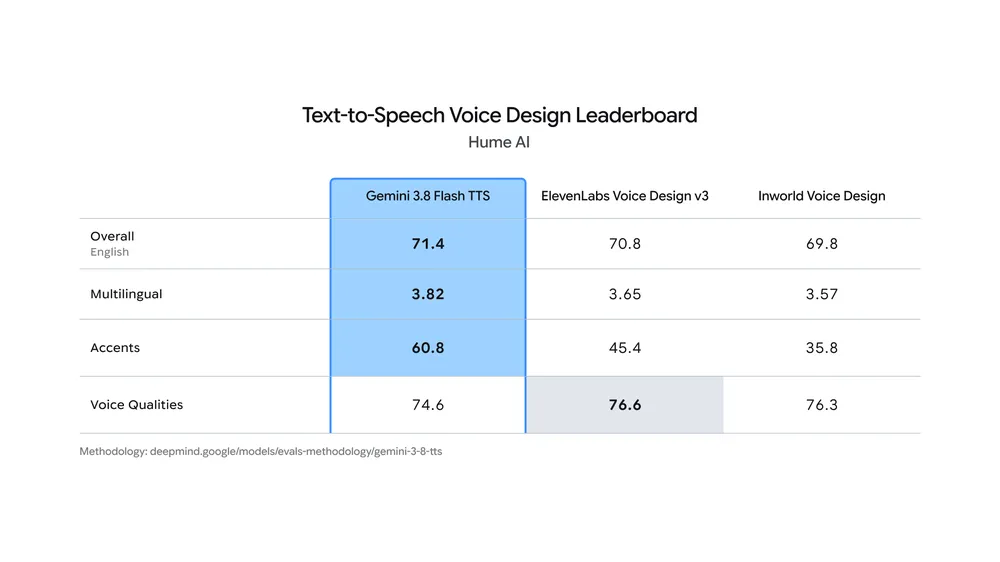
Hume AIの総合品質指標では、Flash TTSが1位、Flash-Lite TTSが2位。表現力を高めながらも、信頼性を犠牲にしていない点が評価されています。
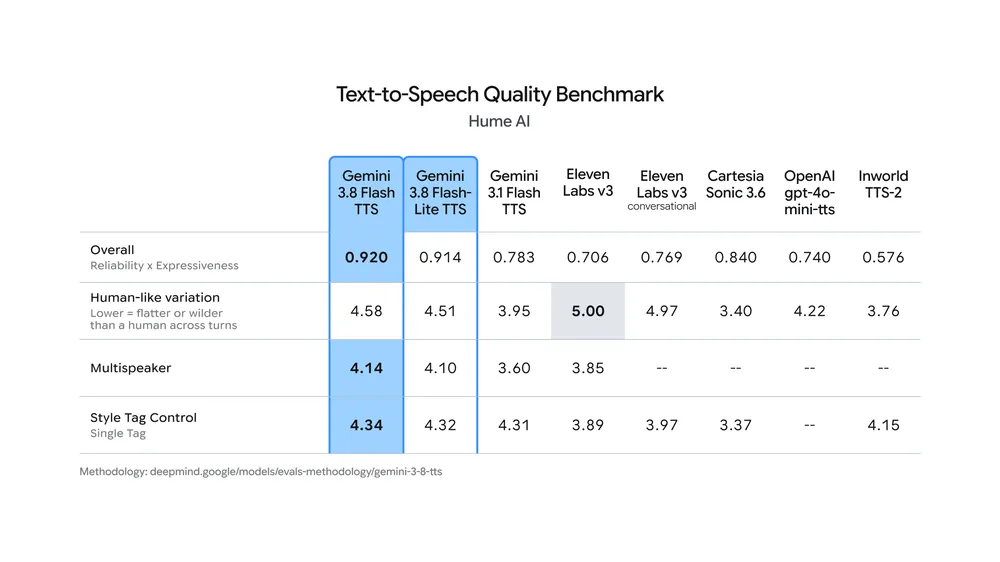
| 評価項目(Hume AI) | Gemini 3.8 Flash TTS | Gemini 3.8 Flash-Lite TTS | Gemini 3.1 Flash TTS | ElevenLabs v3 | OpenAI gpt-4o-mini-tts |
|---|---|---|---|---|---|
| 総合(信頼性×表現力) | 0.920 | 0.914 | 0.783 | 0.706 | 0.740 |
| 人間らしい揺らぎ | 4.58 | 4.51 | 3.95 | 5.00 | 4.22 |
| 複数話者 | 4.14 | 4.10 | 3.60 | 3.85 | — |
| スタイルタグ制御 | 4.34 | 4.32 | 4.31 | 3.89 | — |
日本語を含む多言語で高評価
Googleが紹介したVoice Arenaのブラインド形式の人間評価では、日本語・ポルトガル語・ベトナム語・現代標準アラビア語・メキシコのスペイン語・ヒンディー語といった主要言語で、両モデルが上位を占めました。
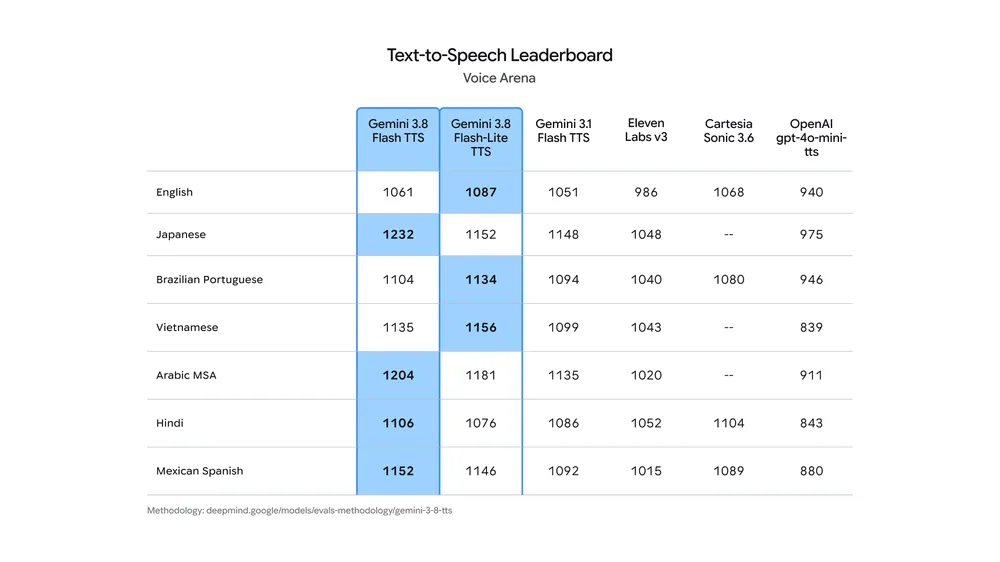
公式ブログに掲載された図表では、日本語でFlash TTSが1232とトップのスコアを記録。Flash-Lite TTS(1152)や前世代の3.1 Flash TTS(1148)を大きく上回っており、日本語コンテンツで使いたい方にとって注目のモデルといえるでしょう。
Text to SpeechとVOICEVOXの違いについて、詳しく知りたい方は下記の記事もあわせてご覧ください。

Gemini 3.8 Flash TTSの安全性・制約
Googleは、声の作成・複製機能に厳格なセーフガードを組み込んでいます。声の持ち主を守り、本人性を尊重し、コンテンツの透明性を確保するのが目的です。
| 安全対策 | 内容 |
|---|---|
| 同意確認(Consent Verification) | 声を複製する際は、参照音声の話者と一致する声の持ち主本人による口頭の同意録音が必要 |
| SynthIDによる電子透かし | Gemini Audioモデルが生成する全ての音声に、知覚できない透かしを音声そのものへ埋め込む |
| C2PAクレデンシャル | ボイスレプリケーションにコンテンツの来歴情報を付与し、開発者と声の提供者を保護 |
| 利用範囲の制限 | 複製できるのは自分の声、または使用権を持つ声に限られる |
SynthIDの透かしは音声出力に直接織り込まれるため、SynthIDの検出の仕組みを使えば、AIが生成した音声かどうかを後から判別できます。なりすましや誤情報の拡散を防ぐ仕組みとして機能すると考えられます。
安全性と責任に関するより詳しい方針は、モデルカードで公開されています。
API側の仕様上の制約は以下のとおりです。
| 項目 | 制約 |
|---|---|
| 入出力 | テキストのみ入力、音声のみ出力 |
| トークン上限(Flash TTS) | 入力8,192トークン、出力16,384トークン |
| 2話者の同時生成 | 1リクエストで扱えるのは2話者まで、かつプリセット音声のみ。カスタム音声同士の会話は話者ごとに生成して音声を連結する |
| カスタム音声の保存 | 1プロジェクトあたり200音声まで、保存期間は1年 |
音声トークンは音声1秒あたり25トークンで換算されます。長尺の音声を作る場合は、リクエストを分割して生成する設計が必要になるでしょう。
Gemini 3.8 Flash TTSの料金
Gemini APIでは、テキスト入力と音声出力のトークン量に応じた従量課金で利用します。無料枠でも試せるため、まずはGoogle AI Studioで品質を確かめてから本番に移るとよいでしょう。
| モデル | 無料枠 | 入力(テキスト) | 出力(音声) |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 無料 | $0.50 | $9.00 |
| Gemini 3.8 Flash-Lite TTS | 無料 | $0.50 | $6.00 |
音声出力は音声1秒あたり25トークンで換算されます。100万トークンはおよそ11時間分の音声に相当するため、Flash TTSなら1時間あたり約0.8ドル、Flash-Lite TTSなら約0.5ドルが目安です。
大量生成向けのFlash-Lite TTSは、出力単価がFlash TTSの3分の2。ほかに、処理を急がない用途向けのBatch・Flexは半額、優先処理のPriorityは割増料金で提供されています。
一般ユーザー向けのGemini NotebookやGoogle Vidsで使う場合は、それぞれのサービスの利用条件に従います。Gemini Enterprise経由のAPI提供は近日開始予定です。
Gemini 3.8 Flash TTSのライセンス
Gemini 3.8 Flash TTSは、GoogleのAPIやサービスを通じて提供される、モデルウェイト非公開のプロプライエタリモデルです。
オープンモデルのような個別のモデルライセンスはなく、Gemini APIの利用規約やGoogleのサービス利用規約が適用されます。生成した音声を商用コンテンツに使う場合や、複製した声を事業で利用する場合は、事前に規約を確認しておく必要があります。
Gemini 3.8 Flash TTSの使い方
開発者はGoogle AI Studioの新しいオーディオプレイグラウンドから、発表当日すぐに試せます。ボイスデザイン用のワークスペースとして作られており、声づくりから台本の演出までを1か所で行える点が特徴です。
Google AI Studioにアクセスし、音声生成(speech generation)の機能を開きます。
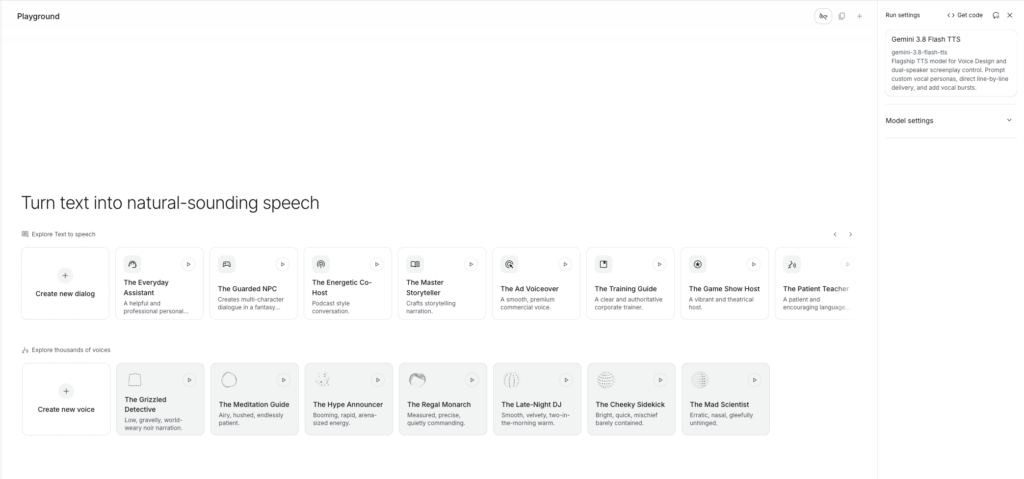
プロンプトでまったく新しい声をゼロから作るか、自分の声を複製します。声を複製する場合は、声の持ち主本人による口頭の同意録音が求められます。
作成した声を2話者対応の台本エディターに取り込み、セリフ1行ごとに読み方を指示します。演技指示や<laughs>などの非言語タグを書き込んで、仕上がりを調整しましょう。
本番環境で使う場合はGemini APIを利用します。Agora・LiveKit・Pipecat・Vercelといった開発者向けプラットフォームを使えば、高性能な音声生成体験を手軽に構築・デプロイ可能です。
コードを書かずに使いたい場合は、Flash TTSはGemini Notebook、Flash-Lite TTSはGoogle Vidsから利用できます。
APIで指定するモデルIDは、Flash TTSがgemini-3.8-flash-tts、Flash-Lite TTSがgemini-3.8-flash-lite-ttsです。両モデルはAPIの形式が共通のため、パラメーター1つで切り替えられます。
Flash-Lite TTSを搭載したGoogle Vidsについて、詳しく知りたい方は下記の記事をご覧ください。
【業界別】Gemini 3.8 Flash TTSの活用シーン
Gemini 3.8 Flash TTSは、声の個性と演技力が求められる分野で力を発揮するでしょう。ここでは業界別の活用シーンを紹介します。
ゲーム
ゲーム開発では、登場キャラクターごとに声を用意するコストが大きな負担でした。
Gemini 3.8 Flash TTSなら、ドラゴンや騎士といったキャラクターの声をプロンプトから生成し、保存して全シーンで使い回せます。公式ブログでも、自然言語のプロンプトから鎧の騎士の声を設計するデモが公開されていました。
ゲーム開発へのAI活用について、詳しく知りたい方は下記の記事をご覧ください。
エンタメ・メディア
オーディオブックやポッドキャストの制作では、数時間にわたる長尺でも声質を保てる点が役立ちます。2話者の掛け合いも1本の台本から生成できるため、対談形式の番組づくりにも向いているでしょう。
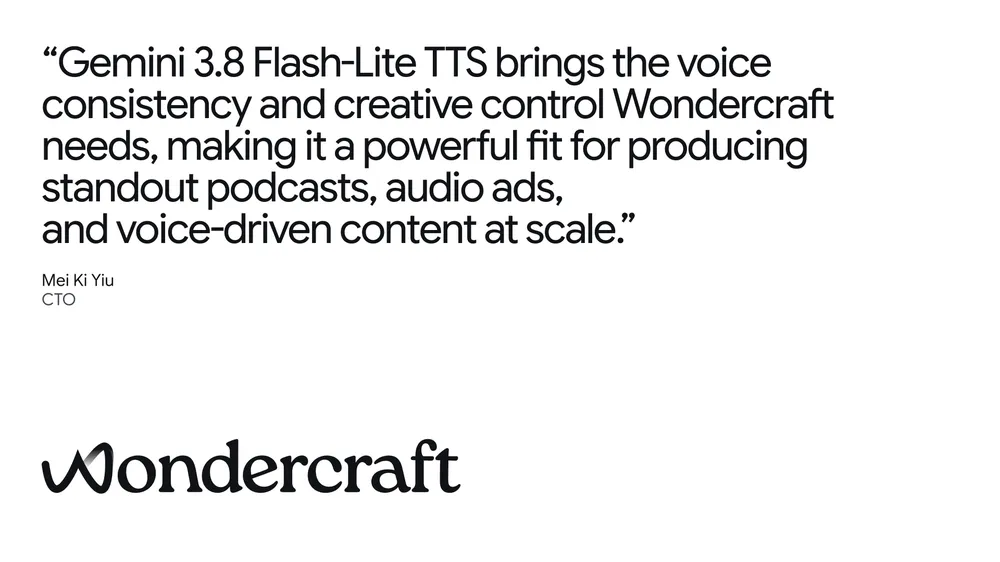
音声コンテンツ制作プラットフォームのWondercraftは、Flash-Lite TTSについて「ポッドキャストや音声広告を大規模に制作するうえで強力な選択肢」とコメントしています。
エンタメ業界の課題とAIによる解決策について、詳しく知りたい方は下記の記事をご覧ください。
マーケティング・動画制作
動画広告やプロモーション動画を多言語で展開する際、吹き替えやローカライズの手間は小さくありません。
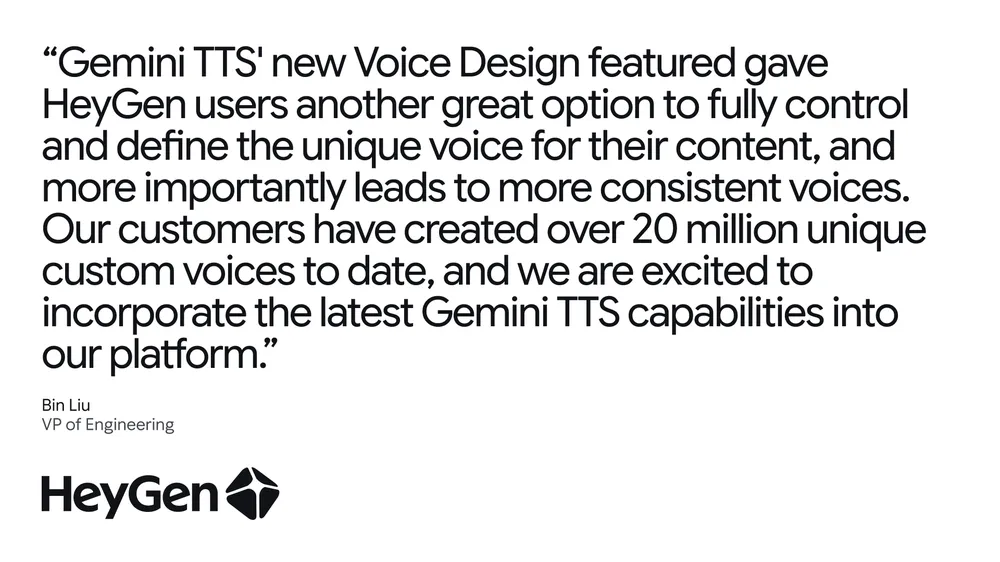
AI動画生成のHeyGenは、Gemini TTSのボイスデザインによってコンテンツ固有の声を定義でき、声の一貫性も高まると評価。同社の顧客はこれまでに2,000万以上のカスタム音声を作成しており、最新のGemini TTSを自社プラットフォームに取り込む予定です。
デザインツールのFigma Weaveでも、感情・トーン・話し方を制御した自然な音声を作れるようになり、サウンドデザインをキャンバス上の制作工程に組み込めるとしています。
生成AIのマーケティング活用方法について、詳しく知りたい方は下記の記事をご覧ください。
コールセンター・カスタマーサポート
電話応答を担う音声エージェントでは、相手の言語や場面に合った話し方が顧客体験を左右します。
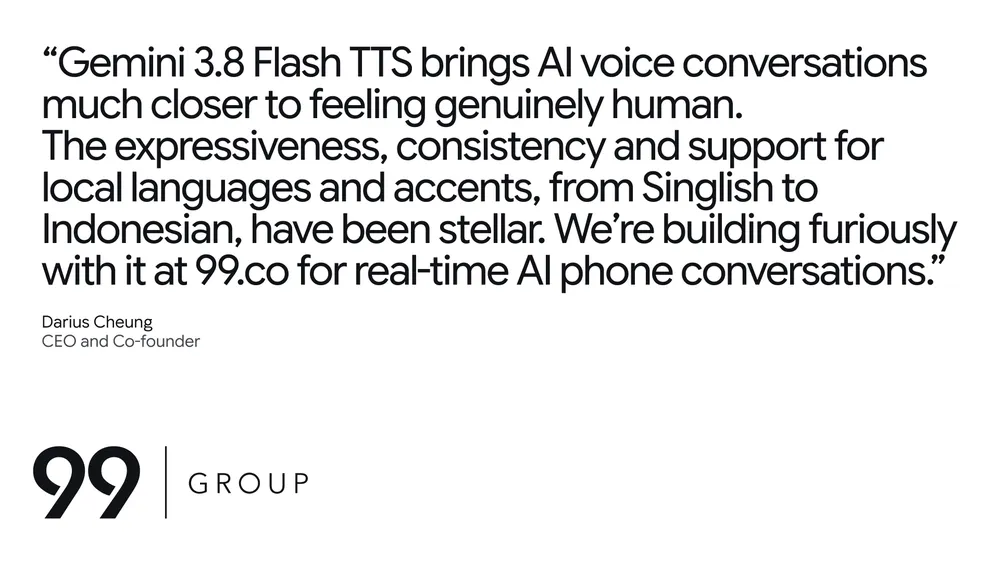
不動産プラットフォームの99.coは、リアルタイムのAI電話対応にGemini 3.8 Flash TTSを活用。シングリッシュからインドネシア語まで、現地の言語やアクセントへの対応を高く評価しています。
落ち着いたカスタマーサービス担当者の話し方も演技指示で再現できるため、問い合わせ窓口の自動応答にも活用が期待できます。
コールセンターへのAI導入について、詳しく知りたい方は下記の記事をご覧ください。

Gemini 3.8 Flash TTSを実際に使ってみた
ここでは、Gemini APIからGemini 3.8 Flash TTSを呼び出し、1人の読み上げと2話者の掛け合いを生成してみます。
まずは1人の読み上げです。セリフとは別に「明るく親しみやすく」という話し方を指定し、プリセット音声の「Kore」で生成しました。
こんにちは。Gemini 3.8 Flash TTSで読み上げています。
(話し方:明るく親しみやすく/音声:Kore)続いて2話者の掛け合いです。セリフごとに話し方を指定し、笑い声(<laugh>)や間(<short pause>)のタグも入れてみました。
Host(明るくテンポよく):今日は新しい音声モデル、Gemini 3.8 Flash TTSを試していきます。
Guest(落ち着いて、少し感心した様子で):声を言葉で指定して作れるんですよね。<laugh> 正直、ちょっと驚きました。
Host(興味津々で):日本語の自然さはどうでした?
Guest(ゆっくり、考えながら):<short pause> 間の取り方まで、かなり人に近いと感じました。
サンプルコードはこちら
"""
使い方
    python tts_demo.py single --text "こんにちは" --style "明るく親しみやすく" --voice Kore
    python tts_demo.py dialogue
    python tts_demo.py single --model gemini-3.8-flash-lite-tts --text "..."
"""

from __future__ import annotations

import argparse
import base64
import json
import logging
import os
import shutil
import subprocess
import sys
import urllib.error
import urllib.request
from datetime import datetime
from pathlib import Path
from typing import Any

logging.basicConfig(level=logging.INFO, format="%(levelname)s %(message)s")
logger = logging.getLogger("tts_demo")

ENDPOINT = "https://generativelanguage.googleapis.com/v1beta/interactions"
ALLOWED_MODELS = {"gemini-3.8-flash-tts", "gemini-3.8-flash-lite-tts"}
# 公式ドキュメント記載のプリセット音声の一部(許可値で絞る)
ALLOWED_VOICES = {"Zephyr", "Puck", "Charon", "Kore", "Fenrir", "Leda", "Orus", "Aoede"}
MAX_TEXT_CHARS = 2000  # 入力上限 8,192 トークンに余裕を持たせた文字数
OUT_DIR = Path(__file__).resolve().parent / "out"

# 2話者のデモ台本(記事の「実際に使ってみた」用サンプル)
DIALOGUE = [
    ("Host", "Puck", "明るくテンポよく", "今日は新しい音声モデル、Gemini 3.8 Flash TTSを試していきます。"),
    ("Guest", "Kore", "落ち着いて、少し感心した様子で", "声を言葉で指定して作れるんですよね。<laugh> 正直、ちょっと驚きました。"),
    ("Host", "Puck", "興味津々で", "日本語の自然さはどうでした?"),
    ("Guest", "Kore", "ゆっくり、考えながら", "<short pause> 間の取り方まで、かなり人に近いと感じました。"),
]


def load_api_key() -> str:
    """環境変数 → 同階層の .env の順で GEMINI_API_KEY を探す。値はログに出さない。"""
    key = os.environ.get("GEMINI_API_KEY", "").strip()
    if not key:
        env_path = Path(__file__).resolve().parent / ".env"
        if env_path.is_file():
            for line in env_path.read_text(encoding="utf-8").splitlines():
                if line.startswith("GEMINI_API_KEY="):
                    key = line.split("=", 1)[1].strip().strip('"').strip("'")
                    break
    if not key:
        logger.error("GEMINI_API_KEY が見つかりません(環境変数か .env に設定してください)")
        sys.exit(1)
    return key


def validate_text(text: str) -> str:
    text = text.strip()
    if not text or len(text) > MAX_TEXT_CHARS:
        raise ValueError(f"テキストは1〜{MAX_TEXT_CHARS}文字で指定してください")
    return text


def text_block(text: str, style: str | None, speaker: str | None = None) -> dict[str, Any]:
    meta: dict[str, Any] = {"type": "speech_metadata"}
    if speaker:
        meta["speaker"] = speaker
    if style:
        meta["style"] = validate_text(style)
    return {"type": "text", "text": validate_text(text), "annotations": [meta]}


def find_audio_b64(obj: Any) -> str | None:
    """レスポンスJSONから最後の音声データ(base64)を探す。"""
    found: str | None = None
    if isinstance(obj, dict):
        if obj.get("type") == "audio" and isinstance(obj.get("data"), str):
            found = obj["data"]
        for v in obj.values():
            found = find_audio_b64(v) or found
    elif isinstance(obj, list):
        for v in obj:
            found = find_audio_b64(v) or found
    return found


def call_api(api_key: str, body: dict[str, Any]) -> dict[str, Any]:
    req = urllib.request.Request(
        ENDPOINT,
        data=json.dumps(body).encode("utf-8"),
        headers={"x-goog-api-key": api_key, "Content-Type": "application/json"},
        method="POST",
    )
    try:
        with urllib.request.urlopen(req, timeout=180) as res:
            return json.loads(res.read().decode("utf-8"))
    except urllib.error.HTTPError as e:
        # エラー本文にはキーは含まれない。長さを切って出す
        detail = e.read().decode("utf-8", errors="replace")[:1000]
        logger.error("API エラー %s: %s", e.code, detail)
        sys.exit(1)


def save_audio(b64: str, label: str) -> Path:
    OUT_DIR.mkdir(exist_ok=True)
    path = OUT_DIR / f"{datetime.now():%Y%m%d-%H%M%S}-{label}.wav"
    # Gemini 3.8 TTS は既定で RIFF ヘッダ付き WAV を返すのでそのまま書く
    path.write_bytes(base64.b64decode(b64))
    return path


def play_audio(path: Path) -> None:
    """macOS 標準の afplay で再生する(引数配列で渡し shell は使わない)。"""
    if shutil.which("afplay") is None:
        logger.warning("afplay が見つからないため再生をスキップしました")
        return
    logger.info("再生中...")
    subprocess.run(["afplay", str(path)], check=False)


def main() -> None:
    parser = argparse.ArgumentParser(description="Gemini 3.8 Flash TTS 検証")
    parser.add_argument("mode", choices=["single", "dialogue"])
    parser.add_argument("--model", default="gemini-3.8-flash-tts", choices=sorted(ALLOWED_MODELS))
    parser.add_argument("--text", default="こんにちは。Gemini 3.8 Flash TTSで読み上げています。")
    parser.add_argument("--style", default="明るく親しみやすく")
    parser.add_argument("--voice", default="Kore", choices=sorted(ALLOWED_VOICES))
    parser.add_argument("--no-play", action="store_true", help="保存だけして再生しない")
    args = parser.parse_args()

    api_key = load_api_key()

    if args.mode == "single":
        content = [text_block(args.text, args.style)]
        speech_config: Any = [{"voice": args.voice}]
    else:
        content = [text_block(t, s, spk) for spk, _, s, t in DIALOGUE]
        speakers = {spk: v for spk, v, _, _ in DIALOGUE}
        speech_config = {
            "mode": "conversational",
            "speakers": [{"speaker": k, "voice": v} for k, v in speakers.items()],
        }

    body = {
        "model": args.model,
        "input": [{"type": "user_input", "content": content}],
        "response_format": {"type": "audio"},
        "generation_config": {"speech_config": speech_config},
    }

    logger.info("リクエスト送信: model=%s mode=%s", args.model, args.mode)
    res = call_api(api_key, body)
    b64 = find_audio_b64(res)
    if not b64:
        logger.error("音声データが見つかりません。レスポンスのキー: %s", list(res.keys()))
        sys.exit(1)
    path = save_audio(b64, f"{args.model}-{args.mode}")
    logger.info("保存しました: %s", path)

    if not args.no_play:
        play_audio(path)


if __name__ == "__main__":
    main()
実際に生成・再生している様子がこちらです。
1人の読み上げは約5秒、2話者の掛け合いは約20秒の音声として出力されました。タグの文字がそのまま読み上げられることはなく、2人の声もはっきり分かれています。
コードを数十行書くだけで、声の指定から2話者の掛け合いまで生成できました。まずは短い台本で、声や話し方の指定を試してみるのがおすすめです。
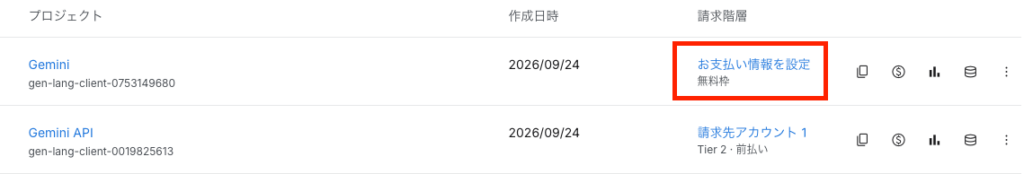
なお、無料枠で実施するためには課金情報が設定されていないプロジェクトを作成し、そのプロジェクトに紐づけてAPIキーを作成する必要があります。
【課題別】Gemini 3.8 Flash TTSが解決できること
Gemini 3.8 Flash TTSが解決できる代表的な課題を紹介します。従来の音声合成では難しかった表現や運用の悩みに、どうアプローチするかを見ていきましょう。
イメージどおりの声を用意できる
「プリセットの中にイメージに合う声がない」という悩みは、音声合成を使う多くの方が経験しているのではないでしょうか。
Gemini 3.8 Flash TTSでは、役柄やアクセント、声質を言葉で伝えるだけで新しい声を作成可能。2,000以上のライブラリから選ぶこともできるため、声探しにかかる時間を減らせる可能性があります。
長尺・シリーズ作品でも声の一貫性を保てる
オーディオブックや連載ポッドキャストでは、途中で声質が変わると作品の没入感が損なわれます。
Gemini 3.8 Flash TTSは、数時間の連続音声でも話者のぶれを最小限に抑える設計です。作成した声を保存して使い回せるため、シリーズ全体で同じ声を維持しやすくなります。
多言語展開の吹き替えを効率化できる
海外向けにコンテンツを展開する場合、言語ごとにナレーターを手配するのは大きなコストです。
100以上の言語に対応し、地域ごとのアクセントまで再現できる、グローバルな吹き替えやローカライズの効率化を想定したモデルです。大量に生成する場面では、コスト効率を重視したFlash-Lite TTSを選ぶとよいでしょう。
| 課題 | 解決できること | 留意点 |
|---|---|---|
| 声の選択肢が少ない | プロンプトで声をゼロから設計、音声ライブラリから選択 | ボイスリミックスは近日提供予定 |
| 長尺で声がぶれる | 数時間の連続音声でも声質を維持し、声を保存して再利用 | APIにはトークン上限があり、長尺は分割生成が前提 |
| 多言語展開のコスト | 100以上の言語とアクセントに対応し、吹き替えを効率化 | 2027年1月から料金が倍になる予定 |
| 自分の声を使いたい | 30秒のサンプルから声を複製 | 本人の口頭同意と使用権が必要、一部地域はAI Studioで利用不可 |
AIによる自動翻訳の仕組みや活用方法について、詳しく知りたい方は下記の記事もあわせてご覧ください。

Gemini 3.8 Flash TTSなど生成AIのご相談はWEELへ!
Gemini 3.8 Flash TTSを活用することで、キャラクターボイスの制作や多言語の吹き替えで、声の一貫性を保ちながら制作効率を高められると考えられます。一方で、声の複製には同意と使用権の管理が欠かせず、運用ルールの設計次第で効果が大きく変わるため、小規模なコンテンツから段階的に導入範囲を広げていくことも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
Gemini 3.8 Flash TTSのよくある質問