Shizuku-Duplexとは?日本語で自然な間合いで話すFull-Duplex音声対話モデルを徹底解説
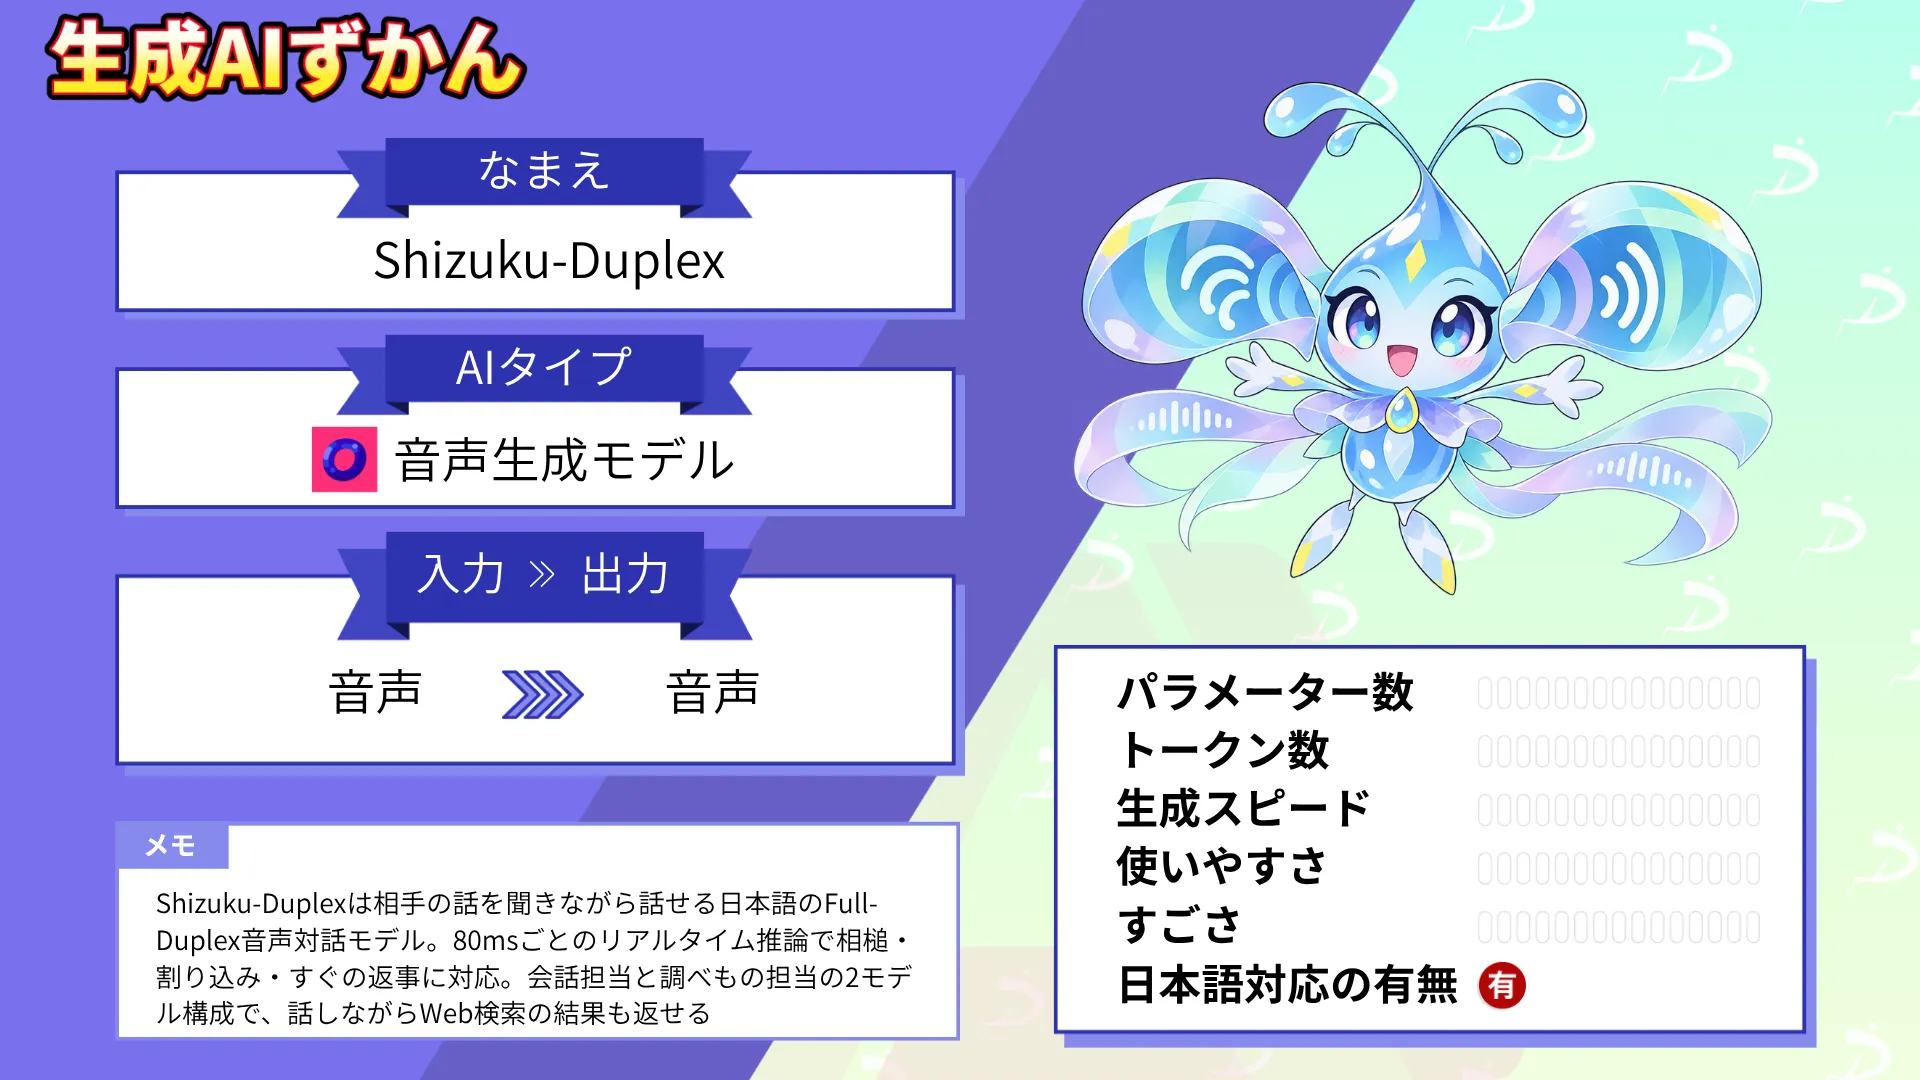
- Shizuku-Duplexは相手の話を聞きながら話せる日本語のFull-Duplex音声対話モデル
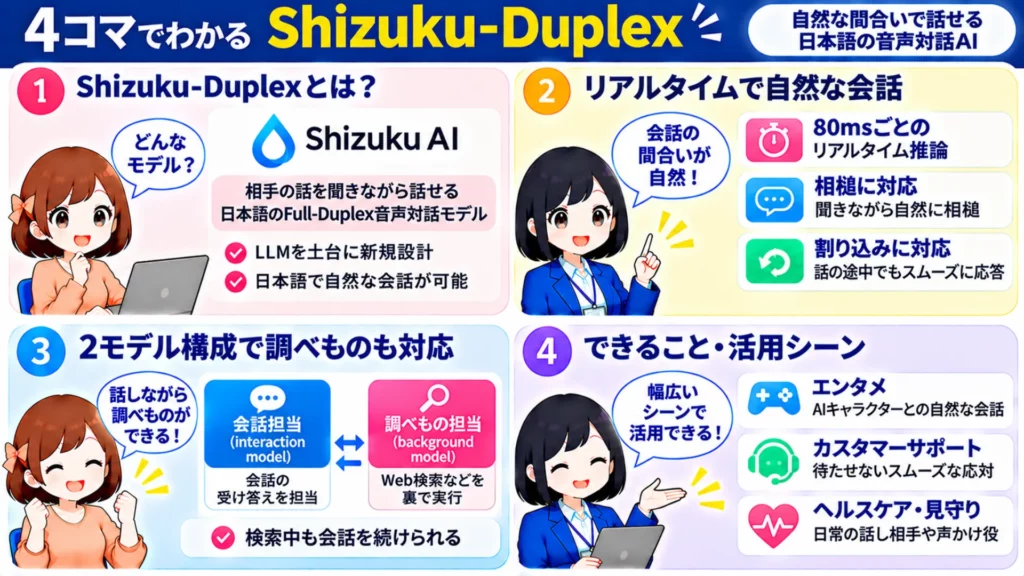
- 80msごとのリアルタイム推論で相槌・割り込み・すぐの返事に対応
- 会話担当と調べもの担当の2モデル構成で、話しながらWeb検索の結果も返せる
2026年11月、Shizuku AIから日本語で自然な間合いの会話ができる音声対話モデルが発表されました。
Shizuku-Duplexは、LLMを土台にアーキテクチャから学習まで新規に設計し、80msごとにリアルタイムで動作します。日本語の評価では、相槌や割り込みなど会話の間合いを測る指標の多くで、Full-Duplexモデルとして最も良い結果を記録。
新しい音声AIが登場するたびに、「従来の音声AIと何が違うのか」「GPT-Liveと比べてどの程度の実力なのか」「実際にどのような場面で使えるのか」といった疑問を感じる方も多いのではないでしょうか。そこで本記事では、Shizuku-Duplexの概要や仕組み、特徴を整理しながら、ベンチマーク結果や料金・ライセンス、業界別の活用シーンについて詳しく解説します。
最後までお読みいただくことで、Shizuku-Duplexがどのように設計され、どのような場面で力を発揮するのかが理解できるはずです。
\生成AIを活用して業務プロセスを自動化/
Shizuku-Duplexとは
Shizuku-Duplexは、Shizuku AIが2026年11月に発表した日本語のFull-Duplex音声対話モデルです。
Full-Duplexとは、相手の声を聞きながら同時に自分も話せる方式のこと。人同士の会話のように、相槌を打ちながら聞き、話し終わるのを待たずに返事ができます。
Shizuku AIは、GPT-Liveを除けば、日本語で賢い対話ができる初めてのFull-Duplexモデルだとしています。応答の品質は、同社が比較した4つのFull-Duplexモデルの中でGPT-Liveに次ぐ水準です。
これまでの多くの音声AIは、音声認識・LLM・音声合成をつないだカスケード型でした。話し終わりを検知してから順に処理するため、間の扱いに限界があったといえるでしょう。
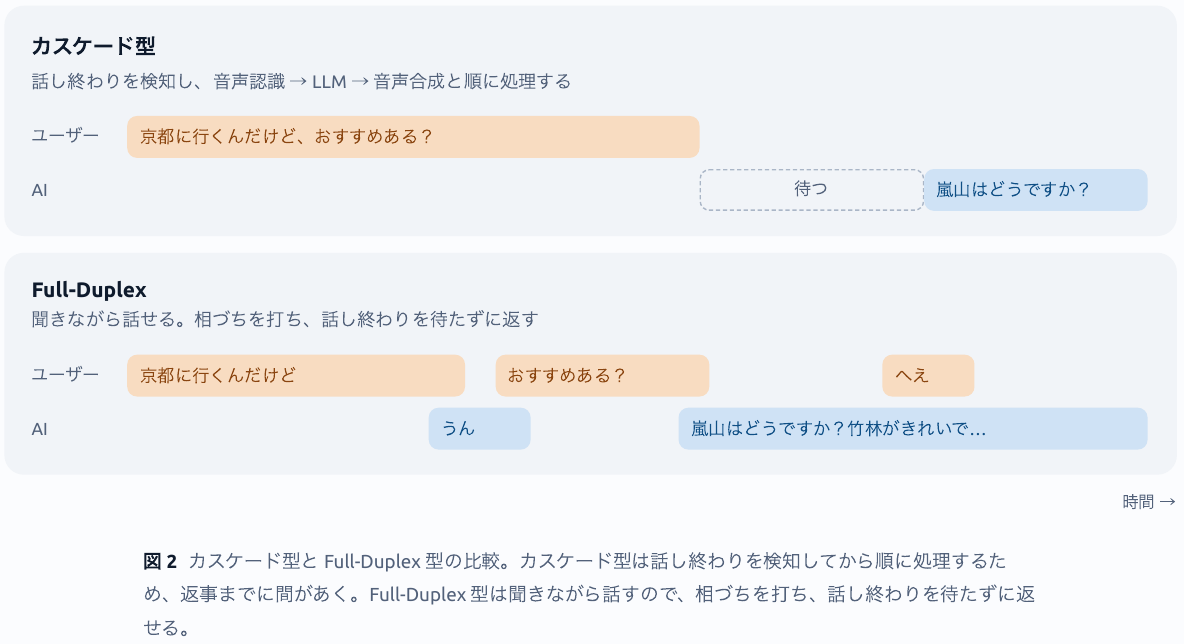
| 比較項目 | Shizuku-Duplex(Full-Duplex型) | 従来の音声AI(カスケード型) |
|---|---|---|
| 処理の流れ | 聞きながら話す処理をinteraction modelがまとめて扱う | 音声認識→LLM→音声合成と順に処理 |
| 返事のタイミング | 話し終わりを待たずに返せる | 話し終わりを検知してから応答 |
| 相槌 | 聞きながら相槌を打てる | 相槌なし |
| 割り込み | 会話の途中で口をはさめる | 途中で口をはさめない |
ここからは、Shizuku-Duplexの主な特徴を見ていきます。まずは全体像を表で確認しましょう。
| 特徴 | できること | 主な数値 |
|---|---|---|
| 日本語の応答品質 | 既存の日本語Full-Duplexモデルを大きく上回る | 検索不要な質問の正答率88%(J-Moshi-extは0%) |
| 相槌・割り込み | 相槌を打ちながら聞き、割り込まれたら話をやめる | 2秒以内に話をやめた割合89% |
| 返事の速さ | 話し終わりを待たずに返す | 返事までの時間は中央値0.57秒 |
| 会話中の調べもの | Web検索を裏で任せ、その間も受け答えを続ける | 検索が必要な質問の正答率43% |
| 長時間の会話 | 会話を定期的に要約してコンテキストを作り直す | 約5分ごとに要約し、切り替えは80ms以内 |
日本語で賢い対話ができるFull-Duplexモデル
日本語のFull-Duplexモデルには、MoshiをもとにしたJ-MoshiやLLM-jp-Moshiがすでにあります。ただ、知識を問う質問や応答内容の評価では、低い結果にとどまっていたのが実情。
Shizuku-DuplexはLLMを土台にアーキテクチャから学習まで新規に設計し、同社の評価では両モデルを応答内容で大きく上回りました。
相槌・割り込み・すぐの返事に対応
相槌を打ちながら聞き、割り込まれたら話をやめ、相手の相槌程度なら話し続ける。こうした間合いの判断をモデル自身が行うのが特徴です。
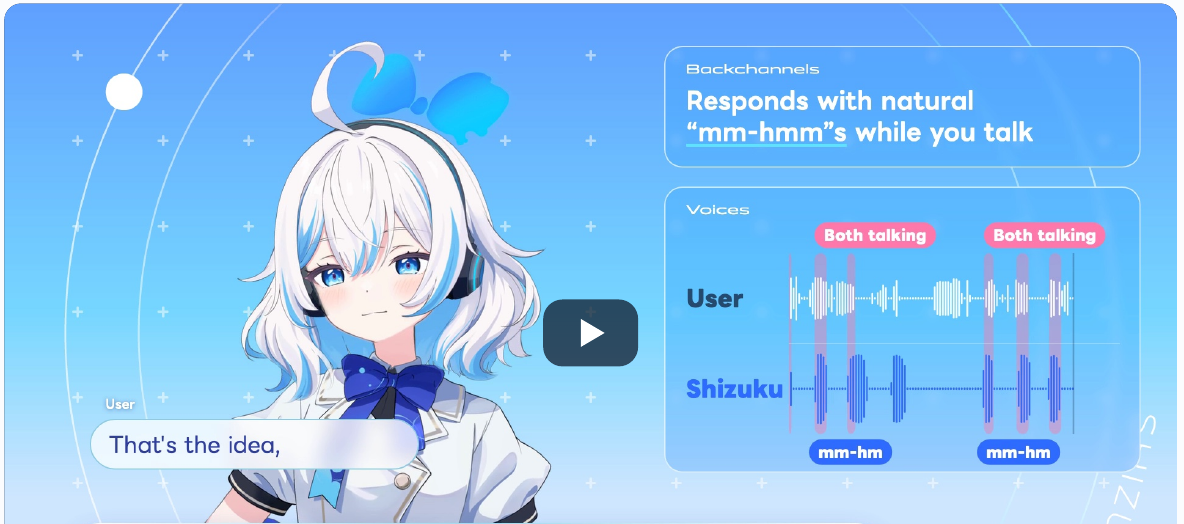
話し終わりから返事までの時間は中央値0.57秒で、GPT-Liveの0.53秒に近い値でした。
会話を続けながら調べものができる
Web検索のような時間のかかる作業は裏のモデルに任せ、その間も受け答えを続けられる設計です。日本語でtool呼び出しができるFull-Duplexモデルは、GPT-Liveを除きShizuku AIの知る限り存在しないとのこと。
長時間の会話でも崩れにくい
Full-Duplexモデルは黙っている間もコンテキストが伸び続け、長い会話では応答が崩れやすいとされています。Shizuku-Duplexは会話を定期的に要約してコンテキストを作り直すことで、この問題に対処しています。
Shizuku-Duplexの仕組み
Shizuku-Duplexの仕組みは、80msごとのリアルタイム推論と、会話と調べものを分担する2つのモデルが柱。ここでは処理の流れとアーキテクチャを順に見ていきます。
80msごとのリアルタイム推論
Shizuku-Duplexは、80msを1tick(処理の最小単位)として、人間と同じ時間の流れで動きます。毎tickユーザーの声を聞きながら、話すか黙るかを制御する仕組み。
1tickごとの処理は、おおむね次の流れです。
- ユーザーの声を聞き取る(黙っている間も話している間も、相手の声は常に聞こえている)
- 声に出す内容を、声より少し先にテキストで書き出す
- 書き出したテキストをもとに、次のtickから音声トークンを予測して声にする
先に書き出すテキストは、モデルのひとりごと(Inner Monologue)にあたります。この仕組みによって、いつ話し始め、いつ黙るかをモデル自身が決められるようになりました。
リアルタイムで動かすには、毎tickの処理を80ms以内に終える必要があります。そこでTensorRTやTritonカーネルを用いた推論最適化により、これを実現。
interaction modelとbackground modelの分担
調べものや込み入った考えごと、toolを呼び出す作業を、会話と同時に行うのは困難です。そこでShizuku-Duplexは、会話を担うinteraction modelと、会話とは非同期に裏で依頼をこなすbackground modelに役割を分けています。
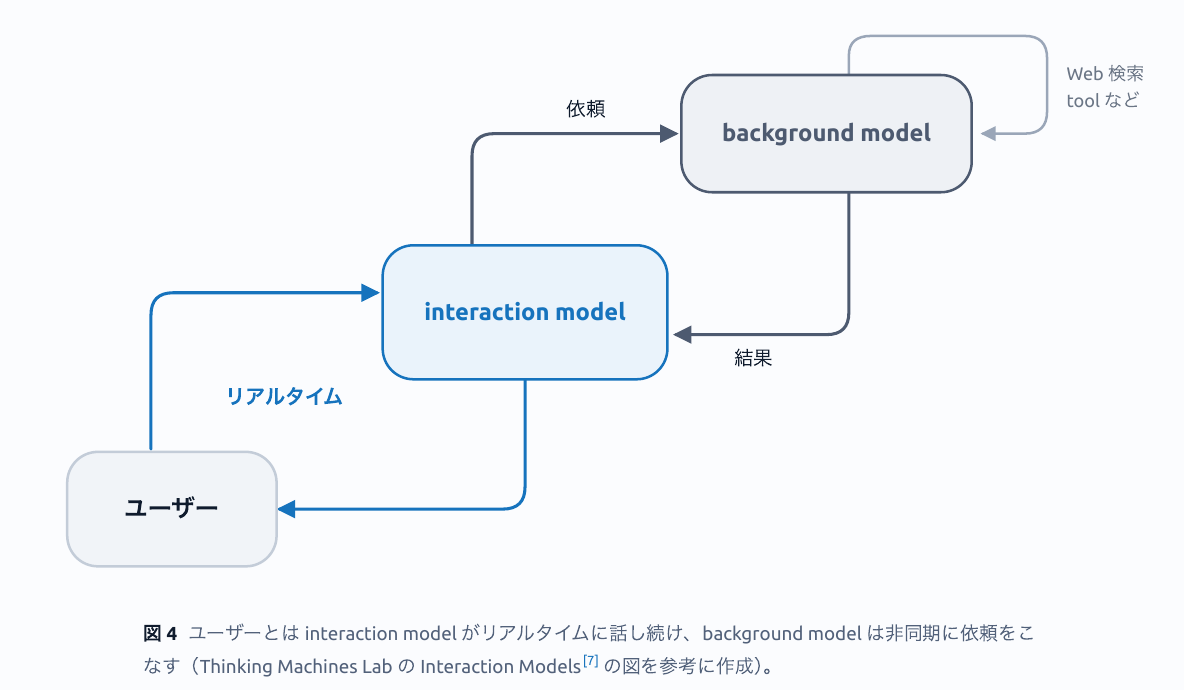
interaction modelは、必要になるとDELEGATEという特別なトークンを出力してbackground modelに依頼します。background modelは、Web検索などのtoolを使えるハーネスの上で動く構成。
background modelが考えている最中も、interaction modelは受け答えを続けている状態になります。届いた結果は、interaction modelが自分の言葉でユーザーに伝える流れです。
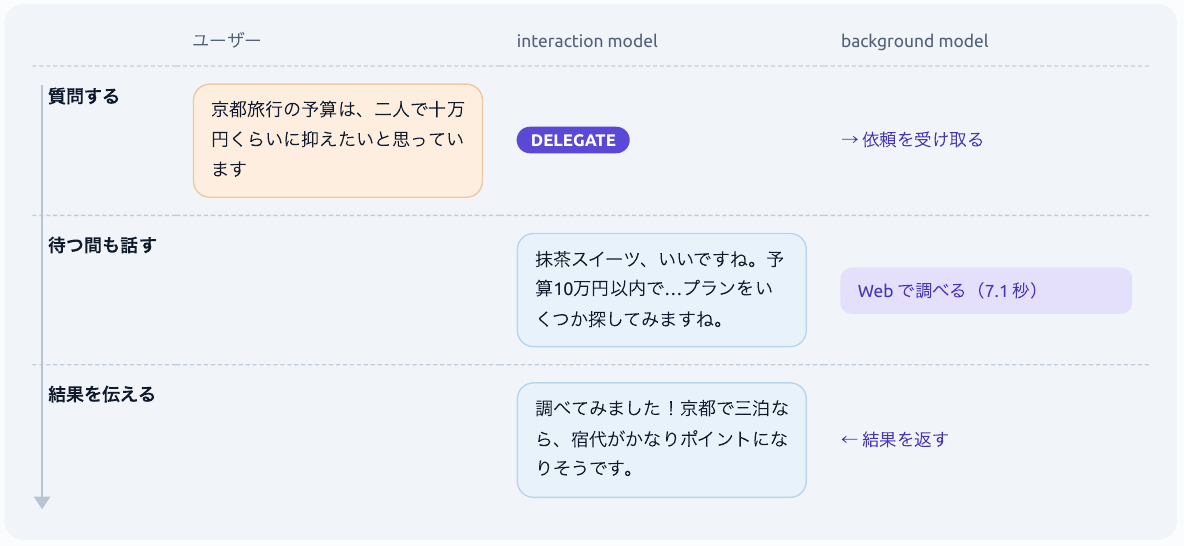
公開された例では、京都旅行の予算を相談されたinteraction modelが調べものを依頼し、約7.1秒の検索中も「プランをいくつか探してみますね」と会話をつないでいます。結果が届くと「京都で三泊なら、宿代がかなりポイントになりそうです」と返していました。
モデルアーキテクチャ
モデルの中心は、LLMを土台にしたTransformer。ユーザーの音声は、ストリーミング音声エンコーダーを通した連続的な特徴として入力されます。
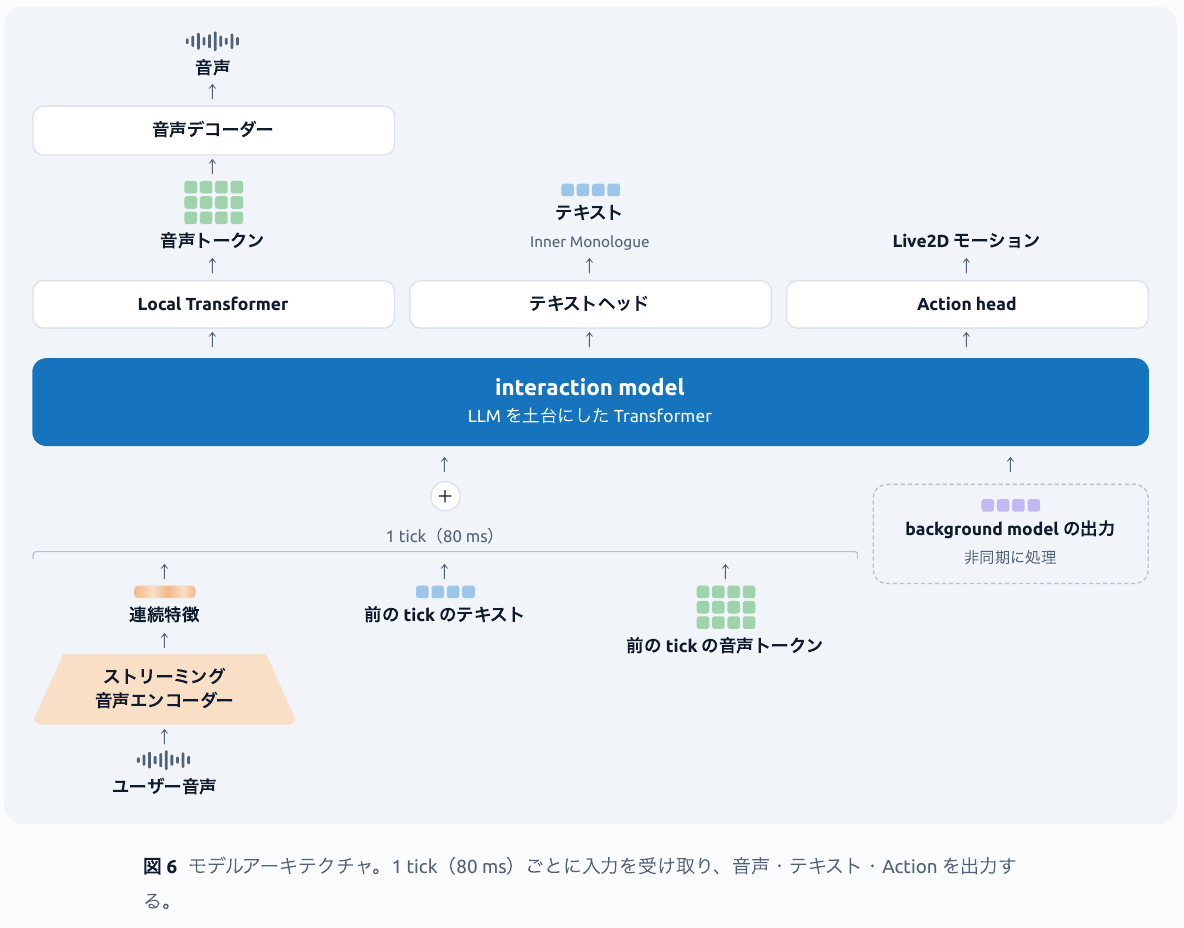
入力は、この音声の特徴と前のtickのモデルの出力を組み合わせたもの。background modelから届いた出力は、系列に差し込まれます。
出力は音声・テキスト・Actionの3つで、それぞれ次の役割を持っています。
| 出力 | 生成する部分 | 役割 |
|---|---|---|
| 音声 | Local Transformer → 音声デコーダー | 音声トークンを波形にデコードして声にする |
| テキスト | テキストヘッド | 声に先立って書き出すInner Monologue |
| Action | Action head | 話している間の気持ちに合ったLive2Dモーションを選ぶ |
長時間対話を支えるAuto-Compaction
長時間の会話に対応するため、Shizuku-Duplexにはコンパクト(Auto-Compaction)と呼ばれる仕組みが入っています。約5分ごとに対話内容を要約し、コンテキストを作り直す方式です。
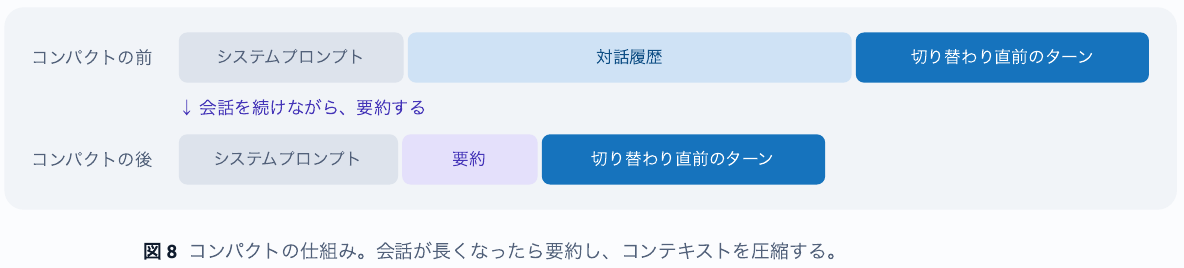
公開された図では、コンパクトの後はシステムプロンプト・要約・切り替わり直前のターンの3つでコンテキストを組み直しています。この切り替えを1tick(80ms)以内に処理し、会話の中断を避ける設計です。
比較対象にもなったOpenAIの音声モデル「GPT-Realtime」について、詳しく知りたい方は下記の記事をご覧ください。
Shizuku-Duplexの料金とライセンス(商用利用の可否)
Shizuku-Duplexの料金体系は公開されていません。一般向けの提供やAPIの公開もまだ発表されておらず、利用料金を判断できる情報はない状況です。
ライセンス情報も確認できませんでした。商用利用などを検討する場合は、事前に提供元への確認が必要です。
| 項目 | 状況 |
|---|---|
| 料金 | 公開されていない |
| 一般向けの提供・API | 公開されていない |
| ライセンス(商用利用の可否) | 確認できず |
| 対応言語 | 日本語(今後拡充予定) |
Shizuku AIは今後の取り組みとして、対話能力の継続的な改善と対応言語の拡充、さらにVisionやActionへの対応を挙げています。提供形態や料金も、こうした開発の進み具合にあわせて明らかになっていくと考えられます。
国内で注目を集めるAI企業Sakana AIについて、詳しく知りたい方は下記の記事もあわせてご覧ください。
【業界別】Shizuku-Duplexの活用シーン
人同士のような間合いで話せるShizuku-Duplexは、会話そのものが価値になる場面で力を発揮すると考えられます。ここでは3つの業界での活用シーンを紹介します。
エンタメ・AIキャラクター
エンタメ分野では、一問一答型の設計だと、AIキャラクターとの会話が単調に感じられてしまう場合があります。返事を待つ間が長いと、キャラクターがそこにいる感覚を損なう可能性もあるでしょう。
Shizuku-Duplexなら、相槌を打ちながら話を聞き、気持ちに合ったLive2Dモーションまで出せます。ゲームやバーチャルキャラクター、配信の相方役といった場面での活用が期待できるでしょう。
AIキャラクターと会話できるサービスについて、詳しく知りたい方は下記の記事もあわせてご覧ください。

カスタマーサポート・電話応対
電話応対の自動化では、話し終わりを待ってから答える音声AIだと会話がぎこちなくなる点が課題。ユーザーが言い直したり途中で口をはさんだりすると、うまく対応できないこともあります。
Shizuku-Duplexは割り込まれると話をやめ、相槌程度なら話し続けられます。調べものをbackground modelに任せている間も会話をつなげるため、待ち時間の不満を減らせる可能性があります。
チャットボットによる問い合わせ対応の自動化について、詳しく知りたい方は下記の記事をご覧ください。

ヘルスケア・見守り
高齢者の見守りや日々の健康づくりでは、気軽に話しかけられる相手が、続けやすさを支える可能性があります。一方で、操作や返事の遅さがある音声AIは、使い続けてもらうのが難しいのではないでしょうか。
Shizuku AIが目指すのは、暮らしの中で一緒に過ごせるAIキャラクター。自然な間合いで話せるShizuku-Duplexは、日常の話し相手や声かけ役としての活用が考えられます。
ヘルスケア領域でのAI活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。
生成AIなどのご相談はWEELへ!
Shizuku-Duplexのように自然な間合いで話せる音声AIを活用すれば、問い合わせ対応やキャラクター体験の質の改善につながる可能性があります。一方で、音声AIは用途や応答の設計次第で効果が大きく変わるため、目的に合ったモデル選びと小さな検証から始めることも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。
Shizuku-Duplexのよくある質問