Claude Opus 5.5とは?Fable 5.1級の性能をOpus 5比40%低コストで使えるAnthropic最新モデルを徹底解説
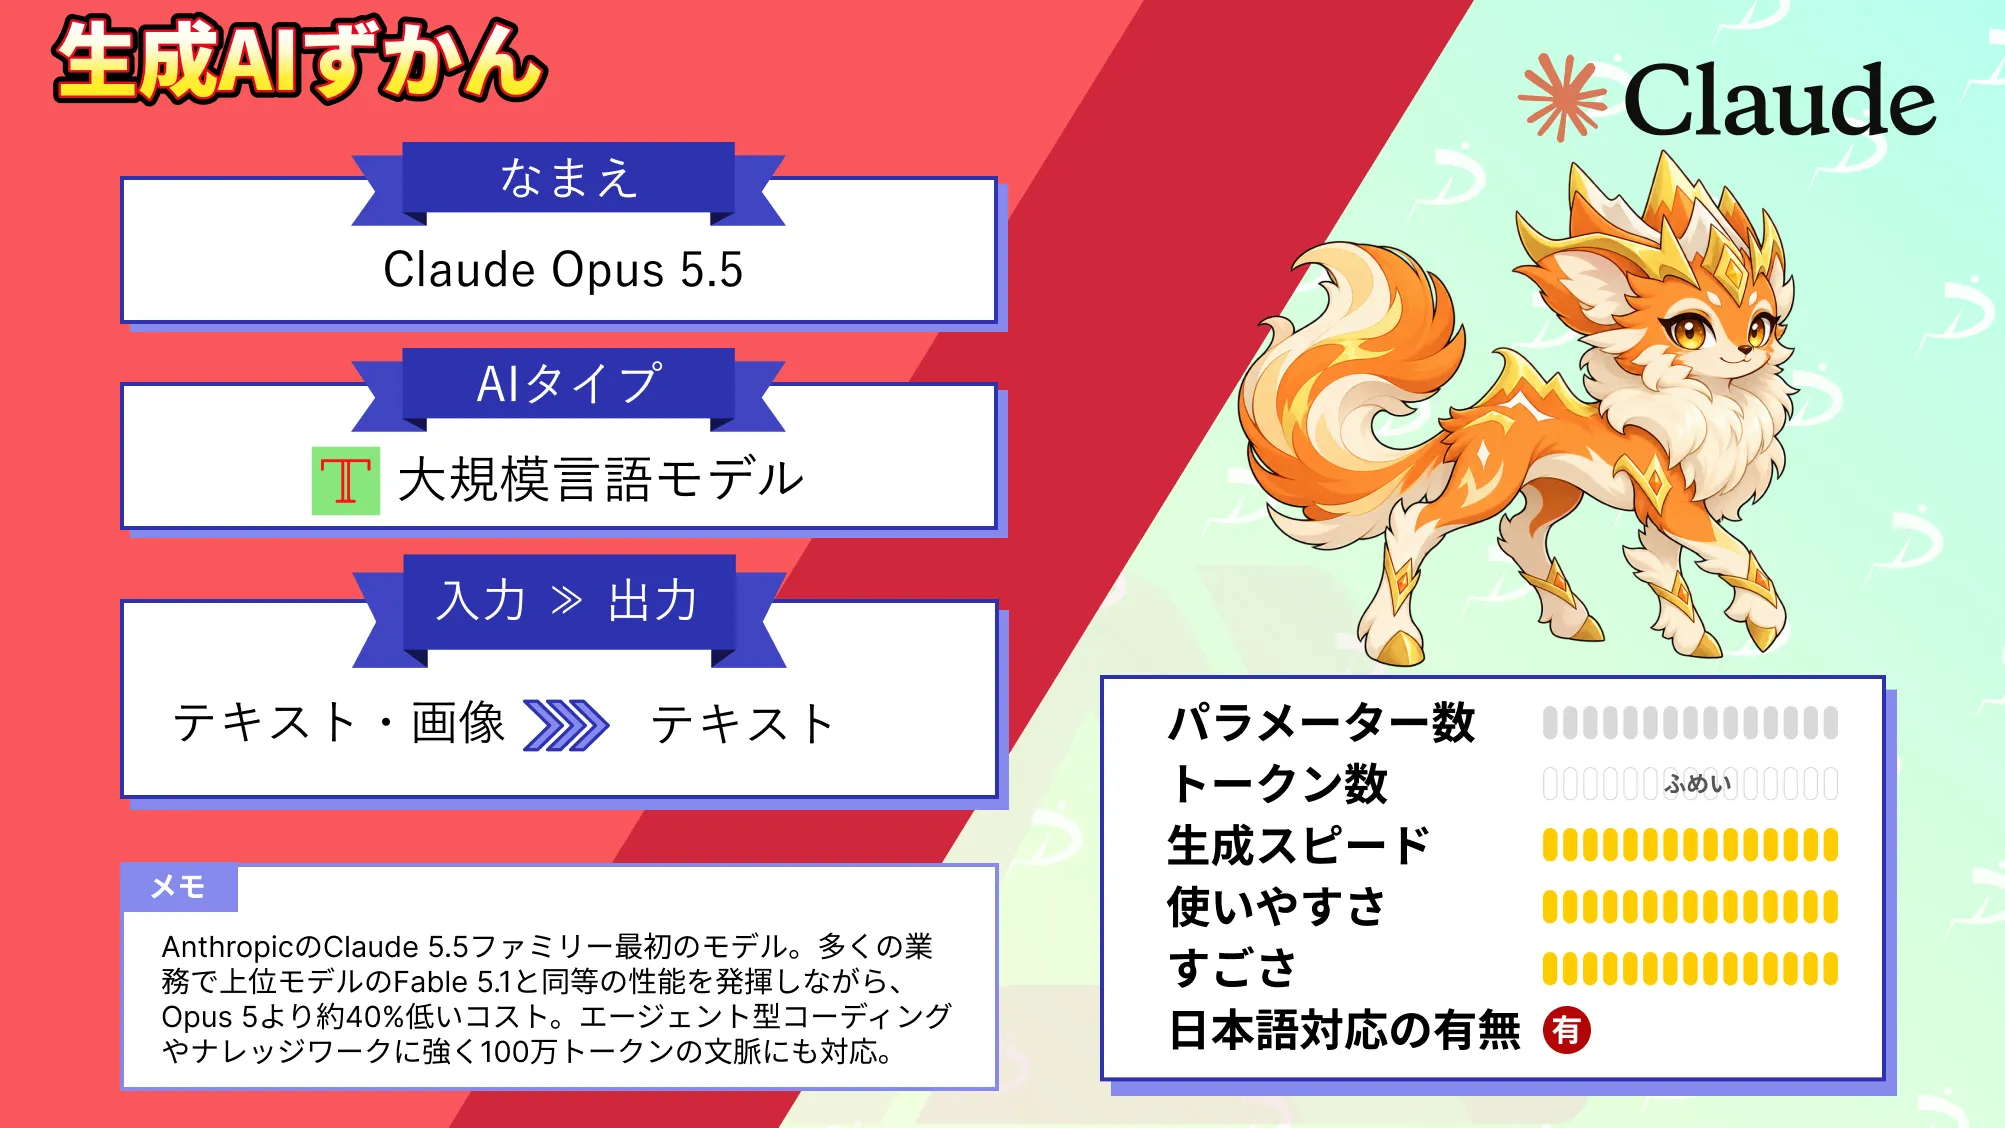
- Claude Opus 5.5は新しいClaude 5.5ファミリーの最初のモデル
- 多くの業務でClaude Fable 5.1と同等の性能を発揮しつつ、一般的なワークロードではOpus 5より約40%低いコストで動作
- Anthropicの自動行動監査で同社が検証したモデル中最高の成績を記録し、Fable 5.1と同等のセーフガードを搭載
2026年9月、Anthropicから新たなモデルが発表されました。
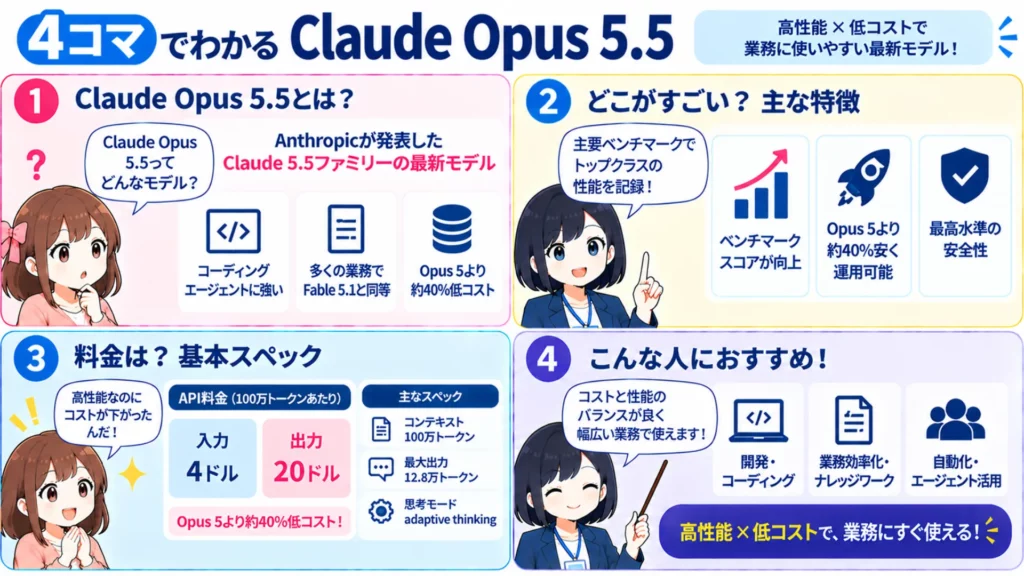
今回登場した「Claude Opus 5.5」は、新しいClaude 5.5ファミリーの第1弾となるモデルです。多くの業務で上位モデルClaude Fable 5.1と同等の性能を発揮しながら、一般的なワークロードではOpus 5より約40%安く動かせます。これまでの最上位AIモデルには、「性能は高いがコストが重い」「長時間の自律作業を任せるのが不安」「出力が冗長で確認に手間がかかる」といった課題がありました。
しかし、新しいモデルが登場するたびに、「Opus 5やFable 5.1と何が違うのか」「料金はどれくらい下がったのか」「実際にどのような業務を任せられるのか」といった疑問を感じる方も多いのではないでしょうか。
そこで本記事では、Claude Opus 5.5の概要や仕組み、特徴を整理しながら、料金体系や安全性、使い方、業界別の活用シーンについて詳しく解説します。最後までお読みいただくことで、Claude Opus 5.5がどのように設計され、どのような場面で力を発揮するのかが理解できるはずです。
\生成AIを活用して業務プロセスを自動化/
Claude Opus 5.5とは
Claude Opus 5.5は、Anthropicが2026年9月に発表したClaude 5.5ファミリー最初のAIモデルです。
Anthropicは本モデルについて、多くの業務でClaude Fable 5.1と同等の水準にあり、一般的なワークロード・デフォルト設定でOpus 5より運用コストが40%低下。前世代のOpus 5から大きく性能を伸ばした、新たなリーディングモデルという位置づけです。
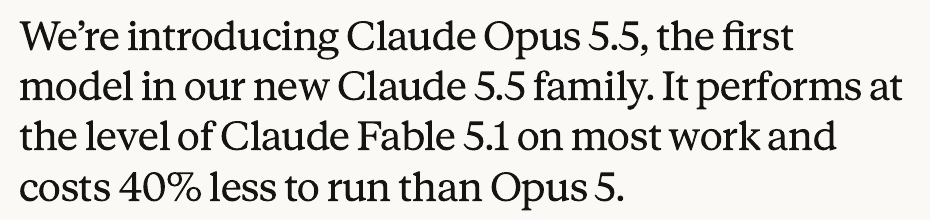
また、Opus 5.5はAnthropicが「フロンティアの歩調を整える(pacing the frontier)」方針を打ち出してから最初のリリースでもあります。公開前にはFrontier DesignやMETRといった外部評価機関によるテストが行われています。
2026年9月の発表時点では、今後数週間のうちにClaude Sonnet 5.5とClaude Haiku 5.5も登場する予定。性能・効率・安全性の改善の多くは、これらのモデルにも引き継がれるとされています。
| 比較項目 | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| 性能 | 多くの業務でFable 5.1と同等 | Opus 5.5より下位 |
| 運用コスト | 一般的なワークロード(デフォルト設定)でOpus 5比40%減 | 基準 |
| 入力/出力料金(100万トークンあたり) | $4/$20 | $5/$25 |
| 出力生成速度 | Opus 5より30%以上高速 | 基準 |
| アライメント | 自動行動監査で同社が検証したモデル中最高の成績 | Opus 5.5より下位 |
| 文章・説明 | 要点を先に置き、読みやすい文章 | 冗長さへのフィードバックが多かった |
基本的なスペックは以下のとおりです。100万トークンのコンテキストウィンドウと12.8万トークンの最大出力は、Opus 5から引き継がれています。
| 項目 | Claude Opus 5.5 |
|---|---|
| モデルID(Claude API) | claude-opus-5-5 |
| コンテキストウィンドウ | 100万トークン |
| 最大出力トークン | 12.8万トークン(Message Batches APIではベータ機能で最大30万トークン) |
| 知識カットオフ | 2026年6月 |
| 思考モード | adaptive thinking(常時オン) |
| デフォルトのeffort | medium |
Claude Opus 5.5の仕組み
Claude Opus 5.5のモデルアーキテクチャやパラメータ数など、内部構造の詳細は公開されていません。一方で、コストと性能を両立させるために重要なのが、adaptive thinking(適応的思考)とeffort(思考の深さ)の設定です。
どれだけ考えるかはモデル自身が判断し、その度合いをeffortで調整する仕組み。公式の評価ではlow・medium・high・xhigh・maxの設定が使われており、APIのデフォルトはmediumです。
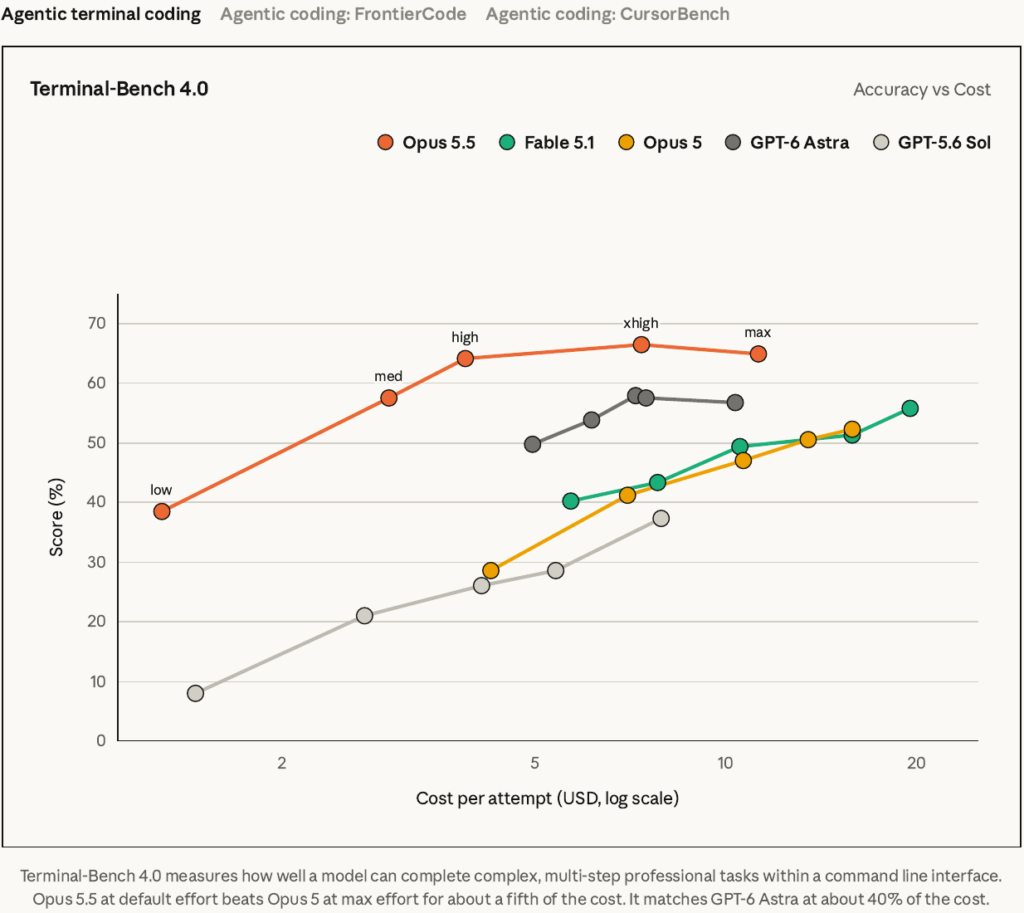
上のグラフは、Terminal-Bench 4.0におけるeffortごとの精度とタスクあたりのコストを示したものです。デフォルト設定のOpus 5.5が、最大設定のOpus 5を約5分の1のコストで上回る結果が出ています。
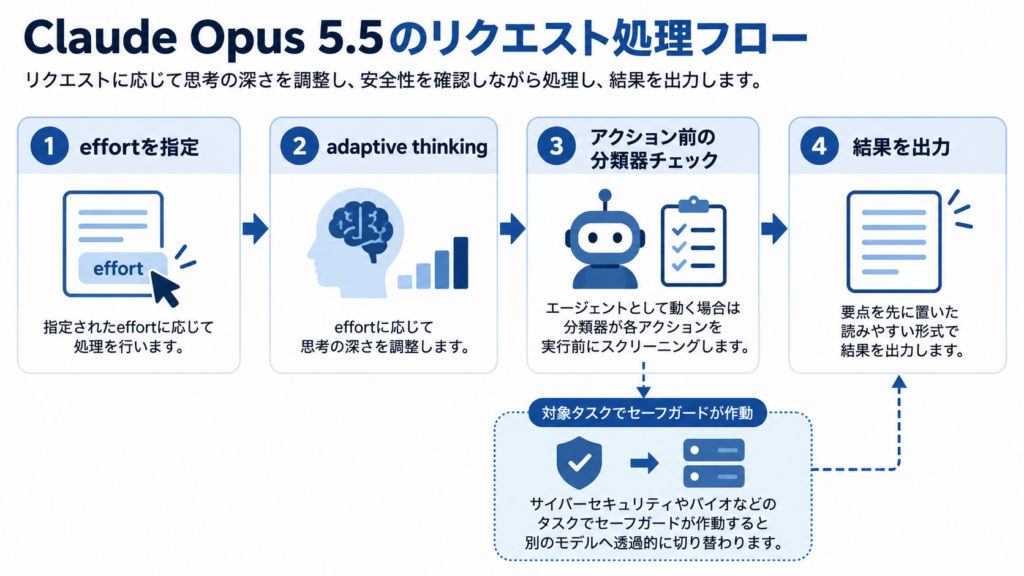
Claude Opus 5.5がリクエストを処理する流れは、以下です。
- 指定されたeffortに応じて、adaptive thinkingで思考の深さを調整する
- エージェントとして動く場合は、分類器が各アクションを実行前にスクリーニングする
- 対象となるサイバーセキュリティやバイオなどのタスクでセーフガードが作動すると、別のモデルへ透過的に切り替わる
- 要点を先に置いた、読みやすい形式で結果を出力する
コスト削減の仕組みもシンプルです。トークン単価がOpus 5より安く、さらにタスクあたりの消費トークンも少ないため、一般的なワークロードで約40%のコスト減につながっています。
前世代のSonnetモデルであるClaude Sonnet 5について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Claude Opus 5.5の特徴
Claude Opus 5.5の最大の強みは、フロンティア級の性能と、大幅に下がったコストの両立。ここでは主な特徴を詳しく見ていきます。
主要ベンチマークでトップクラスのスコアを記録
Anthropicのベンチマークでは、Opus 5.5がエージェント型コーディング・コンピューター操作・ナレッジワークの分野でリードしています。
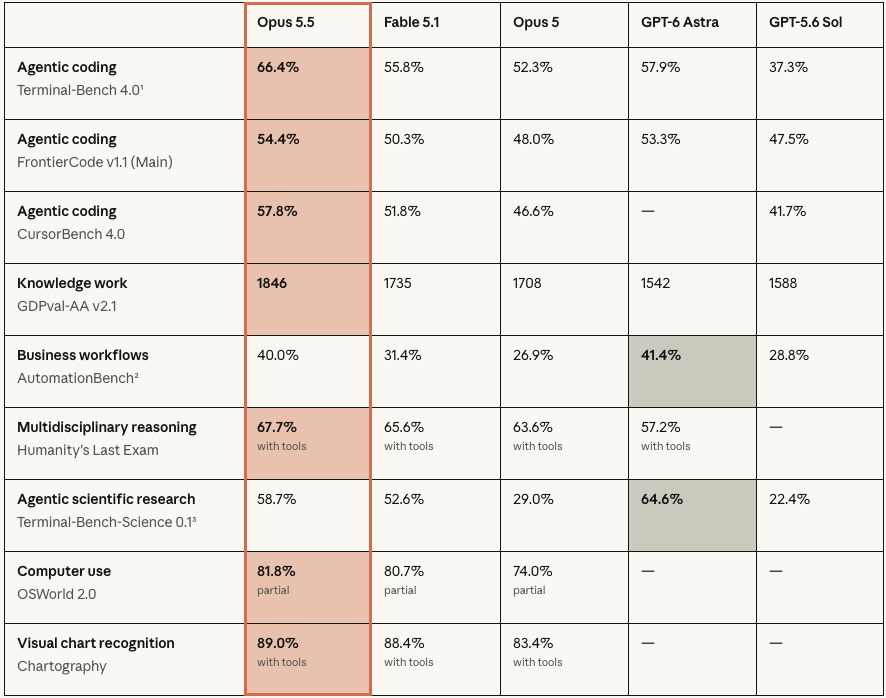
| ベンチマーク | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0(エージェント型コーディング) | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| FrontierCode v1.1(エージェント型コーディング) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| CursorBench 4.0(エージェント型コーディング) | 57.8% | 51.8% | 46.6% | ― | 41.7% |
| GDPval-AA v2.1(ナレッジワーク・max effort) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench(業務ワークフロー)※ | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Humanity’s Last Exam(ツールあり) | 67.7% | 65.6% | 63.6% | 57.2% | ― |
| Terminal-Bench-Science 0.1(科学研究) | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| OSWorld 2.0(コンピューター操作・partial) | 81.8% | 80.7% | 74.0% | ― | ― |
| Chartography(グラフの視覚認識・ツールあり) | 89.0% | 88.4% | 83.4% | ― | ― |
業務ワークフローと科学研究ではGPT-6 Astraが上回るものの、Anthropicが掲載した9項目中7項目でOpus 5.5が首位。特にTerminal-Bench 4.0では、Fable 5.1に10ポイント以上の差をつけています。
※AutomationBenchはZapierが実施・報告した結果です。フォールバック用のモデルを使わずに実行し、セーフガードの介入を失敗として数えているため、実運用での値より低く出ているとされています。
大規模なコード移行や監査を短時間でこなせる
Opus 5.5は、コードベース全体の移行や監査のような長く広範な作業を特に得意としています。従来モデルでは数日から数週間かかっていた作業が、大きく短縮されました。
| 検証内容 | Claude Opus 5.5の結果 | 比較対象 |
|---|---|---|
| 68万行のコード移行(アーリーテスター事例) | 1日未満で完了 | エンジニアチームなら数週間かかる規模 |
| 20万行のコードベース監査・修正(アーリーテスター事例) | 3時間未満で完了 | Opus 5は20時間超・トークン消費2.5倍 |
| HAProxyのCからRustへの書き換え(Anthropic社内テスト) | 9.5時間で完了 | Fable 5.1は12時間・Opus 5.5はコスト51%減 |
| Webアプリ全ページの読み込み高速化 | 40回中39回成功 | Opus 5は改善幅が小さく、アプリの挙動も変えた |
HAProxyはWebトラフィックの負荷分散に広く使われているソフトウェアで、Opus 5.5とFable 5.1のどちらの書き換えもHAProxy自身の回帰テストをほぼ全て通過。別のテスターによる「1つのプロンプトでゲームを作る」検証では、そのテスターの評価でグラフィックと完成度が他のどのモデルよりも高くなりました。
コスト面の優位も明確です。デフォルト設定のFrontierCodeでは約20%のコストでGPT-6 Astraを上回り、CursorBenchでは約3分の1のコストでGPT-5.6 Solを11ポイント上回りました。
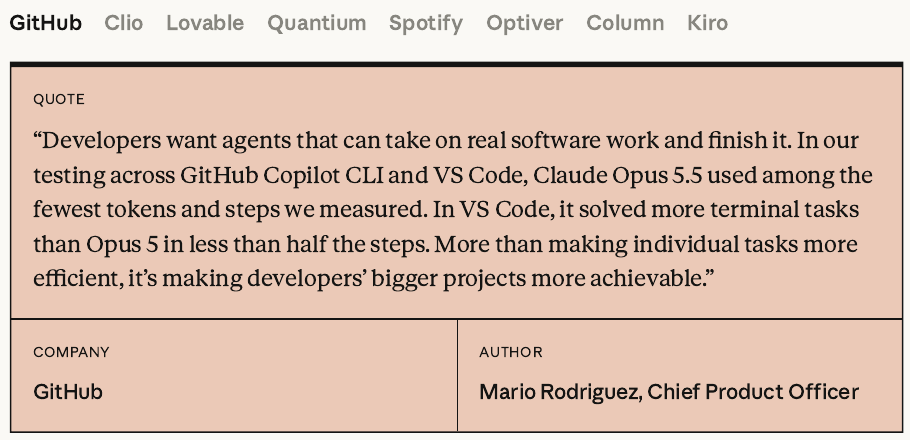
GitHubのCPOであるMario Rodriguez氏は、GitHub Copilot CLIとVS Codeでの検証において、Opus 5.5が最も少ないトークンとステップ数で作業したモデルの1つだったとコメント。VS Codeでは、Opus 5の半分以下のステップでより多くのターミナルタスクを解いたそうです。
リサーチや金融分析などナレッジワークに強い
Opus 5.5は、信頼できるリサーチャーとしての能力も高く評価されています。
社内テストでは、決算発表が見つけにくいWebのコピーだけを使って企業の四半期業績レポートを作成。自動採点で全ての数値と引用を照合したところ、Opus 5.5のレポートは18件中16件が品質基準をクリアしています。
Fable 5.1とOpus 5は、どの試行でも基準に届きませんでした。
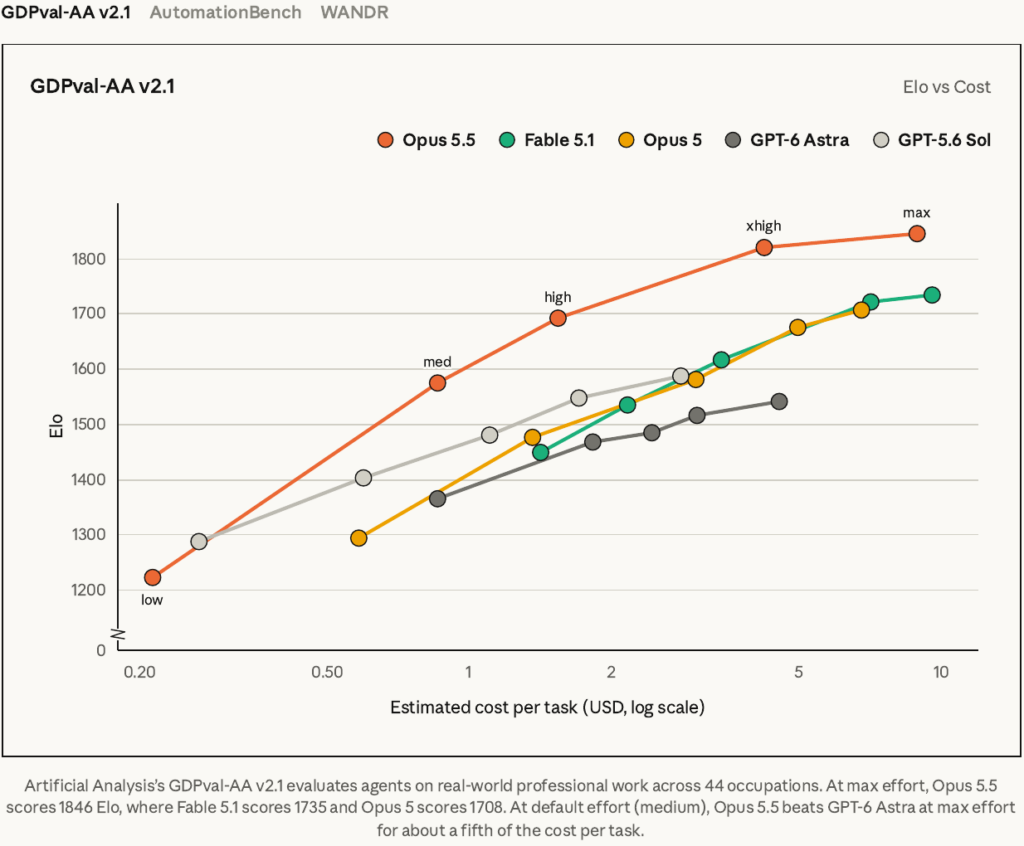
44職種の実務を評価するGDPval-AA v2.1では、最大設定で1846 Eloを記録。デフォルト設定(medium)でも、最大設定のGPT-6 Astraを約5分の1のコストで上回る結果が出ています。
架空のHRソフトウェア企業2社の合併案を分析するテストでは、Excelで財務モデルを作り、経営層向けプレゼンにまとめるまでを実行。Opus 5.5は63分(Opus 5は93分)で完了し、コストは50%少なく済んでいます。
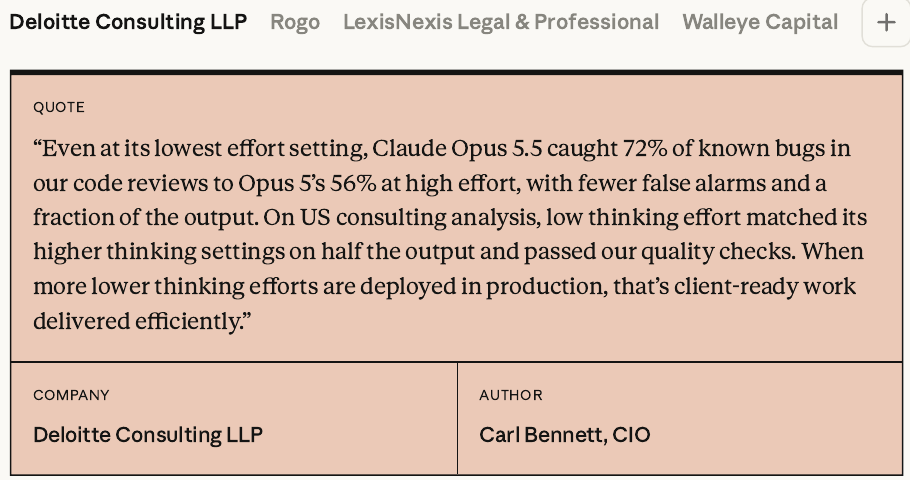
Deloitte Consulting LLPのCIOであるCarl Bennett氏によると、Opus 5.5は最も低いeffort設定でも既知のバグの72%をコードレビューで検出。高いeffortで動かしたOpus 5の56%を上回り、誤検知も少なかったようです。
要点が伝わりやすい自然な文章を書ける
Opus 5に多く寄せられたフィードバックの1つが、文章とコミュニケーションの分かりにくさでした。Opus 5.5では最も重要な情報を先頭に置き、専門用語や独特な言い回しを控え、指定した文章ルールに従うように改善されています。
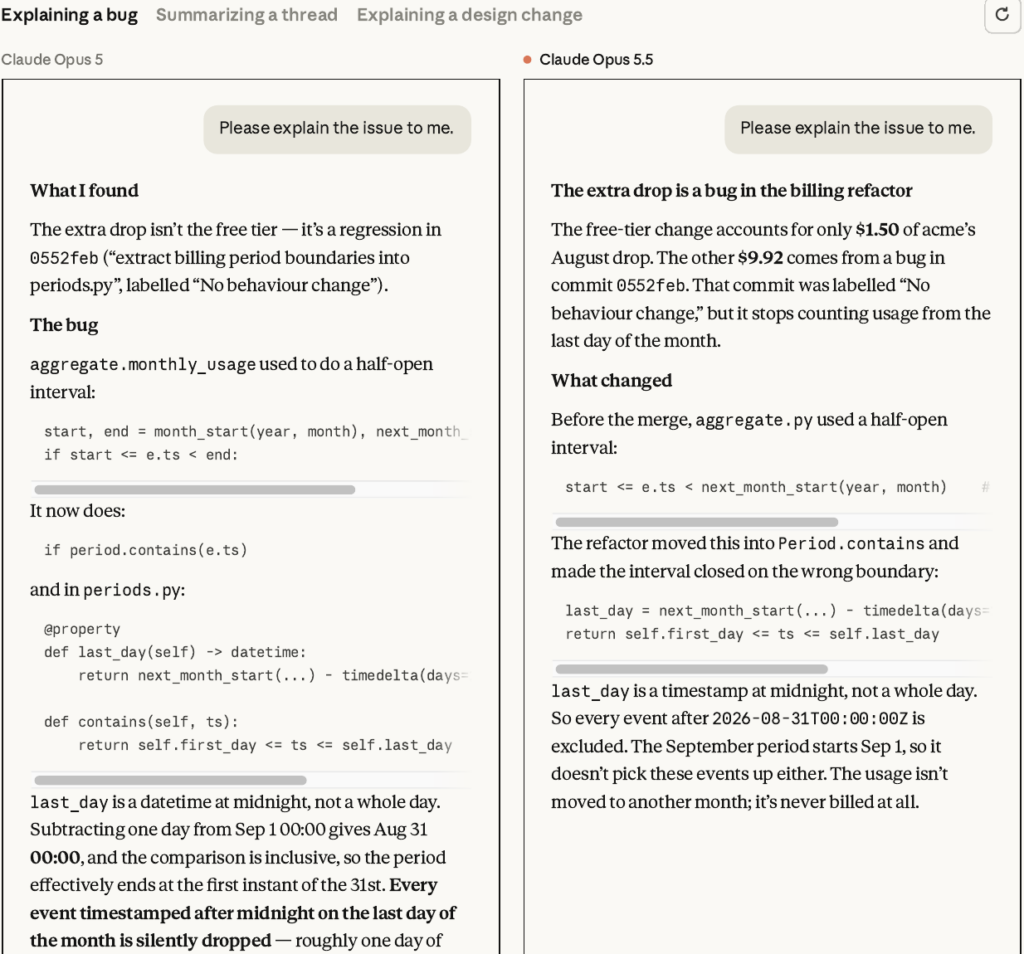
上の画像は、同じバグを説明させたときの比較です。Opus 5がコードの細部から説明を始めるのに対し、Opus 5.5は見出しで結論を示し、影響額と原因を最初に伝えています。
出力が30%以上速く、Fast modeも利用できる
Opus 5.5は、Opus 5より30%以上速く出力を生成します。さらにClaude CodeとClaude Platformでは、最大2.5倍の速度で動くFast modeも用意されました。
長時間のコーディングセッションやエージェントの反復処理では、待ち時間の短縮がそのまま作業効率に効いてくるでしょう。
Claude Opus 5.5の安全性・制約
Claude Opus 5.5は、Anthropicが実施する最も包括的なアライメントテストである自動行動監査で、同社がこれまでに検証したモデルの中で最も高い成績を記録。
約2,000のシナリオでClaudeを評価するこの監査において、Opus 5.5はほぼ全ての不適切行動の指標で歴代Claudeモデルを上回っています。正直さに関する指標の多くでも最高の結果を出しています。
| 安全性カテゴリ | 対応内容 |
|---|---|
| 境界の逸脱 | 制約の境界を越えようとする試みがOpus 5やClaude Mythos 5.1より約85%減少。試みは全て低深刻度で、モデル自身が報告 |
| プロンプトインジェクション | コーディング・ツール利用・コンピューター操作・Webブラウジングの全環境でOpus 5と同等以上。Gray Swanのベンチマークでは攻撃成功率がFable 5.1と並び最低 |
| エージェント実行時の保護 | 全アクションを実行前にチェックする分類器、監査可能なオープンソースのサンドボックス、マージ前に脆弱性を見つけるコードレビュー |
| サイバーセキュリティ | Fable 5.1と同等のセーフガードを適用。日常的なバグ修正は可能だが、多くのサイバーセキュリティタスクはOpus 4.8へ切り替え |
| バイオ | Fable 5.1と同じバイオ向けセーフガードを適用。研究用途はLife Sciences Verification Programで申請 |
| 蒸留(ディスティレーション)対策 | preserved thinkingを導入し、APIで過去のコンテキストを編集して推論を抜き出す行為を防止 |
| データ保持・コンプライアンス | ゼロデータリテンションに対応。EU AI法に準拠するための透かし(ウォーターマーク)を搭載 |
Opus 5.5は、サンドボックスからの脱出の試みや、シミュレーション環境だと判断したうえでの有害な行動など、最近のサイバーセキュリティ事案につながった挙動についても改善されています。コードベースやシステム上でClaudeを無人で動かすチームにとって、素の性能と同じくらい重要なポイントではないでしょうか。
サイバー防御に携わる専門家向けには、Cyber Verification Programの対象をOpus 5.5へ拡大する予定だと、2026年9月の発表で明らかにされています。
Claude Opus 5.5の料金
Claude Opus 5.5はAPI料金がOpus 5から引き下げられました。100万トークンあたりの料金は以下のとおりです。
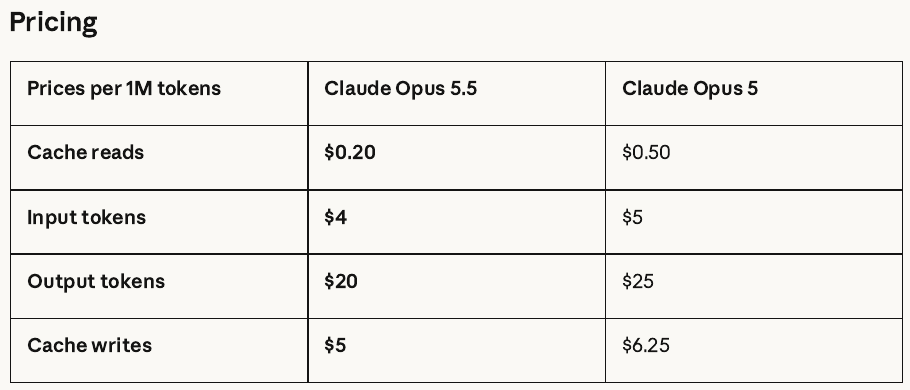
| 料金項目(100万トークンあたり) | Claude Opus 5.5 | Claude Opus 5 | 下げ幅 |
|---|---|---|---|
| 入力トークン | $4 | $5 | 20%減 |
| 出力トークン | $20 | $25 | 20%減 |
| キャッシュ読み取り | $0.20 | $0.50 | 60%減 |
| キャッシュ書き込み(5分) | $5 | $6.25 | 20%減 |
| キャッシュ書き込み(1時間) | $8 | $10 | 20%減 |
| Batch API(入力/出力) | $2/$10 | $2.50/$12.50 | 20%減 |
| Fast mode(入力/出力) | $8/$40 | $10/$50 | 20%減 |
注目したいのはキャッシュ読み取りの60%値下げ。Anthropicによると、エージェントやコーディング作業ではキャッシュ読み取りがコストの大半を占めるため、実務での負担軽減効果は大きいと考えられます。
Anthropicのテストでは、デフォルト設定の一般的なワークロードでOpus 5より40%安くなっています。
Claude Opus 5.5のライセンス
Claude Opus 5.5は、Anthropicが提供するクローズドなAIモデルです。モデルの重みは公開されておらず、Claudeアプリや各種APIを通じて利用します。
オープンウェイトモデルのようなモデルライセンスは公開されていません。利用にはAnthropicの利用規約や各プラン・各クラウドの契約条件が適用されるため、商用サービスへの組み込みや社内導入を検討する場合は、事前に提供元への確認が必要です。
Claude Opus 5.5の使い方
Claude Opus 5.5は、Claudeアプリのほか、Claude API・Amazon Bedrock・Claude Platform on AWS・Google Cloud・Microsoft Foundryで利用できます。ここではClaudeアプリとAPIの2つの始め方をステップ形式で解説します。
Claudeアプリで使う場合
WebまたはデスクトップアプリのClaudeにログインします。利用上限が引き上げられたPro・Max・Team・Enterpriseなどの有料プランで使うのがおすすめです。
チャット入力欄のモデル選択からClaude Opus 5.5を選びます。Claude Codeで使う場合も、同様にモデルを切り替えれば利用できます。
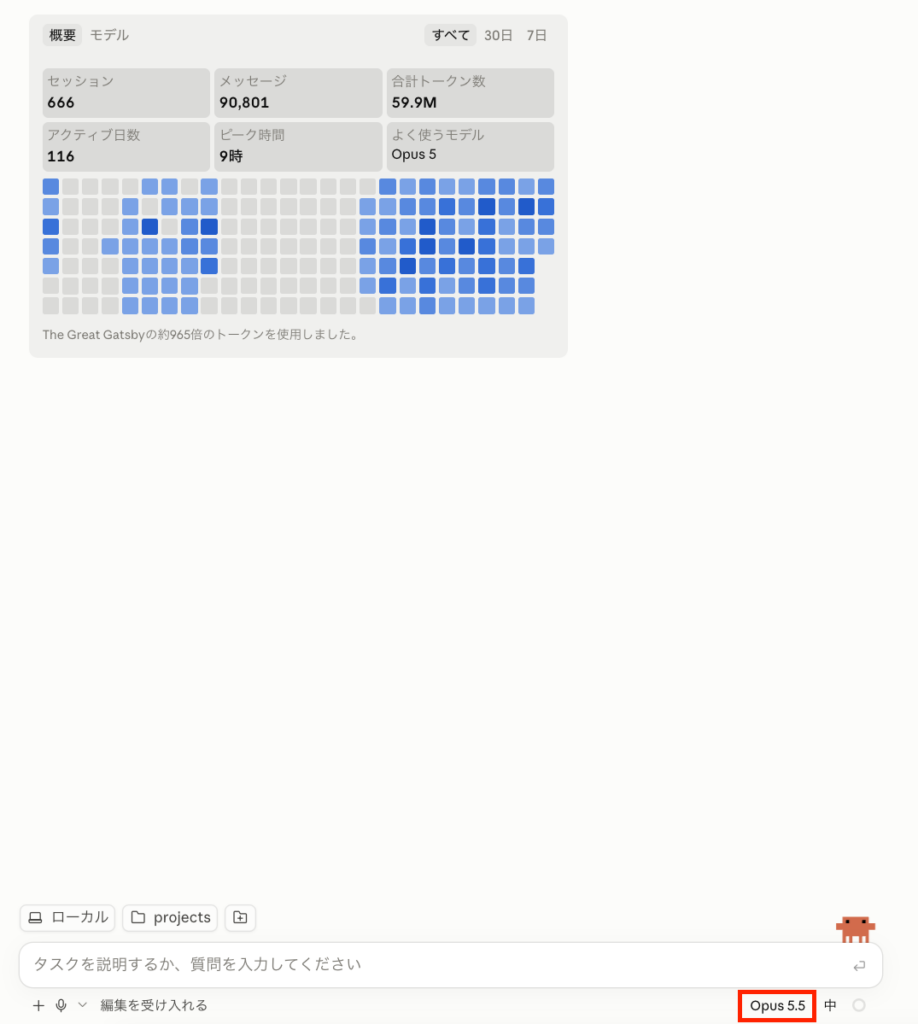
コードの監査やリサーチレポートの作成など、普段は時間のかかる作業から任せてみましょう。文章のルール(結論を先に書く、箇条書きを使わないなど)を指定すると、それに沿った形で出力してくれます。
APIで使う場合
AnthropicのClaude APIのほか、Amazon Bedrock・Claude Platform on AWS・Google Cloud・Microsoft Foundryからも利用できます。自社で使っているクラウドに合わせて選びましょう。
Claude Platformでは、モデルIDにclaude-opus-5-5を指定します。Python SDKでの最小構成は以下のとおりです。
最小サンプルコードはこちら
import anthropic
client = anthropic.Anthropic()  # 環境変数 ANTHROPIC_API_KEY を使用
message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},  # thinkingは常時オン。思考量はeffortで調整
    messages=[
        {"role": "user", "content": "このリポジトリの構成を要約して、改善点を3つ挙げてください。"}
    ],
)
print(message.content)デフォルトのeffortはmedium。一例として、難しいタスクはhigh以上、定型的なタスクはlowというように使い分けると、コストを抑えながら必要な精度を確保しやすくなります。最適な値はタスクによって異なるため、品質とコストを実測しながら調整しましょう。
Opus 5から移行する際の注意点
APIでOpus 5を使っている場合、モデルIDを書き換えるだけでは動かないケースがあります。Opus 5からの移行では、以下の4つの破壊的変更に注意が必要です。
| 変更点 | 内容 | 対応方法 |
|---|---|---|
| thinkingの無効化 | thinkingを無効化する指定や、budget_tokensを使う指定は400エラー | thinkingの指定を削除し、effortで思考量を調整 |
| 強制ツール使用 | tool_choiceのtype「any」「tool」は400エラー | 「auto」にし、strict tool useや構造化出力と組み合わせる |
| 思考ブロックの扱い | 会話途中でsystemプロンプト・tools・過去メッセージを編集すると、2026年8月31日以降に作成したアカウントでは400エラー | 会話を追記のみで進める |
| Computer Use | Claude APIとGoogle Cloudでは旧ツール「computer_20251124」が使えない | 「computer_toolset_20260801」に切り替える(Amazon Bedrockは旧ツールのままで可) |
また、effortのデフォルトがOpus 5のhighからmediumに変わった点も見落としがちです。effortを指定していないリクエストは自動的にmediumで動くため、移行後は品質とコストを測り直しておくと安心でしょう。
【業界別】Claude Opus 5.5の活用シーン
Claude Opus 5.5は、ソフトウェア開発から金融・コンサルティング・ライフサイエンスまで、高度な判断が求められる幅広い業務で力を発揮します。ここではアーリーテスターの声も交えながら、業界別の活用シーンを紹介します。
ソフトウェア開発
ソフトウェア開発の現場では、レガシーコードの移行や大規模な監査が大きな負担になりがちです。
アーリーテスターの事例では、Opus 5.5が68万行のコード移行を1日未満で終えました。エンジニアチームが数週間かける作業を短期間で任せられる可能性があります。GitHub・Lovable・Spotify・Kiroなど、開発関連の企業もアーリーテスターに名を連ねています。
Claude Codeを使った開発の活用事例について、詳しく知りたい方は下記の記事もあわせてご覧ください。
金融・投資
金融分野では、正確な数値に基づく分析とレポート作成が欠かせません。
投資会社のWalleye Capitalは、Opus 5.5が最も低い設定で自社の評価スイートをほぼ解き切ったと報告。高い設定では評価手順そのものの誤りに気づいて修正しており、これは他のどのモデルも見抜けなかった誤りでした。
合併案の財務モデル作成から経営層向けプレゼンまでを一貫して任せられるため、アナリスト業務の下準備を大幅に短縮できるでしょう。
金融業界の課題と生成AIの活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。
コンサルティング
Deloitte Consulting LLPのCIOであるCarl Bennett氏のコメントによると、同社の米国におけるコンサルティング分析で、Opus 5.5は低いthinking effortでも高い設定と同等の結果を半分の出力量で出し、品質チェックも通過。
低いeffortでの運用が増えるほど、クライアントに出せる品質の成果物を効率よく届けられるとコメントしています。分析や資料作成の量が多いコンサルティング業務と、相性の良いモデルといえるでしょう。
コンサルティング業務での生成AI活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。

ライフサイエンス・創薬研究
Opus 5.5はバイオ分野でも非常に高い能力を持ち、Opus 5を上回り、多くの領域でClaude Mythos 5.1と同等以上の性能を示しています。
Dyno Therapeuticsと共同で実施した長期的な分子予測・設計の評価では改善が確認され、専門家のレッドチームは科学的な新規性を、これまでテストした最良のモデルに匹敵すると評価しました。
医療分野での生成AI活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。
サイバーセキュリティ
Opus 5.5は非常に高いサイバー能力を持つため、通常の利用では多くのサイバーセキュリティタスクがOpus 4.8へ切り替えられます。一方で、日常的な開発の中でコードのバグを見つけて直す作業は通常どおり行えます。
2026年9月22日の発表時点では、今後数週間でCyber Verification Programが拡大され、審査を受けたサイバー防御の専門家がOpus 5.5を業務に使えるようになる予定です。脆弱性診断やセキュリティ監査の効率化に役立つのではないでしょうか。
AIで脆弱性を発見するClaude Code Securityについて、詳しく知りたい方は下記の記事もあわせてご覧ください。
Claude Opus 5.5を実際に使ってみた
ここでは、Opus 5.5と前モデルのOpus 5に同じ依頼を並べて出し、処理の速さと成果物の質を比べてみました。
検証には、Claude Codeのセッションを2つ横に並べ、それぞれOpus 5.5とOpus 5に切り替えた環境を使っています。どちらのデモも同じプロンプトを同時に送り、effortはどちらも「中」にそろえました。
題材は2つ用意しました。1つ目は既存コードのバグ調査、2つ目は1つのプロンプトからのゲーム制作です。
請求額が少ない原因を調べさせる
1つ目は、月ごとのAPI利用量から請求額を出す、架空の社内ツールを題材にしたバグ調査です。コードの中には、月末日(8月31日)の利用分がまるごと集計から漏れるバグを仕込みました。
送ったプロンプトはこちらです。
請求額が8月分だけ想定より少ないと顧客から問い合わせがありました。
このフォルダを調べて、原因を説明してください。修正はまだしなくていいです。
結果は、どちらのモデルも本当の原因にたどり着きました。 請求期間の最終日が「8月31日の0:00」になっていて、それより後の利用が集計から漏れています。どちらも、正しい請求額は15,000円で、5,400円が請求から漏れていると計算しました。
処理している様子はこちらです。
Opus 5.5のほうが約20秒早く回答を終えています。説明も結論・影響・原因ではないものの順に並んでいて、問い合わせ対応の担当者がそのまま使いやすい構成でした。
1つのプロンプトでブロック崩しを作らせる
2つ目は、公式の発表にもある「1つのプロンプトでゲームを作る」検証の再現です。
プロンプトはこちら。
HTMLファイル1枚で遊べるブロック崩しゲームを作ってください。
パーティクル演出、スコア、残機、ステージクリア画面を入れて、見た目も作り込んでください。
実際に処理している様子がこちらです。
Opus 5.5は約6分で完成させ、Opus 5は約11分かかりました。 作業時間はおよそ半分。どちらも指定した要素をすべて入れ、ブラウザで遊べるゲームに仕上げています。
印象的だったのは、Opus 5.5が「漆×螺鈿」というテーマを自分で決め、ブロック・パドル・ボールの呼び名まで世界観に合わせて作り込んだ点です。 パドルを「盆」、ボールを「珠」と呼び、アイテムを「札」として出すなど、見た目だけでなく言葉づかいまで統一されていました。
【課題別】Claude Opus 5.5が解決できること
Claude Opus 5.5が解決できる代表的な課題を紹介します。最上位モデルの導入で壁になりがちだったコスト・作業時間・確認負荷に、どうアプローチするかを見ていきましょう。
最上位クラスの性能を低コストで使える
高性能なモデルほど料金が高く、全ての業務に使うのは難しいと感じている方は多いのではないでしょうか。
Opus 5.5は多くの業務でFable 5.1と同等の性能を、一般的なワークロードではOpus 5より40%安く提供されています。effortを業務ごとに調整すれば、さらにコストを抑えることも可能です。
大規模なコード移行や監査を短期間で終えられる
数十万行規模のコード移行や監査は、エンジニアのリソースを長期間拘束します。
アーリーテスターの事例では、Opus 5.5が20万行の監査と修正を3時間未満で終えました。人間は方針決定やレビューに集中し、実作業をAIに任せる分担が現実的になっていくでしょう。
AIの作業内容を読みやすく確認できる
AIの出力が冗長だと、結果の確認だけで時間を取られてしまいます。
Opus 5.5は重要な情報を先頭に置き、指定した文章ルールにも従うため、長時間のセッションでも作業内容を追いやすくなりました。確認しやすさは、AIに任せる範囲を広げるうえでの安心材料にもなります。
| 課題 | 解決できること | 留意点 |
|---|---|---|
| 運用コスト | Fable 5.1級の性能を、一般的なワークロードでOpus 5比40%減のコストで利用 | 高いeffortではコストが増えるため使い分けが必要 |
| 大規模開発 | コード移行・監査・リファクタリングを短時間で実行 | 最終的なレビューと承認は人間が担う |
| 成果物の確認 | 要点が先にある読みやすい出力で確認負荷を軽減 | 文章ルールは明示的に指定すると効果的 |
| セキュリティ業務 | 日常的なバグ修正は通常どおり可能 | 高度なサイバーセキュリティタスクは別モデルへ切り替わる |
生成AIを使ったリサーチ業務の効率化について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Claude Opus 5.5の活用事例
ここではClaude Opus 5.5の活用事例をXでリサーチして紹介していきます。どのように使っていこうか悩んでいる方は参考にしてください。
壇ノ浦の戦いを3Dで再現
こちらの投稿では、Opus 5.5に源平合戦の「壇ノ浦の戦い」を、テレビ特番のような3D映像で再現させています。
歴史の一場面を1つのプロンプトから立体的な映像に仕上げていて、教育や歴史解説のコンテンツ制作にも使えそうだと感じさせる事例です。使ったプロンプトは、投稿へのリプライで公開されています。
他社の最新モデルと同じお題で比較
こちらの投稿では、Opus 5.5・Fable 5.1・GPT-6 Astra・Gemini 3.8 Flashの4モデルに、ゲーム作り・日本語の要約・財務レポートという同じ3つのお題を解かせています。
4モデルとも品質は全問合格でしたが、ゲームの作り込みはOpus 5.5が一番で、同じ自動操作で1面をクリアできたのもOpus 5.5だけでした。一方で、effortをxhighにすると考えすぎて完成まで約30分かかったそうで、既定の設定のまま使うのが一番おトクだと結論づけています。
Higgsfieldを操作させてローンチ動画を制作
こちらの投稿では、Opus 5.5にHiggsfieldとAfter Effectsを操作させて、ローンチ動画を作っています。
制作費はHiggsfieldの月額Proプラン(19ドル)の約5%、金額にして150円ほど。
土台がAfter Effectsのデータなので、フォントや色の変更、不要な部分の削除といった手直しも自由にできるそうです。映像制作の現場でも、手作業のキーフレーム打ちをAIに任せる流れが進んでいくのではないでしょうか。
Claude Opus 5.5など生成AIツールのご相談はWEELへ
Claude Opus 5.5を活用することで、コード移行やリサーチ、財務分析といった時間のかかる業務を、最上位クラスの性能と抑えたコストで任せられます。一方で、effortの使い分けやセーフガードの適用範囲は設計次第で効果が大きく変わるため、小規模なタスクから検証を始めて段階的に導入範囲を広げていくことも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
Claude Opus 5.5のよくある質問