組み込みAI(生成AI)の活用事例!スマホ・車載・産業機器の最新動向と検証結果を解説
- 組み込みAIは、AIモデルをデバイス側で実行し、クラウド依存を抑えて推論する仕組み
- 生成AIでは、スマホ・PC・車載・工場などで小型言語モデル(SLM)や専用チップを活用する事例が拡大
- 導入ではモデルサイズ・ハードウェア制約・開発体制を小規模な概念実証(PoC)で確かめることが重要
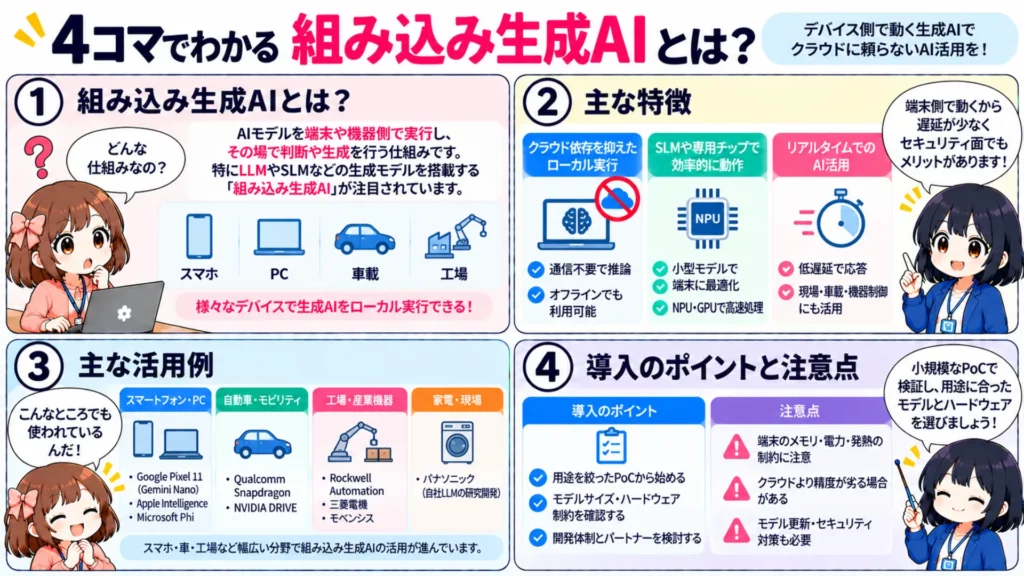
組み込みAIは、AIモデルを端末や機器側に搭載し、入力に対する判断や生成をその場で行う仕組みです。この処理を「推論」と呼びます。本記事では、従来の物体検知・異常検知ではなく、生成AIの大規模言語モデル(LLM)や小型言語モデル(SLM)を端末(デバイス)上で動かす「組み込み生成AI」に焦点を当てます。
スマートフォン・PC・車載・工場などの実例に加え、軽量LLMをWindows PC上でローカル実行した検証結果も紹介します。自社製品への搭載で押さえる技術要素・メリット・制約・導入の進め方までが本記事の範囲です。具体的なPoCを考える際の判断材料としてお役立てください。
\生成AIを活用して業務プロセスを自動化/
組み込みAI(組み込み生成AI)とは
組み込みAIとは、製品や機器に搭載したCPUやGPUなどの計算資源で、入力に対する判断や生成(AI推論)を実行する構成です。なかでも本記事が扱う組み込み生成AIは、LLMやSLMなどの生成モデルをデバイス側で動かす領域を指します。
画像の物体検知や設備の異常検知といった従来型AIも組み込みAIに含まれますが、生成AIとはモデルの役割や必要なメモリ、出力形式が異なります。両者を混同せず、用途ごとに必要なハードウェアとモデルを考えることが重要です。
組み込みAIの定義と仕組み
組み込みAIでは、センサーや入力データをデバイス側で受け取り、搭載したAIモデルがその場で推論します。推論のたびにクラウドへデータを送らなくても処理できる構成を選べる点が特徴です。
生成AIの場合は、比較的小さなLLM・SLMを端末に配置し、テキスト生成や要約、対話などを実行します。一方、従来型では画像分類・音声認識・異常検知などの専用モデルが中心です。なお、モデル更新やログ送信などで外部通信を使う構成もあるため、「組み込みAI=常時完全オフライン」とは限りません。
エッジAI・クラウドAIとの違い
| 比較項目 | 組み込みAI | エッジAI | クラウドAI |
|---|---|---|---|
| 主な処理場所 | 製品・端末の内部 | 端末、ゲートウェイ、近隣エッジサーバー | 遠隔のデータセンター |
| 推論時の通信 | 不要にできる | ローカル通信のみで完結できる場合がある | 原則としてネットワーク接続が必要 |
| 遅延要因 | 端末の計算性能 | 端末性能とローカルネットワーク | ネットワーク往復とクラウド側の処理 |
| モデル規模 | メモリ・電力制約が大きい | 端末からエッジサーバーまで幅がある | 大規模モデルを利用しやすい |
| データ管理 | 端末内に閉じる設計が可能 | 現場・拠点内に閉じる設計が可能 | 送信先・保存条件の確認が必要 |
「エッジAI」は広い概念で、組み込みAIを含めて使われる場合もあります。本記事では比較しやすいよう、製品内部で完結する構成を組み込みAI、端末近くのゲートウェイ(中継機)やサーバーまで含む構成をエッジAIとして整理しています。
【分野別】組み込み生成AIの活用事例
| 分野 | 製品・企業 | 特徴 |
|---|---|---|
| スマートフォン | Google Pixel 11・Gemini Nano | Tensor G6上でオンデバイス生成AIを実行 |
| スマートフォン・Mac | Apple Intelligence・AFM 3 | Apple Foundation Modelsのオンデバイスモデルを提供 |
| Windows PC | Microsoft Phi Silica | NPU(AI推論用の専用演算回路)や対応GPUでローカル言語生成 |
| 自動車 | Qualcomm Snapdragon Digital Chassis | 車載の異種計算基盤でオンエッジAIを実行 |
| 自動車 | NVIDIA DRIVE Thor | 先進運転支援(ADAS)と車内AIを集中型コンピューターへ統合 |
| 工場 | Rockwell Automation・Nemotron Nano | 産業エッジ向け生成AIアシスタントを開発 |
| 工場 | 三菱電機 | 製造業特化の言語モデルをエッジデバイスで動作 |
| ロボット・産業機器 | モベンシス・Jetson Thor | AI処理とリアルタイム制御を1台に統合 |
| 家電・現場 | パナソニック | 自社特化LLMと製品・現場へのAI実装を研究開発 |
組み込み生成AIは、単に「クラウド型生成AIの縮小版を機器へ載せる」技術ではありません。端末内で必要な判断や生成を行い、クラウドとの役割分担を設計することが実装のポイントです。以下では、生成モデルの搭載例に加え、ローカルAIを支える車載・産業向け計算基盤の事例も取り上げ、2026年9月時点の動向を概観します。
パーソナルデバイス(スマートフォン・PC)
Google Pixel 11は、2026年8月に発表されたTensor G6上で最新のGemini Nanoを動かし、オンデバイスのAI処理を前世代比で最大3.5倍高速化したとしています。開発者向けには、Gemma 4の発表にあわせてAICore Developer Previewが公開され、Gemini Nano 4との前方互換を見据えた試作ができます。
Appleは2026年6月、オンデバイス向けのAFM 3 Core/AFM 3 Core Advancedを発表しました。MicrosoftのPhi SilicaはCopilot+ PCのNPUなどで動作しますが、後継のAion Instructへの置き換えが予定されています。2026年11月にWindows Insider向け、2027年1月に一般向けデバイスへ展開される計画のため、採用時は移行時期を確認しましょう。
自動車・モビリティ
QualcommのSnapdragon Digital Chassisは、CPU・GPU・NPU(AI推論向けの専用演算回路)を組み合わせる車載基盤として機能します。2026年1月のCES 2026でも、オンエッジ推論を活用するSnapdragon Chassis Agentsを打ち出しており、車内AIをクラウドだけに依存させない方向性を示す事例です。
NVIDIA DRIVE Thorは、先進運転支援システム(ADAS)と車載インフォテインメント(車内の情報・娯楽機能)を単一システムで実行する集中型車載コンピューターとして設計されています。複数のAI処理を共通基盤に集約する例として、車載AIの設計を考えるうえで参考になります。
産業機器・工場(FA:工場自動化)
Rockwell Automationは2025年11月、NVIDIA Nemotron Nano 9B v2をFactoryTalk Design Studioなどへ組み込む産業エッジ向け生成AIを発表しました。三菱電機は2025年6月、エッジデバイスで動く製造業特化の言語モデルを発表しました。自社の業務データと独自のデータ拡張(学習用データを増やす処理)により、用途に応じた回答を生成できる点が特徴です。
モベンシスは2026年、NVIDIA Jetson Thor上でAI処理とロボット制御を統合する研究を発表しました。LLM搭載例ではなく、オンデバイスAIの判断を実機制御へつなぐ基盤側の事例です。
家電
パナソニックグループは、社内データを追加事前学習した「Panasonic-LLM-100b」を開発しています。公開資料では製品・サービスへの適用も想定されていますが、特定の一般家電に搭載した製品名までは確認できません。そのため、家電分野は量産済みの搭載事例ではなく、研究開発・適用構想として整理します。
製造業での生成AI活用事例は、次の記事にまとめました。
組み込み生成AIを支える技術要素
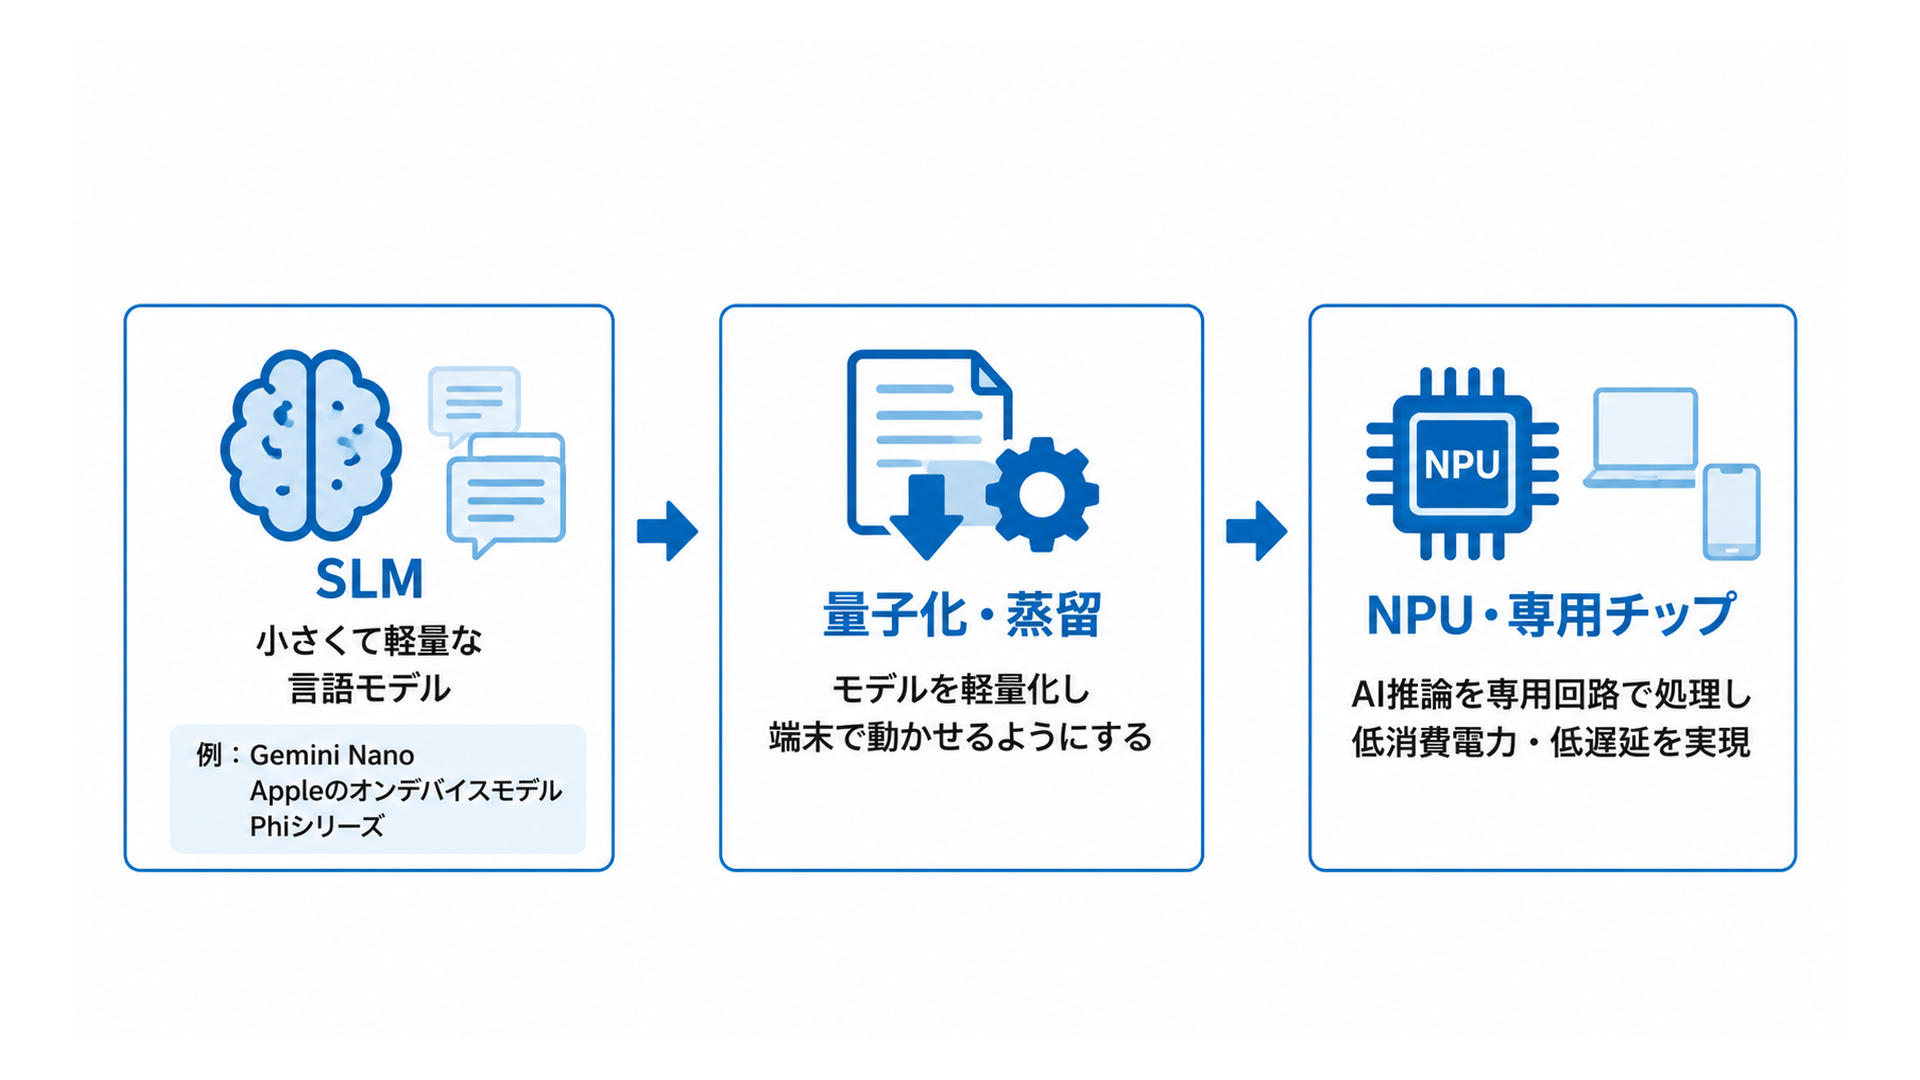
組み込み生成AIでは、大規模モデルをそのまま載せるのではなく、モデル規模・数値表現・実行ハードウェアを一体で最適化します。前章のスマホ・PC・車載・工場の事例でも、SLM・NPU・量子化などが端末側の推論を成立させる重要な要素です。
SLM(小型言語モデル)
SLMは、Small Language Modelの略称です。より大きなLLMと比べてモデル規模や計算量を抑え、限られたメモリや電力で動かしやすい設計が重視されます。厳密なパラメータ数の境界はありません。
具体例として、Gemini Nano、Apple Foundation ModelsのAFM 3 Core、Microsoft Phi Silicaなどがあります。端末で必要なタスクを先に定め、それに合うモデルを選びます。
NPU・専用チップによる高速化
NPU(Neural Processing Unit)は、ニューラルネットワークの推論処理に特化した演算回路です。CPU(汎用処理装置)やGPU(画像・並列計算に強い処理装置)だけで処理するより、対応モデルでは消費電力を抑えつつAI推論を高速化しやすくなります。
ただし、NPUを搭載しただけで速くなるわけではありません。モデル形式、演算精度、ランタイム(モデルを動かす実行基盤)の対応がそろって初めて性能を引き出せます。PoCでは実機で測定しましょう。
モデル軽量化技術(量子化・蒸留)
量子化は、モデルが使う数値の精度を下げてメモリ使用量や計算量を削減する手法です。例えば16bitから8bit・4bitへ表現を小さくすることで、限られたメモリへモデルを載せやすくする効果が期待できます。
蒸留は、大きなモデル(教師モデル)の出力や知識を使って、小さなモデルを学習させる方法です。量子化と同じく軽量化に役立ちますが、精度や応答品質とのトレードオフがあるため、対象タスクで評価します。
【予備検証】Windows PCで軽量LLMをローカル実行してみた
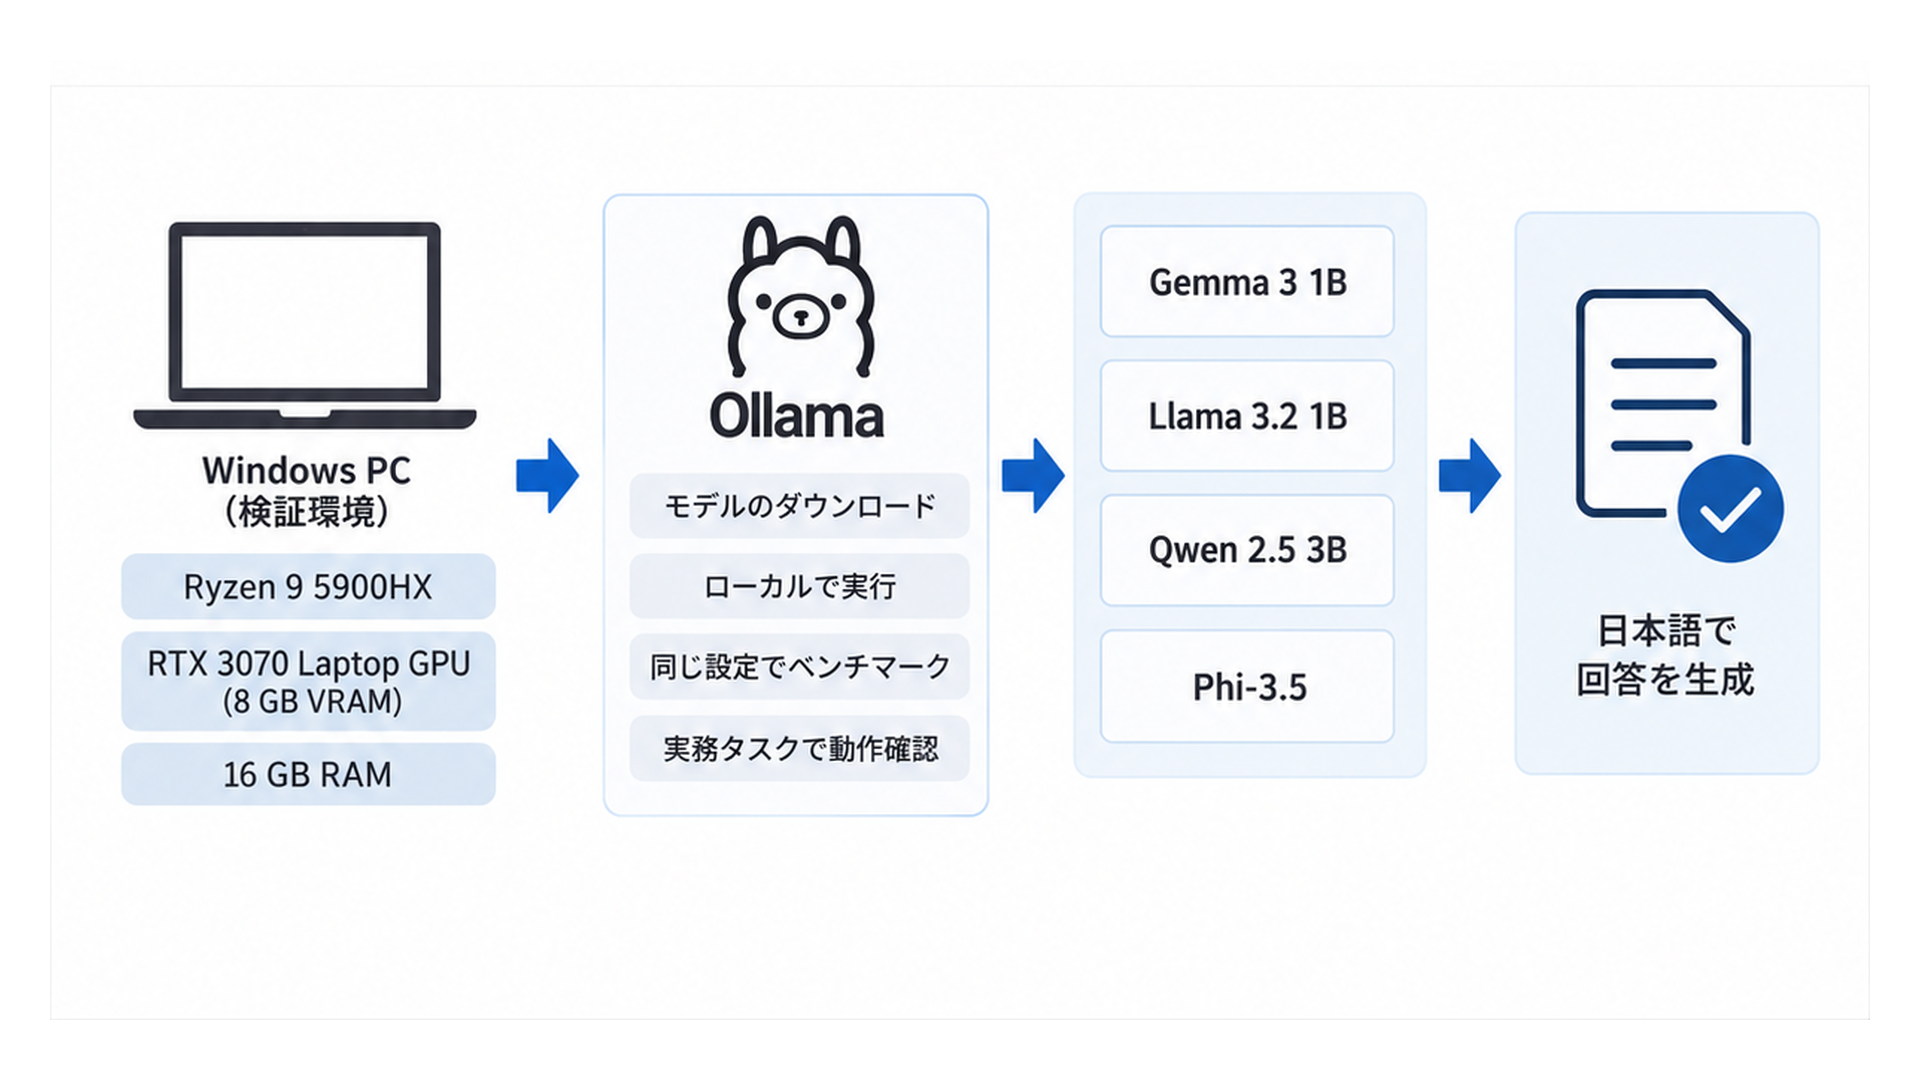
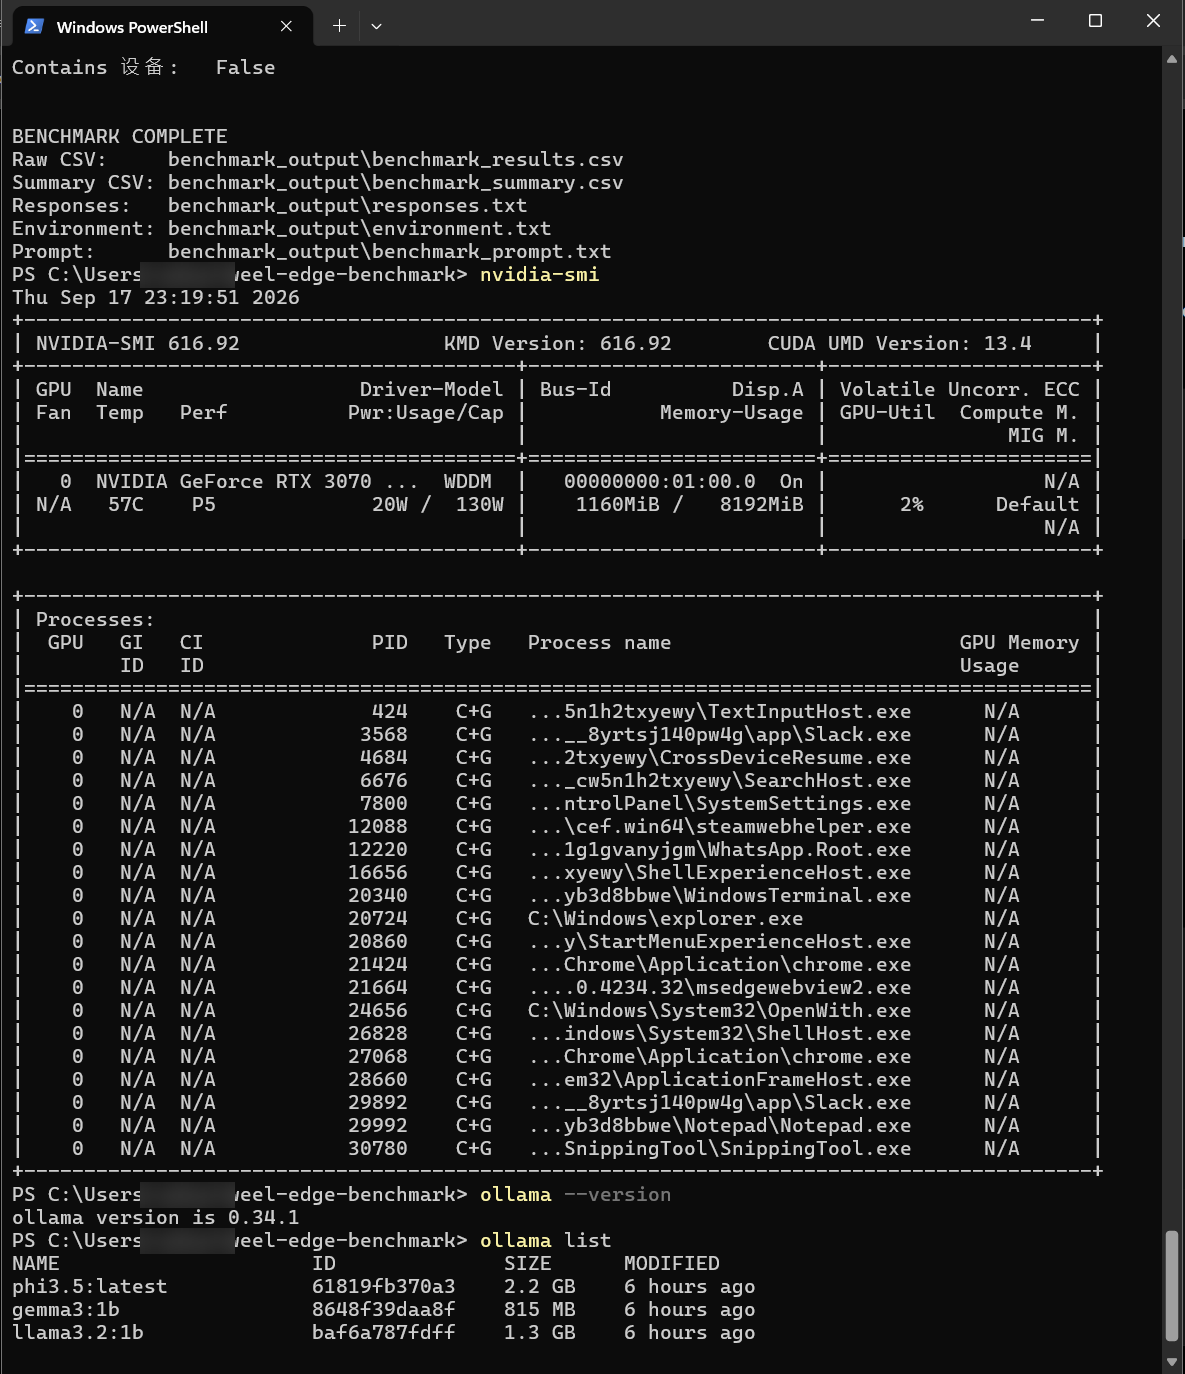
本記事では、組み込み生成AIの性能を具体化するため、WindowsノートPC上のOllamaで4種類の軽量LLMをローカル実行しました。小型マイコンやRaspberry Piそのものではなく、製品に組み込む前のモデル比較・PoCとして行った予備検証です。
同じプロンプト(AIへの指示文)と生成条件で速度と回答内容を比較し、モデルサイズだけでは見えない実装上の違いを確認しました。数値は2026年9月17日に実測した結果であり、別のハードウェアへそのまま適用できるとは限りません。
検証環境・使用モデル
| 項目 | 検証条件 |
|---|---|
| OS | Windows 11 Pro |
| CPU | AMD Ryzen 9 5900HX(8コア16スレッド) |
| メインメモリ(RAM) | 16GB |
| GPU | NVIDIA GeForce RTX 3070 Laptop GPU(GPU専用メモリ〈VRAM〉8GB) |
| 推論ランタイム | Ollama 0.34.1 |
| コンテキスト長 | 4,096 tokens |
| 生成条件 | temperature 0(出力のばらつきを抑える設定)、最大出力128 tokens |
| モデル | Gemma 3 1B・Llama 3.2 1B・Qwen 2.5 3B・Phi-3.5 |
Windows 11 ProにOllama 0.34.1を導入して4種類のモデルを取得し、Pythonの計測スクリプトからOllamaのローカルAPI(PC内の呼び出し口)へ接続しました。条件は、日本語プロンプト、コンテキスト長(1回に扱える入力・出力の長さ)4,096トークン(文章を分割した処理単位)、temperature(生成の揺らぎを調整する値)0、最大128トークンです。
各モデルは、コールド実行(読み込みを含む)を1回、ウォーム実行を3回行い、計16回を測定しました。コールドは初回起動、ウォームは読み込み後です。量子化形式が異なるため、速度差をパラメータ数だけで説明しないよう注意します。
検証手順と結果(推論速度・応答品質の実測)
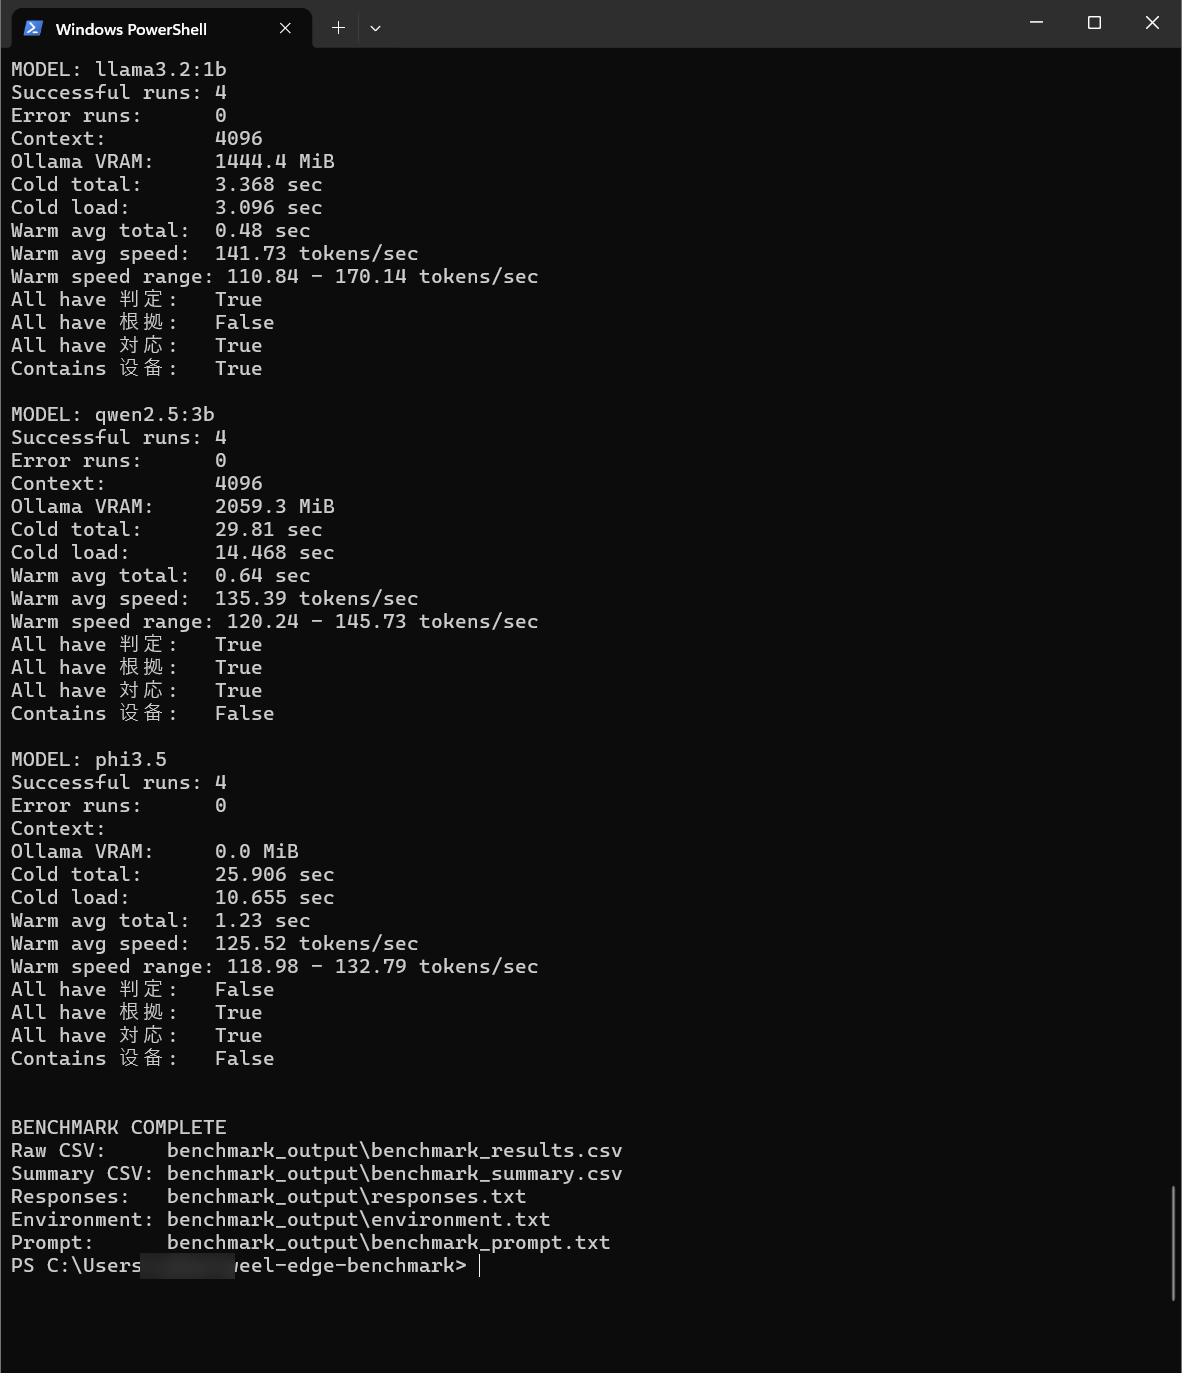
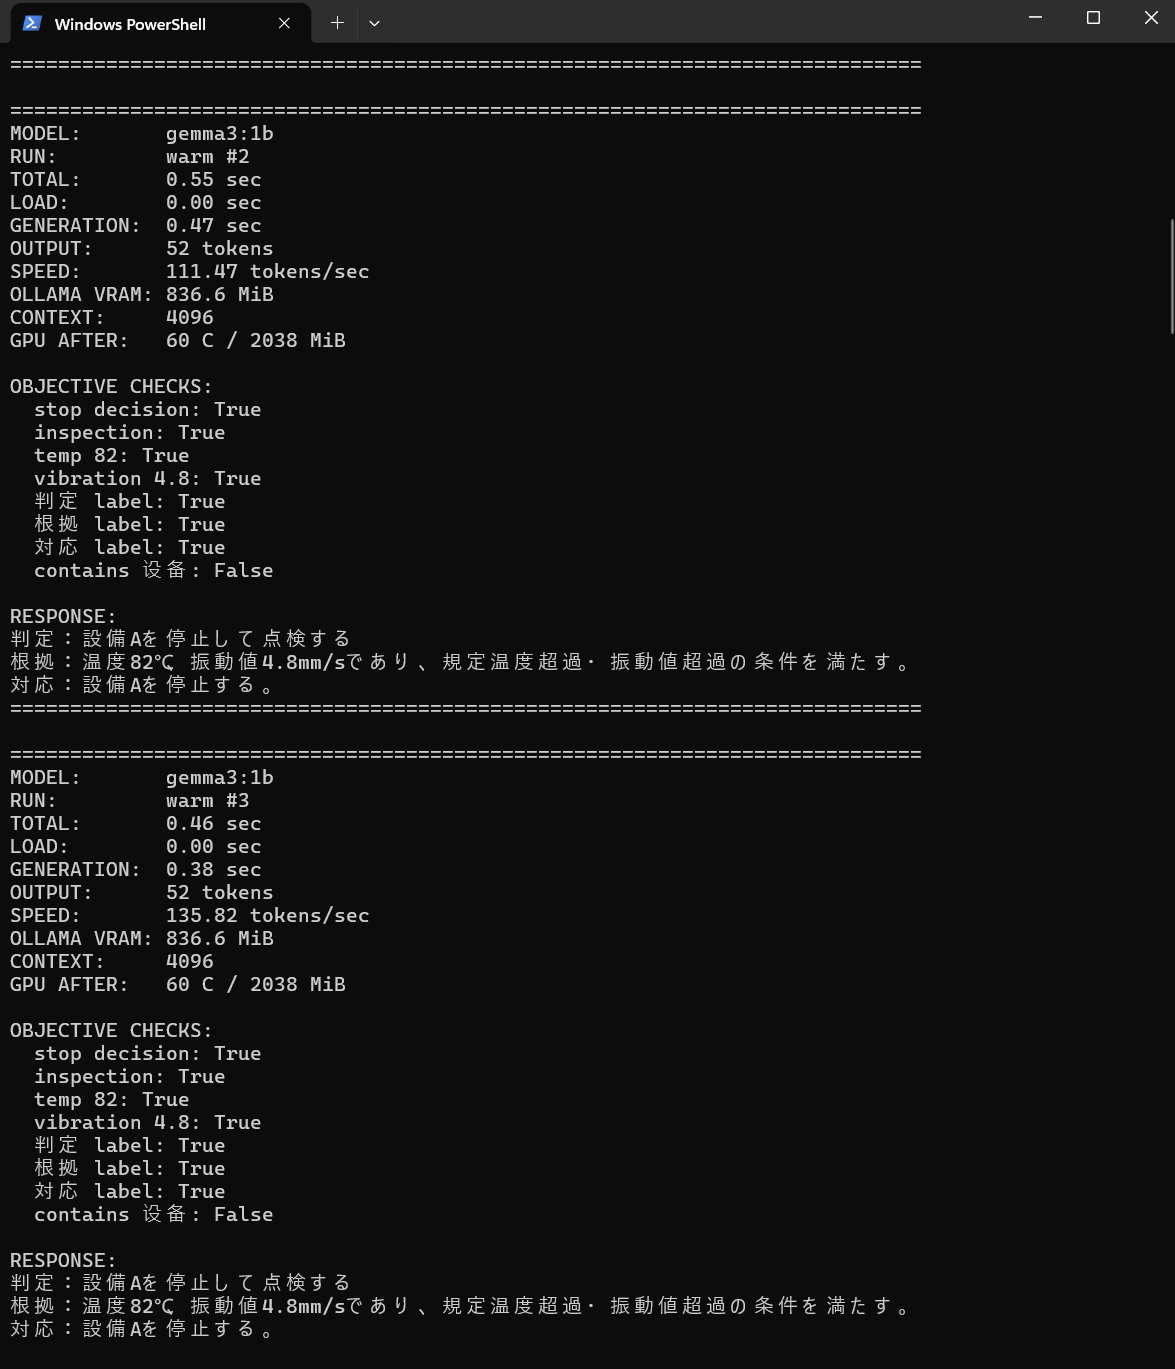
| モデル | コールド総時間 | ウォーム平均総時間 | ウォーム平均生成速度 | 回答の確認結果 |
|---|---|---|---|---|
| Gemma 3 1B | 3.604秒 | 0.50秒 | 122.12 tokens/sec | 判定・根拠・対応を全実行で出力 |
| Llama 3.2 1B | 3.368秒 | 0.48秒 | 141.73 tokens/sec | 停止判断は正しいが「根拠」ラベル欠落、「设备」が混在 |
| Qwen 2.5 3B | 29.810秒 | 0.64秒 | 135.39 tokens/sec | 判定・根拠・対応を出力。閾値の説明にやや曖昧さあり |
| Phi-3.5 | 25.906秒 | 1.23秒 | 125.52 tokens/sec | 「判定」ラベル欠落。ウォーム3回は128 tokens上限で文末が途切れた |
温度82℃・振動値4.8mm/sの架空データで、「温度80℃以上または振動値4.5mm/s以上なら停止」という条件への追従を比較した結果です。Llama 3.2 1Bは141.73 tokens/sec(1秒あたりの生成トークン数)で最速でしたが、「根拠」欠落と「设备」の混在がありました。Gemma 3 1Bは122.12 tokens/secで、3項目を毎回出力しました。Qwen 2.5 3Bは135.39 tokens/secでした。Phi-3.5は125.52 tokens/secで「判定」欄が欠け、128 tokens上限で文末が途切れました。速度以外に、起動時間・指示追従・出力上限を評価します。
検証から見えた導入のポイント
今回の結果では、モデルが大きいほど必ず遅い、または回答品質が高いという単純な関係にはなりませんでした。用途に必要な回答形式と速度を決め、同じ評価データで比較することがモデル選定の基本です。
また、検証準備ではPhi-3.5が131,072トークンのコンテキスト長で起動し、KVキャッシュ(生成中の計算結果を保持するメモリ領域)用の大きなメモリ確保に失敗しました。4,096トークンへ統一すると実行できたことから、モデル本体だけでなくコンテキスト長もメモリ設計に直結します。製品化では端末のRAM・VRAM、発熱、電力、応答上限を含めてPoCで確認しましょう。
組み込み生成AI導入のメリット
クラウド型の生成AIと比べると、組み込み生成AIは推論処理を端末側へ移せるため、通信経路やデータの置き場所を自社で設計しやすくなります。リアルタイム性・オフライン動作・データ送信範囲が重要な製品ほど検討価値のある構成です。
一方で、端末性能が低ければクラウドより遅くなる場合もあります。メリットは「ローカルなら必ず優れる」という意味ではなく、用途に合わせてクラウドとの役割を分けるための選択肢として捉えましょう。
リアルタイム処理・低遅延
組み込み生成AIでは、推論のたびに遠隔クラウドと通信する必要がないため、ネットワーク往復による待ち時間を取り除けます。操作支援や車載・産業機器など、応答時間が体験や制御に影響する用途では大きな利点です。
ただし、ローカルモデルの計算が遅ければ総応答時間は短くなりません。必要なレイテンシ(入力から返答までの遅れ)の目標値を定め、対象ハードウェア上で測定することが重要です。
通信コスト削減・オフライン対応
端末内で生成まで完結すれば、クラウドAPIへ毎回データを送る必要がなく、通信量やAPI従量課金を抑えられる構成を選べます。ネットワークが不安定な工場・車両・屋外機器でも機能を継続しやすい点も利点です。
ただしモデルの取得・更新や監視、ライセンス確認などで通信が必要になる場合があります。完全オフラインが要件なら、推論以外の通信経路まで洗い出してください。
セキュリティ・プライバシー面の利点
入力データを端末外へ送らずに推論できれば、機密情報や個人データが外部ネットワークを通る範囲を減らせます。「どのデータを外へ出さないか」を設計しやすいことが組み込み生成AIの利点です。
一方、端末内にデータを置く以上、端末盗難・アクセス権・ログ・モデルファイルの管理などの対策は必要です。「クラウドを使わないから安全」と決めつけず、想定する攻撃と影響を整理した脅威モデルを、製品全体で確認しましょう。
組み込み生成AI導入の課題と人材不足の実態
組み込み生成AIは、生成AIだけでなくハードウェア・組み込みソフトウェア・電力・熱設計・セキュリティまで関係します。クラウドAPI(外部サービスの機能を呼び出す仕組み)を使うだけの開発より、検討範囲が広くなりやすい点が導入のハードルです。
性能だけを追うと製品コストや消費電力が増え、軽量化だけを優先すると回答品質を落とす可能性があります。PoCで用途を絞り、必要な性能と端末制約の境界を確認することが欠かせません。
開発リソース・エンジニア不足の課題
IPA「DX動向2025」の2024年度調査(日本)では、AIを活用したソフトウェアやシステムを実装できるAI開発者について、53.7%の企業が「不足している」と回答しています。
組み込み生成AIでは、モデル選定・量子化・推論ランタイム(モデルを動かす実行基盤)だけでなく、ドライバー・メモリ・NPU・GPU・リアルタイム制御も扱います。生成AIと組み込み開発を横断する体制を作りにくいことが、プロジェクト開始時の課題です。
全てを内製する必要はありません。自社の製品知識と、外部パートナーのAI・ハードウェア最適化の知見を分担し、どこまでを社内で保有するか決めると進めやすくなります。
モデル選定・ハードウェア制約
デバイスには、RAM(実行中のデータを置くメモリ)・VRAM(GPU用メモリ)・ストレージ・消費電力・発熱の上限があります。モデル規模・量子化レベル・コンテキスト長・出力長を組み合わせて設計します。モデルファイルを保存できても、実用速度で推論できるとは限りません。
今回の検証でも、Phi-3.5はコンテキスト長を4,096へ抑えることで起動できました。量産を想定する場合は、平均速度だけでなく最悪時の応答時間、連続動作時の温度、メモリ余裕まで確認してください。
生成AI開発全体の課題は、次の記事にまとめました。

自社製品・サービスへ生成AIを組み込む際の進め方
| フェーズ | 主な検討内容 | 確認するポイント |
|---|---|---|
| 要件整理 | 利用場面、入力データ、必要な応答を定義 | オフライン要件、目標遅延、データ機密性 |
| PoC | 候補モデルを実機で比較 | 速度、回答品質、メモリ、発熱、消費電力 |
| 本開発 | 製品UI(画面・操作部分)、制御系、更新機能へ統合 | 安全設計、障害時動作、モデル更新方法 |
| 運用 | ログ、評価、更新を継続 | 品質劣化、脆弱性、ライセンス、端末管理 |
組み込み生成AIでは、最初から量産構成を決めるより、要件整理→小規模PoC→本開発→運用の順で技術リスクを減らす進め方が現実的です。WEELにも、自社サービスへ生成AIを組み込みたいものの、ノウハウを持つ開発会社を探しているという趣旨の相談が寄せられています。
パートナー選定で止まらないためにも、最初の相談時点で用途・対象ハードウェア・扱うデータ・求める応答速度を言語化しておくと、相談の焦点を合わせやすくなります。
開発パートナーに相談する際の確認ポイント
相談先を選ぶときは、生成AIの開発実績だけでなく、対象ハードウェア上での推論最適化まで対応できるかを確認しましょう。モデルの量子化、NPU・GPU利用、C/C++など既存組み込みソフトとの連携、性能測定まで扱えるかが判断材料です。
また、PoCだけを納品して終わるのか、本開発・モデル更新・障害対応まで支援できるのかも確認します。量産製品では保守期間が長くなるため、モデルやランタイムの更新方針を事前に話しておくと安心です。
PoCから本開発までの流れ
PoCでは、代表的な入力データと利用場面を絞り、複数モデルを同じ条件で比較します。速度・品質・メモリ・発熱が目標を満たしたら、本開発で製品UI・センサー・制御ロジック・更新機能へ統合していきます。
運用開始後もモデル更新や新しい入力への評価が必要です。PoCの測定条件と評価データを残しておけば、モデル更新時に同じ基準で再評価しやすくなります。
開発パートナーの選び方や生成AI導入支援は、次の記事で確認できます。
生成AIなどのご相談はWEELへ
組み込み生成AIの導入では、モデル選定や軽量化、実機での性能検証など専門的な判断が欠かせません。WEELでは、要件整理からPoC、本開発まで一貫して支援しています。まずは無料相談で、自社製品への組み込み可能性をお気軽にご相談ください。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。
組み込みAIに関するよくある質問
組み込み生成AIの開発にはどのくらいの期間がかかりますか?
PoCなら1〜3ヶ月程度、本番運用を前提としたAIシステムでは4ヶ月〜1年以上が一つの目安ですが、組み込み生成AIではハードウェア調達・モデル軽量化・実機試験が加わるため前後します。既存製品へ組み込む場合は、電力・熱・安全性の評価期間も見込んでください。
開発期間の一般的な目安は、次のWEEL記事でも確認できます。

組み込み生成AI開発に使われるプログラミング言語や開発環境はありますか?
はい。構成例として、モデル検証にPython、製品側の実装にC・C++を組み合わせる方法があります。推論環境にはOllama・llama.cpp・ONNX Runtime・TensorRTなどが候補になり得ます。NPU・GPU・OSによって対応状況が異なるため、対象ハードウェアを決めてからモデル形式とSDKを選びましょう。
組み込み生成AI開発を外部委託する場合、費用相場はどのくらいですか?
WEELの2026年の受託開発FAQでは、PoCは50〜250万円、本格的な生成AIシステム開発は300〜800万円が目安として示されています。ただし組み込み生成AIでは、専用ハードウェア、モデル最適化、実機評価の工数が追加される場合があります。量産条件まで含めた個別見積もりで判断してください。
費用の考え方は、次のページでも確認できます。
組み込み生成AIの精度はクラウド型の生成AIに劣りますか?
一律には決まりません。小型モデルは巨大なクラウドモデルより複雑な推論や幅広い知識で差が出る場合がありますが、用途を限定し、モデル選定や追加学習、プロンプト設計を合わせることで実用性を高められます。重要なのは一般的なベンチマーク順位ではなく、自社製品の実データと評価基準で必要な品質を満たすかです。