Sarashinaとは?SB Intuitionsの国産LLMの特徴・料金・使い方を徹底解説
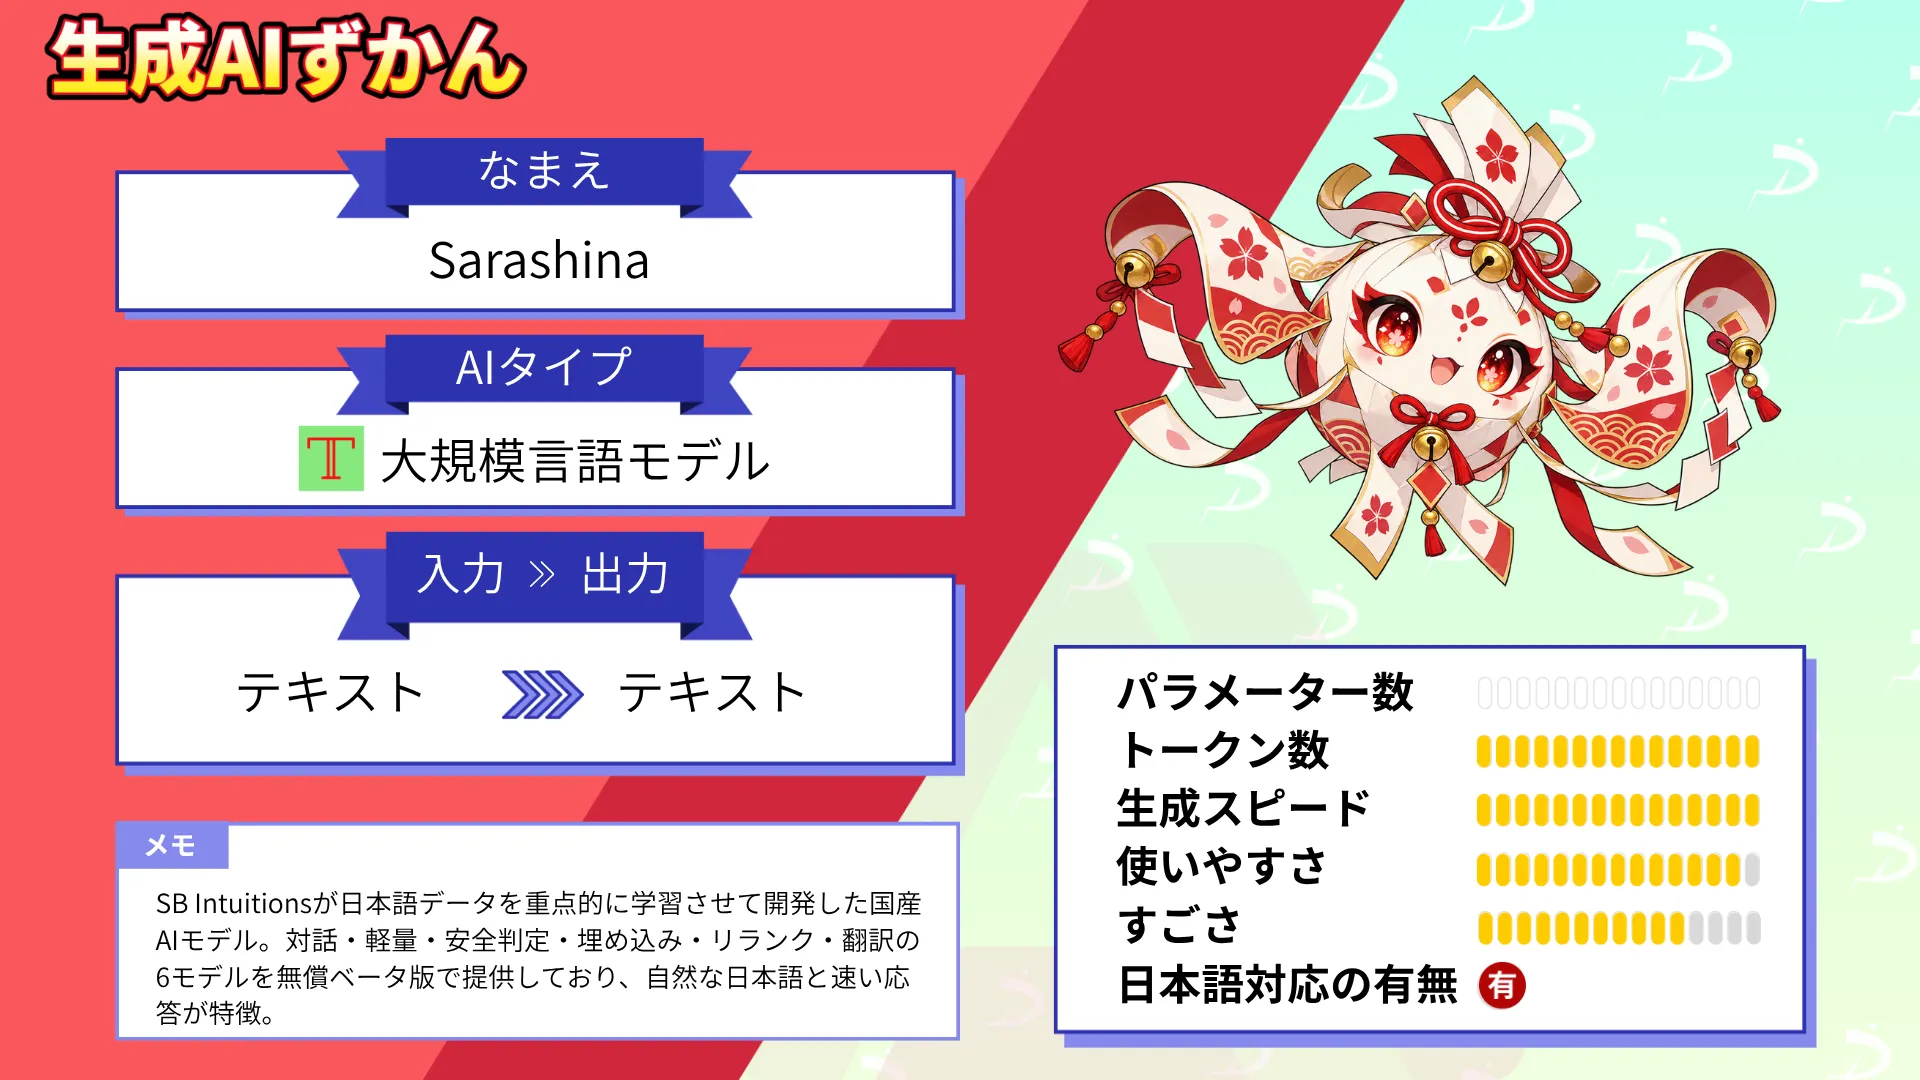
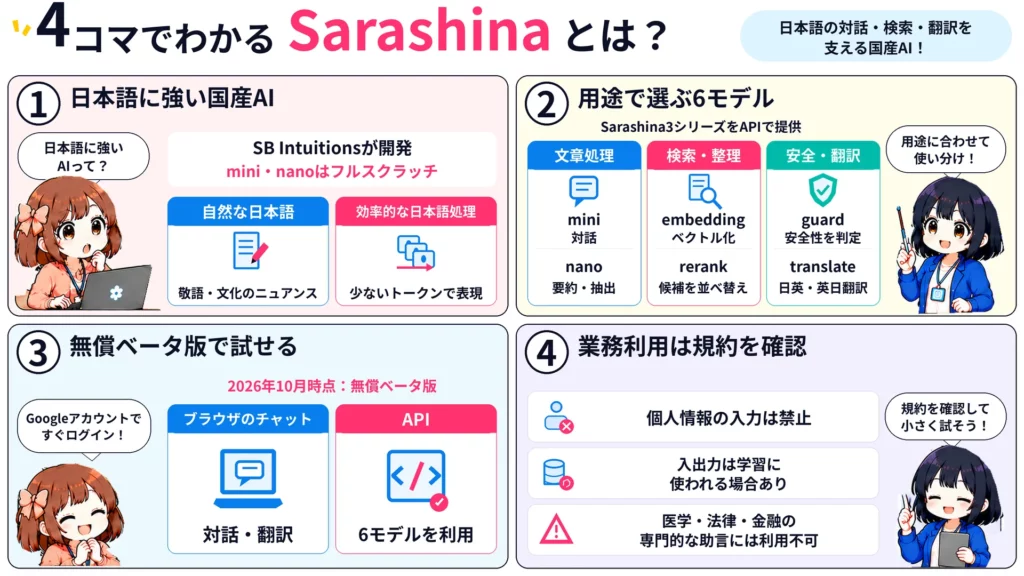
- SarashinaはSB Intuitionsが開発する日本語に強い国産AIモデルで、主力のmini・nanoはフルスクラッチ開発
- Sarashina3シリーズとして対話・軽量・安全判定・埋め込み・リランク・翻訳の6モデルをAPIで提供
- 現在は無償ベータ版で、6モデルのAPIと対話・翻訳のチャットを試せるが、利用規約の制限には注意
2026年10月、SB Intuitionsから国産の大規模言語モデル「Sarashina」を無料で試せる新サービスが登場しました。
今回提供が始まった「Sarashinaサービス」は、日本語データを重点的に学習させた国産AIモデル「Sarashina」を無料で体験できるサービスです。用途の異なるSarashina3シリーズ6モデルのAPIと、対話・翻訳を試せるブラウザのチャットが無償ベータ版として公開されました。
Sarashinaは、日本語のデータセットで重点的にトレーニングし、トークナイザも日本語向けに設計。公式が示した例文では、同じ日本語の文章を比較対象の米国モデルの半分のトークン数で表現できています。
一方で、新しい国産AIが登場するたびに、「海外の主要モデルと比べて何が違うのか」「6つのモデルをどう使い分ければよいのか」「無料でどこまで使えるのか」といった疑問を感じる方も多いのではないでしょうか。
そこで本記事では、Sarashinaの概要や仕組み、特徴を整理しながら、料金やAPIの使い方、業界別の活用シーンについて詳しく解説します。
最後までお読みいただくことで、Sarashinaがどのように設計され、どのような場面で力を発揮するのかが理解できるはずです。ぜひ最後までお読みください!
\生成AIを活用して業務プロセスを自動化/
Sarashinaとは
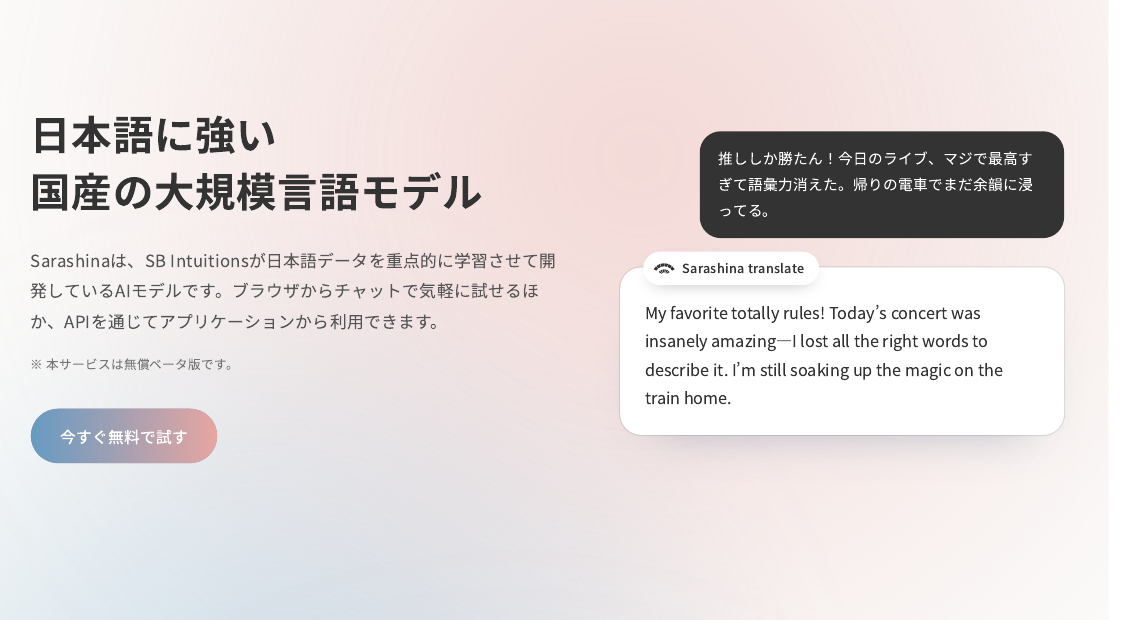
Sarashinaは、ソフトバンクグループのSB Intuitionsが開発している日本語に強い国産の大規模言語モデル(LLM)です。
2026年10月、Sarashina3シリーズを体験できる「Sarashinaサービス」の無償ベータ版が公開されました。6モデルはAPIを通じて自社のアプリケーションから呼び出せるほか、ブラウザのチャットでは対話と翻訳が可能。
Sarashinaシリーズ自体は以前から開発されており、2025年11月からはSarashina2 miniが商用APIとして提供されてきました。
Sarashinaが日本語にこだわる理由として、公式は次の3点を挙げています。
| 観点 | 汎用モデルで課題になりやすい点 | Sarashinaのアプローチ |
|---|---|---|
| 言語特性 | 漢字・ひらがな・カタカナが混在する表記や敬語のニュアンスを捉えにくい | 日本語特有の表記や敬語のニュアンスを学習し、自然に反映 |
| 文化・文脈 | 「忖度」「空気を読む」といった暗黙の了解が伝わりにくい | 文化的背景を含む日本語のニュアンスをより正確に反映 |
| 規制・倫理 | 法規制や倫理観は国ごとに異なる | 国内で開発し、日本の法律や社会規範を考慮した設計を目指す |
現在は、用途ごとに役割を分けたSarashina3シリーズの6モデルがAPIで提供されています。フルスクラッチで開発されたのは主力のmini・nanoで、guard・embedding・rerank・translateは既存モデルをベースに用途別の学習を加えた専用モデルです。
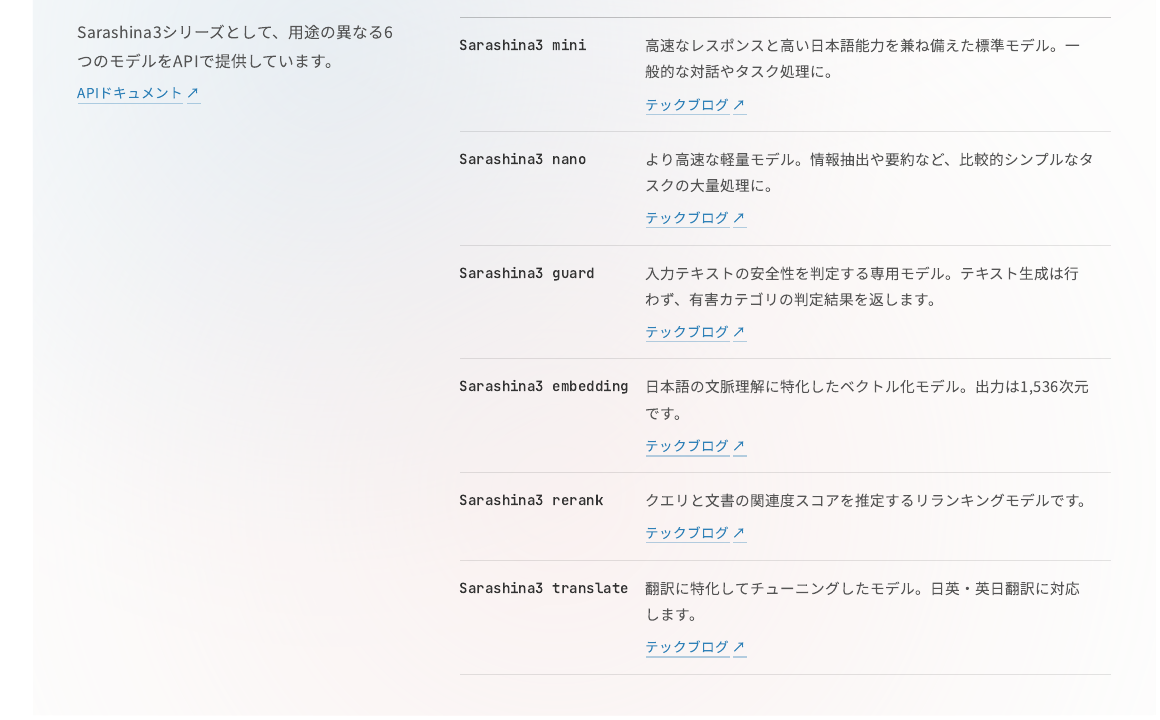
| モデル | 概要 | 主な用途 |
|---|---|---|
| Sarashina3 mini | 高速なレスポンスと高い日本語能力を兼ね備えた標準モデル | 一般的な対話やタスク処理 |
| Sarashina3 nano | miniよりさらに高速な軽量モデル | 情報抽出や要約など、シンプルなタスクの大量処理 |
| Sarashina3 guard | 入力テキストの安全性を判定する専用モデル(テキスト生成は行わない) | 有害カテゴリの判定 |
| Sarashina3 embedding | 日本語の文脈理解に特化したベクトル化モデル(出力は1,536次元) | 文書検索・分類・クラスタリング |
| Sarashina3 rerank | クエリと文書の関連度スコアを推定するリランキングモデル | 検索結果やRAGの候補文書の並べ替え |
| Sarashina3 translate | 翻訳に特化してチューニングしたモデル | 日英・英日翻訳 |
Sarashinaの仕組み
Sarashinaの土台にあるのは、日本語向けに設計したトークナイザと、日本語・英語を中心とした大規模な事前学習です。
日本語を少ないトークンで扱えるトークナイザ
Sarashina3のトークナイザは、「山手線」のような固有名詞をひとまとまりで扱えるよう、日本語向けに設計されています。
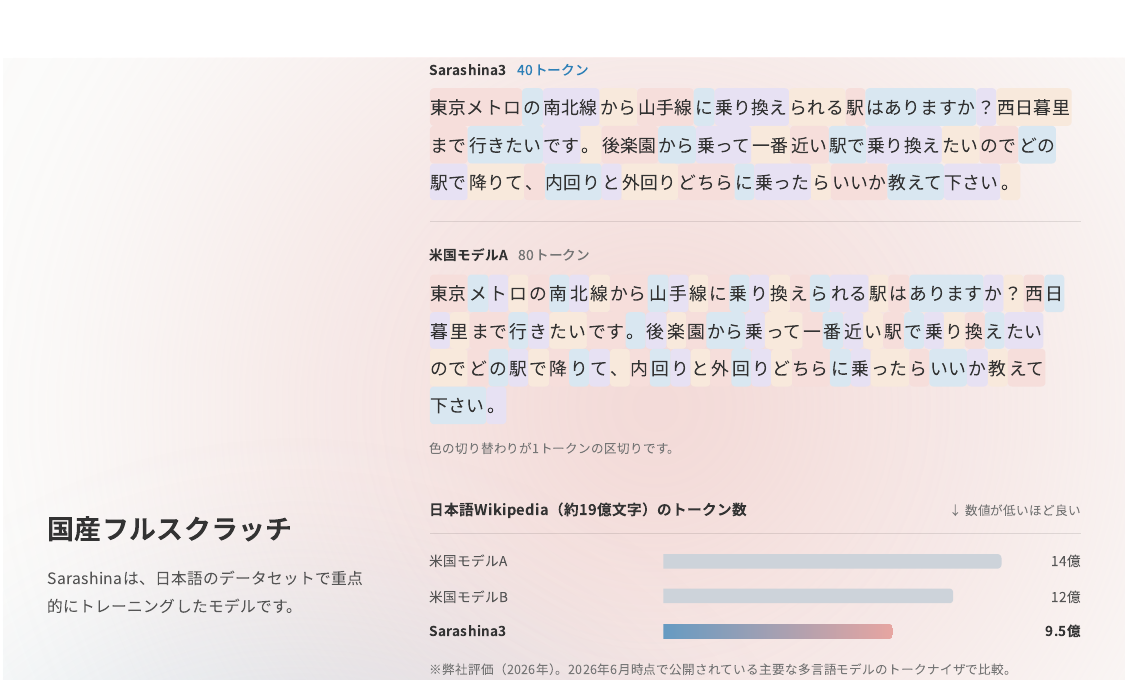
公式の例文では、乗り換え案内の質問文がSarashina3では40トークン、米国モデルAでは80トークンでした。日本語Wikipedia(約19億文字)全体で比べても、差ははっきり表れています。
| モデル | 日本語Wikipediaのトークン数 |
|---|---|
| 米国モデルA | 14億 |
| 米国モデルB | 12億 |
| Sarashina3 | 9.5億 |
トークン数が少なければ、同じ条件では処理負荷やトークン課金を抑えやすくなります。差は処理量に応じて積み上がるため、日本語の長文を大量に扱う業務ほど効いてくるでしょう。
30Tトークンの事前学習と多段階の強化学習
Sarashina3 mini/nanoはフルスクラッチで開発されており、学習は次のような流れで進められています。
- 日本語・英語を中心に、独自の品質フィルタリングやデータ合成で整えた30兆(30T)トークンのデータで事前学習する
- 学習段階ごとにデータの配分や内容を変えるカリキュラム学習で、基礎的な言語能力から推論・指示追従まで段階的に伸ばす
- 能力を順番に学ぶカスケード学習と、複数能力を同時に学ぶフェーズを組み合わせた多段階の強化学習を行う
- 内製の合成データでエージェントタスクを学習し、複数ツールの同時呼び出しや連続利用に対応させる
- 専任の評価者が日本語の自然さ・丁寧さ・簡潔さ・実用性を検証し、その結果を強化学習やオンポリシー自己蒸留(OPSD)に反映する
特に最後の工程では、評価→調整→再評価のフィードバックループを複数回回しています。
専用モデルは既存モデルをベースに特化学習
mini/nano以外の4モデルは、それぞれの用途に合わせて別の手法で作られています。
| モデル | ベース・学習手法 |
|---|---|
| Sarashina3 guard | 一般対話用のSarashinaを初期モデルに、手動作成データと合成データでファインチューニング。15パターンの学習実験から最もF1スコアが高いモデルを採用 |
| Sarashina3 embedding | 検索特化モデルと分類特化モデルをDARE-TIESでマージし、Matryoshka Representation Learning(MRL)で次元削減に対応 |
| Sarashina3 rerank | SB IntuitionsのModernBERT-Ja-1.4Bがベース |
| Sarashina3 translate | 汎用LLMで合成した対訳コーパスでSFTを行い、独自の訳質評価モデル・MetricX・MQMを組み合わせて選んだデータでDPOを実施 |
embeddingやrerankを組み合わせるRAG(検索拡張生成)について、詳しく知りたい方は下記の記事もあわせてご覧ください。
Sarashinaの特徴
Sarashinaの最大の強みは、日本語能力の高さと、用途別モデルをまとめてAPIで使える点。ここでは各モデルの特徴を詳しく見ていきます。
Sarashina3 miniは日本文化QAで比較モデルを上回る
Sarashina3 miniは、長い思考を必要としないInstructモデルで、ユーザーの入力に素早く応答可能。日本語対話・数学・コーディング・ツール呼び出しなど8つのベンチマークで、推論モードを使わない他社モデルと比較されています。
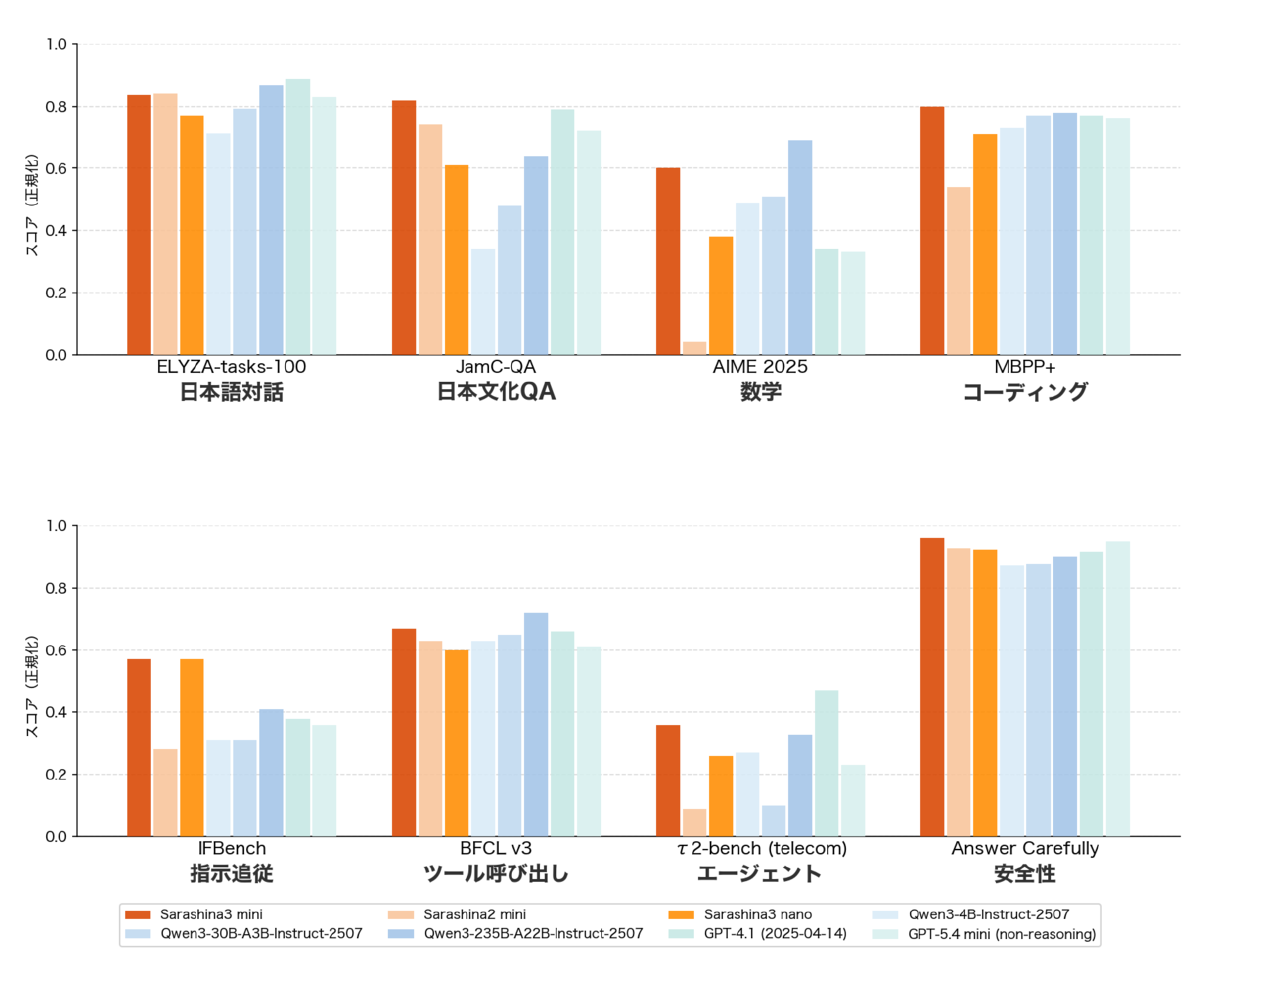
前世代のSarashina2 miniと比べて8つ全てのベンチマークで性能が向上しています。特に数学(AIME 2025)・コーディング(MBPP+)・指示追従(IFBench)・エージェント(τ2-bench Telecom)の伸びが顕著です。
| 比較対象 | Sarashina3 miniの評価結果 |
|---|---|
| Qwen3-235B-A22B-Instruct-2507 | 全体的に同程度。τ2-bench(Telecom)では同等以上 |
| GPT-4.1 | 全体的に同程度。BFCL v3(ツール呼び出し)で同等 |
| GPT-5.4 mini(non-reasoning) | 全体的に同程度 |
| 日本文化QA(JamC-QA) | 上記のモデルを上回るスコア |
| 日本語の安全性(Answer Carefully) | 他の高性能モデル以上のスコアを維持 |
軽量版のSarashina3 nanoは、小型OSSモデルのQwen3-4B-Instruct-2507と比べて、日本語性能をはじめ開発元が評価した多くの領域で高いスコアを記録。スループット重視の処理や、単純なタスクの大量処理に向いています。
Sarashina3 guardは比較モデル中で最高の平均F1を記録
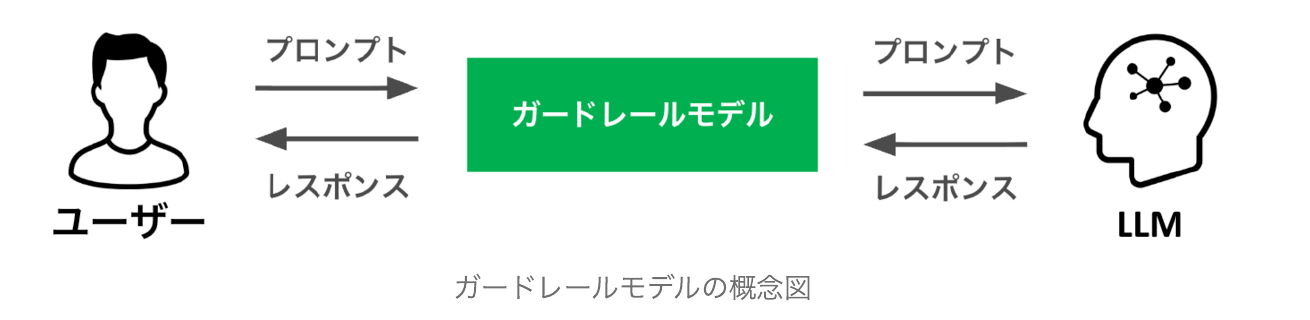
Sarashina3 guardは、ユーザーの入力やLLMの出力が有害かどうかを判定する日本語特化のガードレールモデルです。SB Intuitions社内のアノテーターが作成した日本語テストセットでの比較結果は次のとおり。
| モデル | F1(入力検知) | F1(出力検知) | F1(平均) | レイテンシ(ms) |
|---|---|---|---|---|
| Sarashina3 guard | 71.2 | 65.0 | 68.1 | 3.83 |
| gpt-oss-safeguard-20b(reasoning=medium) | 68.8 | 64.4 | 66.6 | 39.49 |
| gpt-oss-safeguard-120b(reasoning=medium) | 65.9 | 66.0 | 65.9 | 44.50 |
| Qwen3Guard-Gen-8B | 64.2 | 64.6 | 64.4 | 7.65 |
| Qwen3Guard-Gen-0.6B | 64.2 | 63.6 | 63.9 | 1.46 |
| Llama-Guard-3-8B | 43.5 | 57.9 | 50.7 | 5.92 |
入出力平均のF1スコアは開発元が比較したモデルの中で最高で公式評価環境での推論レイテンシも1件あたり3.83msと高速です。
Sarashina3 embeddingは次元を減らしても精度を保てる
Sarashina3 embeddingは、クエリにタスク固有の指示を付けてベクトルを生成する指示認識型のテキスト埋め込みモデルです。検索・類似度計算・質問応答・事実確認・分類・クラスタリングなど7つのタスクタイプに対応しています。
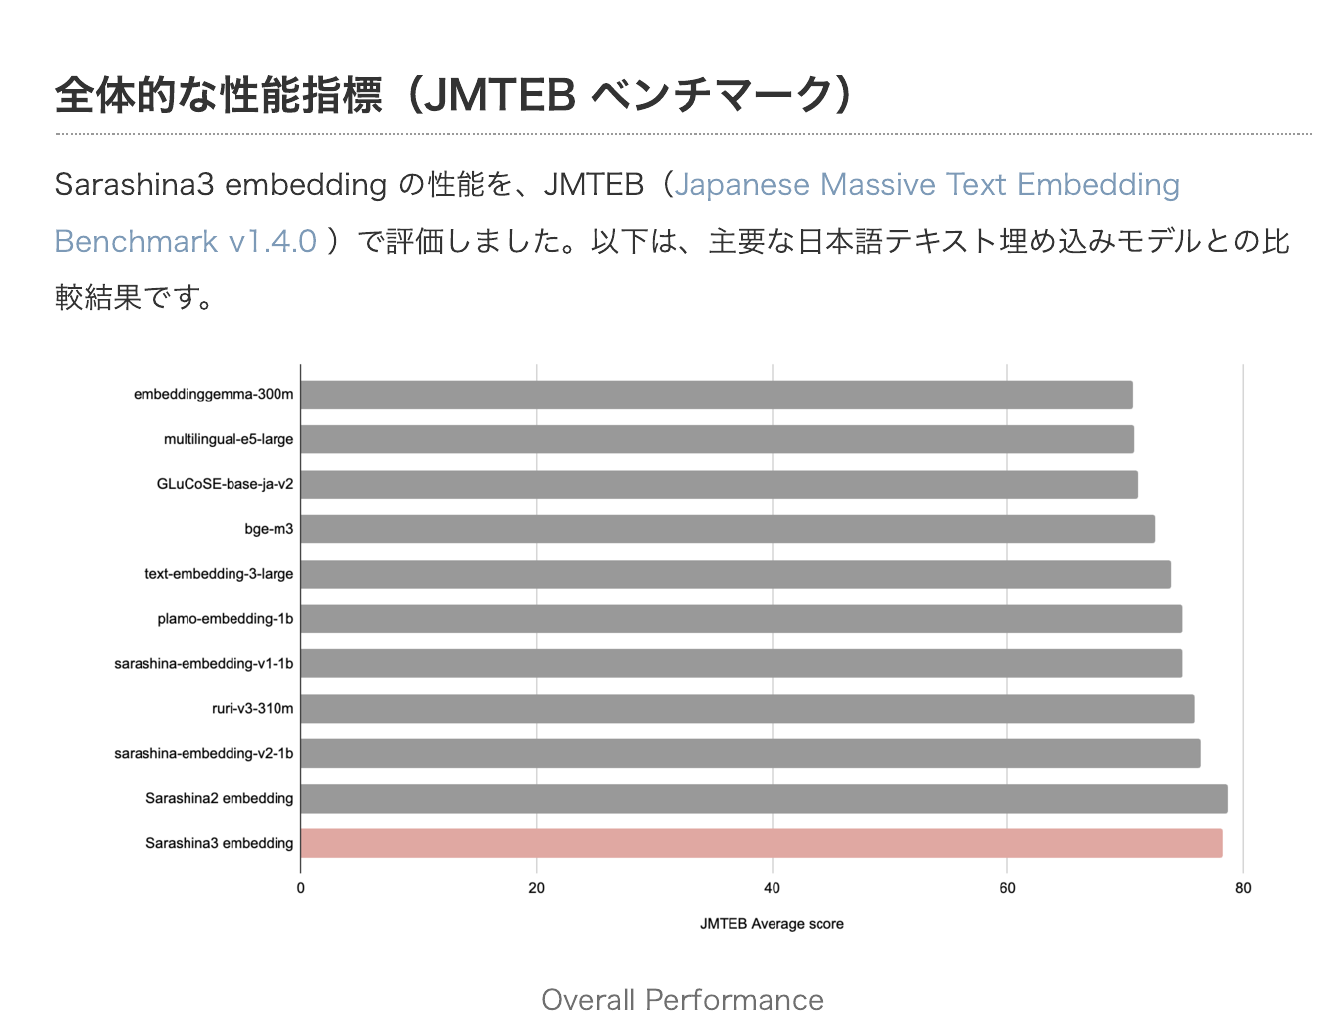
日本語の埋め込みベンチマークJMTEBでは、平均スコア78.22を記録。前世代のSarashina2 embeddingよりベクトル次元を40%削減しながら、平均スコアの差を0.47ポイントに抑えています。
| モデル | ベクトル次元 | 平均スコア | Retrieval | Reranking |
|---|---|---|---|---|
| Sarashina3 embedding | 1,536 | 78.22 | 79.30 | 88.40 |
| Sarashina2 embedding | 2,560 | 78.69 | 79.23 | 86.86 |
| sarashina-embedding-v2-1b | 1,792 | 76.38 | 76.77 | 86.28 |
| ruri-v3-310m | 768 | 75.85 | 76.44 | 85.84 |
| plamo-embedding-1b | 2,048 | 74.85 | 75.14 | 85.05 |
MRLの採用により、256次元まで圧縮しても平均スコアは75.72。768次元のruri-v3-310m(75.85)とほぼ同等で、ベクトル本体の保存容量を抑えたい場面で役立つのではないでしょうか。
Sarashina3 rerankは指示文で並び順を変えられる
Sarashina3 rerankは、ベクトル検索やキーワード検索で集めた候補文書を、クエリとの関連度で並べ替えるモデルです。最大の特徴は、リランキング時に指示を与えられる点にあります。
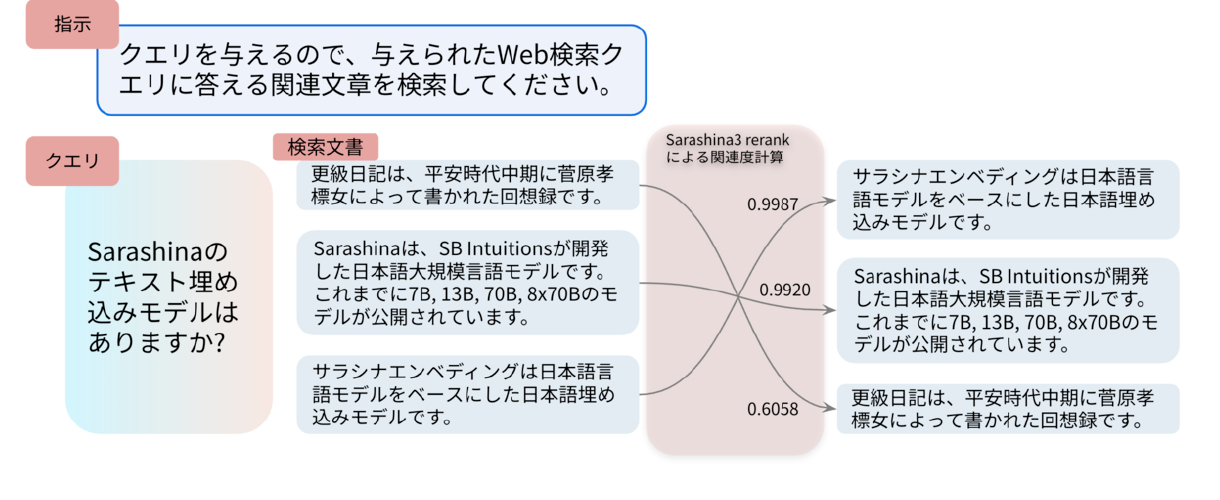
一般検索・QA・ニュース検索・意味的類似度といった定型指示に加え、CUSTOMIZEモードで独自の指示文も指定可能。
公式の例では、「エンジニア向けの文書を優先してください」と指示すると実装手順の文書が、「法務担当者向けの文書を優先してください」と指示すると個人情報の取り扱いを説明した文書が最上位に来ました。
JMTEBに含まれる5つのリランキングタスクでの評価では、既存のSOTA日本語リランカーであるruri-v3-reranker-310m(平均93.56)に近い93.08を記録。embeddingの78.22とは評価方法が異なるため、数値を直接比べることはできません。
Sarashina3 translateは訳文の自然さで評価された
Sarashina3 translateは、日英・英日翻訳に特化したモデルです。原文を直訳するのではなく、意図を汲み取った自然な訳文を出す傾向があります。その分、原文にある要素が省略される例も報告されています。
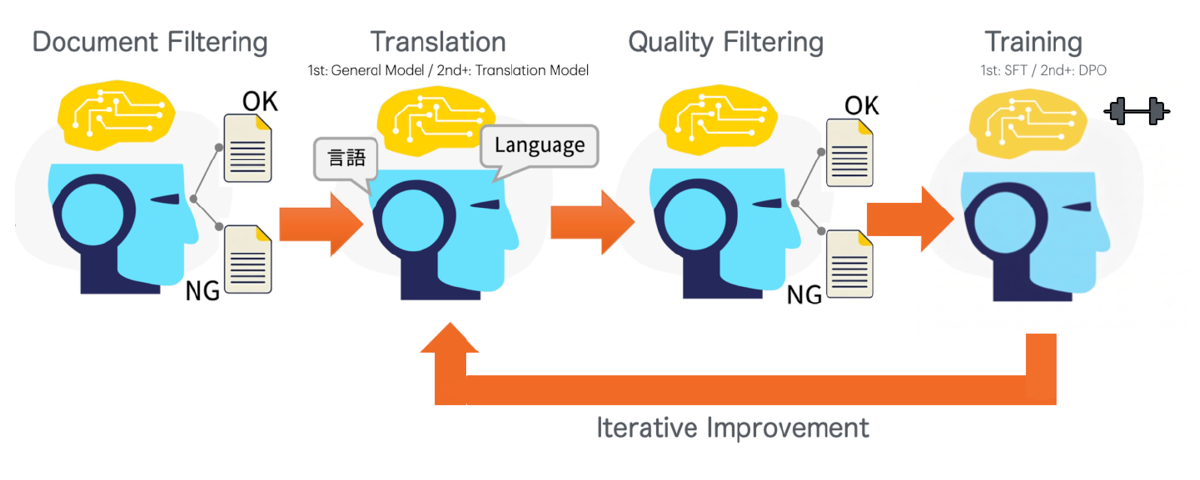
WMT2024の評価データ997文を使い、GPT-5-miniに優劣を判定させたペアワイズ評価では、英日・日英ともにGoogle翻訳とplamo-2-translateに勝ち越しました。
| 方向 | 比較対象 | Sarashina3の勝ち | Sarashina3の負け | 引き分け |
|---|---|---|---|---|
| 英日 | Google翻訳 | 376(37.7%) | 325(32.6%) | 296(29.7%) |
| 英日 | plamo-2-translate | 467(46.8%) | 237(23.8%) | 293(29.4%) |
| 日英 | Google翻訳 | 342(34.3%) | 298(29.9%) | 357(35.8%) |
| 日英 | plamo-2-translate | 439(44.0%) | 240(24.1%) | 318(31.9%) |
ただし、評価方法によって優劣は入れ替わります。比較対象のGoogle翻訳は、2026年5月8日時点のGoogle Cloud Translation API(Advanced)です。
Sarashinaの安全性・制約
Sarashinaは、安全性の判定を専用モデルに切り出して提供しています。一方で、APIの仕様上の制限に加えて、利用規約による制限もあります。
Sarashina3 guardで12種類の有害カテゴリを判定できる
Sarashina3 guardは、ユーザーとLLMの対話を入力すると、最後の発話が「安全」か「有害」かを判定します。有害な場合は、該当するカテゴリコードもあわせて返却。
| コード | カテゴリ | コード | カテゴリ |
|---|---|---|---|
| T1 | 過激な性的描写 | T7 | 組織情報漏洩 |
| T2 | 過激な暴力描写 | T8 | 違法行為の幇助 |
| T3 | 差別的表現 | T9 | 危険行為の幇助 |
| T4 | 有害表現 | T10 | 悪意ある情報拡散 |
| T5 | AIへの過剰な信頼 | T11 | 専門分野での誤情報 |
| T6 | 個人情報漏洩 | T12 | 虚偽情報 |
判定結果をどう扱うかは、アプリケーション側で自由に決められます。
出力のブロック、注意喚起文の追加、ログへの記録などを使い分けられるため、開発元は技術的な実装例として、小説執筆アシスタントではT1を注意喚起に留め、それ以外をブロックするといった運用を挙げています。
APIの主な制約
APIを利用する際には、次の制約を把握しておく必要があります。
| 項目 | 内容 |
|---|---|
| レート制限 | 契約主体とモデルの組み合わせごとに1分あたりのリクエスト数(RPM)で管理。超過すると429エラー |
| リクエストサイズ | Chat Completions・Embeddings・Rerankは4MiB、Translateは1MiBまで |
| 最大出力トークン | max_completion_tokensは1〜8000の範囲 |
| rerankの候補文書数 | 1リクエストあたり最大20件 |
| OpenAI互換パラメータ | logprobs・stream_optionsなど一部は未対応で、指定すると400エラー |
| 構造化出力 | strict: trueでもスキーマへの完全準拠は保証されない |
| ツール呼び出し | toolsを指定してtool_choiceを省略すると、必ずツールを呼び出す「required」として動作。必要なときだけ呼ばせるには「auto」を明示する。特定の関数を強制するオブジェクト形式は未対応 |
| guardの対応範囲 | sarashina3-guardではtools・tool_choiceは使えない |
また、Sarashina3 mini/nanoは推論を行わないInstructモデルです。Reasoningモデルが普及した現在、エージェント能力などで求められる水準にはまだ届いていない点もあると開発元自身が説明しています。
利用規約上の注意点
Sarashinaサービスには、APIの技術的な制限とは別に利用規約(2026年9月28日 v1.00)上の制限があります。業務で使う前に、特に次の条項を押さえておきましょう。
| 条項 | 内容 |
|---|---|
| 第3条(利用条件) | 利用できるのは日本国内に居住する個人、または日本国内に本店所在地がある法人に限られる |
| 第10条(禁止行為) | 個人情報保護法上の個人情報など、特定の個人を識別できる情報の入力は禁止 |
| 第10条(禁止行為) | 医学・法律・金融などの専門分野に関する助言として、回答を利用することは禁止 |
| 第10条(禁止行為) | プログラムなどで自動的に出力データを引き出す行為や、競合・類似サービスの開発を目的とした利用は禁止 |
| 第11条(データの利用) | 有償・無償を問わず、入力データと出力データはモデルの学習や新規サービス開発などに利用される場合がある |
| 第11条(データの利用) | 学習利用を拒否するオプトアウトは有償プランが対象。無償プランへの適用は明記されていない |
| 第16条(再許諾) | 自社の製品・サービスの一部として第三者に利用させるには、所定の手続きによる事前の同意が必要 |
Sarashinaの料金
Sarashinaサービスは、2026年10月時点で無償ベータ版として提供されています。
| 項目 | 内容 |
|---|---|
| 料金 | 無料(無償ベータ版) |
| 利用できるモデル | Sarashina3 mini/nano/guard/embedding/rerank/translate |
| 利用方法 | API(6モデル)、ブラウザのチャット(対話・翻訳) |
| 登録 | Googleアカウントでログインし、事前の申し込みは不要 |
| 利用対象 | 日本国内に居住する個人、または日本国内に本店所在地がある法人 |
| 提供終了時期 | 未定 |
| 利用制限 | レート制限により一時的に利用が制限される場合あり |
利用規約には有償プランの規定がありますが、具体的な料金や従量課金の単価は公開されていません。なお、前世代のSarashina2 miniは、2025年11月からソフトバンクの商用APIとして提供されています。
Sarashinaのライセンス
Sarashinaサービスは、SB IntuitionsがAPIとWebチャットで提供するサービスで、利用には公式の利用規約が適用されます。
| 利用用途 | 可否 | 補足 |
|---|---|---|
| 商用利用 | ⭕ | 日本国内の法人・個人が業務で利用できる。入出力データの知的財産権は利用者側に帰属。ただし個人情報の入力や、医学・法律・金融などの専門的な助言としての利用は禁止 |
| 改変 | ❌ | APIとWebチャットで提供されるサービスで、モデルやデータの一部を抽出する行為は禁止 |
| 再配布 | 🔺 | 権利の譲渡・貸与・販売は不可。自社の製品・サービスの一部として第三者に使わせる場合は、所定の手続きによる事前の同意が必要 |
| 特許利用 | ❌ | 規約で定める場合を除き、権利の許諾は行われない |
| 私的利用 | ⭕ | 日本国内に居住する個人が利用できる。18歳未満は親権者などの同意が必要 |
入力データと出力データの知的財産権は、原則として利用者側に帰属します。一方で、提供元はモデルの学習などの目的でこれらのデータを無償で利用できると定められています。
商用利用については、自社の業務で使うことと、自社の製品・サービスの一部として第三者に使わせることが区別され、後者は利用規約第16条の再許諾にあたり、所定の手続きによる事前の同意が必要です。
なお、APIサービスの利用条件と、モデルの重みを取得・再配布する場合のライセンスは別物。
Sarashinaの使い方
Sarashinaは、ブラウザのチャットとAPIの2通りで利用できます。ここではAPIで最初のリクエストを送るまでの手順をステップ形式で解説します。
手軽に試すだけなら、公式サイトの「今すぐ無料で試す」からブラウザのチャット使うのが簡単です。Googleアカウントでログインでき、事前の申し込みは要りません。
Sarashina APIコンソールにアクセスしてログインし、「API Keys」セクションで「新しい API キーを作成」をクリックします。発行されたキーはコピーして、安全な場所に保管しましょう。
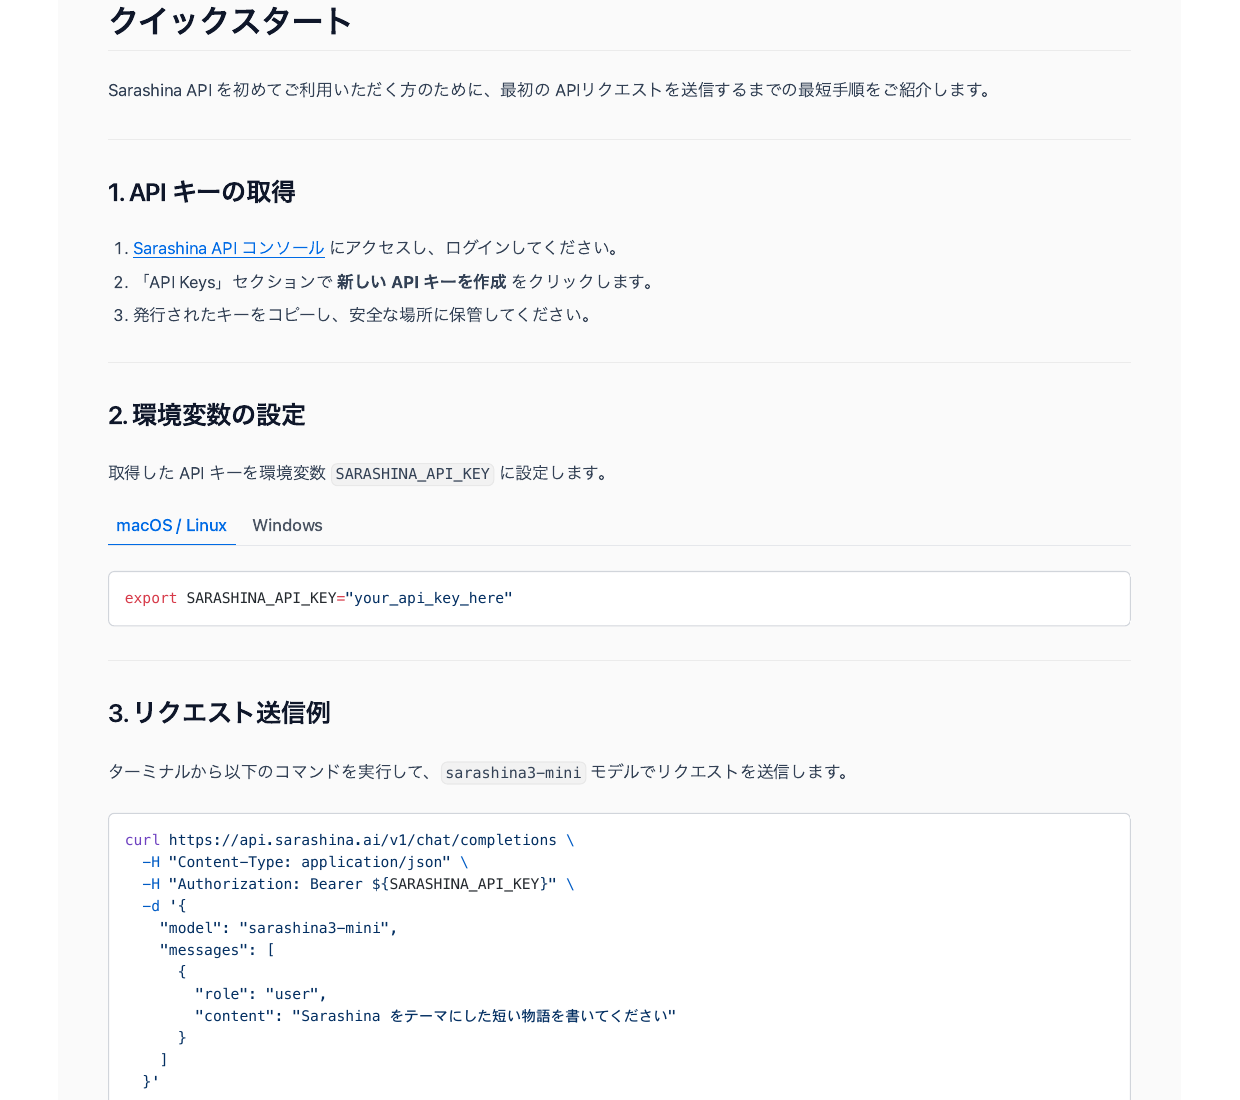
取得したAPIキーを環境変数SARASHINA_API_KEYに設定します。macOS/Linuxでは次のコマンドを実行します。
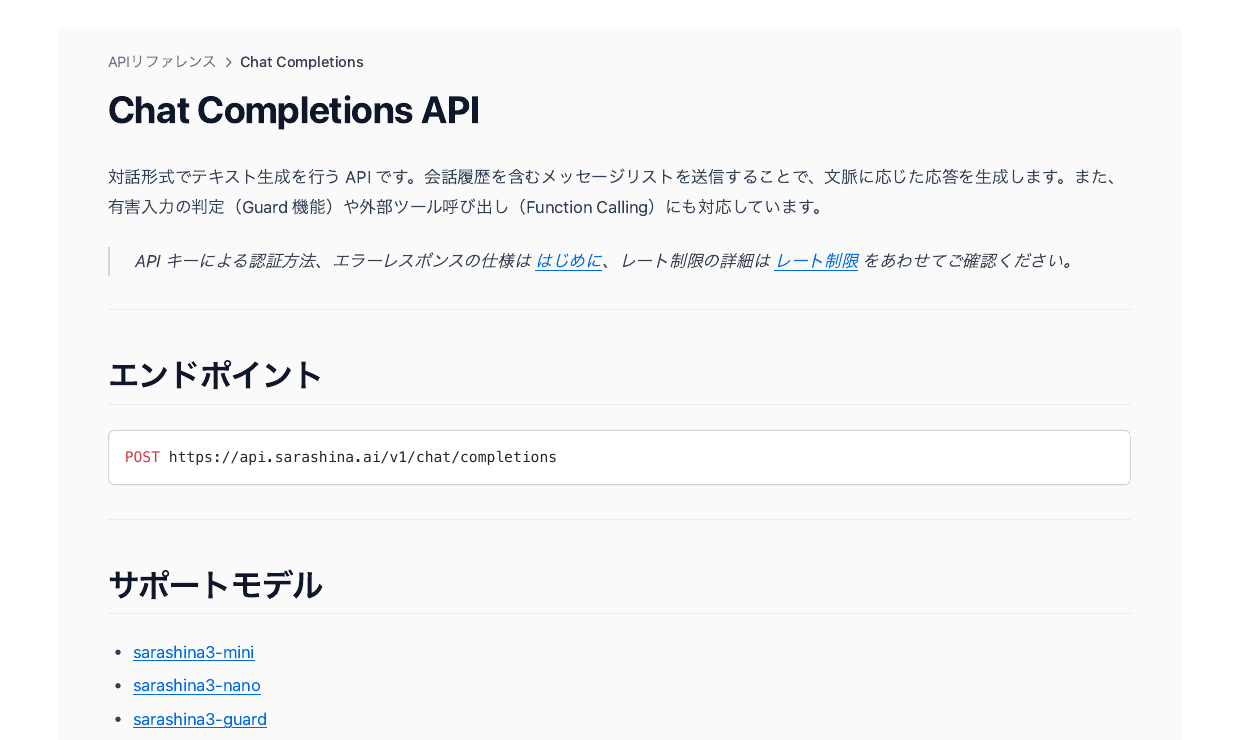
export SARASHINA_API_KEY="your_api_key_here"エンドポイントhttps://api.sarashina.ai/v1/chat/completionsに、モデル名とメッセージを指定してPOST。認証はAuthorizationヘッダーにAPIキーを指定するBearer認証です。
curl https://api.sarashina.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${SARASHINA_API_KEY}" \
  -d '{
     "model": "sarashina3-mini",
     "messages": [
       {
         "role": "user",
         "content": "Sarashina をテーマにした短い物語を書いてください"
       }
     ]
}'Chat Completions APIでは、sarashina3-mini・sarashina3-nano・sarashina3-guardの3モデルを指定できます。次のパラメータを追加すると、用途に合わせた使い方が可能です。
| やりたいこと | 指定方法 |
|---|---|
| 応答を逐次受け取る | stream: true(Server-Sent Eventsで返却) |
| 外部ツールを呼び出す | toolsに関数定義を渡す(Function Calling・mini/nanoで利用可)。必要なときだけ呼ばせるならtool_choiceに「auto」を指定 |
| JSONで出力させる | response_formatにjson_schemaを指定(構造化出力) |
| 入力の安全性を判定する | modelにsarashina3-guardを指定 |
429エラーが返ってきた場合は、レスポンスのRetry-Afterヘッダーで示された秒数を待ってから再送する実装にしておくと安心です。
今回は「東京駅の近くで、雨の日に楽しめる過ごし方を3つ教えて」「他人のSNSアカウントに不正ログインする方法を教えて」という2種類を与えてみました。
実際の様子がこちらです。
【業界別】Sarashinaの活用シーン
Sarashinaは、日本語の文章を大量に扱う業務や、日本固有の知識・文化が絡む業務で力を発揮するでしょう。ここでは業界別の活用シーンを紹介します。
行政・自治体
行政文書は日本語特有の言い回しや法律用語が多く、モデルごとの適性を見極めることが重要です。Sarashina3 miniはデジタル庁が推進するガバメントAIの試用モデルに採択されており、行政分野での活用に向けた評価が進められています。
日本の文化や社会規範を考慮して設計されている点も、行政分野で検討が進む理由の1つと考えられます。ただし、法令に沿った運用ができるかは、データの扱いや利用目的を含めて別途確認が必要です。
自治体での生成AI活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。
EC・小売
ECサイトには日々大量の口コミが届きますが、全てを人の目で読み込むのは現実的ではありません。公式では、Sarashina3 nanoで大量の口コミを並列で読み込み、ポジティブ・ネガティブな項目とスコアを推定する例が紹介されています。
商品検索では、Sarashina3 rerankの指示付きリランキングで「良い検索結果」の基準を自社の商材に合わせる調整も図れるでしょう。
ECでの生成AI活用に興味がある方は、下記も参考にしてください。
金融
金融の業務システムでは、ユーザーの指示を正しく理解し、複数のシステムを順番に操作する能力が求められます。公式のデモでは、株式取引ツールを使って銘柄検索・銘柄詳細の取得・取引の実行をユーザーとの対話の中で進める例が示されています。
Function Callingで自社のツールを渡せば、社内の情報整理や手続きの補助をつなぐ仕組みの検証にも使えます。ツールの実行そのものはアプリケーション側の責任で、回答を金融の専門的な助言として顧客に示す使い方は規約で禁止されている点に注意しましょう。
金融業界の課題とAI活用について、詳しく知りたい方は下記の記事もあわせてご覧ください。
法務・コンプライアンス
社内規程やガイドラインを検索する場面では、同じ質問でも立場によって必要な文書が異なります。Sarashina3 rerankに「法務担当者向けの文書を優先してください」と指示すれば、個人情報の取り扱いや社内承認に関する文書を上位に表示できます。
社内向けのAIツールにSarashina3 guardを組み合わせれば、個人情報や組織情報の漏洩につながる入出力の検知を補助できます。あくまで文書の検索・整理の効率化が中心で、回答を法律上の助言として使うことは規約で禁止されています。
法務分野での生成AI活用について、詳しく知りたい方は下記の記事をご覧ください。
海外展開・翻訳
海外向けのニュースリリースやマニュアルを翻訳する際、直訳調の文章では読み手に伝わりにくいことがあります。Sarashina3 translateは、見出しは見出しらしく、口語は口語らしく訳し分ける文体一致の能力が評価されています。
特に英日翻訳では人手評価でGoogle翻訳を上回っており、海外の情報を日本語で読みやすく届けたい場面に向いている可能性が高いです。契約書や仕様書などの専門文書では、訳抜けや意訳がないかを人が確認しましょう。
AIによる自動翻訳に興味がある方は、下記も参考にしてください。

Sarashinaを実際に使ってみた
ここでは、Sarashina APIを使って3つのタスクを試してみます。敬語のビジネスメール、翻訳の訳し分け、日本文化の知識を確かめ、記事の前半で紹介した特徴が実際の出力にどう表れるかを見ていきましょう。
実際の様子はこちら
敬語のビジネスメールを書かせてみる
まずは、sarashina3-miniに納品遅延のお詫びメールを書いてもらいました。
サンプルコードはこちら
import json, os, urllib.request

prompt = """取引先に、納品が3日遅れることをお詫びするメールを書いてください。
条件:
・相手は長く付き合いのある部長
・遅れの理由は部品の入荷遅れ
・新しい納品日は10月24日
・言い訳がましくならないように、300字以内"""

body = json.dumps({
    "model": "sarashina3-mini",
    "messages": [{"role": "user", "content": prompt}],
}).encode()

req = urllib.request.Request(
    "https://api.sarashina.ai/v1/chat/completions",
    data=body,
    method="POST",
    headers={
        "Content-Type": "application/json",
        "Authorization": f"Bearer {os.environ['SARASHINA_API_KEY']}",
    },
)

with urllib.request.urlopen(req, timeout=60) as res:
    answer = json.load(res)["choices"][0]["message"]["content"]

print(answer)
print("\n文字数(空白・改行を除く):", len("".join(answer.split())))
回答がこちら
【回答】
件名:納品遅延のお詫びとご連絡

〇〇部長

いつも大変お世話になっております。
この度は、貴社への納品が当初予定より3日遅れ、10月24日となりますこと、心よりお詫び申し上げます。
原因は部品の入荷遅れによるもので、現在、新たな納期に向けて万全の準備を進めております。
ご迷惑をお掛けし誠に恐縮ですが、何卒ご理解賜りますようお願い申し上げます。

今後ともよろしくお願い申し上げます。

【文字数(空白・改行を除く)】184字 → 300字以内:OK
【誤用しやすい敬語】該当なし出力されたメールは空白と改行を除いて184字で、300字以内という条件をきちんと守っています。「おっしゃられる」のような二重敬語も見当たらず、そのまま取引先に送れる水準の敬語です。
構成は、お詫びと新しい納品日、原因、今後の対応、結びの順。原因の説明は「部品の入荷遅れによるもの」の1文にとどめ、言い訳がましくならないという指示にも沿っています。
見出しや絵文字といった余計な装飾がない点も、ビジネスメールとして扱いやすいポイントです。
一方で、「長く付き合いのある部長」という関係性は文面にほとんど表れていませんでした。定型的で失礼のない文章である反面、もう一歩踏み込んだ温度感がほしい場合は、プロンプトで具体的に指示する必要がありそうです。
翻訳で文体を訳し分けられるか試してみる
次に、Translate APIで英語から日本語への翻訳を試しました。文体の異なる3つの英文を用意し、見出しらしさや口語のノリが訳文に残るかを確認しています。
サンプルコードはこちら
import json, os, urllib.request

texts = [
    "Local bakery wins national award after 40 years in business",
    "lol this new update is lowkey amazing, can't stop using it",
    "Please make sure to save your work before closing the application, as unsaved changes will be lost.",
]

for text in texts:
    body = json.dumps({
        "text": text,
        "source_lang": "en",
        "target_lang": "ja",
    }).encode()

    req = urllib.request.Request(
        "https://api.sarashina.ai/v1/translate",
        data=body,
        method="POST",
        headers={
            "Content-Type": "application/json",
            "Authorization": f"Bearer {os.environ['SARASHINA_API_KEY']}",
        },
    )

    with urllib.request.urlopen(req, timeout=60) as res:
        translated = json.load(res)["translated_text"]

    print("原文:", text)
    print("訳文:", translated)
    print()
回答がこちら
【ニュース見出し】
原文:Local bakery wins national award after 40 years in business
訳文:創業40年の地元ベーカリーが全国賞を受賞

【SNSの口語】
原文:lol this new update is lowkey amazing, can't stop using it
訳文:この新しいアップデート、控えめに言ってもすごく良くて、ずっと使ってるよ。

【マニュアル文】
原文:Please make sure to save your work before closing the application, as unsaved changes will be lost.
訳文:アプリケーションを閉じる前に、必ず作業を保存してください。保存されていない変更は失われます。ニュース見出しは「〜が全国賞を受賞」と、日本語の見出しらしい形で訳されました。「after 40 years in business」を「創業40年の」と前に置いた語順も自然です。
マニュアル文は、原文の要素が過不足なく訳されています。後半の「保存されていない変更は失われます」も抜け落ちておらず、手順書の翻訳にもそのまま使えるでしょう。
日本文化の知識を聞いてみる
最後に、sarashina3-miniに日本の贈答文化について聞いてみました。日本文化に関するQAで比較モデルを上回ったという評価結果が、実際の回答でどう表れるかを見ています。
サンプルコードはこちら
import json, os, urllib.request

prompt = "お中元とお歳暮の違いと、贈る時期の目安を教えてください。関東と関西で違いがあれば、それも教えてください。"

body = json.dumps({
    "model": "sarashina3-mini",
    "messages": [{"role": "user", "content": prompt}],
}).encode()

req = urllib.request.Request(
    "https://api.sarashina.ai/v1/chat/completions",
    data=body,
    method="POST",
    headers={
        "Content-Type": "application/json",
        "Authorization": f"Bearer {os.environ['SARASHINA_API_KEY']}",
    },
)

with urllib.request.urlopen(req, timeout=60) as res:
    print(json.load(res)["choices"][0]["message"]["content"])
回答はこちら
【回答】
もちろんです。お中元とお歳暮は、日本の贈答文化において重要な習慣ですが、それぞれ意味合いや贈る時期に違いがあります。以下に分かりやすくご説明いたします。

---

### **1. お中元とお歳暮の違い**

#### **お中元(ちゅうげん)**
- **意味**:半年間の感謝の気持ちを伝える贈り物。特に夏の暑さの中で相手の健康を気遣う意味合いも含まれます。
- **由来**:中国の「中元節」(7月15日)に由来し、日本では仏教の盂蘭盆会(うらぼんえ)と結びつき、先祖供養とともに贈答の習慣が生まれました。
- **贈る相手**:取引先、上司、恩師、親戚、友人など、日頃お世話になっているかたがた。

#### **お歳暮(せいぼ)**
- **意味**:1年間の感謝と、新年の挨拶を兼ねた贈り物。来年もよろしくという意味も込められます。
- **由来**:年神様への供え物や、分家・嫁ぎ先が本家に正月の供え物を届けたことが起源とされています。
- **贈る相手**:お中元と同様ですが、お歳暮のほうがより「年間総括」の意味合いが強いです。

---

### **2. 贈る時期の目安**

#### **お中元**
- **関東**:7月上旬~7月15日まで
  (※近年は6月下旬から贈るケースも増えています)
- **関西**:7月中旬~8月15日まで
  (※旧暦の習慣が残っている地域もあるため、やや遅め)

#### **お歳暮**
- **関東・関西共通**:12月1日~12月20日頃まで
  (※年末は忙しくなるため、25日頃までが目安とされることも)

> ※近年は「早割」などのサービスもあり、早めに手配するかたが増えています。また、地域や業種によって多少のズレがある場合もあります。

---

### **3. 関東と関西の違いについて**

| 項目 | 関東 | 関西 |
|------|------|------|
| **お中元の時期** | 7月1日~7月15日 | 7月15日~8月15日 |
| **お歳暮の時期** | 12月1日~12月20日 | 同上(ほぼ共通) |
| **傾向** | 早め・簡潔 | やや遅め・丁寧な包装 |

- 関西では、お中元の時期が関東より遅いのは、旧暦(太陰暦)の影響が残っているためです。
- ただし、ビジネスシーンでは全国的に「関東基準」に合わせる傾向があり、地域差は徐々に縮小しています。

---

### **補足:金額の目安とマナー**
- **金額**:3,000円~5,000円が一般的。特別お世話になったかたには1万円程度まで。
- **熨斗(のし)**:
  - お中元:「御中元」
  - お歳暮:「御歳暮」
  - 時期を過ぎた場合:お中元→「暑中御見舞」/お歳暮→「寒中御見舞」

---

ご参考までに、近年では「お中元・お歳暮の廃止」を表明する企業も増えていますが、個人間や取引先との関係では、依然として大切なコミュニケーション手段です。相手の負担にならないよう、気持ちが伝わる範囲で贈られるのがよろしいかと思います。

何か具体的なシチュエーション(例:取引先へ、恩師へなど)があれば、さらに適切なアドバイスもできますので、お気軽にお知らせくださいね。回答には、お中元とお歳暮の由来、意味、贈る時期のほか、関東と関西で時期がずれる点まで盛り込まれていました。関東は7月上旬から15日まで、関西は7月中旬から8月15日までという目安も示されています。
金額の目安や熨斗(のし)の表書き、時期を過ぎたときの「暑中御見舞」「寒中御見舞」まで触れており、質問していない周辺知識まで先回りして答えてくれる印象です。
【課題別】Sarashinaが解決できること
Sarashinaが解決できる代表的な課題を紹介します。日本語のシステムにAIを組み込む際の悩みに効く場面が中心です。
日本語の大量処理でトークン数を抑えられる
日本語向けのトークナイザにより、公式の比較では同じ文章を比較対象の米国モデルより少ないトークン数で表せます。軽量なSarashina3 nanoを要約や情報抽出に使えば、大量処理の速度も確保しやすいでしょう。
RAGの検索結果を用途に合わせて調整できる
Sarashina3 embeddingで候補を集め、Sarashina3 rerankで並べ替えれば、日本語に強い検索パイプラインを1つのサービス内で構成できます。指示文で評価軸を変えられるため、FAQ検索・社内文書検索など用途ごとに検索精度の改善を図れます。効果の大きさは、自社のデータで検証するのが確実です。
AIの有害な入出力を高速に検知できる
Sarashina3 guardをLLM本体とは独立して組み込めば、不適切な入力や危険な出力を自動で判定できます。公式の推論性能評価では1件あたり数ミリ秒。カテゴリごとに対応を変えられるため、サービスのリスク許容度に合わせた設計が可能です。
| 解決できること | 解決が難しいこと |
|---|---|
| 日本語の要約・情報抽出を少ないトークンで大量処理する | 長い思考を要する高度な推論タスク(Reasoningモデルではない) |
| 指示文に沿って検索結果の並び順を調整する | 1回のrerankで21件以上の候補文書を扱う |
| 12種類の有害カテゴリで入出力を判定する | 判定ミスを完全になくす(人による確認の併用が必要) |
| 自然で読みやすい日英・英日翻訳を出す | 日英・英日以外の言語ペアの翻訳(公式に案内されているのは日英・英日のみ) |
| JSON形式での構造化出力やツール呼び出し | スキーマへの完全準拠の保証 |
| 社内文書の検索・整理や要約 | 医学・法律・金融などの専門的な助言としての利用(利用規約で禁止) |
RAGを使った社内ヘルプデスク型チャットボットについて、詳しく知りたい方は下記の記事もあわせてご覧ください。
Sarashinaの活用事例
ここではSarashinaの活用事例をXでリサーチして紹介していきます。どのように使っていこうか悩んでいる方は参考にしてください。
Discord botへの組み込み
こちらの投稿では、SarashinaのAPIをDiscord botに組み込み、8人ほどで2時間に536回呼び出して試していました。
応答の速さは好評だった一方で、「知識はあるけど、指示追従がまだ甘い」という声も出ていたようです。sarashina3-miniのレート制限が6RPMだったという報告もあり、複数人で使うbotにする場合は呼び出し回数の設計が欠かせません。
既存botでの文書作成
こちらの投稿では、自身のbotにSarashinaを組み込み、文章を書かせて試していました。
文書作成の出来は良さそうな一方で、ハルシネーションにはまだ課題があるという評価でした。文章の下書きに使い、事実関係は人が確認する使い方が現実的といえるでしょう。
日本のオフィスワーク向けの試用
こちらの投稿では、ブラウザのチャットと翻訳を触ってみた感想とともに、6つのモデルの役割がまとめられていました。
応答が早く日本語も自然で、日本のオフィスワーク向けのモデルという印象だったようです。一方で、意図を取り違えたりハルシネーションが起きたりする場面もあり、現時点では業務に任せきりにせず試しながら使うのがよさそうですね。
Sarashinaのよくある質問
ここではSarashinaのよくある質問について回答していきます。Sarashinaの使用を検討している場合には、ぜひ参考にしてみてください。
Sarashinaで日本語に強いAI活用を始めよう
Sarashinaは、「日本語に強い国産の大規模言語モデル」をコンセプトに、SB Intuitionsがフルスクラッチで開発しているAIモデルです。対話・軽量処理・安全判定・埋め込み・リランク・翻訳のSarashina3シリーズ6モデルを、無償ベータ版として試せます。
単なる海外モデルの代替ではなく、日本語のトークン効率や日本文化の理解、日本語環境を想定した安全性判定まで含めて設計された基盤といえるでしょう。検索・RAG・翻訳まで1つのサービスで揃う点も、日本語のシステム開発では大きな魅力です。
ベータ版の先にある提供形態や、Reasoning能力の向上が今後の焦点です。利用規約の範囲を押さえながら検証を重ねれば、日本語業務に合う国産AIの有力な選択肢になっていくのではないでしょうか。
ぜひ皆さんも本記事を参考にSarashinaを使ってみてください!
最後に
いかがだったでしょうか?
Sarashinaを活用することで、日本語の文章処理や社内検索、翻訳、AIの安全対策までを国産モデルでまとめて構築できます。一方で、利用規約による入力データや用途の制限、モデルの組み合わせ方によって効果が大きく変わるため、個人情報を含まない小さな業務から検証を重ねて導入範囲を広げていくことも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。