LangGraphとは?エージェントの使い方とワークフロー構築法をハンズオンで解説
- LangGraphは、AIの処理手順と途中のデータを管理するフレームワーク
- 条件分岐・繰り返し・人の承認を組み込んだ処理を設計できる
- LangChainのエージェントAPIと組み合わせるほか、単独でも利用できる
LangGraphは、AIが複数の手順を進める際に、処理の順序と途中のデータを管理するフレームワークです。2025年10月にv1.0が公開され、LinkedIn・Uber・Replit・Klarnaの活用事例も紹介されています。
本記事で扱うのは、LangChainとの役割の違い、条件分岐や承認待ちの仕組み、Pythonでの実装方法です。単発の質問応答に使うか、業務フローに組み込むかという選び方も整理します。
\生成AIを活用して業務プロセスを自動化/
LangGraphとは
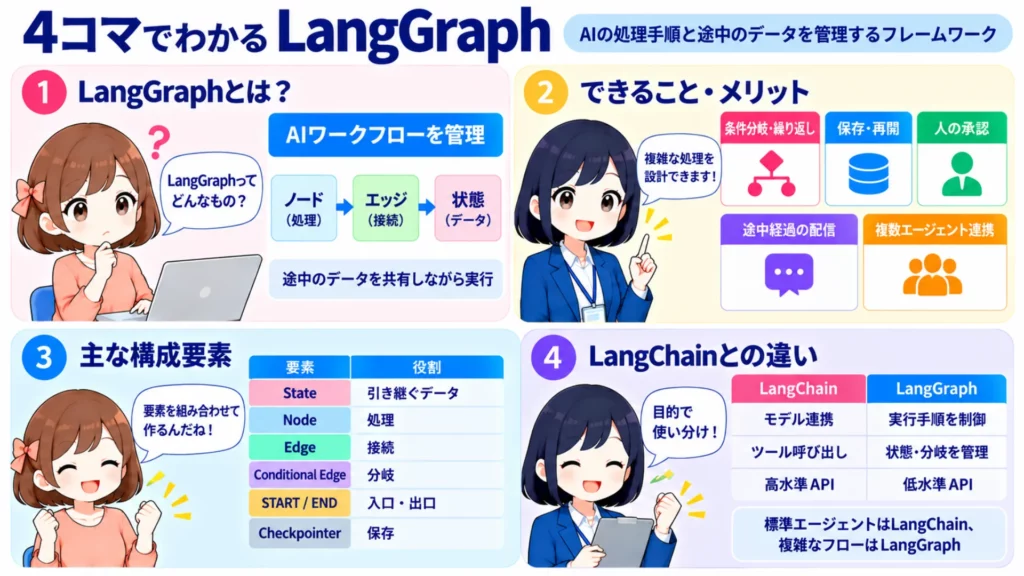
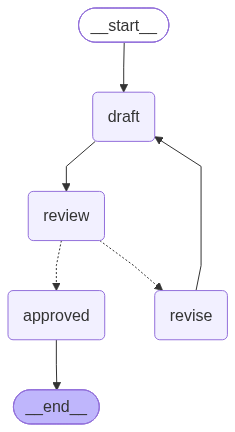
LangGraphは、処理を「ノード」、処理間のつながりを「エッジ」として表し、途中のデータを共有しながら実行するフレームワークです。例えば「下書きを作る→人が確認する→承認なら終了、差し戻しなら修正する」という流れを組めます。
公式ドキュメントでは、状態を引き継ぎながら長時間の処理を進めるエージェント向けの実行基盤と位置づけられています。状態とは、入力、会話履歴、処理状況などの引き継ぐデータです。LangChainの利用は必須ではなく、Python版とJavaScript/TypeScript版が用意されています。
LangGraph本体はMITライセンスのオープンソースソフトウェア(OSS)で、ライブラリの利用料はかかりません。外部モデルのAPI料金や、別サービスのLangSmithなどにかかる費用は分けて考えます。
GitHub Releasesで公開されている版のうち、本記事では2026年10月12日リリースのPython版LangGraph 1.2.15に固定し、10月20日にモデルAPIで実行しました。
LangGraphの構成要素
| 要素 | 役割 | 最小構成や業務フローでの例 |
|---|---|---|
| State | ノード間で引き継ぐデータ | 質問、回答、承認状況 |
| Node | Stateを受け取り、更新内容を返す処理 | 回答を作るask_llm |
| Edge | 次に実行するノードへの接続 | ask_llmから終了へ進む矢印 |
| Conditional Edge | 状態に応じて進む先を選ぶ接続 | 承認なら終了、差し戻しなら修正 |
| StateGraph | 状態の型、ノード、接続を定義するためのクラス | StateGraph(AnswerState)で組み立てる |
| START/END | 処理の入口と出口を表す特別な値 | START→ask_llm→END |
| Checkpointer | 実行途中の状態を保存する仕組み | 承認待ちの内容を保存し、後で再開する |
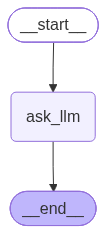
Stateはデータ、Nodeは処理、Edgeは次に進む先です。上の図は、本記事の最小構成のコードから出力したもので、開始から回答処理を経て終了する流れを表しています。
Stateの更新方法も指定できます。例えば会話履歴に新しい発言を追加する処理がReducerです。定義したグラフはcompile()で実行できる形にし、invoke()でまとめて実行したり、stream()で途中の更新を受け取ったりします。詳細はGraph APIの公式解説を参照してください。
RAGは、外部資料を検索し、大規模言語モデル(LLM)がその内容を踏まえて回答する仕組みです。LangGraphは検索そのものを置き換えるのではなく、「検索→回答→不足があれば再検索」といったRAGの処理順序を制御する役割を担えます。
LangGraphでできること・メリット
LangGraphが役立つのは、回答を一度生成するだけでなく、途中の状況に応じて処理を進め直したい場面です。
| できること | 内容 |
|---|---|
| 条件分岐・繰り返し | 検索結果が不足したときだけ再検索するなど、状態に応じた経路を作れます。終了条件もアプリ側で設計します。 |
| 保存・再開 | チェックポイントとして途中の状態を保存し、同じ処理の続きから再開できます。保存先と保持期間の設計は別途必要です。 |
| 人の承認 | Human-in-the-loop(処理の途中に人の判断を挟む方式)により、下書きを確認してから次へ進めます。 |
| 途中経過の配信 | ストリーミングで処理状況や出力を順に受け取り、利用者に進捗を伝えられます。 |
| 複数エージェントの連携 | 調査、検討、確認などの役割を分け、共有するデータと実行順序を定義できます。 |
これらは公式の概要、永続化、ストリーミングで説明されています。仕組みを導入しただけで、回答の正確さや業務の安全性が保証されるわけではありません。評価用の入力、承認条件、失敗時の処理を併せて用意します。
LangChainとの違い
| 観点 | LangChain | LangGraph |
|---|---|---|
| 主な役割 | モデル連携、ツール呼び出し、エージェントの構築 | ノード・接続・状態による実行制御 |
| 実装の入口 | create_agentなどの高水準API | StateGraphなどの低水準API |
| 向く場面 | 標準的なツール利用エージェントを組み立てたい | 独自の分岐、承認待ち、復旧経路を定義したい |
| 両者の関係 | create_agentの実行基盤にLangGraphを利用 | LangChainと組み合わせられるが、必須ではない |
LangChainはモデルやツールを使うための高水準API、LangGraphは実行手順と状態を細かく制御する基盤として使い分けます。「LangChainでは一方向の処理しかできない」という違いではありません。
v1の公式発表では、LangChainのcreate_agentはLangGraph上に構築されていると説明されています。標準的なエージェントから始め、独自の承認経路や保存・再開の制御が必要になったらLangGraphの構造を直接設計する、という選び方ができます。
高水準APIは、よく使う仕組みをまとめて呼び出せる形のAPIです。低水準APIでは、処理の単位や接続を自分で組み立てる分、実行手順を細かく決められます。
LangChainの概要や使い方については、次の記事も参考にしてください。
LangGraphを動かすのに必要な動作環境
| 項目 | 本記事の確認環境 |
|---|---|
| OS | Windows(ビルド26300) |
| Python | 3.11.9 |
| langgraph | 1.2.15 |
| langchain | 1.4.6 |
| langchain-core | 1.6.11 |
| langchain-openai | 1.7.2 |
| openai | 3.31.0 |
| langgraph-checkpoint-sqlite | 3.1.2 |
| langgraph-cli | 0.4.35 |
Python版LangGraph v1はPython 3.10以上が対象です。本記事ではWindows環境に仮想環境を作り、表の構成でGPT-6 Lunaを呼び出しました。モデルの推論はAPI側で行い、手元のGPUは使っていません。表は検証時の固定バージョンで、各パッケージの最新版を示す一覧ではありません。
外部モデルAPIで生成する場合は、インターネット接続と利用するサービスの認証情報が必要です。
LangChainはLangGraph本体の必須条件ではありませんが、本記事ではモデル連携とcreate_agentの例で使用します。SQLite用のパッケージは、承認フローで状態をファイルに保存するためのものです。Pythonの対応範囲は公式のv1移行ガイドで確認できます。
LangGraphの使い方
ここでは、インストールとモデルの準備から、最小構成のグラフ作成、グラフの画像出力、ツールを使うAIエージェントの作成までを順番に解説します。
インストールとモデルの準備
まず、既存のPython環境と分けた仮想環境を作ります。以下はWindowsのPowerShell向けです。APIキーはコードや記事に書かず、環境変数OPENAI_API_KEYから読み込みます。
py -3.11 -m venv .venv
& .\.venv\Scripts\python.exe -m pip install "langgraph==1.2.15" "langchain==1.4.6" "langchain-openai==1.7.2" "langgraph-checkpoint-sqlite==3.1.2"
今回の例ではGPT-6 Lunaを指定します。モデルの公式仕様を確認し、実行するアカウントで利用できるモデル名を設定してください。モデルを変えると回答やツール選択も変わるため、実行結果を読み替える必要があります。
クリックで表示
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="gpt-6-luna",
    reasoning_effort="none",
    max_tokens=500,
    max_retries=0,
    timeout=60,
)
この設定は1回の出力を制限しますが、複数回の呼び出しを含む総費用の上限ではありません。検証用ランナーでは、これとは別にリクエスト前の予算確認を行います。
最小構成のグラフを作る
状態には質問と回答を入れ、ノードは更新する回答だけを返します。TypedDictは、辞書にどの項目を持たせるかを示すPythonの型定義です。STARTとENDを使い、開始と終了を明示します。
クリックで表示
from langgraph.graph import START, END, StateGraph
from langchain_core.messages import HumanMessage, SystemMessage
from typing_extensions import TypedDict

class AnswerState(TypedDict):
    question: str
    answer: str

def build_basic(llm):
    def ask_llm(state: AnswerState):
        reply = llm.invoke([
            SystemMessage(content="日本語で120文字程度で回答してください。知らない事実は推測しないでください。"),
            HumanMessage(content=state["question"]),
        ])
        return {"answer": reply.content}

    builder = StateGraph(AnswerState)
    builder.add_node("ask_llm", ask_llm)
    builder.add_edge(START, "ask_llm")
    builder.add_edge("ask_llm", END)
    return builder.compile()

app = build_basic(llm)
result = app.invoke({"question": "What is LangGraph?"})
print(result["answer"])
この構成には検索ツールがないため、最新の仕様を調べて回答するわけではありません。コードの実行確認と、回答内容の事実確認は分けて行います。
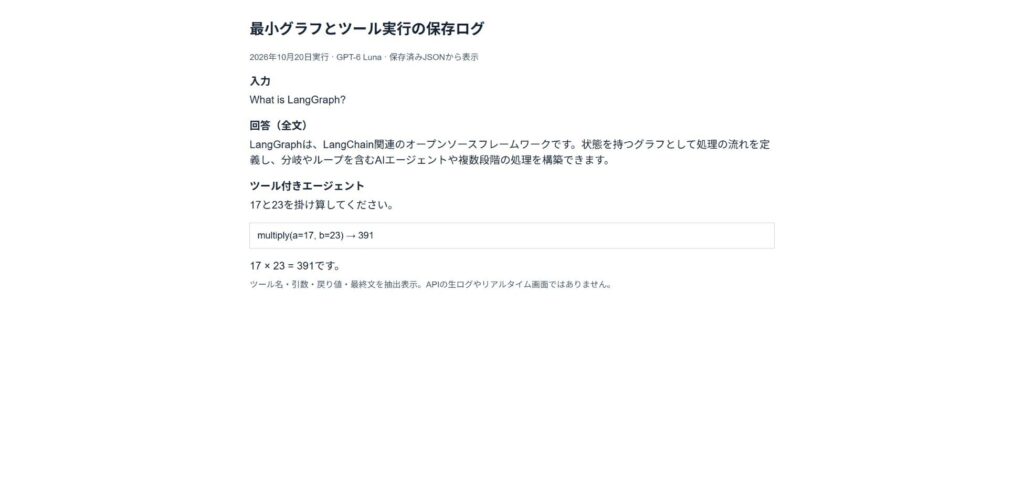
2026年10月20日の実行では、次の回答を得ました。以下は保存した実行ログのanswerをそのまま掲載したものです。
LangGraphは、LangChain関連のオープンソースフレームワークです。状態を持つグラフとして処理の流れを定義し、分岐やループを含むAIエージェントや複数段階の処理を構築できます。グラフをPNG画像として出力する
グラフ構造はMermaidという図の記述形式に変換できます。draw_mermaid_png()を呼ぶとPNGのバイト列を取得できるため、そのままファイルへ保存できます。※2
from pathlib import Path

Path("langgraph-basic.png").write_bytes(app.get_graph().draw_mermaid_png())
本記事の最小構成図もこの方法で出力しました。標準の描画方式では外部のMermaid描画サービスへ図の定義が送信されます。機密情報をノード名に入れず、社内データを含む場合は描画方式と送信先を確認してください。回答を生成せず、グラフの定義だけから図を出力することもできます。
ツールを使うAIエージェントを作る(create_agent)
create_agentは、モデルが必要に応じてツールを選び、その結果を受け取って回答するエージェントを作るAPIです。ここでは掛け算の関数をツールとして渡します。@toolは、関数名、引数、説明をモデルに伝えるための指定です。
クリックで表示
from langchain.agents import create_agent
from langchain_core.tools import tool

@tool
def multiply(a: int, b: int) -> int:
    """二つの整数を掛け算する。"""
    return a * b

def build_agent(llm):
    return create_agent(
        model=llm,
        tools=[multiply],
        system_prompt="計算には必ずmultiplyツールを使い、日本語で短く答えてください。",
    )

agent = build_agent(llm)
result = agent.invoke(
    {"messages": [{"role": "user", "content": "17と23を掛け算してください。"}]},
    {"recursion_limit": 8},
)
for message in result["messages"]:
print(message.type, message.content)最終回答の数字だけでは、ツールを実行したかは判断できません。保存ログにはmultiplyへの呼び出し、引数a=17・b=23、ツールの戻り値391が順に記録されていました。その後、モデルは「17 × 23 = 391です。」と回答しました。正しい数字が出ただけでなく、関数の実行結果を受け取った流れまで確認しています。
この検証では、通常のモデル呼び出しと、ツールを渡した呼び出しでAPIの経路が異なりました。ツール付きの応答にはResponses APIの形式が使われ、contentが文字列ではなく、複数の内容を格納するリストになっています。上のコードは元のcontentを表示するため、最終文だけでなく、項目名やリストも表示される場合があります。
v1移行ガイドで示されている移行先は、langchain.agents.create_agentです。従来のlanggraph.prebuilt.create_react_agentが非推奨になっても、「すでに削除された」という意味ではありません。既存のコードは利用バージョンを確認してから移行します。
LangSmith StudioでLangGraphを可視化・デバッグ
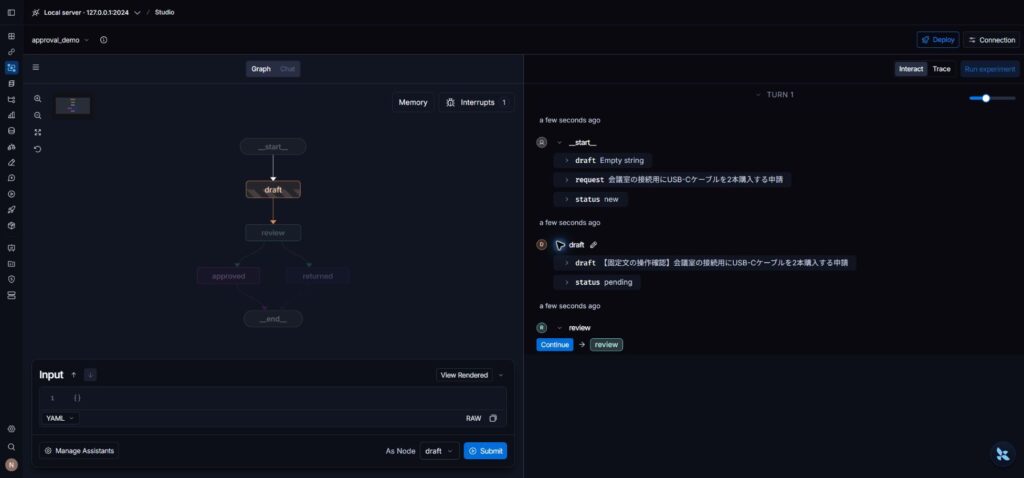
LangSmith Studioは、グラフの形と実行途中の状態を画面で確認する開発用ツールです。LangGraphがライブラリであるのに対し、Studioはその実行を調べるための画面です。
公式の変更履歴では、2025年10月にLangGraph StudioからLangSmith Studio、LangGraph PlatformからLangSmith Deploymentへ名称を変更したと案内されています。
公式クイックスタートに沿って、ローカルの開発サーバーをStudioへ接続できます。ローカルサーバーを使う操作確認と、クラウドへアプリをデプロイする契約は同じものではありません。
& .\.venv\Scripts\python.exe -m pip install "langgraph-cli[inmem]==0.4.35"設定ファイルlanggraph.jsonのgraphsには、表示するグラフを「ファイル名:変数名」の形で登録します。例えばstudio_graph.pyのgraphを表示する設定は次のとおりです。
クリックで表示
{
  "dependencies": ["."],
  "graphs": {"approval_demo": "./studio_graph.py:graph"},
  "env": {"LANGSMITH_TRACING": "false"}
}同じフォルダーに、studio_graph.pyとして次のコードを保存します。draft→review→approved/returnedの経路を持つ固定文のグラフのため、モデルAPIを呼びません。この固定文の操作確認を、LLMの生成結果の検証とは区別します。
クリックで表示
"""Studio-only control demo, fixed draft: no model, API key, or paid call."""
from typing import Literal
from typing_extensions import TypedDict
from langgraph.graph import START, END, StateGraph
from langgraph.types import Command, interrupt


class StudioState(TypedDict):
    request: str
    draft: str
    status: str


def draft(state: StudioState):
    return {"draft": "【固定文の操作確認】" + state["request"], "status": "pending"}


def review(state: StudioState) -> Command[Literal["approved", "returned"]]:
    answer = interrupt({"draft": state["draft"], "choices": ["approve", "revise"]})
    if answer not in {"approve", "revise"}:
        raise ValueError("approveまたはreviseを指定してください")
    return Command(goto="approved" if answer == "approve" else "returned")


def approved(state: StudioState):
    return {"status": "approved_test_only"}


def returned(state: StudioState):
    return {"status": "returned_test_only"}


builder = StateGraph(StudioState)
builder.add_node("draft", draft)
builder.add_node("review", review)
builder.add_node("approved", approved)
builder.add_node("returned", returned)
builder.add_edge(START, "draft")
builder.add_edge("draft", "review")
builder.add_edge("approved", END)
builder.add_edge("returned", END)
# Agent Server supplies its own checkpointer; do not attach an in-memory saver here.
graph = builder.compile()
プロジェクトを読み込むための設定が、次のpyproject.tomlです。
クリックで表示
[project]
name = "langgraph-studio-example"
version = "0.1.0"
requires-python = ">=3.10"
dependencies = ["langgraph==1.2.15"]

[build-system]
requires = ["setuptools>=68"]
build-backend = "setuptools.build_meta"

[tool.setuptools]
py-modules = ["studio_graph"]
これらのファイルを保存したら、同じフォルダーで開発サーバーを起動してください。
& .\.venv\Scripts\langgraph.exe dev --host 127.0.0.1 --port 2024 --no-browserStudioのURLは、起動時にターミナルへ表示されます。そのURLをブラウザーで開いてください。サインインを求められた場合は、自分のLangSmithアカウントでログインします。今回の画面では、Studioの「Connect agent server」からhttp://127.0.0.1:2024へ接続するとapproval_demoが表示されました。起動時のURLで作業領域が空白になる場合は、Studioの接続画面から入り直して確認します。
開発サーバーはローカルでの確認用であり、認証なしで外部に公開するものではありません。画面で確認する対象は、グラフ、ノードごとの実行履歴、Stateの値です。
2026年10月20日の操作では、Inputを「View Raw」に切り替え、次の値を入力しました。JSONは画面のYAML入力欄でも読み込めます。
{"request":"会議室の接続用にUSB-Cケーブルを2本購入する申請","draft":"","status":"new"}「Interrupts」でdraftの「After」を選び、「Submit」を押すとdraft実行後に停止しました。右側でdraftの実行結果を開くと、固定文を加えた下書きとstatusのpendingを確認できます。「Continue」で次のreviewへ進む操作も行いました。これが、ノードの前後で停止させて値の変化を追うデバッグです。
interrupt()による承認待ちを確認する
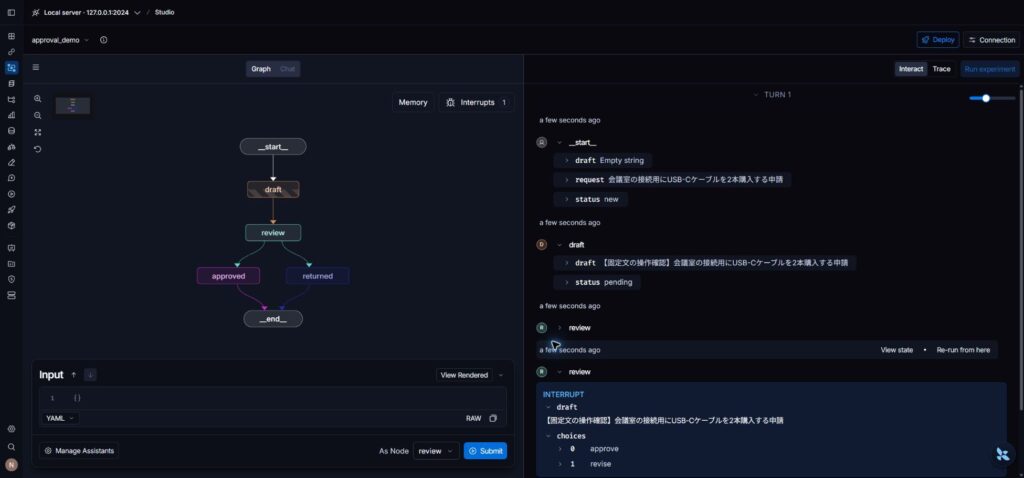
reviewに進むと、コード内のinterrupt()で再び停止し、下書きと選択肢が表示されました。デバッグ用のdraft直後の停止と、コードで定義した承認待ちは別の停止です。「Provide a value to resume execution」の入力欄に文字列の”approve”を入れ、「Resume」を押して再開します。
このStudio用コードは文字列を受け取るため、後のSQLite版で使う{“action”:”approve”}とは入力形式が異なります。”revise”を選ぶ経路はreturnedで終了する固定文の操作例です。モデルによる下書きの再生成は、「Human-in-the-loopの検証」で別に確認します。
再開後のStateを確認する
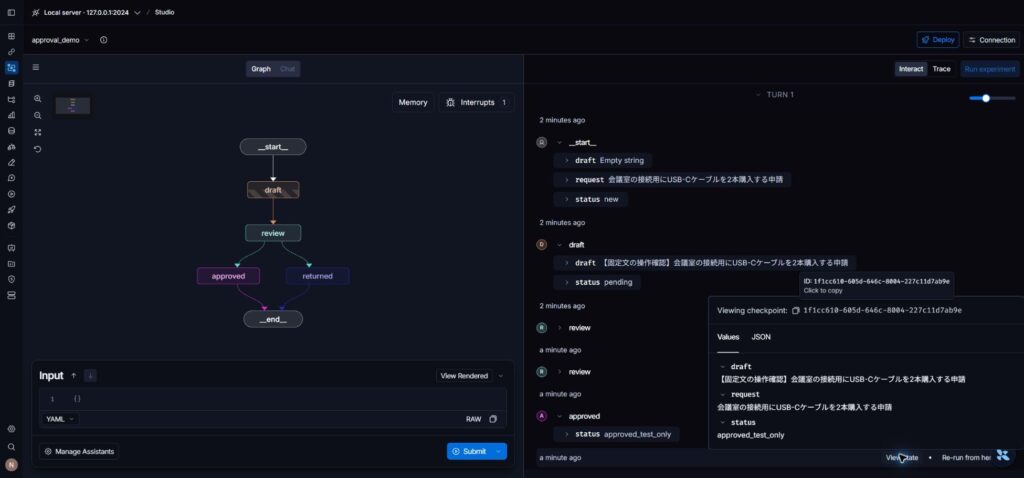
再開後はapprovedノードへ進み、statusがapproved_test_onlyになりました。「View state」を開くと、Valuesに下書き、申請内容、statusが表示されます。どこまで処理が進んだかと、現在の値を同じ画面で照合できました。本物の購買処理やモデルAPIは呼んでいません。操作の詳細はStudioの公式ガイドでも確認できます。
LangGraphの活用事例
以下は、2025年に公開されたLangChain公式の事例紹介に基づきます。各社の事例は特定のシステムでの利用実績であり、同じ構成を導入すれば同等の効果が出るという保証ではありません。
LinkedIn:採用支援エージェント
LinkedInのAI採用支援では、候補者の発見、マッチング、連絡といった処理にLangGraphを活用しています。採用の各手順を、一度の回答生成ではなく、連携する処理として扱う例です。※1
Uber:コード移行とテスト生成
Uberでは、コード移行やテスト生成などに特化したエージェントをLangGraphで連携させています。役割の異なる処理を組み合わせる使い方が参考になります。※1
Replit:コーディングエージェント
Replitはコーディングエージェントの実行基盤としてLangGraphを利用しています。複数段階の作業と人による確認を組み合わせる例として紹介されています。※1
Klarna:カスタマーサポートの処理分岐
Klarnaのカスタマーサポートでは、支払いや返金などの問い合わせに対応するエージェントの処理制御にLangGraphを使用しています。LangSmithによる評価も含め、質問内容に応じた経路の設計と運用を組み合わせた事例です。※3
LangGraphの検証
ここでは、会話を3回繰り返す処理、複数の役割による議論、人の承認を待つ処理を実装します。処理が予定どおり進むかという確認と、LLMが作る文章の品質評価は別の検証です。
2026年10月20日に、「LangGraphの使い方」と同じGPT-6 Lunaの設定で各例を実行しました。循環型処理と議論の例は、動画用にもモデルAPIを呼び出し、その実行画面を連続録画しています。以下の回答例は動画に対応する実行ログから引用しました。人の承認を挟む例は、先に行った実行結果です。固定応答の制御試験とは区別し、モデルの回答と保存された状態の変化を確認します。回答の正確さや処理速度を比較する試験ではありません。
LangGraphの循環型処理
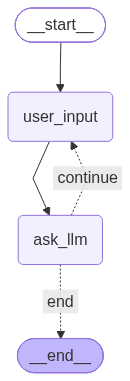
次へ進む先を返す関数と終了条件を組み合わせると、処理を繰り返せます。今回は「LangGraphって何?」「何ができるの?」「活用事例は?」を順に入力し、3回で終了させます。入力は自動で渡しますが、利用者の質問を順に受け取る会話の流れを想定した構成です。
クリックで表示
from langgraph.graph import START, END, StateGraph
from langchain_core.messages import HumanMessage, SystemMessage
from typing_extensions import TypedDict
from typing import Annotated, Literal
from langgraph.graph.message import add_messages

class LoopState(TypedDict):
    messages: Annotated[list, add_messages]
    count: int
    questions: list[str]

def build_loop(llm, checkpointer=None):
    def user_input(state: LoopState):
        return {"messages": [HumanMessage(content=state["questions"][state["count"]])]}

    def ask_llm(state: LoopState):
        reply = llm.invoke([
            SystemMessage(content="会話履歴を参照し、日本語で120文字程度で回答してください。知らない事実は推測しないでください。"),
            *state["messages"],
        ])
        return {"messages": [reply], "count": state["count"] + 1}

    def route(state: LoopState) -> Literal["continue", "end"]:
        return "end" if state["count"] >= len(state["questions"]) else "continue"

    builder = StateGraph(LoopState)
    builder.add_node("user_input", user_input)
    builder.add_node("ask_llm", ask_llm)
    builder.add_edge(START, "user_input")
    builder.add_edge("user_input", "ask_llm")
    builder.add_conditional_edges("ask_llm", route, {"continue": "user_input", "end": END})
    return builder.compile(checkpointer=checkpointer)

from langgraph.checkpoint.memory import InMemorySaver

app = build_loop(llm, InMemorySaver())
config = {"configurable": {"thread_id": "loop-example-1"}, "recursion_limit": 10}
initial = {
    "messages": [], "count": 0,
    "questions": ["LangGraphって何?", "何ができるの?", "活用事例は?"],
}
for update in app.stream(initial, config, stream_mode="updates"):
    print(update)
print(app.get_state(config).values["count"])
add_messagesは、発言を履歴へ追加・更新するためのReducerです。これがない場合、同じキーに返したリストは通常、前の値を置き換えます。終了判定のcountと会話履歴の両方を確認すると、ループ回数だけ合っていて履歴が失われる問題も見つけられます。
モデルAPIを使った実行でも、countが3、履歴が質問3件と回答3件の計6件、終了後の次ノードが空であることを確認しました。保存ログにある3件目の回答は、次のとおりです。
クリックで表示
たとえば、次のような用途があります。
問い合わせ対応:質問を分類し、必要に応じてFAQ検索や担当者への引き継ぎを行う
社内情報検索:検索結果を評価し、不足があれば再検索して回答する
文書処理:要約・分類・内容確認を段階的に進める
複数エージェントの連携:調査役とレビュー役などを協調させる
こうした流れを、状態を保ちながら制御できます。
動画では、各回答の後に読むための待機時間を8秒ずつ設けています。録画用スクリプトで表示と待機を加えたもので、上のコードにこの待機処理はありません。動画の長さをモデルの応答速度として扱うことはできません。
これはモデルが挙げた用途の例であり、企業への導入実績を確認した回答ではありません。実在する企業の事例は「LangGraphの活用事例」で別に紹介しています。InMemorySaverの保存先はメモリー上であり、プロセスを終了しても履歴を残す用途には適しません。
マルチエージェントでの議論
マルチエージェントとは、複数の役割を持つAIを連携させる構成です。基本的な考え方は、次の記事で解説しています。

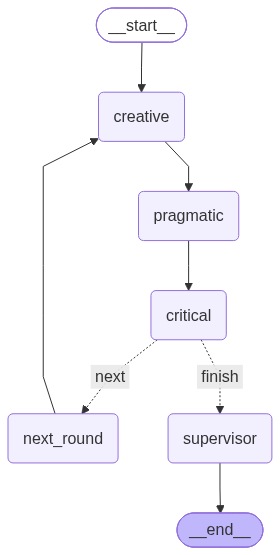
今回は創造的な提案、実行条件の検討、リスクの指摘を3ラウンド行い、最後にスーパーバイザーが整理する構成です。議題は従来例と同じ「10年後20年後の日本の経済成長について。」とします。生成された意見を、経済予測の根拠として扱うものではありません。
クリックで表示
from langgraph.graph import START, END, StateGraph
from langchain_core.messages import HumanMessage, SystemMessage
from typing_extensions import TypedDict
from typing import Literal

class DiscussionState(TypedDict):
    topic: str
    history: list[dict]
    round: int
    summary: str

ROLES = {
    "creative": "クリエイティブ思考者として、新しい案を一つ提示する。",
    "pragmatic": "実用主義者として、費用や実行条件から直前の案を検討する。",
    "critical": "批判的思考者として、直前の意見のリスクや未確認点を指摘する。",
}

def build_discussion(llm):
    def speaker(name):
        def node(state: DiscussionState):
            history = "\n".join(f"{x['role']}: {x['text']}" for x in state["history"])
            reply = llm.invoke([
                SystemMessage(content=ROLES[name] + "過去の発言を踏まえ、日本語で120文字程度。経済予測を事実として断定しない。"),
                HumanMessage(content=f"テーマ: {state['topic']}\nラウンド: {state['round']}\nこれまでの発言:\n{history}"),
            ])
            return {"history": [*state["history"], {"round": state["round"], "role": name, "text": reply.content}]}
        return node

    def next_round(state: DiscussionState):
        return {"round": state["round"] + 1}

    def route(state: DiscussionState) -> Literal["next", "finish"]:
        return "finish" if state["round"] >= 3 else "next"

    def supervisor(state: DiscussionState):
        history = "\n".join(f"{x['role']}: {x['text']}" for x in state["history"])
        reply = llm.invoke([
            SystemMessage(content="スーパーバイザーとして意見を整理する。合意点と未確認点を日本語で200文字程度。事実を追加しない。"),
            HumanMessage(content=f"テーマ: {state['topic']}\n発言:\n{history}"),
        ])
        return {"summary": reply.content}

    builder = StateGraph(DiscussionState)
    for name in ROLES:
        builder.add_node(name, speaker(name))
    builder.add_node("next_round", next_round)
    builder.add_node("supervisor", supervisor)
    builder.add_edge(START, "creative")
    builder.add_edge("creative", "pragmatic")
    builder.add_edge("pragmatic", "critical")
    builder.add_conditional_edges("critical", route, {"next": "next_round", "finish": "supervisor"})
    builder.add_edge("next_round", "creative")
    builder.add_edge("supervisor", END)
    return builder.compile()

app = build_discussion(llm)
initial = {
    "topic": "10年後20年後の日本の経済成長について。",
    "history": [], "round": 1, "summary": "",
}
for update in app.stream(initial, {"recursion_limit": 18}, stream_mode="updates"):
    print(update)
実行ログでは、3役の順序が3回繰り返され、9件の発言の後に整理の処理へ進んでいました。最終整理では、合意点と未確認点が分けて出力されています。以下は保存ログのsummaryの全文です。
合意点: AI導入や人材育成は生産性向上の可能性がある一方、成長を保証しない。費用対効果に加え、賃金・雇用の質や地域・企業規模による偏りを検証し、結果に応じて支援策を見直す必要がある。
未確認点: 比較対象・評価期間・公開範囲など、妥当な検証方法は未確定。効果の分配や、人口動態・エネルギー価格・国際情勢が成長に与える影響も不確実。同じモデルへ異なる役割を指示する実装であり、複数の独立した専門家が検証したことにはなりません。誤りを含む発言が後の発言へ引き継がれる点にも注意が必要です。
Human-in-the-loop(人の承認を挟むフロー)の検証
| 確認した項目 | モデルAPIを使った実行結果 |
|---|---|
| 下書き後の停止 | reviewで停止し、statusがpendingになった |
| 保存後の再構築 | SQLiteへの接続を開き直してもpendingを取得できた |
| 差し戻し | 修正指示を引き継ぎ、再び承認待ちになった |
| 承認 | approved_test_onlyになり、次の処理がなくなった |
| 実行の分離 | 別のthread_idから元の状態は取得されなかった |
業務への組み込みでは、AIが作った内容を確認する前に実行しない仕組みが重要です。ここでは架空の購買申請を使い、下書き→承認待ち→差し戻し→再確認→承認済みの記録という流れを作ります。本物の発注、支払い、基幹システムへの書き込みは行いません。
クリックで表示
from langgraph.graph import START, END, StateGraph
from langchain_core.messages import HumanMessage, SystemMessage
from typing_extensions import TypedDict
from typing import Literal
from langgraph.types import Command, interrupt

class ApprovalState(TypedDict):
    request: str
    draft: str
    feedback: str
    status: str
    revisions: int

def build_approval(llm, checkpointer=None):
    def draft(state: ApprovalState):
        reply = llm.invoke([
            SystemMessage(content="架空の購買申請の下書きを日本語120文字程度で作成。指定された品目・数量を守り、未指定の金額や承認者は作らない。"),
            HumanMessage(content=f"申請: {state['request']}\n修正指示: {state.get('feedback', '')}"),
        ])
        return {"draft": reply.content, "status": "pending"}

    def review(state: ApprovalState) -> Command[Literal["approved", "revise"]]:
        decision = interrupt({"draft": state["draft"], "choices": ["approve", "revise"]})
        if not isinstance(decision, dict) or decision.get("action") not in {"approve", "revise"}:
            raise ValueError("actionはapproveまたはreviseを指定してください")
        if decision["action"] == "approve":
            return Command(update={"status": "approved"}, goto="approved")
        if state.get("revisions", 0) >= 1:
            raise ValueError("この検証では差し戻しは1回までです")
        feedback = decision.get("feedback", "")
        if not isinstance(feedback, str) or not feedback.strip():
            raise ValueError("差し戻しにはfeedbackが必要です")
        return Command(update={"feedback": feedback, "revisions": state.get("revisions", 0) + 1}, goto="revise")

    def revise(state: ApprovalState):
        return {"status": "revising"}

    def approved(state: ApprovalState):
        # 本物の発注・基幹システムへの書き込みは行わない。
        return {"status": "approved_test_only"}

    builder = StateGraph(ApprovalState)
    builder.add_node("draft", draft)
    builder.add_node("review", review)
    builder.add_node("revise", revise)
    builder.add_node("approved", approved)
    builder.add_edge(START, "draft")
    builder.add_edge("draft", "review")
    builder.add_edge("revise", "draft")
    builder.add_edge("approved", END)
    return builder.compile(checkpointer=checkpointer)

from langgraph.checkpoint.sqlite import SqliteSaver

config = {"configurable": {"thread_id": "approval-example-1"}, "recursion_limit": 12}
initial = {
    "request": "検証用の購買申請。USB-Cケーブルを2本購入したい。金額は未定。",
    "draft": "", "feedback": "", "status": "new", "revisions": 0,
}
with SqliteSaver.from_conn_string("approval-example.sqlite") as saver:
    app = build_approval(llm, saver)
    paused = app.invoke(initial, config)
    print(paused["__interrupt__"])

# 別の接続で、同じthread_idの処理を再開する。
with SqliteSaver.from_conn_string("approval-example.sqlite") as saver:
    app = build_approval(llm, saver)
    print(app.get_state(config).values["status"])
    revised = app.invoke(Command(resume={
        "action": "revise", "feedback": "用途を『会議室の接続用』と追記してください。",
    }), config)
    print(revised["__interrupt__"])
    approved = app.invoke(Command(resume={"action": "approve"}), config)
    print(approved["status"])
interrupt()は処理を中断して判断を待ち、Command(resume=…)は判断結果を渡して再開します。再開には、保存先と同じthread_idが必要です。thread_idは一連の実行を識別する値であり、利用者を認証する仕組みではありません。実運用では、誰がどの申請を承認できるかを別途制御します。
判断結果は、検証用コードからあらかじめ決めた値を外部入力として渡しています。人が操作した承認画面や本番の権限管理まで確認した結果ではありません。差し戻しはこの例では1回に制限し、同じ識別子で実験をやり直す場合は保存済みの状態を確認します。
実際に生成された最初の下書きは、次のとおりです。
検証用の購買申請として、USB-Cケーブルを2本購入したく、申請いたします。金額は未定のため、確定後に記載します。用途と必要数をご確認のうえ、手続きをお願いいたします。SQLiteの接続を開き直した後もpendingを取得できました。「用途を『会議室の接続用』と追記してください。」を渡して差し戻すと、下書きは次の内容に変わり、再び承認待ちで停止しました。
購買申請の下書き:検証用として、会議室の接続用にUSB-Cケーブルを2本購入したく、申請いたします。金額は未定です。進め方をご確認ください。続けて承認の値を渡すとstatusがapproved_test_onlyになりました。これは検証用の状態を更新した結果であり、購買手続きが完了したことを意味しません。
公式のinterrupt解説では、再開時にノードが先頭から実行される点も説明されています。中断前にメール送信や発注などを行うと重複するおそれがあるため、承認前後の副作用を分け、重複実行を防ぐ設計が必要です。
LangGraphが向いている業務・向いていない業務
| 向いている業務 | 向いている理由 | 別途設計すること |
|---|---|---|
| 申請書の下書きと承認 | 承認待ちや差し戻しを経路として持てる | 承認権限、変更履歴、二重実行の防止 |
| 問い合わせの分類と担当振り分け | 内容に応じて調査・回答・引き継ぎを分けられる | 判断基準、誤分類時の対応、個人情報の扱い |
| 基幹システムと連携する複数段階の処理 | 実行途中の状態と再開経路を定義できる | 認証、データ整合性、失敗時の復旧 |
選ぶ際は、回答の生成だけで済むか、途中の判断や実行状態まで管理する必要があるかを考えます。表は用途を考えるための例であり、導入済みの顧客事例ではありません。
一方、単発の質問応答や、資料を検索して一度回答するだけの単純なRAGでは、モデルAPIやLangChainの構成で足りる場合があります。分岐や保存の管理を増やす分、実装と運用の負担も生じます。まず必要な処理を洗い出し、LangGraphで管理する範囲を決めましょう。
運用時は、LangSmithなどで実行履歴を追い、代表的な入力に対する評価を続けます。ログが取れることと、回答が正しいことは別です。誤回答率、承認者の修正内容、処理失敗などを業務に合わせて確認し、機密情報の記録範囲も決めます。
業務に合わせたエージェント開発や連携の考え方については、次の記事も参考にしてください。
生成AI開発・業務活用ならWEELへご相談ください
LangGraphによる複雑な処理フローの制御が、貴社のAI活用にどれだけ寄与するかを検証してみませんか?
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
LangGraphに関するよくある質問