Qwen-Audio-3.1とは?最大95%値下げの音声AI5モデルの性能・料金・使い方を徹底解説
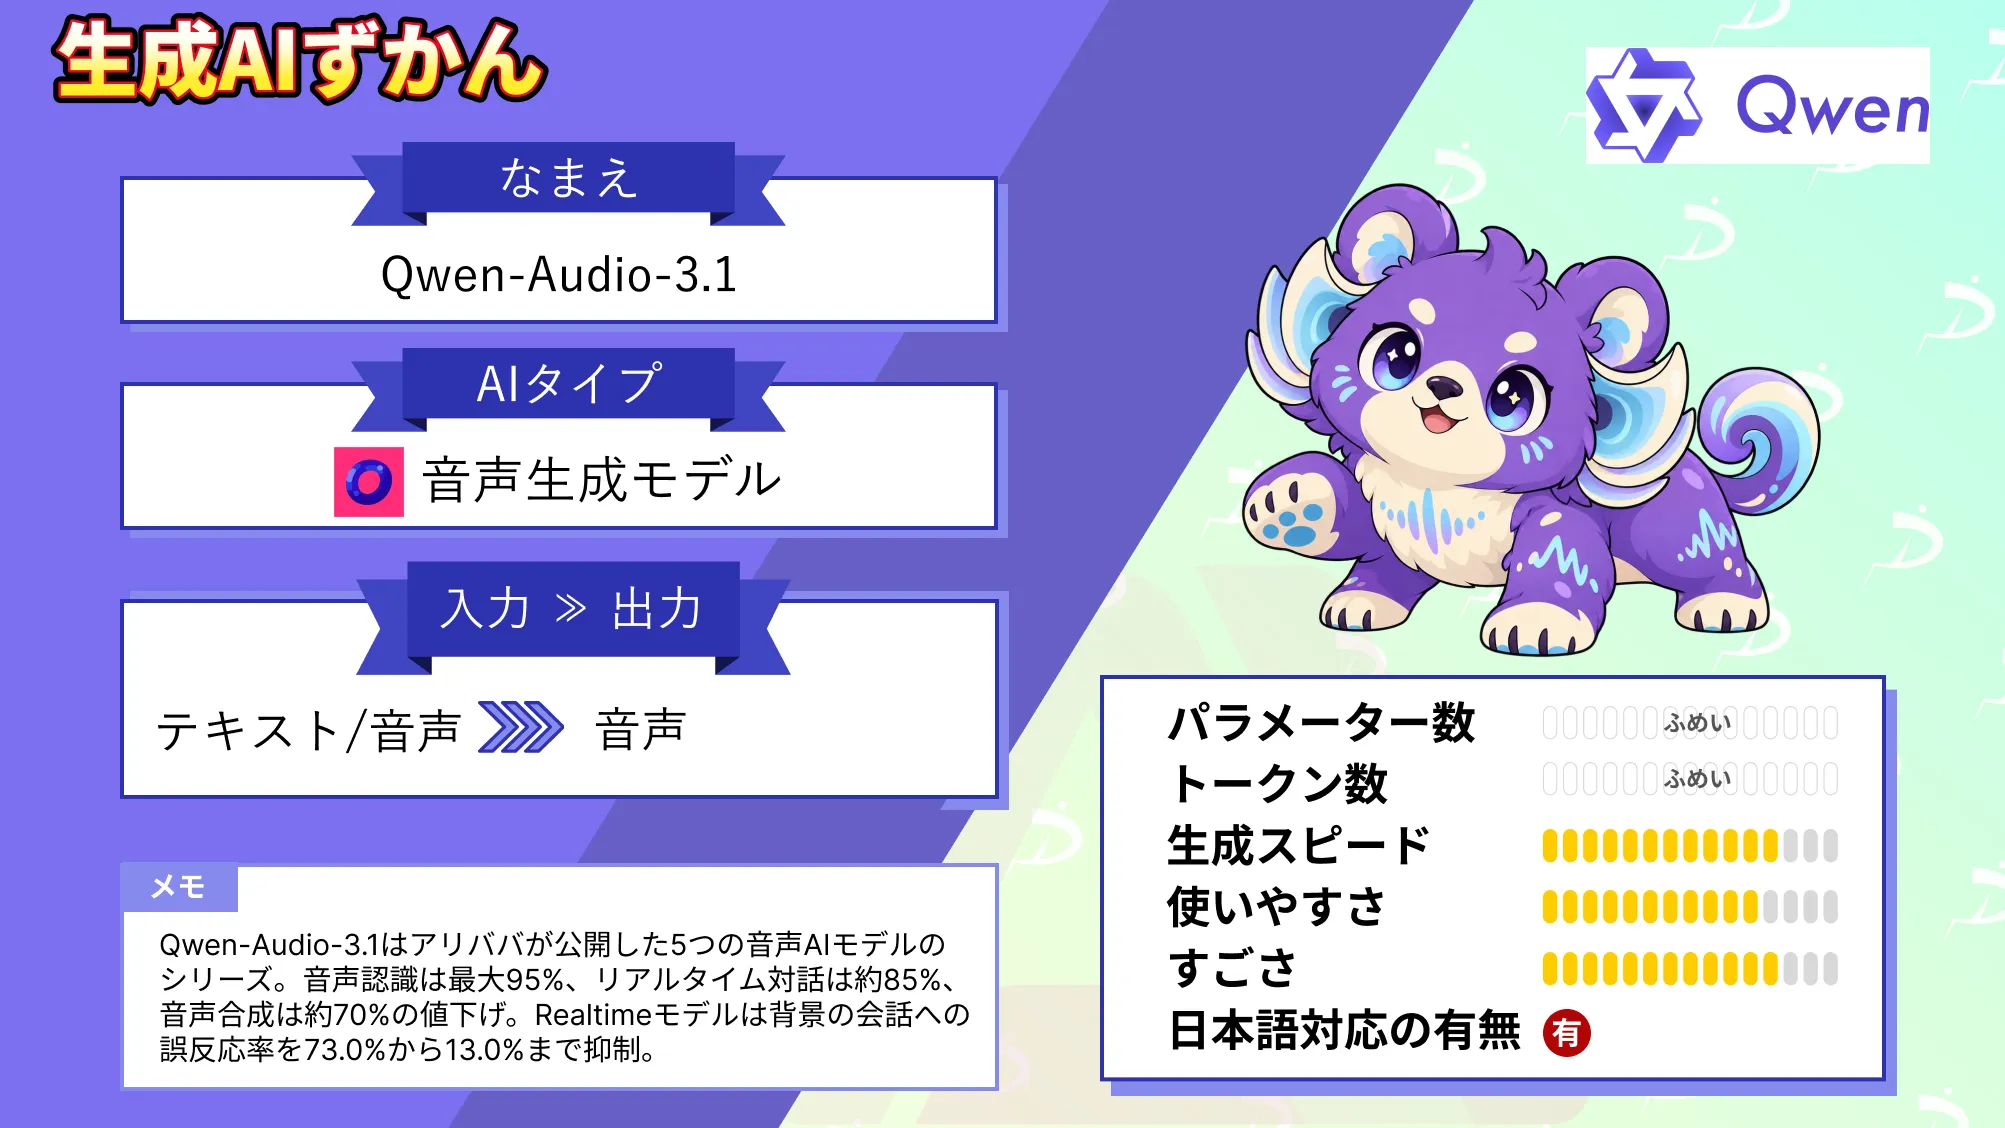
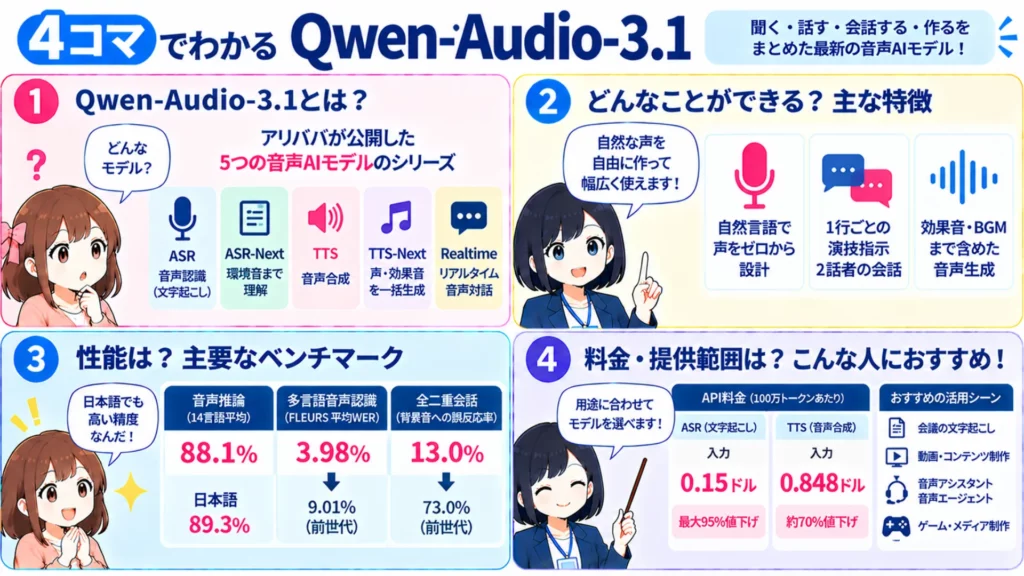
- Qwen-Audio-3.1はアリババが公開した5つの音声AIモデルのシリーズ
- 音声認識は最大95%、リアルタイム対話は約85%、音声合成は約70%の値下げ
- Realtimeモデルは背景の会話への誤反応率を73.0%から13.0%まで抑制
2026年9月23日、アリババのQwenチームが音声AIの新シリーズ「Qwen-Audio-3.1」を公開しました!
今回のリリースでは、音声認識・音声合成・リアルタイム対話の3モデルがまとめて強化されています。さらに、音声を丸ごと理解する「ASR-Next」と効果音まで一括で作れる「TTS-Next」も新登場。加えて、音声認識のAPI料金は最大95%も値下げされており、公式ポストは2026年9月時点で3.8万回以上表示されるなど、音声エージェントを作りたい開発者から熱い視線が注がれているのです。
とはいえ、「5つもモデルがあってどれを使えばいいの?」「日本語でもちゃんと使える?」と気になっている方も多いのではないでしょうか。
そこで本記事では、Qwen-Audio-3.1の概要・仕組み・性能・料金・ライセンスから、APIでの具体的な使い方までまとめて解説します。最後まで読めば、自社の音声業務にどのモデルを組み込むべきか判断できるはず。ぜひご覧ください!
\生成AIを活用して業務プロセスを自動化/
Qwen-Audio-3.1とは?
Qwen-Audio-3.1は、アリババのQwenチームが開発した「聞く・話す・会話する・作る」をひとまとめにした音声AIモデルのシリーズです。まずは5つのモデルの役割と提供形態を整理していきましょう。
今回のシリーズは、既存の3モデルをアップグレードしたものと、新しく追加された2モデルの計5つで構成。音声を文字に起こす「ASR」、テキストを読み上げる「TTS」、話しながら聞ける全二重の会話モデル「Realtime」が既存モデルの強化版にあたります。
一方で新しく登場したのは、話し声だけでなく環境音や機械音まで理解する「ASR-Next」と、声・効果音・背景音を1回の生成でまとめて作る「TTS-Next」です。Qwen公式は、この5モデルで理解・生成・対話・創作までをカバーする音声スタックが完成したと説明しています。
| モデル | 主な役割 | APIのモデルID(2026年9月28日時点) |
|---|---|---|
| Qwen-Audio-3.1-ASR | 音声認識(文字起こし) | qwen-audio-3.1-asr-flash、qwen-audio-3.1-asr-flash-filetransなど |
| Qwen-Audio-3.1-ASR-Next | 話者・感情・環境音まで含む音声理解 | API未公開(公式は近日公開と案内) |
| Qwen-Audio-3.1-TTS | 多言語・方言対応の音声合成 | qwen-audio-3.1-tts-flash |
| Qwen-Audio-3.1-TTS-Next | 声・効果音・背景音の一括生成 | qwen-audio-3.1-tts-next |
| Qwen-Audio-3.1-Realtime | 全二重のリアルタイム音声対話 | qwen-audio-3.1-realtime-plus |
Qwen-Audio-3.1の仕組み
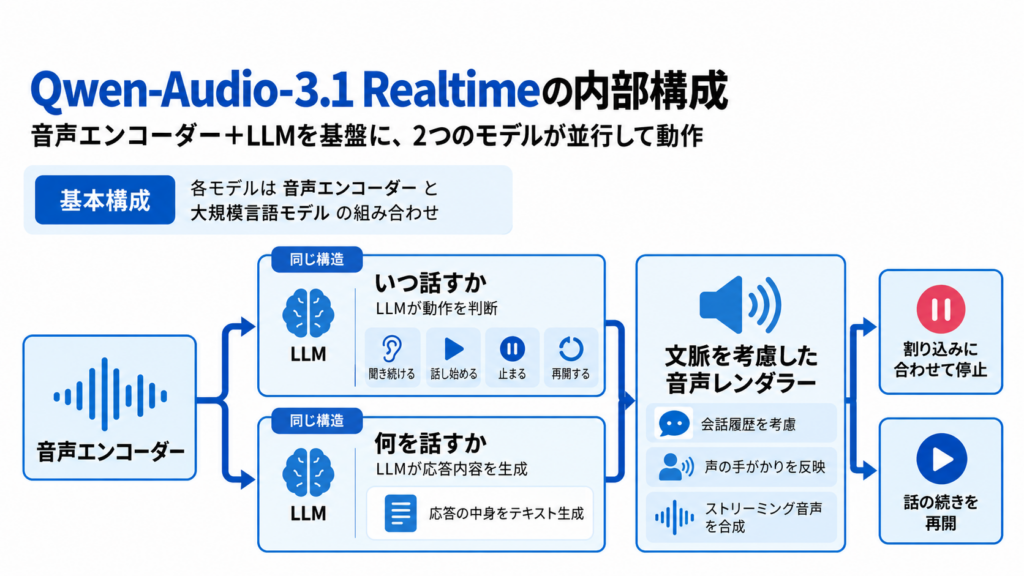
Qwen-Audio-3.1の各モデルは、音声を扱うエンコーダーと大規模言語モデルを組み合わせた構成が基本です。ここでは、技術レポートが公開されているRealtimeを中心に、内部の動きを見ていきます。
Realtimeは2つのモデルが役割分担している
Qwen-Audio-3.1-Realtimeの技術レポートによると、Realtimeの中では「いつ話すか」を決めるモデルと「何を話すか」を決めるモデルが並行して動いています。
どちらも音声エンコーダーの後ろにLLMをつないだ同じ構造を採用。前者は「聞き続ける・話し始める・止まる・再開する」のどれを選ぶかを判断します。後者は応答の中身をテキストとして生成する役割です。
最後に「文脈を考慮した音声レンダラー」が、会話履歴や声の手がかりを踏まえてストリーミング音声を合成します。この分業のおかげで、相手の割り込みに合わせて話すのをやめたり、話の続きを再開したりできるわけです。
Think・Act・Speak and Coordinateの3層で学習
技術レポートでは、Realtimeの学習が「Think」「Act」「Speak and Coordinate」という3つの層で整理されています。
Thinkは、テキストLLMの推論力を音声モデルへ移すための土台です。約100万時間分の音声とテキストのペアデータを使った教師ありファインチューニングに、オンポリシー蒸留を組み合わせています。
Actは、ツールやデータベースを備えた実行環境の中で、強化学習(GRPO)を使ってタスク完遂を学ぶ段階。そしてSpeak and Coordinateでは、どう話すか・いつ話すか・そもそも話すべきかという会話の振る舞いをそろえていくのです。
TTS-NextとASRの構成
音声生成を担うTTS-Nextは、Qwen公式のXポストで言語モデルと拡散モデルを統合したフレームワークと説明されています。テキストや参照音声をもとに、声・効果音・背景音を1回のパスでまとめて出力できるのが強み。
一方のASRは、話者ラベル・タイムスタンプ・テキストを同時に出力するエンドツーエンド構成を採用しているとのこと。短い相づちや声の重なりも残したまま、会議やインタビューを構造化した記録として書き出せます。
Qwen-Audio-3.1の特徴
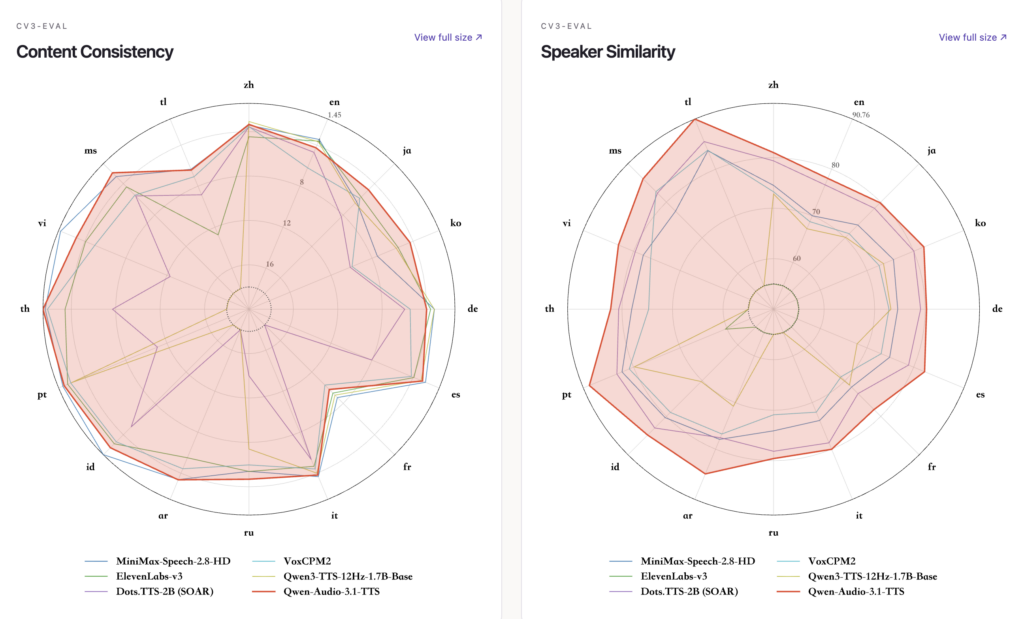
Qwen-Audio-3.1の強みは、単に音声がきれいなだけでなく、会話の空気を読んで動ける点にあります。ここからは、公式の技術レポートや発表で示された数値をもとに、具体的な特徴を見ていきましょう。
日本語を含む多言語の音声推論が大きく向上
技術レポートでは、音声による推論問題「Big Bench Audio」を14言語に翻訳した独自評価の結果が公開されています。3.1の14言語平均は88.1%で、比較対象のGPT-Realtime-2(82.1%)を上回りました。
注目したいのが日本語のスコアです。日本語の正答率は89.3%で、GPT-Realtime-2の79.8%を約10ポイント上回っています。
多言語の音声認識でも伸びが目立ち、FLEURSでの平均単語誤り率は3.0の9.01%から3.98%まで改善。英語のLibriSpeechでも、test-cleanで1.19%、test-otherで2.31%という低い誤り率を記録しました。
周りの雑談に反応しにくい全二重会話
リアルタイム対話で地味に困るのが、テレビの音や隣の会話にAIが反応してしまう問題でしょう。3.1では、Full-Duplex-Bench v1.5の「背景音声」タスクにおける応答率が73.0%から13.0%まで下がりました。
ユーザーが別の方に話しかけている場面でも、応答率は13.0%から3.0%に低下しています。つまり、AIが空気を読んで黙っていられるようになったということです。
さらに、社内評価の複数人会話テストでは、セッション単位の合格率が8%から96%へと跳ね上がりました。オフィスや店頭のように、複数の方が同時に話す環境でも使いやすくなったといえるでしょう。
音声からのツール実行がより確実に
音声で依頼を受けて、外部ツールを呼び出すエージェント性能も底上げされています。τ-Voiceを半二重の音声→テキスト形式に置き換えた独自評価では、タスク成功率が78.4%から82.0%に向上しました。
音声からの関数呼び出しを測るSpeechFCEvalでは86.00%を記録し、GPT-Realtime-2の70.74%を大きく上回る結果に。
Web検索を使う場面での検索クエリ数も、平均4.37回から1.05回まで減りました。無駄な検索が減れば、そのぶん応答の待ち時間やコストも抑えやすくなるでしょう。
方言にも強い高精度な文字起こし
アリババの発表によると、ASRは公開されている中国語方言テストセット「KeSpeech」「WSYue」で平均文字誤り率4.55%を記録し、11のサブセットのうち6つで比較対象のモデルを上回りました。
ストリーミング認識では、最初の文字が返ってくるまでの時間が約160ミリ秒とされています。文字起こしのあとに「えーと」などのフィラーや言い直しを取り除く整形機能も備えており、読みやすいテキストをそのまま受け取れるのもうれしいポイントです。
Qwen-Audio-3.1の安全性・制約
Qwen-Audio-3.1は安全性の面でも前世代から改善されていますが、使い始める前に押さえておきたいリージョンや言語まわりの制約もいくつかあります。
安全性評価の結果
技術レポートによると、Realtimeは中国語と英語の多ターン攻撃テストにおいて、攻撃成功率を中国語で80.5%から26.0%、英語で63.5%から23.5%まで引き下げました。
有害な依頼への対応を測るDo-Not-Answerでも、安全な応答率は94.99%に到達。一方、5名のテスターによる50セッションのレッドチーム評価では、安全な対応率が92.00%にとどまり、GPT-Realtime-2の96.00%には届いていません。
レポート自身も、評価の多くは合成音声で行われており、実際の録音環境での検証はまだ足りないと認めています。
利用前に押さえたい制約
まず、割り込まれたときに話すのをやめるまでの時間は約1.1秒で、GPT-Realtime-2の約0.38秒より遅めです。テンポの速い対話では、このわずかな差が気になるかもしれません。
また、Realtimeで保持できる履歴は最大50ターン・音声300秒まで。Web検索とFunction Callingも同時には有効化できない仕様です。
さらに、TTSとTTS-Nextは2026年9月28日時点で中国(北京)リージョンのみの提供となっており、TTS-Nextの対応言語は中国語と英語に限られます。生成音声には、パラメータでAI生成の識別透かしを付けられる点も覚えておきましょう。
Qwen-Audio-3.1の料金
Qwen-Audio-3.1は、モデルごとにトークン単位の従量課金となっています。値下げ幅については、TTSが約70%、Realtimeが約85%、ASRが最大95%とされています。
以下は、Model Studioの各モデルページに掲載されている定価(プロモーション価格を除く)をまとめたものになります。
| モデルID | リージョン | 入力(100万トークンあたり) | 出力(100万トークンあたり) |
|---|---|---|---|
| qwen-audio-3.1-asr-flash | シンガポール | 0.15ドル | 0.47ドル |
| qwen-audio-3.1-asr-flash-filetrans | シンガポール | 0.15ドル | 0.47ドル |
| qwen-audio-3.1-asr-flash-streaming | シンガポール | 0.93ドル | 0.70ドル |
| qwen-audio-3.1-asr-flash-message | シンガポール | 0.93ドル | 0.70ドル |
| qwen-audio-3.1-tts-flash | 中国(北京) | 1.5元 | 12元 |
| qwen-audio-3.1-tts-next | 中国(北京) | 0.848ドル | 1.696ドル |
| qwen-audio-3.1-realtime-plus | シンガポール | テキスト0.8ドル・音声6.4ドル | テキスト6.4ドル・音声24ドル |
Qwen-Audio-3.1のライセンス
Qwen-Audio-3.1はオープンソースではなく、アリババクラウドの規約に沿って使うクローズドなAPIサービスとして提供されています。
| 利用用途 | 可否 | 備考 |
|---|---|---|
| 商用利用 | ⭕️ | 有料APIとしての利用が前提。試用サービスで生成した音声は商用利用不可 |
| 改変 | ❌ | モデルの重みが非公開のため、モデル本体の改変は不可 |
| 再配布 | ❌ | モデル本体は配布されていない |
| 特許使用 | – | |
| 私的利用 | ⭕️ |
Qwen-Audio-3.1の使い方
Qwen-Audio-3.1は、Alibaba Cloud Model StudioのAPIから利用する形です。ここからは、準備から文字起こし・音声生成・リアルタイム会話までを、公式ドキュメントのコードをもとに順番に紹介します。
APIキーとWorkspace IDを用意する
まずはアリババクラウドのアカウントを作成し、Model Studioを有効化しましょう。
続いて、コンソールからAPIキーを発行し、あわせてWorkspace IDも控えておきます。APIキーはシンガポールと北京でリージョンごとに異なるため、使いたいモデルの提供リージョンに合わせて発行してください。
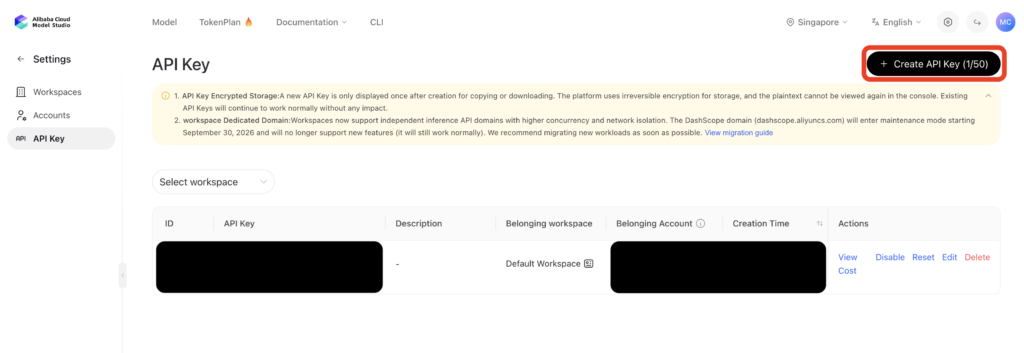
発行したキーは、環境変数に設定しておくと便利です。
export DASHSCOPE_API_KEY="sk-xxxx"
export SFM_WORKSPACE_ID="your-workspace-id"
また、Python SDKを使う場合は、DashScope SDKもインストールしておきます。
pip install -U dashscope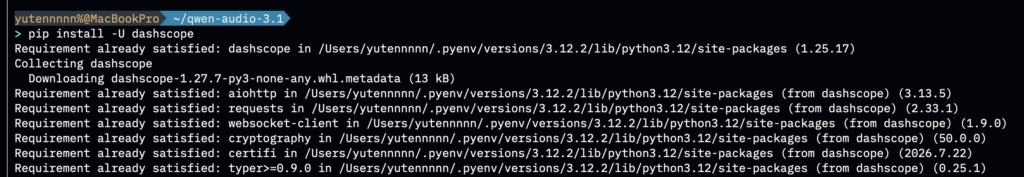
5分以内の音声を文字起こしする
短い音声ファイルなら、qwen-audio-3.1-asr-flashを同期呼び出しで使うのが手軽です。以下は公式ドキュメントに掲載されているcURLの例で、音声ファイルのURLを渡すだけで文字起こし結果が返ってきます。
curl --location --request POST 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation' \
     --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
     --header "Content-Type: application/json" \
     --header "X-DashScope-SSE: disable" \
     --data '{
    "model": "qwen-audio-3.1-asr-flash",
    "input": {
        "messages": [
            {
                "role": "user",
                "content": [
                    {
                        "type": "input_audio",
                        "input_audio": {
                            "data": "{YOUR_AUDIO_URL}"
                        }
                    }
                ]
            }
        ]
    },
    "parameters": {
        "format": "wav",
        "sample_rate": "16000"
    }
}'レスポンスは通常のマルチモーダル応答と構造が異なり、認識結果はoutput.textに格納される仕様です。choicesフィールドは存在しないので、パース処理を書くときに注意してください。
長時間の会議音声を文字起こしする
1時間を超える会議録音などは、非同期で処理するqwen-audio-3.1-asr-flash-filetransを使います。1ファイルあたり最大12時間・2GBまで対応しており、タスクを投げてから結果を取りに行く流れです。
from http import HTTPStatus
from dashscope.audio.asr import Transcription
from urllib import request
import dashscope
import os
import json

dashscope.base_http_api_url = 'https://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api/v1'
dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

task_response = Transcription.async_call(
    model='qwen-audio-3.1-asr-flash-filetrans',
    file_urls=['{YOUR_AUDIO_URL}'],
    language_hints=['ja']
)

transcription_response = Transcription.wait(task=task_response.output.task_id)

if transcription_response.status_code == HTTPStatus.OK:
    for transcription in transcription_response.output['results']:
        if transcription['subtask_status'] == 'SUCCEEDED':
            url = transcription['transcription_url']
            result = json.loads(request.urlopen(url).read().decode('utf8'))
            print(json.dumps(result, indent=4, ensure_ascii=False))
        else:
            print('transcription failed!')
            print(transcription)
else:
print('Error: ', transcription_response.output.message)結果のJSONには、文ごと・単語ごとのタイムスタンプがミリ秒単位で含まれます。話者を区別したい場合は、リクエストにdiarization_enabledをtrueで指定しましょう。ただし、話者分離を有効にする場合、音声は2時間以内に収めるのが公式の推奨です。
効果音つきの音声を生成する
TTS-Nextは北京リージョンのエンドポイントから呼び出します。text_promptに場面の説明やセリフを書くだけで、声と効果音をまとめた音声ファイルが生成される仕組みです。
curl --request POST \
  "https://$SFM_WORKSPACE_ID.cn-beijing.maas.aliyuncs.com/api/v1/services/audio/tts/SpeechSynthesizer" \
  --max-time 300 \
  --header "Authorization: Bearer $DASHSCOPE_API_KEY" \
  --header 'Content-Type: application/json' \
  --data '{
    "model": "qwen-audio-3.1-tts-next",
    "input": {
      "text_prompt": "A woman clearly says: Hello, welcome.",
      "format": "wav",
      "sample_rate": 48000,
      "channels": 2
    }
}'レスポンスのoutput.audio.urlから音声をダウンロードできます。このURLの有効期限は24時間のため、生成したらすぐに保存しておきましょう。
マイクでリアルタイム会話する
Realtimeは、WebSocketでつないだまま音声を送り続ける仕組みです。公式のクイックスタートでは、PyAudioとwebsocketsを使ったサンプルが公開されています。
pip install pyaudio websockets以下のコードをrealtime_quickstart.pyとして保存し、実行してください。
import asyncio
import base64
import json
import os
import pyaudio
import websockets

API_KEY = os.environ["DASHSCOPE_API_KEY"]
URL = "wss://{WorkspaceId}.ap-southeast-1.maas.aliyuncs.com/api-ws/v1/realtime?model=qwen-audio-3.1-realtime-plus"

pya = pyaudio.PyAudio()
mic = pya.open(format=pyaudio.paInt16, channels=1, rate=16000, input=True)
spk = pya.open(format=pyaudio.paInt16, channels=1, rate=24000, output=True)

async def main():
    headers = {"Authorization": f"Bearer {API_KEY}"}
    async with websockets.connect(URL, additional_headers=headers) as ws:
        await ws.send(json.dumps({
            "type": "session.update",
            "session": {
                "modalities": ["text", "audio"],
                "voice": "longanqian_v3.1",
                "turn_detection": {
                    "type": "server_vad",
                    "threshold": 0.5,
                    "silence_duration_ms": 800
                }
            }
        }))

        async def send_audio():
            while True:
                data = await asyncio.to_thread(mic.read, 3200, False)
                await ws.send(json.dumps({
                    "type": "input_audio_buffer.append",
                    "audio": base64.b64encode(data).decode()
                }))
                await asyncio.sleep(0.02)

        async def recv_events():
            async for msg in ws:
                event = json.loads(msg)
                t = event["type"]
                if t == "response.audio.delta":
                    audio = base64.b64decode(event["delta"])
                    await asyncio.to_thread(spk.write, audio)
                elif t == "conversation.item.input_audio_transcription.completed":
                    print(f"[You] {event['transcript']}")
                elif t == "response.audio_transcript.done":
                    print(f"[AI] {event['transcript']}")
                elif t == "error":
                    print(f"[Error] {event['error']['message']}")

        await asyncio.gather(send_audio(), recv_events())

if __name__ == "__main__":
    try:
        asyncio.run(main())
    except KeyboardInterrupt:
        mic.close()
        spk.close()
pya.terminate()turn_detectionのtypeをsmart_turnに変えると、「えーと」のようなフィラーで会話が途切れにくい意味ベースのターン判定に切り替わります。なお、声の種類(voice)は最初のsession.updateでしか設定できない点に気をつけてください。
【業界別】Qwen-Audio-3.1の活用シーン
Qwen-Audio-3.1は、文字起こしから音声生成、リアルタイム会話まで1つのシリーズでそろうため、業界を問わず幅広く活用できるのが魅力です。ここからは、相性のよい業界をピックアップして紹介します。
コールセンター・カスタマーサポート
コールセンターでは、Realtimeを使った一次対応の自動化が有力な使い道になるでしょう。音声で受けた依頼をそのままツール呼び出しにつなげられるので、予約確認や注文状況の照会といった定型的な問い合わせを任せやすくなります。
通話後は、ASR-Flash-Filetransで録音をまとめて文字起こしし、対応品質のチェックに回す流れも組めるはずです。ASR-Flash-Filetransには禁止ワードを伏せ字にするフィルタ機能もあるため、応対記録を社内で共有する際にも役立ちます。
コールセンターにおける生成AI導入について、詳しく知りたい方は以下の記事も参考にしてみてください。

動画制作・メディア
動画やポッドキャストの制作現場では、TTS-Nextが心強い味方になるでしょう。ナレーション・効果音・環境音を別々に用意して重ねる作業を、1回の生成で済ませられる可能性があるからです。
ASR側の字幕づくりにも注目。タイムスタンプつきの文字起こしが標準で返ってくるので、字幕ファイルの作成を効率化できるでしょう。ただし、TTS-Nextは中国語と英語のみの対応のため、日本語ナレーションにはTTS-Flashを使うなどの使い分けが必要になります。
広告業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
教育・語学学習
語学学習アプリでは、RealtimeとTTSの多言語対応が活かせます。TTSは同じ声のまま複数の言語を話し分けられるため、講師キャラクターの声を統一したまま多言語の教材を作れるのが魅力です。
Realtimeを使えば、学習者と音声で自然にやり取りする会話練習パートナーも実現できるでしょう。会話の流れに合わせて口調や感情を調整してくれるので、単調になりがちな反復練習も続けやすくなりそうです。研究用途でも、方言や多言語の音声データを扱う実験の下準備に役立つでしょう。
教育業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。

【課題別】Qwen-Audio-3.1が解決できること
次に、Qwen-Audio-3.1がどんな業務課題を解決できるのかを、課題ごとに整理しました。自社の困りごとに当てはまるものがないか、チェックしてみてください。
会議の議事録作成にかかる手間を減らせる
会議のたびに録音を聞き直して議事録を作るのは、想像以上に時間がかかる作業です。Qwen-Audio-3.1のASRなら、話者ラベル・タイムスタンプ・テキストをまとめて出力してくれるのが強み。
さらに、フィラーや言い直しを取り除く整形機能もあるため、そのまま読める形に近い文字起こしが手に入ります。あとは生成AIのLLMで要約をかければ、議事録作成の大部分を自動化できるでしょう。会議後すぐに要点を共有できれば、決定事項の抜け漏れも防ぎやすくなります。
多言語・方言の問い合わせに1つのモデルで対応できる
海外のお客さまや地方の拠点からの問い合わせに対応するため、言語ごとに別の音声認識サービスを契約している企業も多いのではないでしょうか。
Qwen-Audio-3.1のASRは、1つのモデルで30言語と16種類の中国語方言に対応している点がポイント。中国語と英語が混ざる会話もスムーズに切り替えて認識できるので、窓口ごとにシステムを分けていた運用をまとめられる可能性があります。契約や保守の窓口を一本化できれば、管理の手間も減らせるでしょう。
音声素材の制作コストを抑えられる
ナレーターへの依頼や効果音の購入など、音声素材の制作には何かとコストがかかるもの。TTS-Nextを使えば、セリフと効果音、環境音をまとめて生成できるため、試作段階の音声づくりを社内で完結させやすくなります。
TTS-Flashも、指示文で感情や話す速さを細かく調整できる仕様です。本番収録の前に、複数のトーンの案を短時間でそろえて比較するといった使い方にも向いているでしょう。社内確認用の仮音声をすばやく作れるだけでも、制作の進行はぐっと楽になります。
【実践】Qwen-Audio-3.1を使ってみた
ここからは、実際にQwen-Audio-3.1をAPIから呼び出して、その実力を確かめていきましょう。今回はRealtimeを選び、日本語でのリアルタイム会話を検証してみます。
Realtimeと日本語でリアルタイム会話してみる
設定は、出張の段取りを相談できる音声アシスタントです。確かめたいのは、日本語で質問したときに、どこまで自然な受け答えが返ってくるかという点になります。
コードはこちら
import asyncio
import base64
import json
import os

import pyaudio
import websockets

API_KEY = os.environ["DASHSCOPE_API_KEY"]
WORKSPACE_ID = os.environ["SFM_WORKSPACE_ID"]
URL = (
    f"wss://{WORKSPACE_ID}.ap-southeast-1.maas.aliyuncs.com"
    "/api-ws/v1/realtime?model=qwen-audio-3.1-realtime-plus"
)

INSTRUCTIONS = (
    "あなたは出張の段取りを手伝う日本語の音声アシスタントです。"
    "やさしく自然な口調で、要点を短くまとめて答えてください。"
    "絵文字や記号、Markdownは使わず、話し言葉だけで答えてください。"
)

pya = pyaudio.PyAudio()
mic = pya.open(format=pyaudio.paInt16, channels=1, rate=16000, input=True)
spk = pya.open(format=pyaudio.paInt16, channels=1, rate=24000, output=True)


async def main():
    headers = {"Authorization": f"Bearer {API_KEY}"}
    async with websockets.connect(URL, additional_headers=headers) as ws:
        await ws.send(json.dumps({
            "type": "session.update",
            "session": {
                "modalities": ["text", "audio"],
                "voice": "longanqian_v3.1",
                "instructions": INSTRUCTIONS,
                "turn_detection": {"type": "smart_turn"},
            },
        }))

        async def send_audio():
            while True:
                data = await asyncio.to_thread(mic.read, 3200, False)
                await ws.send(json.dumps({
                    "type": "input_audio_buffer.append",
                    "audio": base64.b64encode(data).decode(),
                }))
                await asyncio.sleep(0.02)

        async def recv_events():
            async for msg in ws:
                event = json.loads(msg)
                t = event["type"]
                if t == "response.audio.delta":
                    audio = base64.b64decode(event["delta"])
                    await asyncio.to_thread(spk.write, audio)
                elif t == "conversation.item.input_audio_transcription.completed":
                    print(f"[あなた] {event['transcript']}")
                elif t == "response.audio_transcript.done":
                    print(f"[AI] {event['transcript']}")
                elif t == "conversation.item.ambient_audio_transcription.delta":
                    print(f"[聞き流した音] {event.get('text', '')}")
                elif t == "error":
                    print(f"[エラー] {event['error']['message']}")

        await asyncio.gather(send_audio(), recv_events())


if __name__ == "__main__":
    try:
        asyncio.run(main())
    except KeyboardInterrupt:
        mic.close()
        spk.close()
        pya.terminate()
        print("会話を終了しました")
準備ができたら、ターミナルで以下のコマンドを実行します。
python realtime_ja_test.py起動したら、マイクに向かって次のように話しかけてみました。
来週の大阪出張で、新幹線の移動中にできる作業を3つ提案して。出力結果はこちら
こちらの発話はほぼ正確に文字起こしされましたが、回答は資料の修正やメール返信といった一般的な内容にとどまり、出張ならではの具体的な提案までは届かない印象です。今回の検証においては、日本語精度もあまり高くない印象でした。
生成AI開発・業務活用ならWEELへご相談ください
Qwen-Audio-3.1は、音声認識・音声合成・リアルタイム会話・音声理解・音声生成の5モデルをそろえた、アリババの最新音声AIシリーズです。日本語を含む多言語での音声推論や、背景の雑談に反応しにくい全二重会話が大きく強化されました。ASRは最大95%、Realtimeは約85%という大幅な値下げも重なり、これまでコスト面で導入を見送っていた企業にとっても現実的な選択肢になっています。
一方で、リージョンや対応言語、規約面の制約もあるため、自社の業務に合う構成を見極めることが欠かせません。まずは無料枠や小さなPoCから、自社に合う使い方を探ってみてください。
弊社では、AI導入を検討中の企業向けに、業務効率化や新しい価値創出を支援する情報提供・導入支援を行っています。最新のAIを活用し、効率的な業務改善や高度な分析が可能です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
よくある質問