【Deepgram】文字起こしから感情分析までできる全能音声AIを使ってみた
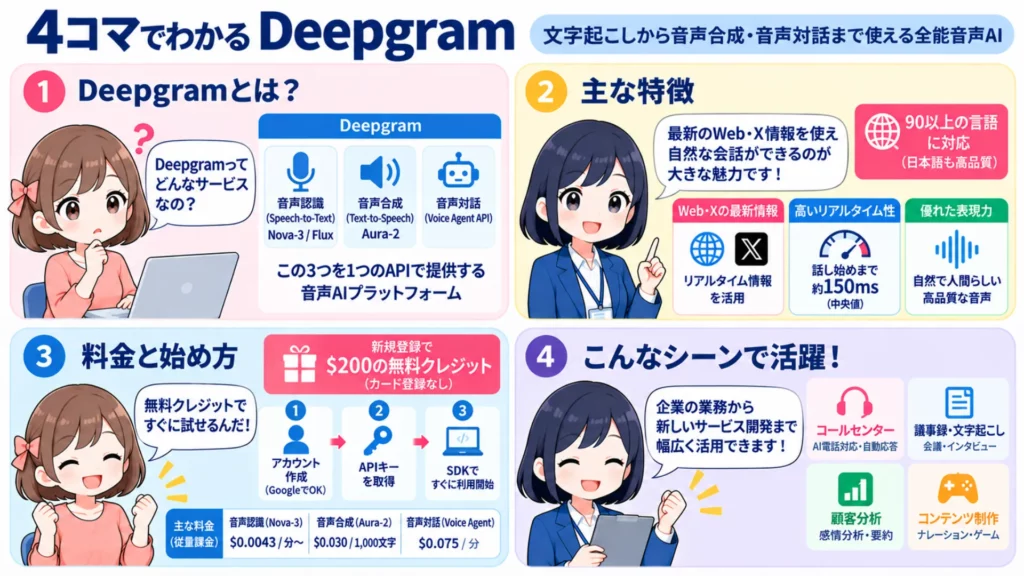
- 音声認識(Nova-3/Flux)・音声合成(Aura-2)・Voice Agent APIの3本柱を1つのAPIで提供
- 日本語はNova-3・Flux Multilingual・Aura-2が対応し、$200の無料クレジットでカード登録なしに試せる
- 企業で使うときはモデル改善プログラムへのデータ提供(mip_opt_out)と同時実行数の上限を先に確認
皆さん、Deepgramという音声AIのプラットフォームはご存知ですか?
「Deepgram」は、音声認識(Speech-to-Text)・音声合成(Text-to-Speech)・音声対話エージェント(Voice Agent API)をまとめてAPIで提供する音声AIプラットフォームです。20万人以上の開発者が使っていて、IBMやTwilioなどの企業も採用しています。
「Nova-3とFluxのどちらを選べばいいのか」「いくらかかるのか」「音声データを安全に扱えるのか」と疑問に思う方も多いのではないでしょうか。
そこで本記事では、Deepgramの概要や最新の料金、導入方法を解説し、APIを使ったリアルタイム文字起こしも実際に試します。ぜひ最後までお読みください!
\生成AIを活用して業務プロセスを自動化/
Deepgramの概要
Deepgramは、2015年に設立されたサンフランシスコの音声AI企業です。
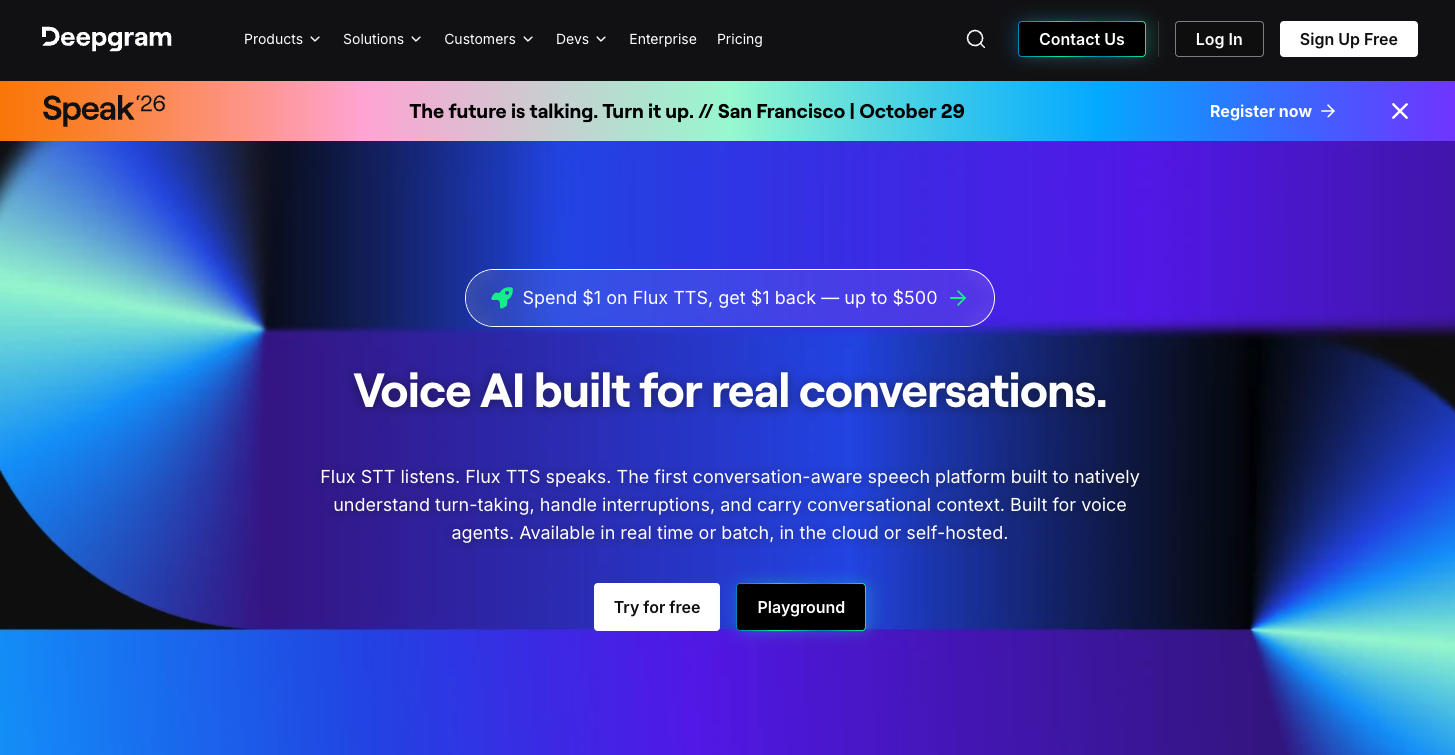
当初は文字起こしが中心でしたが、今は音声の認識・合成・対話まで扱える総合的な音声AIプラットフォームに広がっています。
| プロダクト | できること | 主なモデル |
|---|---|---|
| Speech-to-Text | 音声をテキストに変換 | Nova-3/Flux |
| Text-to-Speech | テキストを自然な音声で読み上げ | Aura-2/Flux TTS |
| Voice Agent API | 音声認識・LLM・音声合成をまとめた音声対話エージェントの構築 | 上記の組み合わせ |
| Audio Intelligence | 音声の要約・感情分析・トピック検出・意図認識 | ー |
| Text Intelligence | テキストデータ向けの分析機能 | ー |
提供形態はマネージドクラウド・VPC・オンプレミスの3つから選べます。累計で5万年分以上の音声を処理し、1,400以上の組織が採用しています。
Speech-to-Text(Nova-3/Flux)
Speech-to-Textの主力は、2025年2月に発表された「Nova-3」です。ノイズの多い環境、複数人が同時に話す場面、遠くの話者の声にも強い汎用モデルで、300ミリ秒未満で文字起こし結果を返します。
Deepgramの公表値では、単語の誤り率(WER)は事前録音で5.26%、ストリーミングで6.84%です。次に精度が高いモデルと比べて、誤り率を約5割減らしたと発表。
もう1つが、2025年10月に登場した会話特化型の「Flux」です。話し終わりの判定(ターン検出)をモデルの中に組み込んでいて、発話の終わりを約260ミリ秒で判定可能。
| 項目 | Nova-3 | Flux |
|---|---|---|
| 位置づけ | 汎用の高精度な音声認識 | 音声エージェント向けの会話特化型 |
| 強み | ノイズ・多人数の会話・多言語 | ターン検出・割り込みへの対応 |
| 日本語 | 対応(単一言語 ja/多言語モデル) | 対応(Flux Multilingual) |
| 速度 | 300ミリ秒未満 | 話し終わりの判定が約260ミリ秒 |
| 精度 | 公表WER 5.26%(事前録音) | Nova-3と同等(公式) |
Fluxは2026年4月末に「Flux Multilingual」として10言語に対応し、日本語も含まれています。言語の自動検出や、会話の途中で言語が切り替わる場合にも、1本のストリーミング接続で対応できるのが特徴です。
Nova-3は、専門用語を最大100語まで登録できるKeyterm Promptingにも対応しています。モデルを再学習しなくても、社名や製品名の認識精度を上げられます。
Audio Intelligence(旧:Speech Understanding)
以前「Speech Understanding」と呼ばれていた機能は、現在はAudio Intelligenceという名前で提供されています。
| 機能 | 内容 |
|---|---|
| 要約(Summarization) | 音声データの特定の部分を要約し、読みやすさと分析の容易さを高めます。 |
| 感情分析(Sentiment Analysis) | この機能は、ポジティブ、ニュートラル、ネガティブな感情を識別します。 |
| トピック検出(Topic Detection) | 重要なトピックを特定し、ラベル付けして洞察を得ます。 |
| エンティティ検出(Entity Detection) | 名前や場所、口座番号などのエンティティを識別します。 |
なお、話者分離(Diarization)や言語の自動検出は、Speech-to-Text側のオプションとして使えます。
Deepgramのユースケース
Speech-to-textとAudio Intelligenceのそれぞれ、ユースケースとしては以下が考えられます。
| ユースケース | 活用イメージ |
|---|---|
| コール分析(Call Analytics) | 顧客との通話データをリアルタイムで分析することが可能です。これにより、顧客満足度の向上や、効率的な問題解決が期待できます。 |
| 会話型AI(Conversational AI) | Deepgramの音声理解能力は、チャットボットや仮想アシスタントの精度を大幅に向上させます。特に、自然な会話の流れを理解する能力が高いため、より人間らしい対話が可能です。 |
| コンタクトセンター(Contact Centers) | 高い精度と速度で音声をテキストに変換できるため、コンタクトセンターでの顧客対応が効率化されます。 |
| ポッドキャストの文字起こし(Podcast Transcription) | ポッドキャストやインタビューの内容を高精度で文字に起こすことができます。これにより、コンテンツのアーカイブや検索性が向上します。 |
さらにこれまでご紹介した機能はAPIで利用可能です。
なお、OpenAI発の音声認識モデルについて知りたい方はこちらをご覧ください。
MacBookでリアルタイムAI音楽演奏を体験できるMagenta RealTime 2について、以下の記事をご覧ください。

企業利用時の注意点(データの取り扱い)
企業で使うときに特に確認しておきたいのが、音声データがモデルの学習に使われるかどうかです。
Deepgramには「Model Improvement Partnership Program(モデル改善パートナーシッププログラム)」があります。このプログラムを通じて提供されたデータは、今後のモデル学習に使われる仕組みです。
学習に使われたくない場合は、APIリクエストにmip_opt_out=trueを付けてオプトアウトします。Speech-to-Text・Text-to-Speech・Voice Agent APIのどれでも指定でき、Voice Agent APIでは設定メッセージ(Settings)の中で指定します。
オプトアウトしたリクエストのデータは、処理に必要な期間だけ保持されます。オプトアウトが効いているかどうかは、コンソールの「Usage > Logs」で確認できます。
| 項目 | 内容 |
|---|---|
| 認証・準拠 | SOC 2 Type II、HIPAA(BAAの締結が必要)、PCI DSS、GDPR、CCPA |
| 暗号化 | 通信はTLS 1.3、保存データはAES-256 |
| データの保存場所 | 標準は米国。オーストラリアのエンドポイントも利用可能 |
| 提供形態 | クラウド/VPC/オンプレミス |
Deepgramの音声合成(Text-to-Speech / Aura-2)
DeepgramはSpeech-to-Textだけでなく、音声合成(Text-to-Speech)も主力製品にしています。それが2025年4月に発表された「Aura-2」です。
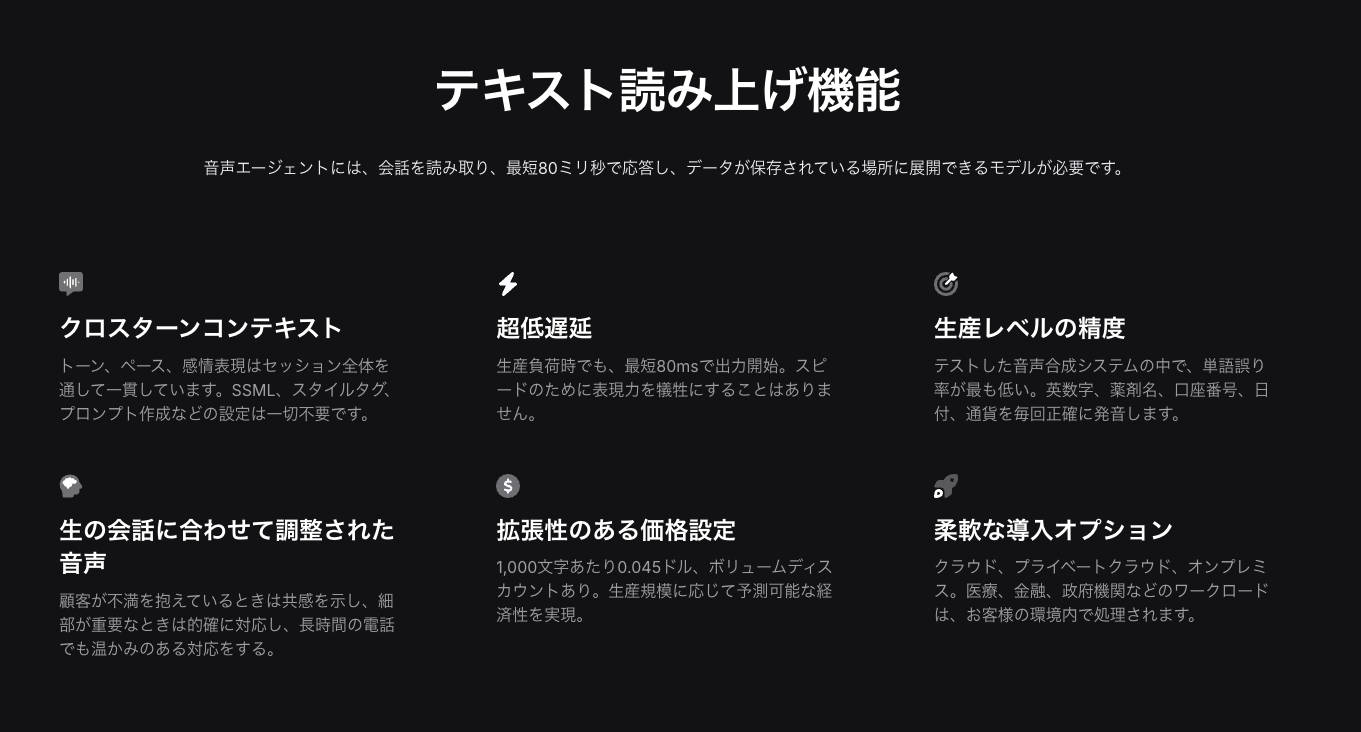
Aura-2は、演技がかった声ではなくビジネスの会話に合う自然な声を目指して作られたモデルです。型番・薬の名前・口座番号・日付・金額などを正確に読み上げられるので、コールセンターや受付の自動化に向いています。
| 項目 | Aura-2 | Flux TTS |
|---|---|---|
| 登場時期 | 2025年4月 | 2026年 |
| 対応言語 | 英語・スペイン語・オランダ語・フランス語・ドイツ語・イタリア語・日本語の7言語 | 英語のみ(多言語はロードマップ) |
| 応答速度 | 最初の音声まで約90ミリ秒 | 約80ミリ秒で読み上げ開始 |
| 特徴 | 業界用語や数字を正確に読める | 前後の会話の文脈を引き継ぐ、SSMLが不要 |
| 料金(Pay As You Go) | 1,000文字あたり$0.030 | 1,000文字あたり$0.045 |
「Flux TTS」は、音声エージェントに組み込むことを前提にしたモデルです。ユーザーに割り込まれたとき、どこまで読み上げたか(text_spoken)と、まだ読んでいない部分(text_remaining)を返してくれます。
DeepgramのVoice Agent API
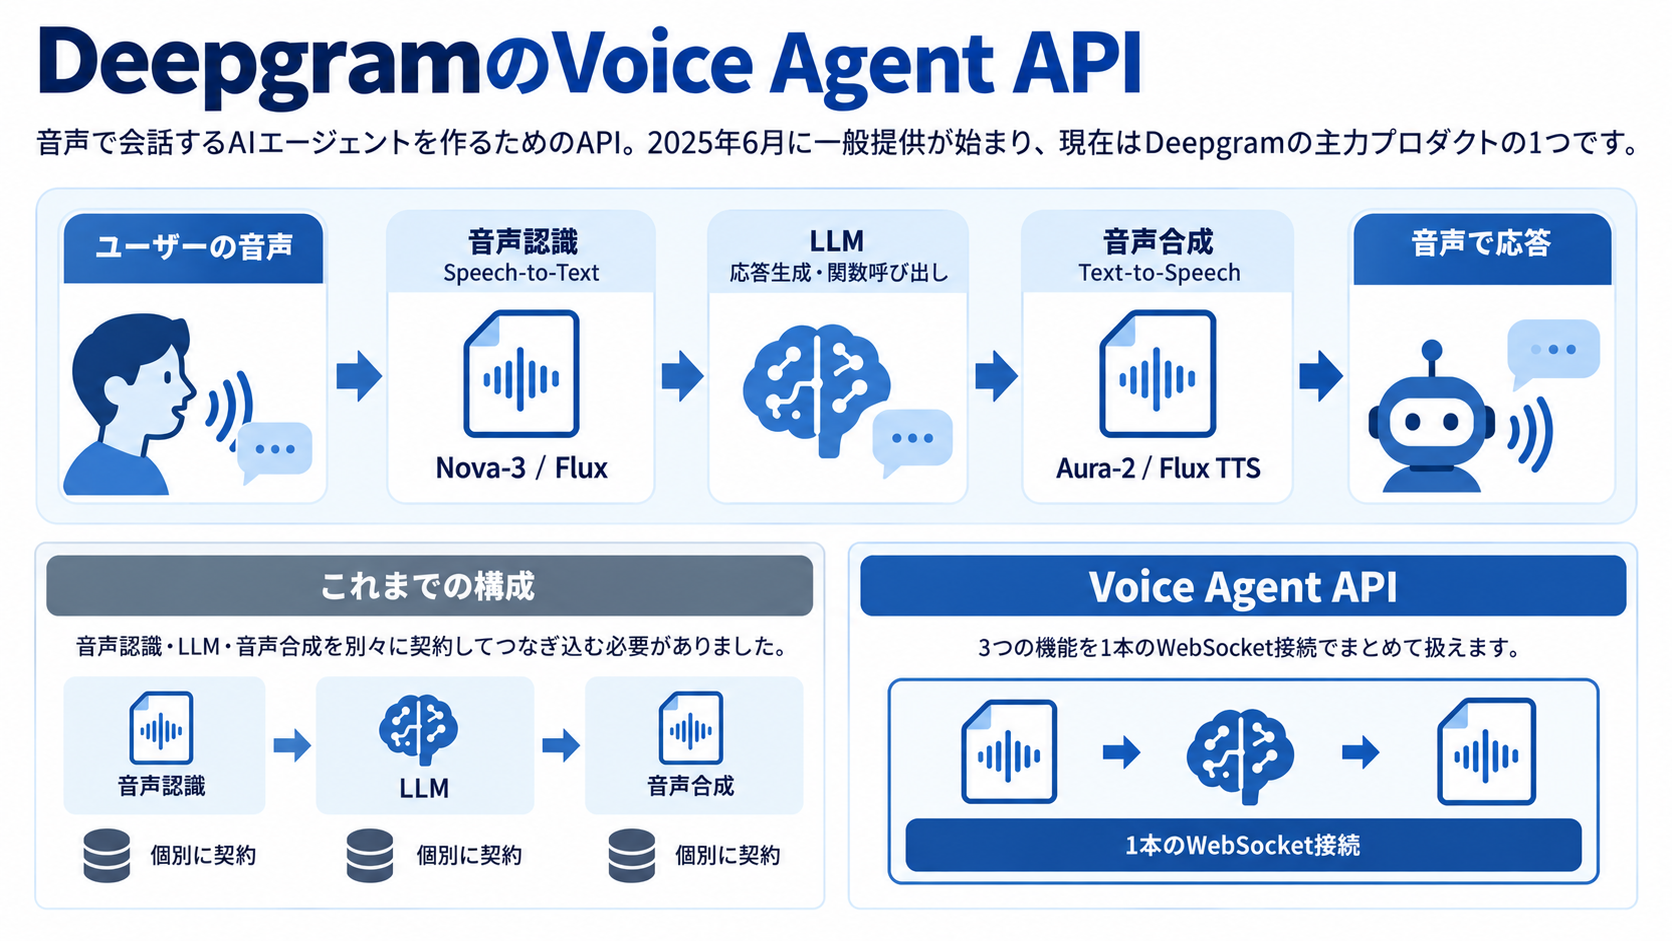
Voice Agent APIは、音声で会話するAIエージェントを作るためのAPIです。2025年6月に一般提供が始まり、今はDeepgramの主力プロダクトの1つです。
これまで音声エージェントを作るには、音声認識・LLM・音声合成を別々に契約してつなぎ込む必要がありました。Voice Agent APIでは、この3つを1本のWebSocket接続でまとめて扱えます。
| 機能 | 内容 |
|---|---|
| 割り込み(バージイン)の検出 | ユーザーが話し始めたら読み上げを止める |
| ターンテイキングの予測 | 話し終わりを予測し、自然なテンポで応答する |
| ファンクションコーリング | 予約システムや社内データベースなど外部の処理を呼び出す |
| マルチエージェント | 用途ごとにエージェントを切り替える |
| BYO(持ち込み) | 自社で使っているLLMや音声合成モデルを組み込める |
料金は、Deepgramのモデルを全部使う構成で1時間あたり$4.50(1分あたり$0.075)です。
Deepgramの料金体系
Deepgramの料金は使った分だけ払う従量課金が基本です。新規登録すると$200の無料クレジットがもらえ、クレジットカードを登録しなくても試せます。
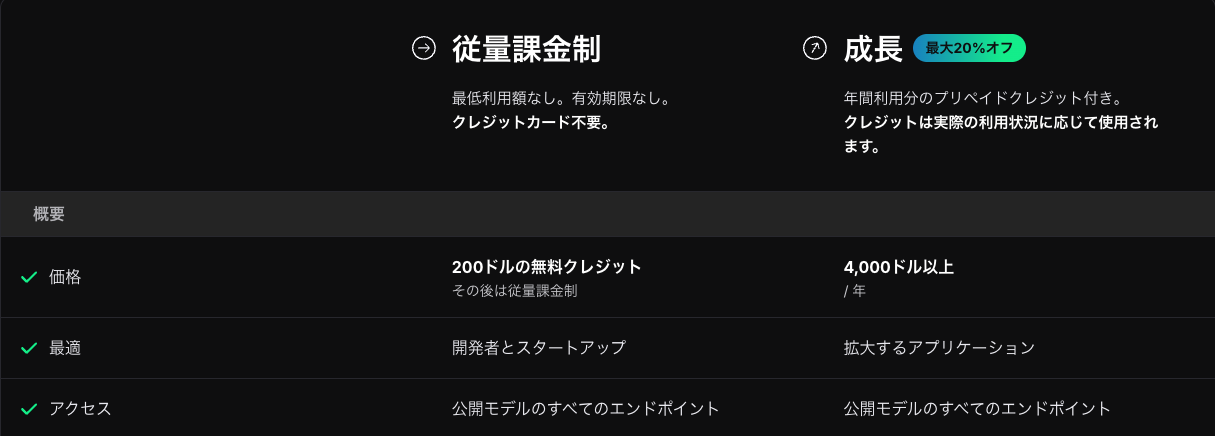
| 項目 | Pay As You Go | Growth | Enterprise |
|---|---|---|---|
| 支払い方法 | 使った分を後払い(最低利用額なし) | 年間$4,000以上を前払い | 個別見積もり |
| 無料クレジット | $200 | ー | ー |
| 対象 | 個人の開発者・検証段階のプロジェクト | 成長段階のスタートアップ・中小企業 | 大規模利用・オンプレミス・厳しいコンプライアンス要件 |
| 割引 | ー | 最大20%お得 | 個別 |
| モデル | 種別 | Pay As You Go | Growth |
|---|---|---|---|
| Nova-3(単一言語) | 事前録音 | $0.0043 | $0.0036 |
| Nova-3(多言語) | 事前録音 | $0.0052 | $0.0043 |
| Nova-3(単一言語) | ストリーミング | $0.0077 | $0.0065 |
| Nova-3(多言語) | ストリーミング | $0.0092 | $0.0078 |
| Flux English | ストリーミング | $0.0077 | $0.0065 |
| Flux Multilingual | ストリーミング | $0.0078 | $0.0068 |
| Whisper Large | 事前録音 | $0.0048 | $0.0048 |
| サービス | Pay As You Go | Growth |
|---|---|---|
| Aura-2(1,000文字あたり) | $0.030 | $0.027 |
| Flux TTS(1,000文字あたり) | $0.045 | $0.0405 |
| Voice Agent API Standard(1分あたり) | $0.075 | $0.068 |
| Voice Agent API(音声合成を持ち込み・1分あたり) | $0.065 | $0.051 |
| Voice Agent API(LLMと音声合成を持ち込み・1分あたり) | $0.050 | $0.041 |
Audio Intelligenceは分単位ではなくトークン単位の課金に変わりました。Pay As You Goの場合、入力が1,000トークンあたり$0.0003、出力が1,000トークンあたり$0.0006です
目安として、$200のクレジットはNova-3の事前録音なら約46,500分(約775時間)に相当。1時間の日本語の会議を文字にしても約$0.26(1ドル150円で約40円)なので、試すには十分な量といえるでしょう。
それでは、導入方法を見ていきましょう。
導入方法
まずは、以下のリンクにアクセスします。
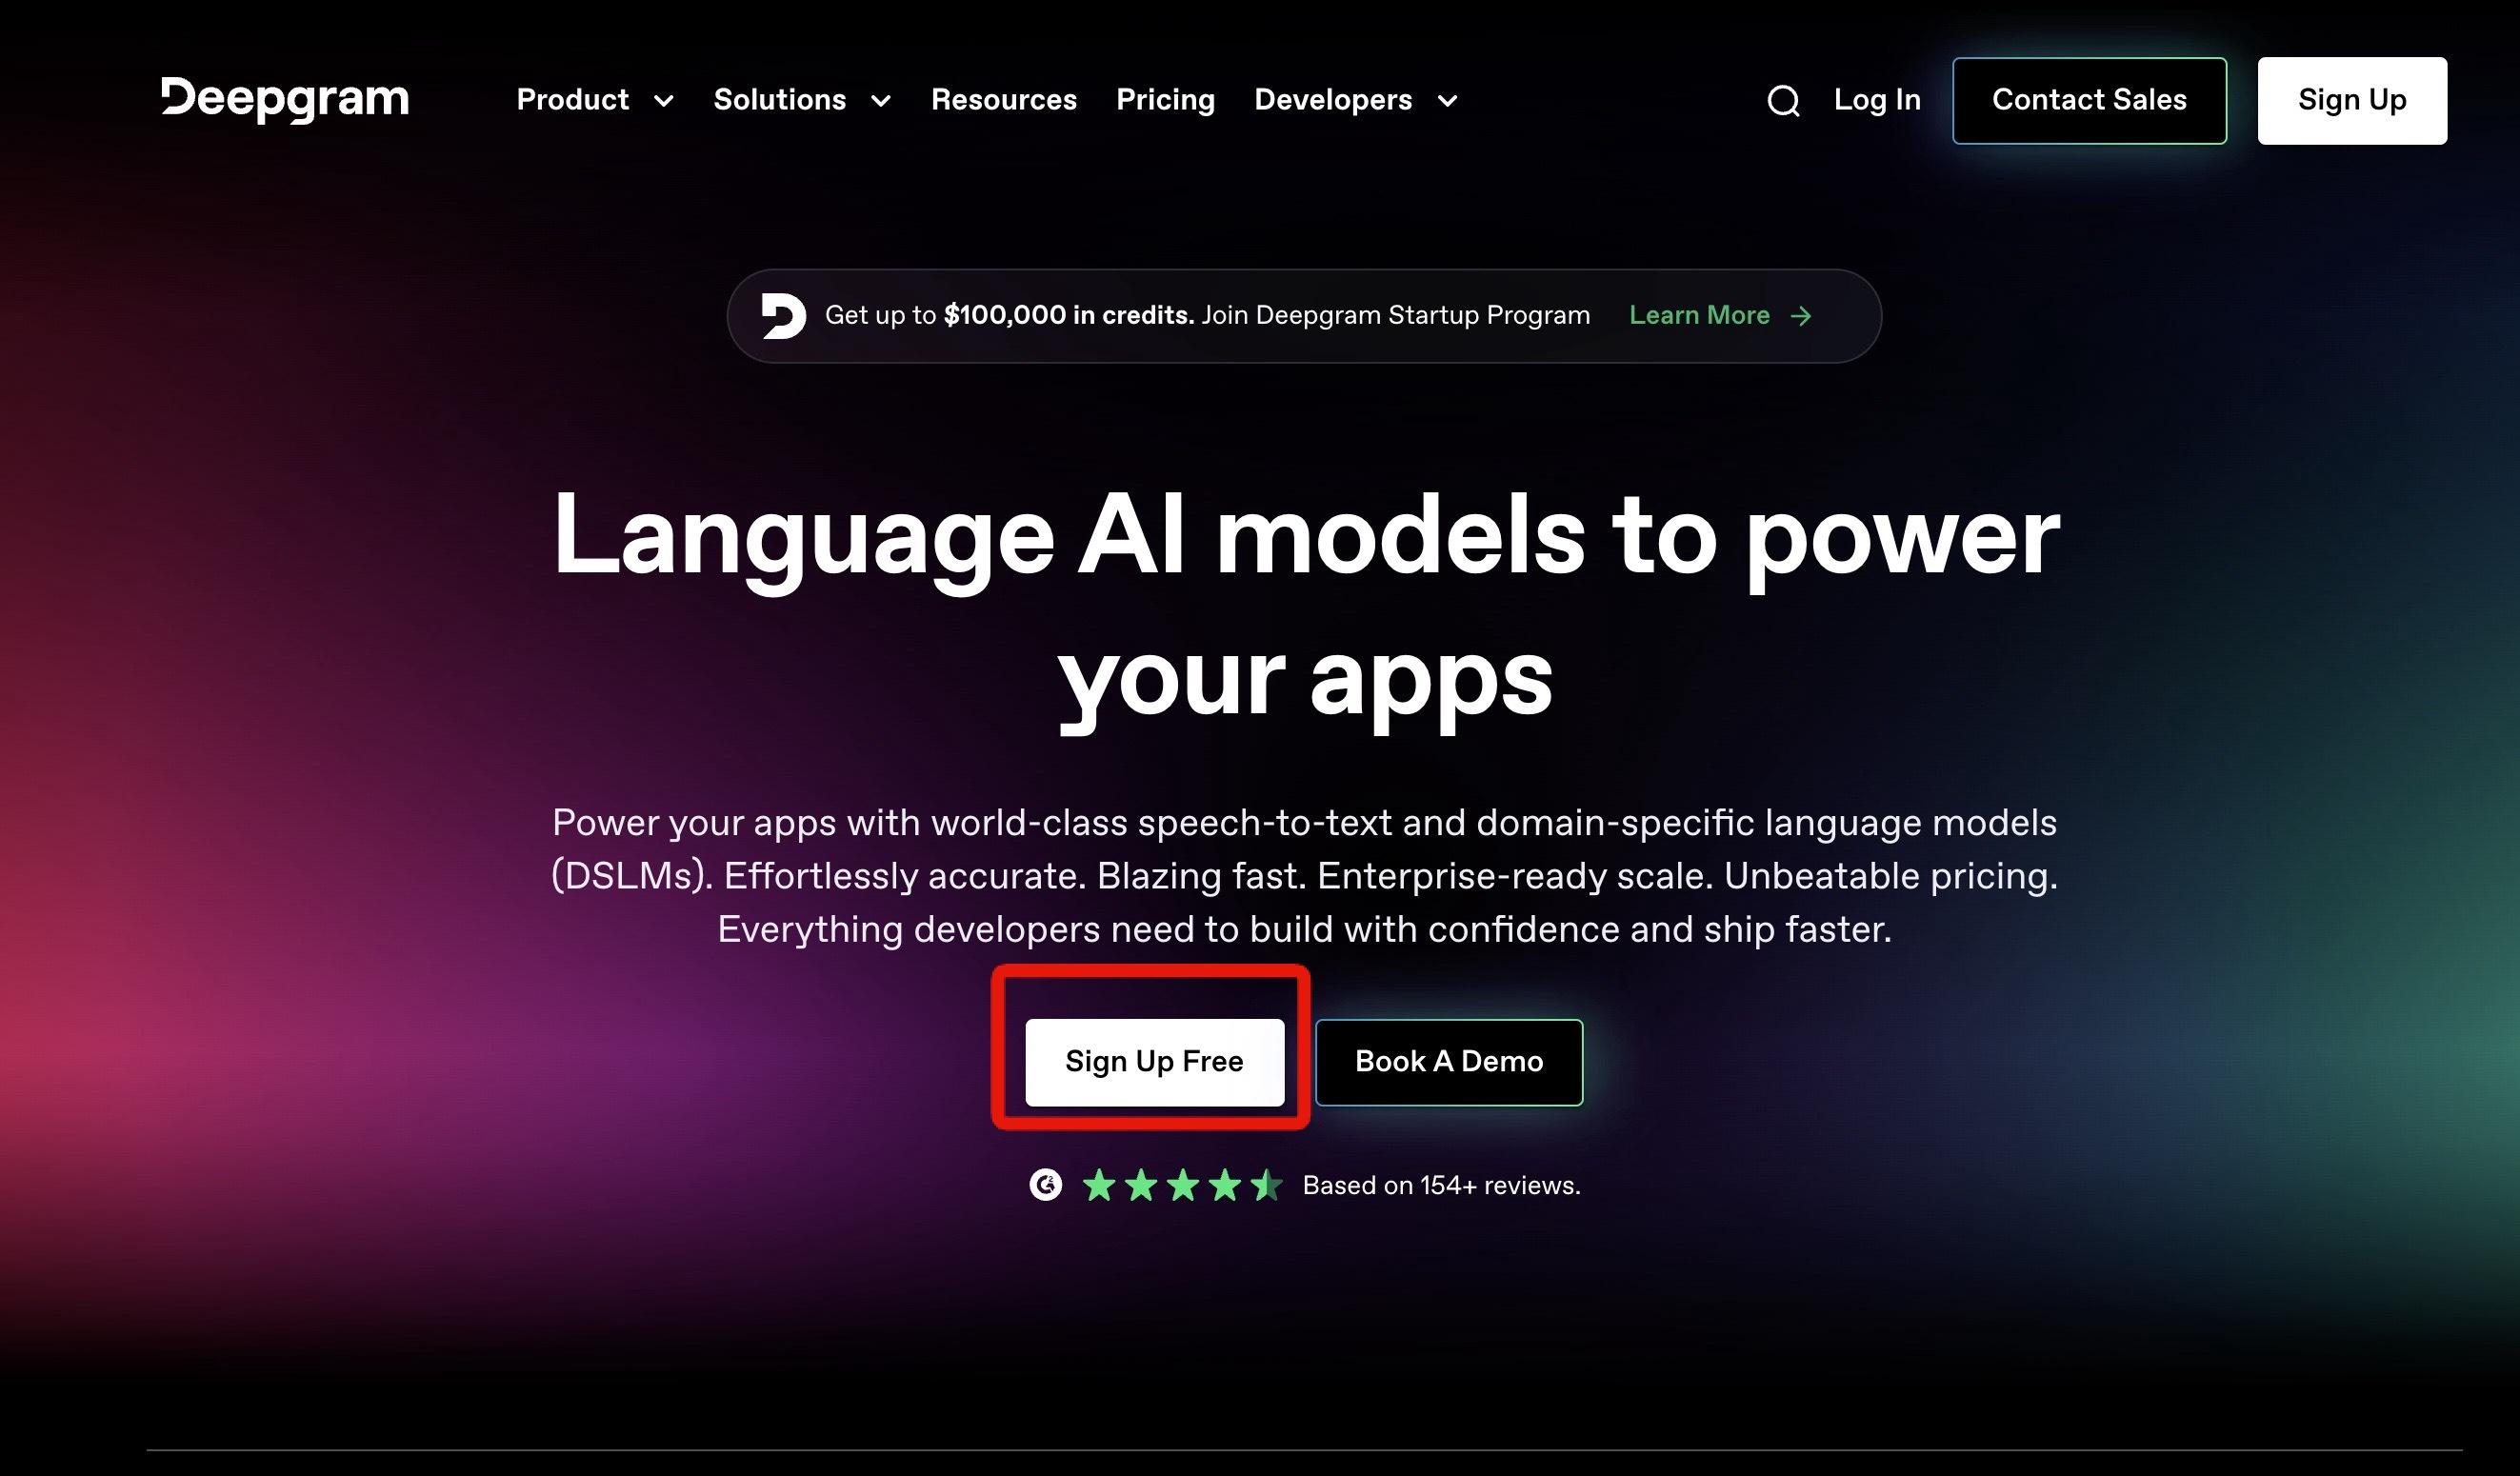
次にSign Up Free をクリック。
Sign up with Google します。
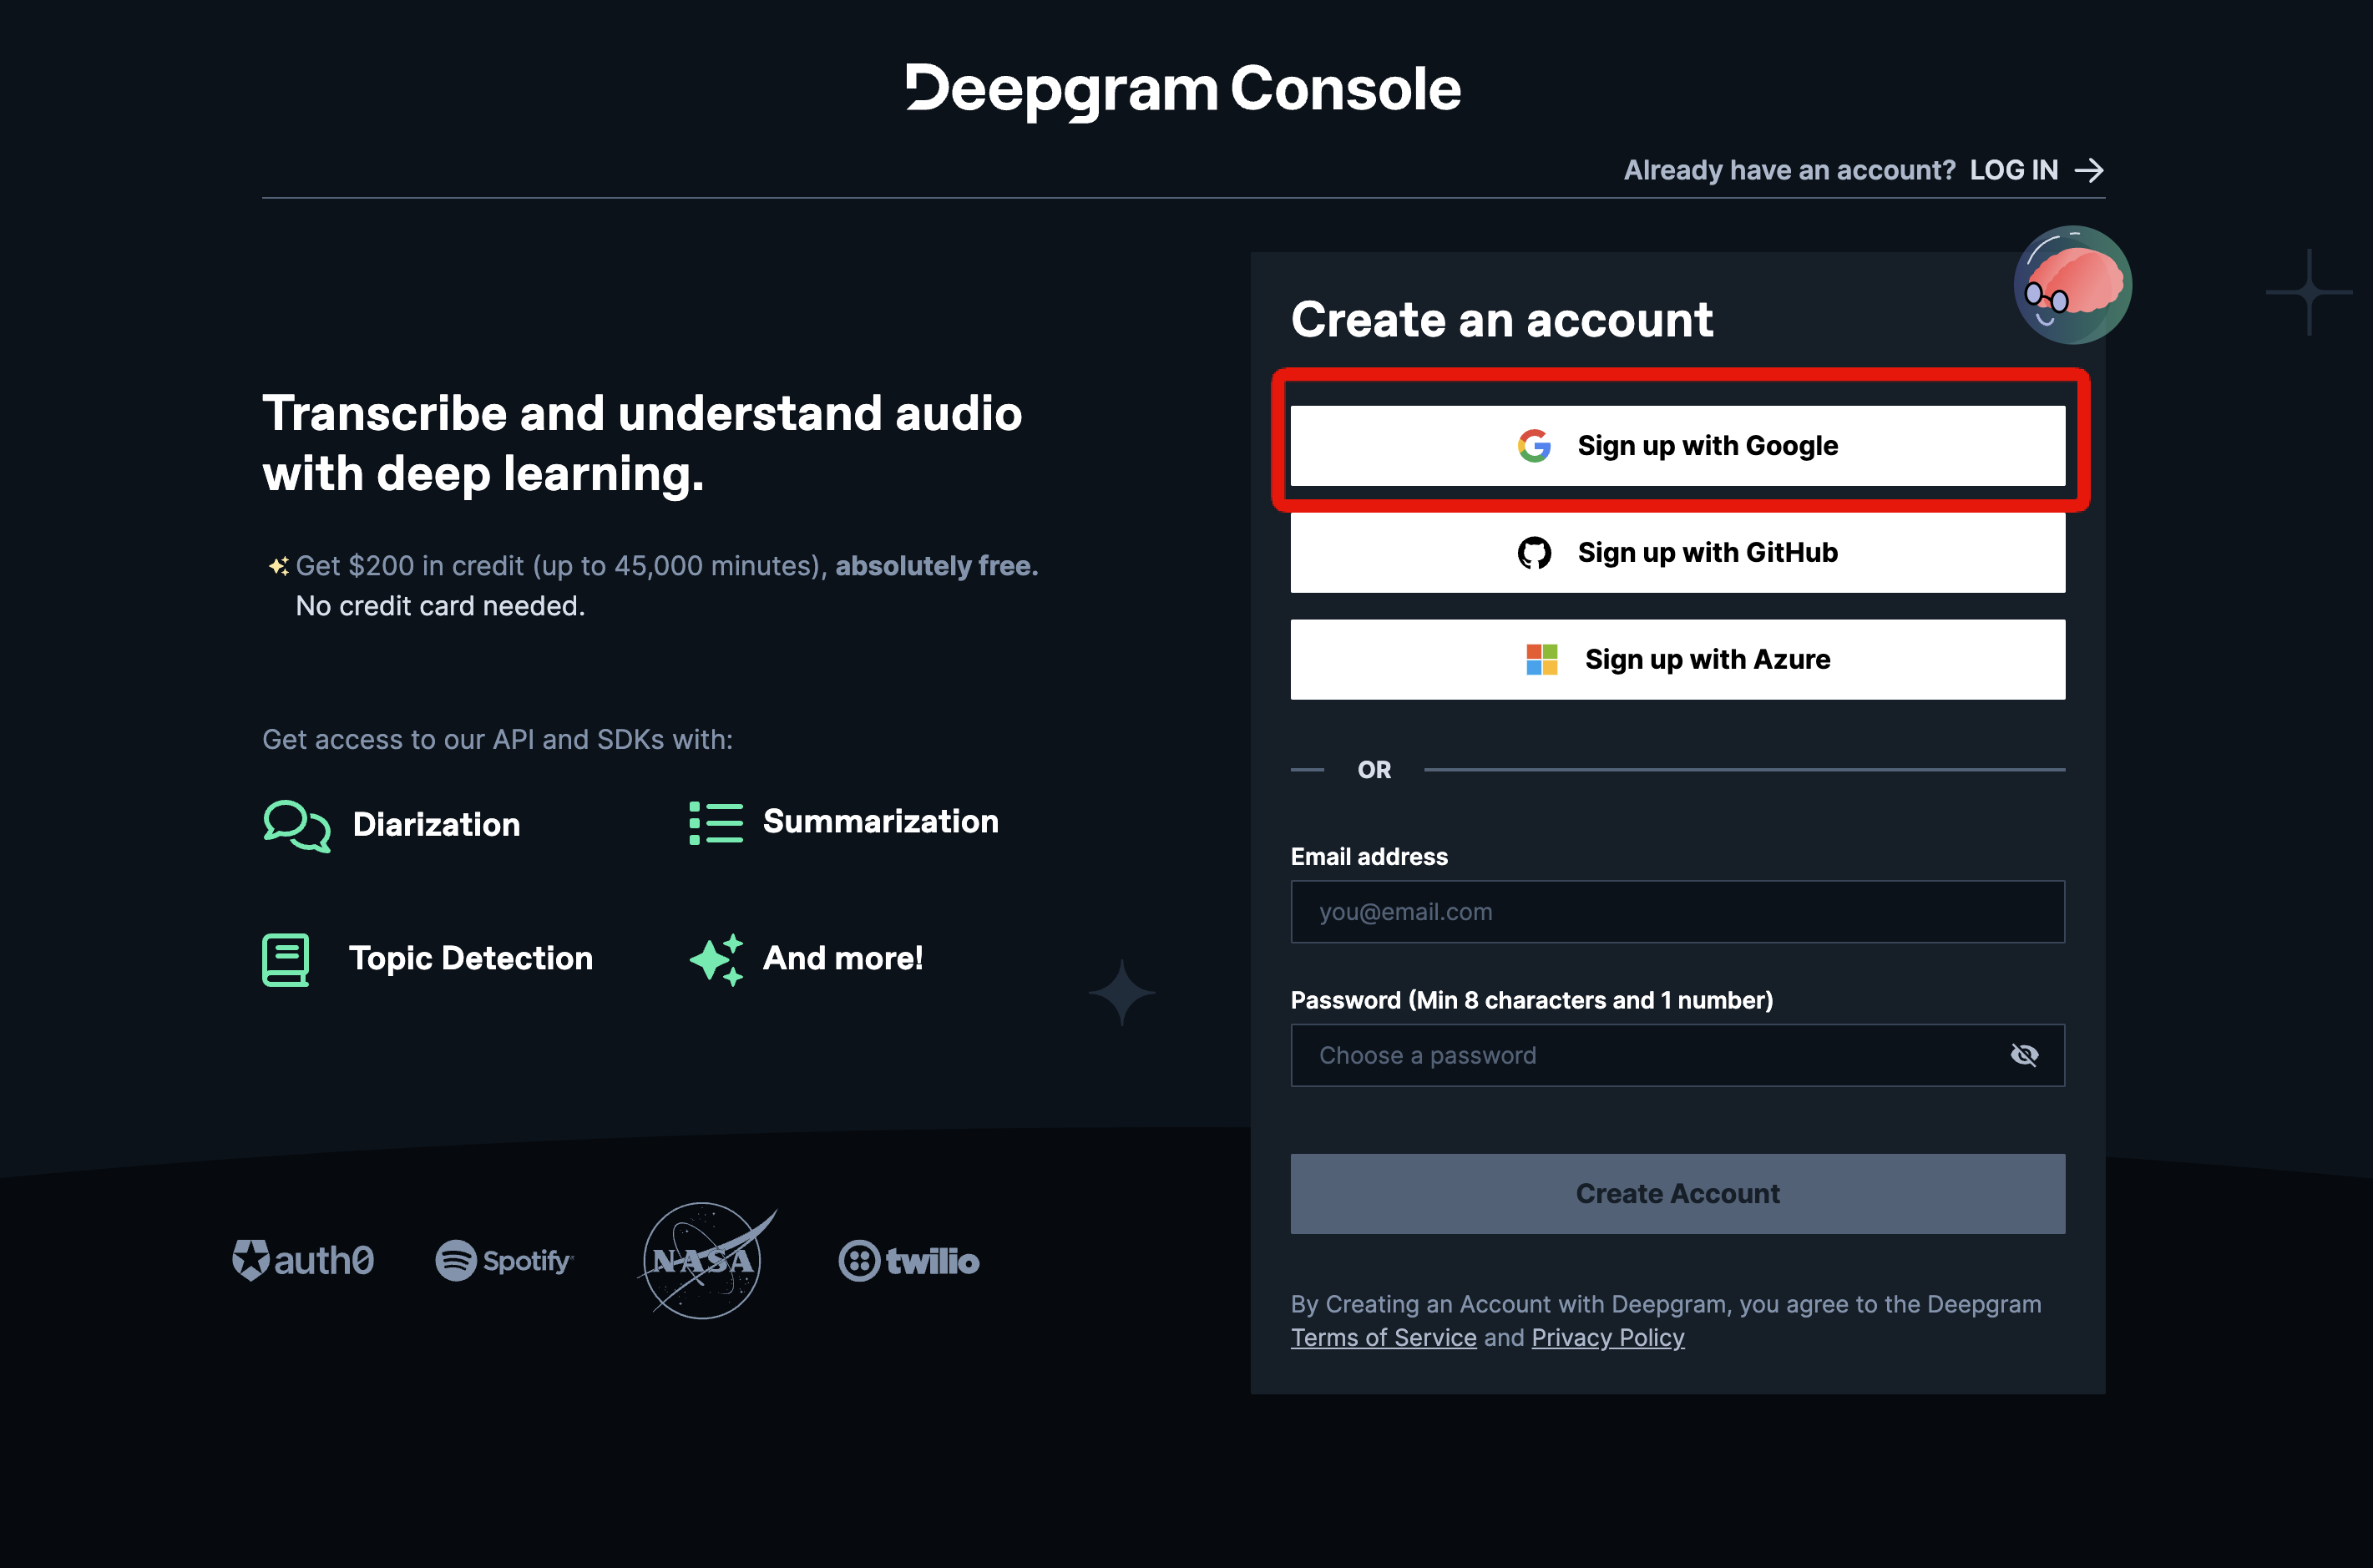
これで準備は完了です。
なお、その他の文字起こし用AIツールについて知りたい方はこちらをご覧ください。
実際に試してみた
先程説明した通りですが、2つのソリューションが提供されています。
それぞれ試してみましょう。
Speech-to-text(音声からテキストへ変換)
こちらは、デモがあるので試してみましょう。
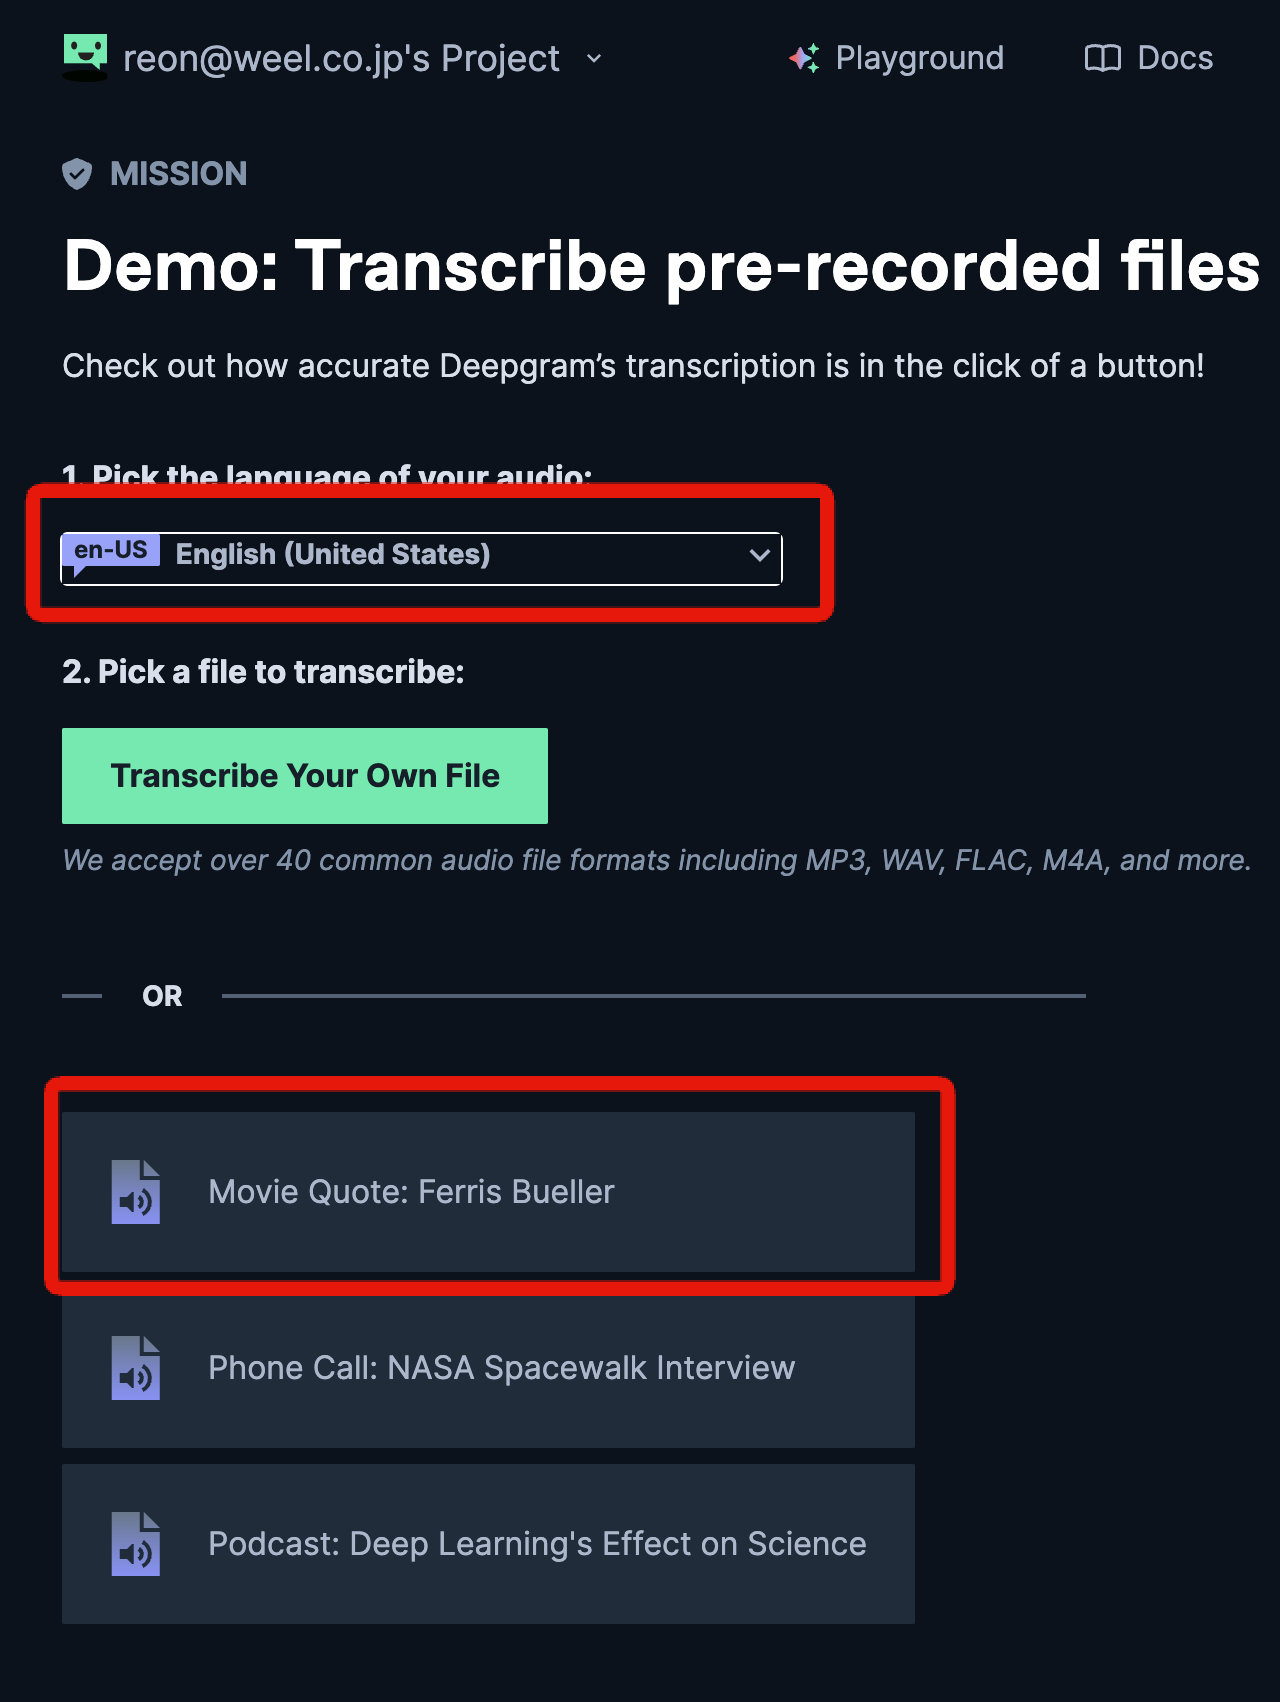
以下の画面で、「Demo:Transcribe pre-recorded files」をクリック。
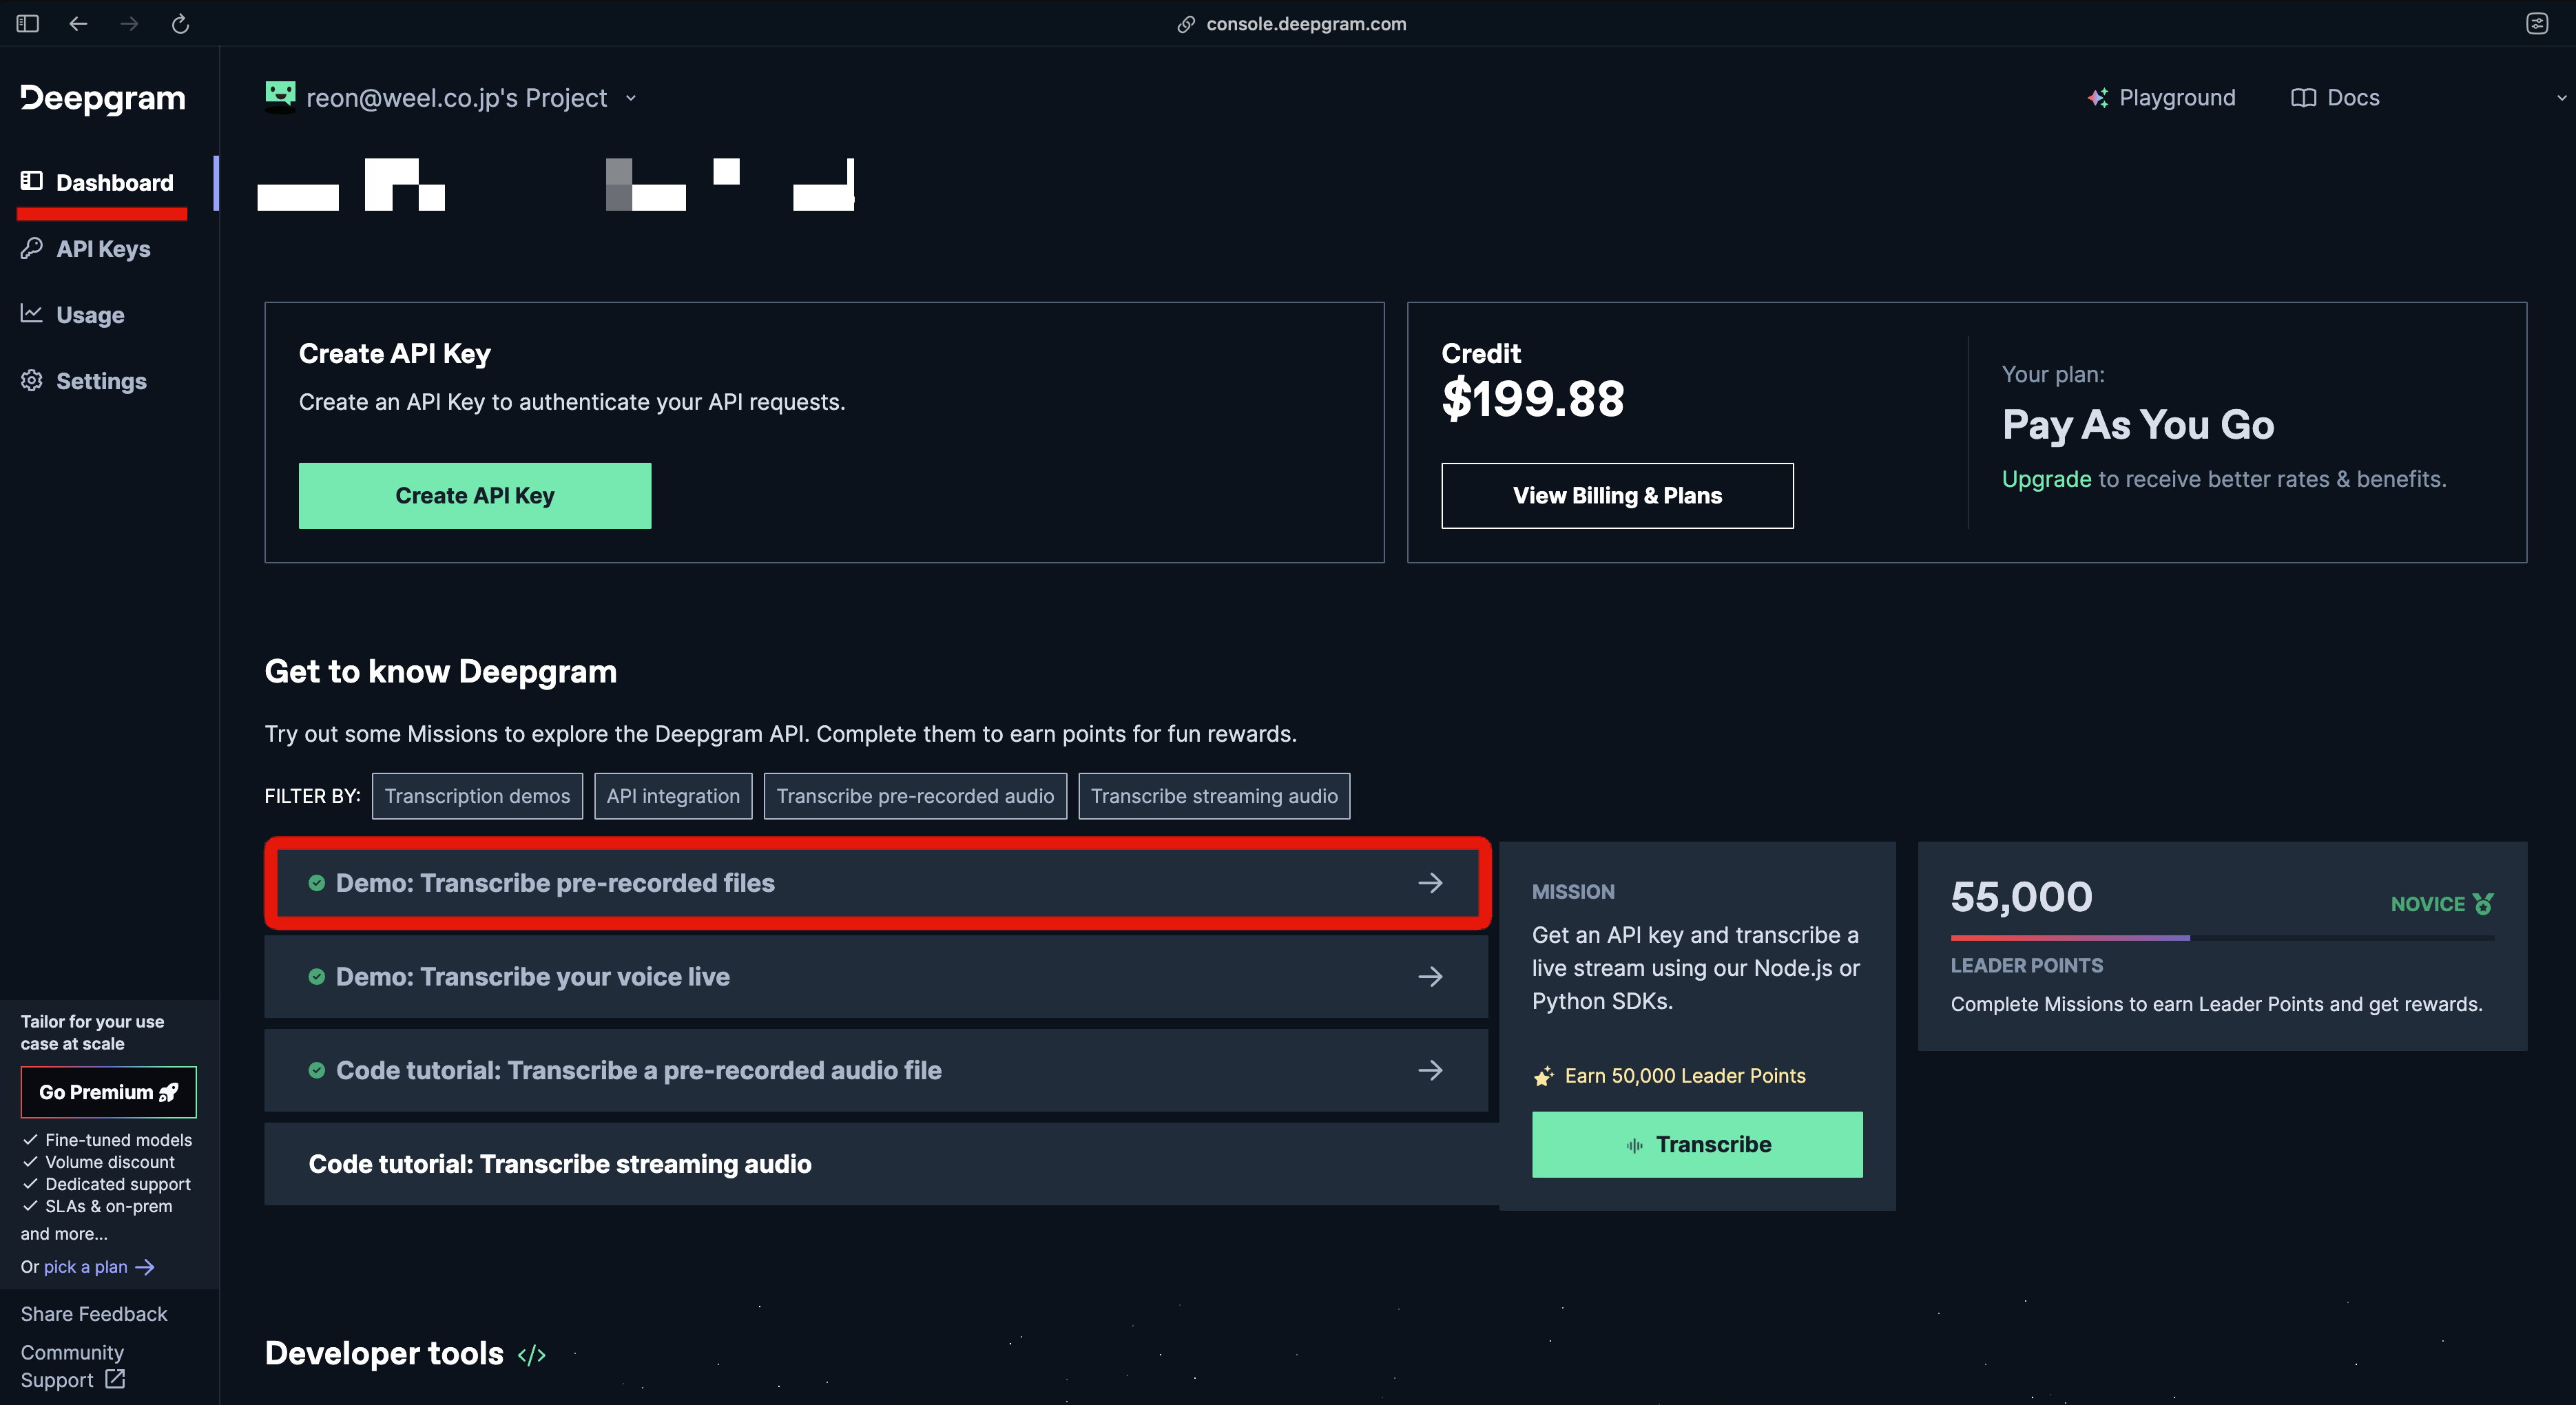
すると以下の画面になるので、まずは言語を英語に。そして、既存の動画を選びましょう。
すると以下のようになり、音声からテキストが生成されます。再生ボタンを押して確認してみましょう。
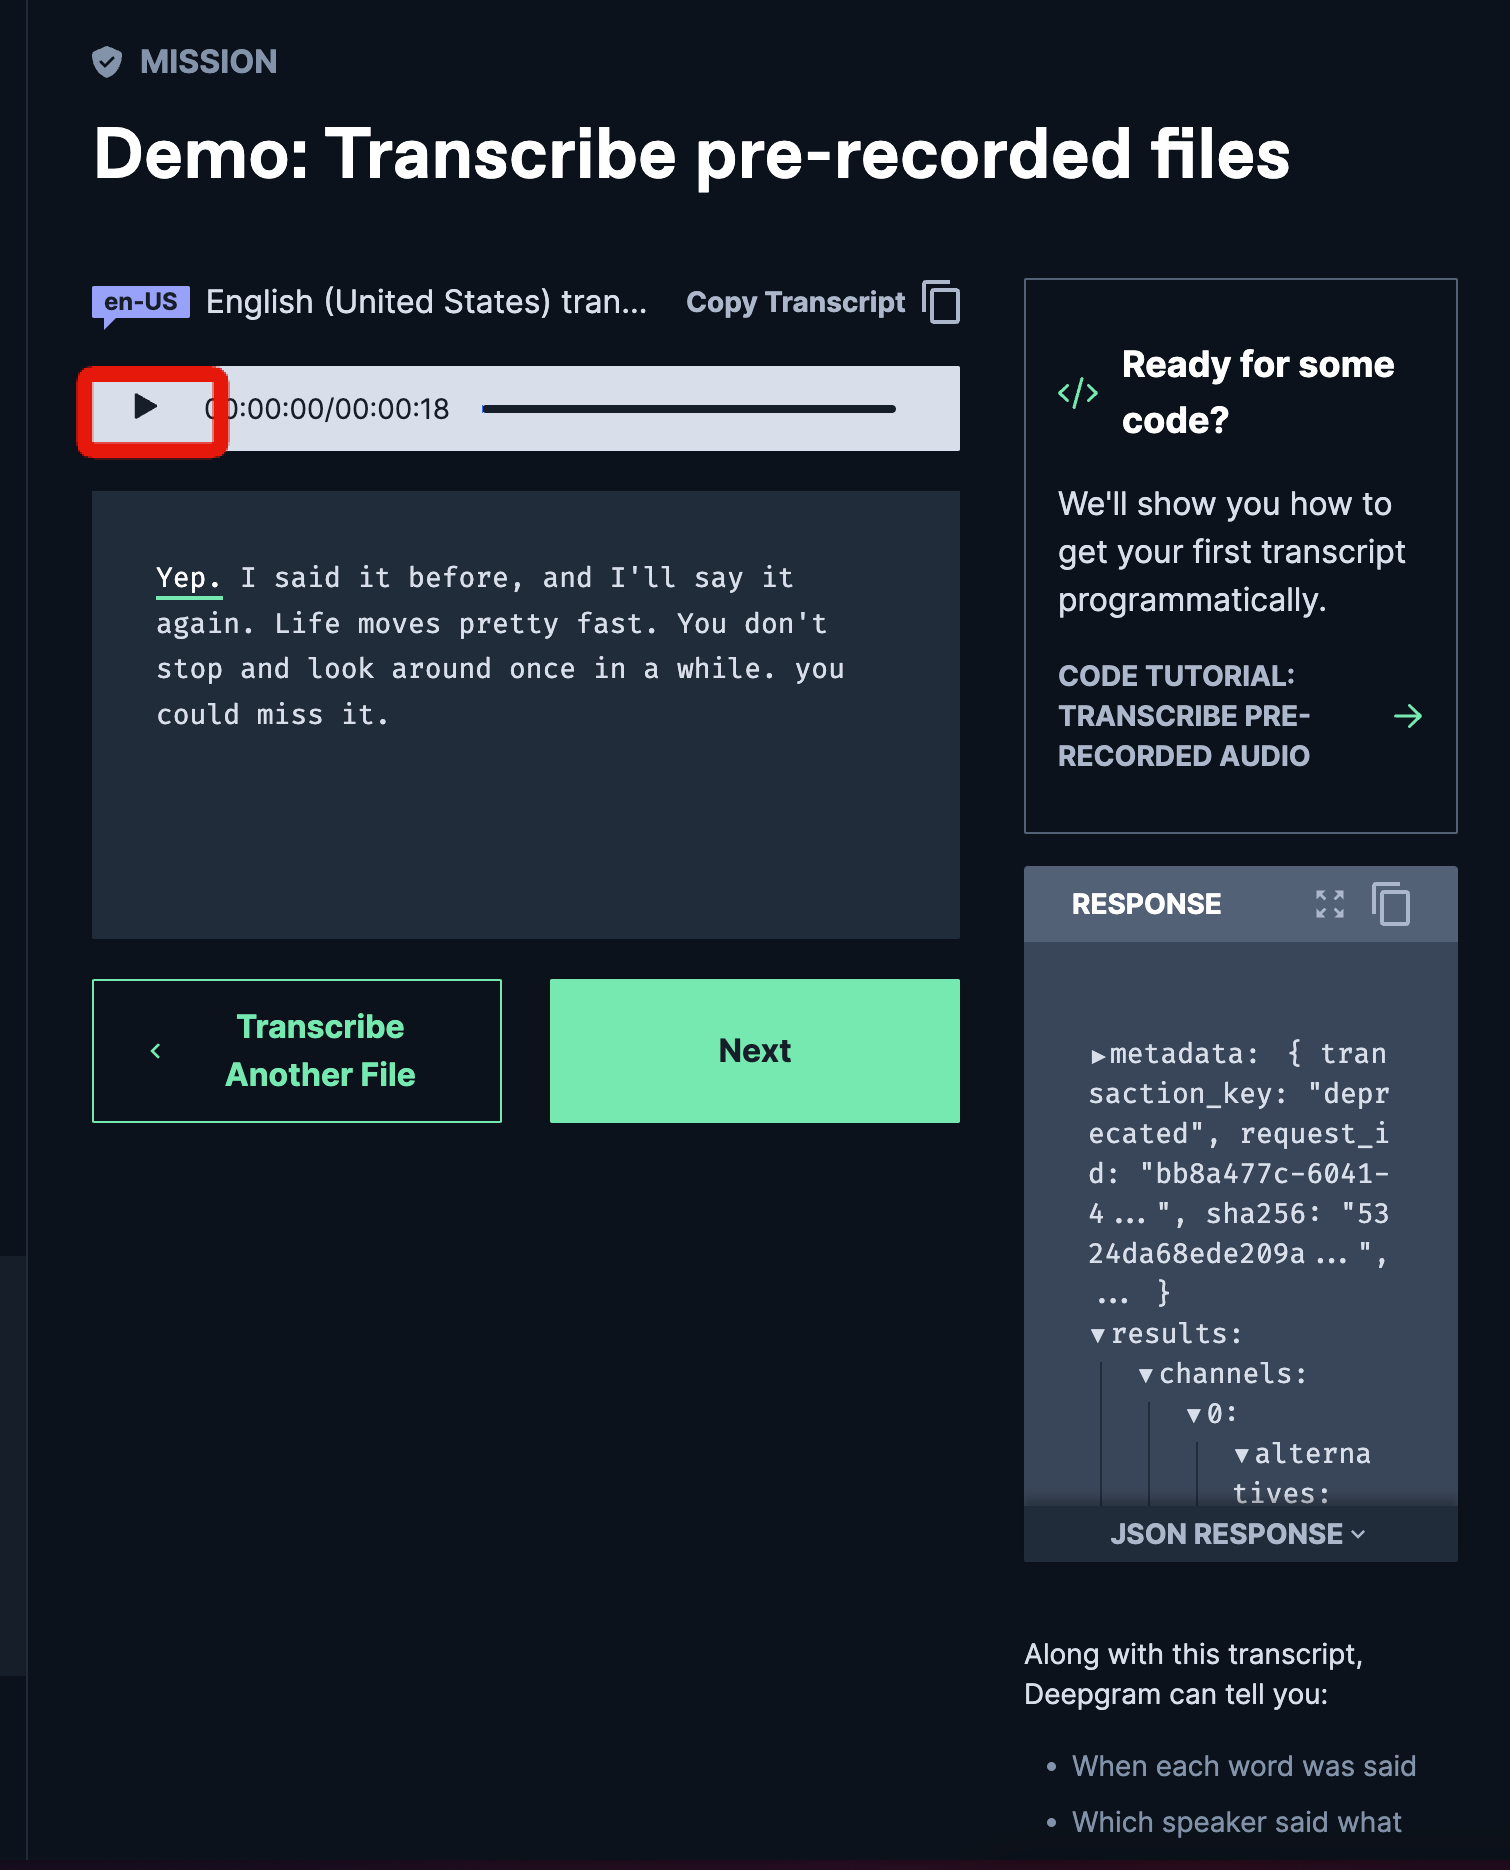
正しくテキストに変換できてました。
動画の文字起こしから感情分析まで自動化したい方は、以下の記事もご覧ください。
Audio Intelligence(音声理解)
音声理解に関しては、Play Ground を通じて利用可能です。
先程の登録では、Pay As You Goプランに登録しているので、200ドル分のクレジットが付与されています。
まずは以下のリンクから、PlayGroundにアクセスします。
この画面になったら、音声ファイルを選びます。自分でアップロードもできますが、今回は用意されているファイルを選びます。
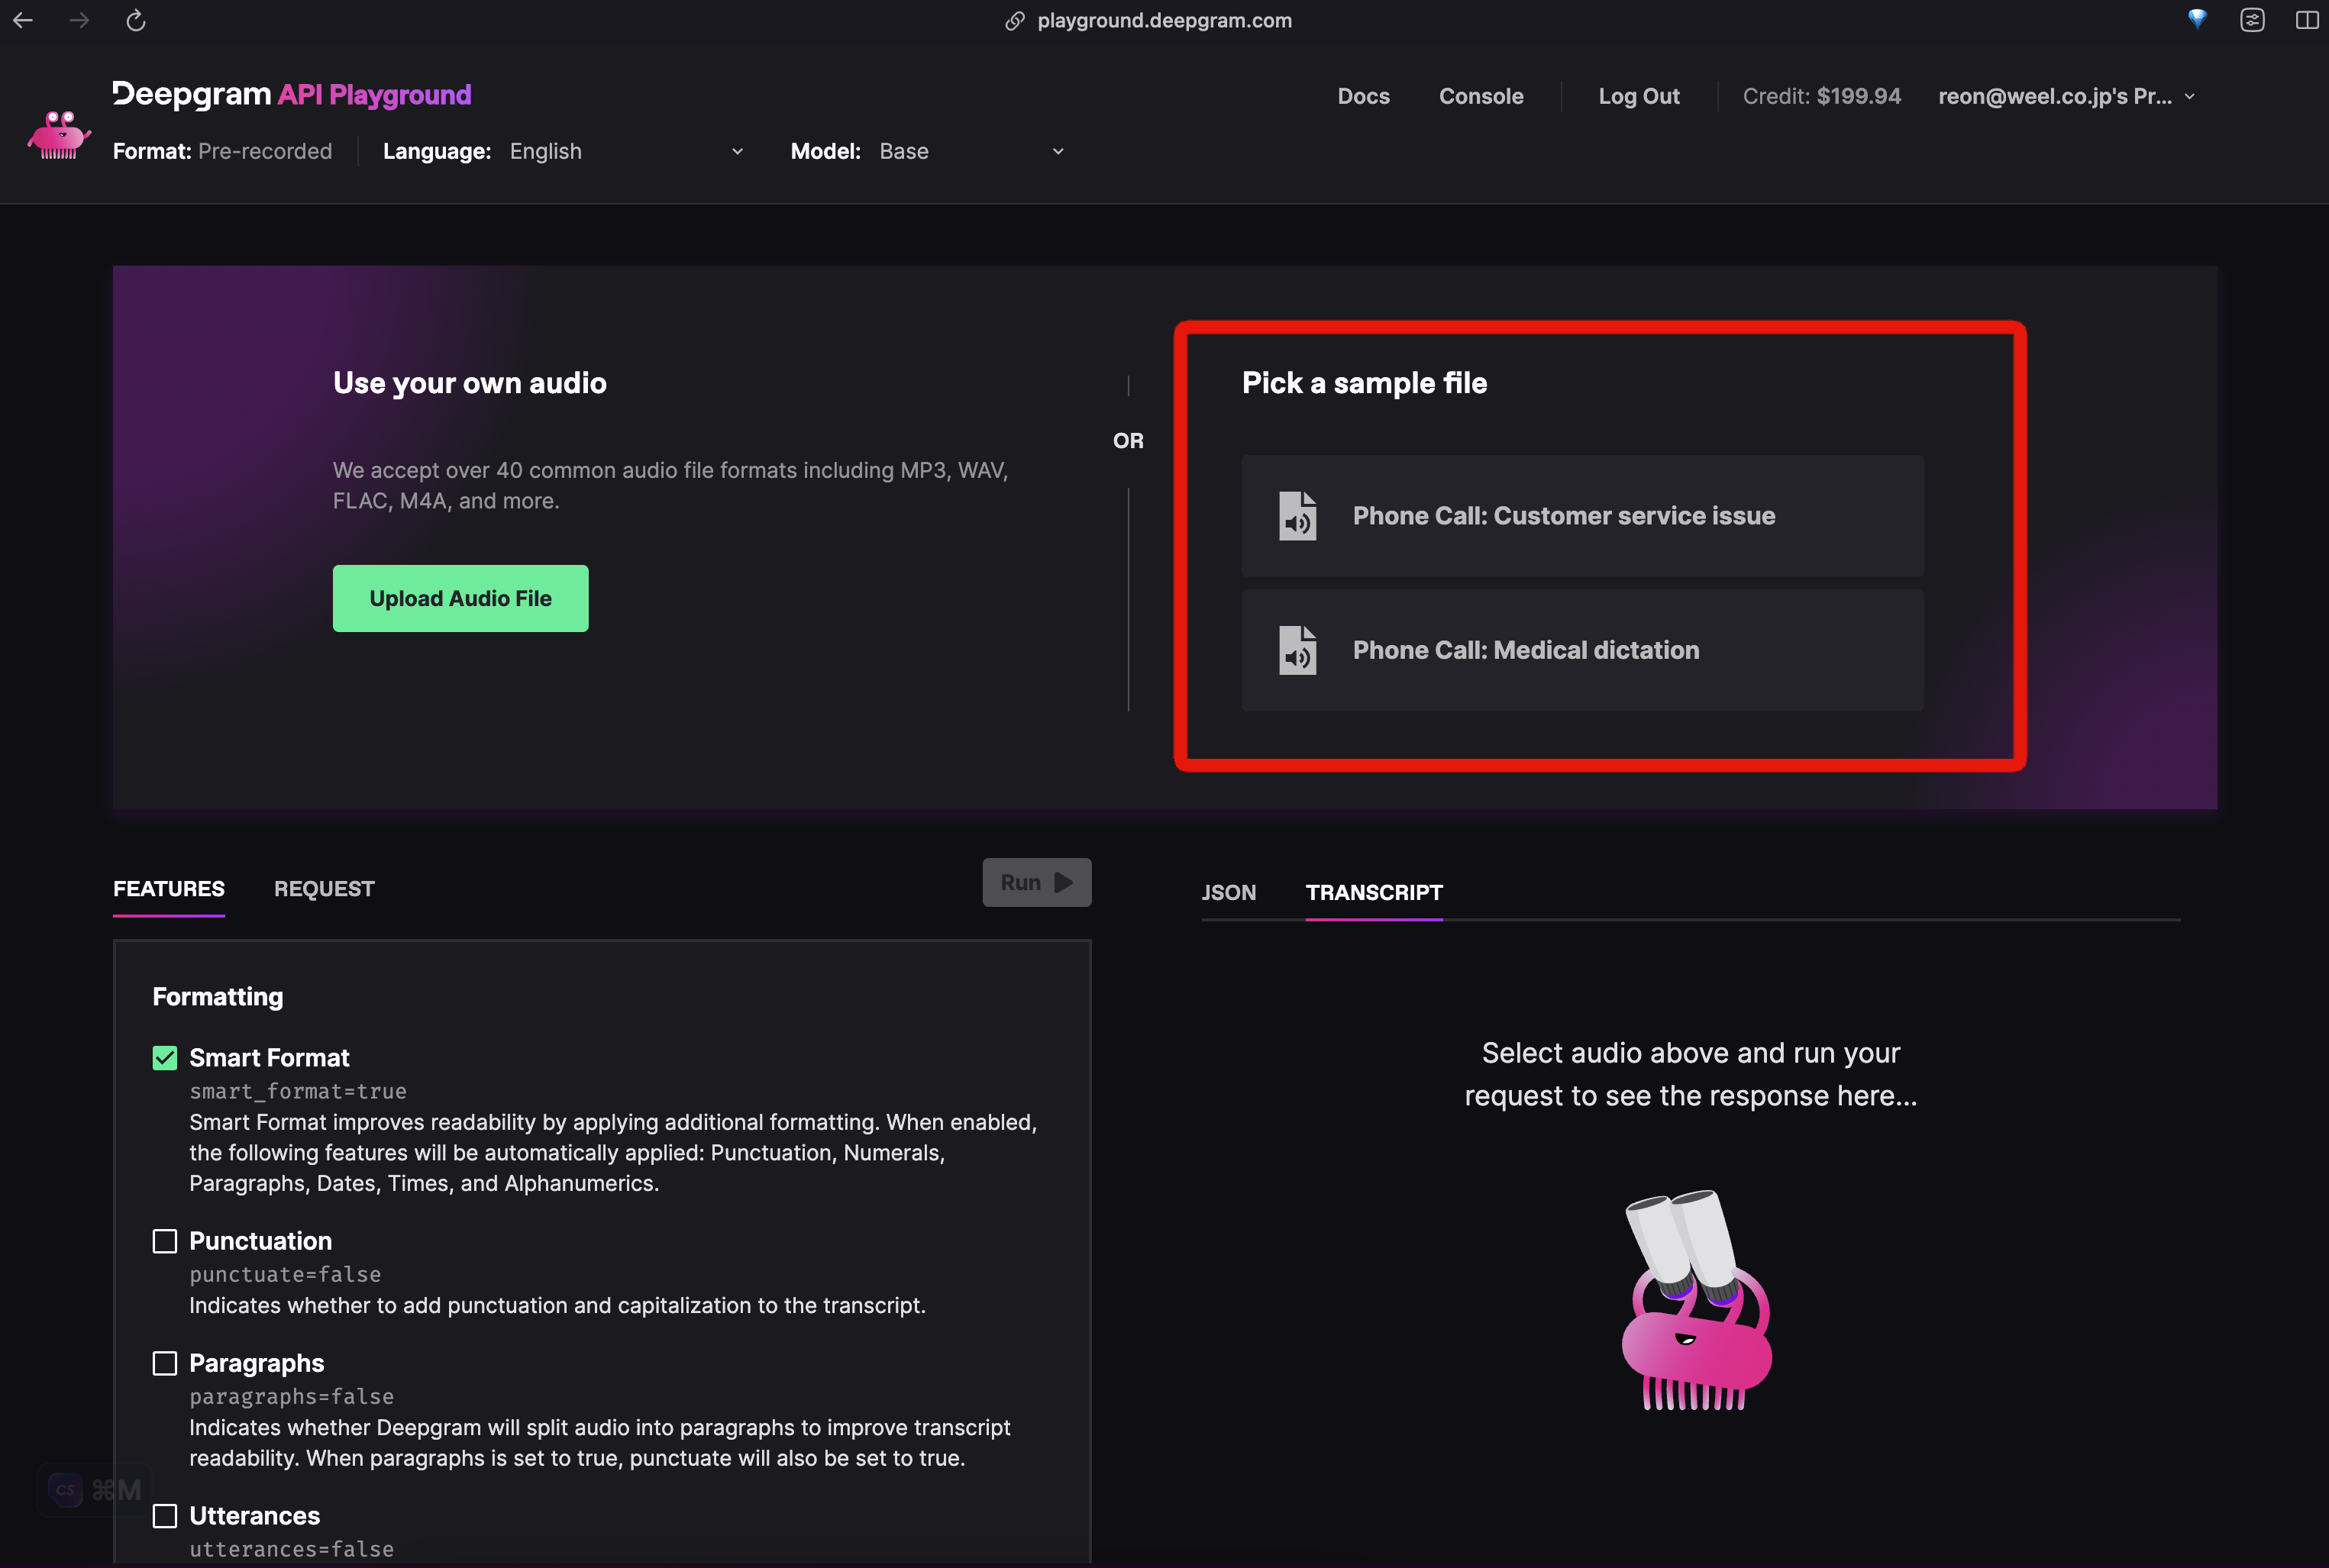
次に、音声に対して行いたいタスクを選びます。今回は「Smart Format」を選択し「Run」をクリック。
これを選択すると、音声から変換したテキストに、句読点や数字を付けて読みやすくするんだとか。
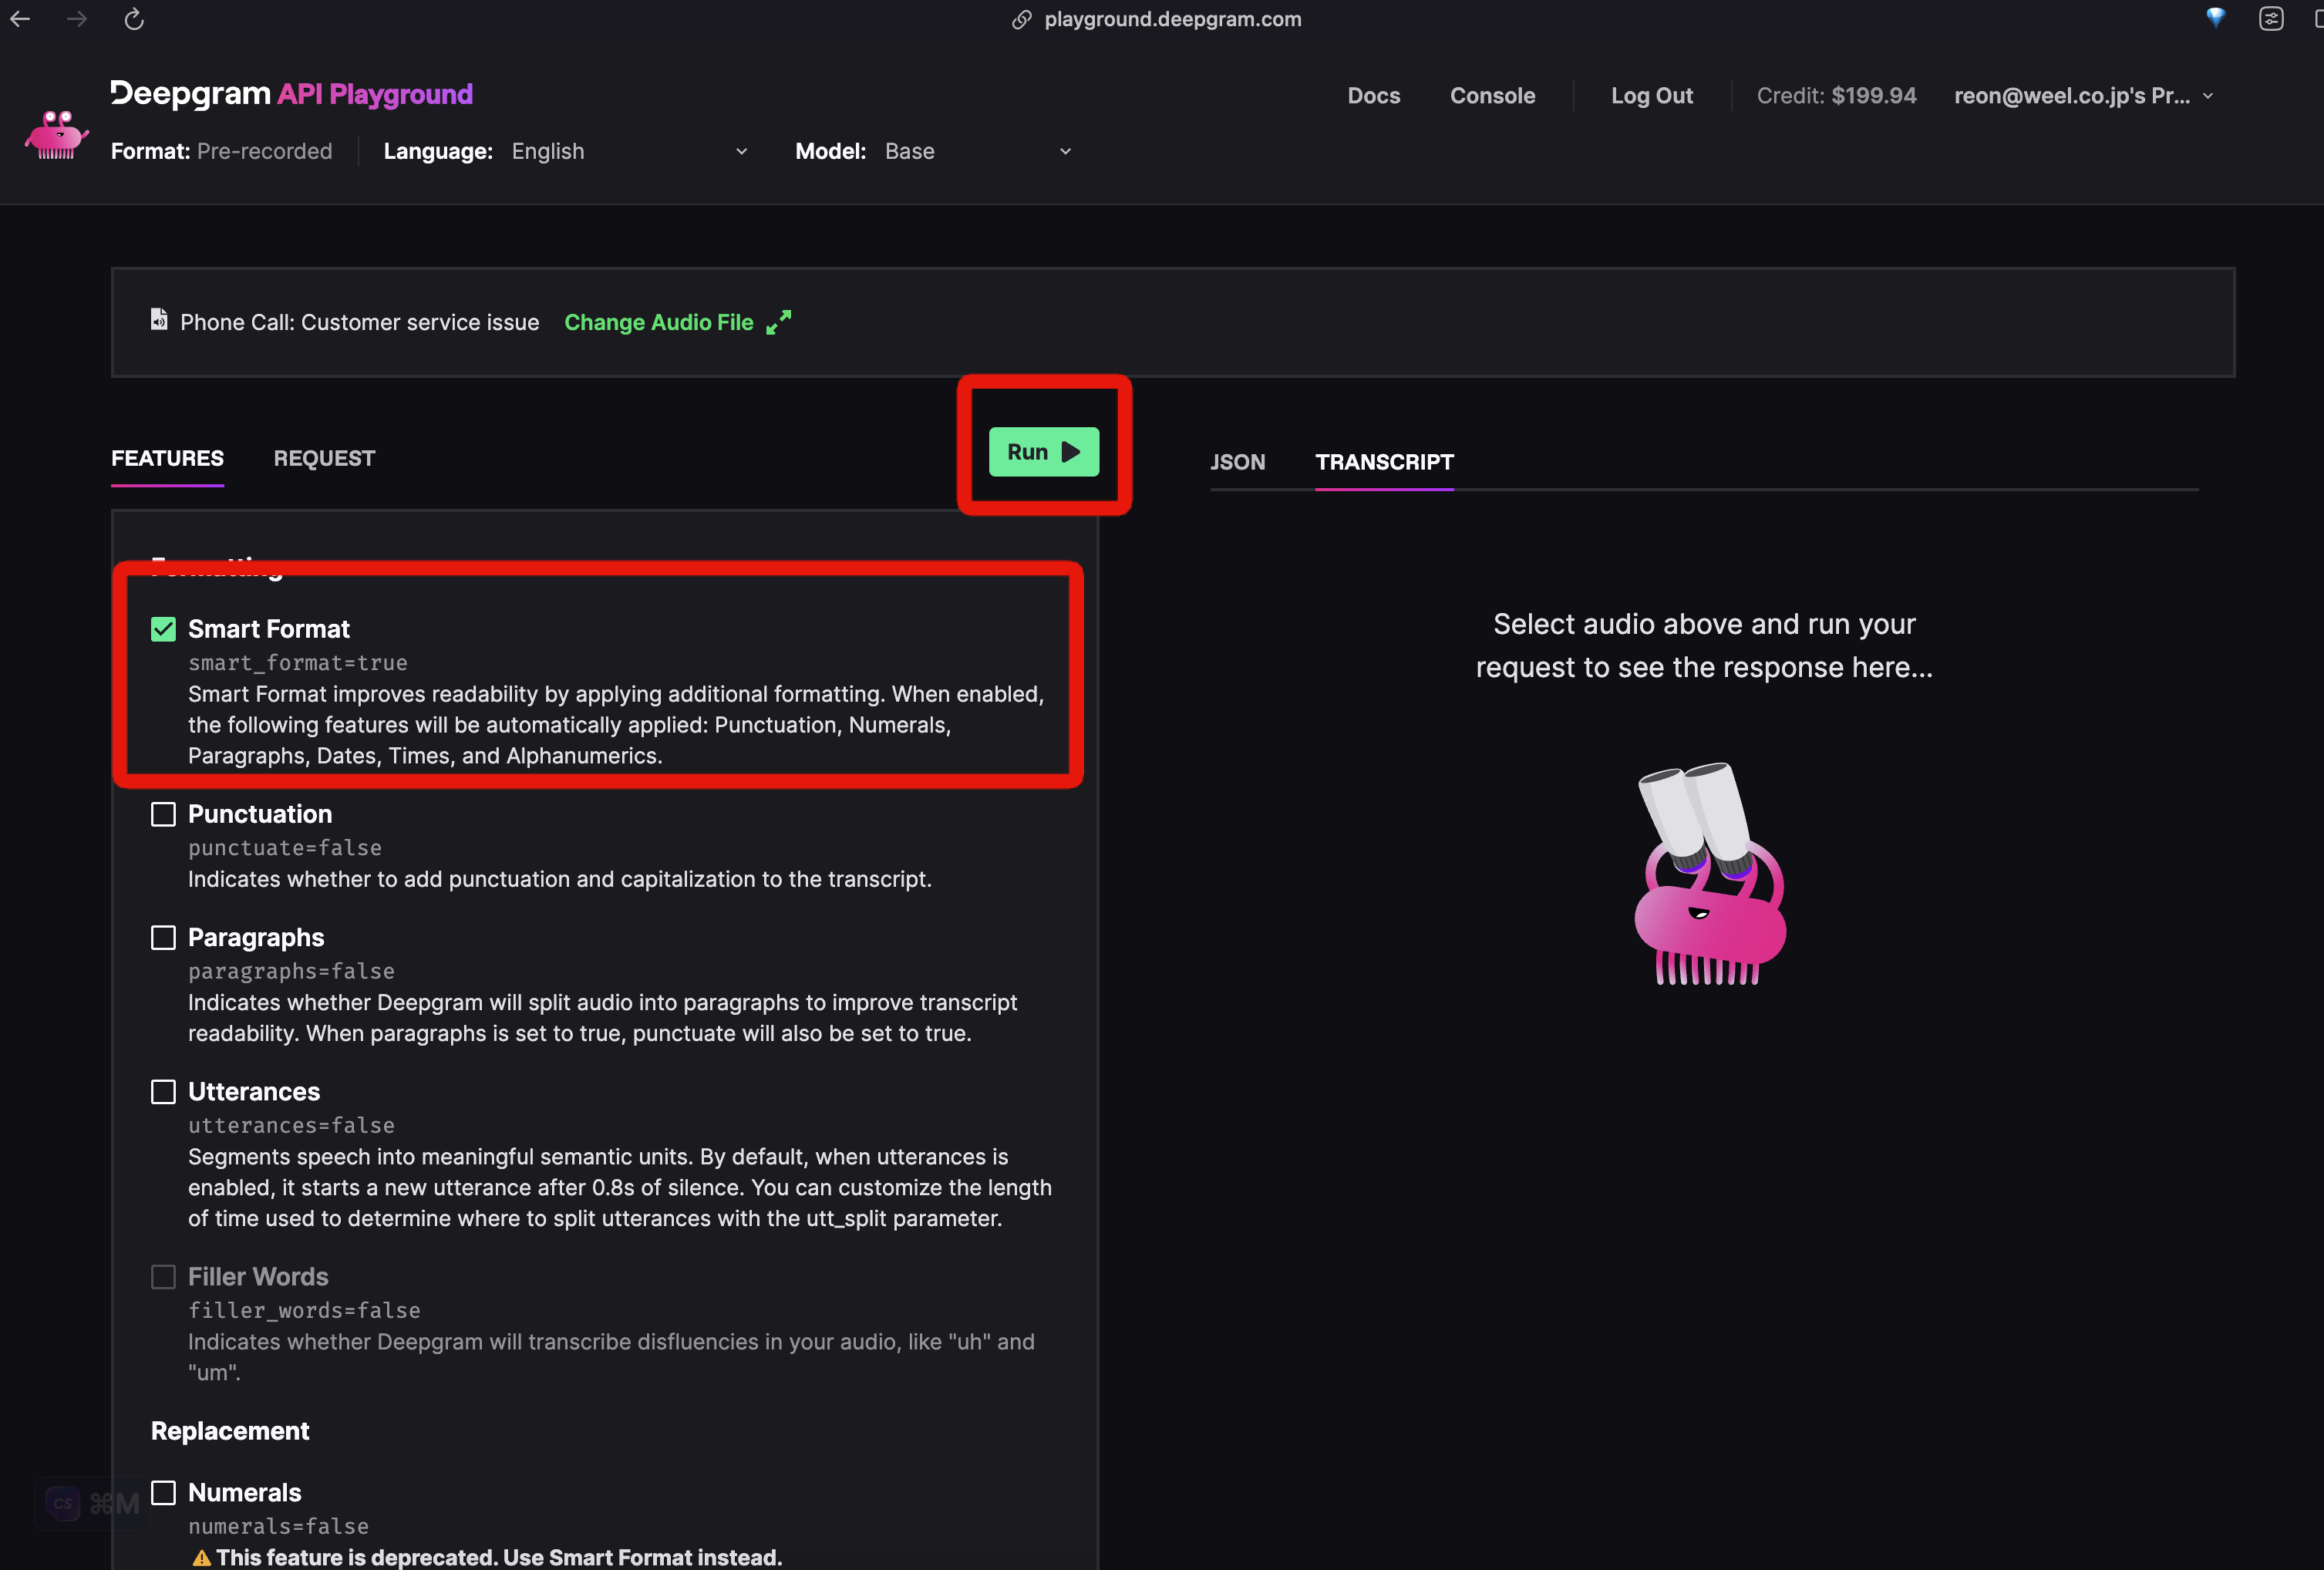
実行するとこのようになります。実行結果のすべてを載せたかったのですが、長文すぎたのでキャプチャだけです。
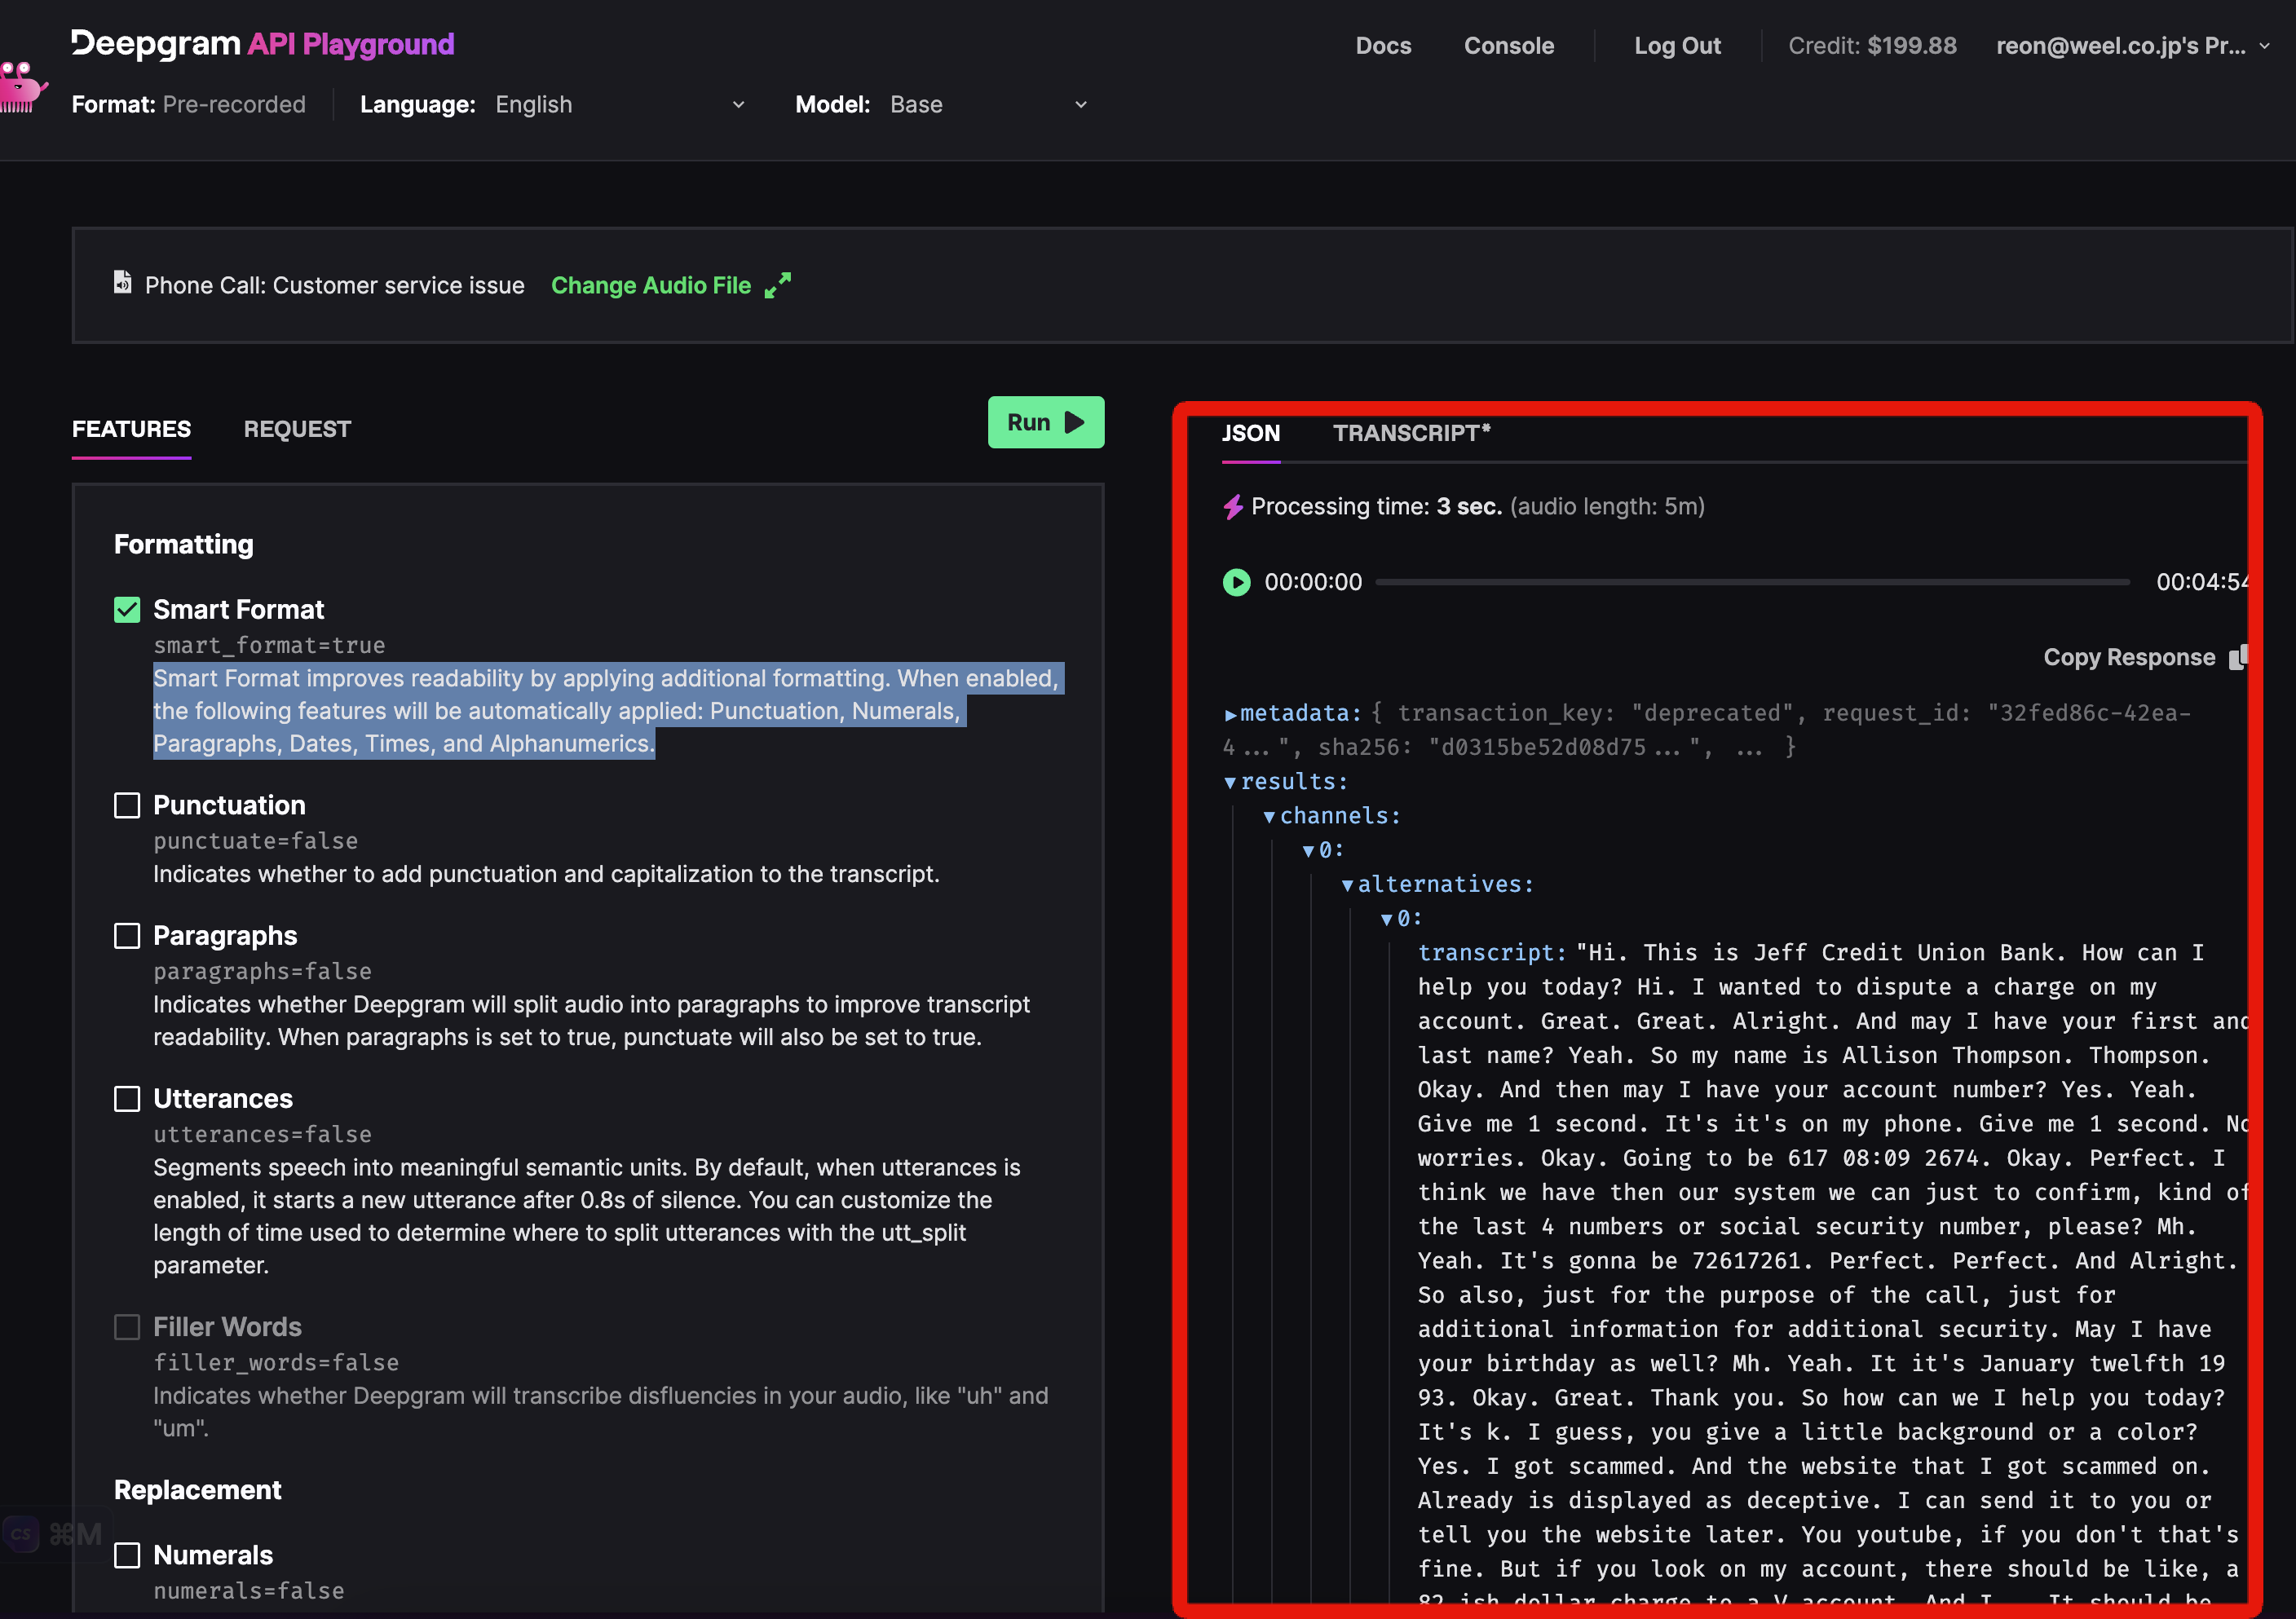
ちなみにレスポンスには以下のような情報が含まれています。
| 項目 | 内容 |
|---|---|
| transcript(トランスクリプト) | 処理された音声セグメントに対するテキスト |
| confidence(信頼度) | 0から1までの浮動小数点値で、トランスクリプトの全体的な信頼性を示す。値が大きいほど信頼度が高い |
| words(単語配列) | トランスクリプト内の各単語に関する情報が格納された配列 |
今回は、フォーマッティング(文章の整形)を試しました。
他にも、リプレースメント(置換)や推論などもあるみたいなのでぜひ色々試してみてください。
なお、音声を手掛かりに状況理解までこなすLLMについて知りたい方はこちらをご覧ください。
生成AI搭載の自動議事録作成ツールを比較したい方は、以下の記事もご覧ください。
リアルタイム文字起こし
Deepgramの一番の強みは、話している最中に文字起こしするストリーミング処理。Nova-3は300ミリ秒未満で結果を返すので、会議の議事録、コールセンターでの応対支援、ライブ字幕などに向いています。
Playgroundの「Transcription」を開き、言語を日本語にしてマイクで話しかけてみます。
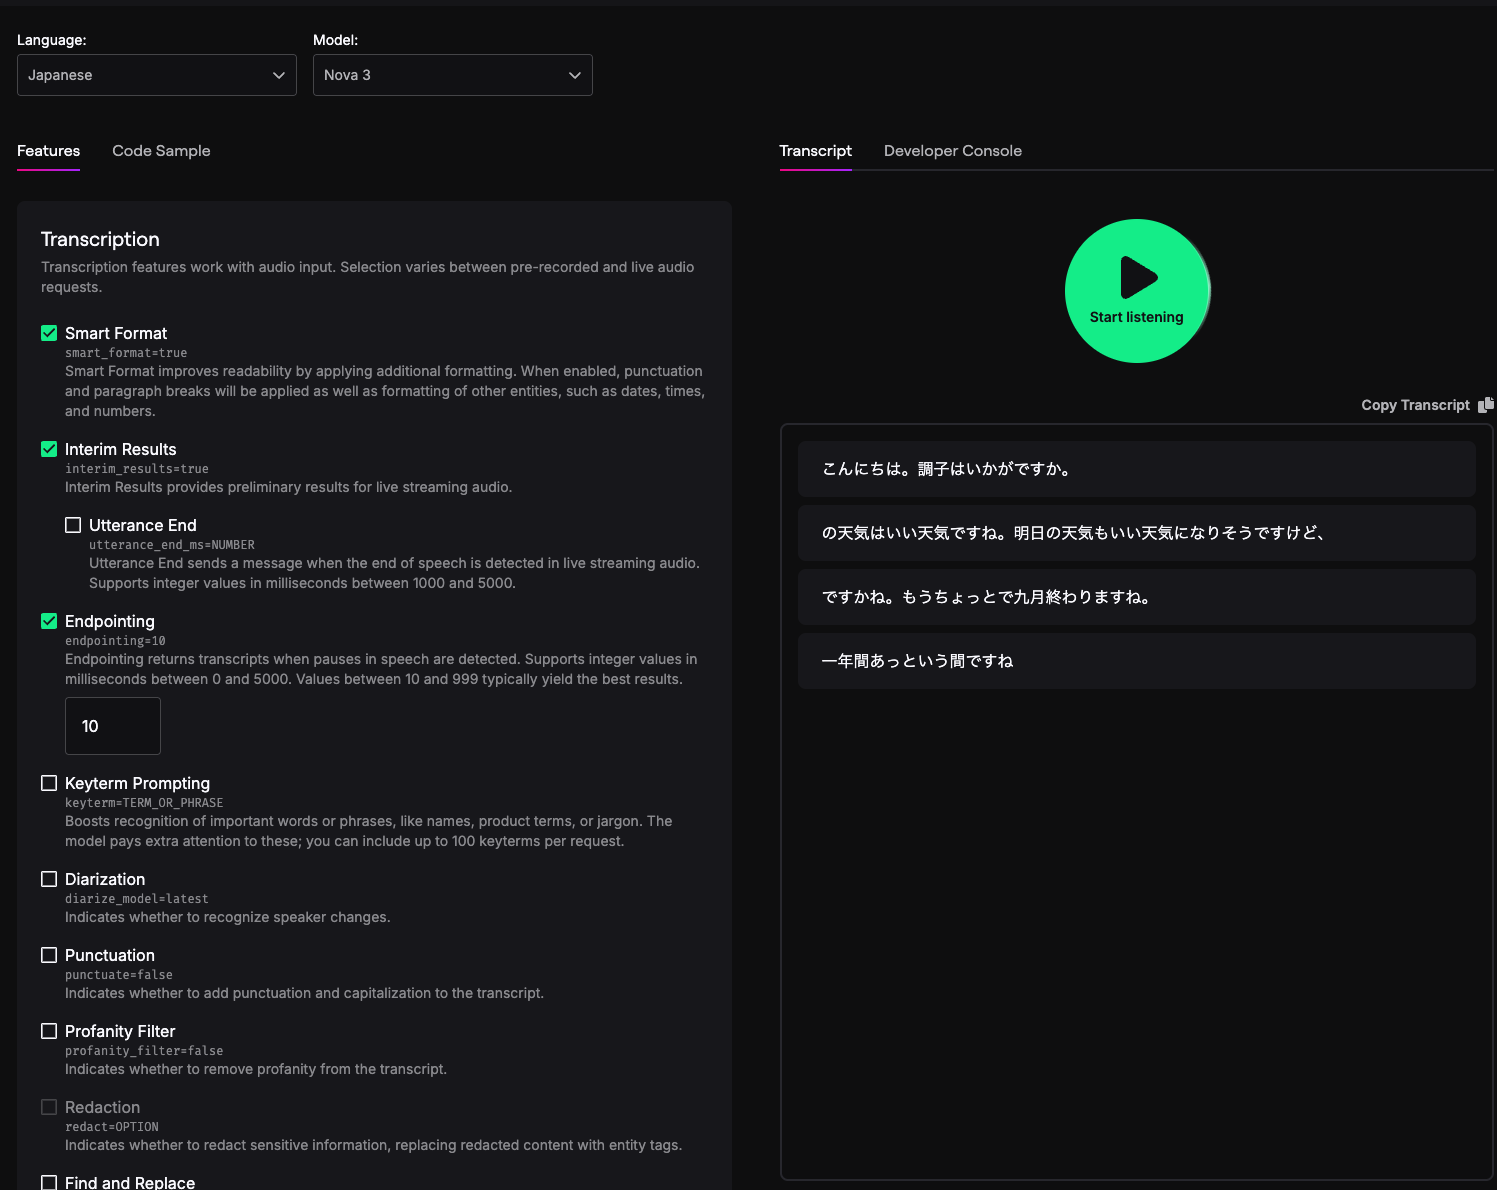
実際の様子はこちらです。
概ね適切に文字起こしされているかなという印象です。
API経由でSpeech-to-textを試してみた
ここでは、APIを使って日本語の音声を文字起こしします。
まずは、導入方法で発行したAPIキーを環境変数に設定し、必要なライブラリをインストールします。
export DEEPGRAM_API_KEY="発行したAPIキー"
pip install requests websockets次に、以下のコードをtranscribe_mic.pyという名前で保存します。モデルにNova-3、言語に日本語(ja)を指定し、句読点などを整えるSmart Formatをオンにしています。
import asyncio
import json
import os

import sounddevice as sd
import websockets

URL = (
    "wss://api.deepgram.com/v1/listen"
    "?model=nova-3&language=ja"
    "&encoding=linear16&sample_rate=16000&channels=1"
    "&interim_results=true&smart_format=true"
)


async def main():
    headers = {"Authorization": f"Token {os.environ['DEEPGRAM_API_KEY']}"}
    loop = asyncio.get_running_loop()
    queue = asyncio.Queue()

    # マイクから届いた音声を順番にキューへ入れる
    def on_audio(indata, frames, time, status):
        loop.call_soon_threadsafe(queue.put_nowait, bytes(indata))

    async with websockets.connect(URL, additional_headers=headers) as ws:

        async def send_audio():
            with sd.RawInputStream(samplerate=16000, channels=1, dtype="int16",
                                   blocksize=1600, callback=on_audio):  # 100ミリ秒ごと
                print("話しかけてください(Ctrl+Cで終了)")
                while True:
                    await ws.send(await queue.get())

        async def receive_text():
            async for message in ws:
                data = json.loads(message)
                if data.get("type") != "Results":
                    continue
                text = data["channel"]["alternatives"][0]["transcript"]
                if not text:
                    continue
                if data["is_final"]:
                    print(f"\r[確定] {text}")
                else:
                    print(f"\r[途中] {text}", end="", flush=True)

        await asyncio.gather(send_audio(), receive_text())


asyncio.run(main())マイクの音声を100ミリ秒ずつDeepgramに送り、返ってきた結果を表示する仕組みです。interim_results=trueを付けているので、話し終わる前の途中の結果も受け取れます。
あとは、ターミナルで実行するだけです。
python transcribe_mic.py実際に話しかけてみると、以下のように文字起こしされました。
話している最中は「[途中] はいい天気です。」のように仮の結果が表示され、話し終わると「[確定] はいい天気ですね。」と確定した文に置き換わりました。話してから文字が出るまでの遅れはほとんど感じず、会話のテンポについてきてくれる印象です。
「、」「。」「?」の句読点は、smart_formatによって自動で付きました。一方で、「ちょっとで休が終わりますけれども」「どんな年齢に」の2か所は、話した内容と違う文字になっていました。
40行ほどのコードで、話した声がその場で文字になるので、議事録ツールや音声アプリにも組み込みやすいのではないでしょうか。
Deepgramなど生成AIツールのご相談はWEELへ
Deepgramを活用することで、議事録の作成やコールセンターの応対記録、音声での受付対応といった手間のかかる業務を、リアルタイムの文字起こしと音声対話エージェントで効率化できます。
一方で、Nova-3とFluxの使い分けや、音声データを学習に使わせない設定(mip_opt_out)は設計次第で効果が大きく変わります。まずは社内の会議の文字起こしなど小規模な用途で精度を確かめ、段階的に導入範囲を広げていくことも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。