DeepSeek App APIとは?アプリの検索・ファイル・音声機能をAPIで使う方法と料金を徹底解説
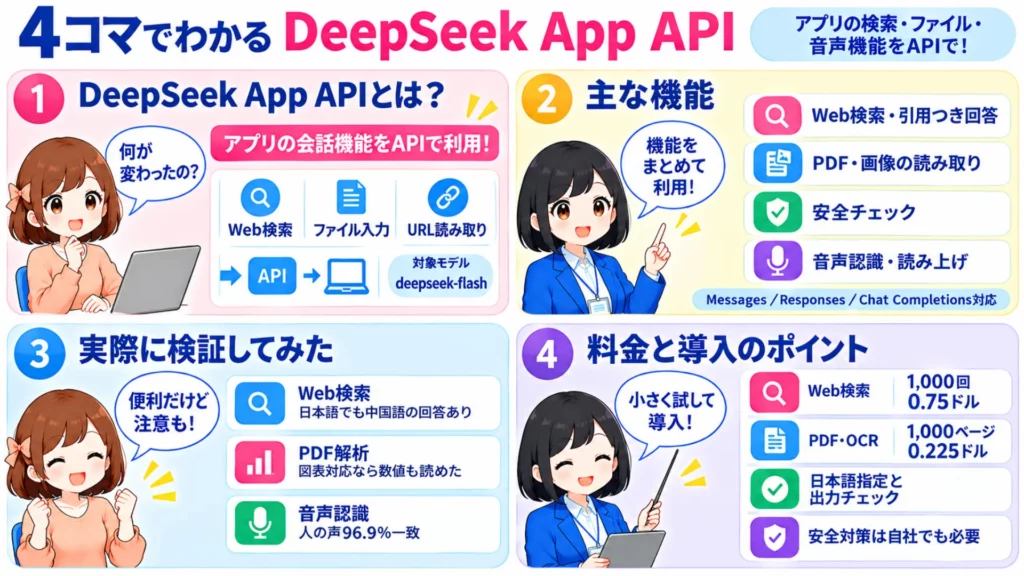
- DeepSeekアプリと同じWeb検索・ファイル入力・URL読み取りなどがAPIから利用可能
- 対象はdeepseek-flash(V4.1-Flash)で、Messages・Responses・Chat Completionsの3形式からパラメータ指定で呼び出し
- Web検索は1,000回0.75ドルで、OpenAIやAnthropicの10ドルと比べて大幅に安い
2026年11月、DeepSeekからアプリの主要な会話機能をAPIで使える新機能が発表されました。
今回発表された「DeepSeek App API」は、既存のDeepSeek APIを拡張し、Web版・アプリ版と同じWeb検索・ファイル入力・URL読み取り・安全チェックを呼び出せるようにした機能群です。音声認識・読み上げ・OCRも単体のAPIとして使えるのが特徴。
これまでDeepSeekのAPIで自社のチャットボットを作る場合、「検索や外部ページの読み込みを自分でつなぎ込む必要がある」「PDFや画像を読ませる前処理が手間」「公開サービスで不適切な回答を防ぐ仕組みが要る」といった課題がありました。
一方で、新しいAPIが登場するたびに、「従来のDeepSeek APIと何が違うのか」「どのくらいの料金で使えるのか」「実際にどう組み込めばよいのか」といった疑問を感じる方も多いのではないでしょうか。
そこで本記事では、DeepSeek App APIの概要や仕組み、特徴を整理しながら、使い方や料金、利用時の注意点について詳しく解説します。
最後までお読みいただくことで、DeepSeek App APIがどのように設計され、どのような場面で力を発揮するのかが理解できるはずです。ぜひ最後までお読みください!
DeepSeek App APIとは
DeepSeek App APIは、DeepSeekが2026年11月13日に発表した「The full DeepSeek App experience, now via API」で提供が始まった機能群です。公式ドキュメントでは「DeepSeek Full-Suite App API」とも表記されています。
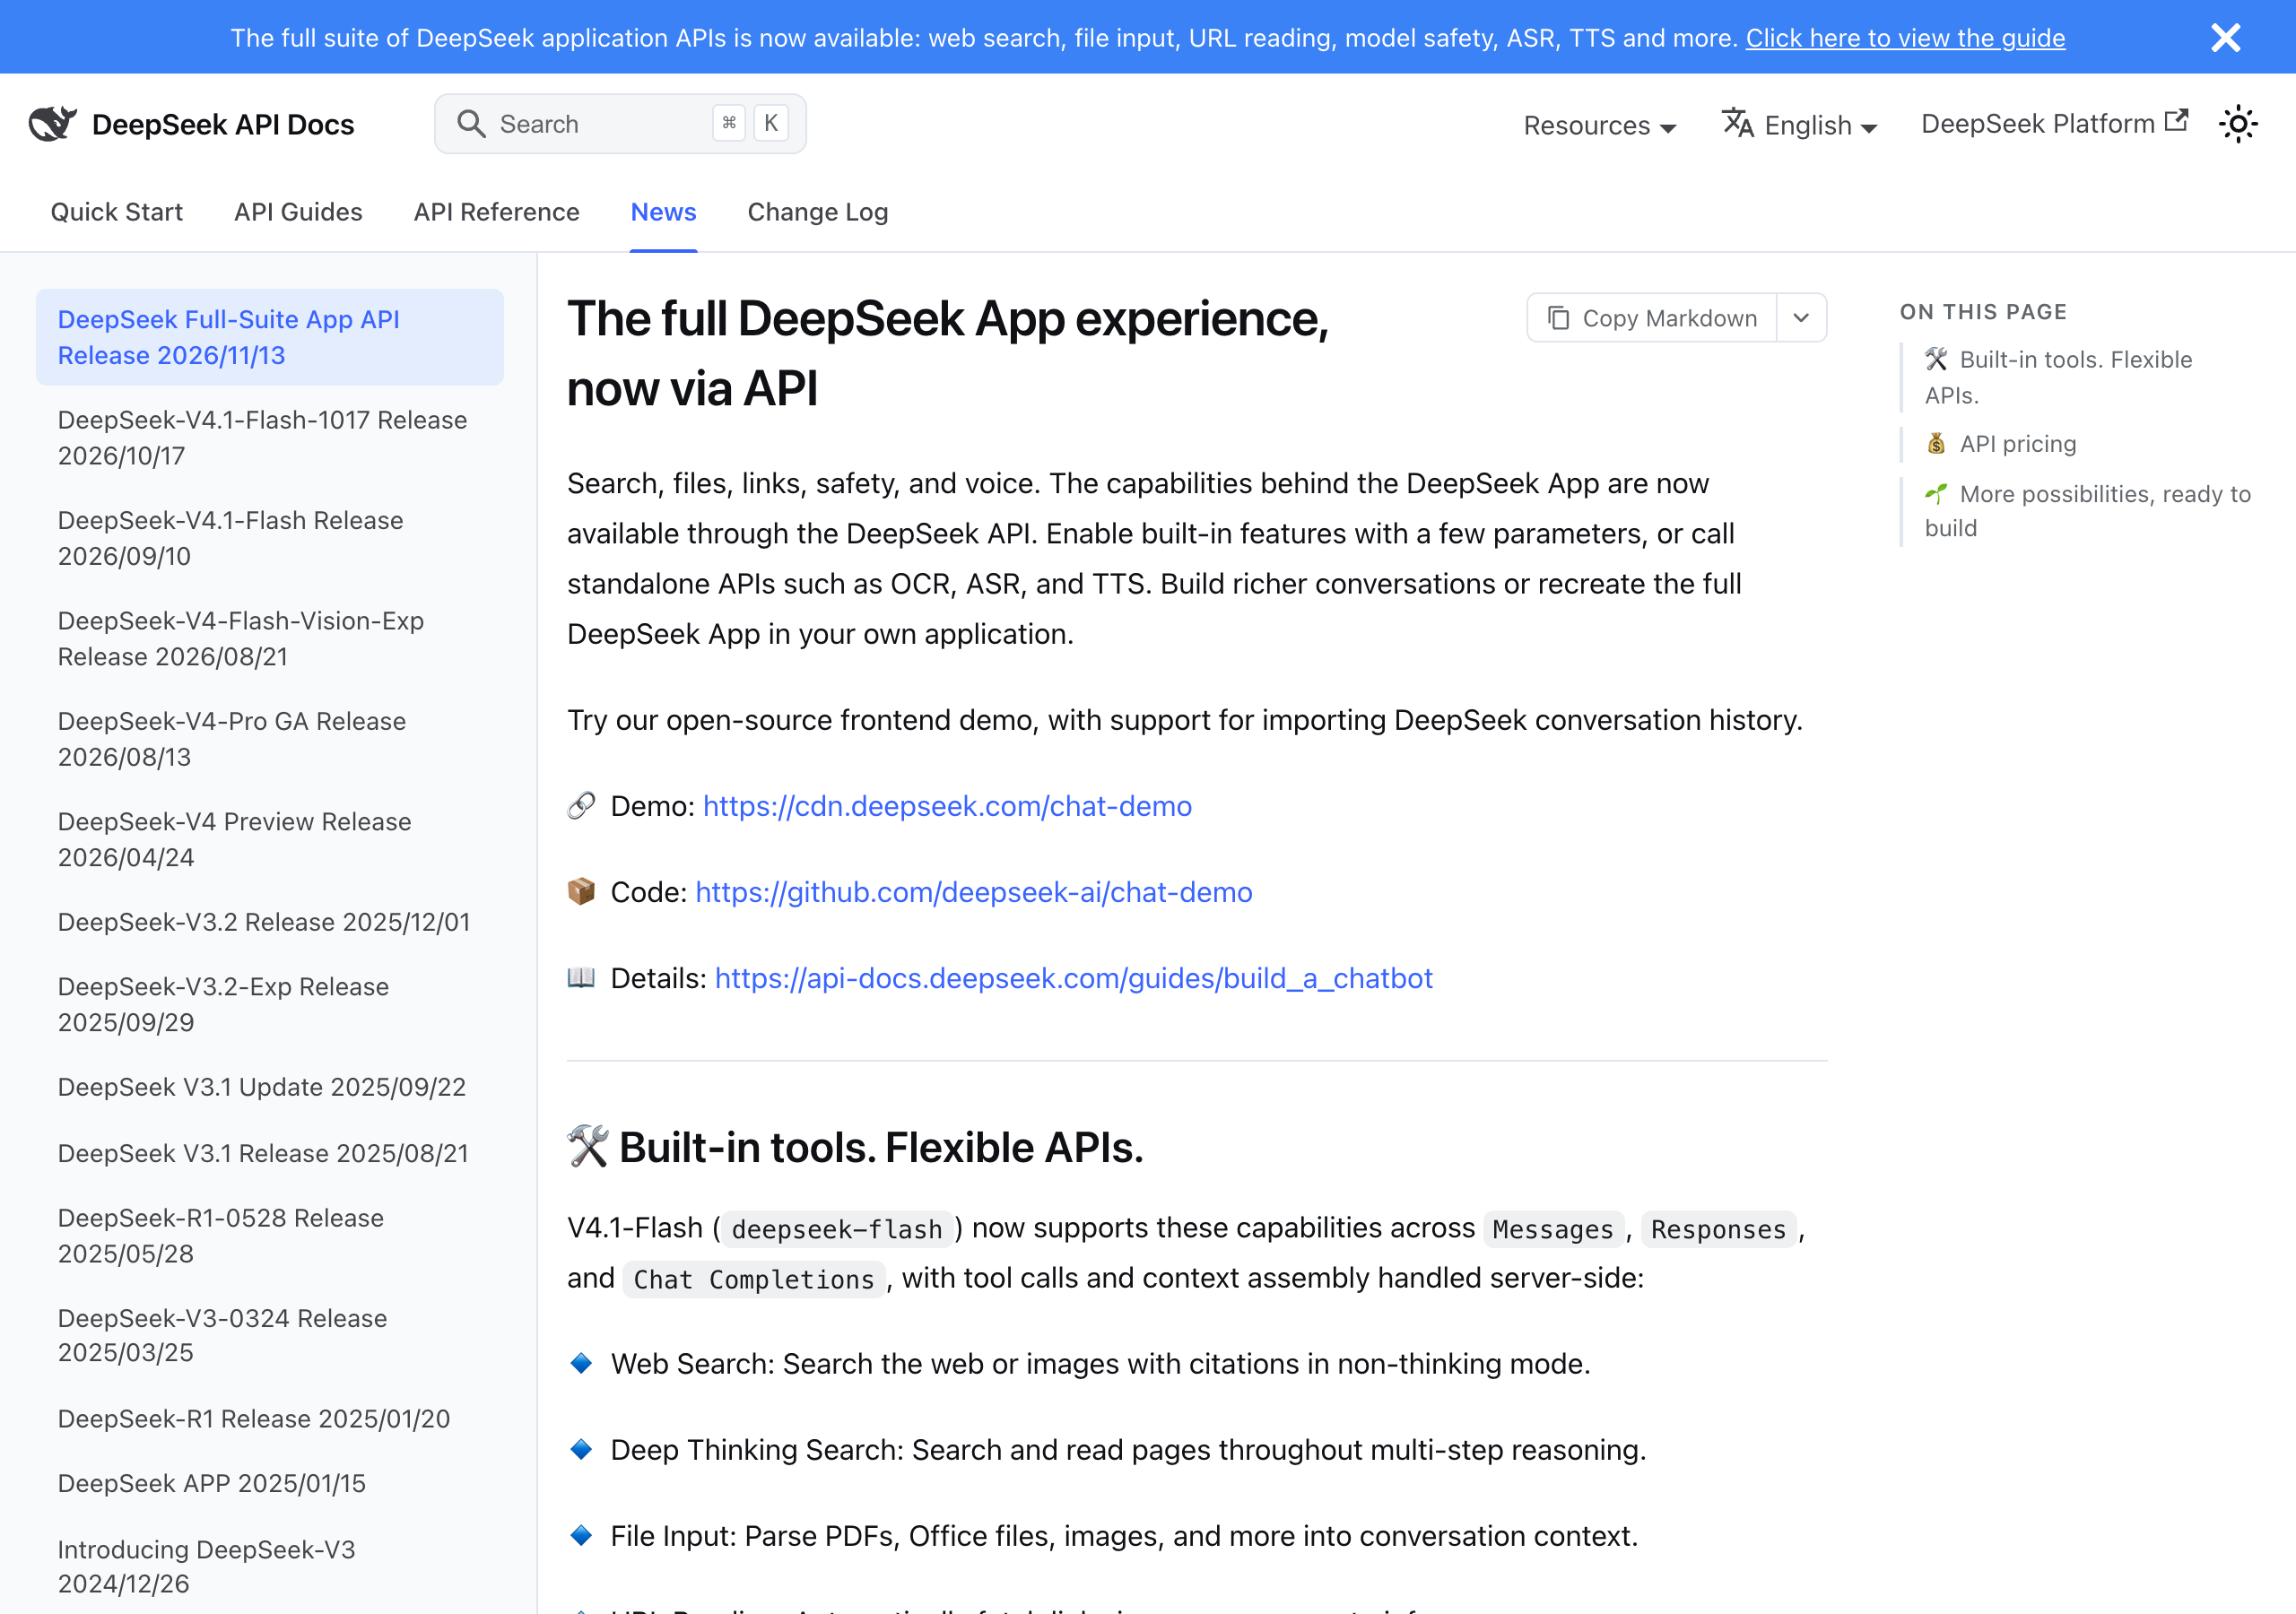
対象モデルはdeepseek-flash(DeepSeek-V4.1-Flash)。コンテキスト長は100万トークン、最大出力は384Kトークンで、画像の入力にも対応しています。
| 比較項目 | チャットAPIだけを使う構成 | DeepSeek App API |
|---|---|---|
| Web検索 | Search APIなどを別に呼び、Function Callingでつなぐ | deepseek_web_searchを指定するだけでサーバー側が実行 |
| URLの読み取り | Fetch APIなどでページを取得してプロンプトに入れる | deepseek_read_urlを指定すると、メッセージ内のリンクを必要に応じて読む |
| ファイル入力 | ファイル解析を使わない場合はPDFなどを自前でテキスト化する | Files APIにアップロードし、file_idで参照 |
| 安全対策 | 既定のチェックに加えた審査は自前で用意する | safety_check(high)で入力・出力の基本審査を追加 |
| 音声・OCR | 別サービスを組み合わせる | ASR・TTS・OCRを単体APIとして提供 |
アプリと同じ会話機能をAPIで使える
最大のポイントはDeepSeek ChatのWeb版・アプリ版と同じ会話機能がAPIで提供されたことです。使える機能は次の通り。
| 機能 | 内容 | 有効にする方法 |
|---|---|---|
| Web検索 | 質問に応じてWeb検索・画像検索を行い、引用つきで回答する | deepseek_web_searchを指定し、thinkingをオフ |
| Deep Thinking Search | 推論の途中で検索とページ閲覧を自分で繰り返す | deepseek_web_searchを指定し、thinkingをオン |
| ファイル入力 | PDF・Word・PowerPoint・画像などを解析して文脈に加える | Files APIでアップロードし、file_idで参照 |
| URL読み取り | ユーザーのメッセージ内のリンクを取得して回答に使う | deepseek_read_urlを指定 |
| 安全チェック | 入力と出力を審査し、リスクがあれば拒否の印を返す | safety_check: {“level”:”high”} |
| ユーザー情報の付与 | 日付・地域・言語などをモデルに伝える | latest_reminderのメッセージを追加 |
| 会話タイトル | 回答の終了時に会話の短いタイトルを生成する | title: {“enabled”: true} |
| 読み上げ・音声入力 | 回答の音声化と、話した内容の文字起こし | TTS・ASRの単体API |
3つのAPI形式から呼び出せる
新機能はAnthropic互換のMessages API、OpenAI互換のResponses APIとChat Completions APIの3形式で使えます。既存のSDKやコードを大きく書き換えずに試せる点は、導入のハードルを下げるのではないでしょう。
検索やURL読み取りをサーバー側で実行する
検索とURL読み取りは、DeepSeekのサーバー側で実行されます。クライアントは返ってきた結果を表示し、次の会話でそのまま返すだけで済みます。
公開サービス向けの安全チェックを備える
安全チェックを有効にすると、モデルへの入力と出力が審査され、リスクがあれば拒否の印か、入力段階のエラー(HTTP 400)が返されます。DeepSeekは、一般向けにサービスを提供する場合はこのパラメータを有効にするよう求めています。
音声・OCRなどは単体APIとしても使える
2026年10月に公開済みのSearch・Fetchに加え、OCR・ASR(音声認識)・TTS(読み上げ)もチャットとは別の単体APIとして提供されています。チャットボットに限らず、独自のワークフローに部品として組み込めます。
画面側のデモもオープンソースで公開
DeepSeekは、これらのAPIで作ったチャット画面のデモ「chat-demo」をGitHubで公開しています。APIキーを入力するだけで試せ、DeepSeek Chatから書き出した会話履歴を読み込んで続きを話すことも可能です。
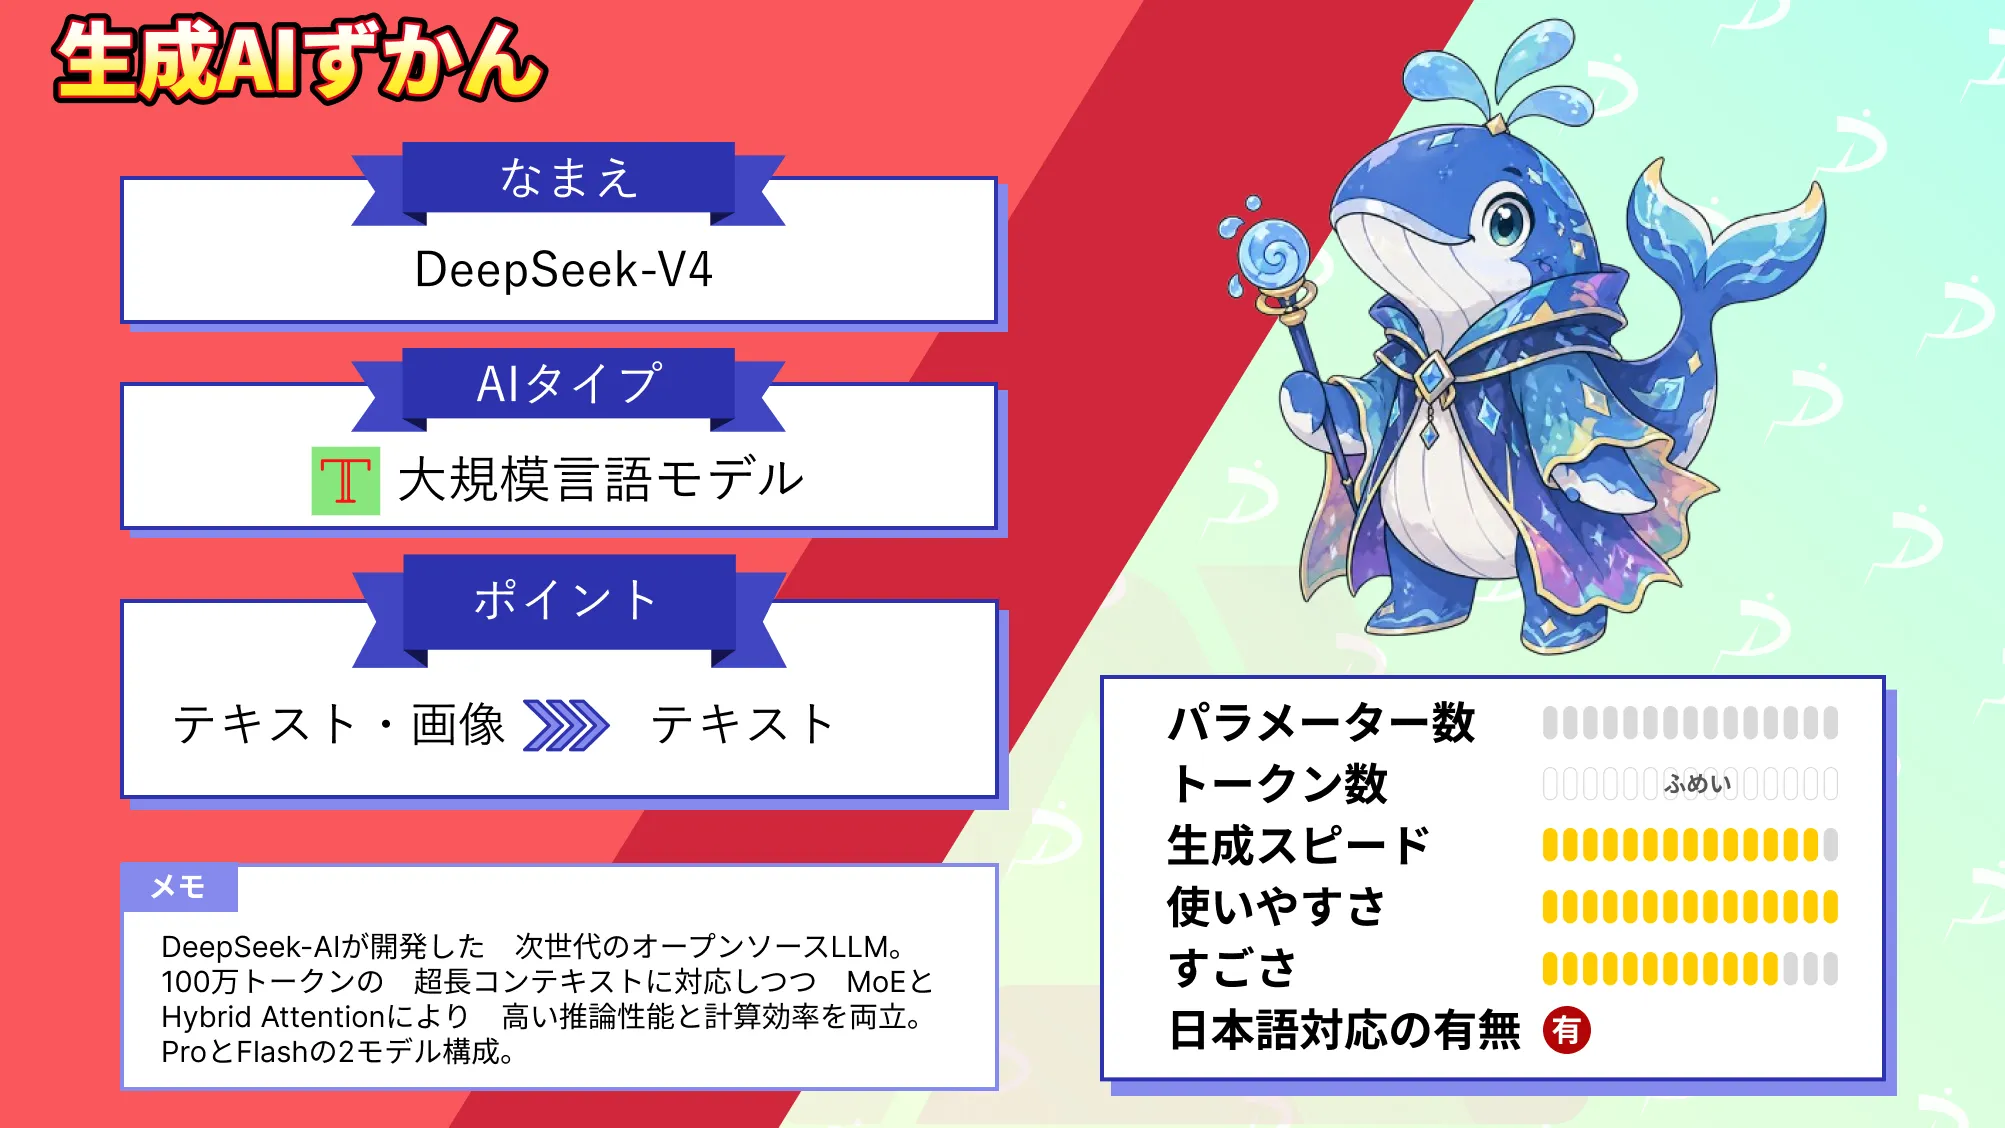
deepseek-flashの前身にあたる「DeepSeek-V4-Flash」について、詳しく知りたい方は下記の記事もあわせてご覧ください。

DeepSeek App APIの仕組み
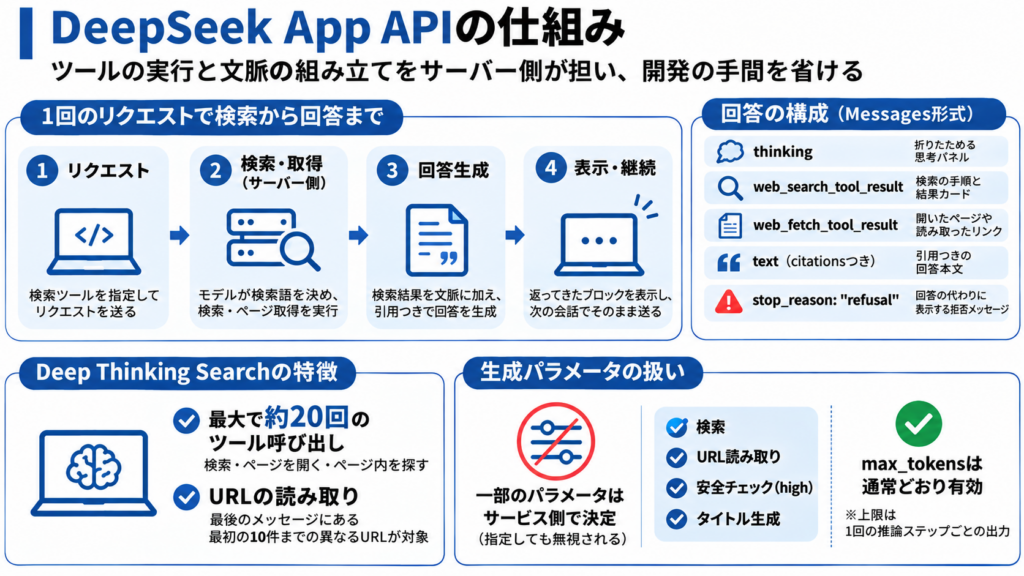
DeepSeek App APIの要は、ツールの実行と文脈の組み立てをサーバー側が担う点です。開発者が検索APIを契約したり、ツール呼び出しのループを書いたりする手間を省けるでしょう。
1回のリクエストで検索から回答まで進む
Web検索を有効にしたリクエストの流れは、次の通りです。
- クライアントがdeepseek_web_searchなどのツールを指定してリクエストを送る
- モデルが質問に応じて検索語を決め、サーバー側で検索やページ取得を実行する
- 検索結果を文脈に加えたうえで、モデルが引用つきの回答を生成する
- クライアントは返ってきた各ブロックを表示し、次の会話でそのまま送り返す
回答は種類の異なるブロックで返る
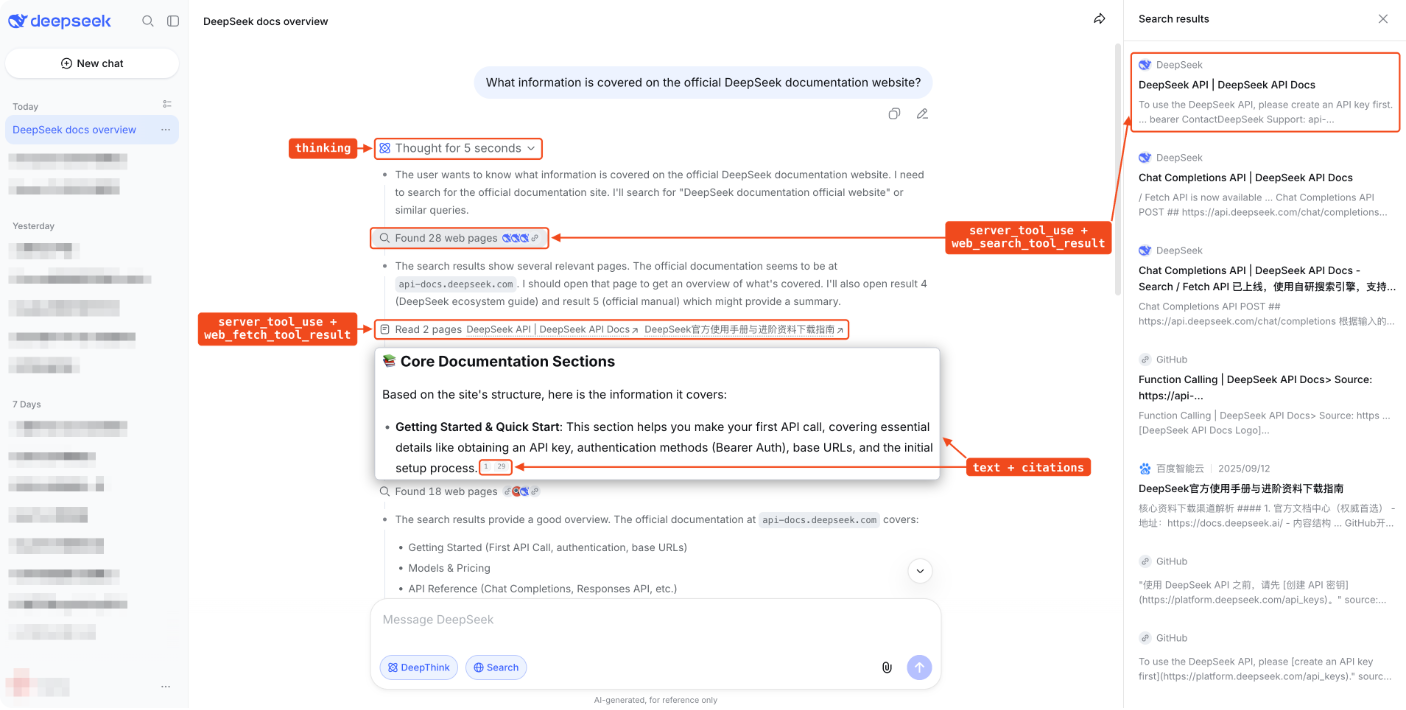
Messages形式の回答は、思考・検索・ページ閲覧・本文といった複数のブロックで構成されます。画面上での見せ方は、公式ガイドで次のように示されています。
| ブロック | 画面での表示 |
|---|---|
| thinking | 折りたためる思考パネル |
| server_tool_use+web_search_tool_result | 検索の手順と結果カード(タイトル・サイト名・アイコン) |
| server_tool_use+web_fetch_tool_result | 開いたページや読み取ったリンク |
| text(citationsつき) | 出典にリンクする引用マークつきの回答本文 |
| stop_reason: “refusal” | 回答の代わりに表示する拒否メッセージ |
Deep Thinking Searchは最大約20回ツールを使う
thinkingをオンにしたDeep Thinking Searchでは、モデルが回答までに最大で約20回のツール呼び出しを行います。検索・ページを開く・ページ内を探すという3種類の動作を組み合わせ、調べながら考える流れです。
URL読み取りでは、最後のユーザーメッセージに含まれる最初の10件までの異なるURLが対象になります。どのリンクを読むかを決めるのはモデル自身。
一部の生成パラメータはサービス側が決める
検索・URL読み取り・安全チェック(high)・タイトル生成のいずれかを有効にすると、temperatureやtop_pなどの値はサービス側が決め、リクエストの指定は無視されます。max_tokensは通常通り効きますが、上限がかかるのは1回の推論ステップごとの出力という扱い。
LLMに検索機能を持たせる「検索API」について、詳しく知りたい方は下記の記事もあわせてご覧ください。

DeepSeek App APIの使い方
DeepSeek App APIを試す方法は、公式デモで画面から触る方法と、APIを直接呼び出す方法の2つです。
公式デモで試す
コードを書かずに機能を確かめるなら、公式のchat-demoが手軽です。ブラウザだけで動く静的なアプリで、バックエンドは必要ありません。
DeepSeekの開発者向けプラットフォームにログインし、APIキーを発行します。利用は残高からの従量課金のため、事前にチャージしておきましょう。
公開版のデモを開きます。GitHubのReleasesから配布ファイルをダウンロードし、展開したindex.htmlをダブルクリックして手元で使うことも可能。
ただし、ブラウザがfile://のページでの保存に対応し、API側がそのアクセスを許可している必要があります。
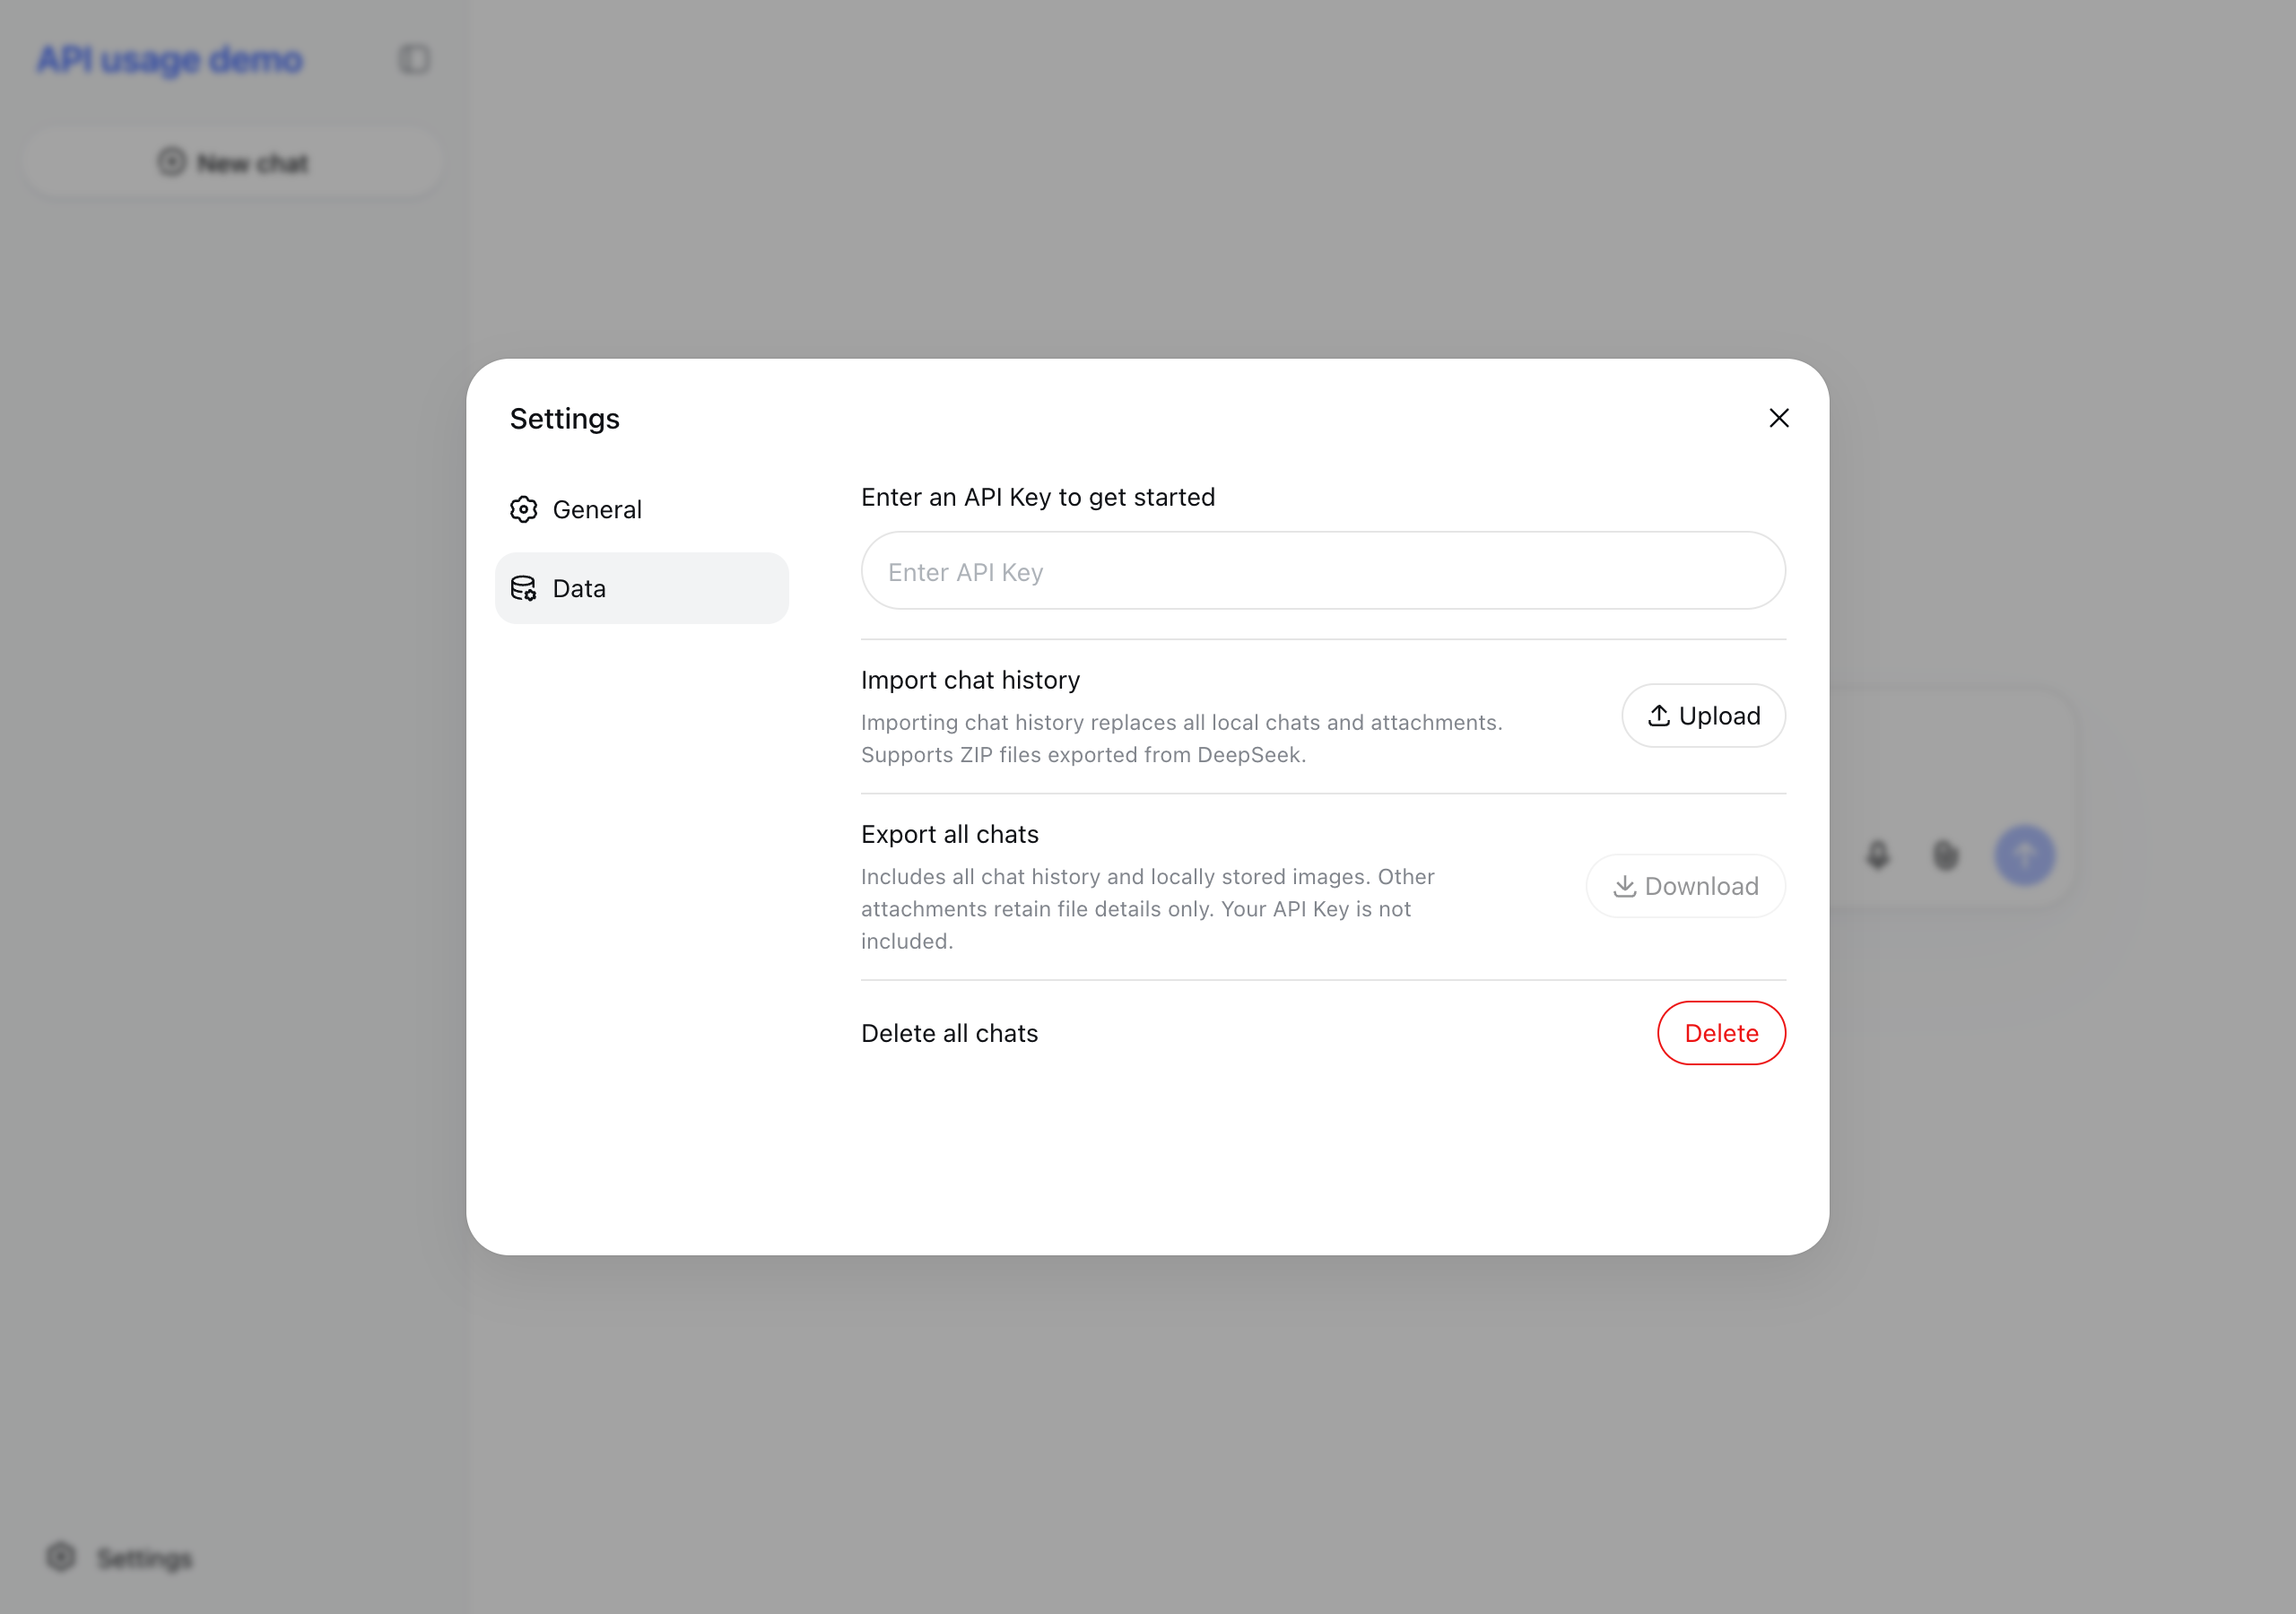
最初のチャットの前に、設定APIキーを入力します。あとは検索や深い思考を切り替えながら、ファイルの添付や音声入力も試してみましょう。
APIで検索つきのチャットを呼び出す
自分のアプリに組み込む場合は、3つのAPI形式から使い慣れたものを選びます。エンドポイントは次の通り。
| API形式 | エンドポイント |
|---|---|
| Messages(Anthropic互換) | POST https://api.deepseek.com/anthropic/v1/messages |
| Responses(OpenAI互換) | POST https://api.deepseek.com/responses |
| Chat Completions(OpenAI互換) | POST https://api.deepseek.com/chat/completions |
発行したAPIキーは、コードに直接書かず環境変数に入れておきます。
export DEEPSEEK_API_KEY="(発行したAPIキー)"Messages形式で、Web検索・URL読み取り・安全チェック・タイトル生成をまとめて指定した例です。thinkingがオンなのでDeep Thinking Searchとして動き、thinkingを”disabled”にすると通常のWeb検索とURL読み取りに切り替わる仕組みです。
curl https://api.deepseek.com/anthropic/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: ${DEEPSEEK_API_KEY}" \
  -d '{
    "model": "deepseek-flash",
    "thinking": {"type": "enabled"},
    "tools": [
      {"type": "deepseek_web_search", "name": "deepseek_web_search"},
      {"type": "deepseek_read_url", "name": "deepseek_read_url"}
    ],
    "safety_check": {"level": "high"},
    "title": {"enabled": true},
    "messages": [{"role": "user", "content": "What is new in DeepSeek V4.1?"}],
    "stream": true
}'ストリームには、思考・検索・検索結果・引用つきの本文が、処理の進み方に応じて返ってくる形。画面にはブロックごとに表示し、次の会話ではそれらを加工せずに送り返すのがルールです。
最後のmessage_deltaの使用量には、課金対象になった検索・ページ取得の回数(tool_search・tool_fetchなど)も含まれます。
ファイルを読み込ませる
ファイル入力は、Files APIにアップロードしてから、返ってきたfile_idを会話で参照する2段階の流れです。解析方法は2種類から選べ、テキストファイルなどはそのまま読み込むこともできます。
| purpose | 内容 | 課金 |
|---|---|---|
| text_recognition | テキストだけを抽出する(図表は除外) | ページ単位 |
| rich_layout_recognition | テキストに加えて図を切り出して扱う | ページ単位 |
| user_data | txt・md・csv・json・ソースコード・Excel・EPUBなどをアップロード時にテキスト化して読む | 解析料金なし |
解析の対象は、PDF・Word(DOC、DOCX)・PowerPoint(PPT、PPTX)と、PNG・JPEGなどの画像。1ファイル100MiB・1,000ページまで扱えます。
Messages形式でfile_idを参照するときは、anthropic-beta: files-api-2025-04-14のヘッダーを付けるのがポイント。
ユーザーの日付・地域・言語を伝える
ユーザーに合った回答を返すため、latest_reminderという役割のメッセージをユーザーのメッセージの直前に置ける仕組みになっています。内容は「日付,曜日,地域,プラットフォーム,言語」をカンマでつないだ文字列で、曜日は指定した言語で書きます。
{"role": "latest_reminder", "content": "2026-11-16,月曜日,Tokyo,Web,日本語"}この指定はMessagesとChat Completionsで使え、Responses APIでは受け付けられません。
チャットボットに社内の資料を読ませる「RAG」に興味がある方は下記も参考にしてください。
【実践】DeepSeek App APIを実際に使って検証してみた!
ここでは、DeepSeek App APIのWeb検索・ファイル入力・音声(TTS・ASR)を、日本語で使ったときの実力を検証してみたいと思います。いずれも2026年11月16日に、Messages形式のAPIをPythonから呼び出して試した結果。
| 検証 | 使った機能 | 見たいこと |
|---|---|---|
| ①検索 | Web検索・Deep Thinking Search | 日本語の質問に、日本語の情報源を引用して答えるか |
| ②PDF入力 | Files API(2種類の解析方法) | 表やグラフの数値を正しく読めるか |
| ③音声 | TTS・ASR | 日本語の読み上げと聞き取りの正確さ |
検証①日本語の質問でWeb検索と引用を確かめる
日本の最低賃金や東京都の人口など、日本語の情報源が必要な質問を5つ用意しました。それぞれをWeb検索(thinkingオフ)とDeep Thinking Search(オン)で1回ずつ聞いています。
| 比較項目 | Web検索 | Deep Thinking Search |
|---|---|---|
| 回答までの平均時間 | 約4.4秒 | 約10.2秒 |
| 引用の数(5問の合計) | 27件 | 26件 |
| うち日本語の情報源 | 17件 | 20件 |
| 中国語で返ってきた回答 | 5問中3問 | 5問中3問 |
最も気になったのは、日本語で質問しても10回中6回は中国語で回答が返ってきたこと。DeepSeekの発表についての質問では、Web検索の引用8件が全て中国のニュースサイトでした。
実際の回答が下記です。まずは東京都の人口について、Web検索とDeep Thinking Searchの回答を並べます。
Web検索(thinkingオフ)の回答
根据东京都官方发布的最新推算数据,截至 2026年6月1日,东京都推计人口为 14,299,726人。

需要说明的是,这是“推计人口”,与基于住民基本台帐的统计口径略有不同。作为参考,此前截至2026年1月1日的住民基本台帐人口为14,077,552人。
Deep Thinking Search(thinkingオン)の回答
東京都の最新の推計人口は**14,288,867人**で、時点は**令和8年(2026年)10月1日現在**です。

### 📊 データの補足
- **出典**:東京都の統計「東京都の人口(推計)」による公式推計値です。
- **推計の基準**:令和7年国勢調査人口(確報値)を基準に、毎月の住民基本台帳人口の増減を加えて算出されています。
- **その他の時点の参考値**:
  - 令和8年4月1日現在:14,295,440人(広報東京都2026年6月号)
  - 令和8年5月1日現在:14,328,115人(東京都の統計)
  - 令和8年8月1日現在:14,303,513人(広報東京都2026年10月号)

> これらの数値は月ごとに変動するため、最新情報は常に東京都の統計ページでご確認ください。
最低賃金の質問(Web検索)でも、日本語で聞いたのに中国語で返ってきました。
最低賃金の回答
2026年度(令和8年度)日本的最低工资全国加权平均额为 **1,177日元**(时薪)。

关于适用时间,并非全国统一日期,而是由各都道府县在 **2026年10月1日至12月2日之间** 陆续生效。具体生效日期因地区而异,需以当地劳动局公布的正式决定为准。
一方で、東京都の人口の質問では差が出ています。Web検索が6月1日時点の数字を答えたのに対し、Deep Thinking Searchは東京都の公式ページから10月1日時点の最新値を探し出しました。
検索料金は、10回の質問で課金対象の検索が計34回、約0.026ドル。日本語で答えさせたい場合は、前述のlatest_reminderで言語に「日本語」を指定するのが有効と考えられます。
検証②PDFの表とグラフを読ませる
総務省の「令和8年版 情報通信白書(概要)」19ページを、文字だけを読むtext_recognitionと図も扱うrich_layout_recognitionの2つの方法でアップロードしました。表やグラフに書かれた数値を、それぞれ聞いています。
| 質問 | 正解 | text_recognition | rich_layout_recognition |
|---|---|---|---|
| 国別のアンケート有効回答数(表) | 日本1,236件、米独中は各624件 | 正解 | 正解 |
| 生成AIの利用経験率の推移(棒グラフ) | 9.1%→26.7%→58.8% | 2023年度を読み取れず | 正解 |
| 「ほぼ毎日1時間以上」の割合(帯グラフ) | 11.1% | 「1割超」までしか答えられず | 正解 |
| アップロード+解析の時間 | ― | 14.9秒 | 12.8秒 |
表の数値はどちらも正しく読めた一方で、グラフの中にしかない数値はrich_layout_recognitionでなければ読めませんでした。text_recognitionで答えられなかった質問は、回答も中国語になっています。
違いが出たのは、グラフの中にしかない数値を聞いた2問です。text_recognitionの回答は次のとおり。
text_recognitionの回答
【利用経験率の推移】
根据文档内容,日本生成AI服务的利用经验率如下:

- **2023年度調査**:文档中未明确给出具体数值(仅说明2023年度和2024年度调查对象为20岁以上)。
- **2024年度調査**:**26.7%**
- **2025年度調査**:**58.8%**(若仅看20岁以上则为52.2%)

其中2024年度→2025年度大幅上升,文档特别说明2025年度新加入了15~19岁调查对象。

【「ほぼ毎日1時間以上」の割合】
根据提供的PDF内容,页面5中写道:

> 日本では「ほぼ毎日」利用すると回答した割合は約3割、「ほぼ毎日1時間以上」利用すると回答した割合に限っても1割超。

因此,日本回答“ほぼ毎日(合計1時間/日以上)”的比例是**1割超(超过10%)**。PDF中没有给出更精确的数值。
rich_layout_recognitionの回答
【利用経験率の推移】
日本の生成AIサービスの利用経験率(「1種類以上使っている(過去にいる)」の割合)は、5ページのグラフ「日本における生成AIサービスの利用経験(全体)」より、以下の数値が読み取れます。

*   **2023年度調査:9.1%**
*   **2024年度調査:26.7%**
*   **2025年度調査:58.8%**

※2025年度調査からは調査対象に15歳~19歳が加わっています(20歳以上に限ると52.2%)。

【「ほぼ毎日1時間以上」の割合】
日本の「ほぼ毎日(合計1時間/日以上)」と回答した割合は **11.1%** です。

(5ページ目の「生成AIサービスの利用頻度(国別)」のグラフにおいて、日本の棒グラフの最も左側、オレンジ色の部分に「11.1」と記載されています。)検証③日本語の読み上げと聞き取りを試す
TTSで日本語の文を2つの声で読み上げ、その音声をASRで文字に戻して原文と比べました。あわせて、筆者が自分で読んだ約15秒の音声もASRにかけています。
2026年11月13日、DeepSeekはアプリの機能をAPIで公開しました。Web検索の料金は1,000回あたり0.75ドルです。明日の会議は午後3時半から第2会議室で行い、担当は佐藤と鈴木です。| 音声 | 原文との一致率 | 崩れた箇所の例 |
|---|---|---|
| stella(女性)の読み上げ | 89.7〜94.1% | 「0.75ドル」→「0.何ゴドル」、「鈴木」→「続き」 |
| tide(男性)の読み上げ | 91.3% | 「1,000回」→「100回」、「鈴木」→「続き」 |
| 筆者の声(約15秒) | 96.9% | 「議題」→「下題」 |
崩れた原因を切り分けるため、同じ読み上げ音声を別の音声認識(Whisper)でも文字にしてみました。「鈴木」が「続き」になる誤りは4回中3回、Whisperでも同じように起きています。
2つの認識で同じ誤りが出ることから、「鈴木」の発音は読み上げ側で崩れている可能性が高いでしょう。一方の「1,000回」→「100回」はWhisperでは正しく聞き取れており、こちらはDeepSeekのASR側の誤り。
人の声の聞き取りは約15秒の音声を1.7秒で文字にし、一致率は96.9%。「11月20日」「DeepSeek」「API」といった数字や英単語も正しく認識できていました。
ASRが文字に戻した結果
【stellaの読み上げ → ASR(1回目)】
2026年11月13日、DeepSeekはアプリの機能をAPIで公開しました。ウェブ検索の料金は1000回あたり丸点何ゴドルです。明日の会議は午後3時半から第二会議室で行い、担当は佐藤と続きです。

【tideの読み上げ → ASR(2回目)】
2026年11月13日、DeepSeekとはアプリの機能をAPIで公開しました。ウェブ検索の料金は100回あたり0.75ドルです。明日の会には午後3時半から第二会議室で行い。担当は佐藤と続きです。

【tideの読み上げ → ASR(1回目・同じ文が繰り返された例)】
2026年11月13日、DeepSeek Token 善逸提示詞 Root 算力 INTJ ISTJ JOJO。 2026年11月13日、DeepSeek Token 善逸提示詞 Root 算力 INTJ ISTJ JOJO。 2026年11月13日、DeepSeek Token 善逸提示詞 Root 算力 INTJ ISTJ JOJO。(以下、同じ文が繰り返し)

【筆者の声(約15秒) → ASR】
来週の打ち合わせは11月20日の午後二時からです。下題は DeepSeek の API導入と見積もりの確認です。資料は前日までに共有します。検証のまとめ
| 検証 | よかった点 | 気になった点 |
|---|---|---|
| ①検索 | Deep Thinking Searchは公式ページから最新の数値を探せた | 日本語の質問でも回答が中国語になることが多い |
| ②PDF入力 | rich_layout_recognitionならグラフ内の数値まで正確 | text_recognitionではグラフの数値を読めない |
| ③音声 | 人の声の聞き取りは96.9%と高精度 | 数字の読み上げで崩れることがあり、ASRが暴走した例もあった |
いずれも料金は数セント以下で、試すハードルはかなり低いのが率直な印象。日本語のサービスに組み込むなら、言語の指定と出力のチェックをセットで設計するのが近道といえるでしょう。
DeepSeek App APIの料金とライセンス(商用利用の可否)
DeepSeek App APIの料金は、モデルのトークン料金に、使ったツールの料金が加わる仕組みです。会話タイトルの生成は無料。
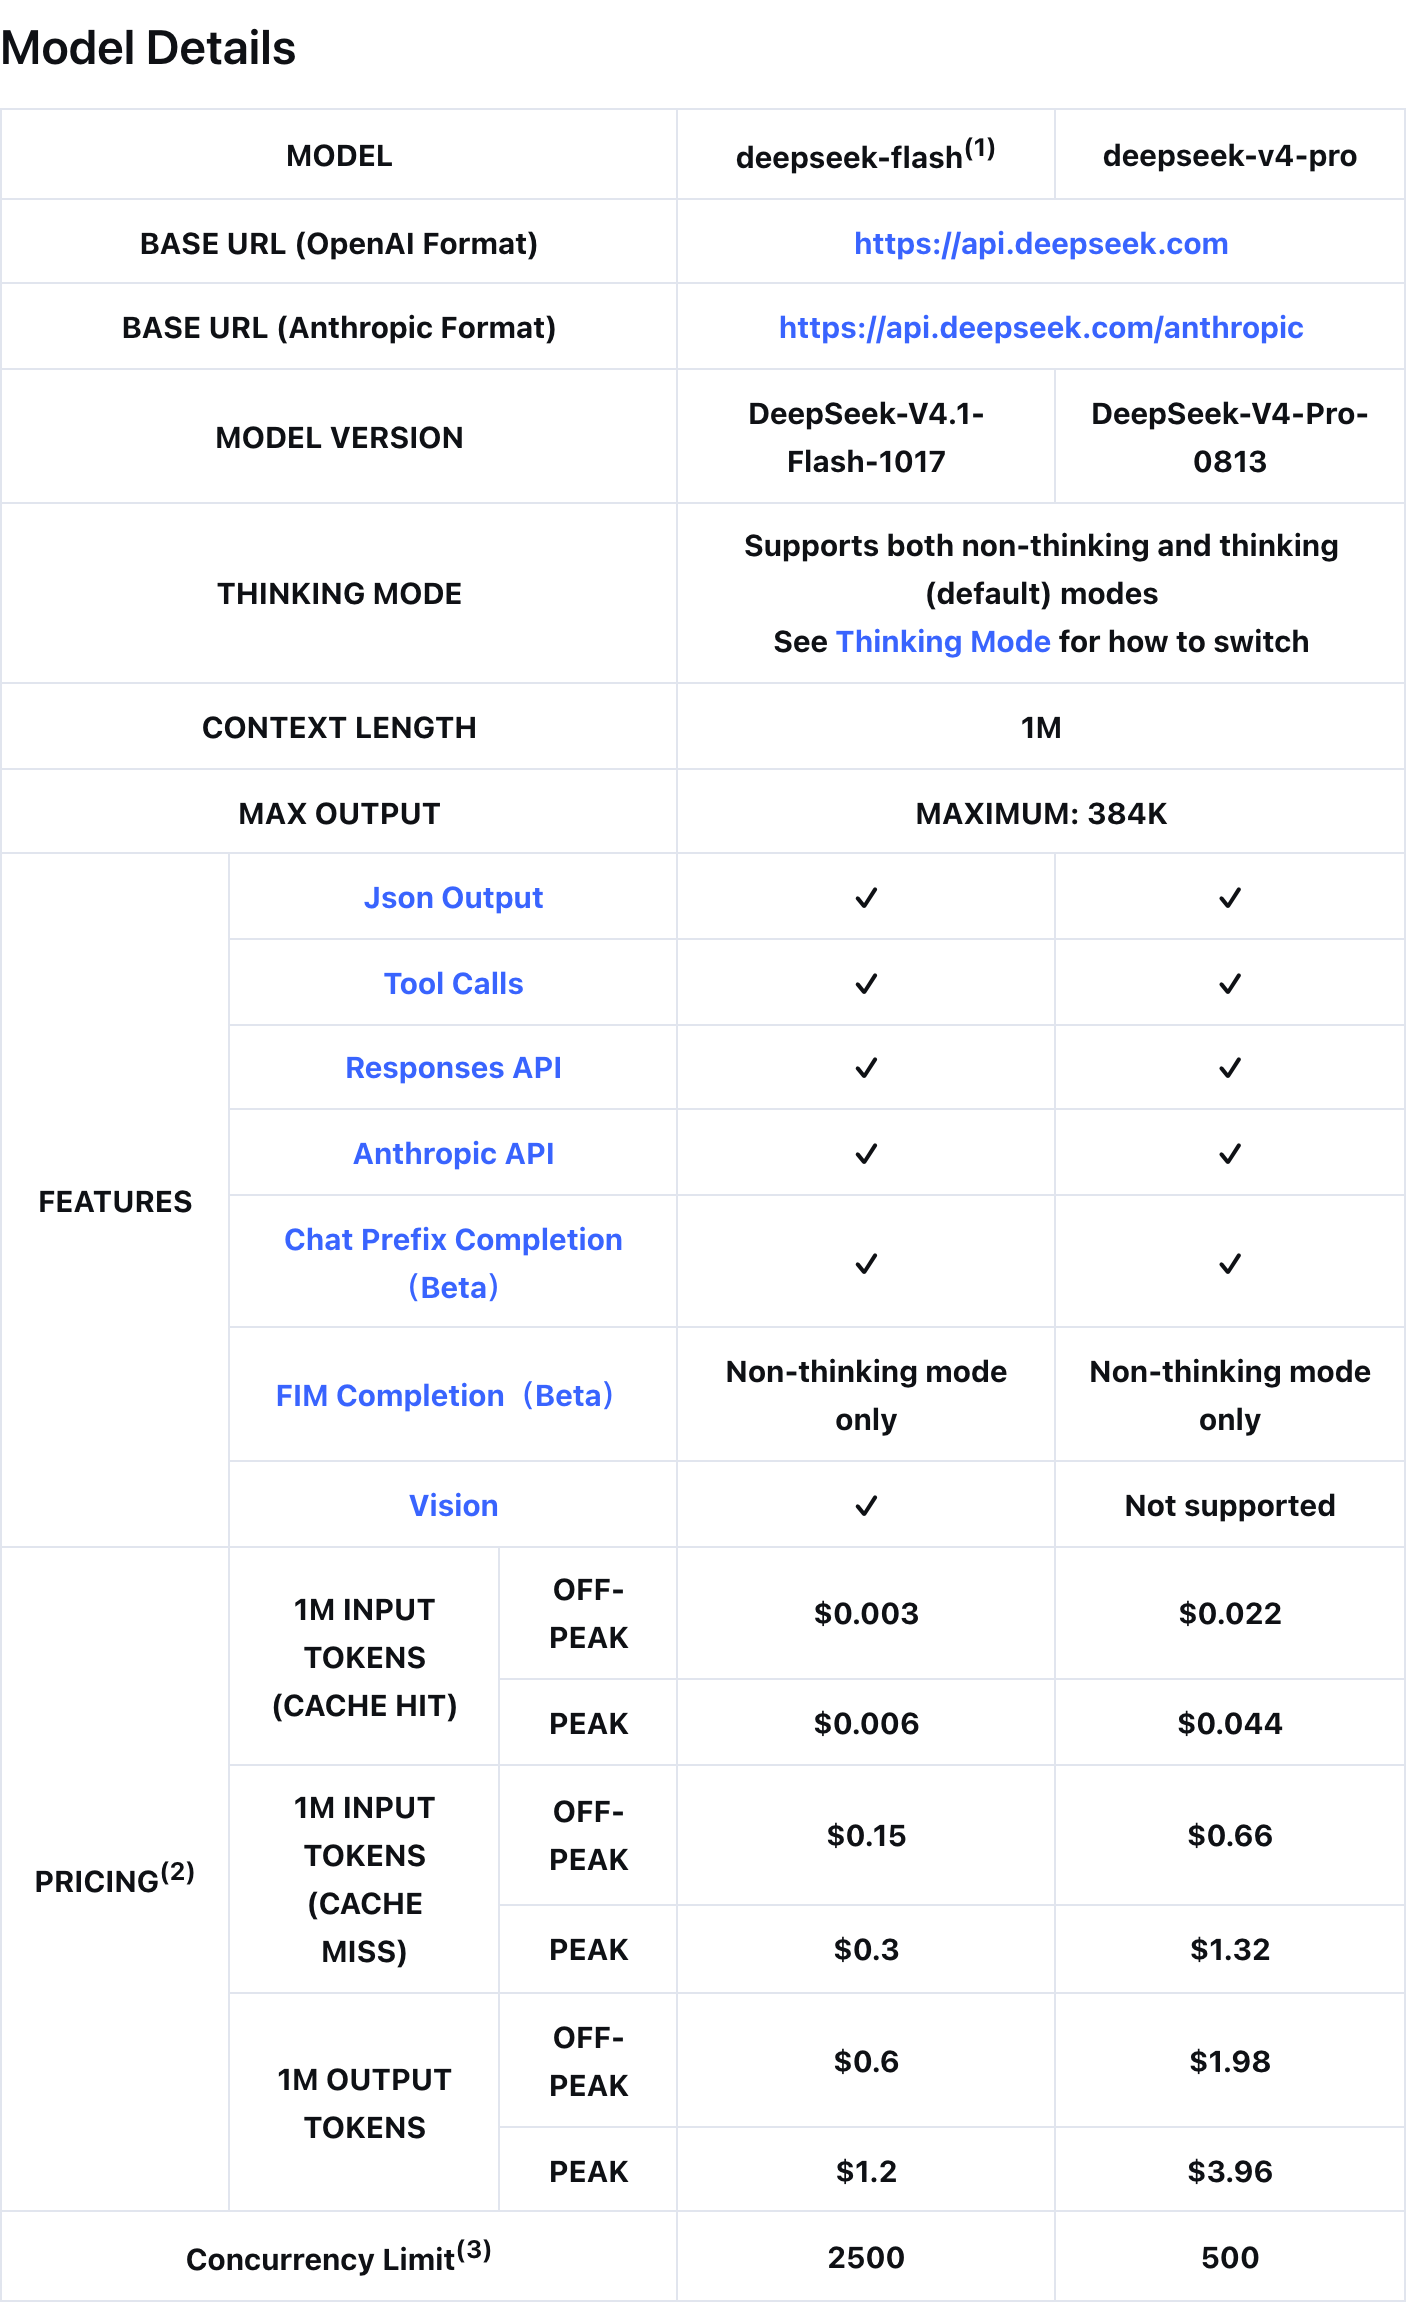
deepseek-flashのトークン料金
deepseek-flashの料金は、時間帯によって変わります。ピーク時間帯はオフピークの2倍に設定されています。
| 項目 | オフピーク | ピーク |
|---|---|---|
| 入力(キャッシュヒット) | 0.003ドル | 0.006ドル |
| 入力(キャッシュミス) | 0.15ドル | 0.3ドル |
| 出力 | 0.6ドル | 1.2ドル |
ピークは平日の日本時間10時〜13時と15時〜19時(UTCでは1時〜4時と6時〜10時)。週末と中国の祝日は終日オフピークです。
ツールの料金
ツールの料金は、トークンとは別に回数やページ数で計算されます。
| ツール | 単位 | 料金 |
|---|---|---|
| 検索(テキスト・画像) | 1,000回 | 0.75ドル |
| URL読み取り(Fetch) | 1,000回 | 0.75ドル |
| ファイル解析・OCR | 1,000ページ | 0.225ドル |
| TTS(読み上げ) | 1万文字 | 0.45ドル(期間限定で半額の0.225ドル) |
| ASR(音声認識) | 音声1時間 | 0.116ドル(期間限定で半額の0.058ドル) |
| 会話タイトル | ― | 無料 |
テキスト検索は検索語1つにつき1回と数えるため、3つの検索語で調べた場合は3回分の課金です。画像検索は画像1枚ごとに加え、モデルが選んだ領域ごとにも1回と数えます。
ページ内の文字列を探す操作は無料で、検索が失敗した場合や結果が空の場合も課金されません。
TTSでは漢字1文字を2文字として数える点にも注意が必要です。安全チェックで使われたトークンも、出力トークンとして課金されます。
他社APIのWeb検索との料金比較
Web検索の料金を、主要なLLM APIの組み込み検索と比べると次のとおりです。
| 提供元 | 検索1,000回あたり | 備考 |
|---|---|---|
| DeepSeek | 0.75ドル | 検索語1つにつき1回 |
| OpenAI | 10ドル | 通常のweb_searchの場合。検索結果のトークンはモデルの料金で別途課金 |
| Anthropic(Claude) | 10ドル | 検索結果のトークンは入力として別途課金 |
| Google(Gemini 3系) | 14ドル | 有料枠で月5,000回まで無料、その後の料金 |
単価だけを見れば、DeepSeekはOpenAIやAnthropicの10分の1以下。検索を多用するチャットボットでは、コストの差が大きく出る可能性があります。
ただ、実際の総額は検索回数や結果のトークン量、無料枠で変わるため、自社の利用量で試算するのが確実でしょう。
利用上の制約
使い始める前に押さえておきたい主な制約は、次のとおりです。
| 項目 | 内容 |
|---|---|
| 対象モデル | 会話機能は公式ガイドでdeepseek-flashを指定(deepseek-v4-proでの利用は明らかにされていない) |
| ASR(音声認識) | 1回120秒・8MiBまで、16bit PCMのWAVかOgg Opusのみ、ストリーミング認識は非対応 |
| TTS(読み上げ) | 声はstella(女性)とtide(男性)の2種類、1回1万課金文字・64KiBまで、話す速さの調整は非対応 |
| ファイル入力 | PDF・Word・PowerPointは100MiB・1,000ページまで(画像は64MiB、テキスト・表計算などは32MiB)、1回の会話で参照できる文書は20件・本文合計8MiBまで |
| 同時接続数 | deepseek-flashはアカウントあたり2,500(超えるとHTTP 429) |
| 生成パラメータ | ツールなどを有効にするとtemperatureなどの指定は無視される |
TTSは日本語を含む10言語、ASRは日本語を含む21言語に対応しています。どちらも言語の指定は不要です。
ライセンスと商用利用
APIの利用には、DeepSeek Open Platformの利用規約が適用されます。一般向けにサービスを提供する場合は、安全チェックを有効にしたうえで、コンテンツの安全審査やAI生成であることの表示など、提供者としての義務を自分で果たすよう求められています。
公式デモのchat-demoは、MITライセンスで公開されました。デモのコードの扱いは次のとおりです。
| 利用用途 | 可否 |
|---|---|
| 商用利用 | ⭕️ |
| 配布 | ⭕️ |
| 改変 | ⭕️ |
| 私的利用 | ⭕️ |
| 特許利用 | 明記なし |
DeepSeekの上位モデルを含む「DeepSeek-V4」シリーズについて、詳しく知りたい方は下記の記事をご覧ください。
【業界別】DeepSeek App APIの活用シーン
DeepSeek App APIは、検索・ファイル・音声を安く組み合わせられる点が強みです。ここでは3つの業界での活用シーンを見ていきましょう。
カスタマーサポート
問い合わせ窓口のチャットボットでは、最新の情報にもとづいて答えられるかと不適切な回答を防げるかが課題になりがち。検索や審査の仕組みを自前で作ると、開発の負担も大きくなります。
DeepSeek App APIなら、URL読み取りで自社のFAQページを読ませた上で回答させ、安全チェックで入出力を審査する構成が考えられます。会話タイトルも無料で付くため、履歴の管理画面も作りやすいのではないでしょうか。
AIチャットボットの導入の進め方について、詳しく知りたい方は下記の記事もあわせてご覧ください。

教育・語学学習
語学学習のアプリでは、発音を聞かせる読み上げと学習者の話した内容の聞き取りの両方が欠かせません。音声のサービスを別に契約すると、費用と実装の手間が膨らむ場合もあるでしょう。
DeepSeek App APIのTTSとASRは、どちらも日本語と英語に対応。教材のPDFをファイル入力で読ませ、内容に沿った会話練習をさせる使い方も考えられます。
テキストから音声を作る「音声生成AI」に興味がある方は下記も参考にしてください。
バックオフィス・書類業務
経理や総務では、紙をスキャンしたPDFや画像の書類から情報を拾う作業が多く発生します。手入力に頼ると、時間がかかるうえに転記ミスも起きやすくなります。
OCRの単体APIは1,000ページあたり0.225ドルで、rich_layout_recognitionを選べば図の位置を示す座標も返されます。読み取った結果を別途チャットに渡して要約・確認させる構成も、同じDeepSeekのAPIで組めるといえるでしょう。
生成AIを使ったOCRの仕組みと選び方について、詳しく知りたい方は下記の記事をご覧ください。
DeepSeek App APIに関するXの話題
DeepSeekの公式アカウントによる発表は、執筆時点で表示回数110万回超・1万2,000以上のいいねを集めました。ここではその反応の一部を紹介します。
こちらがDeepSeek公式の発表投稿。アプリと同じ機能をAPIで提供することが告知されました。
筆者が調べた範囲では、日本語の投稿で最も多くのいいねを集めていたのがこちら。
一方で、11月16日時点で筆者が調べた範囲では、料金や検索の質を実際に比べた日本語のレビューはまだほとんど見当たりません。検索の精度や日本語サイトへの強さは、今後の検証が待たれるでしょう。
生成AIなどのご相談はWEELへ!
いかがだったでしょうか?
DeepSeek App APIを活用することで、検索・ファイル読み込み・音声を備えたチャットボットを低コストで組み込める可能性があります。一方で、検索結果の質や安全対策の要件は用途によって大きく変わるため、自社の質問で小さく検証してから導入範囲を決めることも重要な選択肢です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
DeepSeek App APIのよくある質問
ここではDeepSeek App APIのよくある質問について回答していきます。DeepSeek App APIの使用を検討している場合には、ぜひ参考にしてみてください。