【DeepSeek-V4.1-Flash-1017】一部でOpus 5超え!性能・料金・使い方を徹底解説
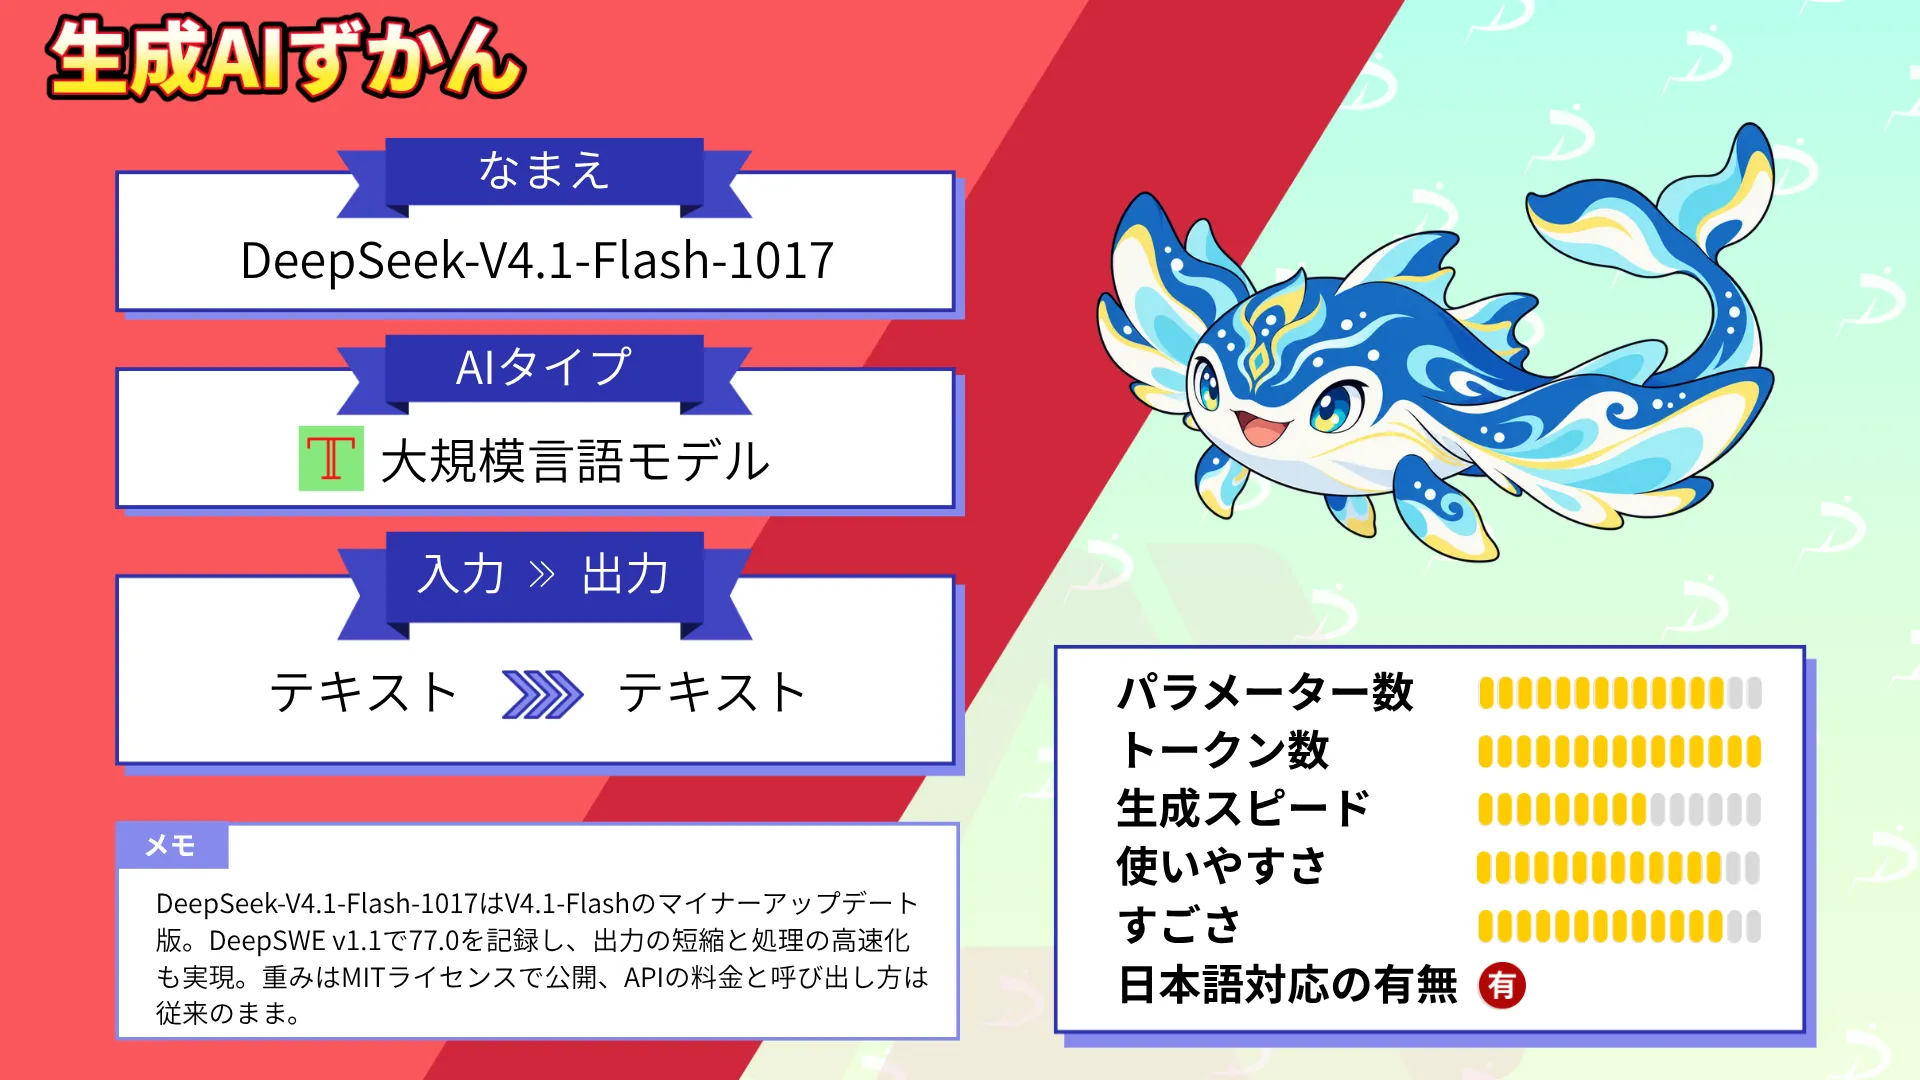
- DeepSeek-V4.1-Flash-1017はV4.1-Flashのマイナーアップデート版
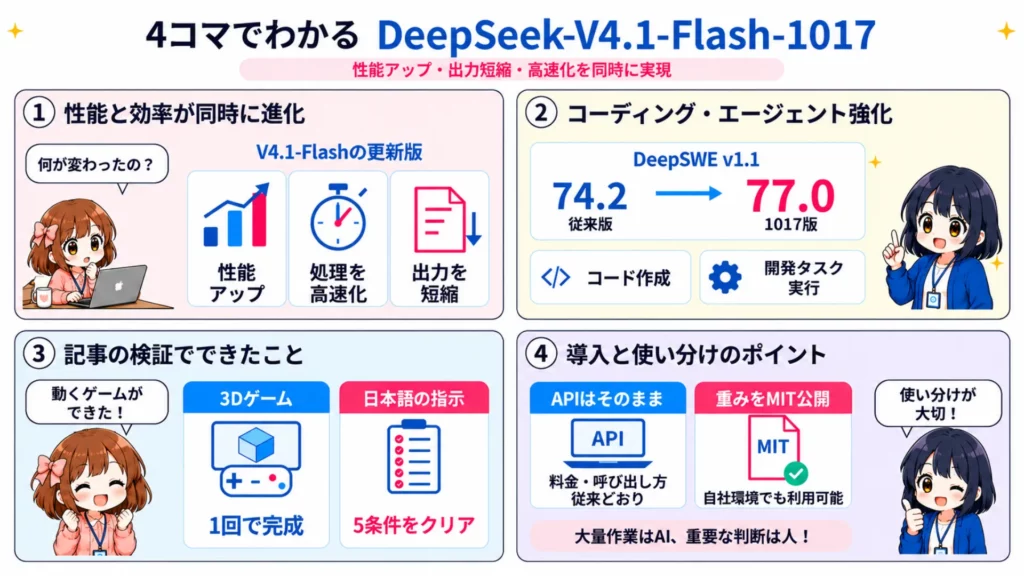
- DeepSWE v1.1で77.0を記録し、出力の短縮と処理の高速化も実現
- 重みはMITライセンスで公開、APIの料金と呼び出し方は従来のまま
2026年10月17日、DeepSeekがV4.1-Flashのアップデート版「DeepSeek-V4.1-Flash-1017」を公開しました!
今回の発表は「性能が上がったのに、出力は短く処理も速くなった」という内容で、性能とコストの両方を同時に改善した点が大きな話題になっています。
ベンチマークでは、コーディングエージェントの実力を測るDeepSWE v1.1で77.0を記録し、Opus 5やGPT-5.6 Solを上回っています。
とはいえ、「前のV4.1-Flashと何が違うの?」「日本語で使うと実際どうなの?」と気になっている方も多いのではないでしょうか?
この記事では、DeepSeek-V4.1-Flash-1017の概要・仕組み・料金・ライセンス・使い方に加えて、実際に3Dゲーム生成などを試した検証結果まで詳しく紹介します。最後まで読めば、このモデルを自社の業務や開発にどう組み込めばよいかが見えてくるはずです。ぜひ最後までご覧ください!
\生成AIを活用して業務プロセスを自動化/
DeepSeek-V4.1-Flash-1017とは?
DeepSeek-V4.1-Flash-1017は、中国のDeepSeekが開発したマルチモーダル対応の大規模言語モデルです。推論・コーディング・エージェント・画像理解の各分野で性能が伸びたうえ、タスクの実行時間と出力の長さが短くなったのがポイントです。
公開と同時にWeb版・アプリ・APIのモデルが切り替わり、重みもHugging FaceとModelScopeで配布されました。APIのモデル名はdeepseek-flashのままで、呼び出し方も料金も変わっていません。
| 項目 | 内容 |
|---|---|
| 開発会社 | DeepSeek |
| 公開日 | 2026年10月17日 |
| ベースモデル | DeepSeek-V4.1-Flash |
| 総パラメータ数 | 763B |
| アクティブパラメータ | プリフィル時8B・デコード時16B(V4.1-Flash公表値) |
| 入力 | テキスト・画像 |
| コンテキスト長 | 100万トークン |
| 最大出力 | 384Kトークン(API) |
| ライセンス | MIT License |
| 提供形態 | Web版・アプリ・API・オープンウェイト |
出力が短くなったのに性能が上がった「パレート改善」
DeepSeek-V4.1-Flash-1017の一番の特徴は、性能とコストのトレードオフを同時に改善したことです。
公式のXポストでは、前バージョンと比べて「ベンチマーク性能の向上」「タスク完了の高速化」「出力の短縮」を挙げ、これを性能とコストのパレート改善と表現しています。性能を上げるために出力を長くするのではなく、短い出力でより正確に解くようになったわけです。
APIは出力トークン数で課金されるため、同じ単価でも出力が短くなれば1タスクあたりの費用は下がります。エージェントのように何十回もモデルを呼び出す使い方では、この差がそのまま月々の請求額に響いてくるでしょう。
コーディングとエージェント性能が大きく伸びた
ベンチマークの伸びが特に大きいのは、ターミナル操作やリポジトリ単位の開発を問うエージェント系の評価です。
モデルカードによると、Terminal-Bench 4.0は31.2から42.3へ、ProgramBenchは20.3から29.1へと大きく伸びています。DeepSWE v1.1では77.0を記録し、Opus 5(74.0)やGPT-5.6 Sol(73.0)を上回る結果となりました。
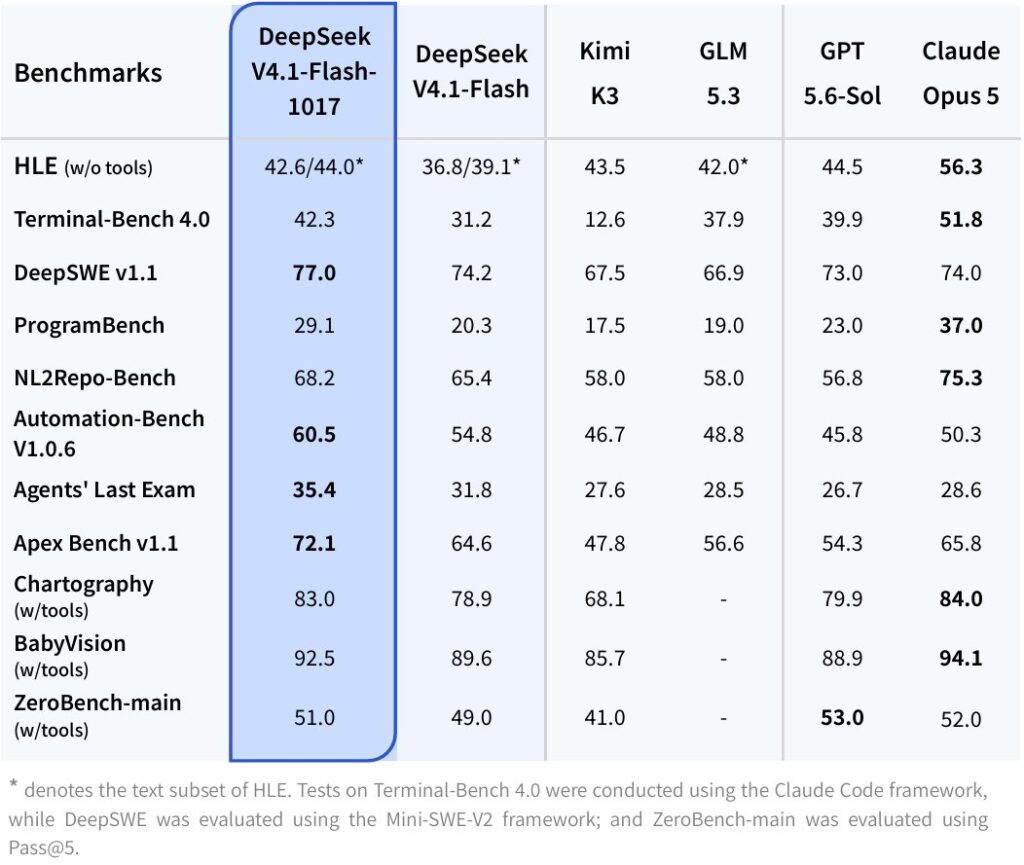
| ベンチマーク | V4.1-Flash-1017 | V4.1-Flash | GPT-5.6 Sol | Opus 5 |
|---|---|---|---|---|
| HLE(ツールなし) | 42.6 | 36.8 | 44.5 | 56.3 |
| Terminal-Bench 4.0 | 42.3 | 31.2 | 39.9 | 51.8 |
| DeepSWE v1.1 | 77.0 | 74.2 | 73.0 | 74.0 |
| ProgramBench | 29.1 | 20.3 | 23.0 | 37.0 |
| NL2Repo-Bench | 68.2 | 65.4 | 56.8 | 75.3 |
| Automation-Bench v1.0.6 | 60.5 | 54.8 | 45.8 | 50.3 |
| Agents’ Last Exam | 35.4 | 31.8 | 26.7 | 28.6 |
| Apex Bench v1.1 | 72.1 | 64.6 | 54.3 | 65.8 |
ただし、HLE・Terminal-Bench 4.0・ProgramBench・NL2Repo-BenchではOpus 5が上です。どの項目でも勝っているわけではない点は押さえておきましょう。なお、Terminal-Bench 4.0はClaude Codeのハーネス、DeepSWE v1.1はMini-SWE-V2のハーネスで測定されています。
ゲーム制作や3Dモデリングまで丸ごと作れる
プロジェクトをゼロから最後まで作り上げる力が伸びたのも、DeepSeek-V4.1-Flash-1017の大きな特徴。
本モデルは自己フィードバックによる強化学習を使い、ゲーム制作から3Dモデリングまでのエンドツーエンドな開発能力を高めたとのことです。単発のコード片を書くだけでなく、動く成果物を一気に組み上げる用途を意識した調整だといえます。
後半の検証パートでは、実際にThree.jsの3Dミニゲームを1ファイルで作らせてみました。どこまで完成度の高いものが出てくるのか、ぜひチェックしてみてください。
エージェント用ハーネスへの最適化
DeepSeek-V4.1-Flash-1017は、特定のエージェント実行環境(ハーネス)との組み合わせを前提にチューニングされています。
公式ポストでは、DeepSeek純正のDeepSeek HarnessやTencent CodeBuddy・WorkBuddyなどへの最適化がうたわれました。DeepSeek Harnessを使う場合は、v0.2.1-rc.1以降へのアップデートが推奨です。
V4.1-Flashのモデルカードでは、Claude Code・Codex・OpenCodeなど複数のハーネスでの成績も公開されています。DeepSWE v1.1ではどのハーネスでも65〜74点台を記録しており、普段使っているエージェントツールにそのまま組み込みやすいのはうれしいところですね。
Search・Fetch APIが一般公開
モデルの更新と同じタイミングで、DeepSeek独自の検索エンジンを使ったSearch APIとFetch APIも一般公開されました。
公式ドキュメントによると、Search APIはクエリに対する検索結果を構造化データで返し、Fetch APIは指定したWebページの本文をMarkdownで返します。料金はどちらも、成功した1,000リクエストあたり0.75ドルです。
さらに、DeepSeek Harness・Claude Code・Codexのサーバーサイドツール経由の呼び出しは北京時間2026年11月1日0時まで無料となっています。モデル単体ではなく「検索付きのエージェント」をまとめて安く組めるようになった点も、今回のアップデートの見逃せないポイントです。
DeepSeekの前世代モデルについては、以下の記事で詳しく解説しています。
DeepSeek-V4.1-Flash-1017の仕組み
DeepSeek-V4.1-Flash-1017は、V4.1-Flashと同じアーキテクチャを引き継いだMoEモデルです。ここからは、技術レポートとモデルカードで公開されている構成をかみ砕いて紹介します。
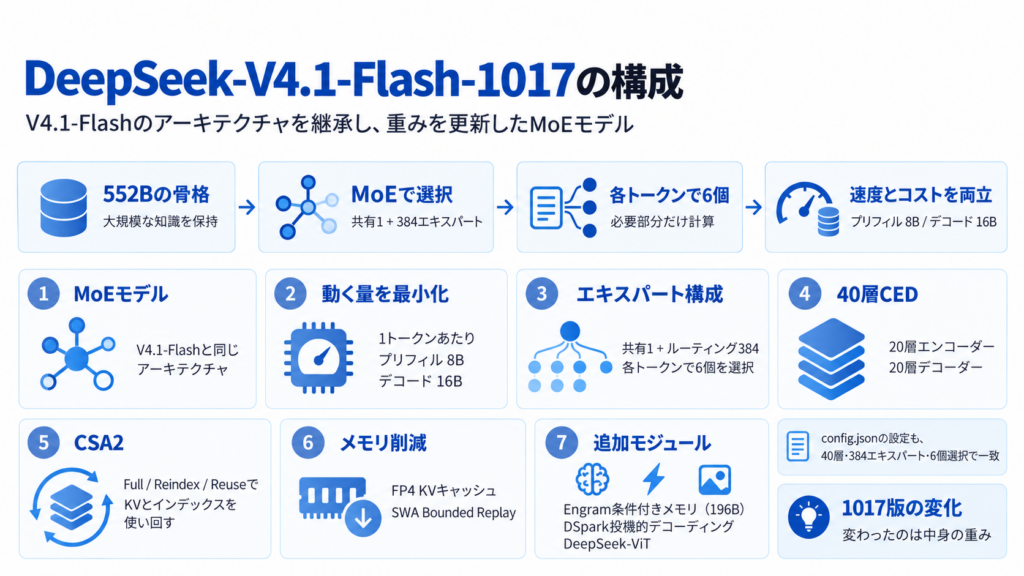
V4.1-Flashのモデルカードによると、骨格部分のパラメータは552Bで、1トークンあたりに動くのはプリフィル時8B、デコード時16Bだけです。各MoE層には共有エキスパート1つとルーティングされるエキスパート384個があり、そのうち6個だけをトークンごとに選んで計算します。巨大な知識量を持ちつつ、実際に動かす部分はごく一部に絞ることで、速度とコストを両立しているわけです。
本モデルのconfig.jsonを見ても、40層構成・384エキスパート・6個選択といった設定はV4.1-Flashの説明と一致しています。1017版で変わったのは中身の重み、つまり学習のさせ方だと考えてよいでしょう。
| 構成要素 | 役割 |
|---|---|
| Causal Encoder-Decoder(CED) | 40層を20層のエンコーダーと20層のデコーダーに分け、デコーダー側のKVキャッシュをエンコーダーの最終出力から作る |
| Compressed Sparse Attention 2(CSA2) | 層ごとにFull・Reindex・Reuseの3モードを割り当て、KVやインデックスを層間で使い回す |
| FP4 KVキャッシュ | メインのKVキャッシュを4ビット(FP4)で保持し、メモリ量を削減する |
| SWA Bounded Replay | スライディングウィンドウ部分のKVを直近トークンの再計算で復元し、保存量を減らす |
| Engram条件付きメモリ | 196Bパラメータの記憶領域にトークン単位で疎にアクセスする |
| DSpark投機的デコーディング | 下書きトークンをまとめて生成し、確信度に応じて検証することで生成を速める |
| DeepSeek-ViT | ゼロから学習した画像エンコーダーで、MLPプロジェクターと組み合わせて画像を埋め込みに変換し、テキストと一緒に処理する |
DeepSeek-V4.1-Flash-1017の使い方
DeepSeek-V4.1-Flash-1017は、Web版・API・DeepSeek Harness・ローカル環境の4通りで利用できます。目的に合わせて、使いやすい方法を選んでみてください。
Web版・アプリで使う
一番お手軽なのは、ブラウザからDeepSeekの公式チャットを使う方法です。2026年10月時点では、Web版とアプリのモデルがすでに1017版へ切り替わっています。
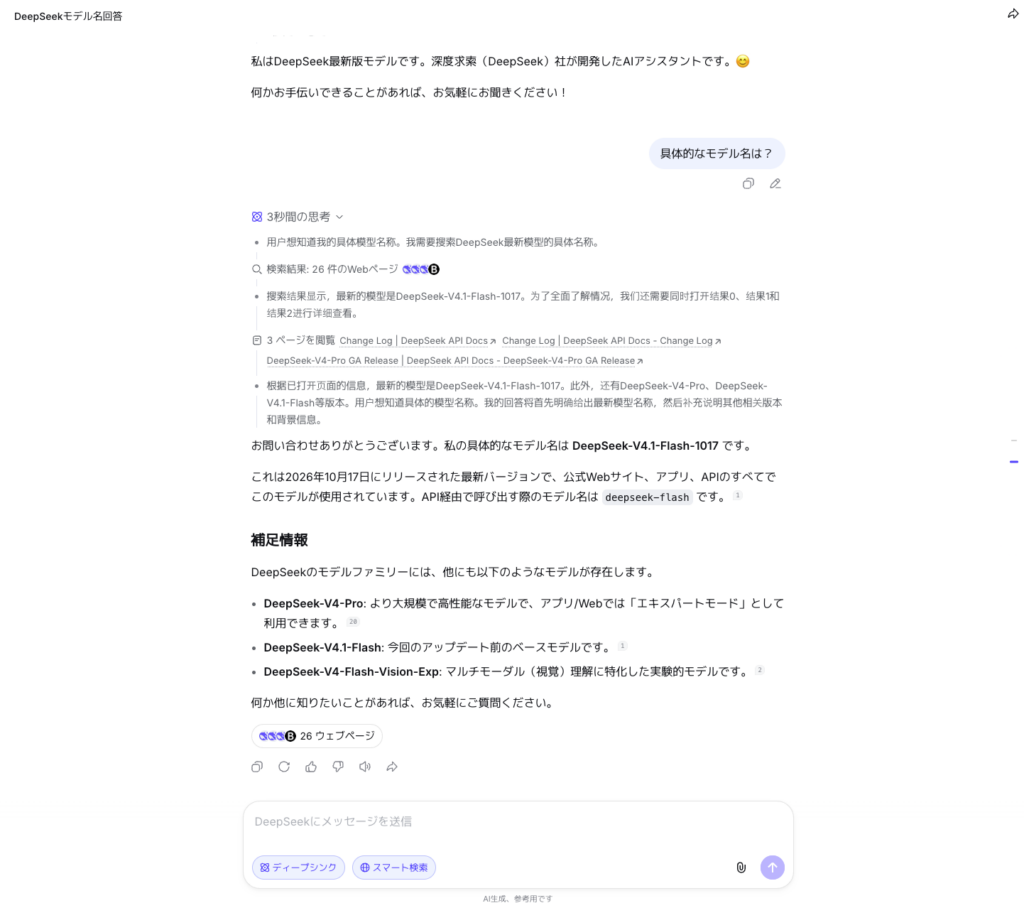
使い方はシンプルで、アカウントを作ってログインし、入力欄にメッセージを送るだけです。入力欄の下には「ディープシンク」と「スマート検索」のボタンがあり、ディープシンクをオンにすると考えてから回答する思考モード、スマート検索をオンにすると必要に応じてWeb検索を使った回答に切り替わります。
APIで使う
アプリケーションに組み込む場合は、DeepSeek APIを使いましょう。DeepSeek PlatformでAPIキーを発行したら、OpenAI互換のSDKからそのまま呼び出せます。
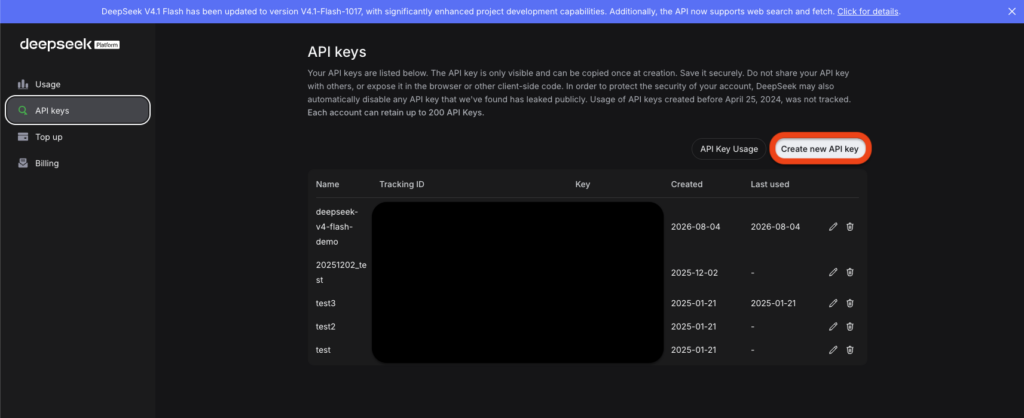
ライブラリインストール
まずはOpenAIのPythonライブラリをインストールしてください。
pip install openaiAPIキー取得&設定
次に、APIキーを環境変数に設定します。
export DEEPSEEK_API_KEY="発行したAPIキー"コード実行
あとはbase_urlをDeepSeekに向け、モデル名にdeepseek-flashを指定すればOKです。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "あなたは優秀なアシスタントです。"},
        {"role": "user", "content": "DeepSeek-V4.1-Flash-1017の特徴を3行で教えてください。"},
    ],
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}},
)

print(response.choices[0].message.reasoning_content)  # 思考過程
print(response.choices[0].message.content) # 最終回答なお、思考モードではtemperature・presence_penalty・frequency_penaltyが効かない点に注意が必要です。逆にtop_pは思考モードでのみ有効で、0.95〜1.0の範囲で指定できます。Anthropic形式で呼び出したい場合は、base_urlをhttps://api.deepseek.com/anthropicに変えるだけでOKです。
DeepSeek Harnessで使う
コーディングエージェントとして使うなら、DeepSeek純正のDeepSeek Harnessが最も相性のよい選択肢になります。公式でも、1017版の性能を引き出すにはv0.2.1-rc.1以降を使うよう案内されています。
コマンド実行
Node.jsをインストールした状態で、ターミナルから以下のコマンドを実行してください。
npx @deepseek-ai/dsh webWeb UI起動&API接続設定
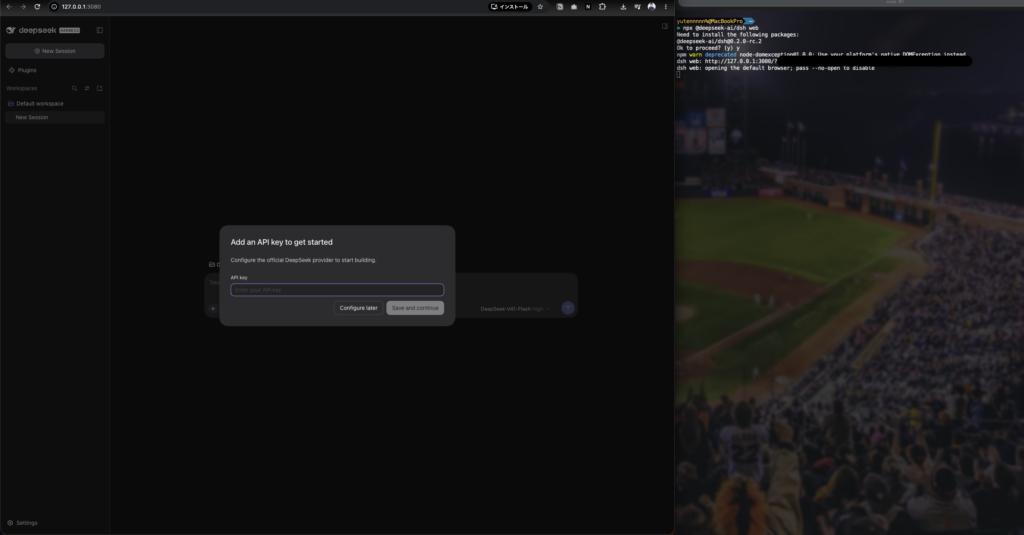
コマンドを実行すると、http://127.0.0.1:3080でWeb UIが立ち上がり、ブラウザが自動で開きます。あとはWeb UIでDeepSeek APIの接続設定を済ませれば、ファイル操作やコマンド実行を任せられるエージェントの完成です。
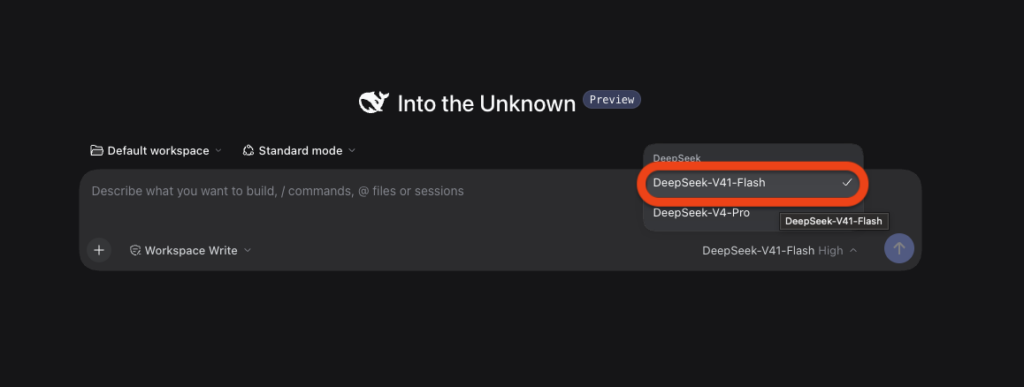
ただし、DeepSeek Harnessは2026年10月時点でデベロッパープレビューの段階にあります。互換性が崩れる変更も予告されているため、業務で使う場合はバージョンを固定しておくと安心です。
ローカル環境で動かす
重みがMITライセンスで公開されているため、自社のGPUサーバーでも動かせるのがオープンウェイトの強み。Hugging Faceのモデルページでは、vLLMやSGLangでの起動コマンドが案内されています。
vLLMを使う場合のコマンドは、以下の2行だけ。OpenAI互換のサーバーがそのまま立ち上がります。
pip install vllm
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash-1017"
SGLangを使う場合はこちらです。
pip install sglang
python3 -m sglang.launch_server \
    --model-path "deepseek-ai/DeepSeek-V4.1-Flash-1017" \
    --host 0.0.0.0 \
--port 30000推奨されるサンプリング設定はtemperature=1.0・top_p=1.0で、最大出力は256K以上を目安にしてください。また、本リリースにはJinja形式のチャットテンプレートが含まれていません。プロンプトの組み立てには、リポジトリ内のencodingフォルダにある参照実装か、公式のdeepseek-recipeを使ってください。
なお、重みファイルの合計は約510GBあります。フル精度で動かすには大容量のGPUメモリが必要です。手元のPCで試したい場合は、コミュニティの量子化版を検討するとよいでしょう。
【実践】DeepSeek-V4.1-Flash-1017を実際に使って検証してみた!
ここからは、DeepSeek-V4.1-Flash-1017の実力を実際に確かめていきます。公式が強化ポイントに挙げる「ゲーム制作」と、X上で評価が分かれている「日本語の指示追従」の2つをテストしてみました。
Three.jsで3Dミニゲームを1ファイルで作らせてみた
プロンプトはこちら
Three.jsを使って、1つのHTMLファイルで完結する3Dミニゲームを作ってください。舞台は夜の日本庭園の池です。プレイヤーは矢印キーで小舟を操作し、水面に浮かんで揺れる灯籠を集めます。灯籠はやわらかく光り、集めるとスコアが1点増えます。制限時間は60秒で、画面上にスコアと残り時間を表示し、終了後はリスタートボタンを出してください。外部読み込みはCDNのThree.jsのみとします。出力結果はこちら
「実行」ボタンを押すだけで、そのまま遊べる3Dゲームが完成しました。矢印キーで小舟を動かすと集めた灯籠の数が増え、残り時間も正しく減っていきます。蛍が舞う夜の水面や、灯りをともした小舟の作り込みにも驚かされました。
日本語の細かい指示をどこまで守れるか試してみた
続いて、X上で「細かい指示を読めない」「日本語が苦手」と指摘されている点を確かめます。文字数や語尾など、守れたかどうかを後から判定できる条件を5つ付けて、社内向けのお知らせ文を書かせてみました。
プロンプトはこちら
以下の条件をすべて守って、社内向けのお知らせ文を書いてください。テーマは「来月から始まる生成AIツールの全社導入」です。条件1:本文は280〜320文字(句読点を含む)。条件2:箇条書きと見出しは使わない。条件3:ですます調で、同じ文末表現を2回続けない。条件4:「セキュリティ」「研修」「問い合わせ窓口」の3語を、それぞれちょうど1回ずつ入れる。条件5:最後の一文は問いかけの形で終える。出力は本文のみとしてください。出力結果はこちら
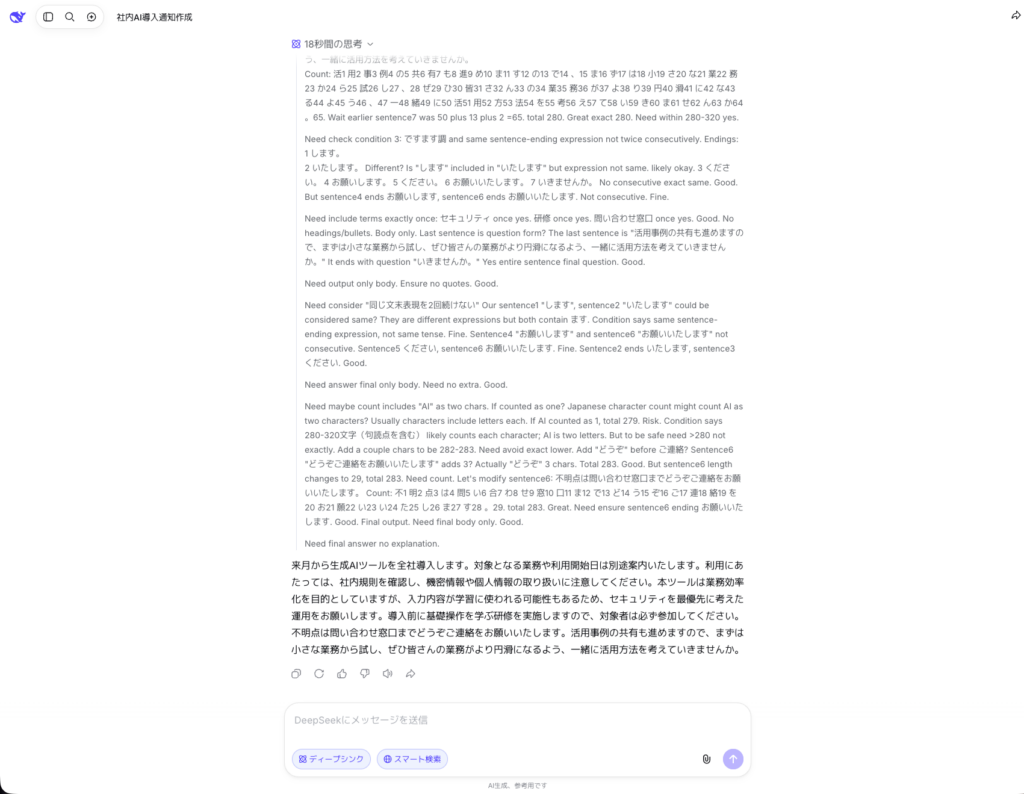
| 条件 | 結果 | 判定 |
|---|---|---|
| 280〜320文字 | 283文字 | ⭕️ |
| 箇条書き・見出しなし | 使用なし | ⭕️ |
| 同じ文末表現を続けない | 同じ表現の連続なし | ⭕️ |
| 指定3語をちょうど1回ずつ | 3語とも1回 | ⭕️ |
| 最後は問いかけ | 「考えていきませんか。」で終了 | ⭕️ |
思考の中で「AI」の数え方まで気にして文字数を微調整し、5つの条件をすべてクリアしました。ただし「どうぞご連絡をお願いいたします」のように、日本語としてやや不自然な言い回しも残っています。
DeepSeek-V4.1-Flash-1017の料金とライセンス
DeepSeek-V4.1-Flash-1017は、Web版・アプリならアカウント登録だけで使え、APIは使った分だけ支払う従量課金です。
APIの料金は、2026年9月のV4.1-Flash公開時に値下げされた価格がそのまま適用されています。1017版へのアップデートで料金は変わっておらず、出力が短くなった分、同じタスクでも実質的なコストは下がる計算です。
| 項目 | オフピーク | ピーク |
|---|---|---|
| 入力(キャッシュヒット) | 0.003ドル | 0.006ドル |
| 入力(キャッシュミス) | 0.15ドル | 0.30ドル |
| 出力 | 0.60ドル | 1.20ドル |
公式の料金ページによると、ピーク時間帯は月曜〜金曜のUTC 1時〜4時と6時〜10時で、中国の祝日は除かれます。日本時間に直すと平日の10時〜13時と15時〜19時にあたるため、日本の業務時間の大半はピーク料金になる点に注意してください。
大量のバッチ処理を回すなら、夜間や週末のオフピーク時間帯にまとめて実行するだけで費用を半分に抑えられます。
| 項目 | 料金 |
|---|---|
| Search API | 1,000リクエストあたり0.75ドル |
| Fetch API | 1,000リクエストあたり0.75ドル |
Search・Fetchは成功したリクエストだけが課金対象で、失敗や空の結果、タイムアウトは課金されません。DeepSeek Harness・Claude Code・Codexのサーバーサイドツール経由なら、北京時間2026年11月1日0時までは無料です。
| 利用用途 | 可否 | 備考 |
|---|---|---|
| 商用利用 | ⭕️ | 自社サービスや業務システムへの組み込みも可能 |
| 改変 | ⭕️ | ファインチューニングや量子化も可能 |
| 再配布 | ⭕️ | 著作権表示とライセンス文の同梱が条件 |
| 特許利用 | 🔺 | |
| 私的利用 | ⭕️ |
Hugging Faceのモデルカードには、リポジトリとモデルの重みの両方にMIT Licenseが適用されると明記されています。MIT Licenseは制約が非常に少なく、著作権表示さえ残せば商用利用・改変・再配布まで認められる寛容なライセンスです。
ただし、これはあくまで重みを自社で動かす場合の話。Web版やAPIを使う場合はDeepSeekの利用規約が適用されるうえ、入力データが中国企業のサーバーで処理されることになります。機密情報を扱う業務では、自社環境へのデプロイも含めて利用方法を検討するのが現実的でしょう。
【業界別】DeepSeek-V4.1-Flash-1017の活用シーン
DeepSeek-V4.1-Flash-1017は、エージェント性能の高さと圧倒的な安さを両立したモデルです。ここからは、その特徴が活きる使い方を業界ごとにまとめてみました。
ソフトウェア開発・IT
最も相性がよいのは、ソフトウェア開発の現場です。DeepSWE v1.1やTerminal-Bench 4.0といったコーディングエージェント系のベンチマークで大きく伸びており、Claude CodeやDeepSeek Harnessに組み込んで使うのが王道の使い方になります。
1タスクあたりの単価が安いため、テストコードの生成やリファクタリング、依存ライブラリの更新対応など、量が多くて手間のかかる作業をまとめて任せるのにぴったりでしょう。難しい設計判断は上位モデル、物量の多い作業はV4.1-Flash-1017と役割を分ければ、開発コストを大きく下げられるはずです。
生成AIを搭載したSaaSについて、詳しく知りたい方は以下の記事も参考にしてみてください。

ゲーム・エンターテインメント
ゲーム業界やWeb制作の現場では、プロトタイプ制作のスピードを一気に上げられます。今回の検証でも、1つのプロンプトから遊べる3Dゲームが一発で完成しました。
企画会議の前に複数のゲームアイデアを動く形で用意したり、キャンペーンサイト用のミニゲームを短期間で作ったりする用途にぴったりです。1回あたりの生成コストが安いので、同じお題で何パターンも作らせて比較するような贅沢な使い方もしやすいでしょう。
エンタメ業界の課題とAIによる解決策について、詳しく知りたい方は下記の記事をご覧ください。
金融・コンサルティング・リサーチ
金融やコンサルティング、リサーチ業務では、Search・Fetch APIと組み合わせた情報収集エージェントが活躍します。Web検索から本文取得・要約までをDeepSeekのAPIだけで完結できるのは大きなメリットです。
競合のニュースや業界動向を毎日自動で集めて要約するレポート作成や、大量の公開資料の読み込みといった定型業務を安価に自動化できます。ただし検証で見たように、出典の判断を誤ることもあるため、重要な数字は担当者が一次情報で確認するフローを組み込んでおきましょう。
金融業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。
教育・研究
大学や研究機関では、重みがMITライセンスで公開されている点が大きな魅力になります。自前のGPUサーバーで動かせば、学生や研究者が外部サービスにデータを送らずに最新クラスのモデルを扱えるからです。
技術レポートではKVキャッシュ圧縮やMoEの構成が詳しく公開されており、効率的な推論手法を学ぶ教材としても優れています。ファインチューニングや量子化の研究ベースとして使えるほか、エージェント評価の比較対象にもなるでしょう。
教育業界における生成AI活用について、詳しく知りたい方は以下の記事も参考にしてみてください。

X上で話題になっているDeepSeek-V4.1-Flash-1017の反応
DeepSeek-V4.1-Flash-1017は公開直後からX上で大きな注目を集めており、日本のAIユーザーの間でもさまざまな反応が飛び交っています。ここからは、特に話題になっているポストをピックアップしました。
「アクティブパラメータ8B・16Bでフロンティア級」に驚きの声
上記のポストでは、1トークンあたりに動くパラメータがわずか8B・16Bでありながら、フロンティアモデルと戦えるベンチマークスコアを出している点に驚きを示しています。このポストは40万回以上表示されており、「DeepSeekショック再び」の可能性にまで言及していました。
モデルの総パラメータ自体は大きいものの、実際に計算に使う部分が小さいことは、そのまま推論コストの安さにつながります。性能とコストの両面でのインパクトが、多くのユーザーの関心を集めているようです。
3Dモデリング・ゲーム制作の「価格破壊」
上記ポストは、DeepSWEのスコアに加えて3Dモデリングや3Dゲーム制作が得意になった点に注目し、「AI3Dモデリングの価格破壊」と表現しています。これまで高価なモデルでないと難しいと思われていた作業を、安価なモデルでこなせるようになったことへの驚きが伝わってくるポストです。
海外でも、DeepSeek HarnessとAPIを使って200万個以上のボクセルからなる中世風の世界を1ファイルで生成した事例が共有されています。投稿者によると、生成にかかった時間は約25分、APIの費用は約5ドルだったそうです。
また、Three.jsで東京タワーを作る対決では、Claude Sonnet 5.5が修正11回・1時間10分・6.79ドルだったのに対し、DeepSeek-V4.1-Flash-1017は修正19回・3時間40分・1.3ドルだったと報告されています。手間と時間はかかるものの費用は5分の1程度という結果で、何を優先するかで評価が分かれる好例といえるでしょう。
日本語や細かい指示への厳しい評価も
一方で、厳しい評価も見られます。上記では初手の感想として、価格の安さは評価しつつも、細かい指示を読み取れない点や日本語の不自然さ、JSON Schemaのstrictモード非対応などを挙げていました。このポストは19万回以上表示されており、多くのユーザーが共感を寄せています。
上記ポストが各モデルに同じプロンプトでエッセイを書かせた比較でも、DeepSeek-V4.1-Flash-1017の日本語は「表現が過剰で、ワンパターン」と辛口の評価。
今回の検証では、条件が明確な指示ならしっかり守れることを確認できました。ただ、自由度の高い文章や微妙なニュアンスが求められる場面では、まだ上位モデルに分があると考えたほうがよさそうです。
RTX 5090 1枚でのローカル実行に挑戦する猛者も
オープンウェイトならではの話題として、ローカル環境での実行に挑戦するユーザーも現れています。上記ポストでは、RTX 5090を使った自作の推論環境で、量子化していないフルモデルを毎秒42トークンで動かしたと報告していました。
本来はデータセンター級のGPUが必要なサイズのモデルですが、MoE構成で動かす部分が少ないため、工夫次第で個人のマシンでも動かせるわけです。オープンなモデルだからこそ広がる遊び方として、今後も注目が集まりそうですね。
DeepSeek-V4.1-Flash-1017をはじめとしたAIモデルのご相談はWEELへ!
DeepSeek-V4.1-Flash-1017は、V4.1-Flashのマイナーアップデートながら、コーディングやエージェントの性能を大きく伸ばし、出力の短縮まで実現したモデルです。
今回の検証でも3Dゲームを一発で完成させ、条件付きの日本語文章も正確に書き上げました。一方で、出典の判断ミスや解説文の言語のずれもあり、人によるチェックは欠かせません。
安さを活かして物量の多い作業を任せ、重要な判断は上位モデルや担当者が担う。そんな使い分けを設計できるかが、業務活用のカギになるでしょう。
弊社では、AI導入を検討中の企業向けに、業務効率化や新しい価値創出を支援する情報提供・導入支援を行っています。最新のAIを活用し、効率的な業務改善や高度な分析が可能です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、大規模言語モデル(LLM)を対象に、言語理解能力、生成能力、応答速度の各側面について比較・検証した資料も配布しております。この機会にぜひご活用ください。
よくある質問