LoRAの仕組み・使い方を解説!Stable Diffusionへの導入方法や活用事例も紹介
- LoRAは既存のAIモデルに追加学習を行い、特定の画風やキャラクター、商品デザインなどに合わせてカスタマイズする技術
- 元のモデルを固定して追加パラメータを学習するため、LoRAはフルファインチューニングと比べて学習するパラメータ数や計算量を抑えやすい
- LoRAはキャラクター制作やアニメ、マーケティング画像生成など幅広く活用されており、利用時はライセンスや著作権などの確認が重要
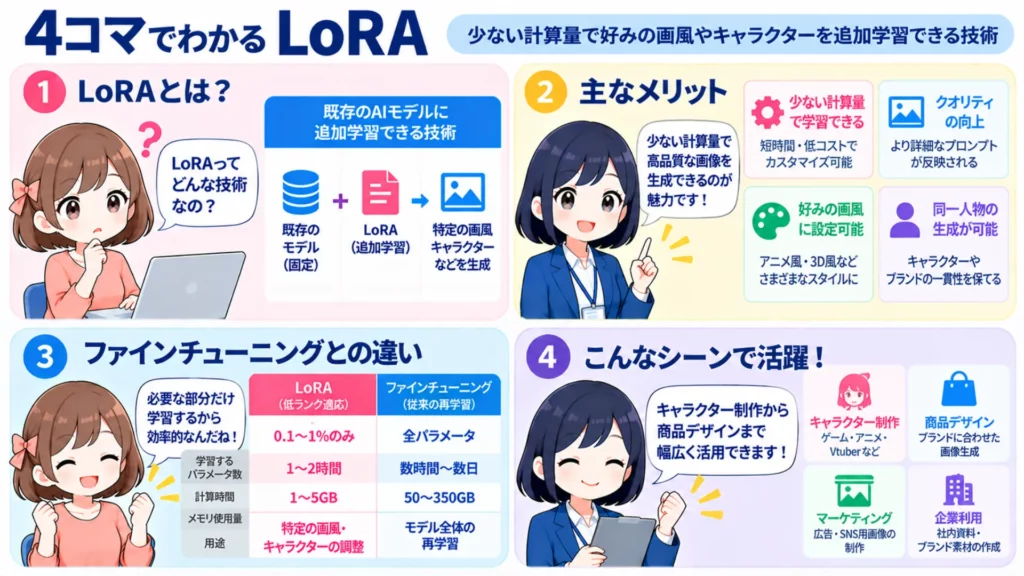
LoRAとは、既存のAIモデルに少量の追加学習を行い、特定の画風やキャラクターなどを覚えさせる技術です。モデル全体を学習し直さずに、用途に合わせたカスタマイズができます。
「ファインチューニングとは何が違うの?」「どうやって使うの?」と疑問に思う方もいるでしょう。
本記事では、LoRAの仕組み・メリット・ファインチューニングとの違い、Stable Diffusionへの導入方法や作成手順、活用事例を解説します。ぜひ参考にしてください。
\生成AIを活用して業務プロセスを自動化/
LoRAとは
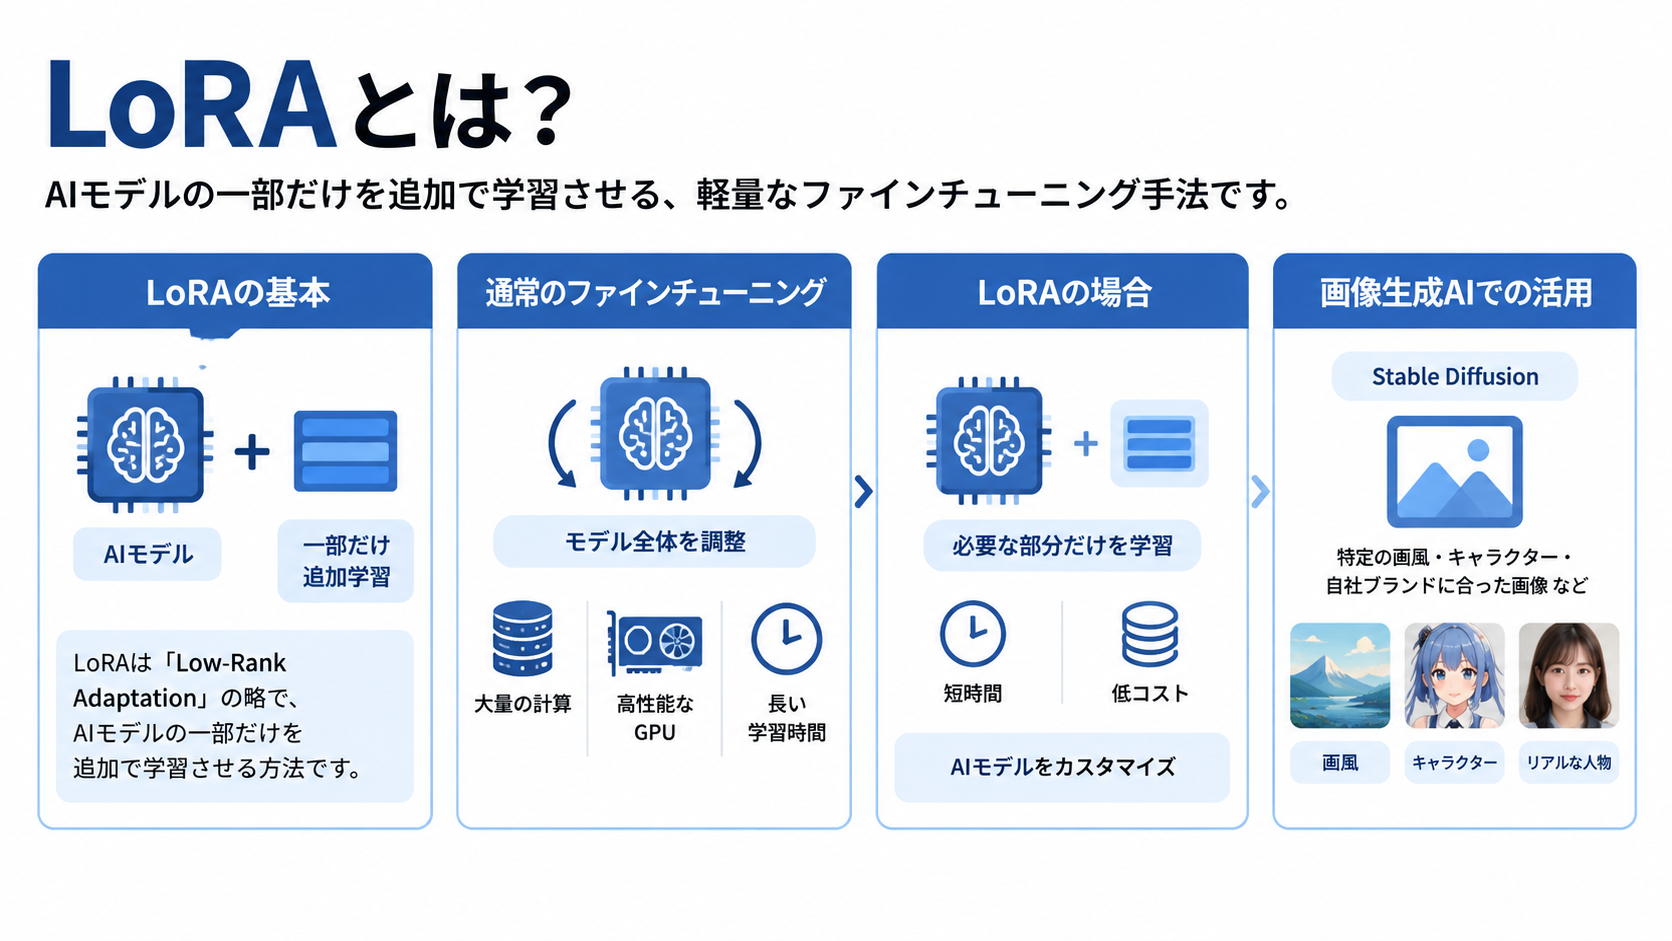
LoRA(ローラ)とは、「Low-Rank Adaptation」の略で、既存のAIモデルの重みを固定したまま、少量の追加パラメータを学習させる手法です。2021年にMicrosoftの研究者らが発表した論文で提案されました。※1
通常のフルファインチューニングでは、モデル全体のパラメータを更新するため、多くの計算資源が必要です。一方、LoRAは学習するパラメータを減らせるため、計算コストやGPUメモリの使用量を抑えながらモデルをカスタマイズできます。
特にStable Diffusionなどの画像生成AIでは、特定の画風やキャラクター、商品デザインなどを再現する用途で活用されています。
ファインチューニングについて詳しく知りたい方は、下記の記事を合わせてご確認ください。

LoRAの仕組み
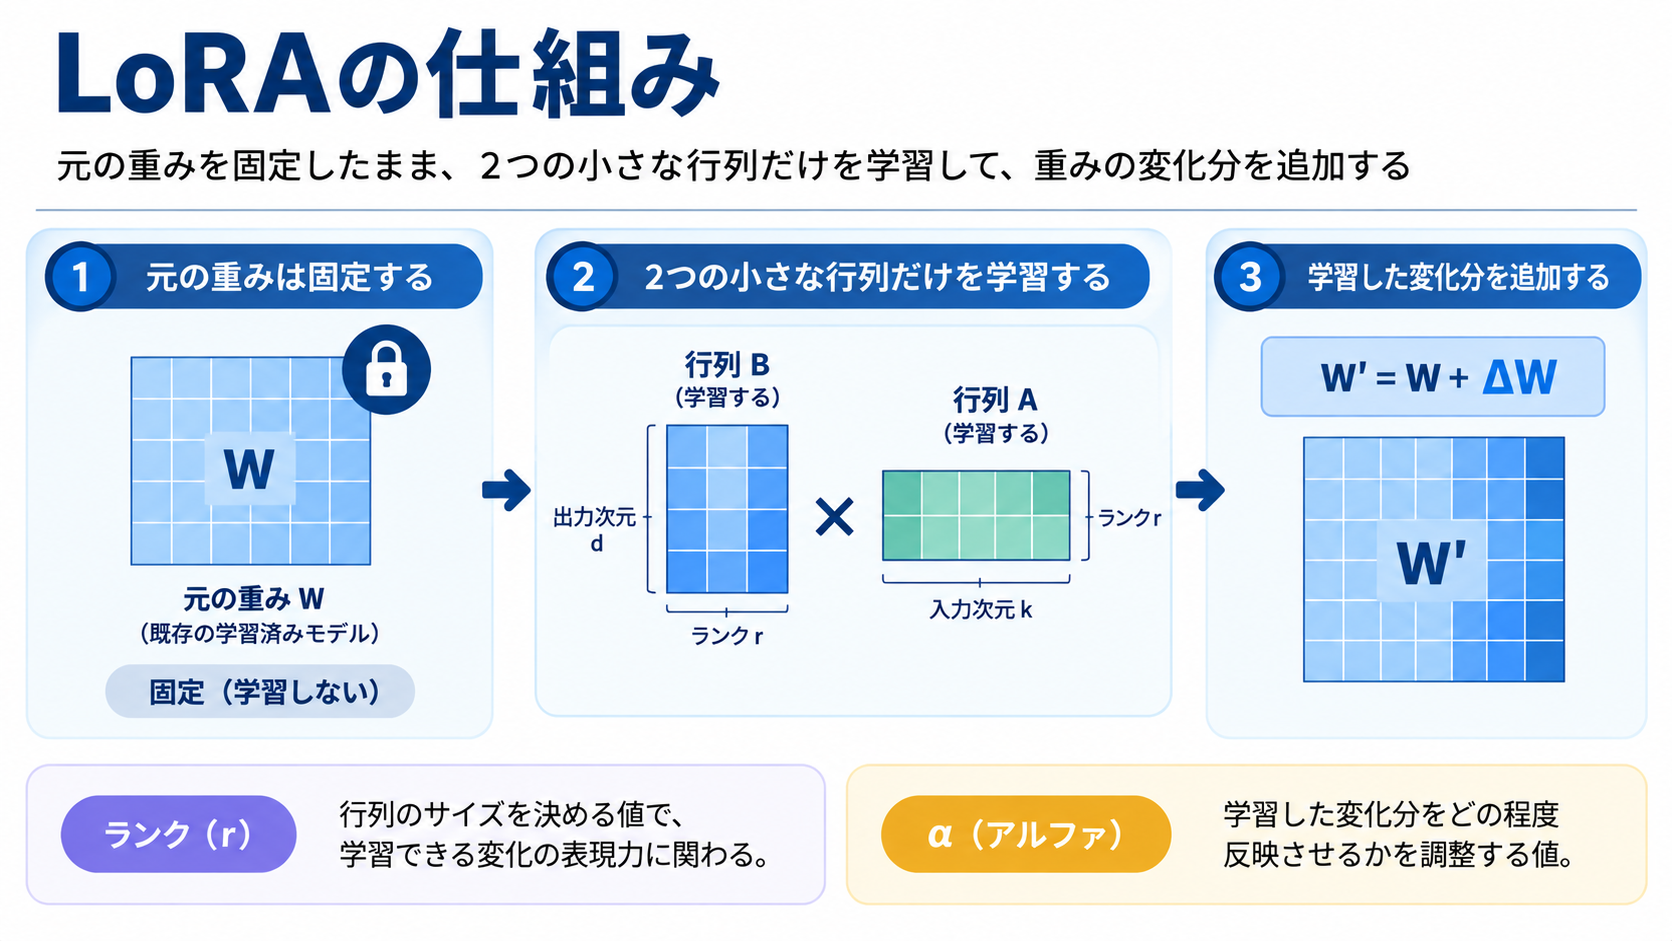
LoRAは、既存のAIモデルの重み(パラメータ)を固定したまま、追加した少量のパラメータだけを学習する仕組みです。
AIモデルは、学習によって調整された重みを使って情報を処理しています。通常のフルファインチューニングでは、モデル全体の重みを更新するため、多くの計算資源が必要です。
一方、LoRAでは、重みの変化分を2つの小さな行列(A・B)の掛け算で表し、その行列だけを学習します。この仕組みにより、元のモデルを変更せずに、特定の画風や人物、商品デザインなどの特徴を追加できます。
学習時には、ランク(r)とα(アルファ)というパラメータを設定するのが一般的です。ランク(r)は学習できる変化の表現力に関わる値で、αは学習した変化をどの程度反映させるかを調整する値です。
LoRAは学習するパラメータが少ないため、フルファインチューニングと比べて計算負荷を抑えられます。ただし、学習時間はGPUの性能や画像枚数、ベースモデルなどによって異なります。
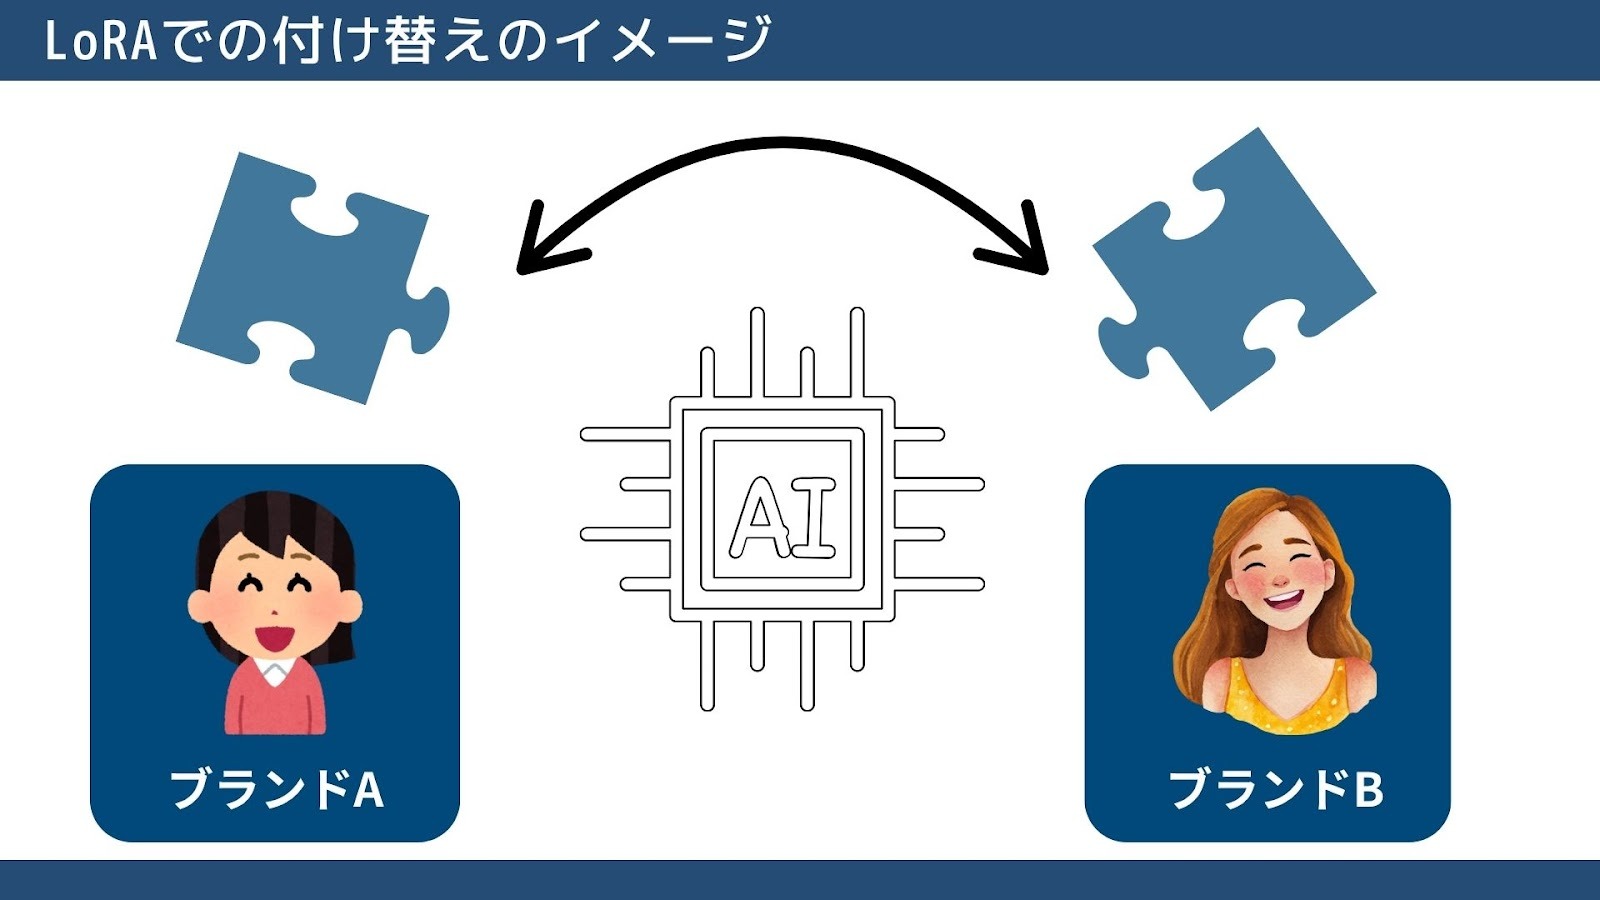
また、LoRAはベースモデルとは別に保存できるため、用途に応じた切り替えや組み合わせも可能です。例えば、ブランドごとに作成したLoRAを切り替えれば、同じベースモデルから異なるテイストの画像を生成できます。
LLMのカスタマイズにも活用可能
LoRAは、Stable Diffusionなどの画像生成AIだけでなく、LLM(大規模言語モデル)のカスタマイズにも活用できる技術です。
通常のフルファインチューニングでは、モデル全体の重みを更新するため、多くの計算資源が必要です。一方、LoRAは追加した少量のパラメータだけを学習するため、GPUメモリの使用量や計算負荷を抑えられます。
例えば、社内文書の書き方や業界特有の専門用語を学習させることで、企業の用途に合わせた文章を生成しやすくなります。また、Hugging Faceが提供するPEFTライブラリを利用すれば、LoRAを既存のLLMに適用することも可能です。
LoRAを導入するメリット
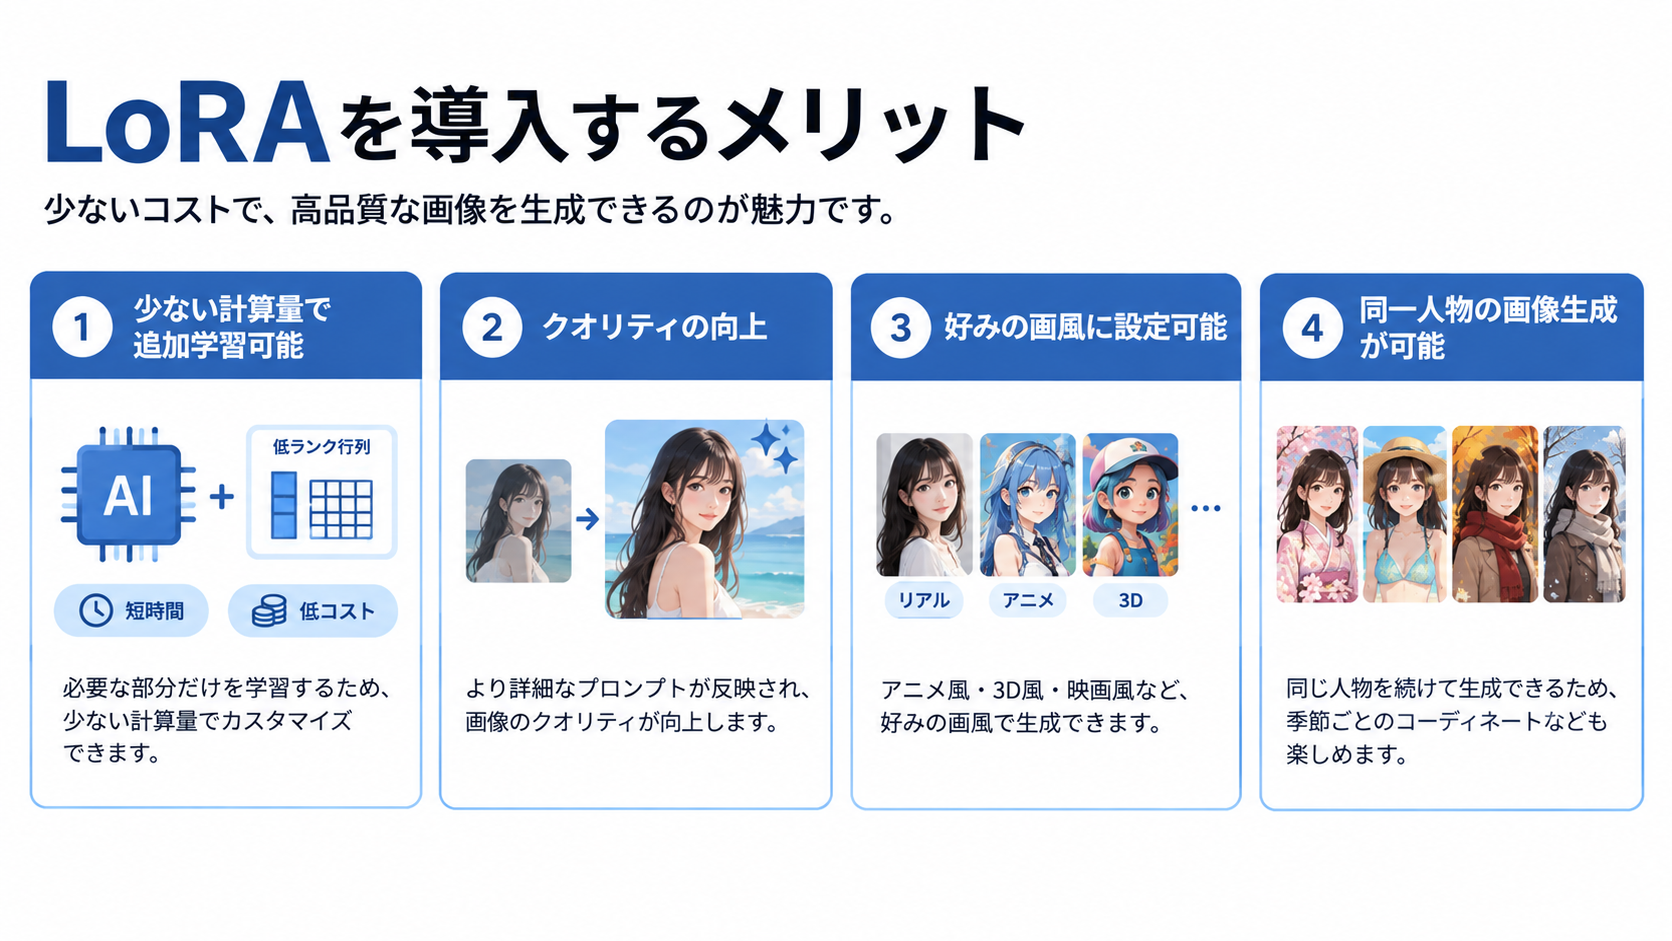
LoRAを導入するメリットは、以下の4つです。
- 少ない計算量で追加学習可能
- 特定の対象の再現度を高められる
- 好みの画風に設定可能
- 同一人物の画像生成が可能
LoRAは、モデル全体を学習し直さずに、特定の人物や画風などを追加学習できる点が特徴です。計算資源を抑えながら、目的に合った画像生成モデルへ調整できます。
少ない計算量で追加学習可能
LoRAは、少ない計算量でAIモデルを追加学習できる技術です。元のモデルの重みを固定し、追加した低ランク行列だけを学習するため、フルファインチューニングよりも学習対象のパラメータを削減できます。
LoRAの原論文では、GPT-3 175Bを用いた実験で、学習対象のパラメータ数を最大10,000分の1に削減し、GPUメモリの使用量を約3分の1に抑えたと報告されています。※1
また、LoRAの追加学習データを保存したファイルは、ベースモデル全体を保存する場合よりも小容量になりやすい点もメリットです。画像生成用のLoRAファイルには数MB〜数百MB程度のものもあり、数GB規模のベースモデルと比べて保存や共有がしやすくなります。
特定の対象の再現度を高められる
LoRAを活用すると、特定の人物・商品・画風などの特徴を追加学習し、生成画像で再現しやすくなります。ベースモデルだけでは表現が難しい対象も、適切な学習データを用意することで再現度の向上が期待できます。
好みの画風に設定可能
LoRAを使用すれば、アニメ風・3D風・映画風など、特定の画風を学習させて画像生成に反映できます。作品やブランドに合わせて、画像の表現を統一しやすくなる点がメリットです。
また、画像生成環境によっては、複数のLoRAを組み合わせて利用することも可能です。LoRAの適用の強さ(ウェイト)を調整すれば、学習した特徴をどの程度反映させるか変更できます。
同一人物の画像生成が可能
LoRAを活用すると、同じ人物やキャラクターの特徴を維持した画像を生成しやすくなります。プロンプトだけでは同じ人物を安定して再現することが難しい場合でも、追加学習によって一貫性の向上が期待できます。
例えば、企業のオリジナルキャラクターを学習させれば、服装や背景を変えたSNS投稿用の画像制作に役立つでしょう。
LoRAとファインチューニングの違い
LoRAとファインチューニングの主な違いは、モデル全体の重みを更新するか、追加した少量のパラメータだけを学習するかにあります。
厳密には、LoRAもファインチューニングの一種です。一般的なフルファインチューニングではモデル全体の重みを更新しますが、LoRAは元の重みを固定したまま追加学習を行います。
それぞれの特徴を比較すると、以下のとおりです。
| 比較項目 | LoRA | フルファインチューニング |
|---|---|---|
| 学習対象 | 追加した低ランク行列 | モデル全体の重み |
| 必要なGPU | 比較的少ないGPUメモリで実行可能 | 大容量のGPUメモリが必要になりやすい |
| 学習時間 | 比較的短くなる傾向がある | 長くなる傾向がある |
| ファイルサイズ | 追加学習した部分のみを保存でき、小容量になりやすい | 更新したモデル全体を保存するため、大容量になりやすい |
| 切り替えやすさ | 同じベースモデルに対応するLoRAを切り替えやすい | 用途ごとにモデル全体を管理する必要がある |
※GPUメモリの使用量や学習時間は、モデルの規模・学習データ・GPUの性能・学習設定などによって異なります。
LoRAは学習対象のパラメータが少ないため、計算資源やモデルの保存容量を抑えながら、用途に応じたカスタマイズを行える点がメリットです。
LoRAとCheckpointとの違い
Checkpointは画像生成モデル本体を保存したファイルで、LoRAは既存のモデルに特定の特徴を追加するための差分ファイルです。
Checkpointは数GB程度の容量になることが多い一方、LoRAは数MB〜数百MB程度と比較的小容量です。ただし、ファイルサイズはモデルの種類や学習設定によって異なります。
両者の主な違いは、以下のとおりです。
| 比較項目 | LoRA | Checkpoint |
|---|---|---|
| 役割 | ベースモデルに特定の特徴を追加する | 画像生成モデル本体として機能する |
| ファイルサイズ | 数MB〜数百MB程度 | 数GB程度 |
| 用途 | 人物・キャラクター・画風などの調整 | 画像生成の基本的な能力や特徴を提供する |
| 柔軟性 | 対応するモデルで複数のLoRAを組み合わせられる | ベースモデルとして切り替えて利用できる |
| 利用条件 | 対応するベースモデルが必要 | 対応する画像生成環境で利用する |
Checkpointをベースモデルとして読み込み、対応するLoRAを追加すれば、元のモデルの特徴を活かしながら、特定の人物や画風などを反映した画像を生成できます。
LoRAを入手する方法
LoRAモデルを配布しているサイトは、おもに2つ存在します。どちらも特徴が違うので、目的に合わせて使い分けると便利です。
Hugging Face
Hugging Faceは、AIモデルやデータセットを公開・共有できるプラットフォームです。画像生成AI向けのLoRAも公開されており、モデルの説明ページから対応するベースモデルや利用条件を確認できます。
無料で利用できる基本プランのほか、月額9ドルのProプランも提供されています。Proプランでは、毎月2ドル分のコンピューティングクレジットが付与され、対象サービスの利用料金に充当可能です。クレジットを使い切った後も、追加購入などによって従量課金でサービスを利用可能です。※2
Civitai
Civitaiは、画像生成AI向けのモデルやLoRAなどを公開・共有できるプラットフォームです。2022年に公開され、現在はさまざまな画像生成用モデルが集まっています。※3
生成画像のサンプルを確認しながらLoRAを探せるため、目的に合った画風やキャラクターのモデルを見つけやすい点が特徴です。モデルの説明ページでは、対応するベースモデルや利用条件なども確認できます。
公開されているLoRAの多くは無料でダウンロードできますが、すべての機能が無料というわけではありません。有料メンバーシップのほか、サイト内通貨「Buzz」を利用する画像生成やLoRA学習などの機能も提供されています。
LoRAの作成方法
ここからは、自分でLoRAを作成する方法を紹介します。
LoRAを自作する手順は、以下のとおりです。
- SDXL対応のXL Lora Trainerにアクセス
- ベースモデルと学習パラメータを設定
- 学習させる画像をアップロード
- LoRAを作成して保存する
以下でそれぞれの手順をみていきましょう。
SDXL対応のXL Lora Trainerにアクセス
LoRAを自作する方法の一つに、Google Colab上で「XL Lora Trainer」を利用する方法があります。XL Lora Trainerは、Stable Diffusion XL(SDXL)向けのLoRAを学習するためのノートブックです。
今回は、ベースモデルに「Stable Diffusion XL 1.0 base」を使用する手順を紹介します。まずは、以下のリンクからXL Lora Trainerを開きましょう。
ベースモデルと学習パラメータを設定
XL Lora Trainerを開いたら、「Setup」で学習に使用するモデルや保存先を設定します。
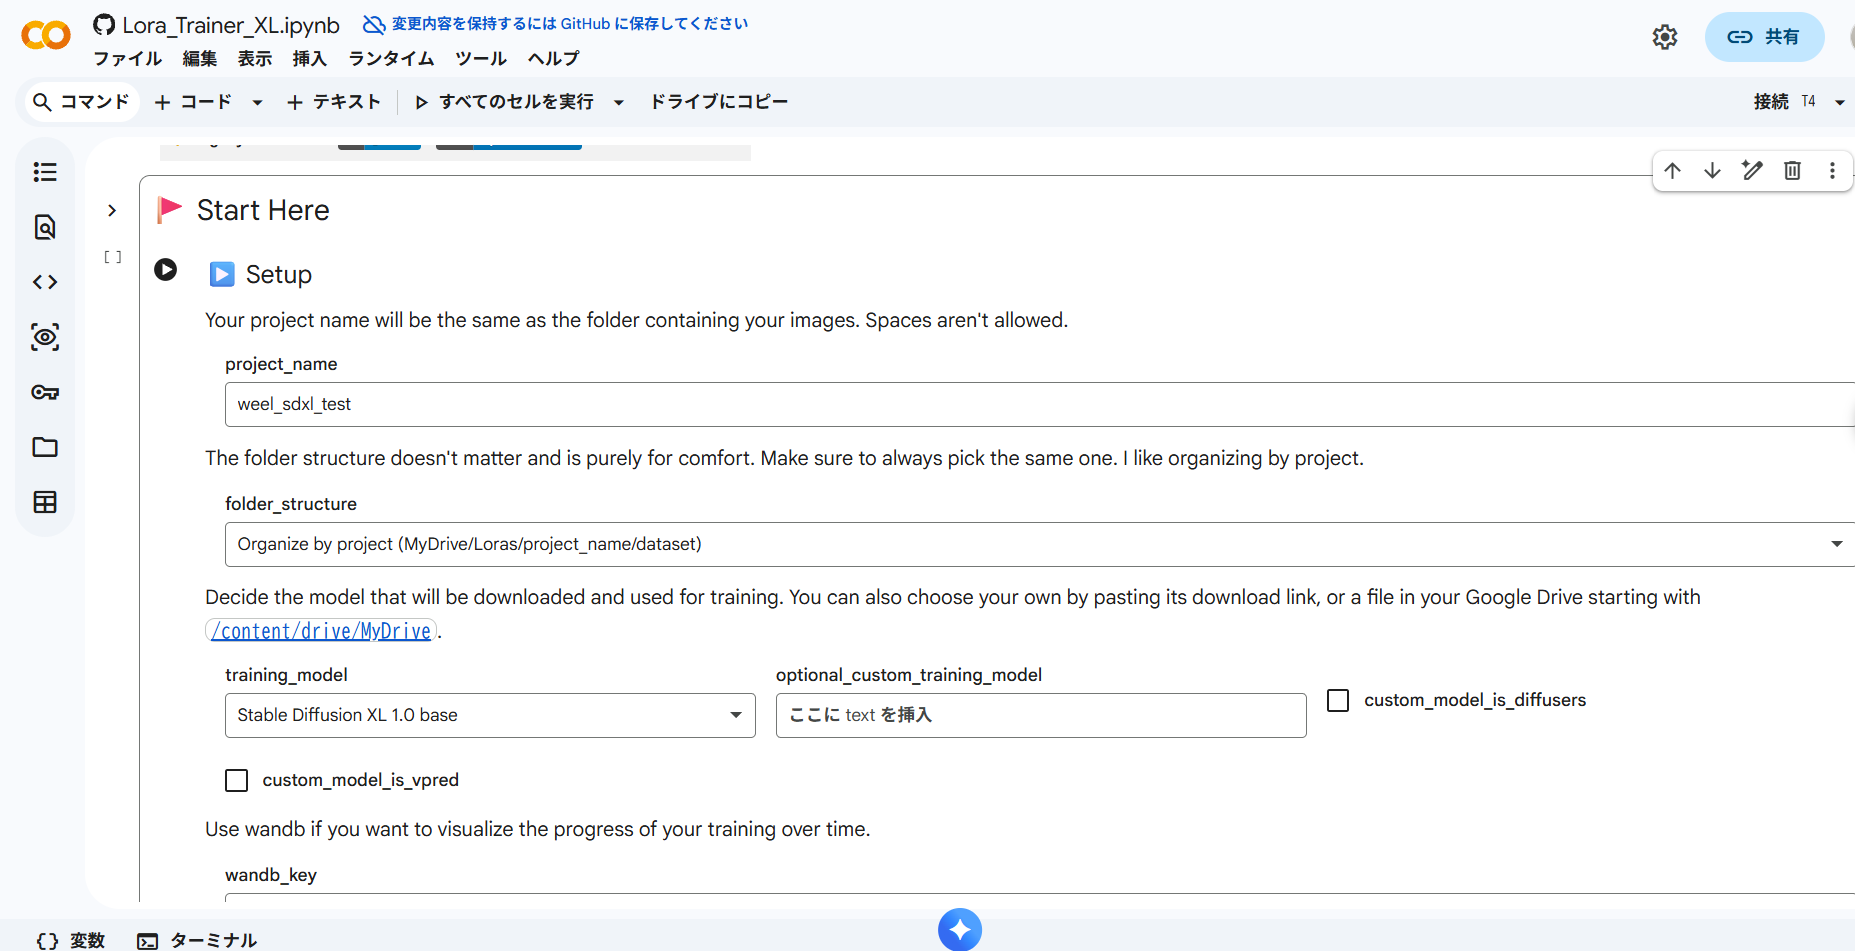
まず、project_nameに任意のプロジェクト名を入力し、folder_structureでGoogleドライブ内の保存先を選択しましょう。
続いて、training_modelから「Stable Diffusion XL 1.0 base」を選択します。
学習回数は「Steps」で指定できます。preferred_unitを「Epochs」にすると、how_manyでエポック数を設定可能です。
また、「Structure」ではlora_typeから「LoRA」を選択します。「Training」のtrain_batch_sizeはGPUメモリの使用量に影響するため、利用環境に応じて調整してください。
今回は、従来のStable Diffusion v1.5より高解像度の画像生成に対応したSDXL Base 1.0を、学習用のベースモデルとして使用します。
学習させる画像をアップロード
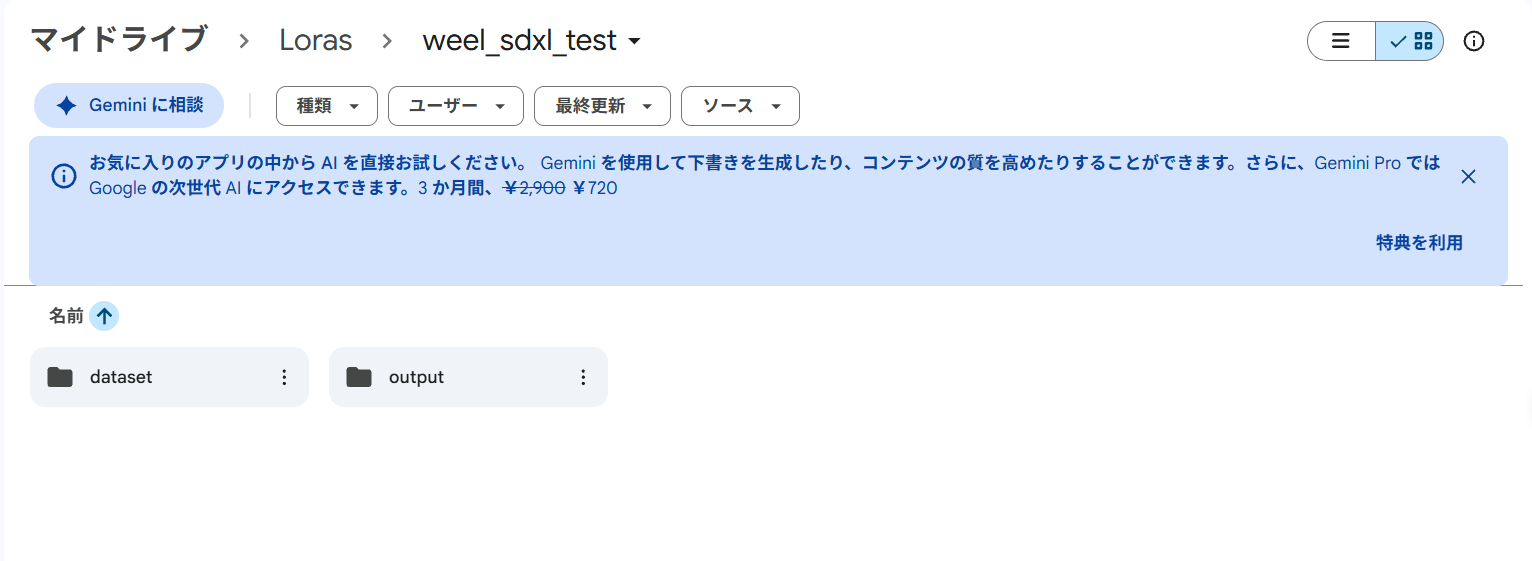
Googleドライブに学習させる画像をアップロードします。folder_structureが初期設定の場合は、「MyDrive/Loras/プロジェクト名/dataset」フォルダに画像を保存します。
LoRAを作成して保存する
画像のアップロード後は、その他必要な設定を以下のように指定します。
| 設定項目 | 設定内容 |
|---|---|
| training_model | Stable Diffusion XL 1.0 base |
| preferred_unit | Epochs |
| how_many | 10(設定例) |
| lora_type | LoRA |
| network_dim | 8 |
| network_alpha | 4 |
| train_batch_size | 1(T4環境での設定例) |
| precision | full fp16 |
その他の項目は初期設定のままで実行して問題ありません。
LoRAの作成にかかる時間は、学習画像の枚数やGPUの性能、ベースモデル、学習設定などによって異なります。学習が完了すると、設定した出力先にLoRAファイルが保存されます。
拡張子が「.safetensors」になっているものが今回自作したLoRAです。
Stable DiffusionへのLoRA導入方法
ここでは、Stable DiffusionへのLoRA導入方法を解説します。
具体的な導入手順は、以下4ステップです。
- LoRAモデルを用意する
- LoRAファイルを指定のフォルダに移動する
- Stable Diffusion WebUIを起動する
- プロンプトでLoRAを適用する
以下でそれぞれの手順を詳しくみていきましょう。
LoRAモデルを用意する

まずは、Civitaiにアクセスし、使用するLoRAモデルをダウンロードしましょう。
Hugging FaceでもLoRAモデルをダウンロードできますが、今回はCivitaiで配布されている「A-Mecha Musume A素体机娘」を例にご紹介します。
ページにアクセスした後は、画像の矢印で示しているダウンロードボタンにカーソルを当て、ファイル名が表示されたら右クリックして「リンクのアドレスをコピー」を選択してください。
Google ColabでLoRAを実行する場合は、コピーしたリンクを使用するので、一旦メモしておきます。
Stable Diffusion WebUIをPCのローカル上にダウンロード済みで、ターミナルなどからStable Diffusion WebUIを呼び出す場合は、LoRAモデルをダウンロードします。
LoRAファイルを指定のフォルダに移動する
ターミナルなどからStable Diffusion WebUIを呼び出す場合は、ダウンロードしたLoRAファイルを「stable-diffusion-webui」→「models」→「Lora」に移動します。
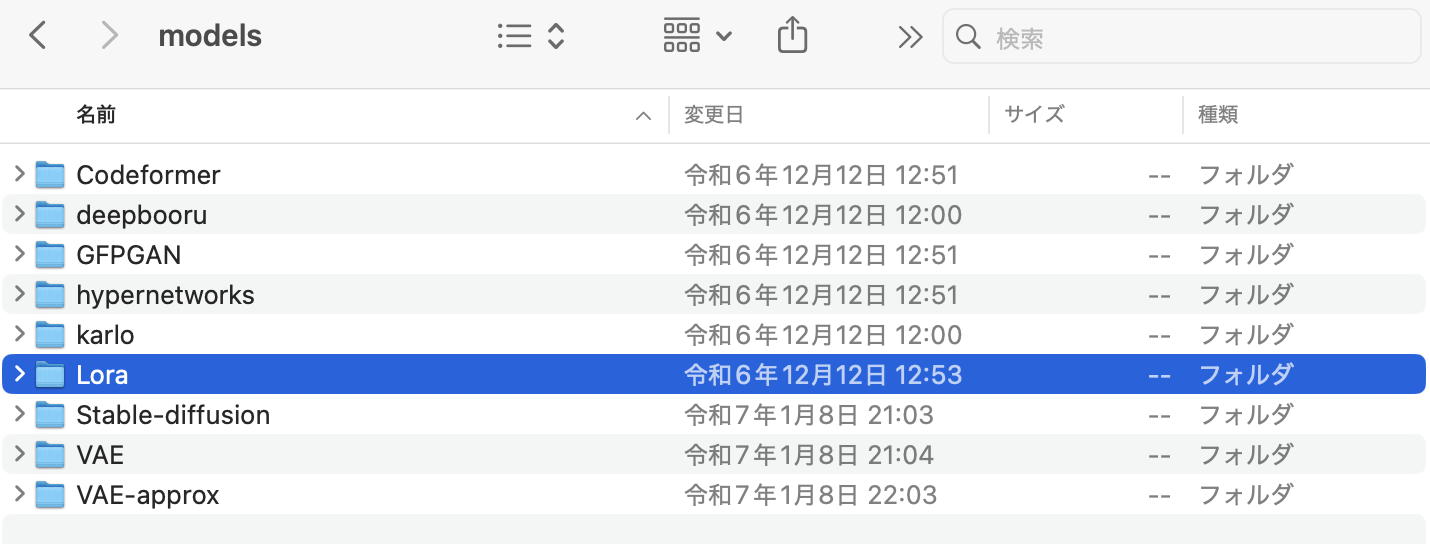

自作したLoRAも同じフォルダに保存することで、Stable Diffusion WebUIから読み込めるようになります。
Stable Diffusion WebUIを起動する
ターミナルで以下のコマンドを実行して、Stable Diffusion WebUIを起動します。
bash stable-diffusion-webui/webui.shまだ、Stable Diffusion WebUIをPCにインストールしていない方は、事前にインストールが必要です。やり方は以下の記事で解説しているので、インストールがまだの方はご覧ください。
プロンプトでLoRAを適用する
LoRAを適用する場合は、Stable Diffusion WebUIの「txt2img」または「img2img」タブを開き、プロンプト欄に以下の形式で入力します。

<lora:ファイル名:強さ>「ファイル名」には、使用するLoRAファイルの拡張子を除いた名前を指定します。「強さ」はLoRAの適用度合いを調整するウェイトで、0.6〜1.0程度を目安に設定し、生成結果を確認しながら調整しましょう。
例えば、「mecha_musume.safetensors」というファイルを使用する場合は、以下のように入力します。
<lora:mecha_musume:0.8>また、LoRAによっては、学習した特徴を呼び出すためのトリガーワードが設定されています。配布ページに記載されたトリガーワードを確認し、必要に応じてプロンプトに追加してください。
例えば、トリガーワードが「mecha musume」の場合は、次のように入力します。
<lora:mecha_musume:0.8>, mecha musume, mechanical parts, robot joints, headgearプロンプトを入力したら「Generate」ボタンを押し、画像を生成します。LoRAの効果が強すぎる場合や特徴が十分に反映されない場合は、ウェイトを調整して再生成しましょう。
なお、Stable Diffusionについて詳しく知りたい方は、下記の記事をご覧ください。
LoRAの活用事例
LoRAは、個人の画像生成だけでなく、企業のコンテンツ制作・商品ビジュアルの生成・ゲームのアート制作にも活用されています。特定の商品やブランド、キャラクターなどの特徴をAIに反映させることで、用途に合わせた画像を効率的に生成できます。
ここでは、実際にLoRAを活用している活用事例を見ていきましょう。
事例①ゲーム開発でのキャラクターデザイン
AI Frog Interactiveが開発するゲーム「EXELIO」では、生成AIをキャラクターデザインや発注資料用の2Dアート制作に活用しています。4人という小規模なチームで開発を進めるなか、生成AIを使ってアイデアを具体的なデザインへ落とし込むことで、制作を効率化しています。※4
同じウェビナーでは、元となるキャラクターのコンセプトイメージからLoRAを作成し、画像から画像を生成する機能(i2i)と組み合わせることで、キャラクターの特徴を保ちながら別角度などのバリエーションを作成する手法も紹介されました。
事例②AIアニメ制作
AIを活用したアニメ制作プロジェクト「ツインズひなひま」では、3DCGとStable DiffusionなどのAI技術を組み合わせてアニメーションを制作しています。※5
制作では、モーションキャプチャーで作成した3DCGをAIでセル画風のアニメ表現に変換しており、LoRAの工程では外部の協力も得ています。
また、AIで変換した映像は最終的な品質の確認と修正を人が担当しており、AIを制作工程の補助として活用している点も特徴です。※5
このようにLoRAは、画像の画風を変えるだけでなく、アニメや映像コンテンツの制作工程にも活用されています。
事例③マーケティング画像生成
Volkswagen Groupでは、生成AIをマーケティング用の車両画像の制作に活用しています。AWSと共同で、車両の画像を生成する仕組みを構築し、2025年には生成AIを活用したマーケティング画像の制作・評価システムを開発しました。※6
そのなかで、Flux.1-Devという画像生成モデルにLoRAアダプターを組み合わせています。LoRAを使ってVolkswagen独自のデザインを反映することで、グリルの質感やホイールのデザイン、車両の形状など、細かな特徴を保った画像を生成できるようにしています。
また、発売前の車両についても画像を生成できるため、実際の撮影を行わずにさまざまなマーケティング素材を作成できる点も特徴です。
LoRAで画像生成する際の注意点
LoRAで画像生成する際は、以下の2点に注意が必要です。
- 著作権への配慮は必要
- 商用利用に関して
とくに、LoRAで生成した画像は、他人の著作権を侵害する恐れがあるので十分な配慮が必要です。何も考えずに商用利用すると、あとで訴訟される事態にもなりかねません。
以下で、注意点について詳しく解説するので、ぜひ参考にしてみてください。
著作権への配慮は必要
LoRAを使用する際は、学習に使用する画像と、生成した画像の著作権に注意が必要です。特に、既存のキャラクターやイラストなどを再現する場合は、著作権侵害につながる可能性があります。
文化庁は2024年3月に「AIと著作権に関する考え方について」を公表し、AIの学習段階と生成・利用段階における著作権の考え方を示しました。
学習段階では、著作権法第30条の4により、一定の条件下で著作権者の許諾なく著作物を利用できる場合があります。ただし、著作物の表現を享受する目的がある場合や、著作権者の利益を不当に害する場合などは対象外となります。
商用利用に関して
LoRAは、使用するモデルによって商用利用OKのものと、NGのものがあります。LoRAモデルをCivitaiなどのサイトでダウンロードする際に、ライセンス内容を確認すれば商用利用に関する記載があるので、必ず事前に確認しておきましょう。
なお、商用利用がOKだったとしても無条件に使えるわけではありません。利用目的がライセンス違反に該当したり、そもそも違法なことを目的に利用したりすると法律で罰せられます。
前述したように、LoRAは有名人やキャラクターを学習したモデルも多数存在するので、著作権問題についても十分考慮しましょう。
\画像生成AIを商用利用する際はライセンスを確認しましょう/
LoRAなどのご相談はWEELへ
画像生成AIを使っていると、「同じキャラクターを安定して生成したい」「自社の商品らしい画像を作りたい」など、生成結果を細かく調整したい場合はLoRAを活用することで問題が解決する場合があります。
既存のAIモデルに特定の画風やキャラクター、商品デザインなどの特徴を追加できるため、自社のコンテンツ制作やマーケティングなど幅広いシーンで活用できます。まずは既存のLoRAを試しながら、どのような用途に使えるのか確認してみるとよいでしょう。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。
LoRAのよくある質問