SFTとは?教師ありファインチューニングの仕組み・実践方法をわかりやすく解説
- SFT(教師ありファインチューニング)は、正解例を含むデータを使ってAIモデルに追加学習させる手法
- 事前学習・RLHF・RAGとは目的やモデルへの適用方法が異なる
- Hugging FaceなどのOSSツールやクラウドのファインチューニング機能を使えば、SFTを実践できる
SFT(Supervised Fine-Tuning)とは、事前学習を終えたAIモデルに正解例を含むデータを追加学習させ、期待どおりの受け答えができるようにする手法です。LLMのポストトレーニングで使われる代表的な手法で、モデルの振る舞いを用途に合わせて調整できます。
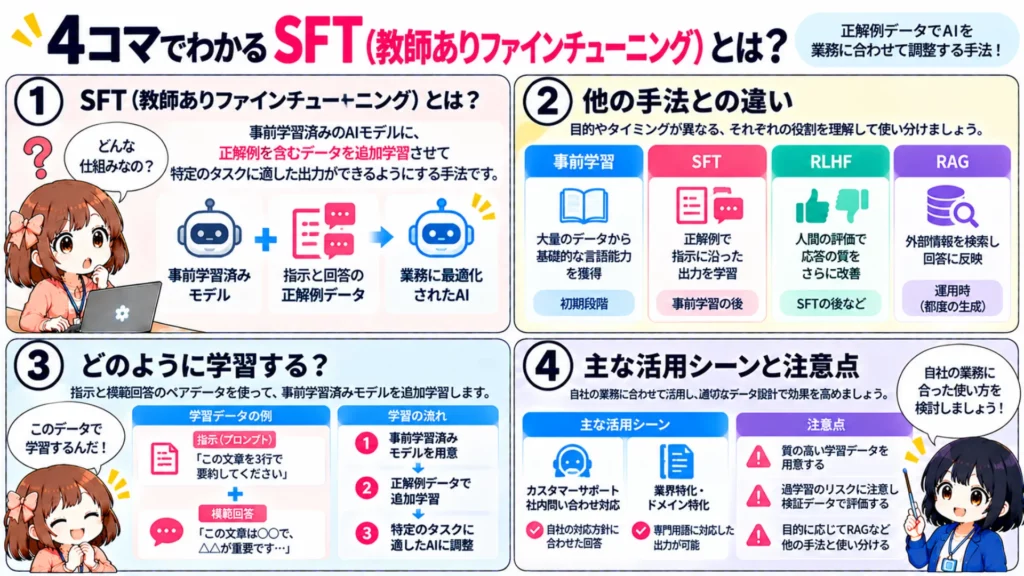
とはいえ、「事前学習やRLHFと何が違うの?」と疑問に思う方も多いのではないでしょうか。
本記事では、SFTの仕組みや他手法との違い、実践のポイントを解説します。
\生成AIを活用して業務プロセスを自動化/
SFT(教師ありファインチューニング)とは
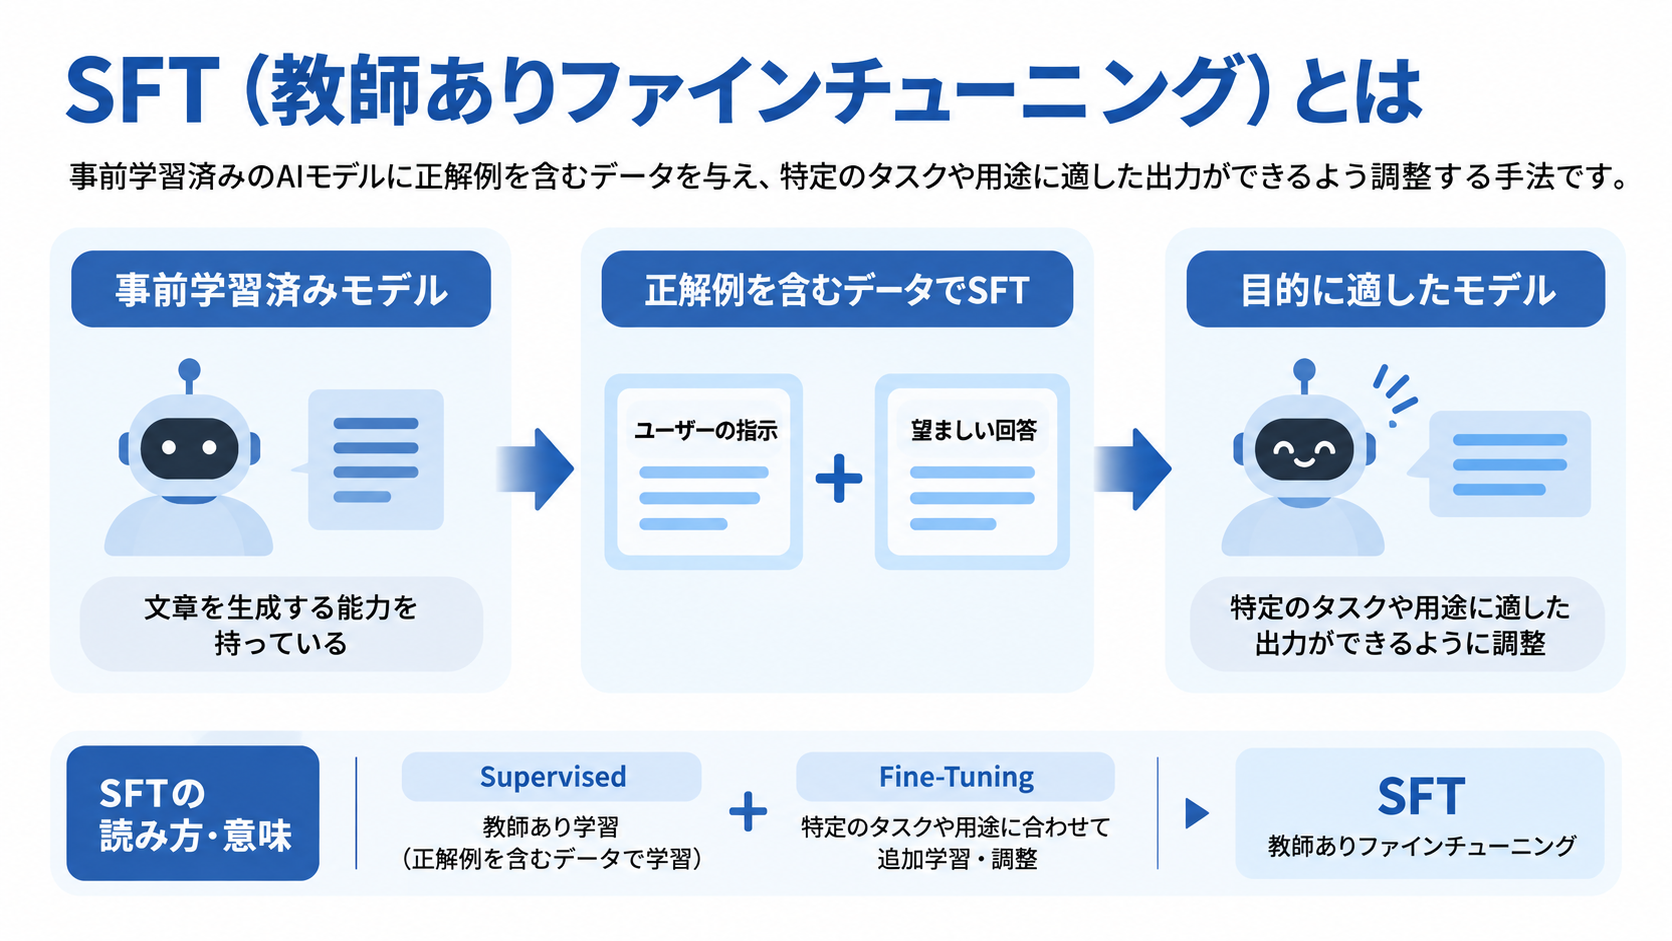
SFT(教師ありファインチューニング)は、事前学習済みのAIモデルを、正解例を含むデータで特定のタスクや用途に適応させる手法です。ここでは、SFTの基本的な意味と名称について解説します。
SFTの基本的な意味
SFTとは「Supervised Fine-Tuning」の略で、日本語では教師ありファインチューニングと呼ばれます。事前学習済みのAIモデルに正解例を含むデータを与え、特定のタスクや用途に適した出力ができるよう追加学習する手法です。
LLMに指示への対応方法を学習させる場合は、ユーザーからの指示と望ましい回答を組み合わせたデータなどを使用します。こうしたデータを学習することで、モデルを目的に応じた応答形式や振る舞いに調整できます。
事前学習だけを終えたベースモデルは、文章を生成する能力を持っていても、必ずしもユーザーの指示に適した回答を返せるとは限りません。SFTは、このようなモデルを特定のタスクや指示に適応させる方法の一つです。
Supervised Fine-Tuningの語源・読み方
Supervised Fine-Tuningは日本語で「教師あり微調整」や「教師ありファインチューニング」と訳され、一般的には頭文字を取って「SFT」と呼ばれます。
「Supervised」は教師あり学習を意味し、正解となるラベルや出力例を含むデータを使ってモデルを学習させることを表します。「Fine-Tuning」は、事前学習済みのモデルを特定のタスクや用途に合わせて追加学習し、調整することです。
つまりSFTは、正解例を含むデータを使って、事前学習済みモデルを目的に合わせて調整する手法と理解するとよいでしょう。
SFTの仕組み・学習プロセス
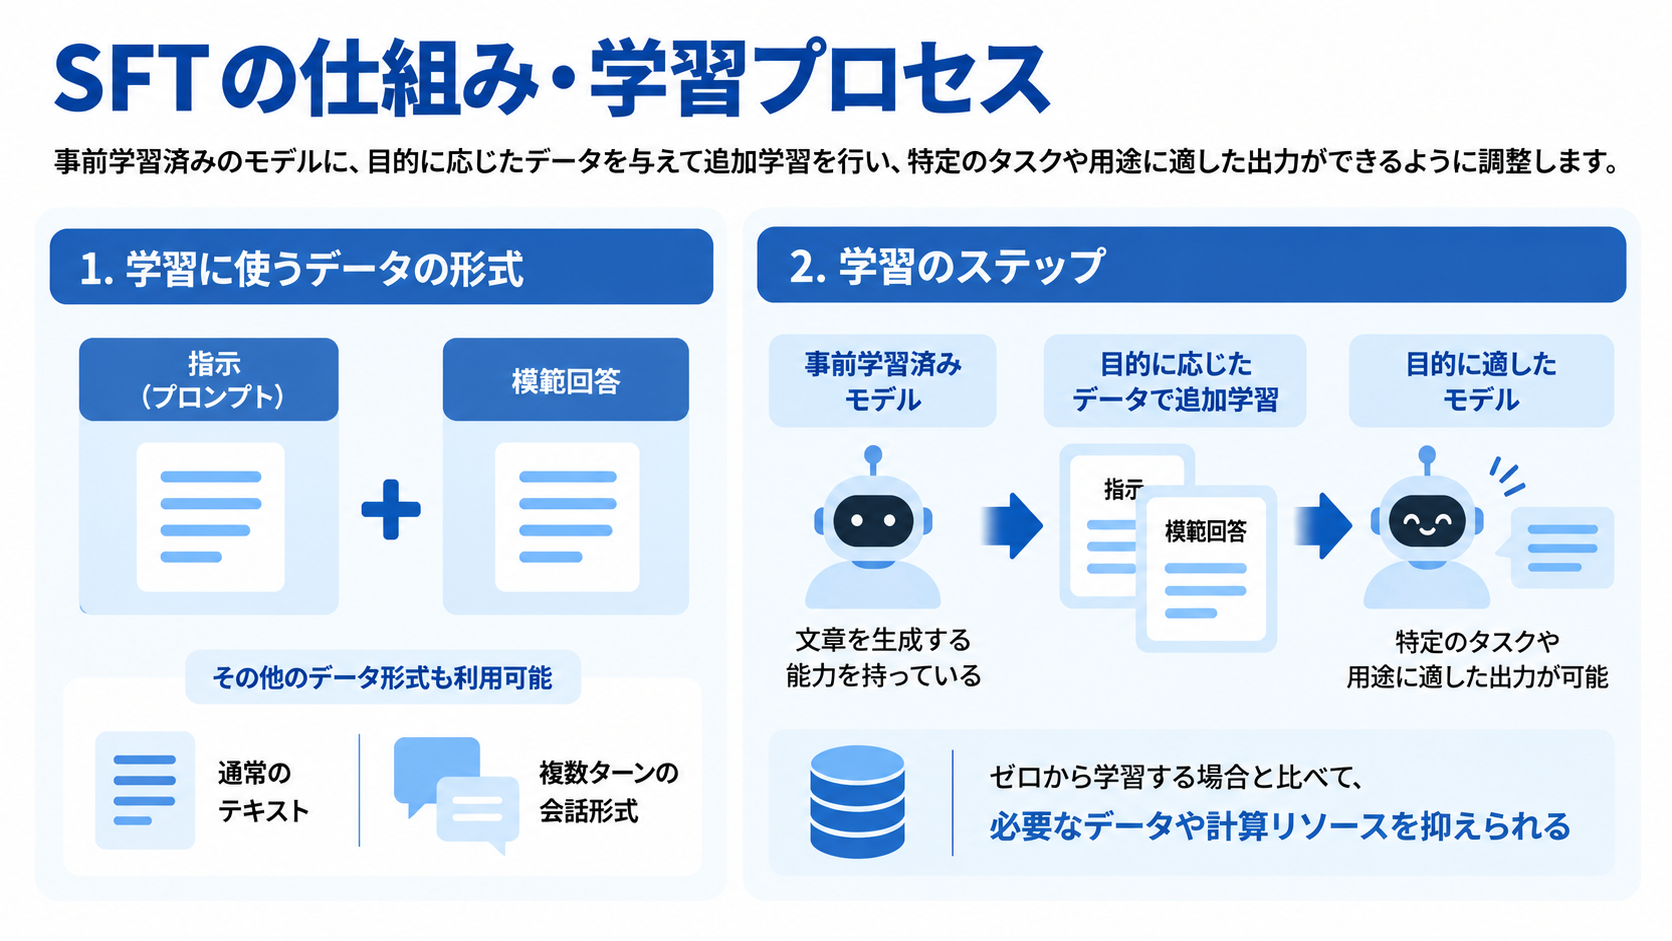
SFTでは、事前学習済みのモデルに目的に応じたデータを与えて追加学習を行います。学習の中心となるのは、どのような入力に対してどのような出力を返すべきかを示した正解例です。
ここでは、SFTで使用するデータの形式と基本的な学習の流れを見ていきましょう。
生成AIがどのように学習しているのかについては、以下の記事で詳しく解説しています。
学習に使うデータの形式(指示と模範回答のペア)
代表的なのは、「指示(プロンプト)」と「模範回答」を1組にしたデータ形式です。たとえば「この文章を3行で要約して」という指示に対して、理想的な要約文を模範回答として用意します。
こうしたデータを使って学習することで、モデルを目的とするタスクや応答形式に適応させます。学習データの内容はモデルの出力に影響するため、目的に合った質の高いデータを用意することが重要です。
なお、SFTで使用できるデータ形式は指示と回答のペアだけではありません。利用するモデルやツールによっては、通常のテキストや複数ターンの会話形式なども学習に利用できます。
学習のステップ(事前学習済みモデルへの追加学習)
SFTは、一般的に事前学習済みのモデルをベースにして追加学習を行います。ゼロからモデルを学習させるのではなく、事前学習で獲得した能力を土台として、目的に応じたデータを使ってモデルを調整する仕組みです。
たとえば、指示と回答のペアを学習データにすれば、特定の指示への対応方法や出力形式をモデルに身につけさせられます。
SFTは大規模なモデルをゼロから事前学習する場合と比べて、必要なデータや計算リソースを抑えられるのが特徴です。ただし、必要なリソースはモデルの規模や学習方法、データ量などによって異なります。
事前学習・RLHF・RAGとの違い
| 手法 | 目的 | タイミング |
|---|---|---|
| 事前学習 | 大量のテキストから基礎的な言語能力を獲得する | モデル開発の初期段階 |
| SFT | 指示に沿った受け答えができるようにする | 事前学習の後 |
| RLHF | 人間の評価をもとに応答の質をさらに高める | SFTの後などのポストトレーニング |
| RAG | 外部情報を検索して回答に反映する | モデル運用時(都度の応答生成時) |
SFTは、事前学習後にモデルを調整する手法の一つです。モデルの学習・活用にはSFT以外にもRLHFやRAGなどがあり、それぞれ目的や仕組みが異なります。ここでは、事前学習・RLHF・RAGとSFTの違いを解説します。
事前学習(Pre-training)との違い
事前学習は、大量のテキストデータなどを使って言葉の並びや意味の関係性といった基礎的な言語能力をモデルに身につけさせる段階です。この段階のモデルは幅広い知識を持つ一方で、指示にうまく従えないことがあります。
SFTは、この事前学習済みモデルを土台にして特定のタスクや指示に適した出力ができるよう追加学習する段階にあたります。事前学習が基礎体力づくりだとすれば、SFTは実践練習に近いイメージです。
RLHF(人間のフィードバックからの強化学習)との違い・位置づけ
RLHF(Reinforcement Learning from Human Feedback)は、SFTを終えたモデルの応答を人間が評価し、その評価結果をもとに強化学習で応答の質をさらに高める手法です。SFTが模範回答を直接教えるアプローチであるのに対し、RLHFは複数の回答に対する人間の評価を利用してモデルを調整します。
一方で、RLHFはSFTと比べて評価データの収集や学習プロセスが複雑になりやすく、実装のハードルも高くなる傾向があります。そのため、目的によってはSFTだけでモデルを調整する方法も十分な選択肢となります。
RLHFの仕組みについては、以下の記事で詳しく解説しています。

RAG(検索拡張生成)との違い・使い分け
RAG(Retrieval Augmented Generation)は、モデル自体を学習し直すのではなく質問に関連する情報を外部データベースから検索し、その内容を踏まえて回答を生成する手法です。SFTがモデルを追加学習して特定のタスクや応答形式に適応させるのに対し、RAGはモデルの外側に情報源を置く点が大きな違いです。
そのため、社内マニュアルの更新など頻繁に情報が変わる用途にはRAGが、特定のタスクや応答のトーン、出力形式などにモデルを適応させたい用途にはSFTが向いています。両者は目的が異なるため、組み合わせて活用することも可能です。
LLMとRAGの関係や仕組みは、以下の記事で解説しています。
SFTを試せる代表的なツール・サービス
| ツール・サービス | 特徴 |
|---|---|
| OpenAIのFine-tuning API | 既存ユーザーのみ利用可能(新規ユーザーの受付は終了) |
| Hugging Face・TRLなどのOSSツール | モデルやデータを自前で管理でき、自由度が高い |
| クラウド(Vertex AI・Azureなど)のファインチューニング機能 | 既存のクラウド基盤・権限管理と統合しやすい |
2026年10月時点では、APIやオープンソースツール、クラウドサービスなど、SFTを実践するための環境が複数提供されています。ここでは、それぞれの特徴を簡単に見ていきましょう。
OpenAIなどのFine-tuning API
OpenAIは、Fine-tuning APIを通じてSFTの機能を提供してきました。プロンプトと望ましい出力例を含む学習データをアップロードするだけで、対応モデルを追加学習できるのが特徴です。
ただし、OpenAIはファインチューニングプラットフォームの提供を段階的に終了しています。公式の非推奨情報によると、2026年5月7日以降はファインチューニングを利用したことのない組織が新たに学習ジョブを作成できなくなり、2027年1月6日には既存ユーザーも新規の学習ジョブを作成できなくなる予定です。
なお、作成済みのファインチューニングモデルは、ベースモデルが廃止されるまで推論に利用できます。これから新たにSFTに取り組む場合は、後述のOSSツールやクラウドサービスを中心に検討するとよいでしょう。
Hugging Face・TRLなどのOSSツール
Hugging FaceのTransformersやTRLといったオープンソースツールを使うと、モデルの選定から学習の細かい設定まで自前でコントロールできます。オープンソースのモデルを使って独自の環境でSFTを行いたい場合に適した選択肢です。
Hugging FaceのTRLにはSFT用の「SFTTrainer」が用意されており、少ないコードで学習を始められます。ただし、学習を実行するためのGPUなどの計算リソースを確保する必要があり、マネージド型のサービスと比べると環境構築や設定の手間がかかります。LoRAのように一部のパラメータだけを学習する手法を組み合わせれば、必要なGPUメモリを抑えることも可能です。
クラウド(Vertex AI・Azureなど)のファインチューニング機能
Google CloudのVertex AIやMicrosoft Azureなど、主要クラウドサービスにもファインチューニング機能が用意されています。既存のクラウド基盤やアクセス権限管理と組み合わせやすいのが特徴です。たとえばVertex AIでは、Geminiモデルを対象に、JSONL形式で用意した学習データを使って教師ありチューニングを実行できます。
すでに特定のクラウドサービスを業務基盤として使っている企業であれば、既存の環境や管理体制と組み合わせて導入を検討しやすい選択肢です。
SFTを実践する際のポイント・注意点
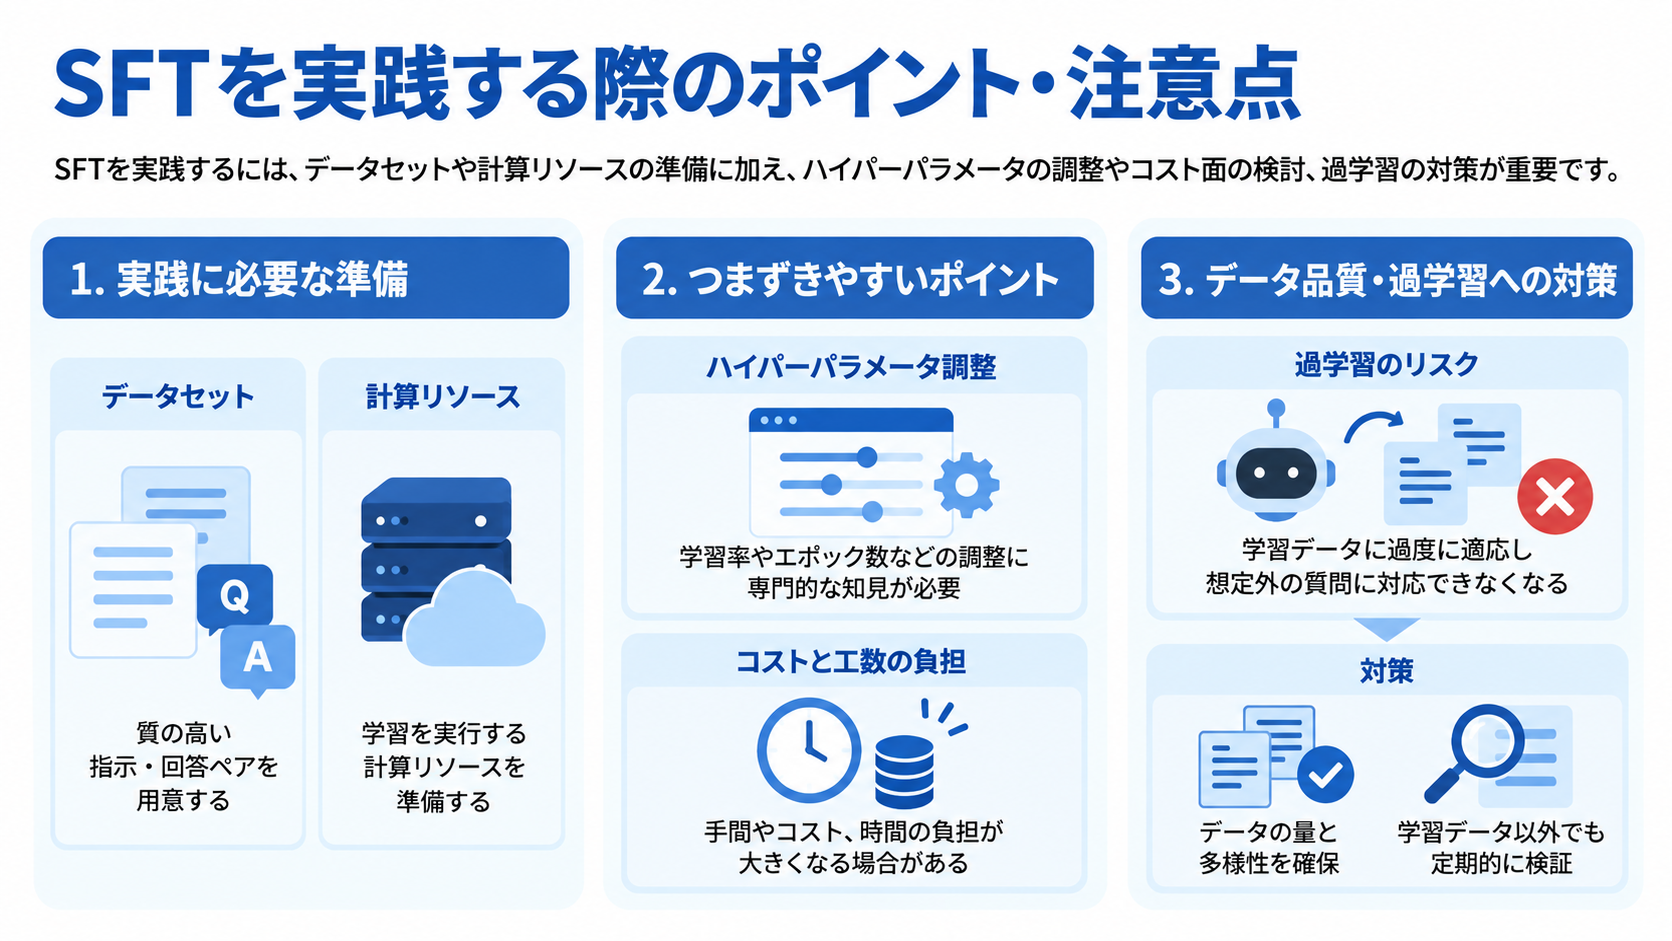
SFTを実践できる環境が整ってきたとはいえ、実際に取り組むと想定外のハードルに直面することもあります。ここでは、実践に必要な準備からつまずきやすいポイントまで解説します。
実践に必要な準備(データセット・計算リソース)
SFTを実践する際の主な準備として、大きく分けて「質の高い指示・回答ペアのデータセット」と「学習を実行する計算リソース」の2つが挙げられます。データセットは自社の業務内容やFAQをもとに、想定される質問と模範的な回答のペアを作成する方法があります。
計算リソースについては、マネージド型のサービスを利用する場合はサービス側の環境を利用できますが、OSSツールで実装する場合はGPUなどの計算リソースを確保する必要があります。
つまずきやすいポイント(ハイパーパラメータ調整・コストと工数の負担)
SFTを自前で実装する場合、学習率やエポック数といったハイパーパラメータの調整には専門的な知見が求められます。設定が合わないと期待する出力が得られず、調整を何度も繰り返すことになりかねません。
WEELが企業からAI開発の相談を受ける中でも、こうした調整方針の設計そのものに知見が不足しているという声が挙がることがあります。また、ハルシネーション対策を目的にSFTを検討しても、手間やコスト、時間の負担を理由にRAGなど別の手法が選ばれる場合もあります。
SFTに取り組む際は、こうした工数・コスト面のハードルもあらかじめ想定しておくことが大切です。
データ品質・過学習(オーバーフィッティング)リスクへの対策
学習データの量や多様性が十分でない場合、学習データの特徴に過度に適応する「過学習」が起きる可能性があります。
過学習が起きると、学習データに似た質問には的確に答えられても、未知の入力に対する性能が低下するおそれがあります。対策としては、データの量と多様性を十分に確保したうえで、学習に使用していない検証データでも評価を行い、応答の品質を確かめることが重要です。
過学習の原因や見分け方は、以下の記事で詳しく解説しています。
SFTのビジネスでの活用シーン
SFTは、企業が生成AIを自社の業務に合わせてカスタマイズする際にも活用されています。代表的な活用シーンを2つ紹介します。
カスタマーサポート・社内問い合わせ対応での活用
過去の問い合わせ対応履歴などをもとにSFTを行うことで、自社のトーン・回答方針に合わせたカスタマーサポートAIを構築できます。汎用AIでは対応しきれない、自社特有の言い回しやルールに沿った出力が期待できます。
社内向けの問い合わせ対応(総務・情シスへの質問対応など)にも同様に応用でき、担当者の負担軽減につながります。なお、規程やマニュアルのように内容が頻繁に変わる情報は、SFTで覚えさせるよりもRAGで参照させるほうが更新しやすいため、両者を組み合わせる構成も検討するとよいでしょう。
下記の記事でも詳しく解説

業界特化・自社ドメイン特化モデルの構築
医療・法律・金融といった専門性の高い業界では、業界特有の用語や言い回しに対応させるためにSFTを活用できます。専門用語を含む質問と望ましい回答例をデータセットとして学習させれば、その分野に適した表現で出力しやすくなります。
汎用モデルのままでは表現が一般的すぎる場合でも、自社の用途に合わせて振る舞いや出力形式を調整できる点がメリットです。ただし、専門分野では誤った回答によるリスクも大きくなるため、専門家が出力内容をチェックする体制もあわせて整えておきましょう。
自社データを活かした生成AI活用ならWEELにご相談ください
SFTは、事前学習済みのAIモデルに正解例を含むデータを追加学習させ、特定のタスクや用途に適した出力ができるよう調整する手法です。RLHFやRAGとは目的や役割が異なり、自社の業務やデータに合わせてAIをカスタマイズしたい場合に有効な選択肢となります。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、通勤時間に読めるメルマガを配信しています。
最新のAI情報を日本最速で受け取りたい方は、以下からご登録ください。
また、弊社紹介資料もご用意しておりますので、併せてご確認ください。
SFTに関するよくある質問