LMM(大規模マルチモーダルモデル)とは?LLMとの違いや代表モデルを解説
- LMMとLLMの決定的な違いは、扱える情報の数と種類である
- ビジネスの現場で「アナログ業務の自動化」を一気に加速させる
- 活用時には「ハルシネーション」と「セキュリティ」への配慮が不可欠
LMM(大規模マルチモーダルモデル)とは、文章だけでなく画像・音声・動画などの複数種類の情報をまとめて理解・処理できるAIモデルのことです。例えば、スマートフォンで撮影した写真をChatGPTやGeminiなどのAIに見せて質問に答えてもらう機能も、LMMによって実現されています。
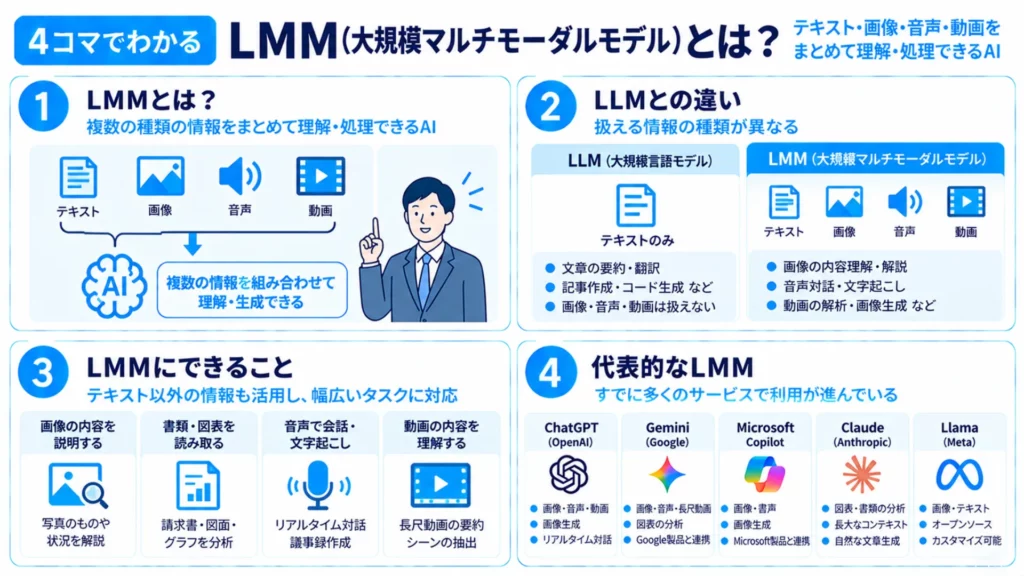
この記事では、LMMの基本やLLMとの違い・代表的なモデル、実際に使って比較した検証結果、業務での活用例と注意点を解説します。ぜひ参考にしてください。
\生成AIを活用して業務プロセスを自動化/
LMM(大規模マルチモーダルモデル)とは?
LMM(大規模マルチモーダルモデル)とは、テキスト・画像・音声・動画など、複数種類の情報(モダリティ)を横断的に処理・理解できるAIモデルを指します。従来のAIモデルの多くはテキスト処理のみを対象としていましたが、LMMでは異なる形式のデータを同時にインプット・アウトプットできます。
例えば、2026年10月時点の代表的な生成AI(ChatGPTやGeminiなど)では、画像や音声ファイルをアップロードして内容について対話したり、リアルタイムの音声会話でやり取りしたりする機能が当たり前になりました。
このように単一のテキスト処理にとどまらず、視覚や聴覚といったマルチモーダルな情報を一体として扱えるようになったことで、LMMを搭載したAIはより人間に近い柔軟な思考や判断ができるようになると期待されています。
LLMとLMMの違い
LLMとLMM(大規模マルチモーダルモデル)の主な違いは、取り扱える情報の種類(モダリティ)にあります。それぞれの特徴と違いをまとめると下表の通りです。
| 項目 | LLM(大規模言語モデル) | LMM(大規模マルチモーダルモデル) |
|---|---|---|
| 扱える情報 | テキスト(文章・コード)のみ | テキスト・画像・音声・動画など複数 |
| できること | 文章の要約・翻訳・記事執筆・プログラミングコードの生成 など | 写真の内容解説、音声対話、画像・動画の解釈や生成、グラフ資料の分析 など |
| 代表例(※2026年10月時点) | テキスト専用の言語モデル(GPT-3、初期のLlamaなど) | ChatGPT・Gemini・Claudeなどに搭載されている最新モデル |
| 苦手なこと・限界 | 写真・図表・音声など、文章以外の情報を直接理解・認識できない | 処理の計算コストが高く、多種多様なモダリティの組み合わせによって解釈ミス(ハルシネーション)が生じる場合がある |
例えるなら、LLMが「文章の読み書きに長けた言語の専門家」だとすれば、LMMはそこに「視覚」や「聴覚」が加わり、人間の五感に近い知覚を持ったAIと言えます。
シングルモーダルとマルチモーダルの違い
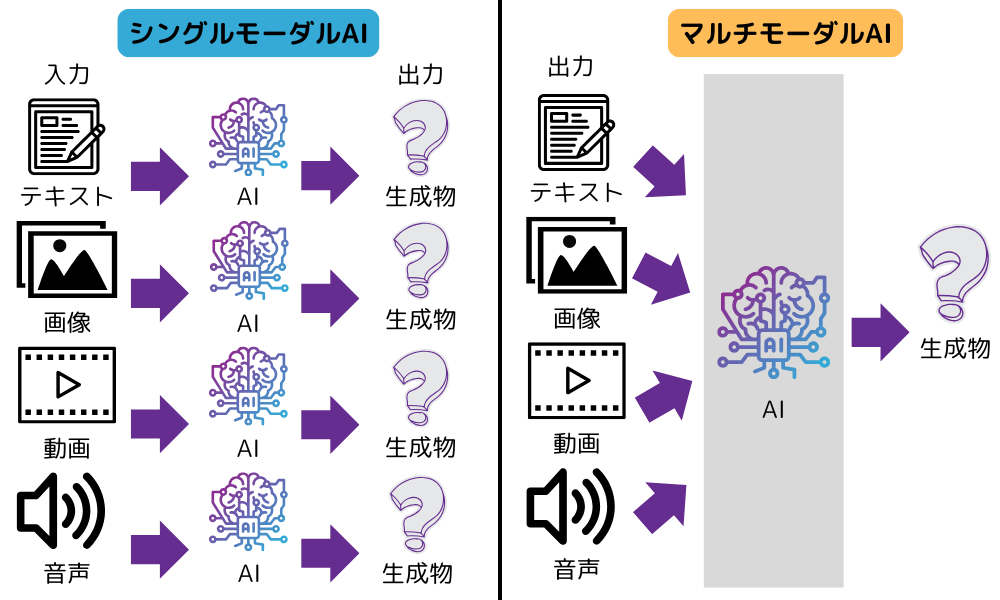
シングルモーダルとマルチモーダルの最大の違いは、扱えるデータの数にあります。シングルモーダルは単一の情報に特化したAIです。例えば「文章を入力して文章で返すテキストAI」や「画像の判定のみを行う画像認識AI」のように、1種類のデータのみを処理します。
一方、マルチモーダルはテキスト・画像・音声・動画など、2種類以上の異なるデータを組み合わせてまとめて処理できるAIです。「写真を見せながら音声や文章で質問し、回答を得る」といった高度なやり取りが可能になります。
マルチモーダルAI全般の特徴や将来性について詳しく知りたい方は、下記の記事もご覧ください。
LMM(大規模マルチモーダルモデル)にできること
LMMはテキストだけでなく画像・音声・動画など多様なデータを統合して処理できるため、従来のAIでは難しかった複雑なタスクに対応可能です。ここでは、業務や日常で具体的に活用できる代表的な機能を紹介します。
画像・写真の内容を説明する
LMMは、アップロードされた画像や写真に写る物体・背景・状況などを認識し、テキストで解説できます。例えば、旅先で撮影した珍しい植物や建築物の写真を読み込ませて「これは何ですか?」と質問すると、名称や背景情報を即座に回答してくれます。
また、目視確認が必要だった商品の外観検品や、部屋のインテリア写真から改善案を提案させるといった活用も可能です。視覚情報を言語化する精度が飛躍的に向上したことで、視覚障害者向けの音声サポートや現地調査の効率化など、幅広い分野で導入が進んでいます。
書類・図面・グラフを読み取る
手書きのメモや複雑なレイアウトの請求書・設計図面・折れ線グラフなどの視覚的資料を正確に分析・データ化できます。従来のOCR(光学文字認識)では難しかった「グラフの傾向を読み取って文章で要約する」「表の数値を分析して課題を抽出する」といった高度な文脈理解が可能です。
これにより、紙で保管されていた過去資料のデジタル化や、毎月の業績レポートの初期分析を自動化できます。複雑な決算書や技術資料を入力するだけで、瞬時に要点を把握できるため、バックオフィス業務の劇的な効率化に貢献します。
音声で会話する・文字起こしする
リアルタイムでの音声対話や、高精度な音声データの文字起こしが可能です。AIとのやり取りがテキスト入力だけでなく自然な会話で行えるため、ハンズフリーでの操作やAIアシスタントとしての活用が広がっています。
また長時間のミーティング音声を入力すれば、単に発言をテキスト化するだけでなく、文脈を考慮した要約やアクションプランの抽出まで自動で行います。複数人の話者を識別したり、言いよどみを補正しながら自然な文章に整えたりできるため、議事録作成の手間を大幅に削減できるでしょう。
動画の内容を理解する
静止画にとどまらず、時間の経過に伴う映像や音声の変化を捉え、動画全体の流れや内容を深く理解できます。例えば、数十分のセミナー動画や監視カメラ映像を入力し「作業手順が正しく行われているシーンを抽出して」「事故の原因となった場面を特定して」といった指示を出すことで、該当箇所を瞬時に検索・要約できます。
長尺動画のハイライト作成やマニュアル動画からの手順化、防犯カメラの異常検知など、これまで人間が長時間視聴して確認していた映像確認タスクを自動化・高速化できる点も魅力です。
文章から画像を作る
テキストで出力したいイメージを入力するだけで、それに沿った高品質な画像を瞬時に生成できます。「カフェでパソコンを開く30代男性、ビジネス感のある明るい雰囲気で」といった具体的な条件を指定することで、Webサイトのアイキャッチ画像やプレゼン資料の挿し絵、広告のクリエイティブ案などを手軽に作成可能です。
デザインの専門知識がない担当者でも、イメージを言葉にするだけで思い通りの画像を得られるため、コンテンツ制作のコスト削減とスピード向上を同時に実現できます。
代表的なLMM(大規模マルチモーダルモデル)
ここでは、2026年10月時点のLMM(大規模マルチモーダルモデル)の代表例を紹介します。
今回ご紹介するのは、以下5つのモデルです。
- ChatGPT
- Gemini
- Microsoft Copilot
- Claude
- Llama
| モデル名 | 開発元 | 扱える情報(画像・音声・動画) | 無料で使えるか |
|---|---|---|---|
| ChatGPT | OpenAI | ・画像(読み取り・生成) ・音声(リアルタイム対話) ・テキスト | ○(一部機能・利用回数制限あり) |
| Gemini | ・画像(高精度な読み取り) ・音声(文字起こし・対話) ・長尺動画(ダイレクト解析) ・テキスト | ○ | |
| Microsoft Copilot | Microsoft | ・画像(読み取り・生成) ・音声(入力・対話) ・テキスト | ○ |
| Claude | Anthropic | ・画像(図表・UI画面の分析) ・超長文データ ・テキスト | ○(高度な機能は有料) |
| Llama | Meta | ・画像(ビジョン対応モデル) ・テキスト | ○(オープンソースのため、モデル自体は無料※利用環境や構築費は別途) |
それぞれのモデルの特徴を詳しくみていきましょう。
ChatGPT
OpenAIが提供するChatGPTには、テキスト・画像・音声・動画(フレーム解析)をひとつのモデルで直接処理できる高度なLMMが搭載されています(※2026年10月時点)。
単一のインターフェース上で、文字による指示だけでなく多様なデータをシームレスに組み合わせた指示・出力が可能です。現在、主に以下のような機能に対応しています。
| 機能 | 内容 |
|---|---|
| 写真・画像・PDFなどのビジュアル読み取り | スマホで撮影した写真や手書きのメモ、グラフ、PDF形式の書類などをそのまま読み込ませて解説を求めたり、指定のフォーマットへデータ変換させたりできる。 |
| 音声によるリアルタイムな対話 | 画面に向かって話しかけることで、人間と会話しているような自然なレスポンス(声による回答)を得ることができる。ハンズフリーでの作業指示や外国語の会話練習などにも活用されている。 |
| プロンプトからの高品質な画像生成 | チャット上で「どのような画像を作りたいか」を日本語などの文章で指示するだけで、希望に沿ったイラストやグラフィック画像をその場で生成・微調整できる。 |
Gemini
Geminiは、Googleが開発・提供するネイティブ設計のLMMです。2026年10月現在、Gemini 3.1 ProやGemini 3.8 Flashといった最新モデルが展開されており、テキストや画像だけでなく、音声や長尺の動画データまで直接読み込んで一体として理解できる高い処理能力が最大の強みとなっています。
具体的には、以下のような高度なマルチモーダル活用に対応しています。
| 機能 | 内容 |
|---|---|
| 長尺動画の理解・解析 | 数分〜数十分のセミナー動画や監視カメラ映像、画面録画などを直接入力し、「動画内で作業手順が切り替わったシーンを抽出して」「指定のトラブルが発生している場面を特定して要約して」といった複雑な指示に正確に応答可能。 |
| 音声・テキスト・画像の同時処理 | 音声の文字起こしや内容の理解はもちろん、会話音声を聴きながら同時に表示されたスライド画像や関連資料を照らし合わせて、重要なポイントや課題を抽出することが可能。 |
| 図面・グラフ・手書き資料の高精度な読取り | Googleの高度な視覚認識技術により、表データ、複雑な棒グラフ・折れ線グラフ、手書きのメモや設計図面まで精度高く読み取り、データ化や数値の傾向分析を自動で行える。 |
なお、Gemini(旧Google Bard)について詳しく知りたい方は、下記の記事をご覧ください。

Microsoft Copilot
Microsoft Copilotは、Microsoftが提供する生成AIアシスタントです。最新のLMMモデルが統合されており、Webブラウザやモバイルアプリから、テキスト・画像・音声などを組み合わせた高度なマルチモーダル処理を直感的に利用できます。
現在のCopilotが対応している主な使い方や機能は、以下のとおりです。
| 機能 | 内容 |
|---|---|
| 画像や書類のマルチモーダル解析 | チャット画面上のファイル・画像追加アイコンから写真をアップロードし、「写っている動物の種類を教えて」「表の内容を要約して」といった指示を出すことで、視覚情報を即座にテキスト化・分析。 |
| 音声入力およびリアルタイムな対話 | マイクアイコンをタップすることで、音声による入力や自然な対話形式でのやり取りが可能。 |
| 対話型の画像生成 | プロンプトを入力することで、AIがイメージに合わせたイラストやデザイン画像をその場で作成が可能。 |
Copilotを利用する際は、専用Webサイトにアクセスするか、iOS・Android向けのMicrosoft Copilotアプリから直接チャットを開始します。また、Windows PCのタスクバーやMicrosoft Edgeブラウザのサイドバーからもワンタップで立ち上げられるのも便利な点です。
なお、Copilot(旧Bing Chat)について詳しく知りたい方は以下の記事をご覧ください。
Copilotでマルチモーダル機能を無料で使いたい方は、以下の記事もご覧ください。
Claude
Claudeは、AIの安全性と倫理観を重視して開発されたAnthropic社のLMMです。2026年10月現在、SonnetやOpusをはじめとする高度な最新モデルが提供されており、自然で人間らしい文章表現に加えて、長大なコンテキストや視覚データの高精度な解釈能力が高く評価されています。
Claudeが対応している主なマルチモーダル処理や実務活用は、以下のとおりです。
| 機能 | 内容 |
|---|---|
| 複雑な図表・グラフ・書類の高精度な分析 | アップロードした画像やPDF資料から、複雑な折れ線グラフ・棒グラフの数値の読み取り、表データの抽出、手書きメモやフローチャートの文脈理解を正確に行う。ビジネス文書の要約やデータ抽出において極めて高い精度を発揮する。 |
| 画面キャプチャやUI・UXコードの解釈・作成 | Webサイトやアプリの画面スクリーンショットを入力し、「この画面デザインの改善点を教えて」「このレイアウトを再現するHTML/CSSコードを書いて」といった視覚情報とプログラミング言語を掛け合わせた高度な指示に応答可能。 |
| 超長文資料と画像の統合処理 | 数万文字を超える長文ドキュメントと複数の画像・図面を同時に読み込ませ、全体を通じた整合性のチェックや高度なレポート作成を行うことができる。 |
Claudeを利用する際は、Webブラウザで公式サイトにアクセスするか、デスクトップアプリやモバイルアプリから直接チャットを開始します。
無料アカウントでも最新のLMMによる画像読み取りや分析機能を試すことができるほか、有料プランや法人向けプランでは、より高度な推論能力を持つモデルへのアクセスや、処理回数制限の緩和が提供されています。
なお、Claudeについて詳しく知りたい方は以下の記事も併せてご覧ください。
Llama
Llama(ラマ)は、Meta社が開発・提供するオープンソース指向のAIモデルシリーズです。初期のLlama 2やLlama 3はテキスト専用のLLMでしたが、マルチモーダルに対応したモデル(Llama 3.2 Visionなど)の登場以降、画像とテキストを同時に理解・処理できるLMMへと進化を遂げました。
GoogleやOpenAIなどの商用API型モデルとは異なり、モデルデータが公開されている点が大きな特徴であり、自社サーバーやオンプレミス環境・ローカルPC上で安全にマルチモーダルAIを運用したい企業を中心に活用されています。
Llamaのマルチモーダル機能では、主に以下のような処理が可能です。
| 機能 | 内容 |
|---|---|
| 画像や図表の解析・データ抽出 | グラフや図面、写真などの視覚データを入力し、その内容に関する質問への回答や要約、データ化をローカル環境で完結して実行可能。 |
| 視覚情報と言語情報の同時処理 | 画像とテキストプロンプトを組み合わせてインプットし、高精度な文脈理解に基づいたアウトプットを得ることが可能。 |
| オンプレミスや自社環境でのカスタム構築 | 外部のクラウドサービスに機密画像やデータを送信することなく、自社独自のデータでファインチューニングを行い、独自のマルチモーダルシステムを構築できる。 |
Llamaシリーズは、Metaの公式サイトやHugging Faceなどからオープンウェイトをダウンロードして自社インフラに構築できるほか、主要なクラウドプラットフォームのマネージドサービス経由でも手軽に利用可能です。
【検証】同じ画像を主要LMMに読ませて比較してみた
LMMの視覚認識能力はどれほど実用的なのでしょうか。今回は、無料で利用できる代表的なAI(ChatGPT・Gemini・Claude)に対し、全く同じ画像と指示を入力して精度の違いや特徴を検証しました。
検証方法と準備した画像データ
以下の4パターンのテスト画像とプロンプトを用意し、各AIに入力しました。
| テスト画像 | プロンプト |
|---|---|
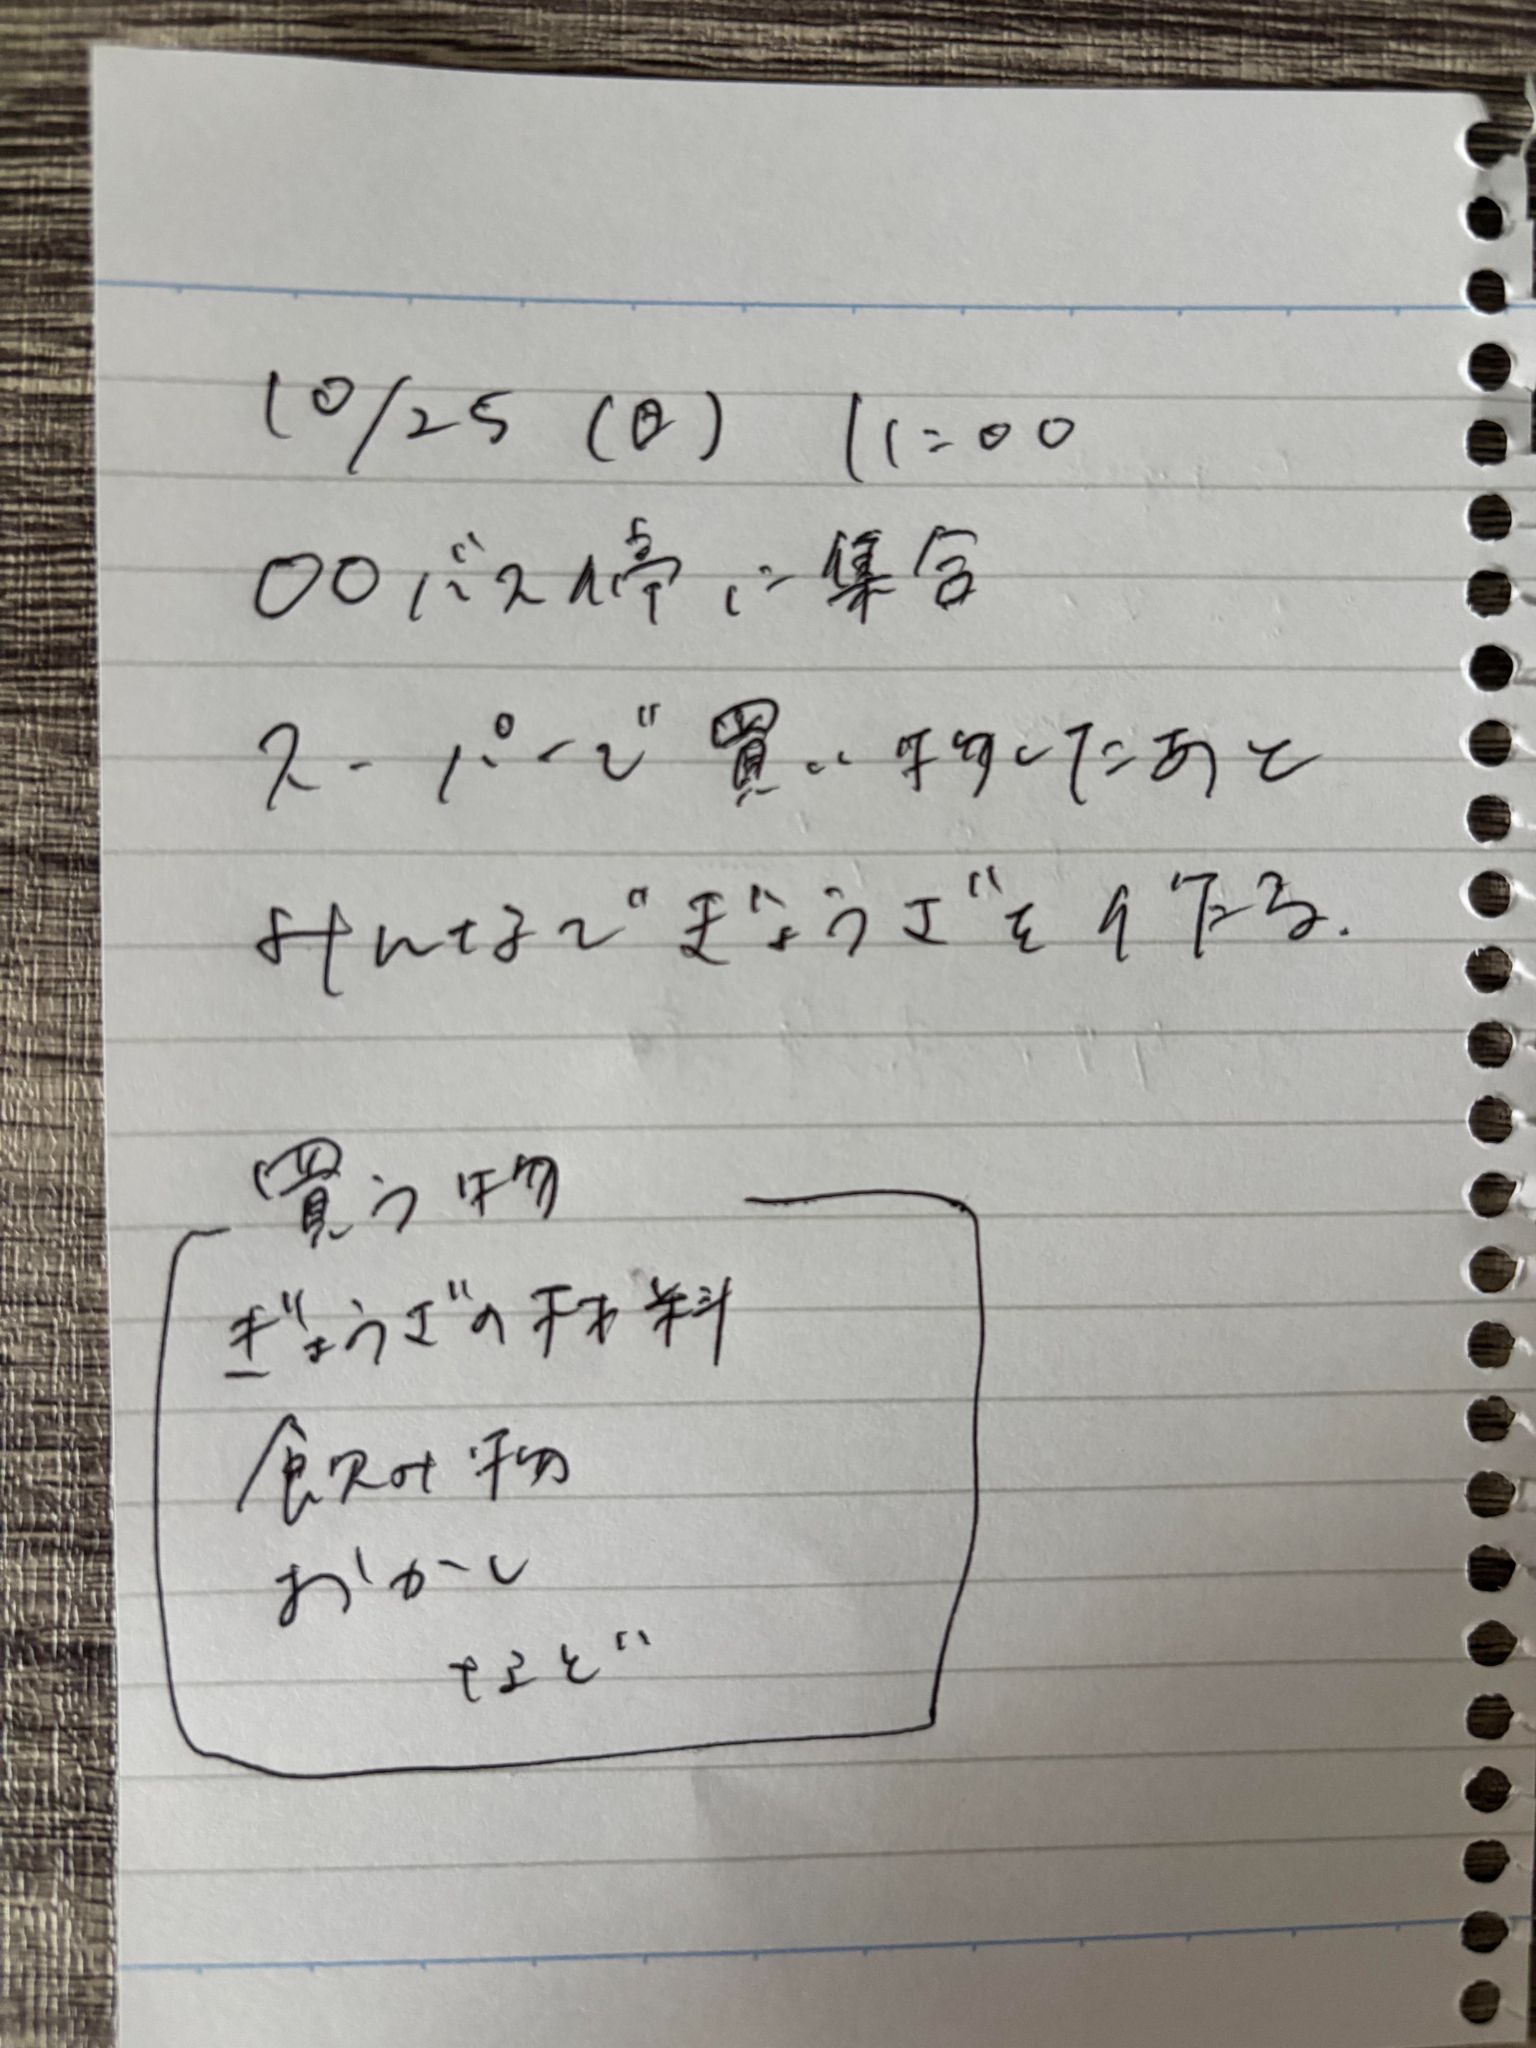
| ①手書きメモの写真 | この画像に書かれている文字や数字をすべて書き出してください。 |
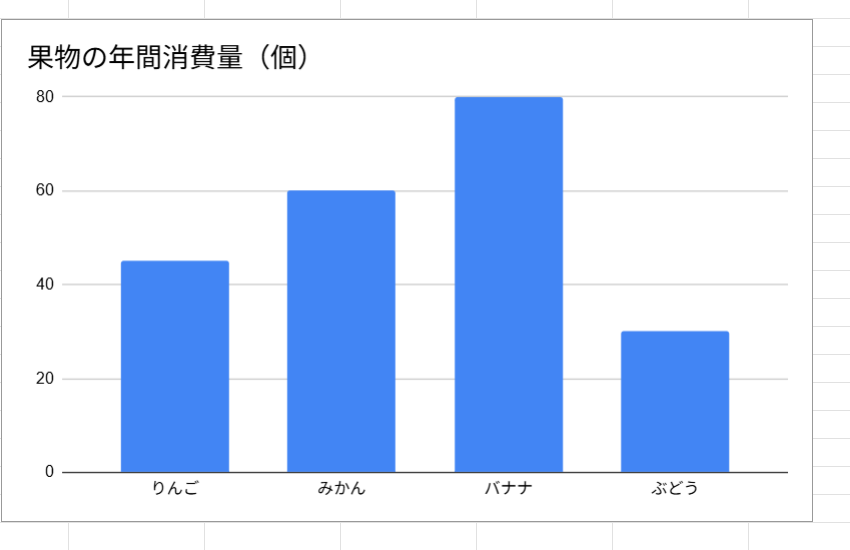
| ②棒グラフ・表 | このグラフから読み取れる数値と傾向を教えてください。 |
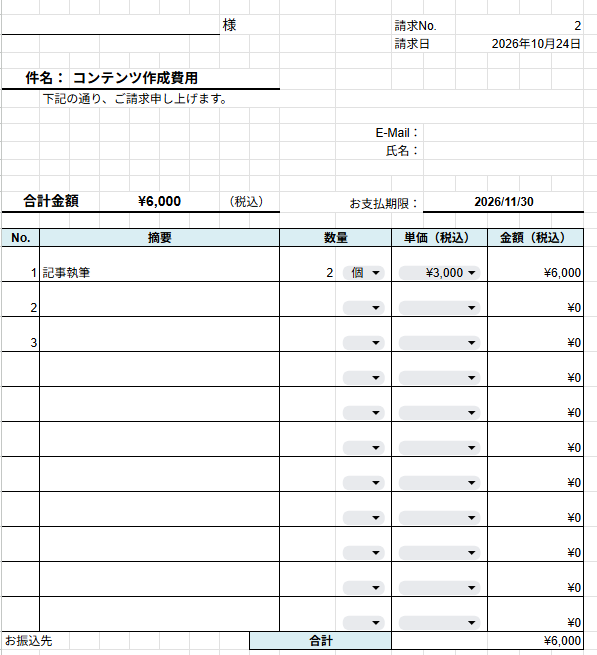
| ③架空の請求書 | この画像に書かれている文字や数字をすべて書き出してください。 |
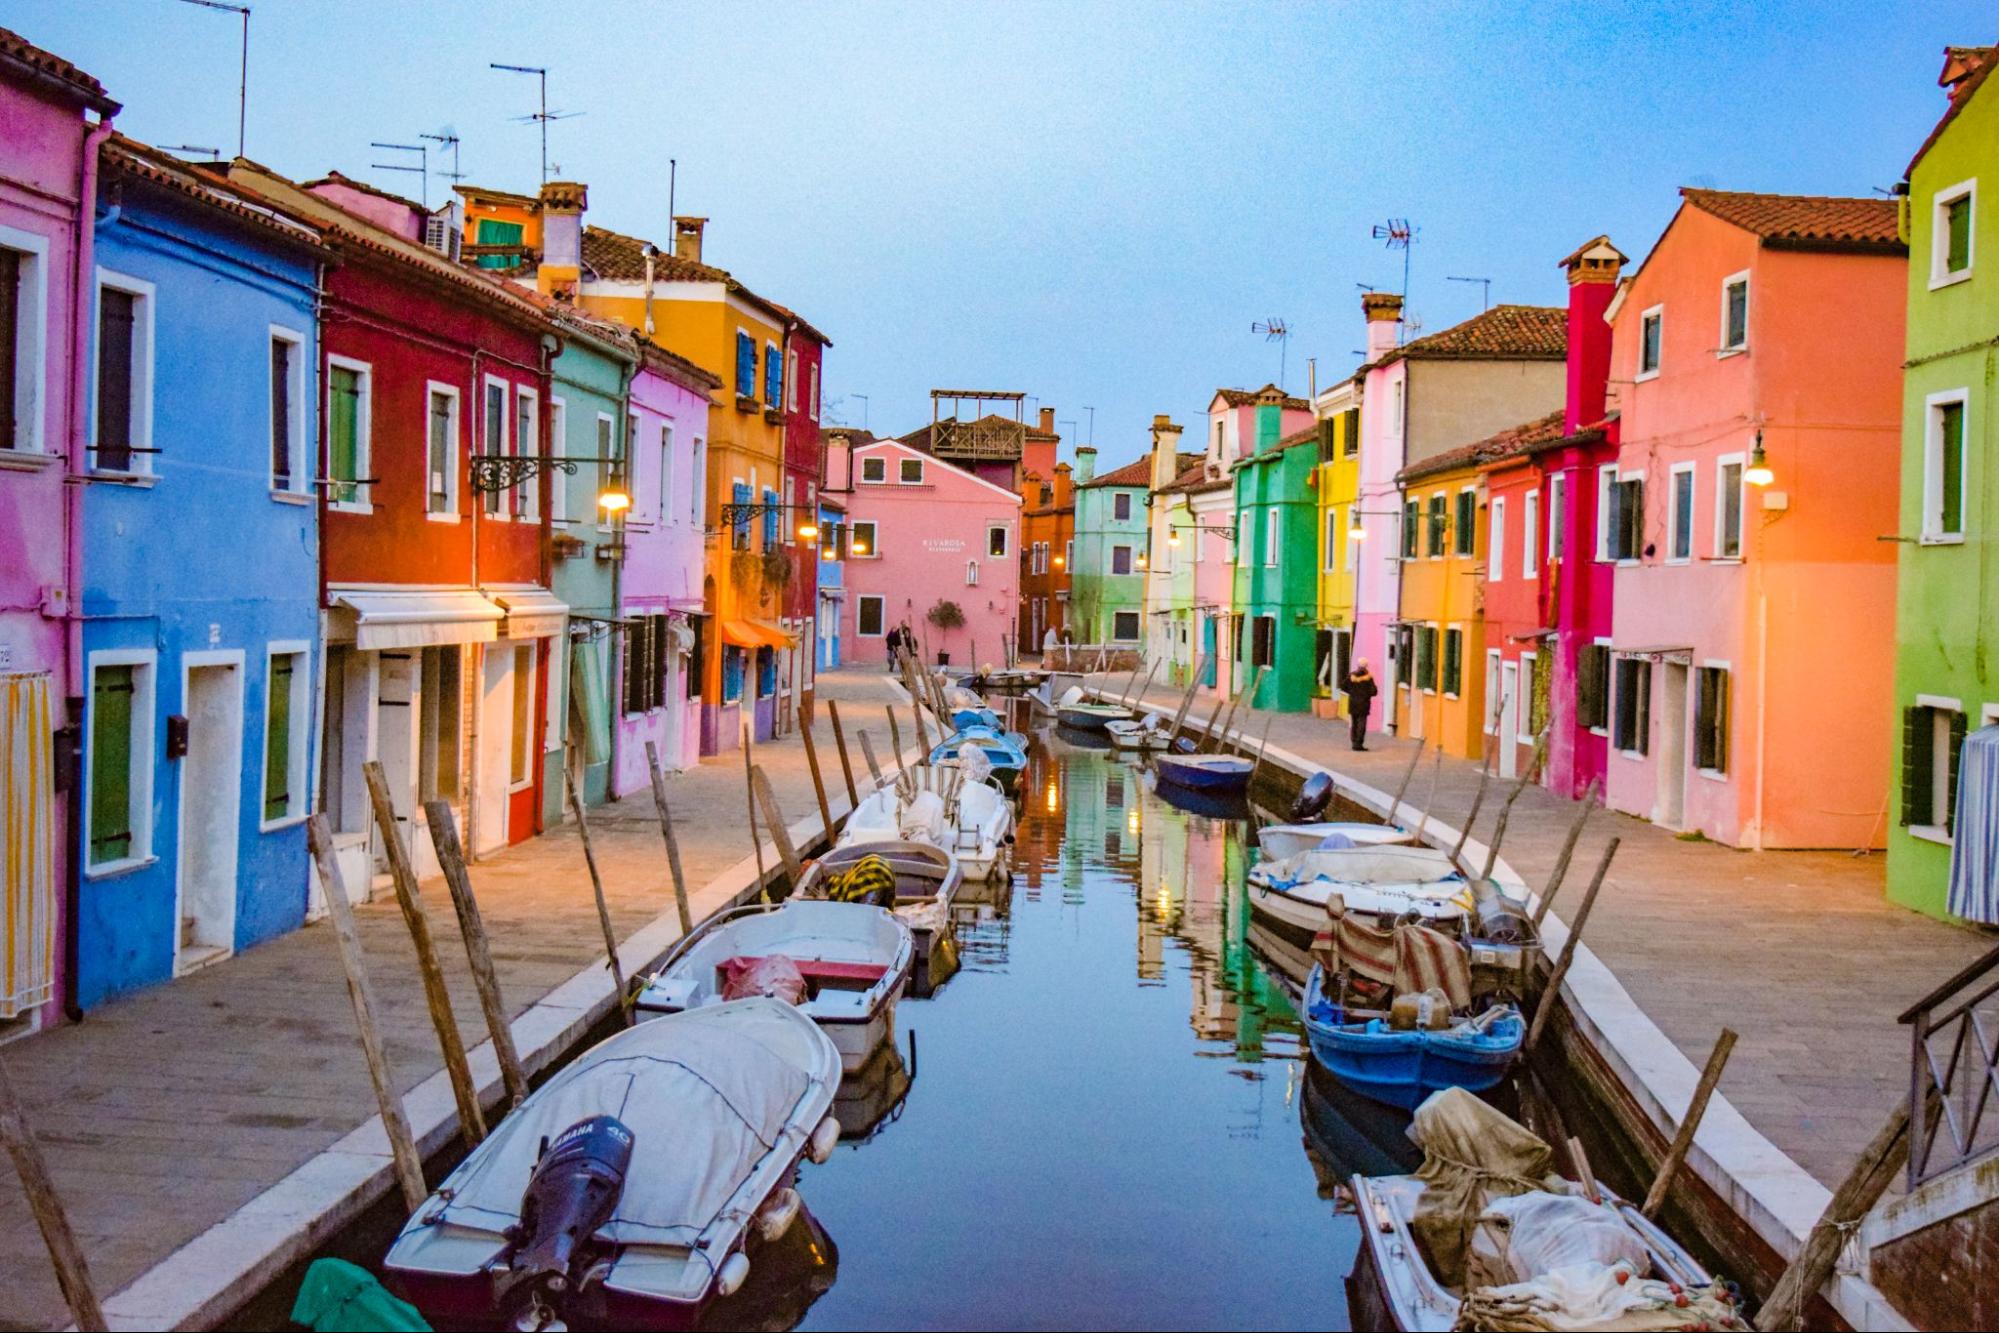
| ④街の写真 | この写真に写っているものを説明してください。 |
①手書きメモの写真
②棒グラフ・表
③架空の請求書
④街の写真
ChatGPT
まずはChatGPTです。①の検証は以下のようになりました。
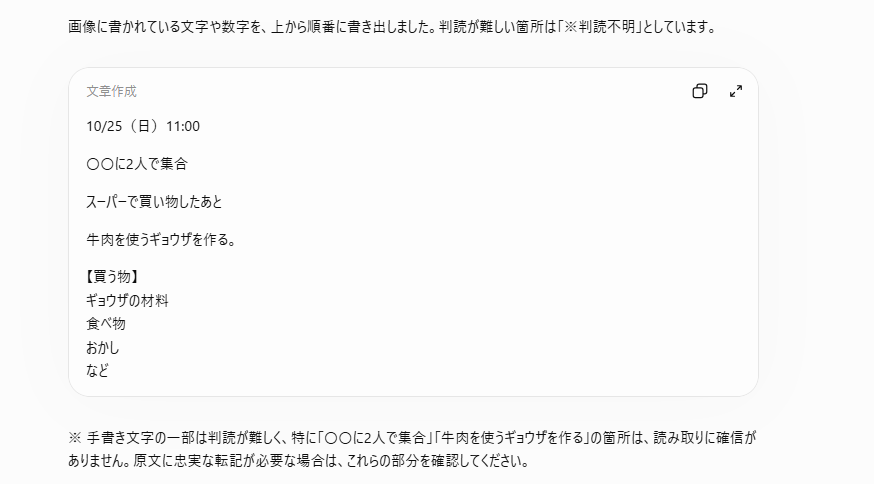
だいたいは判別できているようですが、「2人で集合」とはメモに書いていないため、推測していることがわかります。
次は②です。
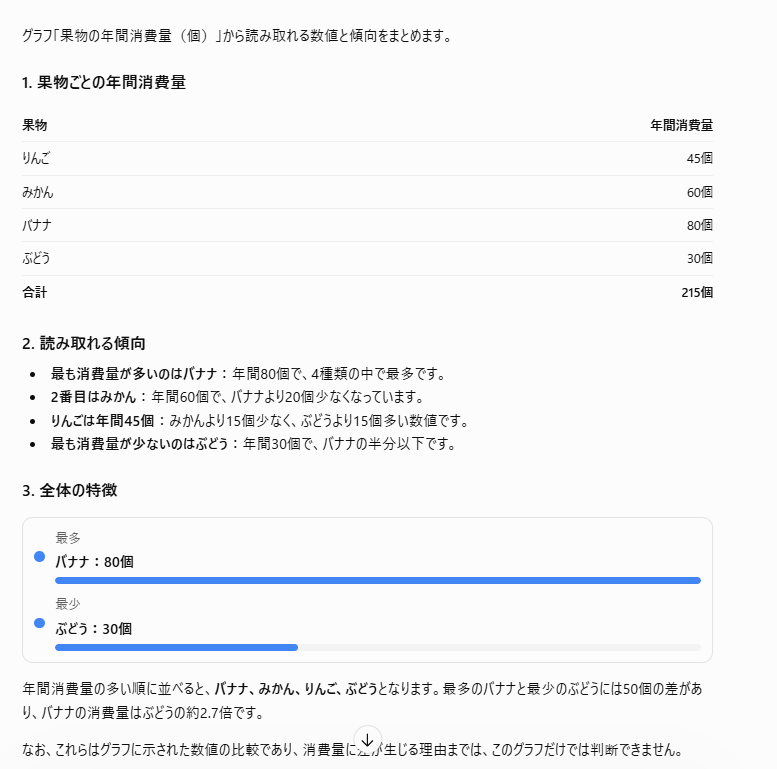
①と比べて正確性が上がっています。読み取れる傾向や特徴などを正しく押さえていることがわかります。
次は③です。
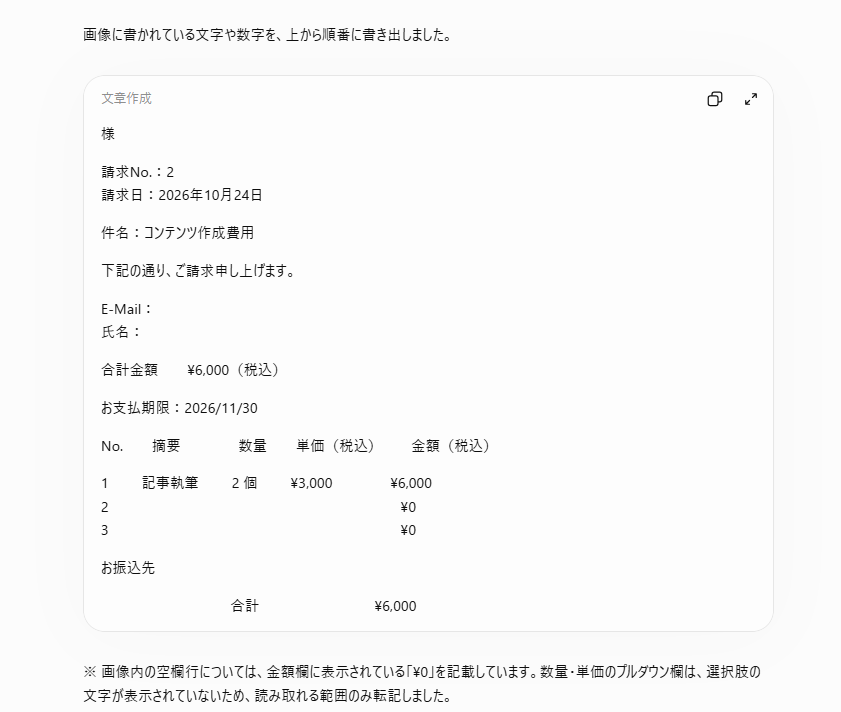
請求書の左上から順に書き出されています。本来の請求書とはレイアウトが少し変わっています。
最後に④です。
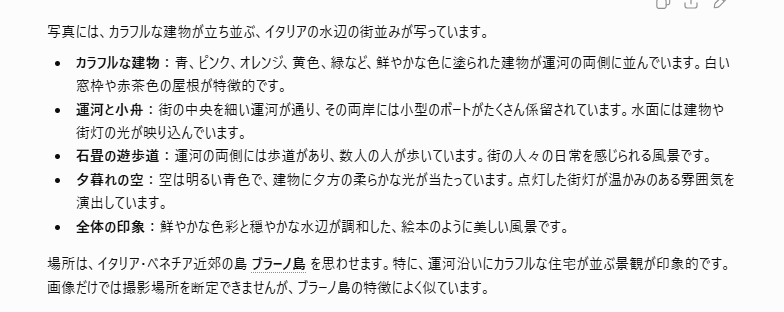
背景や細部の建物まで認識し、どういう状況かを書き出せています。
Claude
次はClaudeでの検証です。①は以下のようになりました。
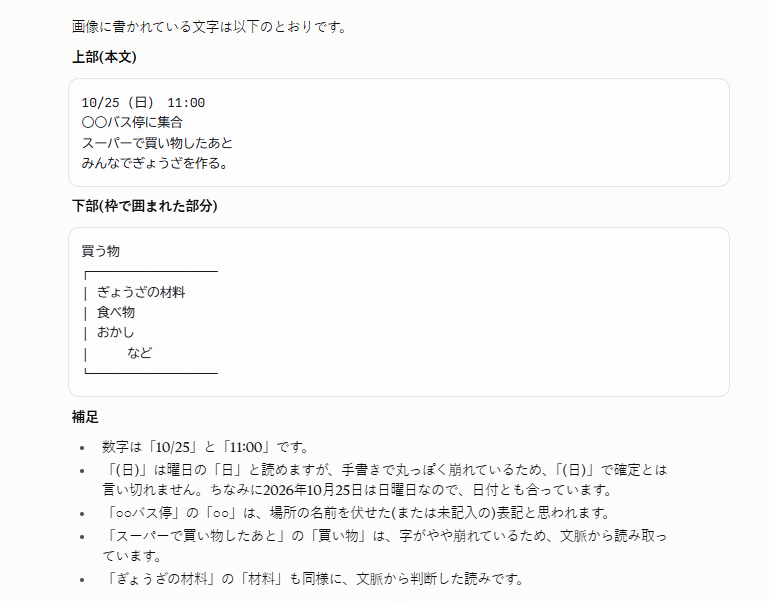
ChatGPTより正確に読み取れていると感じました。記載内容を比較的正確に読み取っており、一部では文脈を補った回答も見られました。
次は②です。
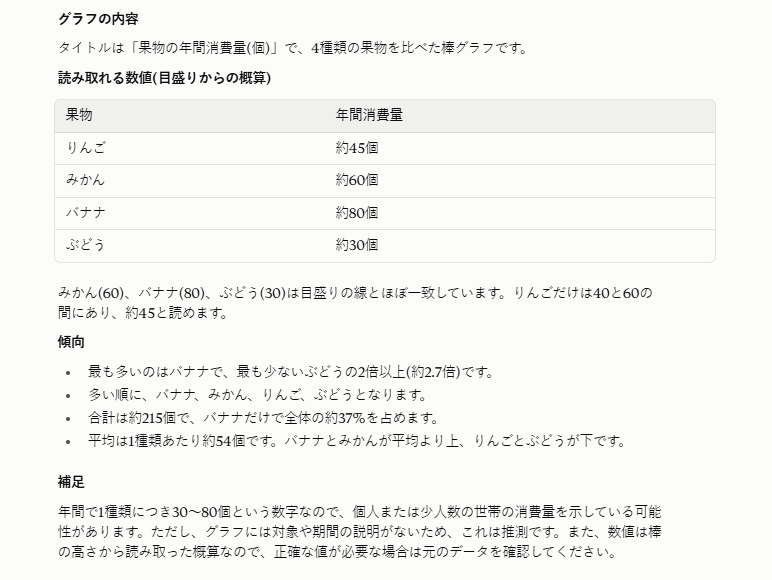
こちらも正しく読み取れています。ChatGPTと比べると、個数に「約」がついている点が違いです。グラフの数値がざっくりしていたためこのような判断にしたと思います。
次は③です。
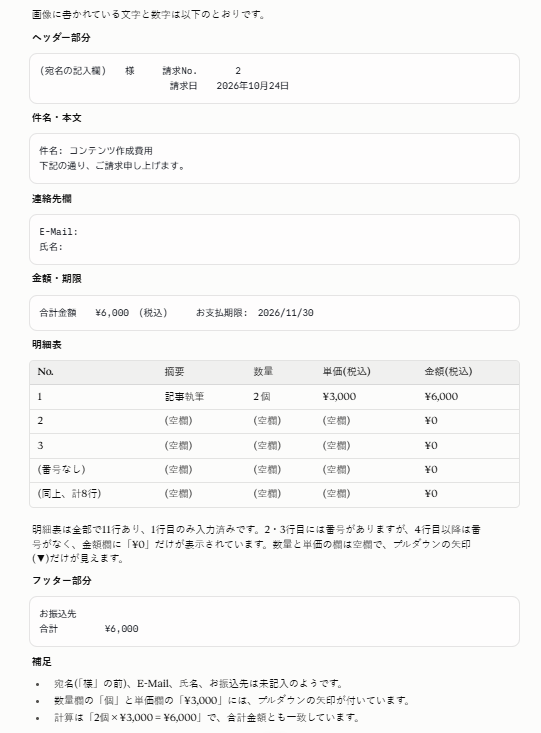
ChatGPTより細かく書き出せています。「明細表は全部で11行あり、1行目のみ入力済みです。」など、どこに何が書いてあるかを認識できていると感じました。
最後は④です。
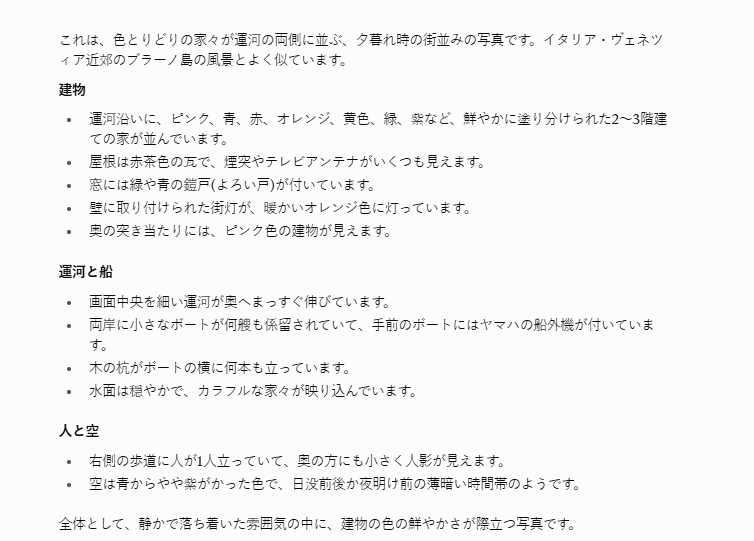
カテゴリごとに詳細に書き出しており、ChatGPTより多くのことを認識できていました。
Gemini
最後はGeminiでの検証です。①は以下のようになりました。
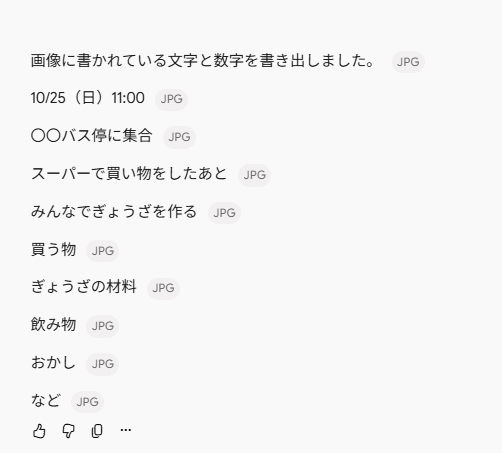
前の2つと比べると、文字の抽出が中心で、情報の整理や補足は比較的少ない回答でした。ただ、達筆だった文字も正確に認識しています。
次は②です。
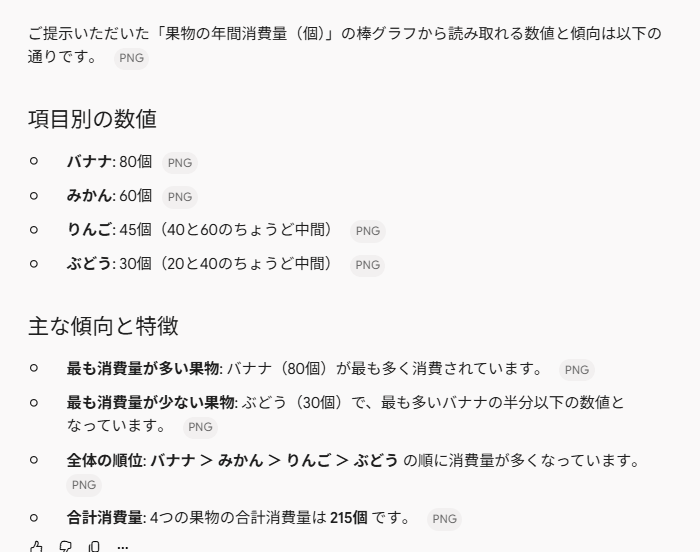
こちらも前2つと比べると情報が少ないように感じました。表から読み取れることだけを反映しています。
次は③です。
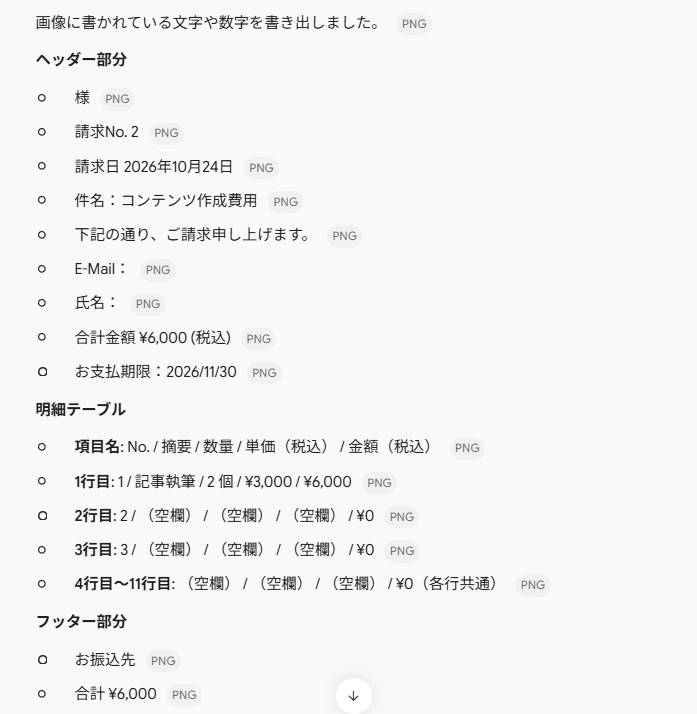
こちらも認識できることを項目ごとに整理して抽出しています。
最後に④です。
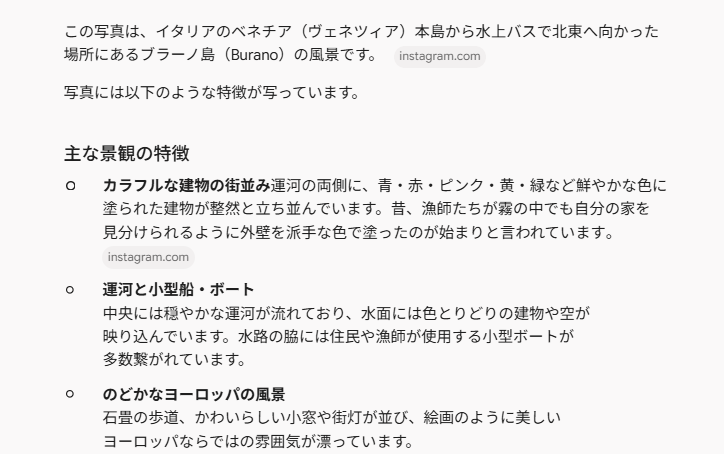
前2つと比べるとやはり情報量は少ないですが、背景や細部の物体まで認識できています。
以上、3つの生成AIで比べた結果でした。検証結果を簡単にすると以下のようになります。
| テスト画像 | ChatGPT | Claude | Gemini |
|---|---|---|---|
| ①手書きメモの写真 | ◯(ほぼ正確に解釈) | ◎(文脈を補正して解釈) | △(整理等をせず) |
| ②棒グラフ・表 | ◯(数値・傾向ともに正確) | ◎(傾向の考察まで極めて詳細) | ◯(数値・傾向ともに正確) |
| ③架空の請求書 | ◯(項目ごとに整理して抽出) | ◎(表組みで綺麗に構造化) | ◯(項目ごとに整理して抽出) |
| ④街の写真 | ◯(主要オブジェクトを認識) | ◎(背景や細部の物体まで認識) | ◯(主要オブジェクトを認識) |
検証の結果、各AIとも表やグラフなどの視覚データの読み取り精度は優秀ですが、特性の違いや弱点も見られました。
LMMの業務での活用例
LMMは、これまで人間が目や耳で確認して手入力していた業務を高度に自動化できるため、幅広い業界で導入が進んでいます。ここでは、実際の業務現場で効果を発揮している代表的な活用例を紹介します。
図面・設計書の読み取り
LMMは、高度な専門知識が必要な設計図面や仕様書の自動読み取りにも活用されています。例えばリコーでは、製造現場の図面からこれまで難しかった公差(許容される寸法の誤差)などの細かい表記まで認識・抽出できるLMMの基本モデルを発表しています。※1
このような技術により、図面確認の属人化を防ぎ、見積もり作成や設計審査などのバックオフィス業務を大幅に効率化することが可能です。
請求書・帳票の読み取りと入力作業の自動化
請求書や領収書、注文書などの紙書類やPDFデータを、LMMを用いて高精度に自動認識・データ化する取り組みが定着しています。レイアウトやフォーマットが企業ごとに異なる非定型な書類であっても、項目名や記載位置をAIが柔軟に解釈して必要な項目(請求金額、発行日、取引先名など)を抽出できる点が特徴です。
システムへの手入力作業やチェックの工数が大きく削減され、入力ミスの防止にも貢献します。
写真からの情報判別
現地で撮影した写真データから必要な状況を自動で判別する用途でもLMMが活躍しています。例えば、屋外の看板やインフラ設備、工場内の機械をスマートフォン等で撮影し、傷・ひび割れなどの劣化状況や異常の有無をAIに判定させるといった活用です。
現地作業員が高度な専門スキルを持っていなくても一次判断を高速に行えるほか、点検報告書の作成までを自動化することで、保全業務の省力化を実現します。
会議や電話の音声の文字起こし・要約
オンライン会議の録音データやコールセンターにおける通話音声を、リアルタイムあるいは事後に自動で文字起こしし、要約まで完結させることができます。単に言葉を書き起こすだけでなく、文脈を考慮して「誰が・何を・いつまでに対応するか」といったタスクや決定事項を自動で整理・抽出してくれます。
会議後の議事録作成時間が大幅に削減され、社内での迅速な情報共有が可能になるでしょう。
実際に弊社(WEEL)にも、以下のようなLMM活用に関するご相談や開発のご依頼が数多く寄せられています。
- 設計図面をAIに読み込ませ、見積もり作成業務を自動化したい
- 現地で撮影した写真から、看板の文字などの情報を正確に判別・データ化したい
- 顧客との通話音声を自動で文字起こしし、自社のデータベースに直接連携させたい
LMMを使うときの注意点
LMMは画像や音声などを扱える非常に便利な技術ですが、実務や日常で運用する際にはいくつか注意すべきポイントがあります。適切な成果を得るためにも、以下の点に留意して活用しましょう。
画像の読み間違い(視覚のハルシネーション)
LMMは入力された画像の内容を高い精度で認識しますが、時には存在しない要素を「ある」と認識したり、まったく異なる物体として読み間違えたりする現象(視覚的ハルシネーション)が発生することがあります。
個人情報・機密情報を含む画像の扱い
顔写真や名刺、顧客情報・社外秘の数値が記載された書類・画面のスクリーンショットなどをLMMに入力する際は、セキュリティ面に配慮が必要です。一般的なAIサービスの標準設定では、送信した画像データがモデルの再学習やサービス改善に利用される可能性があるため、情報の漏洩やプライバシー侵害につながるリスクがあります。
画質が悪い画像や複雑な図面では精度が落ちる
解像度が低い写真、手ブレや光の反射がある画像、あるいは線や記号が細かく入り組んだ建築図面や回路図などは、LMMであっても正しく解釈できない場合があります。文字が小さすぎたりノイズが多すぎたりすると、AIが誤認識を起こしやすくなり、期待する分析結果が得られません。
精度を高く維持するためには、できるだけ鮮明で明るい高解像度の画像を用意する、読み取りたい箇所を切り抜いてアップロードするなどの工夫を行うことが推奨されます。
生成AI開発・業務活用ならWEELへご相談ください
LMMの進化に触れ、次世代のAI技術がもたらすビジネスチャンスを活用する準備を始めましょう。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
LMMのよくある質問