小規模言語モデル(SLM)とは?LLMとの違いや代表モデルを初心者でも分かりやすく解説
- SLMとは、LLMよりもパラメータ数を抑えた小規模言語モデルで、低コスト・高速な処理・ローカル環境での利用などが期待できる
- SLMは、用途に合ったモデルを選ぶことで、機密データを扱う業務やリアルタイム性が求められる業務にも活用できる
- SLMとLLMの違いや代表的なモデル、活用シーンを理解し、両者を組み合わせるハイブリッド設計によってコストと精度の両立を目指せる
SLM(小規模言語モデル)とは、LLM(大規模言語モデル)に比べてパラメータ数が少なく、計算リソースを抑えて動作させやすい言語モデルです。生成AIの社内活用で課題になりやすいコスト・機密データ・応答速度への対応策として、特定の業務に適したSLMを活用する方法が注目されています。
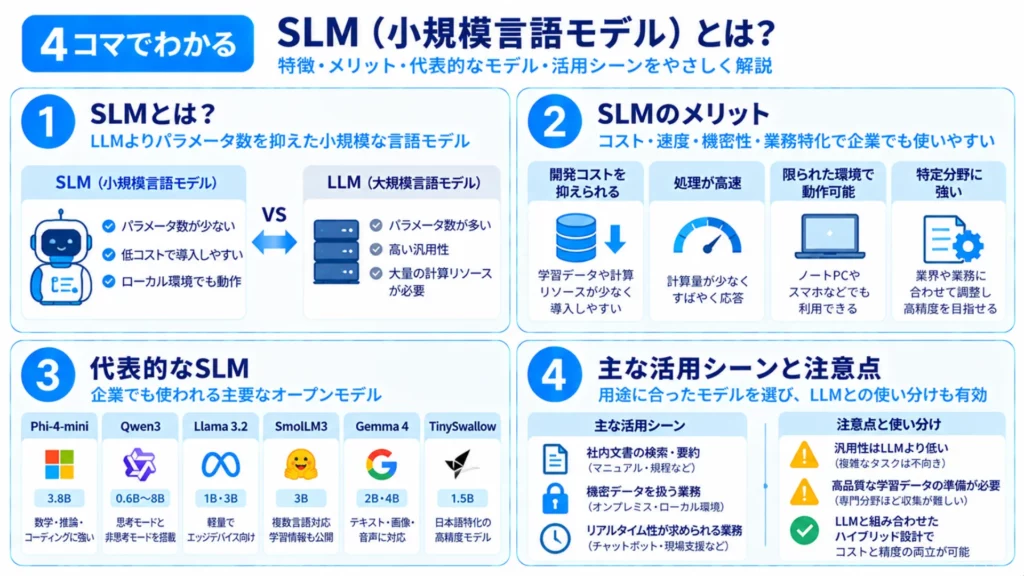
本記事では、SLMの仕組みやLLMとの違い、活用シーン・選び方に加え、SLMとLLMを組み合わせるハイブリッド設計も解説します。
\生成AIを活用して業務プロセスを自動化/
小規模言語モデル(SLM)とは?
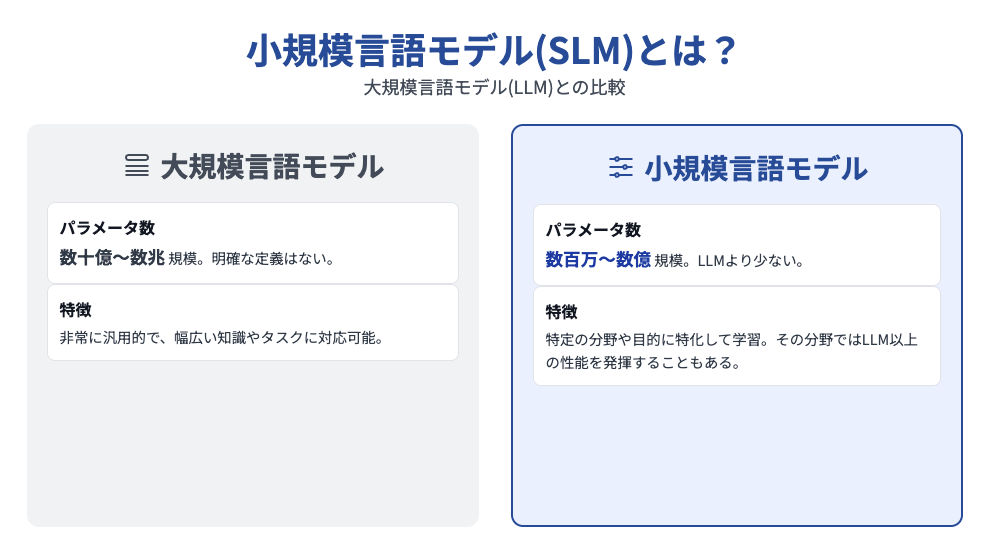
小規模言語モデル(Small Language Model)とは、名前の通りChatGPTやClaudeのような大規模言語モデル(Large Language Model)に比べて、少ないパラメータ数で構成されているモデルのことを指します。
SLMとLLMを区分する明確な基準は統一されていませんが、一般的な目安として、SLMは数十億(100億以下程度)、LLMは数百億〜数兆のパラメータ数を持つモデルを指すことが多いです。
小規模言語モデルは、大規模言語モデルと比べると汎用性が限定される場合がありますが、PhiやGemmaのように幅広い用途に対応するモデルもあります。特定の分野向けに追加学習などで調整すると、その分野のタスクで高い性能を発揮できる場合がある点も特徴でしょう。
小規模言語モデル(SLM)のしくみ
小規模言語モデル(SLM)は、トレーニングに用いる「データセットの質」を重視した言語モデルです。データセットの質を上げて量を減らすことで、処理精度を保ちながらパラメータ数の削減を実現しています。
この効果を示した論文として、小規模言語モデル「phi-1」と従来のLLMのデータ処理精度を比較した「Textbooks Are All You Need」というものがあります。この論文では、コーディングテストでのスコアを比較していて、その結果は以下のとおりです。
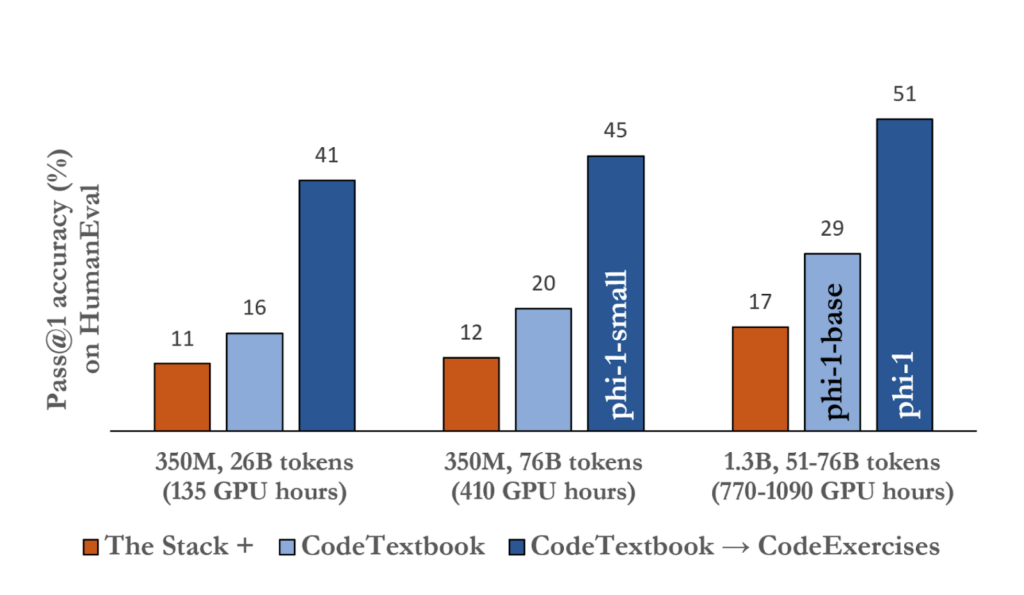
phi-1と従来のLLMを比較すると、phi-1のパラメータ数は13億(1.3B)と比較的小さいにもかかわらず、コーディングテストの精度はむしろ優れているという結果になっています。
さらに、phi-1の学習に使われたデータは約70億トークン(7B)と少なく、トレーニングに要した期間はわずか4日間でした。
このように、高品質な学習データや効率的な学習手法を活用することで、小規模なモデルでも高い性能を目指せます。
そのほかにも、教師となる大規模モデルの知識を小規模モデルに引き継ぐ「知識蒸留」や、モデルの数値表現を低ビット化してメモリ使用量を削減する「量子化」といったモデルを小型化するための手法があります。
言語モデルは、学習データの質を高めるだけでなく、知識蒸留や量子化などの手法を活用することで、モデルの規模や計算リソースを抑えながら用途に応じた性能を目指せるのです。
なお、大規模言語モデルについて詳しく知りたい方は、下記の記事を合わせてご確認ください。
小規模言語モデル(SLM)が注目される背景
小規模言語モデルはその導入しやすさとコストパフォーマンスにより、企業からの注目を集めています。
ChatGPTの登場以降、国内外の企業では、LLMの導入・業務利用が推し進められてきました。
しかし、NTTデータも2026年7月の技術解説で、業務内容・必要な精度・処理コスト・セキュリティ要件などを踏まえて用途に応じてモデルを選定する重要性を指摘しています。
LLMの導入・運用には、次のような課題が指摘されています。(※1)
- 導入コスト(GPU等)が高騰しており、場合によっては数億〜十数億円単位となる
- AIモデルをクラウド上で稼働させるため、データのプライバシーを確保できない
- 用途に対してオーバースペックとなる
そこでLLMに代わって脚光を浴びているのが、パラメータ数の少ないSLMです。推論コストを抑えやすく、ローカル環境でも運用しやすいことから、機密情報を扱う業務や通信環境に制約がある場面での活用が期待されています。
- オープンソースのモデルも多く省メモリ性が高いため、導入・学習・運用のコストが抑えられる
- ノートPC等のローカル環境上で稼働させられるため、機密性が高い
- 業界特化のデータセットで学習させることで、必要十分なスペックを確保できる
GoogleやMicrosoftのような生成AI開発の大手も、次々とSLMをリリースしており、SLMの開発・活用も広がっています。
小規模言語モデル(SLM)と大規模言語モデル(LLM)の違い
ここでは、小規模言語モデルと大規模言語モデルについて、両者の違いと、それぞれに適した活用シーンを表形式で見ていきましょう。
違いの比較
小規模言語モデルと大規模言語モデルの違いは、パラメータ規模や動作環境に大きく表れます。表にまとめると以下のとおりです。
| 小規模言語モデル(SLM) | 大規模言語モデル(LLM) | |
|---|---|---|
| パラメータ規模 | 数百万〜数十億(目安として10B以下) | 数百億〜数兆 |
| 学習データ | 専門領域に特化 | 理数から人文、日常会話まで網羅 |
| 処理速度 | 高 | 低(加えてクラウド化によるタイムラグも) |
| 汎用性 | 低 | 高 |
| 開発に要する費用・時間 | 小 | 極大 |
| 動作環境の目安 | スマートフォン・ノートPCなど | GPUサーバー・クラウドなど |
| 稼働に必要なハードウェア | ノートPC(GPU1基) | 大規模なデータセンター(GPU数千基) |
LLMに比べ、SLMはスペックが限定される代わりに、ソフト面でもハード面でも導入しやすい点が魅力です。
使い分け早見表
小規模言語モデルと大規模言語モデルは、得意な用途が異なります。それぞれに適した活用シーンは以下のとおりです。
| 用途 | 小規模言語モデル(SLM) | 大規模言語モデル(LLM) |
|---|---|---|
| 長文の生成 | ❌ | ⭕️ |
| 文書の要約 | ⭕️ | ⭕️ |
| コーディング支援 | ❌ | ⭕️ |
| オンプレミスシステムとの統合 | ⭕️ | ❌ |
| 保険・金融・医療業界での活用 | ⭕️ | ❌ |
| 社内向けチャットボット | ⭕️ | ⭕️ |
| 顧客向けチャットボット | ❌ | ⭕️ |
| リアルタイムでの応答 | ⭕️ | ❌ |
LLMほどの回答精度・品質はないものの、SLMは幅広いユースケースに適しているといえるでしょう。
小規模言語モデル(SLM)のメリット
ここからは、小規模言語モデルの主なメリットを紹介します。
開発コストを抑えられる
小規模言語モデルは大規模言語モデルに比べて、サイズが小さいため必要な学習データの量や計算リソースも限られた量だけでいいので、開発期間が短くなることが多いです。
生成AIの開発を外注する場合は、人件費や開発期間によって料金が前後するため、アサインする人数や開発期間が短い小規模言語モデルは大規模言語モデルに比べて開発コストを抑えることができます。
反応速度が速い
小規模言語モデルは、大規模言語モデルに比べてパラメータ数が少ないため、回答を生成する際の計算量を抑えやすく、応答速度を高めやすいのが特徴です。
そのため、待ち時間を減らし業務効率をあげることができるため、汎用性の高い大規模言語モデルではなく、業務に特化し反応速度の速い小規模言語モデルが重宝される場面も多くあります。
限られたリソースで動作可能
大規模言語モデル(LLM)に比べて、小規模言語モデル(SLM)はパラメータ数が少なく、計算リソースを抑えて動作させやすいため、幅広いデバイスで利用できる可能性があります。
例えば、Microsoftの「Phi-4-mini-instruct」は38億(3.8B)パラメータのモデルで、実行環境や量子化方式によっては、メモリ8GBのMacで動作する可能性があるでしょう。また、Apple Intelligenceでは、スマートフォンなどの端末上で処理を行う小規模なAIモデルも活用されています。
このように、小規模言語モデルは大規模な計算リソースを確保しにくい環境でも、PCやスマートフォンなどでの活用が期待できるのです。
ただし、実際の動作や応答速度は、端末の性能・メモリ容量・モデルの量子化方式などによって異なります。
特定分野に合わせて回答を制御しやすい
小規模言語モデルは、パラメータ数が少ない分、汎用的な知識や複雑なタスクへの対応力が大規模言語モデルに及ばない場合があります。汎用の小規模言語モデルをそのまま利用すると、誤った回答を生成する可能性もあるでしょう。
しかし、特定分野のデータで追加学習や調整を行ったり、RAG(検索拡張生成)と組み合わせたりすることで回答に必要な情報を補い、出力を制御しやすくなります。
このように、小規模言語モデルは単体であらゆる質問に対応させるのではなく、利用目的や対象分野に合わせて調整することで、業務に適したモデルとして活用できます。
ただし、追加学習やRAGを導入しても誤った回答を完全に防げるわけではないため、回答の検証や運用ルールの整備も重要です。
ファインチューニングが容易
ファインチューニングとは、簡単に説明すると回答精度を高めたり目的に沿ったモデルにするために、学習済みのモデルの一部や全てを再学習させる手法のことです。
大規模言語モデルをファインチューニングしようとする場合、パラメータ数が膨大なため、再学習に必要な計算リソースや時間が大きくなり、手間がかかってしまいます。
しかし、小規模言語モデルはパラメータ数が少ないため、再学習に必要な計算リソースや時間を抑えやすい点もメリットと言えるでしょう。
小規模言語モデル(SLM)のデメリット
一方で、小規模言語モデルには汎用性やデータ収集の面でのデメリットもあります。次に、小規模言語モデルのデメリットについてみてみましょう。
汎用性が低い
小規模言語モデルは、特定の分野や目的に合わせて調整すると、その分野の専門的なタスクで高い性能を発揮できる場合があります。しかし、幅広い一般知識の質問や、長い文章の複雑な推論を必要とするタスクでは、十分な回答を生成できないことがあります。
このように、小規模言語モデルは特定の用途では強みを発揮するものの、大規模言語モデルのように幅広いタスクに対応できるとは限りません。
そのため、小規模言語モデルを導入する際は、利用目的や必要な性能を明確にすることが重要です。
データ収集が難しい
小規模言語モデルを特定の分野向けに調整して活用するには、その分野の正確な専門データを集める必要があります。
特に、専門性の高い法律や医療の分野では、データ収集や学習を行う際にも専門的な知識が必要です。そのため、データ収集の難しさはデメリットといえるでしょう。
代表的な小規模言語モデル(SLM)
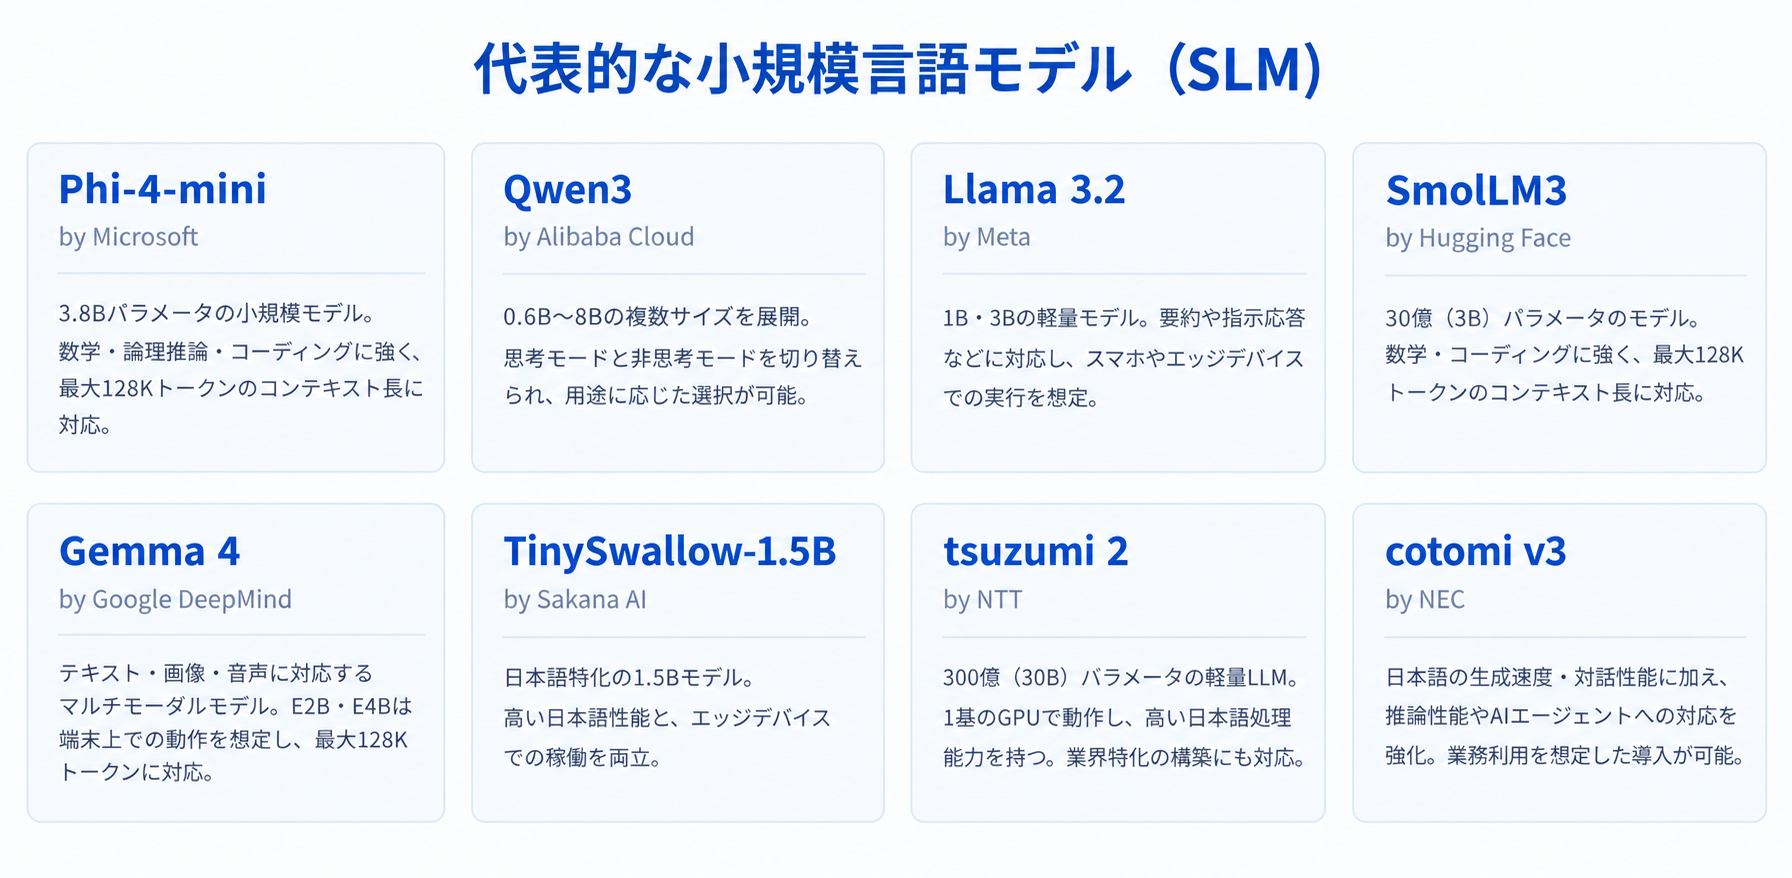
冒頭でもご紹介した通り、小規模言語モデルと大規模言語モデルの明確な定義はありませんが、一般に小規模言語モデルと区分されるモデルは数多くあります。
今回は、その中でも代表的な小規模言語モデルを8つご紹介します。
Phi-4-mini
Microsoftが開発したPhi-4-mini-instructは、38億(3.8B)パラメータの小規模言語モデルです。小規模ながら数学や論理的な推論、コーディングなどのタスクに強みを持っているのが特徴です。
また、最大128Kトークンのコンテキスト長に対応しており、長い文章を扱うタスクにも活用できるため、計算リソースを抑えながら推論能力が求められる用途に活用できます。
Qwen3
Alibaba CloudのQwenチームが開発したQwen3は、0.6B〜8Bを含む複数のサイズを展開するモデルシリーズです。
特徴は、複雑な推論や数学、コーディングなどに適した思考モードと、効率的な応答を重視する非思考モードを切り替えられる点です。そのため、用途に応じてモデルのサイズや動作モードを選択できます。
Llama 3.2
Metaが開発したLlama 3.2には、1Bと3Bの軽量なテキストモデルが展開されています。
要約や指示への応答、文章の書き換えなどに対応し、スマートフォンやエッジデバイス上での実行を想定して設計されているのが特徴です。
また、最大128Kトークンのコンテキスト長に対応しており、長い文章を扱う用途にも活用できます。
SmolLM3
Hugging Faceが公開した「SmolLM3」は、30億(3B)パラメータの言語モデルで、推論を支援する機能を備え、数学やコーディングなどのデータを用いて学習されています。
また、複数言語に対応し、標準で最大65,536トークン、YaRNによる拡張で最大128Kトークンのコンテキストを扱えます。モデルの重みだけでなく学習に関する情報も公開されている点が特徴です。
Gemma 4
Google DeepMindが開発したGemma 4は、テキストや画像、音声などを扱えるオープンモデルです。
小型のE2B・E4Bは、端末上での動作を想定して設計されており、E2Bは実効パラメータ数約20億、E4Bは約40億です。
最大128Kトークンのコンテキスト長に対応し、文章の生成だけでなく、画像の理解や音声処理、推論などにも活用できます。
スマートフォンやノートPCなど、計算リソースに制約のある環境でのAI活用を目指せるモデルです。
TinySwallow-1.5B
「TinySwallow-1.5B」は、日本に本社を構える生成AIスタートアップのSakana AIが開発した、日本語特化の小規模言語モデルです。こちらは段階的に知識を蒸留する新手法「TAID(Temporally Adaptive Interpolated Distillation)」を採用。同規模のモデルを上回る日本語性能と、iPhoneなどのエッジデバイス上での稼働を両立しています。(※2)
tsuzumi2
NTTが開発した「tsuzumi 2」は、300億(30B)パラメータを持つ軽量な大規模言語モデルです。2025年10月に提供が開始され、1基のGPUで動作する軽量設計と高い日本語処理能力を特徴としています。
金融・医療・公共分野の知識を強化しており、RAGやファインチューニングによって、企業や業界に特化したAIの構築にも活用できます。
オンプレミスやプライベートクラウドでの運用にも対応し、コストとセキュリティの両立を目指せるモデルです。
cotomi
NECが開発する生成AI「cotomi」は、2026年3月に「cotomi v3」がガバメントAIの試用対象として選定されました。日本語の生成速度や対話性能に加え、推論性能やAIエージェントへの対応を強化している点が特徴です。
また、軽量・高速なモデル設計により、業務利用を想定した生成AIの導入が可能です。
NECは2024年の発表で、当時のcotomiが日本語ベンチマークにおいてGPT-4などに匹敵する精度を達成したことも公表しています。
小規模言語モデル(SLM)の活用シーン
小規模言語モデルは、端末上でAIを動作させたい場合や、機密情報を扱う業務、応答速度が求められる場面などでの活用が期待されています。特定の業務に適したモデルを選ぶことで、計算コストを抑えながら生成AIを業務に取り入れられる可能性があります。
次に、小規模言語モデルの代表的な活用シーンを4つ見ていきましょう。
スマホ・PC上で動くオンデバイスAI
小規模言語モデルは、スマートフォンやPCなどの端末上でAIを動作させる用途に適しています。
例えば、文章の要約や書き換え、音声の処理といった機能をクラウド上のAIサービスに毎回接続せずに利用することも可能です。
端末内で処理を完結できれば、通信環境に左右されにくくなりオフラインでも利用できたり、入力した情報を外部のAIサービスへ送信せずに済む構成も実現できます。実際に、GoogleのGemma 4 E2B・E4Bなど、モバイル端末での動作を想定したモデルも登場しています。
機密データを扱う社内業務(オンプレミス)
小規模言語モデルは、自社のサーバーなどでモデルを実行するオンプレミス環境にも活用できます。
例えば、社内規程の検索や文書の要約、問い合わせ対応などに利用すれば、社内データを外部のAIサービスに送信せずに処理するシステムを構築できます。
特に、機密情報や個人情報を扱う企業では、データの取り扱いを自社で管理できる点がメリットです。ただし、オンプレミス環境であれば自動的に安全になるわけではないため、アクセス制御やログ管理、モデルの運用ルールなども整備する必要があります。
医療・金融・製造の専門タスク
医療・金融・製造などの専門分野では、対象業務に合わせて調整した小規模言語モデルを活用することで、社内マニュアルに基づく問い合わせ対応や製品仕様書の検索、定型的な文書の分類などに役立ちます。
さらに、特定分野のデータを用いた追加学習や、RAG(検索拡張生成)による情報の補完を組み合わせれば、業務に必要な情報に基づいて回答を生成しやすくなります。
しかし、医療判断や金融上の重要な判断など、誤った場合の影響が大きい業務では、専門家による確認や十分な精度検証が必要でしょう。
コールセンターなどリアルタイムの応答
小規模言語モデルは、応答速度が重視される問い合わせ対応にも活用できます。
例えば、コールセンターでの問い合わせ内容の分類やオペレーターへの回答候補の提示、会話内容の要約など、リアルタイムでの情報処理に役立ちます。
また、よくある質問への回答など、対応範囲を限定した業務では小規模言語モデルを活用しやすいでしょう。
小規模言語モデル(SLM)の選び方
小規模言語モデルを選ぶ際は、パラメータ数の少なさだけでなく、利用する端末の性能・ライセンス・日本語性能などを総合的に確認することが重要です。小型のモデルでも、用途によっては十分な性能を発揮できますが、業務に必要な精度や処理速度を満たせるとは限りません。
ここでは、小規模言語モデルを選定する際に押さえておきたい4つのポイントを紹介します。
SLMを選ぶ際に確認したい4つのポイント
モデルの規模だけでなく、利用環境や業務内容、ライセンスなどを踏まえて選定することが重要です。
導入前に候補モデルを比較し、実際の業務に近い条件で性能や運用コストを検証しましょう。
| 確認項目 | 確認する内容 | 選定時のポイント |
|---|---|---|
| パラメータ数とメモリ | モデルのパラメータ数、量子化方式、推論時に必要なメモリ容量 | 利用するPCやサーバーのメモリ・計算性能で動作するか確認する |
| ライセンス | 商用利用の可否、利用条件、再配布や改変に関する制約 | 自社の利用目的や提供形態に合った条件か確認する |
| 日本語性能 | 日本語の理解・生成能力、専門用語への対応、指示への従いやすさ | 実際の業務で使う質問や文書を用いて精度を検証する |
| コンテキスト長 | 一度の処理で入力できるトークン数の上限 | 長い文書や複数の資料を扱う場合は、必要な入力長を満たすか確認する |
パラメータ数とメモリ
パラメータ数が少ないモデルほど、一般的にはメモリや計算リソースを抑えやすくなります。
しかし、実際に必要なメモリはモデルの構造・量子化方式・コンテキスト長などによって変わるため、利用予定の環境で動作を検証しましょう。
ライセンス
小規模言語モデルには、商用利用や改変が可能なモデルもあれば、独自の利用条件が定められたモデルもあります。
業務で利用する場合はモデルごとのライセンスを確認し、商用利用や再配布などの条件を満たしているか確認することが大切です。
日本語性能
モデルによって、日本語の自然さや指示への対応力、専門用語の理解度に違いがあります。
公開されているベンチマークの評価だけでなく、社内文書の要約や問い合わせ対応など、実際の業務を想定したテストを行い、必要な精度を満たすか確認しましょう。
コンテキスト長
コンテキスト長は、モデルが一度に扱える入力・出力などの情報量に関係する上限のことで、長いマニュアルや複数の資料を扱う場合は、十分なコンテキスト長を持つモデルが候補になります。
しかし、コンテキスト長が長いほど必ず回答精度が高くなるわけではないため、実際の文書を使った検証も必要です。
失敗しないSLM×LLMハイブリッド設計
小規模言語モデルは日進月歩で、すでに高速・低コストながらも単体でビジネスユースに耐えうる精度のものが登場しています。ただ、全体的な回答の質はLLMにもう一歩及ばない、というのが現状です。
そこでSLMを導入・活用するにあたっておすすめしたいのが、SLMとLLMを組み合わせて効率と精度を両立させるハイブリッド設計です。このハイブリッド設計には様々な手法がありますが、なかでも下表の方式は簡単に導入ができて恩恵も得られやすくなっています。
| SLMの役割 | LLMの役割 | 全体での効果 | |
|---|---|---|---|
| トークン単位のルーティング | 端末上で回答の大部分を高速・低コストで生成 | SLMだけでは精度が下がりやすい重要なトークンの生成のみを担当 | 生成トークンの7%未満をLLMに任せるだけで、CommonsenseQAの性能が60%向上(※3) |
| Collab-RAG | 複雑なクエリを単純なサブクエリに分解 | サブクエリで検索した情報を読み取り、回答を生成 | 既存手法(LLMのみの手法・SLMの追加学習)との比較で、平均1.8%〜14.2%精度が向上(※4) |
このハイブリッド設計については株式会社WEELでも、ハイブリッド設計に関連する開発検証を行っています。
例えば、営業分析AIの検証では、ローカルLLMを活用して商談の文字起こしデータから顧客のニーズやよくある質問を抽出し、分析しやすい形式に整理しました。
検証では、出力精度が想定より高かったことに加え、営業担当者の経験則を分析結果から把握できるなど、商談データの有効活用につながる成果が得られています。
生成AI開発・業務活用ならWEELへご相談ください
SLMとLLMの最適な使い分けやハイブリッド設計の導入は、ビジネスの成否を左右する重要な選択です。
「生成AIで新しいプロダクトを作りたい」「もっと本格的に生成AIを業務に組み込みたい」とお考えの方は、ぜひ株式会社WEELにご相談ください。
開発実績として、
・新規事業室での「リサーチ」「分析」「事業計画検討」を70%自動化するAIエージェント
・社内お問い合わせの1次回答を自動化するRAG型のチャットボット
・過去事例や最新情報を加味して、10秒で記事のたたき台を作成できるAIプロダクト
・お客様からのメール対応の工数を80%削減したAIメール
・サーバーやAI PCを活用したオンプレでの生成AI活用
・生徒の感情や学習状況を踏まえ、勉強をアシストするAIアシスタント
などの開発実績がございます。
生成AIを活用したプロダクト開発の支援内容は、以下のページでも詳しくご覧いただけます。
➡︎株式会社WEELのサービスを詳しく見る。
アイデア段階でも構いません。まずは無料相談でお気軽にご相談ください。
➡︎生成AIを活用したプロダクト開発・業務効率化について相談する
「生成AIを社内で活用したい」「生成AIの事業をやっていきたい」という方に向けて、生成AI社内セミナー・勉強会をさせていただいております。
セミナー内容や料金については、ご相談ください。
また、サービス紹介資料もご用意しておりますので、併せてご確認ください。
SLMのよくある質問